논문 리뷰
논문 리뷰: Lost in a Single Vector - Improving Long-Document Retrieval with Chunk Evidence Aggregation
1. 들어가며
RAG 파이프라인을 한 번이라도 손으로 만들어본 사람이라면 검색이 전체 시스템의 발목을 잡는 순간을 안다. 아무리 좋은 생성 모델을 붙여도, 정답이 담긴 문서를 상위로 끌어올리지 못하면 그다음은 없다. 그런데 실무에서 검색해야 하는 문서는 회의록, 판결문, 소설처럼 수천에서 수만 토큰에 이르는 긴 문서인 경우가 많고, 정작 질의에 답하는 결정적 근거는 그 안의 몇 문장에 불과한 경우가 흔하다.
Dense retrieval은 이런 긴 문서를 벡터 하나로 압축한 뒤 질의 벡터와의 유사도로 랭킹을 매긴다. 인터페이스가 단순하고 수십억 규모로 확장되기 때문에 산업 표준으로 자리 잡았지만, 여기엔 구조적인 병목이 있다. 문서 하나를 벡터 하나로 요약해야 한다는 제약이다. 관련성이 짧은 국소 구간(local span)에서 결정되는 상황에서, 그 몇 문장이 수천 개의 무관한 토큰과 함께 뭉개져 하나의 벡터로 눌러 담기면, 질의와 비교하기도 전에 결정적 근거가 이미 희석되어 버린다.
이 논문("Lost in a Single Vector")은 바로 이 실패 모드를 정면으로 다룬다. 저자들은 이 현상을 **문서 측 조기 압축(document-side early compression)**이라 명명하고, 이를 정량적으로 측정하는 지표 EDI(Evidence Dilution Index)를 제안한다. 그리고 이 진단에 기반해, 학습이 전혀 필요 없는(training-free) 문서 인코딩 전략 **DICE(Document Inference via Chunk Evidence)**를 내놓는다. 발상은 단순하다. 문서를 통째로 인코딩하지 말고 청크(chunk)로 쪼개 독립적으로 인코딩한 뒤, 다시 벡터 하나로 합쳐서 표준 검색 인터페이스를 그대로 유지하자는 것이다.
결과가 꽤 인상적이다. LongEmbed 벤치마크에서 4k 토큰을 넘는 어려운 슬라이스일수록 이득이 커지는데, Dream 백본 기준으로 Passkey 4k 초과 구간의 Hit@1이 30.0에서 90.0으로, Needle 4k 초과 구간이 23.3에서 74.0으로 뛴다. 12,779개 표본 중 92.8%에서 DICE가 단일 벡터 대비 낮은 EDI를 기록했다는 대목은, 성능 향상이 우연이 아니라 저자들이 지목한 메커니즘과 정확히 맞물려 있음을 보여준다.
| 항목 | 내용 |
|---|---|
| 제목 | Lost in a Single Vector: Improving Long-Document Retrieval with Chunk Evidence Aggregation |
| 저자 | Shanshan Lyu, Yiwei Wang, Yujun Cai, Jiafeng Guo, Shenghua Liu (Chongqing University, ICT CAS, UC Merced, University of Queensland) |
| arXiv | arXiv:2606.18781 |
| 코드 | github.com/PunchlineAAAA/DICE |
2. 문제 정의: 단일 벡터라는 병목
긴 문서 검색이 어려운 이유를 흔히 "컨텍스트 윈도우가 부족해서"라고 생각하기 쉽다. 하지만 저자들은 이 통념을 정면으로 반박한다. 요즘 인코더는 4k에서 32k 토큰을 무리 없이 처리하는데도, 문서가 길어지면 검색 품질이 떨어진다(Zhu et al., 2024). 그리고 모델은 두드러진 위치(salient position)에서 벗어난 정보를 체계적으로 덜 활용한다(Liu et al., 2024, "Lost in the Middle"). 즉 이건 용량(capacity)의 문제가 아니라 **표현(representation)**의 문제다.
무슨 뜻인지 구체적인 예로 보자.
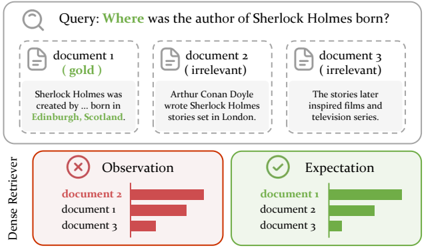
Figure 1 (원논문): 긴 문서 검색의 동기가 되는 사례. 골드 문서(document 1)에는 결정적 국소 근거가 담겨 있지만, 단일 벡터 인코딩은 검색 전에 근거가 희석되어 이 문서를 낮게 랭킹한다.
"셜록 홈즈의 작가는 어디서 태어났는가?"라는 질의를 생각해보자. 정답을 담은 골드 문서(document 1)에는 "Sherlock Holmes was created by ... born in Edinburgh, Scotland"라는 결정적 문장이 들어 있다. 그런데 이 문서는 아서 코난 도일에 관한 다른 서술로 채워져 있고, 문서 전체를 하나의 벡터로 인코딩하는 순간 "Edinburgh, Scotland"라는 짧은 근거가 나머지 문맥에 파묻힌다. 결과적으로 Dense Retriever의 관찰(Observation) 랭킹에서는 document 2가 1위로 올라오고, 정작 정답을 가진 document 1은 밀려난다. 기대(Expectation)와 실제 관찰이 어긋나는 지점이 바로 조기 압축이 일으키는 오류다.
수식으로 보면 표준 dense retrieval은 다음과 같이 코사인 유사도로 문서를 랭킹한다.
여기서 는 인코더, 는 질의, 는 문서다. 문제는 문서 가 짧은 근거 구간 와 대량의 무관한 문맥 로 이루어졌을 때, 인코딩 가 유사도를 계산하기도 전에 이미 결정적 근거의 표현에서 멀어진다는 데 있다. 문서에 정답이 있어도, 그 정답을 담은 짧은 국소 구간을 문서 벡터가 충분히 강하게 보존하지 못하면 랭킹에서 밀리는 것이다. 저자들의 표현을 빌리면, 핵심 질문은 "관련 근거가 문서에 존재하느냐"가 아니라 "단일 벡터 압축이 그 근거를 랭킹에 영향을 줄 만큼 강하게 보존하느냐"로 바뀐다.
2.1 근거 희석을 재는 자: EDI
직관은 좋은데, 이걸 어떻게 측정할까? 저자들은 문서 수준 표현을 같은 골드 문서 안의 청크 수준 근거와 비교하는 방식을 택한다. 골드 문서를 개의 청크로 나누고, 각 청크와 질의의 유사도를 라 하자. 그중 가장 강한 국소 근거를 , 평균 청크 유사도를 로 둔다. 여기서 max 값은 분석용 오라클(oracle)일 뿐, 배포 가능한 베이스라인이 아니라는 점을 저자들은 분명히 못 박는다.
첫 번째 지표는 **근거 집중도(Evidence Concentration, EC)**다. 질의 관련성이 소수 청크에 날카롭게 몰려 있는지(높은 EC), 아니면 문서 전반에 고르게 퍼져 있는지(낮은 EC)를 잡아낸다.
max와 평균의 격차 가 클수록 근거가 특정 청크에 몰려 있다는 뜻이므로 EC가 높다. 이 값은 어떤 표본이 구조적으로 근거 희석에 취약한지를 알려주는 사전 진단 역할을 한다.
두 번째이자 이 논문의 중심 지표가 **근거 희석 지수(Evidence Dilution Index, EDI)**다.
여기서 는 인코딩 방법 로 얻은 문서 수준 유사도다. EDI는 문서 벡터가 가장 강한 청크 수준 근거로부터 얼마나 아래로 떨어졌는지를 잰다. EDI가 낮을수록 문서 표현이 가장 관련성 높은 국소 구간에 가깝게 남아 있다는 뜻이고, EDI가 음수라면 문서 벡터가 여러 청크의 신호를 통합해 단일 청크 오라클마저 넘어섰다는 의미가 된다. 이 마지막 대목이 중요한데, 여러 청크에 근거가 분산된 경우 잘 통합된 문서 벡터가 오히려 max 오라클보다 강할 수 있음을 열어둔다.
두 지표 모두 근거 마진 를 분모나 분자로 활용한다. 이 마진이 0에 가까우면 비율이 불안정해지는데, 거의 모든 청크가 질의와 무관한 합성(synthetic) 설정에서 특히 그렇다. 그래서 저자들은 인 표본을 걸러내고 중앙값(median) 통계만 보고한다. 이 필터링 기준은 이후 실험 전반에서 "robust subset"이라는 이름으로 반복 등장한다.
이 프레임워크의 진짜 가치는 조기 압축을 막연한 직관에서 구체적인 설계 목표로 바꿔놓았다는 데 있다. 단일 문서 벡터가 체계적으로 가장 강한 청크 근거보다 아래로 떨어진다면, 자연스러운 처방은 압축을 늦추는 것이다. 국소 근거를 먼저 보존하고, 통합은 그 이후에 한다. DICE는 정확히 이 전략을 따른다.
3. 제안 방법: DICE
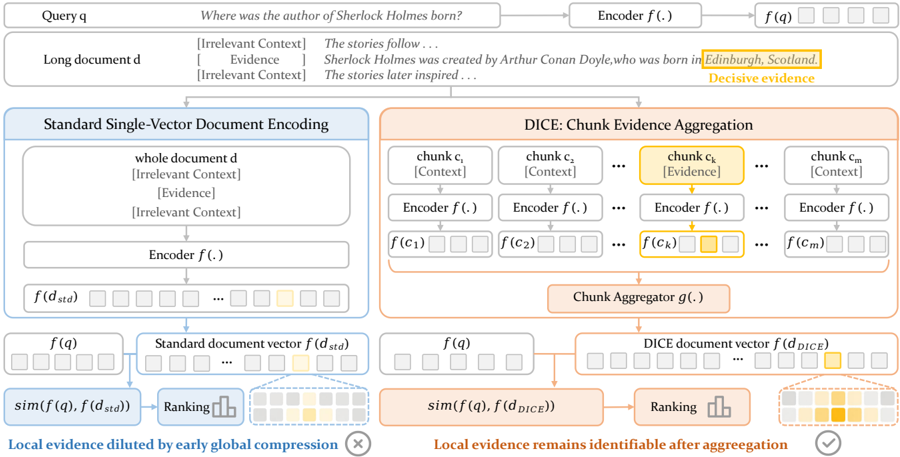
Figure 2 (원논문): DICE의 전체 개요. 문서 측만 바뀐다. 청크들이 로컬 위치로 독립 인코딩된 뒤 하나의 벡터로 통합되며, 질의 경로와 검색 인터페이스는 그대로 유지된다.
Figure 2가 DICE의 전부를 담고 있다. 왼쪽은 기존 표준 단일 벡터 인코딩이다. 문서 전체(무관 문맥 + 근거 + 무관 문맥)를 인코더 에 한 번에 넣어 를 얻는다. 그림에서 근거에 해당하는 노란 칸이 문서 벡터에서 흐릿하게 남아 있는데("Local evidence diluted by early global compression"), 이게 바로 앞서 본 조기 압축이다.
오른쪽이 DICE다. 같은 문서를 청크 으로 쪼갠 뒤 각각을 인코더 로 독립 인코딩한다. 근거가 담긴 청크 의 임베딩 에서는 노란 신호가 선명하게 살아남는다. 그다음 청크 애그리게이터 가 이들을 하나의 문서 벡터 로 합친다. 통합 후에도 노란 신호가 뚜렷하게 식별된다("Local evidence remains identifiable after aggregation"). 왼쪽과 오른쪽 모두 질의 경로 와 랭킹 방식은 동일하다. 바뀐 것은 오로지 문서 벡터를 만드는 방법뿐이다.
세 단계로 나눠 보자.
청킹(Chunking). 문서 를 토큰화한 뒤, 토큰 시퀀스를 크기 의 청크로 자른다. 선택적으로 겹침(overlap) 를 둘 수 있다. 분할은 토큰 공간에서 이루어져 토큰 정체성과 경계를 보존한다. 기본값은 겹침이 없는() 청크이며, 를 바꿔가며 청크 세분성(granularity)의 영향을 본다.
로컬 위치 인코딩(Local position encoding). 각 청크 는 동결된(frozen) 인코더 로 독립 인코딩되는데, 이때 위치 인덱스를 원 문서에서 물려받지 않고 청크마다 0에서 다시 시작하도록 리셋한다.
여기서 는 청크 의 토큰 id, 는 청크 안에서 0부터 시작하는 로컬 위치 시퀀스다. 로컬 위치를 쓰는 이유는 각 청크가 원 문서에서의 오프셋(offset)에 영향받지 않고 그 자체로 완결된 컨텍스트 윈도우로 처리되도록 하기 위함이다. 뒤에서 다룰 절제 실험(Appendix C.2)이 보여주듯, 이 위치 리셋은 단순히 "문서를 쪼갰다"는 것 이상의 실질적 기여를 한다. 질의 인코딩은 그대로 두는데, 질의는 문서에 비해 짧아서 청킹의 실익이 없고, 청킹하면 오히려 유지하려던 검색 인터페이스만 복잡해지기 때문이다.
애그리게이션(Aggregation). 청크 임베딩들은 질의와 무관한(query-independent) 통합 함수 를 통해 하나의 문서 벡터로 융합된다.
통합은 질의를 보기 전에 수행되므로 질의-청크 상호작용을 활용할 수 없다. 그래서 저자들은 질의와 무관한 단순 풀링 규칙의 작은 집합에 집중한다. 모든 청크를 동등하게 보존하는 방식, 활성도가 높은 청크를 강조하는 방식, 일부 청크만 선택하는 방식으로 나뉜다. 구체적으로는 세 가지를 비교한다.
- 평균 풀링(mean pooling): 기본 전략. 모든 청크의 근거를 동등하게 보존한다.
- 최대 풀링(max pooling): 청크 간 원소별 최댓값을 취하는 더 선택적인 대안.
- topk 풀링: 임베딩 노름 을 질의와 무관한 청크 중요도의 대리 지표로 삼아, 노름이 가장 큰 상위 개 청크를 평균낸다.
검색 인터페이스(Retrieval interface). 통합이 끝나면 검색은 단일 벡터 베이스라인과 똑같이 진행된다.
DICE는 청크를 검색하지 않고, 코퍼스 엔트리 수를 늘리지 않으며, 2차 스코어러를 추가하지도 않는다. 변화는 전적으로 문서 인코딩 측에만 있고, 랭킹의 차이는 오로지 문서 표현에서 나온다. 이 점이 ColBERT류 late interaction이나 passage retrieval과 결정적으로 다른 지점이다. 저장 벡터는 문서당 하나, 질의 인코딩과 스코어링 인터페이스는 그대로다.
4. 실험 설정
벤치마크와 메트릭. 메인 벤치마크는 LongEmbed(Zhu et al., 2024)로, 합성 태스크 2개(Passkey, Needle)와 실제 검색 태스크 4개(NarrativeQA, QMSum, SummScreenFD, WikiMQA)로 구성된다. 합성 태스크는 Hit@1(%)을 4k 토큰 이하와 초과로 나눠 보고하고, 실제 태스크는 nDCG@10을 쓴다. 분할 메트릭은 해당 길이 슬라이스에 대한 매크로 평균이다. 모든 평가는 MTEB 프레임워크(Muennighoff et al., 2023)에서 이루어진다. 추가로 Dream 백본에 대해 FollowIR(Weller et al., 2024)의 세 태스크(News21, Core17, Robust04)를 평가하는데, News21은 nDCG@5, Core17과 Robust04는 MAP@1000을 쓰고 p-MRR을 보조 지표로 둔다.
비교 범위. 저자들이 강조하는 지점은 "배포 등가(deployment-equivalent)" 설정이다. 문서당 저장 벡터 하나, 질의 인코딩 불변, 동일한 1차 질의-문서 스코어링 인터페이스. 이 범위 안에서 SINGLE(단일 벡터 베이스라인)과 대안적 청크 통합 규칙들이 직접 비교 대상이 된다. passage retrieval, ColBERT식 late interaction, late chunking은 검색 단위나 스코어링 방식을 바꾸므로 동급 경쟁자가 아니라 인접 참조(adjacent reference)로만 다룬다. 이 구분을 처음부터 명확히 해둔 점이 논문의 주장 범위를 정직하게 좁혀준다.
모델. 주 백본은 Dream 7B 언어 모델 위에 세운 확산(diffusion) 기반 임베더(Zhang et al., 2025)다. 효과가 확산 아키텍처에만 국한되는지 검증하기 위해, 자기회귀(autoregressive) 백본 3개도 양방향 임베더로 변환해(BehnamGhader et al., 2024, LLM2Vec) 함께 평가한다. Llama3 8B, Mistral 7B, Qwen2.5 7B다. 모든 비교에서 SINGLE과 DICE 사이의 인코더 가중치는 동결된다. 즉 학습 없이 인코딩 방식만 바꾼 결과다.
구현. DICE는 확산과 자기회귀 백본을 모두 지원하도록 확장한 LLM2Vec 코드베이스 위에서, 통합 평가 래퍼 안의 문서 측 로직으로 구현된다. 질의 입력은 일반 인코딩으로, 문서 입력은 설정에 따라 단일 벡터 또는 청크 통합 경로로 라우팅된다. 별도 언급이 없으면 DICE는 청크 크기 1024, 겹침 없음, 평균 통합, bfloat16 추론, 코사인 유사도를 쓴다. 모든 평가는 단일 NVIDIA A6000 GPU에서 SINGLE과 DICE 설정을 맞춰 수행했다.
5. 메인 결과
Table 1이 이 논문의 핵심 결과다. 네 백본 모두에서 단일 벡터 문서 인코딩을 DICE로 교체하면 LongEmbed 성능이 오른다. 그리고 그 이득이 4k 초과 합성 슬라이스, 즉 조기 압축 가설이 정확히 예측하는 가장 어려운 구간에 집중된다.
| Backbone | Method | Avg. | Pk >4k | Nd >4k | NQA | QMS | SFD | WQA |
|---|---|---|---|---|---|---|---|---|
| Llama3 | SINGLE | 34.64 | 3.33 | 7.33 | 18.06 | 29.24 | 77.45 | 40.08 |
| Llama3 | DICE (ours) | 50.56 | 35.33 | 25.33 | 45.64 | 27.59 | 93.00 | 61.16 |
| Llama3 | Δ | +15.92 | +32.00 | +18.00 | +27.58 | -1.64 | +15.55 | +21.08 |
| Qwen | SINGLE | 43.80 | 8.67 | 9.33 | 19.51 | 35.82 | 87.89 | 51.95 |
| Qwen | DICE (ours) | 59.06 | 66.67 | 20.00 | 35.25 | 42.06 | 91.83 | 61.51 |
| Qwen | Δ | +15.27 | +58.00 | +10.67 | +15.75 | +6.24 | +3.94 | +9.56 |
| Mistral | SINGLE | 57.24 | 30.00 | 18.00 | 33.10 | 43.50 | 92.64 | 61.08 |
| Mistral | DICE (ours) | 74.38 | 86.00 | 58.67 | 55.73 | 50.79 | 96.48 | 71.38 |
| Mistral | Δ | +17.14 | +56.00 | +40.67 | +22.63 | +7.29 | +3.84 | +10.31 |
| Dream | SINGLE | 63.41 | 30.00 | 23.33 | 43.63 | 43.93 | 97.77 | 79.43 |
| Dream | DICE (ours) | 81.92 | 90.00 | 74.00 | 65.01 | 50.54 | 98.53 | 86.04 |
| Dream | Δ | +18.50 | +60.00 | +50.67 | +21.39 | +6.61 | +0.76 | +6.61 |
Table 1 (원논문): LongEmbed 메인 결과. DICE는 청크 크기 1024, 평균 통합. Avg.는 생략된 합성 4k 이하 두 열을 포함한 8개 메트릭의 비가중 평균. Pk=Passkey, Nd=Needle, NQA=NarrativeQA, QMS=QMSum, SFD=SummScreenFD, WQA=WikiMQA.
숫자에서 눈에 띄는 건 합성 4k 초과 구간의 폭발적 증가다. Dream에서 Passkey 4k 초과가 30.0에서 90.0으로 60포인트, Needle 4k 초과가 23.3에서 74.0으로 50.7포인트 뛴다. Mistral과 Qwen도 Passkey 4k 초과에서 각각 +56.0, +58.0으로 비슷한 폭의 상승을 보인다. 정답이 긴 문서 깊숙이 묻혀 있는 바로 그 상황에서, 청크로 쪼개 근거를 살려두는 전략이 가장 크게 먹힌다는 뜻이다.
반면 소수의 퇴보(regression)도 정직하게 드러난다. Llama3의 QMSum이 -1.64로 유일하게 떨어지는데, 이런 예외는 문서가 짧거나 관련성이 덜 국소적인 경우에 발생한다. 근거가 문서 전반에 고르게 퍼져 있으면 애초에 조기 압축으로 잃을 것이 적으니, DICE가 개입할 여지도 줄어드는 셈이다. 백본 관점에서 보면 흥미로운 대비가 있다. 확산 백본 Dream이 절대 성능(81.92)에서 가장 앞서지만, 상대적 개선폭(Δ Avg. +18.50)은 자기회귀 백본들과 크게 다르지 않다. 즉 DICE의 효과는 특정 아키텍처의 산물이 아니라 단일 벡터 인터페이스라는 공통 병목에서 비롯된다.
Dream 측 인접 참조로, 저자들은 Late Chunking(Gunther et al., 2024)을 각색한 LATECHUNK-DOC도 추가로 시험한다. Dream에서 LATECHUNK-DOC는 평균 81.51점으로 단일 벡터(63.41)를 크게 웃돌고 DICE(81.92)에 근접한다. 다만 이건 설계가 다른 이웃 방법이므로 1차 베이스라인이 아닌 보충 참조로만 취급한다(자세한 내용은 Appendix C.1).
6. 분석
6.1 길이별 Needle: 컨텍스트가 길어질수록 벌어지는 격차
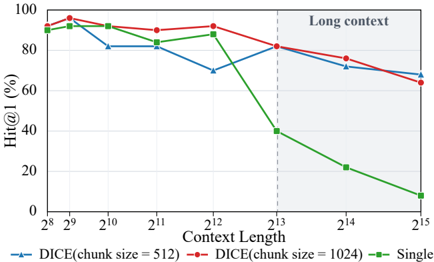
Figure 3 (원논문): Dream에서 컨텍스트 길이별 Needle Hit@1(%). 청크 수준 인코딩은 단일 벡터 문서 압축에서 관찰되는 급격한 장문맥 성능 붕괴를 막는다.
Figure 3은 Needle Hit@1을 컨텍스트 길이(부터 토큰)로 분해한다. 4k() 지점까지는 단일 벡터(초록 실선)가 청크 방식(빨강 chunk-1024, 파랑 chunk-512)과 거의 붙어 있다. 짧은 문서에서는 압축으로 잃을 게 별로 없으니 당연하다. 그런데 (8k)을 넘어 "Long context" 회색 영역에 진입하는 순간 초록선이 가파르게 무너진다. 32k()에서 단일 벡터는 0.08까지 곤두박질치는 반면, chunk-512와 chunk-1024는 모두 0.64 이상을 유지한다.
이 그래프가 논문의 논지를 시각적으로 못 박는다. 격차가 4k를 넘어서면서 단조롭게 벌어진다는 사실은, 장문맥에서의 성능 저하가 컨텍스트 윈도우 용량만의 문제가 아니라 조기 압축이라는 표현적 병목에서 온다는 강력한 증거다. 모델이 32k를 "처리할 수 있느냐"와 그 안의 짧은 근거를 "벡터에 보존하느냐"는 전혀 다른 문제라는 것이다.
6.2 청크 크기와 통합 방식: 무엇이 이득을 만드는가
Table 2는 DICE의 두 설계 축, 청크 세분성과 통합 전략을 Dream 백본에서 전수 절제한 결과다. 모든 런은 겹침 없는 청크, bfloat16, 코사인 유사도를 쓰고 절제 변수만 바꾼다.
| Chunk | Agg. | Avg | Pk ≤4k | Pk >4k | Nd ≤4k | Nd >4k | NQA | QMS | SFD | WQA |
|---|---|---|---|---|---|---|---|---|---|---|
| - (SINGLE) | - | 63.41 | 100.0 | 30.00 | 89.20 | 23.33 | 43.63 | 43.93 | 97.77 | 79.43 |
| 128 | mean | 61.21 | 48.80 | 33.33 | 71.20 | 56.00 | 60.41 | 44.98 | 97.74 | 77.22 |
| 256 | mean | 69.83 | 75.20 | 34.00 | 84.80 | 74.67 | 63.09 | 47.43 | 98.36 | 81.12 |
| 512 | mean | 76.30 | 88.80 | 66.67 | 84.40 | 74.00 | 64.17 | 49.60 | 98.66 | 84.07 |
| 1024 | mean | 81.92 | 98.80 | 90.00 | 92.40 | 74.00 | 65.01 | 50.54 | 98.53 | 86.04 |
| 1024 | max | 64.63 | 99.20 | 100.0 | 89.20 | 44.67 | 26.65 | 25.39 | 88.40 | 43.53 |
| 1024 | topk | 56.65 | 86.80 | 9.33 | 88.00 | 18.00 | 49.60 | 39.99 | 95.39 | 66.09 |
Table 2 (원논문): Dream의 LongEmbed 절제 실험. 상단 블록은 평균 통합에서 청크 크기를 변화시키고, 하단 블록은 청크 크기를 1024로 고정한 채 통합 규칙을 바꾼다. '-'는 SINGLE 베이스라인, 볼드는 열별 최고값.
두 가지 분명한 패턴이 나온다.
첫째, 청크 세분성이 결정적으로 중요하다. 128 토큰에서는 DICE가 오히려 SINGLE에 뒤진다(61.21 대 63.41). 너무 잘게 쪼개면 유용한 국소 문맥조차 보존하지 못한다는 뜻이다. 특히 Passkey 4k 이하가 100.0에서 48.80으로 반토막 나는데, 짧은 문서를 잘게 쪼개면 정답 구간이 여러 청크로 분산되어 오히려 신호가 약해진다. 하지만 256부터는 전체 평균이 단조 상승하고, 어려운 장문맥 슬라이스는 더 가파르게 개선된다. 청크 크기 1024가 최고 평균(81.92)을 달성하며 8개 메트릭 중 7개에서 최고 또는 준최고를 기록한다. 청크가 커질수록 좋다는 이 경향은 합성 태스크의 Hit@()에서도, Mistral 백본에서도 유지된다(각각 Appendix B.2, B.1).
이 청크 크기 절제를 시각화한 것이 Figure 4다.
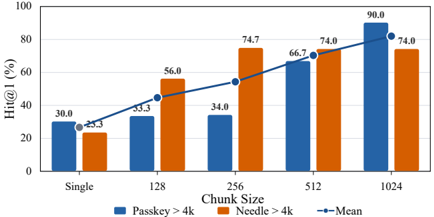
Figure 4 (원논문): Dream의 LongEmbed 청크 크기 절제. 막대는 Passkey 4k 초과(파랑)와 Needle 4k 초과(주황) Hit@1(%), 선은 둘의 평균. 청크 크기가 클수록 가장 어려운 장문맥 슬라이스가 일관되게 개선되며, 1024에서 어려운 슬라이스 평균이 최고에 이른다.
Figure 4에서 파란 막대(Passkey 4k 초과)는 Single의 30.0에서 청크 128의 33.3, 256의 34.0을 거쳐 512에서 66.7, 1024에서 90.0으로 계단식으로 오른다. 주황 막대(Needle 4k 초과)는 128에서 이미 56.0으로 크게 뛴 뒤 256~1024 구간에서 74점대로 안정된다. 두 슬라이스의 평균선(파란 마커)이 25.3에서 82.0까지 우상향하는 모습이, "국소 문맥을 충분히 보존할 만큼 청크를 크게 잡아야 한다"는 결론을 한눈에 보여준다. Passkey가 Needle보다 큰 청크의 덕을 더 보는 이유는, Passkey의 정답 문자열이 더 짧고 국소적이라 작은 청크로 쪼갤 때 문맥 단서를 잃기 쉽기 때문으로 보인다.
둘째, 더 정교한 통합이 더 좋은 것은 아니다. Table 2 하단이 이를 보여준다. 최대 풀링은 Passkey 4k 초과에서 100.0으로 전 설정 중 최고를 찍지만, 실제 태스크에서 무너진다. NQA가 65.01에서 26.65로, QMS가 50.54에서 25.39로, WQA가 86.04에서 43.53으로 급락한다. 합성 태스크는 정답이 단 하나의 청크에 몰려 있어 max가 잘 먹히지만, 실제 태스크는 근거가 여러 청크에 분산되어 있어 원소별 최댓값이 서로 다른 청크의 신호를 뒤섞어 문서 표현을 오염시키기 때문이다. topk 풀링(노름 기반)은 모든 메트릭에서 평균 풀링에 뒤지고 종종 SINGLE보다도 낮다. 결국 이득은 정교한 청크 선택이 아니라 충분한 국소 문맥을 보존하고 보수적으로(평균으로) 통합하는 데서 온다. 그래서 메인 결과 전반의 기본값은 평균 풀링 + 청크 1024다.
6.3 위치 인코딩: 쪼개는 것만으로는 부족하다
저자들은 위치 방식도 절제한다. 로컬 리셋 대신 각 청크의 원 문서 절대 오프셋을 보존하는 변형을 시험했는데, 완료된 모든 백본에서 로컬 리셋을 넘어서지 못했다. Dream에서 평균이 81.92에서 81.85로, Llama3에서 50.56에서 43.19로, Mistral에서 74.38에서 73.74로 떨어진다(Appendix C.2). 특히 Llama3의 하락폭이 크다. 그래서 기본값은 로컬 리셋으로 둔다. Qwen은 이 실험에서 빠졌는데, 절대 오프셋이 매우 긴 입력에서 청크 위치 id를 백본 지원 범위 밖으로 밀어내는 실용적 강건성 문제를 드러냈기 때문이다. 로컬 리셋은 이 문제를 애초에 피한다.
이 결과의 함의는 미묘하지만 중요하다. DICE의 이득이 단순히 "문서를 조각냈다"에서 오는 게 아니라, "각 조각을 아주 긴 위치 범위의 늦은 파편이 아니라 그 자체로 완결된 로컬 컨텍스트로 인코딩했다"는 데서 온다는 것이다. 청킹과 로컬 위치 리셋은 별개의 기여이며, 둘 다 필요하다.
6.4 품질-비용 트레이드오프
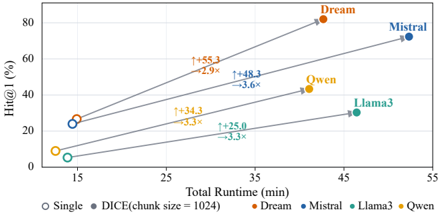
Figure 5 (원논문): LongEmbed의 품질-비용 트레이드오프. 품질은 Passkey 4k 초과와 Needle 4k 초과 Hit@1(%)의 평균이며, 화살표는 각 백본에서 SINGLE(빈 원)에서 DICE(채운 원)로의 이동을 나타낸다.
DICE는 효율 방법이 아니다. 문서당 여러 청크를 인코딩하니 문서 측 연산이 늘어난다. Figure 5는 정확도-런타임 트레이드오프를 백본별로 그린다. 화살표가 하나같이 우상향하는데, 네 백본 모두 문서 측 런타임을 대략 3~4배 늘리는 대가로 장문맥 Hit@1을 끌어올린다. 예컨대 Dream은 +55.3의 품질 향상을 2.9배 런타임으로, Qwen은 +34.3을 3.3배로, Mistral은 +48.3을 3.6배로, Llama3는 +25.0을 3.3배로 각각 얻는다.
이 그림이 정직하게 말하는 바는, DICE가 공짜 점심이 아니라는 것이다. 다만 실제 운영 지점은 장문서 재현율(recall)이 추가 인코딩 비용을 정당화하느냐에 달려 있다. 문서를 오프라인으로 한 번 색인해두고 여러 번 질의하는 시나리오라면, 색인 시점의 3~4배 비용은 충분히 받아들일 만하다. 반대로 실시간으로 문서를 인코딩해야 하는 상황이라면 이야기가 달라진다.
6.5 겹침(overlap)의 효과
인접 청크 사이에 토큰 겹침을 두면 어떨까? 청크 크기 1024에서 겹침을 도입해도 겹침 없는 베이스라인 대비 평균 성능이 나아지지 않았다. 256 토큰 겹침에서는 평균이 81.92에서 70.79로 떨어지는데, 주로 Passkey 4k 초과가 90.0에서 46.7로 무너진 탓이다. 겹침을 512 토큰으로 늘리면 평균이 80.78로 부분 회복되고 Passkey 4k 초과 94.0, Needle 4k 초과 79.3까지 오르지만, 런타임 대가가 가파르다(LongEmbed 전체 스위트 기준 겹침 없이 43분 대 512 겹침 80분). 겹침은 문서 인코딩 시간을 늘리면서도 일관된 평균 이득을 주지 못하므로, 메인 설정에서는 을 유지한다.
7. EDI 기반 검증: 메커니즘을 직접 시험하다
절제 실험은 청크 세분성과 보수적 통합이 DICE의 이득을 만든다는 것을 보였다. 하지만 이건 아직 논문의 중심 가설 "단일 벡터 인코딩이 국소 근거를 체계적으로 희석한다"를 직접 시험한 게 아니다. Section 2.2에서 정의한 EDI 프레임워크가 바로 이 지점에서 소환된다. 이 절의 모든 분석은 Dream 백본, 청크 크기 1024, 평균 통합을 쓰며, robust subset은 마진 필터()를 통과한 표본을 뜻한다. Dream 기준으로 12,779개 표본이 남는다.
| Split | SINGLE EDI ↓ | DICE EDI ↓ | DBR (%) ↑ |
|---|---|---|---|
| Overall | 0.055 | -0.709 | 92.8% |
| NQA | 0.046 | -0.737 | 95.7% |
| QMS | -0.131 | -1.020 | 94.7% |
| SFD | -0.009 | -0.693 | 92.7% |
| WQA | 0.286 | 0.205 | 61.0% |
Table 3 (원논문): Dream의 LongEmbed robust subset EDI 비교(청크 1024, 평균 통합). robust subset은 인 모든 표본이며, DBR은 EDI(DICE) < EDI(SINGLE)인 표본의 비율.
Table 3의 숫자가 논문의 뼈대다. 전체적으로 DICE는 중앙값 EDI를 0.055에서 -0.709로 낮추고, 표본의 92.8%(DBR)에서 SINGLE보다 낮은 EDI를 기록한다. EDI가 양수에서 음수로 바뀌었다는 건, DICE 문서 벡터가 평균적으로 단일 청크 오라클(max)마저 넘어섰다는 뜻이다. 여러 청크의 신호를 통합해 개별 최강 청크보다 강한 표현을 만들어냈다는 것이다. NQA, QMS, SFD에서 이 패턴이 강하게 유지되며 DBR이 92% 이상이다.
예외는 WikiMQA다. 0.286에서 0.205로 줄기는 하지만 폭이 작고 DBR도 61.0%에 그친다. 이 태스크는 근거가 상대적으로 덜 국소적이라 애초에 희석될 것이 적고, 그만큼 DICE의 개입 여지도 작다. 완벽하게 균일한 효과는 아니지만 방향은 일관된다는 저자들의 서술이 정직하다. Mistral을 이용한 가벼운 교차 검증(Appendix A.2)에서도 같은 질적 패턴이 나와, EDI가 Dream에만 특화된 진단이 아님을 보여준다.
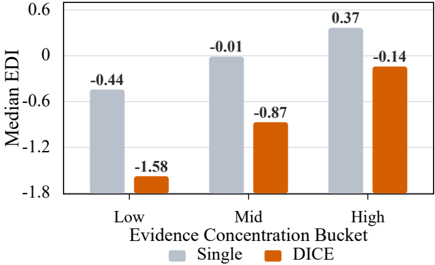
Figure 6 (원논문): Dream의 LongEmbed robust subset에서 EC 삼분위(tercile)별 중앙값 EDI. 두 방법 모두 EC가 높아질수록 EDI가 오르지만, DICE는 세 구간 모두에서 일관되게 낮다. SINGLE과 DICE의 상대 격차는 저EC 구간에서 가장 크다.
Figure 6은 이 결과를 EC 삼분위(저 , 중 0.085-0.126, 고 , 각 약 4,260개 표본)로 더 쪼갠다. 두 방법 모두 EC가 높아질수록 EDI가 오르는데, 이는 날카롭게 국소화된 근거일수록 단일 벡터로 보존하기가 본질적으로 어렵다는 뜻이다. 동시에 DICE는 모든 구간에서 SINGLE보다 낮다. 저EC 구간 -1.58 대 -0.44, 중EC -0.87 대 -0.01, 고EC -0.14 대 0.37이다.
이 분해가 메커니즘 해석을 두 가지 방향으로 날카롭게 만든다. 첫째, 앞서 본 길이별 성능 저하와 맞물린다. 관련성이 더 국소화되고 더 깊이 묻힐수록 단일 벡터 압축이 더 자주 실패한다. 둘째, 상대 격차가 저EC 구간에서 가장 크다는 사실이 흥미롭다. DICE는 하나의 청크가 지배하는 경우뿐 아니라, 유용한 근거가 여러 청크에 분산된 경우에도 도움이 된다는 것이다. max 오라클을 넘어서는 음수 EDI가 바로 이 다중 청크 통합의 산물이다.
8. FollowIR로의 전이
명시적 장문서 벤치마크를 넘어서도 이득이 이어질까? 2차 전이 점검으로 Dream을 FollowIR에서 평가한다.
| Method | News nDCG@5 | Core MAP@1000 | Robust MAP@1000 |
|---|---|---|---|
| SINGLE | 36.66 | 24.87 | 25.81 |
| DICE-256 | 39.03 | 29.02 | 29.18 |
| DICE-256+ov32 | 42.25 | 29.61 | 29.79 |
| DICE-256+ov128 | 38.80 | 31.14 | 30.27 |
| DICE-512 | 35.42 | 25.74 | 27.93 |
Table 4 (원논문): Dream의 FollowIR 결과. 개선이 LongEmbed 너머로 지속되지만, 최적 청크 설정은 태스크에 따라 달라진다.
문서 측 청크 통합은 단일 벡터 베이스라인을 일관되게 넘어선다. News21 nDCG@5가 36.66에서 42.25로, Core17 MAP@1000이 24.87에서 31.14로, Robust04가 25.81에서 30.27로 오른다. 다만 LongEmbed와 달리 FollowIR에서는 단일한 겹침 없는 청크 크기가 최적이 아니다. News21은 256 토큰 청크 + 32 토큰 겹침을, Core17과 Robust04는 같은 청크 크기에 128 토큰 겹침을 선호한다. 저자들은 이를 두고 "이득이 명시적 장문서 벤치마크 너머로 확장된다는 전이 증거"로 삼되, 최적 세분성은 벤치마크 의존적임을 함께 강조한다. 솔직히 이 부분은 DICE의 실용적 약점이기도 하다. 새 도메인에 적용할 때 청크 크기와 겹침을 다시 튜닝해야 할 수 있다는 뜻이니까.
정리하면, DICE에서 가장 신뢰할 만한 이득은 문서가 길고 관련성이 국소적일 때 나타나며, 그 이득은 정교한 청크 선택이 아니라 문서 수준 압축 전에 충분한 국소 문맥을 보존하는 데서 온다.
9. 부록: 보충 실험
논문의 부록은 세 갈래로 나뉜다. A는 메커니즘 증거 보강, B는 검색 분석 확장, C는 대안 설계 참조다. 메인 주장의 범위를 좁히고 해석을 더 구체화하는 재료들이다.
9.1 Appendix A: 메커니즘 증거 보강
QMSum 사례(Figure 7). 부록 A.1은 조기 압축의 실패 모드를 구체적 사례로 보여준다. Figure 7은 이미지가 아니라 텍스트 상자 형태인데, 내용을 그대로 옮기면 다음과 같다.
질의: "Industrial Designer는 회의가 브레인스토밍에 우호적이지 않다고 생각했다. 제약은 분위기가 아니라 실제 환경과 제한된 논의 시간에 관한 것이었다. 게다가 상호작용이 구조화되어 각자 한 가지 과제만 맡고 충분한 협업이 없었다. 이메일을 통한 소통도 비효율적이었다."
골드 문서 내 국소 근거: "the meetings ... are more brainstorming sessions than meetings"; "the room not being ... very friendly"; "the time given also restricts"; "the interactions are very structured"; "each individual is structured to one particular task"; "it just comes back to us so slow in the email"; "they don't support collaboration."
골드 문서 랭킹 — SINGLE: 128위, DICE: 1위
Figure 7 (원논문): 고도로 국소화된 근거를 가진 QMSum 사례. 짧은 논의 구간이 골드 문서를 되찾는 데 필요한 결정적 근거를 담고 있다.
이 사례의 요점은 QMSum이 특별하다는 게 아니라, 결정적 근거가 눈에 띄게 국소화되어 있다는 점이다. 짧은 구절 몇 개가 질의를 해소하는데도, 전체 문서 SINGLE 표현은 골드 문서를 128위로 밀어낸다. 반면 DICE(청크 1024)는 1위로 되찾는다. 압축을 늦추면 집중된 근거가 보존된다는 주장을 가장 극적으로 보여주는 예다.
교차 백본 EDI 점검(Table 5, 6). 부록 A.2는 Dream 중심 분석을 보완하기 위해 Mistral로 동일한 robust subset 기준의 가벼운 점검을 수행한다. 먼저 청크 크기 경향이 Mistral에서도 전이되는지 확인한다.
| Chunk | Avg | Pk ≤4k | Pk >4k | Nd ≤4k | Nd >4k | NQA | QMS | SFD | WQA |
|---|---|---|---|---|---|---|---|---|---|
| - (SINGLE) | 57.24 | 99.2 | 30.00 | 80.4 | 18.00 | 33.10 | 43.50 | 92.64 | 61.08 |
| 128 | 52.77 | 37.2 | 18.00 | 75.6 | 42.00 | 51.58 | 42.35 | 91.97 | 63.48 |
| 256 | 58.66 | 51.6 | 29.33 | 76.0 | 52.67 | 53.35 | 46.06 | 94.24 | 66.05 |
| 512 | 65.65 | 80.0 | 44.67 | 79.2 | 54.67 | 54.52 | 48.80 | 95.43 | 67.89 |
| 1024 | 74.38 | 96.0 | 86.00 | 80.0 | 58.67 | 55.73 | 50.79 | 96.48 | 71.38 |
Table 5 (원논문): Mistral의 LongEmbed 청크 크기 스윕. 합성 점수는 Hit@1(%), 실제 태스크는 nDCG@10. Dream에서 관찰된 청크 세분성 경향이 Mistral에도 그대로 나타난다.
Dream과 같은 순서가 재현된다. 청크 128은 평균적으로 너무 작고(52.77로 SINGLE 57.24보다 낮다), 청크가 커질수록 성능이 꾸준히 오르며, 1024가 가장 강한 전체 결과와 함께 어려운 4k 초과 슬라이스에서 가장 뚜렷한 이득을 준다. 이어서 이 전이가 같은 방향의 EDI 개선을 동반하는지 본다.
| Split | SINGLE ↓ | DICE ↓ | DBR (%) ↑ |
|---|---|---|---|
| Overall | 0.404 | -0.361 | 91.8% |
| NQA | 0.415 | -0.407 | 94.6% |
| QMS | 0.311 | -0.394 | 93.1% |
| SFD | 0.478 | -0.228 | 92.2% |
| WQA | 0.489 | 0.076 | 87.7% |
Table 6 (원논문): Mistral의 robust subset EDI. 낮은 EDI와 높은 DBR이 Dream 너머에서도 메인의 질적 패턴을 재현한다.
두 Mistral 표는 Dream과 같은 해석을 뒷받침한다. 큰 청크가 지나치게 잘게 쪼갠 것보다 낫고, 최고 설정이 모든 실제 태스크 분할에서 현저히 낮은 EDI와 높은 DBR을 준다. 절대 크기는 Dream과 다르다. 특히 WikiMQA에서 그런데(DICE EDI가 Dream에서는 여전히 양수 0.205, Mistral에서는 0.076), 더 나은 검색과 낮은 희석 사이의 질적 정렬은 그대로 유지된다.
9.2 Appendix B: 검색 분석 확장
합성 topk 검색(Table 7). 부록 B.2는 랭킹 경향이 Hit@1을 넘어서도 지속되는지 확인한다.
| Method | Pk Hit@1 | Pk Hit@2 | Pk Hit@3 | Pk Hit@5 | Pk Hit@10 | Nd Hit@1 | Nd Hit@2 | Nd Hit@3 | Nd Hit@5 | Nd Hit@10 |
|---|---|---|---|---|---|---|---|---|---|---|
| SINGLE | 30.00 | 30.00 | 30.00 | 30.00 | 30.00 | 23.33 | 25.33 | 26.00 | 26.00 | 26.67 |
| DICE-128 | 33.33 | 40.67 | 48.67 | 58.67 | 73.33 | 56.00 | 71.33 | 78.67 | 87.33 | 92.67 |
| DICE-256 | 34.00 | 52.67 | 62.00 | 78.67 | 89.33 | 74.67 | 88.67 | 92.67 | 95.33 | 100.00 |
| DICE-512 | 66.67 | 80.67 | 90.00 | 96.00 | 100.00 | 74.00 | 86.00 | 90.67 | 96.67 | 98.67 |
| DICE-1024 | 90.00 | 100.00 | 100.00 | 100.00 | 100.00 | 74.00 | 88.00 | 90.67 | 94.00 | 98.67 |
Table 7 (원논문): Dream의 4k 초과 슬라이스 합성 Hit@k(%). DICE의 랭킹 이득이 Hit@1을 넘어 더 넓은 topk 컷오프에서도 지속된다.
이 표에서 흥미로운 대비가 하나 있다. SINGLE은 Passkey 4k 초과에서 Hit@1부터 Hit@10까지 전부 30.00으로 완전히 정체된다. 골드 문서를 아예 상위 후보에조차 못 올린다는 뜻이다. 반면 DICE는 컷오프를 넓힐수록 계단식으로 오른다. 특히 작은 청크(DICE-128)조차 Hit@10에서 73.33까지 회복하는데, 이는 청크 근거가 우연히 재랭킹된 게 아니라 실제로 보존되고 있음을 시사한다. 큰 청크(DICE-1024)는 Passkey에서 Hit@2부터 이미 100.0에 도달한다. Needle에서는 DICE-256이 Hit@10에서 100.0으로 가장 높은데, Needle의 근거가 Passkey보다 조금 더 넓게 퍼져 있어 중간 크기 청크가 유리한 것으로 보인다.
LATECHUNK-DOC 참조(Table 8). 부록 C.1에 속하지만 Table 8은 여기서 함께 보는 게 자연스럽다. Late Chunking을 문서 측으로 각색한 이웃 설계다.
| Method | Avg. | Pk ≤4k | Pk >4k | Nd ≤4k | Nd >4k | NQA | QMS | SFD | WQA |
|---|---|---|---|---|---|---|---|---|---|
| SINGLE | 63.41 | 100.0 | 30.00 | 89.2 | 23.33 | 43.63 | 43.93 | 97.77 | 79.43 |
| LATECHUNK | 81.51 | 96.0 | 93.33 | 90.0 | 73.33 | 65.05 | 50.13 | 98.53 | 85.69 |
| DICE (ours) | 81.92 | 98.8 | 90.00 | 92.4 | 74.00 | 65.01 | 50.54 | 98.53 | 86.04 |
Table 8 (원논문): Dream의 인접 단일 벡터 참조 LATECHUNK-DOC. 합성은 Hit@1(%), 실제는 nDCG@10. 압축 전에 토큰 근거를 문맥화하는 이웃 설계 대비 DICE의 위치를 보여준다.
LATECHUNK-DOC는 긴 컨텍스트 순전파(long-context forward pass)로 토큰 근거를 문맥화한 뒤 하나의 문서 벡터로 압축한다. 평균 81.51로 DICE(81.92)에 아주 근접한다. 이 비교가 유용한 이유는 쉽게 뒤섞이는 두 아이디어를 분리해주기 때문이다. "압축을 늦추면 도움이 된다"는 것과, "그 방식이 긴 컨텍스트 문맥화냐 독립적 로컬 청크 인코딩이냐"는 별개의 설계 선택이다. 두 방법이 비슷한 성능에 도달한다는 사실은, 압축 전에 근거를 풍부하게 유지하는 것이 핵심이며 그 구체적 경로는 여러 가지일 수 있음을 보여준다. DICE는 그중에서도 가장 단순하고 학습이 필요 없는 설계점인 셈이다.
9.3 Appendix C.2: 절대 오프셋 프로브
| Backbone | Method | Avg. | Pk ≤4k | Pk >4k | Nd ≤4k | Nd >4k | NQA | QMS | SFD | WQA |
|---|---|---|---|---|---|---|---|---|---|---|
| Dream | DICE | 81.92 | 98.80 | 90.00 | 92.40 | 74.00 | 65.01 | 50.54 | 98.53 | 86.04 |
| Dream | AbsPos | 81.85 | 99.20 | 90.67 | 90.80 | 74.00 | 64.98 | 50.28 | 98.54 | 86.34 |
| Llama3 | DICE | 50.56 | 66.00 | 35.33 | 50.40 | 25.33 | 45.64 | 27.59 | 93.00 | 61.16 |
| Llama3 | AbsPos | 43.19 | 37.20 | 18.00 | 48.40 | 18.67 | 30.07 | 36.38 | 82.94 | 48.63 |
| Mistral | DICE | 74.38 | 96.00 | 86.00 | 80.00 | 58.67 | 55.73 | 50.79 | 96.48 | 71.38 |
| Mistral | AbsPos | 73.74 | 96.40 | 85.33 | 76.80 | 57.33 | 55.71 | 50.72 | 96.41 | 71.20 |
Table 9 (원논문): 청크 크기 1024에서의 절대 오프셋 프로브. 합성은 Hit@1(%), 실제는 nDCG@10. 절대 문서 오프셋 보존은 기본 로컬 리셋 위치 방식을 넘어서지 못한다.
Table 9는 6.3절에서 다룬 위치 실험의 전체 수치다. 절대 오프셋이 로컬 리셋을 넘어서지 못한다는 것을 세 백본에서 확인한다. Dream과 Mistral에서는 차이가 미미하지만(각각 -0.07, -0.64), Llama3에서는 50.56에서 43.19로 크게 무너진다. 특히 Llama3의 Passkey 4k 초과가 35.33에서 18.00으로 반토막 나는데, 자기회귀 백본이 긴 절대 위치 범위에서 뒤쪽 파편을 다룰 때 더 취약함을 보여준다. 이 프로브가 던지는 질문은 "DICE의 이득이 청킹 자체에서 오는가, 아니면 특정 위치 리셋에서 오는가"인데, 답은 후자에 무게가 실린다. 문서를 조각내는 것만으로는 부족하고, 각 조각을 자기완결적 로컬 컨텍스트로 인코딩해야 한다는 것이다.
길이별 topk 프로파일(Figure 8, 9, 10). 부록 B.2의 나머지 그림들은 topk 검색 경향을 길이별로 시각화한다.
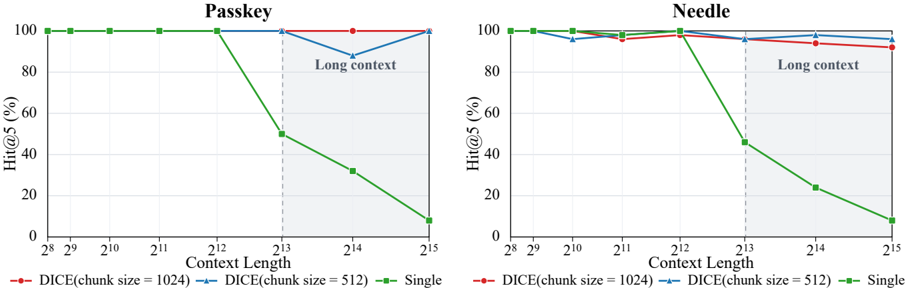
Figure 8 (원논문): 합성 태스크의 길이별 Hit@5(%). DICE의 우위는 더 긴 컨텍스트에 집중된다.
Figure 8은 Passkey(좌)와 Needle(우)의 Hit@5를 길이별로 보여준다. Hit@1(Figure 3)과 마찬가지로 4k 이하에서는 세 방법이 붙어 있다가, "Long context" 영역에서 초록선(Single)만 급락한다. Passkey에서 Single이 에서 6점대로 떨어지는 동안 DICE-1024(빨강)는 100 근처를 유지한다. 흥미로운 건 Passkey에서 DICE-512(파랑)가 부근에서 살짝 꺾이는데, 이는 512 청크가 특정 길이에서 정답 구간을 청크 경계에 걸치게 만들 수 있음을 시사한다.
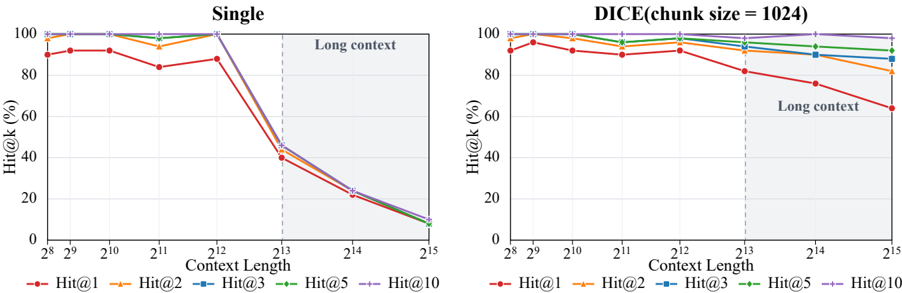
Figure 9 (원논문): 길이별 Needle Hit@k(%). 전체 topk 프로파일이 컨텍스트가 길어져도 DICE가 우위를 유지함을 보여준다.
Figure 9는 Needle에서 Hit@1부터 Hit@10까지 전체 프로파일을 Single(좌)과 DICE-1024(우)로 비교한다. Single 쪽은 을 넘으면 Hit@1부터 Hit@10까지 모든 곡선이 한 덩어리로 붕괴한다. 반면 DICE 쪽은 장문맥 영역에서도 곡선들이 대부분 90 이상에 머물고, 가장 아래 곡선인 Hit@1조차 에서 63점대를 유지한다. topk를 넓힐수록 격차가 더 벌어진다는 건, DICE가 골드 문서를 상위 후보권 안에 안정적으로 붙잡아둔다는 뜻이다.
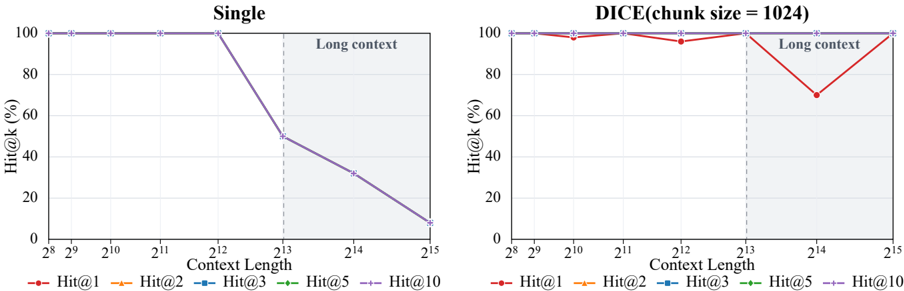
Figure 10 (원논문): 길이별 Passkey Hit@k(%). 여기서 곡선이 겹치는 것은 플로팅 아티팩트가 아니라 실질적 검색 행동을 반영한다.
Figure 10은 Passkey에 대한 같은 분해다. Single(좌)은 를 넘으면 Hit@k 곡선 전체가 하나로 겹쳐 급락한다. 이는 골드 문서를 아예 상위권 밖으로 밀어내 topk를 넓혀도 소용이 없다는 뜻이다. DICE-1024(우)는 대부분의 곡선이 100에 붙어 있고, Hit@1만 부근에서 70점대로 잠깐 내려갔다가 회복한다. 저자들이 캡션에서 "곡선 겹침이 플로팅 아티팩트가 아니다"라고 못 박은 이유가 여기 있다. Passkey는 정답이 완전히 맞거나 완전히 틀리는 이진적 성격이 강해, 일단 골드 문서를 후보권에 넣으면 topk 전반에서 거의 동일하게 잡히기 때문이다.
10. 관련 연구 속 위치
DICE의 좌표를 세 갈래로 짚어볼 수 있다.
Dense retrieval과 단일 벡터 병목. Sentence-BERT(2019)와 DPR(2020)에서 시작해 E5, Contriever, BGE, GTE 같은 대조 학습 임베더를 거쳐, LLM2Vec, NV-Embed, GritLM, 그리고 최근의 확산 기반 임베더(Zhang et al., 2025)에 이르기까지, dense retrieval은 "검색 단위당 벡터 하나"라는 안정적 인터페이스를 유지한 채 인코더를 강화하는 방향으로 발전해왔다. DICE는 이 인코더 중심 흐름에서 벗어난다. 인코더를 동결한 채 추론 시점에 문서 벡터를 계산하는 방법만 바꾼다.
다중 벡터와 late interaction. 단일 벡터 제약을 푸는 병렬 흐름이 있다. passage retrieval은 문서를 청크로 쪼개 독립 검색하는데, 깔끔한 단일 벡터 인터페이스를 하위 합성 복잡도와 맞바꾼다. ColBERT와 ColBERTv2 같은 다중 벡터 late interaction은 토큰 수준 표현을 유지해 세밀한 질의-문서 정렬을 계산하지만, 색인과 스코어링 파이프라인이 복잡해진다. DICE는 "세밀한 표현이 도움이 된다"는 직관은 빌리되, 청크 근거를 하나의 문서 벡터로 다시 통합해 표준 인터페이스를 지킨다.
청크/세그먼트 수준 표현. 가장 가까운 이웃이다. Late chunking(Gunther et al., 2024)은 긴 컨텍스트 순전파로 토큰 임베딩을 문맥화한 뒤 청크 수준 검색을 위해 풀링한다. DICE는 "전역 압축 전에 근거를 잡아야 한다"는 전제는 공유하지만, 단일 문서 벡터를 반환하고 청크를 로컬 위치로 독립 인코딩한다는 점에서 검색 세분성과 인코딩 경로가 다르다. SeDR(Chen et al., 2022)도 세그먼트 수준으로 긴 문서를 모델링하지만 전용 인코더를 학습해야 하는 반면 DICE는 학습이 필요 없다. 최근 Bhat et al.(2025)이 청크 세분성이 passage retrieval 품질에 크게 영향을 준다고 보였는데, DICE의 절제 실험은 이 관찰을 문서 수준 표현으로 확장한다. 통합이 질의와 무관하고 보수적으로 유지될 때 큰 청크의 이점이 지속된다는 것이다.
11. 비판적으로 읽기
강점. 이 논문의 가장 큰 미덕은 정직한 문제 정의와 그것을 재는 자를 함께 제안했다는 점이다. "긴 문서 검색이 안 된다"는 막연한 관찰을 "문서 측 조기 압축"이라는 구체적 실패 모드로 좁히고, EDI라는 표본 단위 진단으로 측정 가능하게 만든 것이 특히 좋다. 성능이 올랐다는 주장에 그치지 않고, 92.8%의 표본에서 EDI가 낮아졌음을 보여 성능 향상과 지목한 메커니즘을 직접 연결한 점은 인과적 서사를 탄탄하게 만든다. 방법 자체도 매력적이다. 학습이 전혀 필요 없고, 저장 벡터는 문서당 하나이며, 질의 경로와 검색 인터페이스가 그대로다. 기존 색인 파이프라인에 그대로 얹을 수 있다는 실용성이 크다. 네 백본, 확산과 자기회귀를 아우르는 검증도 결과의 일반성을 뒷받침한다.
약점. 몇 가지 아쉬운 지점이 있다. 첫째, 비용이다. 문서 측 인코딩이 3~4배로 늘어나는 건 오프라인 색인에서는 감내할 만하지만, 결코 무시할 수 없는 비용이다. DICE가 효율 방법이 아니라 정확도 방법이라는 점을 저자들도 분명히 한다. 둘째, 질의와 무관한 통합이라는 설계가 단일 벡터 인터페이스를 지키는 대가로 질의 관련 청크를 동적으로 강조할 기회를 포기한다. 평균 풀링이 가장 강건하다는 결과는 곧 "더 똑똑한 통합을 아직 못 찾았다"는 뜻이기도 하다. 셋째, 여전히 문서를 벡터 하나로 압축하므로 다중 벡터나 passage 수준 검색에 비해 세밀한 근거를 잃는 근본적 천장이 있다. 넷째, FollowIR에서 드러났듯 최적 청크 크기와 겹침이 벤치마크마다 달라, 새 도메인에서 재튜닝이 필요할 수 있다. 이건 "학습이 필요 없다"는 장점을 부분적으로 상쇄한다.
리뷰어 관점에서 하나 더 덧붙이자면, EC 지표의 정의가 본문에서 다소 압축적으로 서술되어 재현에 약간의 해석이 필요했다. 또 max/topk 통합이 실제 태스크에서 무너지는 현상은 잘 보여줬지만, "평균과 max 사이"의 부드러운 절충(예: 소프트맥스 가중 통합)을 탐색하지 않은 점은 후속 연구의 여지로 남는다. 저자들도 결론에서 "다중 벡터 표현을 단일 벡터로 학습 기반 압축하는 것"을 다음 단계로 언급하는데, 여기가 가장 자연스러운 확장 방향으로 보인다.
12. 마무리
DICE의 메시지는 의외로 단순하다. 긴 문서 검색이 실패하는 주된 이유는 모델이 긴 문맥을 "처리하지 못해서"가 아니라, 결정적 근거가 질의와 비교되기도 전에 문서 벡터 하나로 눌러 담기며 희석되기 때문이라는 것이다. 그렇다면 처방도 단순하다. 압축을 늦춰라. 청크로 쪼개 근거를 먼저 살려두고, 통합은 그다음에 하되 욕심부리지 말고 평균으로 하라.
학습 한 줄 없이, 인코더를 동결한 채, 문서당 벡터 하나라는 인터페이스를 지키면서 4k 초과 슬라이스에서 50~60포인트를 끌어올린 결과는 그 자체로 설득력이 있다. 하지만 이 논문이 더 오래 기억될 이유는 성능 숫자보다 관점의 전환에 있다. 그동안 긴 문서 검색 연구가 인코더를 더 크고 강하게 만들거나(encoder-centric), 검색 단위를 바꾸는(late interaction, passage retrieval) 두 방향에 몰려 있었다면, DICE는 "문서를 어떻게 벡터로 만드느냐"는 인코딩 측 자유도가 아직 충분히 탐색되지 않은 실용적 레버임을 보여준다. EDI라는 측정 도구를 함께 남긴 덕분에, 후속 연구가 이 레버를 더 정교하게 당길 수 있는 발판도 마련됐다. 색인은 한 번, 질의는 여러 번인 실제 검색 시스템에서, 이 3~4배의 색인 비용은 충분히 지불할 만한 값이다.