논문 리뷰
논문 리뷰: Fine-Grained Distillation for Long Document Retrieval
긴 문서는 여러 토픽을 담고 있어 크로스 인코더의 지식을 바이 인코더로 그대로 증류하면 잘 먹히지 않는다. 이 논문은 문서 전체가 아니라 문단, 문장 단위의 세밀한 표현으로 지식을 증류하는 Fine-Grained Distillation(FGD) 프레임워크를 제안해, 추론 효율은 그대로 유지하면서 장문서 검색에서 SOTA를 달성한다.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Fine-Grained Distillation for Long Document Retrieval |
| 저자 | Yucheng Zhou, Tao Shen, Xiubo Geng, Chongyang Tao, Guodong Long, Can Xu, Daxin Jiang (University of Technology Sydney, Microsoft) |
| 학회/저널 | arXiv preprint (2022년 12월) |
| 논문 링크 | arXiv:2212.10423 |
| 키워드 | 장문서 검색, 지식 증류, 밀집 검색, 바이 인코더, 크로스 인코더 |
1. 들어가며
검색 시스템을 만들 때 늘 부딪히는 딜레마가 있다. 정확도를 원하면 크로스 인코더(cross-encoder)를 써야 하고, 속도를 원하면 바이 인코더(bi-encoder)를 써야 한다. 크로스 인코더는 쿼리와 문서를 하나로 이어붙여 트랜스포머에 통째로 넣기 때문에 토큰 단위 상호작용을 정밀하게 포착하지만, 검색 대상이 수백만, 수십억 건이면 매 쿼리마다 모든 문서와의 조합을 다시 계산해야 해서 온라인 서비스에 쓸 수가 없다. 반면 바이 인코더는 쿼리와 문서를 각각 하나의 벡터로 임베딩해두고 내적(dot-product) 한 번으로 유사도를 구하니 문서 임베딩을 미리 계산해둘 수 있어 빠르지만, 단일 벡터라는 정보 병목(information bottleneck) 탓에 크로스 인코더보다 정확도가 한참 떨어진다.
이 간극을 메우는 실전적 해법이 지식 증류(knowledge distillation)다. 크로스 인코더(교사)가 매긴 relevance 점수 분포를 바이 인코더(학생)가 흉내 내도록 학습시키는 것이다. 증류는 학습 단계에만 개입하고 추론 구조는 그대로 두기 때문에, 속도를 전혀 희생하지 않으면서 정확도만 끌어올릴 수 있다. 실제로 패시지(passage) 검색에서는 이 기법이 잘 통해서 1% 이상의 성능 향상을 어렵지 않게 얻는다.
문제는 긴 문서다. 저자들의 파일럿 실험에서 브루트포스 증류(brute-force distillation)를 장문서 검색에 그대로 적용했더니, 아무리 튜닝해도 겨우 0.1% 향상에 그쳤다. 패시지에서 얻던 1% 이상과 비교하면 사실상 효과가 없는 셈이다. 왜 이런 일이 벌어질까? 이 논문은 그 원인을 "granularity mismatch(granularity 불일치)"로 진단하고, 문서 레벨이 아니라 세밀한(fine-grained) 단위에서 증류하는 FGD 프레임워크로 이를 해결한다. 결과부터 말하면 MS-MARCO 문서 검색에서 이전 SOTA인 COSTA의 MRR@100 0.422를 0.440까지 끌어올리며, 멀티 벡터 앙상블까지 더하면 0.444에 도달한다.
2. 문제 정의: scope hypothesis와 granularity mismatch
이 논문을 관통하는 개념이 scope hypothesis다. Robertson과 Zaragoza(2009)가 정리한 이 가설은 "긴 문서 하나는 여러 개의 토픽을 담을 수 있다"는 관찰이다. 짧은 문장이나 패시지는 대개 하나의 토픽에 집중하지만, 수천 단어짜리 문서는 그렇지 않다. 논문에서 패시지 하나가 평균 65단어인 데 반해 장문서는 수천 단어에 이른다는 대비를 든다. Figure 1이 이 상황을 아주 직관적으로 보여준다.
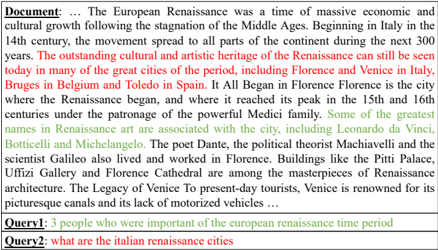
Figure 1 (원논문): 하나의 긴 문서에서 서로 다른 쿼리가 서로 다른 부분을 필요로 하는 scope hypothesis의 사례.
Figure 1의 문서는 유럽 르네상스를 다루는데, 두 개의 쿼리가 서로 완전히 다른 부분을 요구한다. Query1("르네상스 시대에 중요했던 세 사람")은 문서 후반부에 나오는 다빈치, 보티첼리, 미켈란젤로가 언급된 문장(빨간 하이라이트)이 정답이고, Query2("이탈리아 르네상스 도시들")는 피렌체와 베네치아가 언급된 앞부분(노란 하이라이트)이 정답이다. 여기서 핵심은 쿼리에 따라 문서 안에서 relevant한 스팬(span)이 완전히 달라진다는 점이다.
이 관찰이 왜 증류를 어렵게 만드는가를 뜯어보면 이렇다. 크로스 인코더는 쿼리와 문서를 함께 self-attention에 넣기 때문에, 쿼리에 따라 문서의 어느 부분에 집중할지를 동적으로 결정한다. Query1이 들어오면 다빈치 문장에, Query2가 들어오면 피렌체 문장에 attention을 준다. 즉 크로스 인코더의 점수는 "쿼리 의존적(query-dependent)"이고 salience가 명시적으로 모델링된다. 반면 바이 인코더는 문서를 쿼리와 무관하게 미리 하나의 벡터로 압축해버린다. 문서 표현이 "쿼리 비의존적(query-agnostic)"인 것이다. 쿼리가 뭐가 됐든 르네상스 문서는 항상 같은 벡터로 표현된다.
그러니 크로스 인코더가 "이 문서는 Query1에 대해 0.9, Query2에 대해 0.3"이라는 세밀한 판단을 내려도, 바이 인코더는 쿼리마다 달라지는 이 신호를 하나의 고정된 문서 벡터로는 재현할 수가 없다. 교사와 학생이 바라보는 granularity 자체가 어긋나 있는 것이다. 저자들이 말하는 granularity mismatch가 바로 이것이고, 문서가 길어질수록(=토픽이 많아질수록) 이 불일치는 심해진다. 브루트포스 증류가 장문서에서 0.1%밖에 못 올린 근본 원인이 여기에 있다.
3. 기존 연구의 한계
이 논문의 포지셔닝을 이해하려면 세 갈래의 선행 연구를 봐야 한다.
증류 기반 검색기 학습. 밀집 검색(dense retrieval)에서 크로스 인코더 리랭커를 교사로 삼아 바이 인코더에 증류하는 흐름은 RocketQAv2(Ren et al., 2021), AR2(Zhang et al., 2022) 등으로 활발히 연구되어 왔다. 흥미로운 점은 검색에서의 증류가 모델 압축이 목적이 아니라는 것이다. Menon et al.(2022)은 바이 인코더가 학습셋에 과적합되는 경향이 있고, 크로스 인코더로부터의 증류가 이 과적합을 완화한다는 것을 실증했다. 하지만 이 연구들은 하나같이 패시지 검색기 개선에만 관심을 뒀지, 장문서에서의 granularity 문제는 건드리지 않았다.
멀티 granularity 표현 학습. 장문서의 정보 병목을 깨려는 시도들이 있었다. 가장 단순한 방법은 서로 다른 granularity(문단, 문장)의 토큰 임베딩에 평균 풀링(mean-pooling)을 적용하는 것인데(Liu et al., 2022c), 저자들의 파일럿 실험에서는 문서 길이가 극단적으로 길어지면 이 방식이 효과를 잃었다. Zheng et al.(2020)처럼 문서, 문단, 문장을 노드로 하는 그래프를 만들고 relational graph attention network(RGAT)로 표현을 갱신하는 정교한 접근도 있지만, 이들은 granularity를 가로지르는 일관된(global-consistent) 표현을 만들어내지 못한다는 한계가 있다. 이 대목이 이 논문의 방법론적 출발점이 된다.
멀티 granularity 증류. Liu et al.(2022a)은 여러 granularity의 언어 단위 정보를 활용하는 멀티 granularity 지식 증류를 제안했지만, 이는 교사와 학생이 같은 구조여야 한다는 전제를 깔고 있어 서로 다른 아키텍처(크로스 인코더 → 바이 인코더) 사이의 지식 전이에는 쓸 수 없다. 저자들은 여기서 영감을 받아, 아키텍처를 가로지르는 local-aligned score distilling을 설계했다고 밝힌다.
정리하면 FGD는 이 세 갈래가 각각 놓친 지점 - 장문서에서의 증류, granularity 일관성, 이종 아키텍처 간 세밀한 증류 - 을 한꺼번에 겨냥한다.
4. 제안 방법: Fine-Grained Distillation (FGD)
FGD의 전체 구조는 Figure 2에 압축되어 있다.
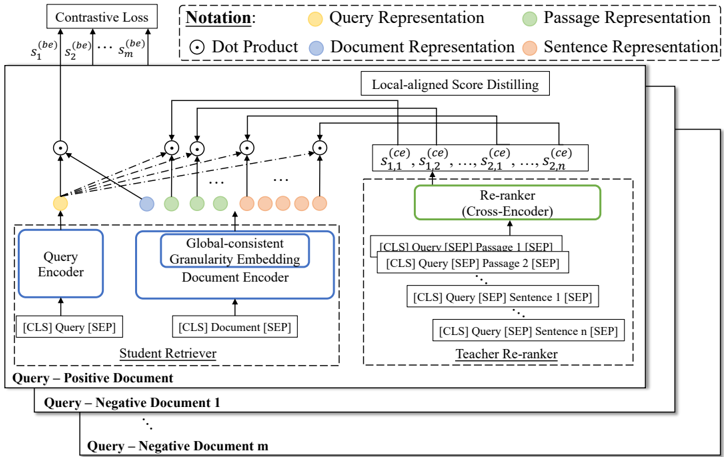
Figure 2 (원논문): 장문서 검색을 위한 fine-grained distillation(FGD)의 전체 개요. 왼쪽 학생 검색기(Student Retriever)와 오른쪽 교사 리랭커(Teacher Re-ranker)가 local-aligned score distilling으로 연결된다.
Figure 2의 구조를 왼쪽부터 읽으면 이렇다. 학생 검색기(Student Retriever)는 쿼리 인코더와 문서 인코더로 구성된 통상의 바이 인코더인데, 문서 인코더에 "Global-consistent Granularity Embedding"이 붙어 있다는 점이 다르다. 이 모듈이 문서를 문서 벡터(파란색), 문단 벡터(초록색), 문장 벡터(주황색)로 각각 뽑아낸다. 쿼리 벡터(노란색)와 이 여러 granularity 벡터들의 내적으로 같은 바이 인코더 점수들이 나온다. 오른쪽 교사 리랭커(Teacher Re-ranker)는 크로스 인코더로, [CLS] Query [SEP] Passage_1 [SEP], [CLS] Query [SEP] Sentence_1 [SEP]처럼 쿼리와 각 세밀 단위를 이어붙여 넣고 점수를 낸다. 그리고 이 두 점수 분포를 granularity별로 정렬해서 맞추는 것이 "Local-aligned Score Distilling"이다. 맨 아래를 보면 이 전체 과정이 Query-Positive Document뿐 아니라 Query-Negative Document 1, ..., m에 대해서도 반복된다는 것을 알 수 있다.
핵심은 이 모든 멀티 벡터 연산이 학습 단계에서만 일어난다는 점이다. 추론 시에는 여전히 문서당 단일 벡터 하나로 검색하므로, 기존 밀집 검색 패러다임과 효율이 완전히 동일하다. 멀티 granularity 표현은 증류를 위한 중간 매개물(intermediate)로만 쓰이고 버려진다. 이 설계가 FGD를 실전에 바로 쓸 수 있게 만드는 지점이다.
이제 네 개의 구성요소를 차례로 뜯어본다.
4.1 증류가 있는 바이 인코더 학습 (Bi-encoder Learning with Distillation)
먼저 베이스라인이 되는 통상의 증류 학습을 수식으로 정리한다. 바이 인코더의 relevance 점수는 쿼리와 문서를 각각 인코딩한 벡터의 내적이다.
여기서 는 파라미터 없는 내적, 는 텍스트를 밀집 벡터로 임베딩하는 인코더다. 가 바이 인코더 전체를 파라미터화하며, 쿼리 인코더와 문서 인코더는 파라미터를 공유할 수도 있다.
정답 문서 하나와 채굴된 negative 집합 이 주어지면, 이들 위에서 소프트맥스로 점수 분포를 만든다.
는 temperature로 1로 설정한다. 대조 학습(contrastive learning)의 손실은 정답 문서에 대한 음의 로그 우도다.
교사인 크로스 인코더는 쿼리와 문서를 이어붙여 트랜스포머에 넣고 MLP로 스칼라 점수를 뽑는 분류기 형태다.
이 점수로 크로스 인코더의 분포 도 위 소프트맥스로 구할 수 있다. 저자들은 크로스 인코더 를 미리 잘 학습된 상태로 고정해서 쓴다(바이 인코더와 함께 업데이트하는 방식도 가능하지만 전자를 택함). 증류 손실은 두 분포 사이의 KL 발산이다.
그래서 통상의 증류 바이 인코더 학습 손실은 가 된다. 여기까지가 기존 방법이고, FGD는 이 를 세밀한 버전으로 갈아끼운다.
4.2 Global-consistent Granularity Embedding
문서 전체가 아니라 문단, 문장 단위로 증류하려면 먼저 각 granularity의 임베딩을 뽑아야 한다. 그런데 여기에 함정이 있다. 앞서 말했듯 단순 평균 풀링은 문서가 길어지면 무너지고, GNN 기반 embedding propagation은 파라미터가 늘어난다. 게다가 대부분의 문서 검색 연구가 [CLS] 임베딩 패러다임에 의존하는데, 평균 풀링으로 뽑은 세밀 표현은 이 [CLS] 표현과 일관성이 없다.
저자들의 통찰은 [CLS] 임베딩 자체를 self-attention 풀링으로 재해석하는 데 있다. "[CLS] 임베딩으로 시퀀스 전체를 표현한다"는 것은, 마지막 레이어의 attention 모듈에서 [CLS]가 각 토큰에 준 attention 확률로 가중 평균을 내는 것과 동등하다.
는 문서 안의 토큰 인덱스, 는 이전 레이어에서 토큰 의 은닉 상태, 는 [CLS]가 토큰 에 준 attention 확률(비선형 함수 , 보통 softmax로 계산), FFN은 트랜스포머의 MLP와 residual connection을 포함하는 후처리다. 즉 문서 벡터는 마지막 레이어 attention 점수를 가중치로 삼은 토큰 표현들의 합인 셈이다.
여기서 한 발 더 나간다. 이미 계산되어 있는(off-the-shelf) 이 attention 점수를 재활용하면, 문서 전체가 아니라 임의의 스팬 에 대해서도 같은 방식으로 표현을 만들 수 있다. 스팬 의 토큰 인덱스가 라면, 그 범위 안에서 attention 점수를 정규화해 가중 합을 낸다.
이렇게 하면 문단이든 문장이든 원하는 granularity의 표현을 손쉽게 뽑을 수 있다. 이 방법이 "global-consistent"인 이유는, 모든 granularity 표현이 동일한 [CLS] attention 분포에서 파생되기 때문이다. 문서 벡터와 문장 벡터가 같은 전역(global) attention 좌표계를 공유하므로 서로 일관된 표현이 된다. 저자들이 강조하는 차별점은 이것이다. GNN이나 평균 풀링 기반 선행 연구들은 세밀 표현 그 자체를 최종 응용(QA 등)에 쓰려 했지만, FGD는 문서 레벨 단일 병목을 그대로 유지하면서 세밀 표현을 증류의 중간 매개물로만 활용한다. 그래서 복잡한 embedding propagation 없이도 문서 레벨과 세밀 표현 사이의 일관성을 확보한다.
4.3 Local-aligned Score Distilling
세밀 표현을 얻었으니 이제 이것으로 증류한다. 여러 granularity의 텍스트 조각들을 다음처럼 표기한다.
는 granularity 인덱스, 은 granularity 총 개수, 는 번째 granularity 안에서 조각의 인덱스, 는 번째 granularity의 조각 총 개수다. 은 문서 레벨이라 이고 이 된다. 이 논문의 실험에서는 문서, 문단, 문장의 세 granularity를 쓴다.
Eq (1)을 세밀 조각용으로 다시 쓰면 각 granularity 조각의 점수가 나온다.
그리고 granularity별 점수 분포는 다음과 같다.
는 번째 granularity에서의 negative 집합인데, 이걸 어떻게 뽑는지는 다음 절의 주제다. 교사인 크로스 인코더도 같은 세밀 조각에 대해 점수를 낸다. 여기서 중요한 차이가 있다. 크로스 인코더가 조각 에 매기는 점수는 오직 그 조각에만 근거하며 문서의 나머지 부분과 무관하다.
이건 의도된 설계다. 학생 바이 인코더는 문서 레벨 병목 학습에 정렬시키려고 global-consistent 세밀 표현을 쓰는 반면, 교사 크로스 인코더는 쿼리와 조각의 관계를 정확히 기술하는 정밀한 relevance 점수를 제공하는 역할이다. 교사의 분포 도 마찬가지로 구한다. 최종적으로 멀티 granularity 정렬 증류 손실은 다음과 같다.
주목할 대목은 합산에서 (문서 레벨)을 뺀다는 점이다. 문서 레벨 relevance는 대조 학습으로만 배우고, 증류는 문단과 문장 레벨에서만 한다. 이 로 §4.1의 를 대체하면 FGD의 최종 손실이 완성된다.
오버헤드는 얼마나 늘어날까. 무거운 크로스 인코더로 이렇게 광범위하게 증류하면 학습 비용이 폭증하지 않을까 하는 걱정이 자연스럽다. 저자들의 분석은 이렇다. 학생 바이 인코더 쪽은 이미 계산된 attention 점수로 attention 풀링을 몇 번 더 하는 정도라 추가 비용이 거의 없다. 교사 크로스 인코더 쪽은 비용이 시퀀스 길이에 대해 제곱으로() 늘어나는데, 세밀 단위(문단, 문장)에 적용하면 복잡도가 수준이다. 따라서 크로스 인코더 호출로 인한 전체 복잡도는 여전히 에 머문다. 게다가 이 모든 건 학습 시에만이고, 추론 시에는 문서당 단일 병목 벡터 하나만 쓴다. ColBERT류의 멀티 벡터 저장(Santhanam et al., 2021)과는 다르다는 점을 저자들이 재차 강조한다.
4.4 Hierarchical Hard Negative Mining
증류 손실 Eq (10)을 보면 각 granularity마다 negative 조각 가 필요하다. 그런데 문제가 하나 있다. 문서 레벨()에서는 정답 문서 를 알지만, 문단이나 문장 레벨에서는 정확한 정답 조각 을 알 수 없다. 어느 문장이 쿼리의 정답인지 라벨이 없기 때문이다.
저자들은 약지도(weakly-supervised) 방식으로 이를 우회한다. 정답 문서 안의 모든 조각 를 그냥 positive 조각으로 간주하는 것이다. 그리고 negative는 위에서 아래로 계층적으로(hierarchical) 채굴한다. 즉 번째 granularity의 negative는 번째 granularity의 negative 안에서 뽑는다.
는 번째 granularity의 모든 negative를 뜻하고, 최상위 은 정답 문서를 뺀 전체 컬렉션이다. 직관적으로 보면, 먼저 best-so-far 검색기로 문서 레벨 하드 negative를 뽑고, 그 negative 문서들 안에서 문단 하드 negative를 뽑고, 다시 그 문단들 안에서 문장 하드 negative를 뽑는 하향식 구조다. granularity를 관통하는 일관된 하드 negative를 만든다는 점에서, 앞의 global-consistent 표현과 철학이 맞닿아 있다.
5. 학습 파이프라인
FGD를 실제로 돌리는 전체 파이프라인은 Figure 3의 흐름도로 정리된다.
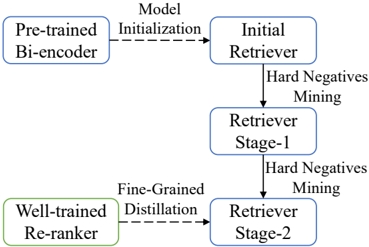
Figure 3 (원논문): 사전학습된 바이 인코더에서 시작해 두 단계의 파인튜닝을 거치는 FGD 학습 파이프라인.
Figure 3을 왼쪽에서 오른쪽으로 따라가면, 사전학습된 바이 인코더(Pre-trained Bi-encoder)로 초기 검색기(Initial Retriever)를 초기화하고, 하드 negative 채굴 → Stage-1 검색기 → 다시 하드 negative 채굴 → Stage-2 검색기로 이어진다. 그리고 잘 학습된 리랭커(Well-trained Re-ranker)가 Stage-2에만 Fine-Grained Distillation을 공급한다. 단계별로 정리하면 이렇다.
Stage-0: 사전학습(Pre-training). 모델을 자기지도 사전학습으로 초기화한다. 두 종류로 나뉘는데, 하나는 일반 코퍼스에서 언어 모델링으로 학습한 PLM(예: RoBERTa)이고, 다른 하나는 그 위에 검색 컬렉션에 대해 추가 사전학습을 얹은 corpus-aware 사전학습(예: coCondenser, SimLM의 ED-MLM)이다. 저자들은 두 종류 모두에서 프레임워크를 테스트한다. 여기에 더해 선행 연구 관행을 따라 패시지 검색에 대한 지도 사전학습도 기본으로 수행한다.
Stage-1: 워밍업 파인튜닝(Warmup Fine-tuning). 사전학습 검색기로 문서 레벨 하드 negative를 채굴하고, 대조 학습 손실 만으로 검색기를 문서 검색에 워밍업한다. 이 단계에서는 아직 증류를 쓰지 않는다.
Stage-2: 연속 파인튜닝(Continual Fine-tuning). 워밍업된 검색기로 더 도전적인 하드 negative를 다시 채굴하고, 여기서 비로소 FGD 손실 Eq (13)을 적용한다. 선행 연구들이 이 단계에서 대조 학습만 쓰는 것과 대비되는 지점이다.
구현 세부. 백본은 RoBERTa-base이고, 그 위에 ED-MLM(SimLM) 목적함수로 corpus-aware 사전학습을 얹는다. MS-MARCO 컬렉션에 대해 길이 384, stride 64의 슬라이딩 윈도우를 만들어 학습률 , 배치 2048, 3 에폭으로 A100 8장에서 약 20시간이 걸린다. 파인튜닝은 Adam, 학습률 , 1000 스텝 선형 워밍업을 쓰고, Stage-1은 2 에폭, Stage-2는 20 에폭이다. 최대 문서 길이 512, 최대 쿼리 길이 32, weight decay 0.01이며, 문서에서 연속된 64토큰과 128토큰 조각을 잘라 각각 문장과 문단으로 삼는다. 증류에 쓰는 리랭커는 R2ANKER(Zhou et al., 2022)이고, 배치 64에 positive 1개, negative 8개, negative 채굴 깊이는 100이다. 랜덤 시드는 42로 고정한다.
6. 실험 결과
6.1 데이터셋과 평가 지표
평가는 두 데이터셋에서 이뤄진다. MS-MARCO 문서 검색은 320만 문서, 36.7만 학습 쿼리, 5천 개발 쿼리로 구성된 널리 쓰이는 벤치마크로, MRR@100과 Recall@100(R@100)으로 개발셋을 평가한다. TREC 2019 Deep Learning 문서 검색은 MS-MARCO 문서 랭킹 태스크의 테스트셋으로, 43개 쿼리에 더 촘촘한 라벨링이 되어 있고 nDCG@10과 R@100으로 평가한다.
6.2 메인 결과
MS-MARCO와 TREC 2019에서 강력한 경쟁자들과 비교한 결과다.
| Method | MS-MARCO MRR@100 | MS-MARCO R@100 | TREC 2019 nDCG@10 | TREC 2019 R@100 |
|---|---|---|---|---|
| Sparse / lexicon retriever | ||||
| BM25 | 0.277 | 0.808 | 0.519 | 0.395 |
| DeepCT (Dai and Callan, 2019) | 0.320 | - | 0.544 | - |
| BestTRECTrad (Craswell et al., 2020) | - | - | 0.549 | - |
| Dense retriever | ||||
| ANCE (Xiong et al., 2021) | 0.377 | 0.894 | 0.610 | 0.273 |
| BERT (Ma et al., 2022) | 0.389 | 0.877 | 0.594 | 0.301 |
| STAR (Zhan et al., 2021b) | 0.390 | 0.913 | 0.605 | 0.313 |
| ICT (Lee et al., 2019) | 0.396 | 0.882 | 0.605 | 0.303 |
| PROP (Ma et al., 2021) | 0.394 | 0.884 | 0.596 | 0.298 |
| B-PROP (Ma et al., 2021) | 0.395 | 0.883 | 0.601 | 0.305 |
| SEED (Lu et al., 2021) | 0.396 | 0.902 | 0.605 | 0.307 |
| RepCONC (Zhan et al., 2022) | 0.399 | 0.911 | 0.600 | 0.305 |
| JPQ (Zhan et al., 2021a) | 0.401 | 0.914 | 0.623 | - |
| ADORE+STAR (Zhan et al., 2021b) | 0.405 | 0.919 | 0.628 | 0.317 |
| SeDR (Chen et al., 2022) | 0.409 | 0.921 | 0.632 | 0.343 |
| COSTA (Ma et al., 2022) | 0.422 | 0.919 | 0.626 | 0.320 |
| FGD (ours) | 0.440 | 0.925 | 0.635 | 0.349 |
Table 1 (원논문): MS-MARCO와 TREC 2019 데이터셋에서의 비교 결과.
Table 1에서 먼저 눈에 띄는 건 sparse/lexicon 검색기(BM25, DeepCT)가 dense 검색기 전반에 크게 뒤진다는 점이다. BM25의 MRR@100이 0.277인데 가장 약한 dense 모델 ANCE도 0.377이니 무려 0.1의 격차다. dense 검색기가 단어 매칭을 넘어 쿼리와 문서 사이의 의미적 relevance를 잡아내기 때문이다.
FGD는 MS-MARCO MRR@100에서 0.440으로, 직전 SOTA인 COSTA(0.422)를 0.018 앞선다. 얼핏 작아 보이지만 이 벤치마크에서 0.409(SeDR) → 0.422(COSTA)가 당대의 진전이었던 걸 감안하면, 0.422 → 0.440은 그보다 큰 폭의 개선이다. R@100도 0.925로 최고치다. TREC 2019에서도 nDCG@10 0.635, R@100 0.349로 두 지표 모두 SOTA를 기록해, 촘촘하게 라벨링된 테스트셋에서도 FGD의 우위가 유지됨을 보여준다. 특히 TREC R@100에서 SeDR(0.343)과 COSTA(0.320)를 앞서는데, 이는 FGD가 상위 랭킹뿐 아니라 재현율(recall) 측면에서도 강하다는 신호다.
6.3 Ablation Study
각 구성요소의 기여를 뜯어본 결과다. 여기서 'FG'는 fine-grained, 'w/o ALL'은 Stage-2에서 아무것도 안 한 ED-MLM 베이스라인과 같다.
| Method | MS-MARCO MRR@100 | MS-MARCO R@100 |
|---|---|---|
| FGD (stg2) | 0.440 | 0.925 |
| FGD w/o pass-distill | 0.435 | 0.924 |
| FGD w/o sent-distill | 0.435 | 0.925 |
| FGD w/ doc-distill | 0.436 | 0.924 |
| FGD w/ FG pooling | 0.426 | 0.924 |
| only doc-distill | 0.428 | 0.923 |
| w/o ALL | 0.427 | 0.923 |
Table 2 (원논문): Ablation study. 'FG'는 fine-grained, 'w/o ALL'은 Stage-2의 ED-MLM과 동일.
Table 2를 읽는 순서가 중요하다. 맨 아래 두 줄이 출발점이다. 아무 증류도 안 한 w/o ALL이 0.427이고, 문서 레벨 증류만 한 only doc-distill이 0.428이다. 둘 사이 차이가 0.001에 불과한데, 이게 바로 도입부에서 말한 "브루트포스 증류가 장문서에서 0.1%밖에 못 올린다"는 주장의 실증이다. 문서 레벨 증류는 사실상 무용지물인 셈이다.
반면 세밀 증류를 넣으면 0.427에서 0.440으로 뛴다. 문단 증류를 빼면(w/o pass-distill) 0.435, 문장 증류를 빼면(w/o sent-distill) 0.435로 각각 0.005씩 떨어지니, 두 granularity가 모두 기여하고 있음을 알 수 있다. 흥미로운 건 FGD w/ doc-distill(0.436)이다. FGD에 문서 레벨 증류를 다시 더했더니 오히려 0.440에서 0.436으로 성능이 떨어졌다. 문서 레벨 증류와 세밀 증류가 서로 잘 호환되지 않는다는 뜻인데, 이는 §4.3에서 손실 합산에 을 일부러 뺀 설계 결정을 정당화한다. 문서 레벨의 query-agnostic 신호를 억지로 증류하면 세밀 증류의 이점을 오히려 갉아먹는 것이다.
마지막으로 FGD w/ FG pooling(0.426)이 눈에 띄게 낮다. global-consistent granularity embedding을 평범한 평균 풀링으로 바꿨더니 성능이 0.440에서 0.426으로 크게 떨어졌다. 세밀 표현을 어떻게 뽑느냐가 방법 전체의 성패를 가르며, attention 기반 global-consistent 임베딩이 이 프레임워크의 실질적 엔진임을 확인해준다.
6.4 검색기와 리랭커 교체 실험
FGD가 특정 모델 조합에만 통하는 건 아닌지, 교사와 학생을 갈아끼워 일반성을 검증한다.
| Method | MS-MARCO MRR@100 | MS-MARCO R@100 |
|---|---|---|
| FGD (ED-MLM + psg-ranker) | 0.440 | 0.925 |
| 학생(바이 인코더) 교체 | ||
| STAR (stg2) | 0.417 | 0.914 |
| FGD (STAR as student) | 0.430 | 0.915 |
| 교사(크로스 인코더) 교체 | ||
| ED-MLM (stg2) | 0.427 | 0.923 |
| FGD (doc-ranker as teacher) | 0.438 | 0.923 |
Table 3 (원논문): 서로 다른 바이 인코더와 크로스 인코더 조합에서의 결과.
Table 3의 메시지는 명확하다. 학생을 STAR로 바꿔도 FGD는 0.417 → 0.430으로 0.013을 끌어올리고, 교사를 문서 랭커(doc-ranker)로 바꿔도 ED-MLM 베이스라인 0.427 → 0.438로 0.011을 올린다. 어떤 조합이든 FGD를 얹으면 일관되게 개선된다는 것이다.
한 가지 관찰할 지점은 FGD (STAR as student)(0.430)가 기본 FGD (ED-MLM + psg-ranker)(0.440)보다 낮다는 것이다. 저자들은 그 이유를 STAR가 일반 사전학습 인코더인 RoBERTa에서 출발한 반면, ED-MLM은 MS-MARCO에 특화된 corpus-aware 사전학습 인코더이기 때문이라고 설명한다. 즉 FGD의 효과 위에 백본 사전학습 품질이 그대로 얹혀서 최종 성능을 결정하는 구조다. FGD는 어느 백본에서든 향상을 주지만, 더 좋은 백본에서 더 높은 절대 성능에 도달한다.
6.5 Fine-Grained Distillation의 효과 분석
FGD가 실제로 무엇을 더 잘하게 만드는지를 예측 분포로 들여다본 것이 Figure 4다.
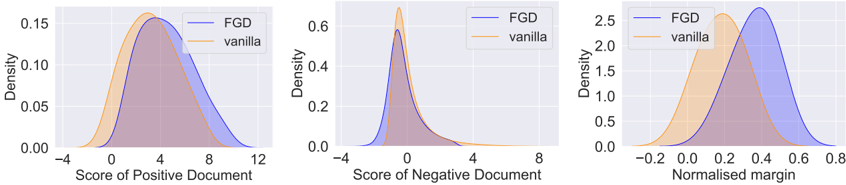
Figure 4 (원논문): MS-MARCO 테스트셋에서 FGD(왼쪽)와 vanilla 문서 레벨 증류(가운데)의 예측 분포, 그리고 두 방법의 정규화된 마진(오른쪽) 비교.
Figure 4는 세 개의 밀도 그래프로 이뤄진다. 왼쪽은 positive 문서에 매긴 점수 분포, 가운데는 negative 문서에 매긴 점수 분포, 오른쪽은 정규화된 마진(normalised margin) 분포이며, 각각 FGD(파란색)와 vanilla(주황색)를 겹쳐놨다.
왼쪽 그래프에서 FGD의 positive 점수 분포는 vanilla보다 오른쪽으로 밀려 있다. 정답 문서에 더 높은 점수를 준다는 뜻이다. 반대로 가운데 negative 그래프에서는 두 분포가 비슷하되 FGD가 살짝 더 낮은 쪽에 무게가 실린다. positive는 더 높게, negative는 더 낮게 - 즉 FGD가 정답과 오답을 더 크게 벌려놓는다.
이 차이를 정량화한 것이 오른쪽 마진 그래프다. 저자들은 정규화된 마진을 로 정의하는데(는 최대 점수 범위), FGD의 마진 분포가 vanilla보다 뚜렷하게 오른쪽에 위치한다. vanilla의 봉우리가 0.2 근처인 데 반해 FGD는 0.4 근처에서 정점을 찍는다. positive와 negative 사이의 판별 마진이 두 배 가까이 크다는 것으로, FGD가 더 discriminative한 검색기를 만든다는 정량적 증거다. 왜 세밀 증류가 메인 결과에서 이겼는지를 이 마진 확대가 설명해준다.
7. 멀티 벡터 검색과 fine-grained 표현 방식 비교
7.1 멀티 벡터 검색 (Multi-Vector Retrieval)
FGD는 문서, 문단, 문장의 멀티 granularity 표현을 만들 수 있으므로, 이걸 추론 시에 앙상블로 활용해볼 수 있다. 앙상블 하이퍼파라미터 로 쿼리-문서, 쿼리-문단, 쿼리-문장 relevance를 통합한다.
는 쿼리-문서 relevance이고, 와 는 문서 안 문단들과 문장들에 대한 최대 relevance다. 즉 문서 점수에다가, 그 문서에서 쿼리와 가장 잘 맞는 문단과 문장의 점수를 가중치로 더한다. 를 바꿔가며 성능 변화를 본 것이 Figure 5다.
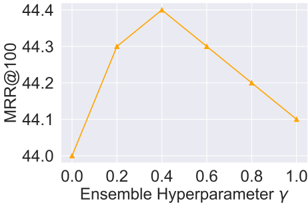
Figure 5 (원논문): 멀티 벡터 검색에서 앙상블 하이퍼파라미터 의 변화에 따른 MRR@100.
Figure 5는 를 0에서 1까지 바꿨을 때 MRR@100의 변화를 보여준다. (만 사용)에서 44.0으로 시작해 에서 44.4로 정점을 찍고, 그 뒤로는 완만히 하락한다. 볼록한 형태의 곡선이라는 게 시사하는 바가 있다. 세밀 신호를 적당히 섞으면 도움이 되지만, 지나치게 의존하면(가 커지면) 문서 레벨 신호를 오히려 밀어내 성능이 떨어진다. 문서, 문단, 문장 세 레벨의 균형이 최적점을 만드는 것이다.
이 최적 지점의 결과를 정리하면 다음과 같다.
| Method | MS-MARCO MRR@100 | MS-MARCO R@100 |
|---|---|---|
| Previous SoTA | 0.422 | 0.919 |
| FGD | 0.440 | 0.925 |
| FGD + multi | 0.444 | 0.926 |
Table 4 (원논문): 멀티 벡터('multi') 검색으로 FGD를 부스팅한 결과.
Table 4에서 멀티 벡터 앙상블은 FGD를 0.440에서 0.444로 0.004 더 올린다. 다만 이건 어디까지나 추가 옵션이라는 점을 짚어야 한다. 멀티 벡터 검색은 추론 시 문단과 문장 벡터를 모두 저장하고 계산해야 하므로 §4.3에서 강조한 "단일 벡터 효율"이라는 FGD의 장점을 일부 포기한다. 즉 효율을 유지하고 싶으면 순수 FGD(0.440), 효율을 조금 양보하고 최고 성능을 원하면 FGD+multi(0.444)를 택하는 트레이드오프다.
7.2 Fine-Grained 표현 방식 비교
세밀 표현을 만드는 방식으로 global-consistent 외에 두 가지 대안을 비교한다. FG pooling은 문장/문단에 해당하는 토큰 표현을 평균 풀링으로 합치는 방식이고, RGAT는 FG pooling으로 뽑은 문장, 문단, 문서 표현을 노드로, 그들의 관계를 엣지로 하는 그래프를 만들어 relational graph attention network로 표현을 갱신하는 방식이다.
| Method | MS-MARCO MRR@100 | MS-MARCO R@100 |
|---|---|---|
| FGD (global-consistent) | 0.440 | 0.925 |
| FGD w/ RGAT | 0.441 | 0.925 |
| FGD w/ FG pooling | 0.426 | 0.924 |
Table 5 (원논문): 세밀 표현을 도출하는 서로 다른 방식들의 MS-MARCO 개발셋 비교.
Table 5의 결론은 명쾌하면서도 실용적이다. FG pooling은 0.426으로 아무 이득이 없다(오히려 global-consistent 대비 크게 낮다). RGAT는 0.441로 global-consistent(0.440)와 사실상 동급이지만, 그래프 신경망을 얹느라 모델 파라미터를 추가로 도입해야 한다. 즉 RGAT는 더 복잡한 구조로 겨우 동률을 낼 뿐이니, 추가 파라미터 없이 이미 계산된 attention 점수만 재활용하는 global-consistent 방식이 실전에서 명백히 낫다. 방법을 단순하게 유지하면서도 최고 성능에 도달했다는 점에서, §4.2의 설계 선택이 다시 한번 정당화된다.
8. 비판적 관점
강점부터 짚으면, 이 논문의 문제 진단이 아주 날카롭다. "장문서 증류가 왜 안 통하는가"를 scope hypothesis와 granularity mismatch로 명료하게 규정하고, 그 진단이 곧바로 해법(세밀 증류)으로 이어지는 논리 전개가 깔끔하다. 특히 global-consistent granularity embedding은 [CLS] 임베딩을 self-attention 풀링으로 재해석한 뒤 이미 있는 attention 점수를 스팬에 재활용한다는, 우아하면서도 비용이 거의 안 드는 아이디어다. Table 5에서 RGAT라는 훨씬 무거운 대안과 동률을 내면서 파라미터는 하나도 안 늘렸다는 게 이 설계의 가치를 잘 보여준다. 추론 효율을 전혀 건드리지 않고 학습만 손본다는 점도 실전 배포 관점에서 매력적이다.
아쉬운 부분도 있다. 첫째, 성능 향상의 절대폭이 크지는 않다. MRR@100 기준 0.422 → 0.440이고, 멀티 벡터까지 동원해야 0.444다. 방법론의 정교함에 비하면 개선폭이 다소 소박하게 느껴진다. 물론 성숙한 벤치마크에서의 SOTA 경신이라는 맥락을 감안해야 하지만, 여러 단계의 사전학습과 파인튜닝, 계층적 negative 채굴까지 더한 복잡도 대비 얻는 이득을 실무자가 어떻게 볼지는 별개 문제다.
둘째, 계산 오버헤드에 대한 논증이 다소 낙관적이다. 저자들은 학생 쪽 추가 비용이 "거의 없다"고 하지만, 크로스 인코더를 문단과 문장 각각에 대해 positive/negative별로 여러 번 호출해야 하는 교사 쪽 비용은 실제로 만만치 않을 수 있다. 로 복잡도 order는 유지된다는 논증은 맞지만, 상수 배수(constant factor) 관점에서 학습 시간이 얼마나 늘어나는지에 대한 구체적 수치가 제시되지 않았다. 실제 학습 시간 비교 테이블이 있었다면 설득력이 더 컸을 것이다.
셋째, 문단과 문장을 "64토큰, 128토큰의 연속 조각"으로 기계적으로 자른다는 점이다. Figure 1이 보여준 것처럼 진짜 문제는 의미 단위(토픽)의 분리인데, 고정 길이로 자르면 하나의 토픽이 여러 조각에 걸치거나 한 조각에 여러 토픽이 섞일 수 있다. 의미 기반 분할이나 실제 문장 경계를 썼을 때 어떻게 달라지는지에 대한 분석이 없어서, 세밀 단위 정의의 민감도가 궁금하게 남는다.
넷째, 평가가 MS-MARCO와 그 파생인 TREC 2019에 국한된다. 둘 다 결국 MS-MARCO 문서 랭킹 태스크라, 도메인이 다른 장문서(법률, 의학, 학술 논문 등)에서도 같은 이득이 나올지는 검증되지 않았다. scope hypothesis가 더 극단적으로 나타날 초장문서 도메인이야말로 이 방법이 진짜 빛날 곳일 텐데, 그 검증이 빠진 게 개인적으로는 가장 아쉽다.
9. 관련 연구와의 포지셔닝
FGD의 위치를 다른 접근들과 견줘보면 성격이 분명해진다. ColBERT류의 late interaction(Santhanam et al., 2021)이나 poly-encoder(Humeau et al., 2020)는 문서를 여러 벡터로 저장해 세밀한 상호작용을 추론 시에 수행하지만, 그만큼 저장 비용과 검색 지연이 커진다. FGD는 정반대 전략이다. 멀티 벡터는 학습 시 증류의 매개물로만 쓰고 추론 시엔 단일 벡터로 돌아가, 효율을 지키면서 세밀함의 이득만 흡수한다.
증류 계열에서 보면, RocketQAv2나 AR2 같은 선행 연구가 패시지 검색에서의 크로스→바이 증류를 다뤘다면, FGD는 그 아이디어를 장문서로 확장하되 granularity mismatch라는 장문서 특유의 장벽을 정면으로 해결했다는 점에서 구별된다. 멀티 granularity 표현 계열의 Zheng et al.(2020)이 그래프로 세밀 표현을 만들되 global 일관성을 놓쳤다면, FGD는 [CLS] attention을 매개로 일관성을 확보했다. 멀티 granularity 증류의 Liu et al.(2022a)이 동일 구조 교사-학생에 묶여 있었다면, FGD는 크로스 인코더와 바이 인코더라는 이종 아키텍처 사이의 증류를 해냈다. 요컨대 FGD는 세 계열이 각자 놓친 조각들을 하나의 프레임워크로 봉합한 작업이다.
10. 마무리
FGD가 던지는 메시지는 단순하다. 긴 문서를 통째로 증류하려 들지 말고, 문서가 실제로 담고 있는 여러 토픽을 세밀한 단위로 쪼개서 증류하라는 것이다. 크로스 인코더가 쿼리에 따라 문서의 다른 부분에 집중한다는 사실 - scope hypothesis - 을 정직하게 받아들이면, 증류의 단위도 그에 맞춰 세밀해져야 한다는 결론이 자연스럽게 따라온다.
방법론에서 가장 배울 점은 global-consistent granularity embedding이다. 새 파라미터를 하나도 추가하지 않고 이미 계산된 [CLS] attention 점수만 스팬에 재활용해서 일관된 멀티 granularity 표현을 만든다는 발상은, 복잡한 GNN을 얹은 RGAT와 동률을 내면서도 훨씬 가볍다. 여기에 계층적 하드 negative 채굴과 문서 레벨 증류를 의도적으로 배제한 손실 설계까지, 각 구성요소가 ablation에서 제 몫을 증명한다.
한계도 분명하다. 절대 성능 향상폭이 크지 않고, 평가가 MS-MARCO 계열에 갇혀 있으며, 고정 길이 조각화의 민감도나 실제 학습 시간 오버헤드에 대한 검증이 부족하다. 그럼에도 "추론 효율은 그대로, 학습만 손봐서 장문서 검색을 개선한다"는 실전적 가치는 여전히 유효하다. RAG를 비롯해 긴 문서를 검색해야 하는 상황이 늘어나는 지금, 문서를 세밀 단위로 다루는 이 프레임워크의 문제의식은 앞으로도 곱씹어볼 만하다.