논문 리뷰
논문 리뷰: LMK > CLS: Landmark Pooling for Dense Embeddings
문서 하나를 벡터 하나로 압축할 때 쓰는 [CLS]/mean 풀링의 고질적 약점을 짚고, 시퀀스 중간중간에 landmark 토큰을 꽂아 그 임베딩만 평균 내는 단순한 풀링으로 장문 검색 성능을 크게 끌어올린 연구.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | LMK > CLS: Landmark Pooling for Dense Embeddings |
| 저자 | Meet Doshi, Aashka Trivedi, Vishwajeet Kumar, Parul Awasthy, Yulong Li, Jaydeep Sen, Radu Florian, Sachindra Joshi (IBM Research) |
| 게재 | arXiv 프리프린트, 2026 (ICML 투고 형식) |
| 논문 링크 | arXiv:2601.21525 |
1. 들어가며
임베딩 모델을 쓰다 보면 이상하게 잘 안 되는 구간이 있다. 짧은 질의응답 검색은 잘 되는데, 수천 토큰짜리 긴 문서를 넣으면 검색 품질이 눈에 띄게 무너지는 경우다. RAG 파이프라인을 짜본 사람이라면 "왜 이 긴 문서는 관련 질의에 안 걸리지?" 하는 경험을 한 번쯤 했을 것이다. 보통은 청킹 전략이나 학습 데이터를 의심하지만, 이 논문은 훨씬 근본적인 곳을 지목한다. 바로 토큰 시퀀스를 벡터 하나로 뭉개는 풀링(pooling) 연산 그 자체다.
트랜스포머 인코더는 입력을 토큰 단위 contextualized 표현 로 바꿔준다. 문제는 이 가변 길이 시퀀스를 다운스트림에서 쓸 수 있는 고정 차원 벡터 하나로 줄여야 한다는 점이다. 관행적으로는 맨 앞 [CLS] 토큰의 표현을 쓰거나(CLS 풀링), 전체 토큰 표현을 평균 내는(mean 풀링) 두 방식이 지배적이다. 그런데 이 둘 다 장문에서 조용히 실패한다는 게 이 논문의 출발점이다.
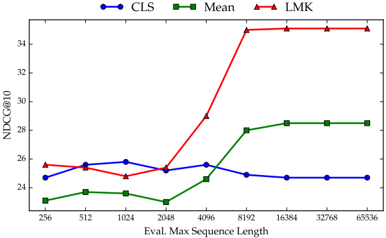
Figure 1: MSMarco Passage로 파인튜닝한 ModernBERT-base의 MLDR(영어) 장문 검색 성능. 평가 최대 시퀀스 길이(x축)를 늘려가며 NDCG@10(y축)을 측정. (원논문)
Figure 1은 이 논문의 문제의식을 한 장으로 압축한다. 평가 시퀀스 길이를 256에서 65,536까지 늘려가며 세 풀링 방식을 비교하는데, CLS(파란색)는 시퀀스가 길어져도 24~25 근처에서 평평하게 정체된다. 긴 문서를 더 많이 읽혀줘도 성능이 전혀 늘지 않는 것이다. mean(초록색)은 4k 지점을 넘기며 28대로 올라간다. 반면 LMK(빨간색)는 8k 지점에서 35 부근으로 급등한 뒤 그 성능을 끝까지 유지한다. 세 방법 모두 똑같이 512 토큰으로 학습됐는데도 장문 외삽(extrapolation) 능력이 이렇게 갈린다는 게 핵심이다. 짧은 구간(256~2048)에서는 셋이 비슷하다는 점도 눈여겨볼 만한데, LMK가 단문을 희생하지 않으면서 장문만 끌어올린다는 뜻이기 때문이다.
이 논문이 제안하는 Landmark(LMK) 풀링은 아이디어만 놓고 보면 허탈할 정도로 단순하다. 시퀀스를 고정 크기 청크로 쪼개고 청크 사이사이에 특수 토큰(landmark)을 삽입한 다음, 그 landmark 토큰들의 임베딩만 평균 내서 최종 표현을 만든다. 특수 토큰 몇 개를 추가하는 비용만 치르면 장문 성능이 크게 좋아진다. 방법이 단순한 만큼, 이 리뷰에서는 "왜 CLS와 mean이 실패하는가"라는 진단 파트에 무게를 두려 한다. 진단이 정확하기 때문에 처방이 단순할 수 있었던 셈이다.
2. 기존 연구의 한계
2.1 Dense 임베딩과 풀링 관행
Dense 임베딩의 초기 연구(Gao et al., 2011; Huang et al., 2013)는 관련 질의-문서 쌍의 거리를 최소화하는 방식으로 토큰 표현의 변환을 학습했다. 이후 BERT류의 강력한 인코더(Devlin et al., 2019; Warner et al., 2025)와 대조 학습 계열의 학습 목표(van den Oord et al., 2018)가 표현 품질을 크게 끌어올렸다. 그런데 이런 발전에도 불구하고 대부분의 방법은 여전히 토큰 표현 시퀀스를 단순 풀링으로 벡터 하나에 뭉갠다. 저자들의 지적은 이 마지막 압축 단계, 특히 장문 검색에서의 압축이 거의 연구되지 않았다는 것이다.
풀링 방식에는 학계의 합의가 없다. 최신 모델 중 상당수가 CLS 풀링을 쓰고(Awasthy et al., 2025; Zhang et al., 2024; Merrick et al., 2024), 또 다른 진영은 mean 풀링으로 비슷한 성능을 낸다(Wang et al., 2022; Nussbaum et al., 2024). 학습 가중치나 하이브리드 전략을 쓰는 경우도 있는데(Chen et al., 2024; Lee et al., 2025), 특히 Chen et al. (2024)은 추론 시점에 CLS 토큰을 여러 개 삽입하는 multi-CLS 풀링을 제안했다. 문제는 이런 표현들이 문서 길이와 무관하게 크기가 고정돼 있어, 보존할 수 있는 정보량이 원천적으로 제한된다는 점이다(Santhanam et al., 2022; Weller et al., 2025).
이 논문의 직접적 뿌리는 Luo et al. (2024)의 Landmark Embedding이다. 이들은 자기회귀 LLM의 RAG에서 청크 단위 표현을 잡기 위해 landmark 토큰을 도입했다. 다만 이 아이디어를 양방향(bidirectional) dense 임베딩의 장문 풀링에 적용하는 문제는 다루지 않았다. 이 논문은 바로 그 빈칸을 채워, landmark 토큰을 DPR(Dense Passage Retrieval) 세팅으로 확장하고 풀링 메커니즘 자체를 체계적으로 분석한다.
2.2 학습/평가 데이터의 장문 공백
임베딩 학습 데이터는 MSMarco, NQ 같은 표준 벤치마크에서 출발해(Nguyen et al., 2016; Kwiatkowski et al., 2019) 대규모 이질적 혼합 데이터로 진화해왔다(Chen et al., 2024; Li et al., 2025a). 평가도 여러 도메인, 태스크, 언어를 아우르는 광범위한 벤치마크로 확장됐다(Thakur et al., 2021; Enevoldsen et al., 2025). 그런데 가장 널리 쓰이는 벤치마크 대부분이 짧은 시퀀스(보통 512 토큰 이하)에 집중돼 있다. 현실의 많은 응용은 장문 임베딩을 요구하는데, 풀링 선택이 여기에 어떤 영향을 주는지는 거의 탐구되지 않았다. 이 논문은 풀링 메커니즘과 장문 평가를 명시적으로 연결해서 기존 방식들을 LMK와 정면으로 비교한다.
3. 왜 기존 풀링이 실패하는가
이 파트가 논문에서 가장 재미있는 부분이다. 저자들은 "장문에서 잘 안 된다"는 현상을 관찰에 그치지 않고, RoPE의 수학적 성질까지 파고들어 원인을 짚는다.
3.1 CLS 풀링: RoPE의 long-term decay가 앞부분에 집착하게 만든다
먼저 두 관행적 풀링을 수식으로 정리해두자. CLS 풀링은 [CLS] 토큰 하나의 표현을 그대로 최종 표현으로 쓴다.
mean 풀링은 시퀀스 전체 토큰 표현을 차원별로 평균 낸다.
여기서 는 시퀀스 길이, 는 번째 토큰의 표현이다. 개념만 보면 mean은 모든 토큰을 균등하게 반영하는 전체적(holistic) 집계이고, CLS는 단일 토큰에 모든 정보를 몰아넣는 방식이다. CLS가 문제인 건, 이 단일 위치에 표현 부담이 과도하게 쏠린다는 점이다.
왜 하필 앞부분에 쏠리는가? 저자들은 위치 정보가 어떻게 인코딩되는지부터 따진다. 어텐션 블록은 입력 에서 query, key, value를 만든다.
여기서 이고 는 헤드 차원이다. 현대 인코더가 쓰는 RoPE(Rotary Positional Embeddings)는 위치에 따라 query/key 벡터를 회전 시켜 위치 정보를 주입한다. 각 주파수는 다음과 같이 정의된다.
는 base frequency로 보통 10,000이다. , 로 두면, 위치 과 사이의 어텐션 로짓은 상대 위치 에만 의존하는 형태가 된다.
여기서 RoPE의 이른바 long-term decay가 등장한다. 회전 행렬은 상대 거리 이 커질수록 어텐션 로짓의 크기를 감쇠시킨다. [CLS] 토큰은 항상 에 있으므로, 로짓은
가 되고, 그 크기는 이 커질수록 줄어든다. softmax를 거치면 멀리 있는 토큰에 배정되는 어텐션 가중치가 작아지고, 결국 [CLS] 표현은 앞쪽 토큰에 편향된다. 이 편향은 시퀀스가 길어질수록 심해진다. 학습 길이를 넘어 외삽할 때는 더 나빠진다. base frequency 를 키우면 감쇠가 느려져 완화는 되지만, 근본 편향이 사라지지는 않는다.
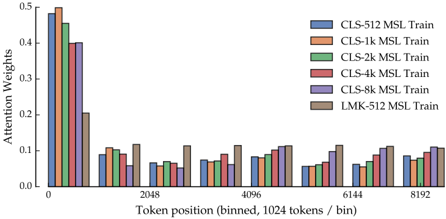
Figure 2: 8,192 토큰 이상의 긴 MLDR 문서에 대해, 다양한 최대 시퀀스 길이(MSL)로 파인튜닝한 mmBERT-base의 풀링 토큰([CLS] 및 LMK) 어텐션 분포를 정규화한 것. x축은 토큰 위치(1,024 토큰 단위 binning). (원논문)
Figure 2는 이 편향을 직접 눈으로 보여준다. 긴 문서에서 풀링 토큰이 각 위치에 배정하는 최종 레이어 어텐션 가중치를 위치별로 집계한 것인데, CLS 계열(512, 1k, 2k, 4k, 8k MSL로 학습한 다섯 막대)은 위치 0 근처에서 0.4~0.5에 달하는 반면 뒤쪽 위치로 가면 0.1 아래로 뚝 떨어진다. 앞부분에 어텐션이 몰빵되는 셈이다. 학습 시퀀스를 길게 잡을수록(8k) 이 쏠림이 다소 완화되기는 하지만 완전히 없어지지는 않는다. 반면 512 토큰으로만 학습한 LMK(맨 오른쪽 갈색 막대)는 위치 0에서 0.21 정도로, 애초에 앞부분 집착이 훨씬 약하고 뒤쪽 위치에도 CLS와 비슷하거나 더 고른 가중치를 준다. 짧게 학습했는데도 편향이 작다는 게 핵심 관찰이다. 이 그림은 "장문에서 CLS가 못 하는 이유"에 대한 논문의 이론적 주장을 경험적으로 뒷받침한다. 참고로 이건 최종 레이어 기준 시각화지만, ModernBERT처럼 전역 어텐션이 특정 레이어에만 있는 구조에서도 결론은 유효하다는 게 저자들의 설명이다.
3.2 mean 풀링과 latent attention: 반대 방향의 실패
CLS가 위치 편향으로 실패한다면, mean 풀링은 정반대 이유로 실패한다. mean은 위치 독립적이라 장문 외삽에는 구조적 제약이 없다. 실제로 Figure 1에서도 mean은 장문에서 CLS보다 낫다. 문제는 다른 데 있다. 모든 토큰을 균등 가중하다 보니 토큰 표현들이 공유 중심(centroid)으로 수렴하는 경향이 생기고, 그 과정에서 salient한(두드러진) 특징이 희석된다. 게다가 정규화된 인코더 표현에서는, 태스크와 무관한 정보를 담은 토큰도 최종 임베딩에 균등하게 기여한다.
이 균등 집계는 "태스크 관련 정보가 시퀀스 전체에 고르게 퍼져 있다"고 암묵적으로 가정하는 셈인데, 현실에서는 이 가정이 자주 깨진다. 특히 단문 태스크에서는 결정적 근거가 소수 토큰에 집중되는 경우가 많다. 그래서 mean은 명시적 집계 메커니즘(어텐션)을 학습하는 CLS보다 단문에서 뒤처지곤 한다. 정리하면 mean은 장문 외삽은 잘하지만 단문에서 약하고, CLS는 단문은 잘하지만 장문에서 약하다. 서로의 약점이 정확히 반대다.
Lee et al. (2025)의 Latent Attention은 "모든 토큰을 균등 취급"하는 mean의 약점을 겨냥한다. 학습 가능한 latent 벡터로 토큰 임베딩에 선택적으로 어텐션을 걸어 재가중하는 방식이다. 인코더 출력 와 학습 가능한 latent 집합 (은 latent 개수, 은 latent 헤드 차원)에 대해 query/key/value를 계산한다.
여기서 , 이다. 이후 Prenorm(표준 LayerNorm)과 FFN을 거쳐 latent 벡터 기반 표현을 만들고, 이를 다시 mean 풀링해 문장 표현을 얻는다. 저자들의 지적이 날카로운데, 이 절차는 결국 개념적으로 mean 풀링과 등가라서 장문 외삽에 유리한 편향을 만들지 못한다. 즉 latent attention은 파라미터와 연산만 추가로 지불하면서 mean의 한계를 그대로 물려받는다. 뒤에 나올 실험 결과가 이 예측과 정확히 맞아떨어진다.
이 셋의 장단점을 저자들은 이렇게 요약한다. CLS는 가까운 토큰에 편향되지만, 학습된 selector로서 시퀀스의 여러 부분에 적응적으로 어텐션을 거는 능력은 표현 학습에 바람직하다. mean은 salient 특징을 희석하지만, 여러 토큰이 각자 독립적으로 전체 시퀀스를 평가하게 해준다. latent attention은 고정된 latent 벡터로 재가중하느라 추론 시점의 복잡도만 늘린다. LMK는 이 장점들(적응적 selector + 다중 평가 지점)은 취하고 단점(위치 편향)은 피하려는 설계다.
4. 제안 방법: Landmark (LMK) Pooling
LMK 풀링은 표준 인코딩에 두 가지만 바꾼다. (1) 토크나이징 절차를 바꾸고, (2) LMK 토큰 위치에 의존하는 풀링을 쓴다. 단일 특수 토큰([CLS]) 대신 여러 특수 토큰을 시퀀스 곳곳에 삽입하는 게 전부다. LMK 토큰으로는 SEP 토큰을 재활용하는데, 대부분의 언어 인코더에서 이미 구분자 역할을 하기 때문이다. SEP이 없는 토크나이저라면 EOS 토큰이 적절한 대안이 된다.
4.1 토크나이징 (Algorithm 1)
첫 단계는 텍스트를 토큰으로 쪼갠 뒤 청크마다 landmark를 끼워넣는 것이다. Algorithm 1의 흐름은 다음과 같다.
- 입력: 텍스트 , 토크나이저 , granularity , landmark 토큰
- 1: : 특수 토큰 없이 순수 토큰화
- 2: : 토큰 시퀀스를 granularity 단위로 분할
- 3:
- 4:
- 5: return
핵심은 3번 줄이다. 맨 앞에 [CLS]를 두고, 각 청크 뒤마다 landmark 토큰을 삽입한다. 가 32이면 32 토큰마다 landmark 하나가 들어가는 식이다. 이렇게 하면 landmark들이 문서 전체에 규칙적으로 분포하고, 각 landmark는 자기 주변 청크 정보를 흡수할 위치를 얻게 된다.
4.2 풀링 (Algorithm 2)
풀링 자체는 간단하다. 인코더가 뱉은 토큰 임베딩 에서 landmark 토큰 위치의 임베딩만 골라 평균 낸다. landmark 위치 집합을 라 하면 최종 표현은
이다. mean 풀링과 형태는 같지만 평균 대상이 전체 토큰이 아니라 landmark들뿐이라는 점이 결정적 차이다. 각 landmark는 양방향 어텐션을 통해 문서 전체 문맥의 영향을 받으면서도, 물리적으로 문서 곳곳에 흩어져 있으니 특정 위치에 어텐션이 몰려도 다른 landmark가 이를 보완한다. CLS의 "단일 selector" 장점(어텐션으로 적응적 집계)과 mean의 "다중 평가 지점" 장점을 동시에 취하는 구조인 셈이다. 그러면서 landmark가 여러 위치에 있으니 RoPE long-term decay가 특정 앞부분에만 쏠리는 것을 구조적으로 막는다.
4.3 landmark를 어디에 꽂을 것인가: granularity 전략
landmark 삽입 위치를 정하는 방식으로 세 가지를 실험한다.
- Sentence chunking: 토큰화 전에 문장 단위로 쪼개고 문장마다 landmark를 삽입. 자연스럽지만 코드나 문장 구분자가 불명확한 언어에는 일반화가 어렵다.
- Fixed length chunking: 토큰화 후 고정 간격마다 landmark 삽입. 단순하지만 위치 편향을 만들 수 있고, 파인튜닝 때 고른 granularity에 성능이 민감해진다.
- Variable chunking: 미리 정한 간격 집합 에서 학습 중 매번 무작위로 하나를 뽑아 삽입 간격으로 사용. granularity 선택에 대한 강건성을 주고, 하나의 모델이 추론 시점에 태스크에 따라 서로 다른 granularity를 지원할 수 있게 한다.
실험 전반에서 variable chunking이 가장 안정적이라는 결과가 나온다. 학습을 특정 간격에 고정하지 않으니 추론 때 granularity를 자유롭게 바꿔도 성능이 잘 유지되기 때문이다.
4.4 연산 오버헤드
특수 토큰을 추가하면 실효 시퀀스 길이가 늘어 연산이 더 든다. 그런데 landmark를 성긴 간격으로 넣으므로 실제 오버헤드는 작다. LongEmbed 벤치마크에서 최대 평가 길이 32K일 때 128 토큰마다 landmark를 넣으면 256개 토큰만 추가되는데(32,768 / 128 = 256), 이 정도로 다른 풀링을 크게 앞선다. 저자들은 공정성을 위해 LMK 평가 시 추가 특수 토큰만큼 토큰 예산을 늘려주지 않았다고 명시한다. 즉 LMK는 같은 토큰 예산 안에서 이만큼의 성능을 낸 것이다.
5. 실험 설정
모델과 학습 데이터. 영어 실험은 장문 학습을 지원하는 gte-en-mlm-base와 ModernBERT-base를 쓴다. MS MARCO passage/document ranking 데이터(Li et al., 2025a 제공)로 학습하며, hard negative(passage 7개, document 1개)와 distillation 점수를 함께 쓴다. 5k 스텝, 학습률 . passage ranking은 실효 query 배치 2,048에 최대 길이 512, document ranking은 배치 256에 최대 길이 8,192다. 다국어 실험은 ModernBERT의 다국어판인 mmBERT-base와 gte-multilingual-base를 쓰고, Chen et al. (2024)의 BGE-m3 다국어 데이터로 학습한다(10k 스텝, 배치 1,024, 길이 512). 장문 학습 ablation에서는 길이를 8,192까지 늘리되 메모리 제약으로 배치를 64로 줄인다. 학습 파이프라인은 FlagEmbedding 기반, BF16 정밀도, H100 80GB 8장, InfoNCE 온도 , DeepSpeed와 HuggingFace Accelerate로 최적화한다.
평가. 도메인 내(in-domain)는 MS MARCO Dev. 단문 out-of-domain은 BEIR(15), MTEB-v2(10), MIRACL Retrieval. 장문 out-of-domain은 MLDR, COIR 코드 검색(8), 그리고 8k 사전학습 컨텍스트를 자주 넘기고 타깃 정보가 분산돼 있는 LongEmbed(6)다. 다국어는 MIRACL Hard Negatives(18개 언어), MLDR(13개 언어), Multi-EURLEX 제로샷 장문 분류(23개 언어, Macro-F1)로 평가한다. 평가 최대 길이는 LongEmbed만 32,768이고 나머지는 8,192다.
베이스라인. CLS, Mean, Latent Attention(latent 64개)에 더해, CLS로 학습한 모델을 추론 시점에만 CLS 토큰 여러 개 삽입해 mean 풀링하는 MultiCLS, 그리고 특수 토큰 없이 매 번째 토큰만 mean 풀링하는 Mean@k를 넣는다. Mean@k는 "특수 풀링 토큰이 정말 필요한가"를 검증하는 대조군이다. LMK 쪽은 sentence/fixed/variable splitter를 비교하고, fixed는 32/64/128/256 granularity를 각각 본다.
6. 주요 결과
6.1 영어 검색: 단문은 지키고 장문은 이긴다
MSMarco Passage로 학습한 ModernBERT-base의 결과가 논문의 대표 표다. in-domain, 단문 out-of-domain, 장문 out-of-domain을 한 표에서 비교한다.
| Pool (FT) | Gran. | Eval Gran. | MSMarco Dev | BEIR(15) | MTEBv2(10) | MIRACL | Avg.단문 | MLDR | COIR(8) | LongEmbed | Avg.장문 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| CLS | - | - | 39.8 | 42.8 | 44.2 | 48.7 | 45.2 | 24.9 | 43.5 | 43.3 | 37.2 |
| CLS→MultiCLS | - | 128 | 39.0 | 33.6 | 31.2 | 31.0 | 31.9 | 5.1 | 35.4 | 43.9 | 28.1 |
| Mean | - | - | 39.8 | 41.6 | 43.3 | 48.0 | 44.3 | 28.0 | 44.1 | 62.7 | 44.9 |
| Latent Attn | - | - | 40.1 | 41.3 | 43.1 | 48.3 | 44.2 | 24.5 | 43.3 | 62.8 | 43.5 |
| Mean@k | 64 | 64 | 38.6 | 39.7 | 41.4 | 44.1 | 41.7 | 15.7 | 39.8 | 44.8 | 33.4 |
| LMK | 32 | 32 | 39.7 | 43.9 | 45.9 | 48.5 | 46.1 | 34.8 | 46.4 | 60.2 | 47.1 |
| LMK | 64 | 64 | 39.9 | 43.5 | 45.1 | 48.2 | 45.6 | 33.6 | 46.6 | 60.0 | 46.7 |
| LMK | 128 | 128 | 40.0 | 42.9 | 44.0 | 48.4 | 45.1 | 30.8 | 46.3 | 54.1 | 43.7 |
| LMK | 256 | 256 | 39.9 | 41.8 | 42.8 | 47.0 | 43.9 | 34.1 | 46.4 | 58.2 | 46.2 |
| LMK | Var | 32 | 40.3 | 44.0 | 45.8 | 48.6 | 46.1 | 35.0 | 47.0 | 62.4 | 48.1 |
| LMK | Var | 64 | 40.2 | 43.8 | 45.5 | 48.6 | 46.0 | 34.7 | 46.9 | 62.3 | 48.0 |
| LMK | Var | 128 | 40.2 | 43.6 | 45.1 | 48.1 | 45.6 | 32.1 | 46.8 | 59.0 | 46.0 |
| LMK | Var | 256 | 40.2 | 43.1 | 44.5 | 48.1 | 45.2 | 28.7 | 46.4 | 55.5 | 43.5 |
| LMK | Sent | Sent | 40.2 | 43.6 | 45.4 | 48.2 | 45.7 | 28.0 | 42.7 | 62.6 | 44.4 |
Table 1 (원논문): MSMarco passage로 파인튜닝한 ModernBERT-base의 in-domain 및 out-of-domain 검색 벤치마크 비교. 학습/평가에 쓴 풀링과 granularity를 함께 표기. LongEmbed는 P@1과 NDCG@10 중 대표값. 굵은 글씨는 열별 최고 부근.
이 표에서 읽어야 할 이야기가 몇 겹이다. 먼저 단문 평균(Avg.단문)을 보면 LMK-Variable(32)과 LMK-32가 46.1로 CLS의 45.2를 오히려 앞선다. LMK가 단문을 희생한다는 걱정은 데이터로 반박되는 셈이다. mean(44.3)과 latent(44.2)는 예상대로 단문에서 CLS보다 뒤처지는데, 3.2절의 "mean은 salient 특징을 희석해 단문에 약하다"는 진단과 일치한다.
장문 평균(Avg.장문)이 이 논문의 하이라이트다. CLS는 37.2에 머무는 반면 LMK-Variable(32)은 48.1로 무려 11점 가까이 앞선다. 특히 MLDR에서 CLS 24.9 대 LMK 35.0으로 격차가 크다. mean(44.9)과 latent(43.5)도 CLS보다는 낫지만 LMK에 못 미친다. latent attention이 mean과 사실상 같은 수준(43.5 vs 44.9)에 그친 것은 "latent는 mean의 한계를 물려받는다"는 3.2절 예측을 그대로 확인해준다.
가장 인상적인 대조군은 MultiCLS와 Mean@k의 붕괴다. MultiCLS는 장문 평균 28.1, MLDR은 5.1로 처참하다. CLS로 학습한 모델에 추론 때만 CLS 토큰을 여러 개 꽂는 트릭은, 학습 없이는 완전히 무너진다는 뜻이다. Mean@k도 장문 33.4, MLDR 15.7로 약하다. 이 둘의 실패가 중요한 이유는, LMK의 성능이 "그냥 토큰 여러 개 평균"에서 오는 게 아니라 학습 단계에서 landmark 구조에 맞춰 표현을 배우는 것에서 온다는 걸 보여주기 때문이다. 특수 토큰을 학습 없이 추론 때만 삽입하면 소용없다.
granularity 관점에서는 세밀할수록(32) MLDR/BEIR에서 유리하고, 성길수록(256) LongEmbed에서 유리한 트레이드오프가 보인다. Variable로 학습하면 추론 때 granularity를 32~256로 바꿔가며 이 트레이드오프를 태스크별로 골라 쓸 수 있다. Variable(32)이 대부분 지표에서 최상위권인 게 그래서다. sentence splitter는 단문에서는 괜찮지만 MLDR(28.0)과 COIR(42.7, 코드)에서 약한데, 코드처럼 문장 경계가 모호한 도메인에 문장 청킹이 안 맞는다는 4.3절 우려가 확인된다.
6.2 다국어로도 이어지는가
mmBERT-base를 BGE-m3 다국어 데이터로 대조 파인튜닝한 결과다.
| Pool | FT Gran. | Eval Gran. | MIRACL(18) | MLDR(13) | M-EURLEX(23) F1 | LongEmbed(6) |
|---|---|---|---|---|---|---|
| CLS | - | - | 57.6 | 24.9 | 27.5 | 44.1 |
| Mean | - | - | 56.1 | 17.0 | 27.5 | 48.4 |
| Latent | - | - | 56.6 | 19.6 | 28.0 | 46.9 |
| LMK | 128 | 128 | 58.0 | 37.2 | 31.5 | 62.1 |
| LMK | Var | 32 | 57.8 | 38.7 | 33.7 | 70.7 |
| LMK | Var | 64 | 57.9 | 38.6 | 33.4 | 70.7 |
| LMK | Var | 128 | 57.9 | 38.3 | 33.2 | 70.2 |
| LMK | Var | 256 | 57.7 | 38.0 | 33.0 | 69.8 |
Table 2 (원논문): BGE-m3 다국어 데이터로 파인튜닝한 mmBERT-base의 in/out-of-domain 검색 벤치마크 비교.
다국어에서도 패턴이 유지된다. 단문 성격의 MIRACL(18개 언어)에서는 LMK가 CLS와 대등하거나 살짝 앞선다(58.0 vs 57.6). 장문으로 가면 격차가 벌어진다. MLDR에서 CLS 24.9 대 LMK-Variable(32) 38.7로 14점 가까이 앞서고, 제로샷 장문 분류인 Multi-EURLEX에서 27.5 대 33.7, LongEmbed에서 44.1 대 70.7로 크게 앞선다. LongEmbed의 70.7은 특히 눈에 띄는데, out-of-domain 장문 검색에서 LMK의 이점이 언어를 가리지 않고 나타난다는 뜻이다. mean이 MLDR에서 17.0으로 CLS(24.9)보다도 낮은 것도 흥미롭다. 다국어 장문에서는 mean의 salient 희석 문제가 더 크게 작동하는 것으로 보인다. 언어별 상세는 아래 부록(Table 10~12)에서 다시 본다.
7. 장문 성능: 데이터 아티팩트인가, 모델의 한계인가
여기서 저자들은 스스로에게 반론을 던진다. LMK가 장문에서 이긴 게 혹시 "학습 데이터가 짧아서 CLS가 불리했을 뿐"은 아닐까? 이걸 검증하려면 학습 데이터에 긴 문서를 넣어보면 된다.
7.1 긴 문서로 학습해도 CLS는 out-of-domain에서 못 따라온다
먼저 MSMarco Document Ranking(passage보다 김)으로 학습 컨텍스트를 8k로 늘려 두 모델을 학습한다.
| Model | Pool | MSMarco Dev | BEIR(15) | MTEBv2 | MIRACL | Avg.단문 | MLDR | COIR | LongEmbed | Avg.장문 |
|---|---|---|---|---|---|---|---|---|---|---|
| gte-en | CLS | 28.7 | 37.6 | 39.0 | 32.3 | 36.3 | 29.1 | 30.1 | 49.1 | 36.1 |
| gte-en | Mean | 28.3 | 36.3 | 37.7 | 29.0 | 34.3 | 30.0 | 32.5 | 61.6 | 41.4 |
| gte-en | LMK(Var/32) | 28.9 | 37.1 | 38.1 | 32.1 | 35.8 | 31.4 | 30.9 | 59.8 | 40.7 |
| ModernBERT | CLS | 26.0 | 38.0 | 39.8 | 32.0 | 36.6 | 29.7 | 44.2 | 58.3 | 44.1 |
| ModernBERT | Mean | 26.1 | 37.1 | 38.4 | 31.4 | 35.6 | 31.3 | 42.3 | 62.4 | 45.3 |
| ModernBERT | LMK(Var/32) | 26.0 | 38.7 | 40.4 | 33.1 | 37.4 | 32.2 | 45.6 | 58.1 | 45.3 |
Table 3 (원논문): MSMarco document 데이터로 파인튜닝한 gte-en-mlm-base와 ModernBERT-base의 벤치마크 비교.
결과가 모델마다 갈린다. gte-en에서는 CLS가 단문 최강, 장문에서는 mean이 CLS와 LMK를 앞선다(CLS는 여기서 크게 부진). ModernBERT에서는 LMK가 단문/장문 모두에서 가장 일관적이다. CLS가 LongEmbed에서 58.3으로 괜찮아 보이지만, 이건 주로 Passkey Retrieval 서브셋 덕분이고 다른 장문 벤치마크에서는 여전히 부진하다(뒤의 Table 9에서 확인). 즉 긴 문서로 학습해도 CLS의 장문 약점이 완전히 사라지지는 않는다.
7.2 MSMarco document는 사실 그렇게 길지 않다
그런데 MSMarco document ranking을 "장문 학습 데이터"로 믿어도 될까? 저자들은 아니라고 본다.
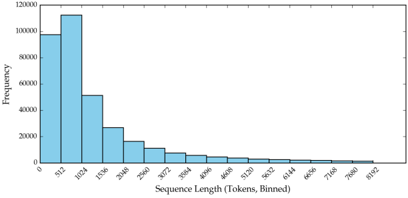
Figure 3: ModernBERT-base 토크나이저로 잰 MS MARCO Document Ranking 학습셋의 passage 토큰 길이 분포(binning). (원논문)
Figure 3을 보면 분포가 짧은 쪽에 심하게 쏠려 있다. 512와 1,024 bin에 각각 10만, 11만 건이 몰려 있고, 2k를 넘는 문서는 급격히 줄어 8k 근처는 거의 없다. "document"라는 이름과 달리 대부분이 2k 미만인 것이다. 이게 왜 중요하냐면, 이 데이터로 학습한 모델은 사실상 진짜 장문을 거의 못 본 셈이고, 그래서 8k 학습이라 해도 장문 외삽 능력을 제대로 못 배운다. 저자들이 뒤에서 진짜 긴 MLDR 학습셋으로 넘어가는 이유가 여기 있다.
7.3 학습 시퀀스를 늘리면? in-domain은 좁혀지지만 out-of-domain은 안 좁혀진다
그래서 진짜 긴 문서(MLDR 학습셋 포함 다국어 데이터)로 mmBERT-base를 학습하고, 학습 최대 길이(MSL)를 512에서 8,192까지 바꿔가며 CLS와 LMK를 비교한다.
| FT MSL | MLDR CLS | MLDR LMK | M-EURLEX CLS | M-EURLEX LMK | LongEmbed CLS | LongEmbed LMK |
|---|---|---|---|---|---|---|
| 512 | 31.7 | 36.6 | 30.5 | 32.9 | 46.1 | 70.6 |
| 1024 | 32.5 | 40.9 | 30.1 | 33.1 | 45.4 | 71.1 |
| 2048 | 39.8 | 43.6 | 30.0 | 32.0 | 52.2 | 72.6 |
| 4096 | 46.3 | 45.9 | 29.4 | 31.7 | 52.5 | 73.3 |
| 8192 | 49.1 | 49.6 | 30.2 | 31.5 | 56.2 | 71.3 |
Table 4 (원논문): mmBERT-base의 학습 최대 길이(MSL)가 장문 임베딩 성능에 미치는 영향. CLS와 LMK 비교.
이 표가 논문의 반론을 정면으로 처리한다. in-domain인 MLDR에서는 학습 길이를 8k까지 늘리면 CLS(49.1)가 LMK(49.6)에 거의 따라붙는다. 즉 CLS도 진짜 긴 데이터로 학습하면 장문 편향을 부분적으로 완화할 수 있다. 하지만 out-of-domain으로 나가면 이야기가 다르다. Multi-EURLEX(제로샷 법률 문서)에서는 어느 MSL에서도 LMK가 앞서고, LongEmbed에서는 격차가 압도적이다(예: MSL 512에서 46.1 vs 70.6, MSL 8192에서도 56.2 vs 71.3). CLS는 학습 도메인 안에서만 장문을 배우고, 처음 보는 도메인의 장문에는 여전히 약한 것이다. 반면 LMK는 512로만 학습해도 out-of-domain 장문에서 70대를 찍는다. 실무적으로 이 차이가 결정적인데, 현실의 장문 검색은 대부분 학습 때 못 본 도메인이기 때문이다.
7.4 다른 모델에서도 같은 결론
gte-multilingual-base로 같은 실험(MSL 8192)을 반복한다.
| Pool | FT/Eval Gran. | MIRACL(18) | MLDR(13) | M-EURLEX(23) F1 | LongEmbed(6) |
|---|---|---|---|---|---|
| CLS | - | 66.7 | 58.7 | 13.9 | 66.1 |
| Mean | - | 66.3 | 58.3 | 14.5 | 65.8 |
| Latent | - | 66.2 | 58.4 | 14.6 | 66.9 |
| LMK | 32/32 | 66.1 | 58.1 | 16.4 | 72.9 |
| LMK | Var/32 | 66.2 | 58.1 | 18.0 | 73.1 |
Table 5 (원논문): gte-multilingual-base의 장문 파인튜닝 ablation, 최대 길이 8192.
여기서도 일관된다. 긴 데이터로 학습하니 CLS, Mean, Latent가 in-domain MLDR에서 LMK와 대등해진다(58대 초반). 그런데 out-of-domain인 Multi-EURLEX(CLS 13.9 vs LMK 18.0)와 LongEmbed(66.1 vs 73.1)에서는 LMK가 다시 앞선다. 7.1~7.4를 종합하면 결론이 분명하다. 장문 학습은 기존 풀링의 위치 편향을 줄일 수는 있지만 없애지는 못한다. 특히 도메인을 벗어나면 편향이 되살아난다. LMK만이 학습 도메인에 관계없이 장문 외삽을 안정적으로 한다.
8. Retrieval Pretraining과의 결합 (RetroMAE)
LMK가 파인튜닝만이 아니라 사전학습 단계에도 꽂히는지를 본다. RetroMAE(Xiao et al., 2022)는 라벨 없이 표현을 강화하는 자기지도 사전학습으로, 대규모 대조 학습 전에 임베딩을 다지는 중간 단계로 자주 쓰인다. 인코더가 마스킹된 입력을 처리하고, 가벼운 bottleneck 디코더가 인코더 표현으로부터 원문을 복원하는 구조다. 보통 이 디코더 입력으로 CLS 표현을 쓰는데, 저자들은 이 자리에 LMK 풀링을 대신 넣는다. BookCorpus, Wikipedia, StackExchange에서 약 225k 샘플로 2 에폭, 학습률 , 최대 길이 8,192로 사전학습한 뒤 MSMarco passage로 파인튜닝한다.
| Model | Pool | MSMarco Dev | BEIR(15) | MTEBv2 | MIRACL-HN EN | Avg.단문 | MLDR EN | COIR | LongEmbed | Avg.장문 |
|---|---|---|---|---|---|---|---|---|---|---|
| gte-en | CLS | 42.3 | 44.0 | 44.7 | 47.9 | 45.5 | 27.3 | 36.6 | 52.0 | 38.6 |
| gte-en | + CLS RetroMAE | 42.5 | 44.7 | 45.5 | 47.4 | 45.9 | 31.2 | 42.1 | 60.8 | 44.7 |
| gte-en | LMK(Var/256) | 43.0 | 44.2 | 44.8 | 48.1 | 45.7 | 31.7 | 37.6 | 65.2 | 44.8 |
| gte-en | + LMK RetroMAE | 42.6 | 44.5 | 45.4 | 48.4 | 46.1 | 36.6 | 43.3 | 67.7 | 49.2 |
| ModernBERT | CLS | 39.8 | 42.8 | 44.2 | 48.7 | 45.2 | 24.9 | 43.5 | 43.3 | 37.2 |
| ModernBERT | + CLS RetroMAE | 39.8 | 42.8 | 44.4 | 47.9 | 45.0 | 24.9 | 44.3 | 42.1 | 37.1 |
| ModernBERT | LMK(Var/32) | 40.3 | 44.0 | 45.8 | 48.6 | 46.1 | 35.0 | 47.0 | 62.4 | 48.1 |
| ModernBERT | + LMK RetroMAE | 40.2 | 41.3 | 42.5 | 47.8 | 43.9 | 31.8 | 46.2 | 66.4 | 48.1 |
Table 6 (원논문): RetroMAE 사전학습 후 파인튜닝했을 때 CLS와 LMK 풀링의 성능(gte-en-mlm-base, ModernBERT-base).
gte-en에서는 LMK RetroMAE의 효과가 뚜렷하다. LMK 파인튜닝만 했을 때 장문 44.8이던 게 LMK RetroMAE를 거치면 49.2로 오르고, MLDR도 31.7에서 36.6으로 뛴다. 사전학습 단계에서 landmark 구조를 미리 학습해두면 그만큼 표현이 더 좋아지는 것이다. 반면 ModernBERT에서는 CLS든 LMK든 RetroMAE의 추가 이득이 뚜렷하지 않다(장문 48.1로 동일). ModernBERT가 이미 강한 사전학습을 거친 모델이라 RetroMAE의 여지가 적은 것으로 보인다. 흥미로운 대조는 CLS RetroMAE인데, ModernBERT에서 장문 37.2 → 37.1로 사실상 제자리다. CLS 표현으로 복원을 학습해도 위치 편향이 그대로라 장문 이득이 없는 셈이다. 요약하면 LMK는 사전학습 파이프라인에 무리 없이 얹히고, 모델에 따라 추가 이득까지 준다.
9. LMK는 무엇을 포착하는가
마지막 분석은 LMK 임베딩이 실제로 무엇을 담는지를 들여다본다. LMK 풀링은 시퀀스를 고정 크기 청크로 나눠 청크마다 LMK 표현 하나를 만든다. 각 LMK는 문서 전체의 영향을 받은 contextualized 표현이다. 그렇다면 이 표현이 자기 주변 청크의 로컬 정보를 얼마나 보존할까?
이를 재려고, 각 청크를 독립적으로 인코딩한 non-contextualized 임베딩과, 문서 전체 문맥을 받은 contextualized LMK 임베딩을 비교한다. MLDR(En)에서 256개 이상 청크를 가진 긴 문서를 뽑아, 각 LMK 임베딩에 가장 가까운 청크 임베딩을 검색하는 방향성 Hit@를 측정한다. LMK 토큰은 왼쪽 청크와 오른쪽 청크 사이에 있으므로, 방향별 검색 편향도 잴 수 있다.
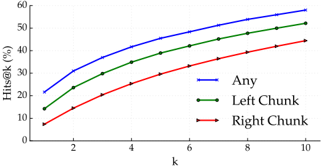
Figure 4: 길이 8,192, LMK granularity 32(청크 248개 이상) 시퀀스에서 LMK 토큰 임베딩과 왼쪽/오른쪽/전체 청크 임베딩 간 Hits@k. (원논문)
Figure 4에서 두 가지가 읽힌다. 첫째, 왼쪽이든 오른쪽이든 각 청크 임베딩이 대응 LMK 임베딩을 Hit@10 기준 58% 이상으로 찾아낸다(Any 곡선은 더 높다). 문서 전체 문맥으로 뒤섞였는데도 LMK가 자기 주변의 로컬 의미 정보를 상당히 보존한다는 뜻이다. mean 풀링이 salient 특징을 뭉개버리는 것과 대비되는 지점이다. 둘째, 왼쪽 청크(초록) 곡선이 오른쪽 청크(빨강) 곡선보다 일관되게 위에 있다. LMK가 오른쪽 이웃보다 왼쪽 이웃, 즉 이전 문맥에 더 끌린다는 방향성 편향이 있는 것이다. 이건 landmark 토큰이 자기 앞 청크 뒤에 삽입되는 구조와, 앞쪽 문맥을 더 무겁게 반영하는 어텐션 성향이 겹친 결과로 볼 수 있다. 로컬 정보를 지키면서 전역 문맥도 흡수한다는 이 관찰이, LMK가 표현 용량과 분별력 사이에서 균형을 잡는다는 저자들의 주장을 뒷받침한다.
10. 부록 상세 결과
부록은 본문 결과를 다른 모델, 다른 데이터, 언어별로 확장한다. 전부 훑는다.
10.1 gte-en-mlm-base의 영어 결과 (Table 7, 8)
먼저 MSMarco passage 학습 gte-en 결과다. Table 1의 ModernBERT판에 대응한다.
| Pool | FT Gran. | Eval Gran. | MSMarco Dev | BEIR | MTEBv2 | MIRACL | Avg.단문 | MLDR | COIR | LongEmbed | Avg.장문 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| CLS | - | - | 42.3 | 44.0 | 44.7 | 47.9 | 45.5 | 27.3 | 36.6 | 52.0 | 38.6 |
| CLS→MultiCLS | - | 128 | 42.8 | 42.5 | 42.5 | 42.6 | 42.5 | 31.0 | 36.9 | 60.5 | 42.8 |
| Mean | - | - | 42.1 | 42.4 | 43.9 | 45.6 | 44.0 | 31.4 | 36.6 | 60.8 | 42.9 |
| Latent Attn | - | - | 42.0 | 42.3 | 43.8 | 44.9 | 43.7 | 30.2 | 36.8 | 61.7 | 42.9 |
| Mean@k | 64 | 64 | 41.9 | 43.2 | 44.2 | 46.8 | 44.7 | 29.3 | 37.1 | 56.0 | 40.8 |
| LMK | 32 | 32 | 42.8 | 44.2 | 44.9 | 46.4 | 45.2 | 31.0 | 38.0 | 63.9 | 44.3 |
| LMK | 128 | 128 | 43.2 | 44.2 | 44.9 | 47.1 | 45.4 | 32.9 | 37.6 | 64.8 | 45.1 |
| LMK | 256 | 256 | 43.0 | 44.0 | 44.6 | 49.0 | 45.9 | 34.6 | 36.8 | 59.7 | 43.7 |
| LMK | Var | 256 | 43.0 | 44.2 | 44.8 | 48.1 | 45.7 | 31.7 | 37.6 | 65.2 | 44.8 |
| LMK | Sent | Sent | 42.6 | 44.3 | 45.0 | 46.9 | 45.4 | 33.7 | 36.6 | 61.0 | 43.8 |
Table 7 (원논문): MSMarco passage로 파인튜닝한 gte-en-mlm-base의 벤치마크 비교(대표 행 발췌, Variable @32/64/128 행은 각각 장문 43.5/44.1/44.7).
ModernBERT와 같은 그림이다. LMK가 단문을 지키면서 장문에서 CLS(38.6)를 크게 앞선다(LMK-128 45.1). MultiCLS는 여기서는 완전히 붕괴하진 않지만(42.8) 여전히 LMK보다 낮다. Variable로 학습해 granularity를 바꿔 쓰는 유연성도 재확인된다.
다음은 MSMarco document 학습 gte-en 결과다.
| Pool | FT/Eval Gran. | MSMarco Dev | BEIR | MTEBv2 | MIRACL | Avg.단문 | MLDR | COIR | LongEmbed | Avg.장문 |
|---|---|---|---|---|---|---|---|---|---|---|
| CLS | - | 28.7 | 37.6 | 39.0 | 32.3 | 36.3 | 29.1 | 30.1 | 49.1 | 36.1 |
| Mean | - | 28.3 | 36.3 | 37.7 | 29.0 | 34.3 | 30.0 | 32.5 | 61.6 | 41.4 |
| LMK | 128 | 28.6 | 36.7 | 37.5 | 30.1 | 34.8 | 30.0 | 31.6 | 63.1 | 41.6 |
| LMK | Var/32 | 28.9 | 37.1 | 38.1 | 32.1 | 35.8 | 31.4 | 30.9 | 59.8 | 40.7 |
| LMK | Var/64 | 28.5 | 36.9 | 37.9 | 31.0 | 35.3 | 31.1 | 30.6 | 60.4 | 40.7 |
| LMK | Var/128 | 28.5 | 37.1 | 38.0 | 31.1 | 35.4 | 30.3 | 30.4 | 60.0 | 40.2 |
| LMK | Var/256 | 28.5 | 36.9 | 37.9 | 30.4 | 35.1 | 29.7 | 30.1 | 59.9 | 39.9 |
Table 8 (원논문): MSMarco document로 파인튜닝한 gte-en-mlm-base의 벤치마크 비교.
부록 설명에 따르면 이 세팅에서 LMK가 in-domain 최고, 단문은 CLS가 LMK를 약 0.5점 앞서고, 장문은 mean이 최고(LMK가 근소하게 뒤따름), CLS는 장문에서 크게 뒤처진다. 앞서 Figure 3에서 봤듯 MSMarco document가 진짜 장문이 아니라서, 이 데이터로는 landmark 구조의 이점이 mean 대비 충분히 살아나지 못하는 것으로 읽힌다.
10.2 CLS가 LongEmbed에서 잘 보이는 이유: Passkey의 착시 (Table 9)
7.1절에서 "CLS의 LongEmbed 점수는 Passkey 덕분"이라 했는데, 그 근거가 Table 9다.
| Pool | NarrativeQA | QMSum | WikiMQA | SummScreenFD | Needle P@1 | Passkey P@1 | Avg. |
|---|---|---|---|---|---|---|---|
| CLS | 30.9 | 32.3 | 75.0 | 82.4 | 46.5 | 82.8 | 58.3 |
| Mean | 47.1 | 35.7 | 81.1 | 86.8 | 48.3 | 75.8 | 62.4 |
| LMK(Var/32) | 44.4 | 34.7 | 79.8 | 89.5 | 41.8 | 58.5 | 58.1 |
Table 9 (원논문): MSMarco document로 파인튜닝한 modernbert-base의 LongEmbed 서브태스크별 성능.
LongEmbed를 서브태스크로 쪼개보면 CLS의 실체가 드러난다. CLS는 Passkey(82.8)에서만 유독 높고, NarrativeQA(30.9), QMSum(32.3) 같은 실질적 장문 검색에서는 mean/LMK에 크게 뒤진다. Passkey는 긴 문맥 속 짧은 키를 찾는 인위적 태스크라, 앞부분 편향이 오히려 안 해로운 특수 케이스다. 평균만 보면 CLS가 그럴듯해 보이지만, 태스크를 나눠 보면 CLS의 장문 약점이 그대로 노출된다. 단, 이 표에서는 LMK가 Passkey에서 58.5로 낮아 평균이 CLS와 비슷해졌다는 점은 솔직히 LMK에 불리한 대목이다. LMK가 모든 장문 태스크에서 무조건 최고는 아니라는 것이다.
10.3 LongEmbed 데이터셋별 외삽 곡선 (Figure 5)
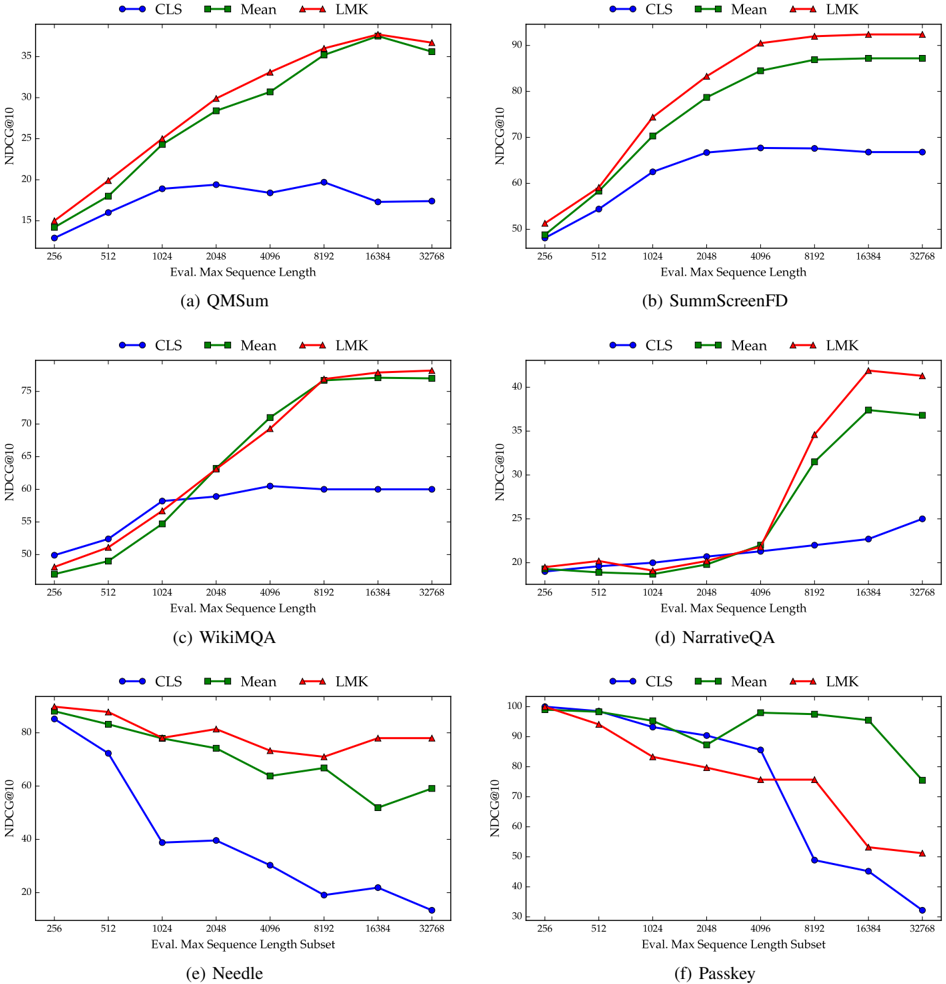
Figure 5: MSMarco Passage로 파인튜닝한 ModernBERT-base의 LongEmbed 데이터셋별 장문 검색 성능. 평가 최대 길이(x축)를 늘려가며 측정. (a) QMSum, (b) SummScreenFD, (c) WikiMQA, (d) NarrativeQA, (e) Needle, (f) Passkey. (원논문)
Figure 5는 6개 LongEmbed 서브태스크 각각에서 평가 길이를 256~32,768로 늘려가며 세 풀링을 비교한 곡선 모음이다. (a)~(d)의 실질적 검색 태스크에서 공통 패턴이 보인다. LMK(빨강)와 mean(초록)은 길이가 늘수록 성능이 계속 오르는데, CLS(파랑)는 특정 길이에서 정체되거나 꺾인다. 예를 들어 (b) SummScreenFD에서 LMK는 90 이상까지 오르지만 CLS는 67 부근에서 평평해진다. (d) NarrativeQA에서는 4k를 넘기며 LMK가 급등해 40 이상, mean 37, CLS는 25에 그친다. LMK가 CLS의 장문 외삽 실패를 확실히 극복한다는 걸 태스크별로 보여준다.
반대로 (e) Needle과 (f) Passkey는 예외적이다. 두 태스크 모두 길이가 늘수록 세 방법 다 성능이 떨어지는데, (f) Passkey에서는 mean이 가장 잘 버티고(32k에서도 76 부근) LMK와 CLS가 함께 하락한다. Passkey/Needle이 "긴 문맥 속 특정 토큰 하나 찾기"라 분산 표현이 오히려 불리한 태스크라는 걸 감안하면 이해되는 결과다. LMK의 강점은 정보가 문서 전체에 퍼진 실질 장문 검색에 있고, 단일 needle 찾기에는 mean이 나을 수 있다는 뉘앙스를 이 그림이 정직하게 드러낸다.
10.4 다국어 언어별 상세 (Table 10, 11, 12)
Table 2의 다국어 결과를 언어별로 펼친 것이다. 먼저 MIRACL-HN(18개 언어) NDCG@10이다.
| Pool | ara | ben | deu | eng | fas | fin | fra | hin | ind | jpn | kor | rus | spa | swa | tel | tha | yor | zho | avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| CLS | 66.1 | 63.4 | 47.4 | 48.1 | 49.5 | 68.4 | 51.6 | 44.5 | 48.4 | 59.2 | 61.7 | 58.0 | 49.2 | 68.2 | 75.9 | 69.1 | 58.4 | 50.1 | 57.6 |
| Mean | 65.0 | 61.4 | 45.7 | 44.5 | 50.5 | 67.3 | 48.8 | 43.6 | 48.2 | 58.3 | 61.4 | 54.7 | 49.3 | 68.8 | 77.3 | 66.8 | 50.1 | 47.2 | 56.1 |
| Latent | 65.5 | 62.9 | 46.2 | 45.6 | 50.6 | 67.7 | 49.1 | 43.2 | 48.8 | 58.6 | 61.0 | 56.0 | 50.5 | 68.9 | 77.4 | 67.5 | 51.2 | 48.7 | 56.6 |
| LMK(128) | 67.2 | 65.6 | 45.5 | 45.2 | 51.0 | 68.9 | 50.8 | 44.9 | 50.3 | 57.5 | 61.6 | 56.3 | 50.2 | 71.0 | 78.1 | 68.9 | 59.5 | 52.1 | 58.0 |
| LMK(Var/32) | 66.5 | 63.7 | 45.8 | 44.7 | 50.5 | 69.1 | 50.0 | 44.8 | 50.1 | 59.9 | 60.9 | 57.6 | 49.8 | 69.9 | 77.1 | 68.9 | 61.2 | 49.8 | 57.8 |
Table 10 (원논문): mmBERT-base의 MIRACL-HN(18) 언어별 NDCG@10. LMK Variable @64/@128/@256의 평균은 각각 57.9/57.9/57.7. (대표 5개 행 발췌)
단문 성격의 MIRACL에서는 언어 전반에 걸쳐 풀링 간 차이가 크지 않다. 그래도 LMK-128이 평균 58.0으로 최고이고, 특히 저자원 언어인 yor(요루바)에서 CLS 58.4 대 LMK 59.5, ben(벵골어)에서 63.4 대 65.6으로 조금씩 앞선다. 단문에서도 LMK가 손해는 아니라는 Table 2의 결론이 언어별로도 유지된다.
다음은 진짜 장문인 MLDR(13개 언어) NDCG@10이다.
| Pool | ara | cmn | deu | eng | fra | hin | ita | jpn | kor | por | rus | spa | tha | avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| CLS | 21.9 | 9.0 | 13.6 | 8.5 | 42.1 | 13.1 | 35.7 | 28.5 | 13.3 | 50.9 | 35.3 | 45.0 | 7.2 | 24.9 |
| Mean | 11.9 | 7.4 | 14.3 | 6.0 | 7.9 | 11.2 | 15.3 | 30.2 | 5.4 | 36.3 | 26.5 | 39.8 | 9.4 | 17.0 |
| Latent | 15.5 | 6.0 | 18.0 | 4.3 | 11.8 | 11.3 | 20.9 | 30.8 | 6.3 | 41.5 | 30.9 | 46.2 | 11.1 | 19.6 |
| LMK(128) | 31.0 | 15.5 | 31.5 | 24.7 | 60.9 | 19.3 | 48.3 | 36.8 | 21.2 | 63.4 | 46.4 | 60.6 | 23.5 | 37.2 |
| LMK(Var/32) | 30.8 | 16.9 | 33.2 | 27.1 | 60.3 | 20.2 | 51.8 | 39.3 | 25.2 | 63.7 | 48.2 | 63.1 | 23.8 | 38.7 |
| LMK(Var/64) | 31.0 | 16.3 | 32.8 | 27.0 | 60.4 | 19.5 | 51.8 | 38.6 | 25.4 | 63.9 | 47.9 | 63.6 | 23.6 | 38.6 |
| LMK(Var/128) | 30.4 | 15.6 | 32.3 | 27.2 | 60.9 | 18.5 | 52.1 | 39.5 | 24.0 | 63.1 | 47.7 | 63.4 | 23.7 | 38.3 |
| LMK(Var/256) | 30.2 | 14.3 | 32.4 | 27.4 | 60.7 | 18.2 | 51.8 | 39.8 | 23.1 | 64.0 | 46.2 | 63.6 | 21.8 | 38.0 |
Table 11 (원논문): mmBERT-base의 MLDR(13) 언어별 NDCG@10.
이 표가 다국어 장문에서 LMK의 우위를 가장 극적으로 보여준다. 거의 모든 언어에서 LMK가 CLS/Mean/Latent를 두 배 안팎으로 앞선다. eng(영어)에서 CLS 8.5, Mean 6.0인데 LMK는 27.1이고, fra(프랑스어)는 CLS 42.1 대 LMK 60.3, deu(독일어)는 13.6 대 33.2다. mean이 여러 언어에서 CLS보다도 낮아 평균 17.0에 그치는 것도 눈에 띈다. 다국어 장문에서는 mean의 salient 희석이 특히 치명적으로 작동하는 셈이다. LMK가 언어를 가리지 않고 장문 표현을 안정적으로 만든다는 게 이 표의 메시지다.
마지막으로 제로샷 장문 분류 Multi-EURLEX(23개 언어) F1이다. 원표의 언어별 셀은 파싱 잡음이 있어 대표 언어와 평균 위주로 정리한다.
| Pool | deu | eng | fra | ita | spa | pol | 평균(23) |
|---|---|---|---|---|---|---|---|
| CLS | 27.2 | 26.8 | 27.3 | 27.3 | 26.4 | 27.7 | 27.5 |
| Mean | 27.3 | 27.9 | 27.0 | 26.7 | 25.8 | 26.5 | 27.5 |
| Latent | 28.1 | 27.3 | 27.4 | 27.2 | 27.6 | 26.9 | 28.0 |
| LMK(128) | 31.5 | 30.0 | 29.4 | 30.3 | 30.5 | 31.9 | 31.5 |
| LMK(Var/32) | 34.1 | 32.1 | 31.6 | 32.5 | 33.2 | 34.0 | 33.7 |
| LMK(Var/64) | 34.0 | 31.8 | 31.3 | 32.3 | 32.8 | 33.8 | 33.4 |
| LMK(Var/128) | 34.1 | 31.6 | 31.2 | 32.4 | 32.6 | 33.8 | 33.2 |
| LMK(Var/256) | 34.0 | 31.5 | 30.9 | 32.3 | 32.4 | 33.4 | 33.0 |
Table 12 (원논문): 파인튜닝한 mmBERT-base의 Multi-EURLEX 23개 언어 제로샷 장문 분류 F1(최대 길이 8192). 언어별 값은 대표 6개 발췌, 평균은 23개 언어 전체 기준.
제로샷 법률 문서 분류, 즉 학습 때 전혀 못 본 도메인의 장문 태스크다. 여기서 기존 풀링은 27~28대에 갇혀 있는 반면 LMK-Variable(32)은 33.7로, 언어를 불문하고 5~6점씩 앞선다. 개별 언어를 봐도 deu 27.2 대 34.1, spa 26.4 대 33.2처럼 격차가 일정하다. 7.3절에서 강조한 "out-of-domain 장문에서 LMK만 편향에 강하다"는 주장을, 완전히 다른 태스크(검색이 아니라 분류)에서도 재확인해준다는 점에서 설득력이 크다.
10.5 RetroMAE 상세 결과 (Table 13, 14)
8절 RetroMAE 실험을 granularity별로 펼친 표들이다. 먼저 gte-en-mlm-base다.
| Pretrain/FT/Eval Gran. | MSMarco Dev | MRR@10 | BEIR | MTEBv2 | MIRACL-HN EN | MLDR EN | COIR | LongEmbed | Avg.장문 |
|---|---|---|---|---|---|---|---|---|---|
| CLS | 42.5 | 36.1 | 44.7 | 45.5 | 47.4 | 31.2 | 42.1 | 60.8 | 44.7 |
| LMK 64 | 42.6 | 36.2 | 44.5 | 45.5 | 46.8 | 36.7 | 43.0 | 66.1 | 48.6 |
| LMK 128 | 42.8 | 36.5 | 44.2 | 44.8 | 47.3 | 34.6 | 43.2 | 65.7 | 47.8 |
| LMK 256 | 42.8 | 36.3 | 44.5 | 45.1 | 48.7 | 36.0 | 42.8 | 67.6 | 48.8 |
| LMK Var → eval 32 | 42.6 | 36.1 | 44.3 | 45.4 | 46.7 | 37.8 | 43.5 | 68.4 | 49.9 |
| LMK Var → eval 64 | 42.5 | 36.2 | 44.3 | 45.3 | 46.5 | 38.1 | 43.3 | 68.4 | 49.9 |
| LMK Var → eval 128 | 42.7 | 36.3 | 44.4 | 45.4 | 47.1 | 37.5 | 43.2 | 68.1 | 49.6 |
| LMK Var → eval 256 | 42.6 | 36.2 | 44.5 | 45.4 | 48.4 | 36.6 | 43.3 | 67.7 | 49.2 |
| LMK Sentence | 42.5 | 35.9 | 44.5 | 45.3 | 47.4 | 36.2 | 42.2 | 63.6 | 47.3 |
Table 13 (원논문): CLS 또는 LMK로 사전학습 후 MSMarco passage로 파인튜닝한 gte-en-mlm-base의 벤치마크 비교.
LMK 사전학습을 거친 모든 granularity가 CLS 사전학습(장문 44.7)을 앞서고, Variable로 사전학습하면 추론 granularity를 바꿔가며 49.9까지 낸다. 사전학습부터 landmark 구조를 학습해두는 게 장문에 확실히 이롭다는 걸 세밀하게 뒷받침한다.
다음은 ModernBERT-base다.
| Pretrain Gran. | FT/Eval | MSMarco Dev | BEIR | MTEBv2 | MIRACL-HN EN | Avg.단문 | MLDR EN | COIR | LongEmbed | Avg.장문 |
|---|---|---|---|---|---|---|---|---|---|---|
| CLS | CLS | 39.8 | 42.8 | 44.4 | 47.9 | 45.0 | 24.9 | 44.3 | 42.1 | 37.1 |
| LMK 64 | LMK 32 | 40.3 | 42.5 | 44.1 | 47.7 | 44.8 | 31.9 | 46.8 | 59.8 | 46.2 |
| LMK Var | LMK 32 | 40.2 | 41.3 | 42.5 | 47.8 | 43.9 | 31.8 | 46.2 | 66.4 | 48.1 |
| LMK Sentence | LMK Sent | 40.0 | 42.0 | 43.2 | 46.9 | 44.0 | 32.3 | 43.4 | 64.9 | 46.9 |
Table 14 (원논문): CLS 또는 LMK로 사전학습 후 MSMarco passage로 파인튜닝한 ModernBERT-base의 벤치마크 비교.
ModernBERT에서는 CLS 사전학습이 장문 37.1인데 LMK 사전학습은 46~48로 크게 앞선다. Table 6에서 "ModernBERT는 RetroMAE 추가 이득이 작다"고 했지만, 그건 LMK 파인튜닝 자체가 이미 강하기 때문이지 LMK 사전학습이 CLS 사전학습보다 못하다는 뜻은 아니다. CLS 대비로는 LMK 사전학습이 여전히 압도적이다.
10.6 MTEB-v2 태스크별 (Table 15)
임베딩 범용성을 보려고 MTEB-v2를 태스크 유형별로 나눈 표다.
| Model | Pool | Class.(8) | Clust.(8) | PairCls.(3) | Rerank.(2) | Retr.(10) | STS(9) | Summ.(1) | Avg.(41) |
|---|---|---|---|---|---|---|---|---|---|
| gte-en | CLS | 69.5 | 41.6 | 83.3 | 44.8 | 44.7 | 77.1 | 27.6 | 58.5 |
| gte-en | Mean | 70.1 | 40.9 | 83.3 | 44.5 | 44.9 | 75.9 | 30.4 | 58.3 |
| gte-en | LMK 256 | 70.0 | 41.5 | 83.3 | 44.9 | 44.6 | 76.5 | 27.2 | 58.4 |
| ModernBERT | CLS | 69.5 | 41.6 | 80.4 | 44.1 | 44.2 | 76.0 | 24.2 | 57.8 |
| ModernBERT | Mean | 69.6 | 41.2 | 79.4 | 43.6 | 43.3 | 75.3 | 24.8 | 57.3 |
| ModernBERT | LMK 32 | 69.9 | 42.2 | 80.2 | 44.3 | 45.9 | 74.9 | 25.6 | 58.1 |
| ModernBERT | LMK Var/128 | 69.9 | 42.5 | 80.5 | 44.1 | 45.1 | 75.2 | 25.7 | 58.1 |
Table 15 (원논문): gte-en-mlm-base와 ModernBERT-base(MSMarco Passage 학습)의 MTEB-v2 태스크별 평균.
이 표의 요지는 "LMK가 장문만 챙기느라 범용 임베딩 품질을 잃지 않았다"는 것이다. 분류, 클러스터링, STS 등 대부분 단문 위주 태스크에서 LMK는 CLS/Mean과 대등하다. ModernBERT에서는 오히려 LMK가 종합 평균 58.1로 CLS(57.8), Mean(57.3)을 앞서고, 특히 Retrieval에서 45.9로 최고다. 풀링을 바꾼 게 특정 태스크만 좋아지고 다른 데서 손해 보는 제로섬이 아니라는 걸 보여준다.
10.7 학습 데이터의 길이 통계 (Table 16, 17)
마지막으로 왜 장문 학습이 어려운지를 데이터로 못 박는 두 표다. 먼저 영어 dense 학습에 쓰는 bge-en-icl 데이터의 문자 길이 통계다(일부 발췌).
| Dataset | Count | Median | P25 | P75 |
|---|---|---|---|---|
| msmarco document | 367,013 | 3,897 | 2,160 | 7,758 |
| msmarco passage | 485,823 | 336 | 281 | 454 |
| fever | 29,096 | 1,633 | 859 | 2,496 |
| arXiv abstract | 20,000 | 825 | 581 | 1,135 |
| hotpotqa | 84,516 | 396 | 270 | 559 |
| nq | 58,568 | 624 | 599 | 652 |
| squad | 87,599 | 693 | 559 | 895 |
| nli | 275,601 | 37 | 27 | 55 |
| eli5 | 325,475 | 393 | 232 | 621 |
| banking classification | 10,003 | 35 | 27 | 41 |
Table 16 (원논문): bge-en-icl 데이터셋의 positive 문서 문자 길이 통계(count, median, P25, P75). 문자당 4~5자를 토큰으로 잡아도 대부분 median이 250 토큰 이하. (33개 중 대표 10개 발췌)
토큰당 4~5자로 보수적으로 잡아도 대부분 데이터셋의 median 시퀀스가 250 토큰 이하다. msmarco document만 예외적으로 길지만(median 3,897자) 그마저 P75가 7,758자로 2,000 토큰 안팎이다. 현대 임베딩 학습 코퍼스가 아무리 다양해져도, 영어 검색 학습 데이터에는 여전히 진짜 장문 지도(supervision)가 희소하다는 걸 수치로 보여준다. LMK가 짧은 데이터로 학습해도 장문 외삽을 잘한다는 게 그래서 실용적으로 중요하다.
다국어 학습에 쓰는 bge-m3 데이터도 비슷하다(일부 발췌).
| Dataset | Count | Median | P25 | P75 |
|---|---|---|---|---|
| MLDR (en) | 10,000 | 18,229 | 10,553.8 | 25,636.25 |
| MLDR (de) | 1,847 | 24,850 | 15,070 | 29,238.5 |
| MLDR (zh) | 10,000 | 6,079.5 | 3,610 | 8,624.75 |
| MSMARCO | 485,905 | 336 | 281 | 454 |
| NQ | 58,568 | 624 | 599 | 652 |
| SQuAD | 87,599 | 693 | 559 | 895 |
| DuReader | 80,416 | 296 | 258 | 411 |
| HotpotQA | 84,516 | 396 | 270 | 559 |
| MIRACL (en) | 2,863 | 661 | 446 | 901 |
| EN-NLI | 274,951 | 37 | 27 | 55 |
Table 17 (원논문): bge-m3 데이터셋의 positive 문서 문자 길이 통계. MLDR만 다른 벤치마크보다 훨씬 길다. (47개 중 대표 10개 발췌)
MLDR 계열만 median이 6,000~25,000자로 압도적으로 길고, 나머지는 수백 자 수준이다. 부록 설명에 따르면 MLDR은 전체 약 300만 학습 쌍 중 4.2만 쌍뿐이라 학습 전반에 미치는 영향이 작다. 그래서 MLDR 없이 CLS/mean으로 학습하면 장문 일반화가 잘 안 되고, MLDR을 넣어도 그 소수 비중 탓에 기존 풀링은 여전히 장문 외삽이 약하다. 이 데이터 현실이 "왜 풀링 구조로 장문 문제를 풀어야 하는가"에 대한 배경이 된다. 데이터를 늘리는 건 비싸고 느리지만, 풀링을 바꾸는 건 공짜에 가깝기 때문이다.
11. 강점과 한계
강점
- 진단과 처방의 정합성. 이 논문의 가장 큰 미덕은 RoPE long-term decay라는 이론적 원인(3.1절)과, 이를 우회하는 landmark 구조(4절), 그리고 어텐션 분포로 편향을 직접 보인 Figure 2가 하나의 논리로 이어진다는 점이다. "왜 안 되는지"를 먼저 정확히 짚었기 때문에 처방이 단순할 수 있었다.
- 반론을 스스로 처리. "장문에서 이긴 건 데이터가 짧아서 아니냐"는 반박을 7절에서 정면으로 다뤄, 긴 데이터로 학습해도 out-of-domain 장문에서는 CLS가 못 따라온다(Table 4, 5)는 걸 보였다. 자기 주장에 대한 가장 강한 반론을 실험으로 막은 셈이다.
- 범용성 유지. LMK가 장문만 챙기고 단문/범용 임베딩을 희생하지 않는다는 걸 Table 1, 15로 확인했다. 오히려 단문 평균이 CLS와 대등하거나 앞선다.
- 파이프라인 호환성. RetroMAE 사전학습(Table 6, 13, 14), 여러 인코더(gte, ModernBERT, mmBERT), 다국어(Table 2, 10~12)에 모두 얹힌다. 코드 몇 줄로 기존 학습 스택에 넣을 수 있다는 실용성이 크다.
- 정직한 실패 보고. Passkey/Needle(Table 9, Figure 5e/f)에서 LMK가 mean에 밀리는 결과를 숨기지 않았다.
한계 및 아쉬운 점
- granularity가 하이퍼파라미터로 남는다. Variable chunking이 강건성을 주긴 하지만, 결국 추론 때 태스크에 맞는 granularity를 골라야 최적이다. 32~256 사이 선택이 MLDR/LongEmbed 트레이드오프를 만든다(Table 1). "granularity를 자동으로 정하는" 메커니즘은 아직 없다.
- needle 유형 태스크의 약점. 정보가 한 토큰에 집중된 Passkey에서는 분산 표현인 LMK가 오히려 불리하다(Table 9의 58.5, Figure 5f). 실무에서 검색 대상이 "긴 문맥 속 단일 사실"이라면 LMK가 답이 아닐 수 있다.
- 모델 의존성. RetroMAE 이득이 gte-en에서는 크지만 ModernBERT에서는 미미했다(Table 6). 이득의 크기가 백본에 따라 달라지는 이유에 대한 분석은 얕다.
- 왜 SEP을 재활용하는가에 대한 통제 실험 부재. landmark로 SEP 토큰을 쓴다고 했는데, 완전히 새로운 special 토큰을 추가했을 때와 비교한 ablation은 보이지 않는다. SEP 재활용이 기존 SEP 의미와 충돌하지 않는지에 대한 검증이 있었으면 좋았다.
- 효율성 수치의 부재. "오버헤드가 작다"고 정성적으로 말하지만(4.4절), 실제 지연 시간이나 처리량을 CLS 대비로 잰 표는 없다. 32K에서 landmark 256개 추가가 실측 latency에 얼마나 영향을 주는지 궁금하다.
12. 마치며
이 논문의 결론은 한 문장으로 압축된다. 문서를 벡터 하나로 줄일 때, 그 마지막 압축(풀링)을 어떻게 하느냐가 장문 검색의 성패를 가른다는 것이다. [CLS]는 RoPE의 long-term decay 탓에 앞부분에 집착하고, mean은 salient 특징을 희석하며, latent attention은 mean의 한계를 비싸게 물려받는다. 이 세 실패를 landmark 토큰 몇 개로 동시에 우회한다는 게 LMK의 아이디어다. 각 landmark가 전역 문맥을 흡수하면서도 문서 곳곳에 흩어져 로컬 정보를 지키니, CLS의 적응적 selector 장점과 mean의 다중 평가 지점 장점을 함께 취한다.
특히 인상적인 건, 512 토큰으로만 학습해도 32K까지 안정적으로 외삽한다는 점이다. 진짜 장문 학습 데이터가 희소하다는 현실(Table 16, 17)에서 이건 큰 실용적 가치다. 데이터를 늘리는 대신 풀링을 바꿔 문제를 푸는 접근이라, 기존 학습 스택에 부담 없이 얹힌다.
가져갈 교훈은 두 가지다. 하나는 임베딩 모델을 장문에 쓸 계획이라면 풀링 선택을 기본값으로 두지 말고 의심해봐야 한다는 것. 다른 하나는, 아키텍처의 미세한 구조적 편향(여기서는 위치 편향)이 특정 응용에서 조용히 성능을 갉아먹을 수 있으며, 그 편향의 원인을 수학적으로 짚으면 의외로 단순한 처방이 나온다는 것이다. 저자들이 결론에서 언급하듯 이 방법은 multi-vector 임베딩이나 청킹 기반 RAG로도 확장 여지가 있다. 다음 임베딩 모델을 고를 때 "풀링이 뭔가요"를 한 번 물어볼 이유가 생긴 셈이다.
References
- Doshi, M., Trivedi, A., Kumar, V., Awasthy, P., Li, Y., Sen, J., Florian, R., Joshi, S. (2026). LMK > CLS: Landmark Pooling for Dense Embeddings. arXiv:2601.21525.
- Luo, K. et al. (2024). Landmark Embedding: A Chunking-Free Embedding Method for Retrieval Augmented Long-Context LLMs. ACL 2024.
- Su, J. et al. (2024). RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing.
- Warner, B. et al. (2025). Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder (ModernBERT). ACL 2025.
- Lee, C. et al. (2025). NV-Embed: Improved Techniques for Training LLMs as Generalist Embedding Models. ICLR 2025.
- Chen, J. et al. (2024). BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings.
- Xiao, S. et al. (2022). RetroMAE: Pre-Training Retrieval-Oriented Language Models via Masked Auto-Encoder. EMNLP 2022.
- Zhu, D. et al. (2024). LongEmbed: Extending Embedding Models for Long Context Retrieval. EMNLP 2024.
- Chalkidis, I. et al. (2021). MultiEURLEX: A Multi-Lingual and Multi-Label Legal Document Classification Dataset. EMNLP 2021.