논문 리뷰
논문 리뷰: LiveFigure: Generating Editable Scientific Illustration with VLM Agents
연구 도식을 픽셀이 아니라 코드로 그린다. 사람 디자이너의 작업 흐름을 흉내 낸 VLM 에이전트가 파워포인트 소스 파일을 직접 생성해서, 벡터 형식으로 편집 가능한 논문용 그림을 만들어내는 프레임워크.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | LiveFigure: Generating Editable Scientific Illustration with VLM Agents |
| 저자 | Chenyang Shao, Jiahe Liu, Fengli Xu*, Yong Li (Tsinghua University, BNRist / Zhongguancun Academy) |
| 학회/저널 | ICML 2026 (PMLR 306), Seoul |
| 논문 링크 | arXiv:2605.23527 |
| 코드 | github.com/tsinghua-fib-lab/LiveFigure |
1. 들어가며
논문을 써 본 사람이라면 누구나 겪는 고통이 있다. 방법론 자체보다 그 방법론을 설명하는 개요 그림(overview figure) 한 장 만드는 데 하루를 통째로 날려본 경험이다. Adobe Illustrator를 켜고 박스를 하나하나 그리고, 화살표를 연결하고, 리뷰어 코멘트가 오면 모듈 위치를 다시 조정하고, 오타 하나 고치려고 텍스트 상자를 다시 찾는다. 도식 한 장에 담긴 정보량은 본문 몇 페이지에 맞먹지만("한 장의 그림은 때로 만 단어의 가치가 있다"는 Larkin & Simon의 1987년 고전이 괜히 나온 게 아니다), 그 그림을 만드는 노동은 연구 그 자체와 무관하게 연구자의 시간을 잡아먹는다.
그래서 최근 몇 년간 폭발적으로 발전한 이미지 생성 모델이 이 병목을 풀어줄 것처럼 보였다. GPT-Image-1.5, Gemini의 Nano Banana 같은 모델은 사진 수준의 이미지를 프롬프트만으로 뽑아낸다. 그런데 막상 과학 도식 생성에 갖다 대면 근본적인 벽에 부딪힌다. 이 모델들은 픽셀 기반의 래스터(raster) 이미지를 한 번에 통째로 렌더링하는 방식이라, 그림을 "편집 가능한 의미 단위들의 조합"이 아니라 "쪼갤 수 없는 하나의 시각적 덩어리"로 취급하기 때문이다. 박스 하나를 옮기고 싶어도, 오타 하나를 고치고 싶어도 방법이 없다. 자연어로 "오른쪽 아래 weighted Sum 박스를 Value 박스에 맞춰 아래로 내려줘"라고 지시하면, 모델은 그림 전체를 처음부터 다시 생성해버린다. 그 과정에서 멀쩡했던 다른 부분까지 망가진다.
이 논문이 제안하는 LiveFigure는 문제의 접근 자체를 뒤집는다. 픽셀을 생성하지 말고, 그림을 그리는 코드를 생성하자는 것이다. 그것도 사람이 하듯이 단계를 나눠서. 참고할 만한 좋은 그림들을 먼저 찾아보고, 전체 레이아웃 청사진을 구상하고, 필요한 아이콘 같은 자산을 만들고, 도구를 써서 조립하고, 마지막으로 눈으로 보면서 어긋난 부분을 고친다. 저자들은 이 인지적 작업 흐름을 명시적으로 모델링해서 VLM 에이전트들에게 나눠 맡긴다. 그 결과물은 놀랍게도 마이크로소프트 파워포인트 소스 파일(.pptx)이다. 이 선택이 처음엔 의아하지만, 읽다 보면 상당히 계산된 결정이라는 게 드러난다.
성능 수치부터 던지자면, LiveFigure가 생성한 그림은 80%가 "17번 이하의 사소한 수동 편집만으로 논문에 실을 수 있는" 상태에 도달했다. 가장 강력한 베이스라인인 Nano Banana의 같은 기준 달성률이 24%인 것과 비교하면 격차가 크다. 사람 평가자들의 이중 맹검 선호도 조사에서도 Nano Banana를 상대로 69%, gpt-image-1.5를 상대로 60%의 승률을 기록했다.
2. 기존 연구의 한계
2.1 범용 이미지 생성 모델
Diffusion Transformer 아키텍처가 스케일업되고 멀티모달 추론이 발전하면서, 범용 이미지 생성 모델은 최근 몇 년 사이 기하급수적으로 좋아졌다. GPT-Image-1.5나 Gemini Nano Banana 같은 최상위 폐쇄형 모델은 사진 수준의 이미지를 높은 미적 완성도로 합성한다. AutoFigure 같은 파이프라인도 이런 파운데이션 모델에 크게 의존한다.
그런데 엄밀한 과학 도식 제작이라는 맥락에서 이 픽셀 기반 종단간(end-to-end) 모델들은 **편집 불가능성(uneditability)**이라는 근본적 문제를 안고 있다. 게다가 텍스트와 논리의 환각도 자주 발생한다. 텍스트가 뭉개지거나, 위상적으로 앞뒤가 안 맞거나, 없는 내용을 지어내는 일이 흔하다. 학술 출판이 요구하는 엄격한 기준을 만족시키지 못한다.
편집 제약을 완화하려는 시도로 구조 인식(structure-aware) 생성 패러다임도 나왔다. OmniGen은 다양한 생성/편집 태스크를 하나의 모델로 통합하려 했지만 출력은 여전히 분해 불가능한 래스터 형식이다. Qwen-Image-Layered는 잠재 공간 분해로 이미지를 여러 RGBA 레이어로 나눠서 객체 단위 이동/삭제를 가능하게 했다. 객체 수준 제어성은 어느 정도 개선했지만, 여전히 본질은 픽셀 기반 연산이다. 레이어 개수와 분리 granularity의 한계 때문에, 과학 도식에 필요한 세밀한 텍스트 편집이나 벡터 수준 스타일 조정은 지원하지 못한다.
2.2 과학 연구를 위한 자율 에이전트
'AI for Science'의 물결 속에서 자율 에이전트는 인간의 연구 능력을 증강하는 핵심 도구로 빠르게 진화하고 있다. 정보 획득과 종합 영역에서는 Deep Research 계열이 방대한 문헌에서 지식을 추출하고 종합한다. 도메인 특화 실행에서는 ChemCrow(화학 합성 계획)나 Data Interpreter(코드 기반 데이터 분석) 같은 도구가 있고, 가설 검증과 최적화에서는 AlphaEvolve 같은 진화 프레임워크가 모델 아키텍처를 자동 탐색한다.
이 시스템들이 지식 생산을 가속하는 건 분명하지만, 발견을 전파하고 소통하는 자동화에는 공백이 있다. 대부분의 어시스턴트가 읽기, 계산하기, 실행하기에 집중하는 동안 시각적 도식의 제작은 여전히 수작업으로 남겨져 있었다. LiveFigure는 바로 이 공백을 겨냥해서, 추상적인 연구 설계를 출판 수준의 편집 가능한 그림으로 변환하는 특화 에이전트로 연구 자동화의 범위를 시각 영역까지 확장한다.
2.3 그 밖의 시도들
코드 기반 생성 방법(StarVector, MatplotAgent 등)은 벡터 출력을 만들긴 하지만, 이 그림들은 본질적으로 편집이 어렵고 시각적으로 지나치게 단순하다. 의미적 풍부함과 미적 품질이 부족한 것이다. AutoFigure는 OCR로 라벨을 인식해 다시 삽입하는 방식으로 텍스트만 편집 가능하게 만들었지만, 나머지 그래픽 요소는 여전히 픽셀 기반이라 직접 수정할 수 없다.
정리하면, 지금까지 어느 방법도 래스터 이미지와 편집 가능한 과학 도식 사이의 간극을 완전히 메우지 못했다. 픽셀 기반 모델은 편집이 안 되고, 코드 기반 방법은 볼품이 없다. 이 이분법을 깨는 것이 LiveFigure의 출발점이다.
3. 핵심 아이디어: Cognition-Inspired Procedural Construction
논문의 문제의식을 한 문장으로 압축하면 이렇다. 과학 도식에서 진정한 native 편집 가능성을 얻으려면, 전통적인 픽셀 기반 종단간 생성을 버리고 새로운 패러다임으로 가야 한다. 저자들은 이 패러다임을 **Cognition-Inspired Procedural Construction(인지 기반 절차적 구성)**이라고 부른다.
이 발상의 근거는 사람 전문가가 실제로 그림을 그리는 방식에 대한 관찰이다. 전문가가 도식을 만드는 과정은 픽셀 조작이 아니라 단계적 인지 작업이다. 먼저 관련 참고 그림들을 찾아 영감을 얻고, 고수준의 시각적 청사진을 구상하고, 의미 있는 자산(아이콘, 심볼)을 찾거나 디자인하고, 적절한 도구로 이 자산들을 조립하고, 마지막으로 시각적 피드백을 보며 반복적으로 다듬는다. 이 과정을 명시적으로 모델링하고 시뮬레이션하면서, 생성을 픽셀이 아니라 코드로 구동하면, 본질적인 편집 가능성과 논리적 정확성을 동시에 얻을 수 있다는 것이다.
기존 픽셀 모델이 "그림을 한 번에 그려낸다"면, LiveFigure는 "그림을 그리는 프로그램을 짠다". 이 차이가 결정적이다. 프로그램으로 그린 그림은 각 요소가 독립된 객체로 존재하므로, 박스 하나를 옮기거나 색을 바꾸는 게 코드 몇 줄 수정으로 끝난다. 요소를 옮기면 연결된 화살표가 자동으로 따라오고, 텍스트는 언제든 다시 쓸 수 있으며, 무한히 확대해도 깨지지 않는 벡터로 남는다. 이 논문의 세 가지 기여는 (1) Cognition-Inspired Procedural Construction이라는 에이전트 패러다임 제안, (2) 이를 구현한 실용 프레임워크 LiveFigure, (3) 최소한의 수동 조정만으로 즉시 채택 가능함을 입증한 광범위한 실험이다.
먼저 자연어 지시로는 왜 안 되는지를 보여주는 그림부터 보자.
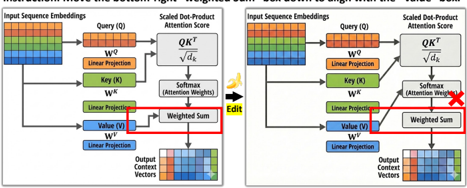
Figure 1 (원논문): 자연어 지시로는 생성 모델이 과학 도식을 정밀하게 수정하도록 유도하기 어렵다.
Figure 1은 어텐션 메커니즘 도식을 예로 든다. 왼쪽이 원본, 오른쪽이 "오른쪽 아래 weighted Sum 박스를 Value 박스에 맞춰 아래로 내려줘"라는 지시 후의 결과다. 사람이 보기엔 사소한 정렬 작업이지만, 픽셀 기반 모델은 이 국소적 수정을 처리하지 못한다. 오른쪽 그림에서 weighted Sum 박스는 위치가 바뀌었지만 Softmax와의 연결이 끊기고(빨간 X 표시), 주변 레이아웃까지 흐트러졌다. 국소 편집을 요청했는데 전역 재생성이 일어나면서 멀쩡했던 부분이 함께 망가지는 것이다. 이 한 장의 실패 사례가 논문 전체의 동기를 압축한다. 과학 글쓰기가 요구하는 반복적이고 세밀하며 검증 가능한 편집 과정을, 픽셀 패러다임은 원리적으로 지원할 수 없다.
여기에 더해, Nature나 Science 같은 최상위 학술지는 그림을 벡터 형식으로 제출하도록 요구한다. 벡터 그래픽은 태생적으로 편집 가능하고 해상도 독립적 확대를 지원하는데, 정확한 과학적 소통과 고품질 인쇄, 엄격한 출판 기준에 모두 필수적이다. 그런데 기존 이미지 생성 모델은 벡터 그래픽을 아예 만들지 못한다. 출판 요구사항과 근본적으로 호환되지 않는 셈이다.
4. 제안 방법 (Method)
4.1 전체 구조
LiveFigure는 사람 디자이너의 인지적 작업 흐름을 시뮬레이션하는 에이전트 프레임워크다. 입력 방법론 텍스트 을 받아, 의미 정렬과 시각적 명료성을 동시에 최대화하는 편집 가능한 파워포인트 그림 을 합성하는 것이 목표다. 전체 파이프라인은 세 개의 특화된 매핑 함수의 순차 합성으로 정의된다.
각 단계의 역할은 이렇다. (Visual Planning via Prior Induction)은 최상위 학회 논문들에서 고품질 디자인 패턴을 발굴해 시각적 레이아웃의 신뢰할 만한 사전지식(prior)을 세운다. (Procedural Figure Generation, 본문에서 로도 표기)은 디자인 청사진을 실행 가능한 그림 생성 스크립트로 매핑하되, 코드 실행성과 논리적 일관성을 함께 보장한다. (Targeted Refinement via Visual Diagnostics)은 멀티모달 폐루프 피드백으로 생성된 그림을 반복 최적화한다.
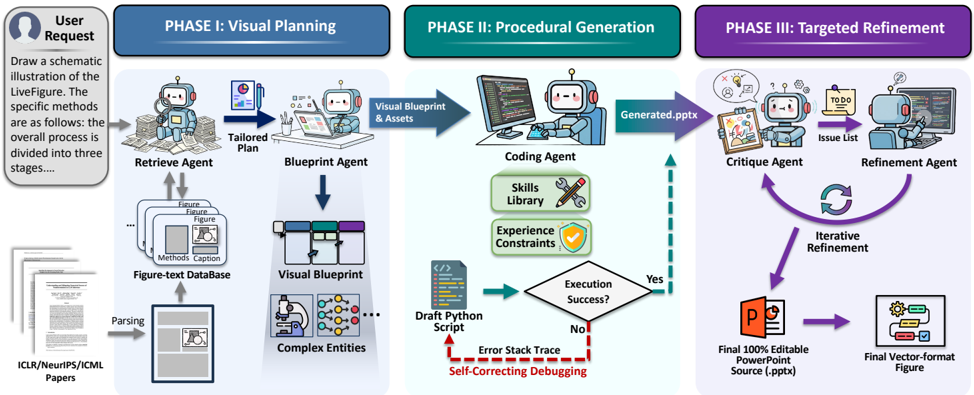
Figure 2 (원논문): LiveFigure 전체 개요. 세 단계 - (I) Visual Planning via Prior Induction, (II) Procedural Figure Generation via Skills and Experience, (III) Targeted Refinement via Visual Diagnostics - 로 사람의 그림 디자인 과정을 시뮬레이션한다. 이 그림 자체도 LiveFigure로 생성한 뒤 14번의 수동 편집으로 다듬은 것이다.
Figure 2는 세 단계를 관통하는 데이터 흐름을 보여준다. 왼쪽 PHASE I에서는 사용자 요청과 ICLR/NeurIPS/ICML 논문 데이터베이스가 입력으로 들어가서, Retrieve Agent가 참고 그림을 검색하고 Blueprint Agent가 시각적 청사진과 복잡한 개체(아이콘)를 만든다. 가운데 PHASE II에서는 Coding Agent가 Skills Library와 Experience Constraints를 활용해 파이썬 스크립트를 생성하고, 실행에 실패하면 에러 스택 트레이스를 받아 자가 수정(Self-Correcting Debugging)을 반복한다. 오른쪽 PHASE III에서는 Critique Agent가 렌더링 결과를 진단해 이슈 리스트를 뽑고 Refinement Agent가 코드를 국소 수정하는 루프가 돈다. 최종 산출물은 100% 편집 가능한 파워포인트 소스와 벡터 형식 그림이다. 캡션에 붙은 한마디 - "이 그림 자체도 LiveFigure로 생성해 14번 손봤다" - 가 재밌는데, 시스템이 자기 논문 도식을 그렸다는 일종의 자기 참조적 증명인 셈이다.
4.2 Stage I - Visual Planning via Prior Induction
흔히 하는 말처럼 첫 단추가 가장 어렵다. 입력 방법론 텍스트만으로 구체적인 시각 디자인을 뽑아내는 일()은 상당한 추론을 요구한다. 백지에서 시작하면 레이아웃이 엉망이 되기 쉽다. 그래서 저자들은 Visual Prior Induction(시각 사전지식 유도) 메커니즘을 도입한다. 문헌에 있는 고품질 방법론 그림에서 재사용 가능한 도식 디자인 사전지식을 증류(distill)하는 것이다. 최상위 학회의 전문가 예시들을 활용해 믿을 만한 시각 사전지식을 세우고, 이것으로 청사진 계획을 안내한다.
이를 위해 과학 그림에 초점을 둔 figure-text 지식 베이스 를 구축한다. 는 그림, 는 캡션, 는 밀도 높은 기술적 서술이다. 이 지식 베이스는 구조 인식 필터링과 문맥 인식 추출을 거쳐 고품질 방법론 순서도와 프레임워크 도식만 담도록 만들어진다(구축 과정 상세는 부록 A.4).
검색은 두 단계로 진행된다. 먼저 retrieve agent가 입력과 가장 의미적으로 관련된 상위 개 참고 그림을 가져온다.
여기서 는 임베딩 함수(예: Qwen3-Embedding)이고 은 유사도다. 다음으로 VLM이 검색된 참고 과 사용자 입력 을 함께 분석해서, 참고 그림들에 담긴 레이아웃 조직과 시각 구성을 뜯어본다. 그 밑에 깔린 디자인 원리를 추상화하고 증류해서 타깃 방법론에 맞게 적응시킨 구조 계획 을 만든다.
마지막으로 blueprint agent가 원래 문맥과 구조 계획을 프롬프트로 받아, 하위 절차적 생성에 공간적 지침을 제공하는 시각 청사진 를 만든다.
여기서 한 가지 실용적 디테일이 붙는다. 에 등장하는 도메인 특화 개체 (예: '현미경', '로봇 팔')는 기본 기하 도형으로 표현하기엔 시각적 복잡도가 높다. 이런 개체를 위해 asset generation 모듈이 스타일이 일관된 자산을 합성한다. 추론 비용을 최소화하면서 고품질 생성을 얻으려고, 개별 생성 대신 그리드 기반 배치 생성을 쓴다. 의 시각 스타일에 엄격히 조건화해서 격자의 아이콘을 한 번에 담은 합성 이미지를 만든 뒤, 자동 후처리(격자 자르기, 배경 제거)를 거쳐 자산 라이브러리 를 얻는다.
아이콘을 하나씩 그리면 API 호출도 많아지고 스타일도 제각각이 되기 쉬운데, 한 판에 몰아서 그리면 비용도 줄고 스타일 일관성도 자연스럽게 확보된다는 점이 영리하다.
4.3 Stage II - Procedural Figure Generation via Skills and Experience
청사진 와 자산 라이브러리 가 준비되면, Phase II의 목표는 편집 가능한 그림을 절차적으로 생성하는 것이다. 이 과정은 매핑 로 형식화된다.
왜 파워포인트인가? 이 논문에서 가장 논쟁적이면서도 설득력 있는 선택이 편집 가능 그림의 매개체로 마이크로소프트 파워포인트를 고른 것이다. Adobe Illustrator 같은 전문 벡터 도구가 산업 표준이지만, 폐쇄적 생태계와 가파른 학습 곡선 탓에 AI 자동화에는 부적합하다. 반면 파워포인트는 폭넓은 사용자 접근성과 개발자 수준의 개방성을 동시에 갖춘 드문 조합이다. 사용자 입장에서는 연구 커뮤니티의 사실상 공용어라 어디에나 있고, 개발자 입장에서는 OpenXML을 통한 풍부한 프로그래밍 인터페이스로 그래픽 primitive를 세밀하게 조작할 수 있으며 표준 벡터 형식으로의 export도 매끄럽다. 낮은 마찰의 사용자 편집과 높은 정밀도의 모델 제어라는 이중 요구를 파워포인트가 유일하게 만족시킨다는 것이다(PDF/SVG 대신 파워포인트를 고른 상세 논거는 부록 A.7).
그런데 VLM에게 python-pptx 기반 원시 파이썬 코드를 그냥 짜라고 시키면 잘 안 된다. 코드가 지나치게 장황해지고, API 환각이 나오고, 구현 버그가 넘치고, 공간 추론이 서툴다. 이를 해결하려고 저자들은 **표준화된 스킬 기반 생성(Standardized Skill-based Generation)**과 **경험 강화(Experience Enhancement)**를 결합한다.
표준화된 스킬을 원자적 primitive로. 파이썬 라이브러리 형태의 표준화된 스킬 집합 을 구축한다. 각 스킬 는 사전에 디버깅되고 엄격히 검증된 것으로, 연결선 라우팅이나 중첩 텍스트-도형 조합 같은 복잡한 렌더링 로직을 고수준 의미 인터페이스로 캡슐화한다. 절차적 생성 과정 은 청사진 와 스킬 라이브러리 에 조건화해서 실행 가능한 파이썬 스크립트 를 합성하는 것으로 모델링되고, 이를 실행해 초기 편집 가능 그림 를 얻는다.
이 스킬 추상화는 두 가지를 노린다. 첫째는 실행성 보장이다. 모델의 행동 공간을 검증된 원자 함수 집합으로 제약하면 문법 오류와 API 환각이 크게 줄어든다. 둘째는 **인지적 오프로딩(cognitive offloading)**이다. 고수준 레이아웃 추론과 저수준 구현 디테일을 분리해서, 모델은 "컴포넌트 A를 컴포넌트 B에 꺾은선 화살표로 연결한다" 같은 의미 수준 결정에만 집중할 수 있다. 앵커 포인트나 중간 픽셀 라우팅 좌표를 일일이 계산하지 않아도 된다. 스킬 한 번 호출이 수십 줄의 복잡한 레이아웃 로직을 대체하니 코드 길이와 복잡도도 크게 줄어든다.
경험 기반 제약 주입(Experience-Driven Constraint Injection). LM은 시각화/렌더링 라이브러리와 상호작용할 때 학습 데이터의 편향 탓에 API 환각이나 잘못된 파라미터 조합을 자주 만든다. 이를 체계적으로 줄이려고 Evolving Experience Injection 메커니즘을 도입한다. 개발과 대규모 생성 과정에서 축적된 디버깅 경험을 형식화된 부정 제약(negative constraint) 로 증류하는 것이다. 시스템이 더 많은 케이스를 처리할수록 경험 저장소가 새로 관찰된 런타임 오류를 계속 반영한다. 예컨대 알려진 API 오용을 막으려고 "slide.shapes.add_shape(MSO_SHAPE.LINE, ...)를 직접 쓰지 말고 add_connector를 써라" 같은 금지 규칙이 프롬프트에 자동 삽입된다. 도메인 특화 실패 지식을 이렇게 자동으로 통합함으로써, 생성 탐색 공간에 대한 사전 가지치기(pre-pruning)를 수행한다. 모델이 과거의 실수에서 배우고, 알려진 오류 경로를 생성 로직 수준에서 차단하게 되는 것이다.
자가 수정 실행 루프(Self-Correcting Execution Loop). 스킬과 경험 제약이 오류율을 크게 낮춰도 산발적인 복잡한 로직 충돌은 남는다. 이를 위해 런타임 피드백 기반 반복 디버깅을 붙인다. 실행이 실패하면 시스템이 에러 스택 트레이스 를 잡아 모델에 되먹인다. 초기 생성 코드를 라 하면, 디버깅 반복 시퀀스는 다음과 같이 정의된다.
이 루프는 실행 성공 시 종료되어 검증된 실행 스크립트 를 내놓는다. 예상치 못한 런타임 오류에서 시스템이 자율적으로 회복하도록 하는 마지막 안전망이다.
4.4 Stage III - Targeted Refinement via Visual Diagnostics
Phase II가 내놓은 스크립트 는 유효하고 실행 가능하지만, 그 결과 그림 에는 코드 논리로는 안 보이는 미묘한 시각적 결함이 남기 마련이다. 요소가 서로 가려지거나(occlusion), 스타일이 들쭉날쭉하거나. 코드 논리와 시각 인지 사이의 간극을 메우려고 Visual Diagnosis-Driven Refinement 폐루프를 설계한다. 이는 최적화 매핑 로 형식화된다.
이 단계는 '관찰-진단-수정(observe-diagnose-refine)'의 반복 과정이다. Phase II에서 물려받은 스크립트를 라 하자. 매 반복 에서 시스템은 현재 스크립트를 시각 스냅샷 로 렌더링한다. VLM이 '시각 비평가(visual critic)' 역할을 맡아 진단을 수행하고, 구체적 결함을 정확히 짚는 구조화된 Actionable Issue List 를 출력한다(예: "텍스트 상자 A가 화살표 B와 겹침").
이어서 에이전트가 타깃 수정을 실행한다. 전체 스크립트를 재생성하지 않고, 피드백 리스트에 조건화해 코드에 증분 업데이트를 적용한다.
이 루프는 이슈 리스트가 비거나 수렴에 도달할 때까지 계속되고, 최종 출판 준비 그림은 로 얻어진다. 사람을 흉내 낸 시각 피드백을 통해 출력이 까다로운 미적 기준을 충족하도록 보장하는 장치다. 전체 스크립트를 다시 짜지 않고 문제 지점만 국소 수정한다는 점이 픽셀 모델의 전역 재생성과 정면으로 대비된다. 앞서 Figure 1이 보여준 실패 - 국소 편집이 전역 붕괴로 번지는 - 를 원리적으로 피하는 것이다.
5. 실험 결과
5.1 실험 설정
베이스라인. 비교 대상은 크게 두 부류다. 래스터 이미지 생성 모델로는 Gemini-3-Pro-Image(Nano Banana, 2025년 11월 Google), GPT-Image-1.5(2025년 12월 OpenAI), Imagen-4.0-Ultra(Google), Qwen-Image(2025년 8월 Alibaba), Grok-2-Image(2024년 8월 xAI)를 쓴다. 프로그래밍 방식 그림 생성 라이브러리로는 Mermaid, Graphviz, Matplotlib, TikZ-V1, HTML/CSS를 포함한다. AutoFigure는 오픈소스가 아니라 제외됐다. LiveFigure 자신은 에이전트 백본으로 Gemini-3-Pro와 Gemini-3-Image-Pro를 쓴다. 코드 기반 베이스라인도 모두 Gemini-3-Pro가 완성 코드를 생성하고 로컬 샌드박스에서 컴파일/실행한다.
Edit Distance 메트릭. 실용적 편집 가능성을 정량화하려고 Edit Distance를 정의한다. 사용자가 생성된 그림을 완성하기까지 수행하는 원자적 수정 단계의 수다. PPTX 파일이 내부적으로 구조화된 XML 트리이므로, 편집 전후의 XML 표현을 직접 diff해서 계산한다. 세 종류의 연산을 센다. Modify(같은 ID 요소가 양쪽에 있지만 위치/색/텍스트 등 속성이 다름), Add(편집본에만 나타남), Delete(제거됨). 같은 개체에 대한 반복 조정은 하나의 연산으로 집계되므로, 사람의 편집 노력을 객관적이고 강건하게 측정한다.
시각 평가 메트릭. 세 차원 총 9개 메트릭으로 평가하며 모두 높을수록 좋다. Visual Design은 Aesthetic(미적 품질), Expressiveness(추상 개념을 직관적 시각 심볼로 변환), Polish(정렬/간격/연결선/폰트의 출판 품질). Information Clarity는 Clarity(핵심 정보 파악 용이성), Logical Flow(레이아웃/화살표가 인과적으로 일관된 흐름을 안내하는지), Text Legibility(텍스트 가독성, 철자, 생성 오류 여부). Content Fidelity는 Accuracy(노드/연결/정보 흐름이 원 과학 서술을 정확히 반영하는지), Completeness(핵심 모듈/단계가 모두 표현됐는지), Appropriateness(추상화 수준과 스타일이 대상 독자와 학술 맥락에 적합한지).
데이터셋. ICLR 2024, NeurIPS 2024, ICML 2024 채택 논문에서 도출한 과학 도식 데이터셋으로 평가한다. 학회당 100개씩 figure-text 쌍을 자동 추출해 총 300개 테스트 인스턴스를 만들었다. 각 쌍은 도식과 그에 딸린 텍스트 서술(캡션 + 관련 방법 서술)로 구성된다. 입력은 두 설정이다. V1은 캡션만, V2는 캡션 + 방법 서술을 함께 준다.
5.2 주요 결과 - Edit Distance
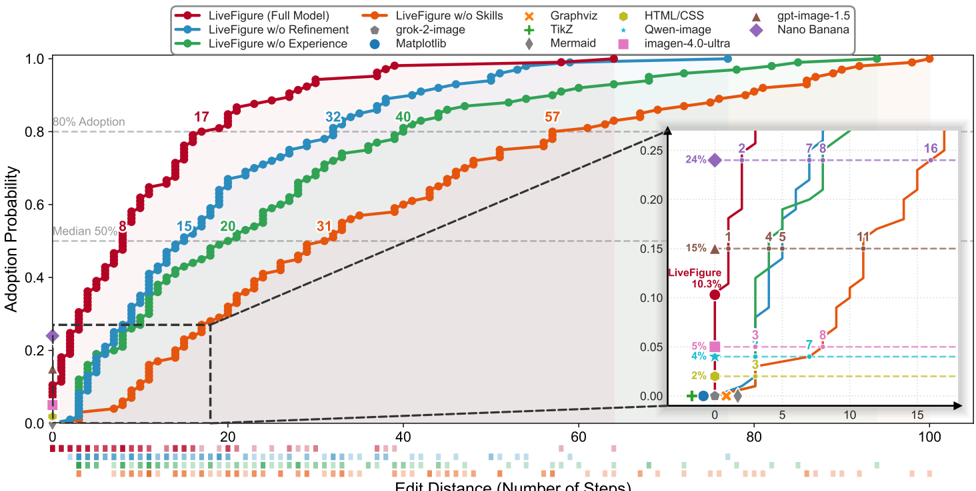
Figure 3 (원논문): 편집 노력 대비 누적 채택 확률 곡선. x축은 사용자 채택까지 필요한 Edit Distance, y축은 생성된 그림이 채택될 누적 확률. 본 곡선은 full 모델(빨강)과 세 ablation 변형을 비교하고, 오른쪽 확대 패널은 수정 없이(x=0) 채택되는 비율을 보여준다. 아래 rug plot은 edit distance 밀도 분포다.
Figure 3이 이 논문에서 가장 핵심적인 실용성 지표를 담고 있다. full 모델(빨강)은 8단계에서 중앙값(50%) 채택률에, 17단계에서 80% 임계값에 도달한다. 데이터 점들이 저편집 영역에 빽빽이 몰려 있다는 건 생성된 그림 대다수가 최소한의 손질만으로 사용자 기준을 만족한다는 뜻이다.
계층적 설계의 필요성은 ablation 곡선들이 뒷받침한다. Skill Library를 빼면(w/o Skills, 주황) 성능 저하가 가장 심해서 중앙값 edit distance가 31단계로 뛴다. 거의 4배의 노력이다. 실행 가능한 도구 없이는 문법적 정밀성에서 헤맨다는 신호다. Experience 모듈을 빼면(w/o Experience, 초록) 중앙값 채택이 20단계로 밀린다. 축적된 디버깅 경험과 실패 유래 제약을 주입하는 것의 가치를 보여준다. 대조적으로 범용 VLM의 zero-shot 생성은 크게 고전한다. 오른쪽 확대 패널을 보면 무편집(x=0) 채택률에서 Nano Banana는 24%, gpt-image-1.5는 15%에 그치는 반면 LiveFigure는 10.3% 지점이 표시되는데, 곡선이 워낙 가파르게 올라가 몇 단계 안에 이들을 추월한다. 이 대비가 전문 과학 작도에서 생성 이미지 모델의 한계와 프레임워크의 필요성을 동시에 드러낸다.
5.3 시각 품질과 내용 충실도
전체 9개 메트릭에 걸친 VLM 기반 평가 결과가 다음이다. LiveFigure 행은 볼드로 표시했다.
| Models | Aesthetic | Express. | Polish | Clarity | Flow | Legibility | Accuracy | Complete. | Appropriate. | Ave. |
|---|---|---|---|---|---|---|---|---|---|---|
| V1: Caption-only | ||||||||||
| Nano Banana | 7.68 | 6.73 | 7.81 | 7.14 | 7.49 | 8.54 | 5.92 | 6.20 | 7.12 | 7.18 |
| gpt-image-1.5 | 8.08 | 7.05 | 8.09 | 7.44 | 7.63 | 8.21 | 5.75 | 6.02 | 7.31 | 7.29 |
| Qwen-image | 8.00 | 6.83 | 7.14 | 5.49 | 5.44 | 5.88 | 3.90 | 4.28 | 5.41 | 5.82 |
| grok-2-image | 5.90 | 4.54 | 5.30 | 3.66 | 3.62 | 2.91 | 3.18 | 3.26 | 3.68 | 4.01 |
| imagen-4.0-ultra | 7.63 | 6.31 | 7.33 | 5.58 | 5.80 | 6.23 | 4.65 | 4.61 | 5.70 | 5.98 |
| Mermaid | 2.49 | 1.70 | 1.78 | 3.01 | 3.18 | 3.41 | 4.35 | 2.12 | 2.12 | 2.68 |
| Graphviz | 3.53 | 3.52 | 4.21 | 5.21 | 6.24 | 7.34 | 5.83 | 6.03 | 6.59 | 5.39 |
| Matplotlib | 5.99 | 5.22 | 5.82 | 5.66 | 5.88 | 6.70 | 4.80 | 4.92 | 5.53 | 5.61 |
| TikZ | 3.59 | 2.95 | 3.51 | 3.12 | 3.28 | 3.87 | 2.62 | 2.74 | 3.17 | 3.21 |
| HTML/CSS | 6.76 | 5.87 | 7.09 | 6.64 | 6.80 | 7.34 | 5.61 | 5.86 | 6.52 | 6.50 |
| LiveFigure | 7.69 | 6.86 | 7.76 | 7.07 | 7.29 | 8.29 | 6.80 | 6.69 | 7.26 | 7.30 |
| V2: Caption + Method Description | ||||||||||
| Nano Banana | 7.94 | 7.16 | 7.99 | 7.57 | 8.17 | 8.65 | 7.61 | 7.71 | 8.07 | 7.87 |
| gpt-image-1.5 | 7.91 | 7.05 | 8.07 | 7.65 | 7.98 | 8.60 | 7.06 | 7.12 | 7.34 | 7.64 |
| Qwen-image | 7.43 | 6.42 | 6.25 | 5.43 | 5.84 | 5.43 | 4.75 | 5.22 | 5.85 | 5.85 |
| grok-2-image | 5.53 | 4.44 | 4.42 | 3.39 | 3.78 | 2.97 | 3.15 | 3.45 | 3.61 | 3.86 |
| imagen-4.0-ultra | 7.89 | 6.41 | 7.29 | 5.45 | 5.59 | 6.56 | 4.91 | 5.28 | 6.02 | 6.16 |
| Mermaid | 2.98 | 1.97 | 1.70 | 3.24 | 3.02 | 3.58 | 4.40 | 2.77 | 2.99 | 2.96 |
| Graphviz | 4.28 | 3.87 | 4.39 | 5.65 | 6.43 | 7.60 | 6.34 | 6.81 | 6.61 | 5.78 |
| Matplotlib | 5.75 | 5.07 | 5.42 | 5.07 | 5.72 | 5.70 | 5.91 | 6.09 | 5.76 | 5.61 |
| TikZ | 3.53 | 2.93 | 3.53 | 2.93 | 3.35 | 3.87 | 3.05 | 3.15 | 3.33 | 3.30 |
| HTML/CSS | 6.60 | 5.76 | 7.01 | 6.38 | 6.76 | 7.29 | 6.39 | 6.68 | 6.72 | 6.62 |
| LiveFigure | 7.87 | 7.08 | 7.87 | 7.59 | 7.75 | 8.62 | 8.29 | 8.16 | 7.79 | 7.89 |
Table 1 (원논문): 시각 디자인, 정보 명료성, 내용 충실도 세 차원에 걸친 VLM 기반 평가. Ave.는 9개 메트릭 평균. 모든 메트릭 높을수록 좋음.
이 표에서 읽어야 할 이야기가 몇 겹 있다. 먼저 전통적 프로그래밍 도구와의 격차다. Graphviz(V2 평균 5.78)나 Matplotlib(5.61)는 경직된 레이아웃 탓에 Visual Design 점수가 일관되게 낮다. LiveFigure는 V2 평균 7.89로, 구조적 편집 가능성과 높은 미적 품질을 균형 있게 잡아낸다. 코드 기반 도구들이 벡터라서 편집은 되지만 볼품이 없다는 2절의 지적이 수치로 확인되는 셈이다.
SOTA 래스터 생성 모델과 비교하면 그림이 흥미로워진다. Nano Banana(V2 평균 7.87)나 gpt-image-1.5(7.64)는 미적 외양(Aesthetic)에서 LiveFigure를 살짝 앞선다. 픽셀 모델이 예쁜 그림을 뽑는 데는 여전히 강하다는 뜻이다. 그런데 Content Fidelity에서 판도가 뒤집힌다. V2 입력에서 LiveFigure는 Accuracy 8.29, Completeness 8.16으로 gpt-image-1.5(각각 7.06, 7.12)를 큰 폭으로 넘어선다. 과학적 구조와 논리에 훨씬 충실하다는 것이다. 픽셀 기반 생성은 예쁘지만 내용을 지어내고, 코드 기반 생성은 정확하지만 못생겼는데, LiveFigure는 정확성 쪽에 무게를 실으면서 미적 품질도 상위권을 유지한다.
또 하나 눈에 띄는 건 V1에서 V2로 갈 때의 일관된 향상이다. LiveFigure 평균이 7.30에서 7.89로 오른다. 더 풍부한 텍스트 입력이 구조적으로 정확하고 과학적으로 엄밀한 도식 생성을 더 잘 뒷받침한다는 뜻이다. 캡션만 주는 것보다 방법 서술까지 주면 에이전트가 논리 구조를 더 정확히 재구성한다.
5.4 반복 정제에 따른 성능 변화
Stage III의 반복 정제가 실제로 각 차원을 얼마나 끌어올리는지를 iteration 0/1/2로 나눠 본 결과가 다음이다.
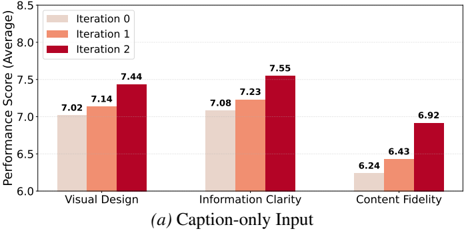
Figure 4(a) (원논문): 반복 횟수에 따른 성능 비교, 캡션만 입력(V1). 세 시각 평가 차원 평균.
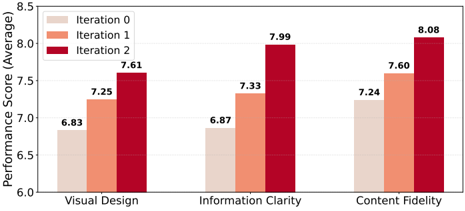
Figure 4(b) (원논문): 반복 횟수에 따른 성능 비교, 캡션 + 방법 서술 입력(V2).
Figure 4는 두 입력 설정에서 iteration이 진행될수록 세 차원이 모두 단조 증가함을 보여준다. V1(패널 a)에서 Content Fidelity가 6.24 → 6.43 → 6.92로 오르고, Visual Design은 7.02 → 7.14 → 7.44, Information Clarity는 7.08 → 7.23 → 7.55로 오른다. V2(패널 b)에서는 상승 폭이 더 크다. 특히 Content Fidelity가 7.24 → 7.60 → 8.08로, Information Clarity는 6.87 → 7.33 → 7.99로 올라간다. 어느 차원도 반복하면서 퇴보하지 않고 일관되게 좋아진다는 점이 중요하다. 시각 진단 기반의 타깃 정제가 시각적 조직과 구조적 충실도를 실제로 개선한다는 것을 정량적으로 뒷받침한다. 흥미로운 대비는 V2에서 Information Clarity의 상승 폭(6.87 → 7.99, 약 1.1점)이 가장 크다는 점인데, 방법 서술이라는 풍부한 입력이 있을 때 정제 루프가 레이아웃과 흐름을 다듬을 여지도 그만큼 커지기 때문으로 보인다.
5.5 사람 선호도 평가
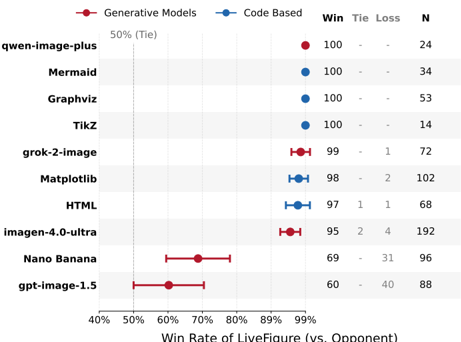
Figure 5 (원논문): 이중 맹검 쌍대 비교 기반 사람 선호도 평가. forest plot은 조정 승률(adjusted win rate)과 95% 신뢰구간을 보여주고, 오른쪽 표는 각 비교의 Win/Tie/Loss 세부 내역이다.
시각 품질과 레이아웃 정확성을 평가하려고 이중 맹검 쌍대 사람 선호도 실험을 했다. 평가자들에게 무작위 순서로 그림 쌍을 제시하고 정보 정확성과 시각적 명료성이 더 나은 쪽을 고르게 했다. Figure 5의 forest plot 데이터를 표로 옮기면 다음과 같다.
| 상대 모델 | 조정 승률 | Win(%) | Tie(%) | Loss(%) | N |
|---|---|---|---|---|---|
| qwen-image-plus | 100% | 100 | - | - | 24 |
| Mermaid | 100% | 100 | - | - | 34 |
| Graphviz | 100% | 100 | - | - | 53 |
| TikZ | 100% | 100 | - | - | 14 |
| grok-2-image | 99% | 99 | - | 1 | 72 |
| Matplotlib | 98% | 98 | - | 2 | 102 |
| HTML | 97% | 97 | 1 | 1 | 68 |
| imagen-4.0-ultra | 95% | 95 | 2 | 4 | 192 |
| Nano Banana | 69% | 69 | - | 31 | 96 |
| gpt-image-1.5 | 60% | 60 | - | 40 | 88 |
Figure 5 데이터(원논문): LiveFigure의 상대별 승률 세부 내역.
코드 기반 방법(Matplotlib, TikZ, Mermaid, Graphviz, HTML)을 상대로는 조정 승률이 97% 이상, 사실상 압승이다. 복잡한 스타일링을 자동화하는 데서 오는 우위를 확인해준다. 더 의미 있는 건 SOTA 생성 모델과의 대결이다. Nano Banana 상대 69%, gpt-image-1.5 상대 60%로, 두 경우 모두 95% 신뢰구간이 50% 임계값을 엄격히 상회한다. 통계적으로 유의미한 우위라는 뜻이다. 픽셀 모델이 미적 외양에서 살짝 앞선다는 Table 1의 결과에도 불구하고 사람들은 LiveFigure를 더 자주 선택했는데, 정보 정확성이라는 기준을 함께 저울에 올리면 내용 충실도의 우위가 미적 열세를 상쇄하고도 남는다는 해석이 가능하다.
한 가지 짚어둘 점은 초록의 서술과 본문의 수치 사이에 소소한 불일치가 있다는 것이다. 초록은 "Nano Banana 상대 60% 승률"이라고 쓰는데, 본문 4.5절과 Figure 5는 Nano Banana 69%, gpt-image-1.5 60%로 보고한다. 아마 초록에서 상대를 혼동한 표기 오류로 보이고, 세부 실험 수치인 후자가 맞을 것이다.
5.6 정성 사례 연구 개괄
논문 본문은 다양한 시나리오에서의 정성 사례 연구를 부록에 몰아두고, 4.6절에서 목차만 제시한다. 부록 B.3과 B.4는 복잡한 구조 레이아웃에 대한 교차 모델 비교, B.5는 native 출력의 객체 수준 편집 가능성 검증, B.6은 생물학 워크플로 도식을 통한 학제간 일반화, B.7은 전형적 생성 실패 모드 분석, B.8은 자연어 기반 대화형 수정 능력을 다룬다. 이 사례들은 아래 6절에서 그림과 함께 상세히 본다.
6. Ablation과 부록 실험
6.1 구성요소 Ablation
각 아키텍처 구성요소의 기여를 검증한 ablation 결과다.
| Model Variant | Executability ↑ | Debug Turns ↓ | VLM Score ↑ |
|---|---|---|---|
| w/o Experience | 40.0% | 3.30 | 6.52 |
| w/o Skills | 77.3% | 1.60 | 5.47 |
| w/o Refinement | 83.5% | 0.46 | 6.78 |
| w/o Visual Prior | 82.3% | 0.55 | 6.81 |
| Full LiveFigure | 83.5% | 0.53 | 7.28 |
Table 2 (원논문): Experience, Skills, Refinement, Visual Prior 모듈에 대한 ablation.
이 표는 각 모듈이 서로 다른 역할을 맡고 있음을 깔끔하게 보여준다. Experience 모듈은 문법적 정확성의 토대다. 이를 빼면 Executability가 40.0%로 폭락한다. 축적된 디버깅 경험 없이는 절반 이상의 생성 코드가 아예 실행되지 않는다는 뜻이다. Debug Turns도 3.30으로 크게 늘어난다. Standardized Skills는 미적 품질의 핵심이다. 이를 빼면 VLM Score가 5.47로 전체 최저를 찍는다. 실행은 어느 정도 되더라도(77.3%), 저수준 primitive로 직접 그리면 결과물의 시각 품질이 무너진다. Refinement는 필수적인 교정 층이다. 이를 빼면 VLM Score가 6.78로 떨어진다(full 7.28). Visual Prior를 빼도 6.81로 하락하는데, 좋은 청사진 없이 시작하면 레이아웃 계획의 질이 떨어지기 때문이다.
정리하면 Executability는 Experience가, 미적 품질은 Skills가 지배적으로 결정하고, Refinement와 Visual Prior가 최종 품질을 마무리로 끌어올린다. 네 모듈이 겹치지 않는 역할을 분담한다는 점이 설계의 정합성을 뒷받침한다.
6.2 단계별 누적 평가
구성요소를 빼는 방식(6.1)과 반대로, vanilla LLM 베이스라인에 각 단계를 순차적으로 더해가며 성능이 어떻게 쌓이는지도 측정했다.
| Pipeline Configuration | Executability ↑ | Debug Turns ↓ | VLM Score ↑ |
|---|---|---|---|
| Vanilla LLM Generation | 31.0% | 3.40 | 5.03 |
| + Stage 1 (Visual Prior) | 32.5% | 3.50 | 5.75 |
| + Stage 2 (Skills & Experience) | 83.5% | 0.46 | 6.78 |
| + Stage 3 (Refinement) → Full LiveFigure | 83.5% | 0.53 | 7.28 |
Table 5 (원논문): 단계별 누적 평가의 정량적 진행.
이 표의 궤적이 흥미롭다. Baseline → Stage 1(시각 계획 이득): Visual Prior를 넣으면 VLM Score가 5.03 → 5.75로 오른다. 사람다운 거시 레이아웃 계획 덕분이다. 그런데 Executability는 32.5%로 여전히 낮고 Debug Turns는 오히려 3.40 → 3.50으로 살짝 늘어난다. 저자들의 솔직한 해석이 인상적인데, vanilla LLM에게 복잡한 시각 청사진을 원시 파이썬 코드로 충실히 렌더링하라고 강요하면 오히려 코딩 난도가 올라가 시행착오가 더 많아진다는 것이다. 좋은 계획이 곧 좋은 실행을 보장하지 않는다는 역설이다.
Stage 1 → Stage 2(실행 효율 개선): Skill Library와 Debug Experience를 넣으면 이 실행 병목이 완전히 풀린다. Executability가 32.5%에서 83.5%로 치솟고 Debug Turns는 0.46으로 급감한다. 렌더링 로직을 구조화된 API로 캡슐화하니 추상 레이아웃이 거의 한 번에 함수 코드로 번역되는 것이다. VLM Score도 6.78로 올라간다. 계획된 레이아웃이 이제 정확하고 안정적으로 렌더링되기 때문이다. 이 단계가 파이프라인 전체에서 가장 극적인 도약을 만든다.
Stage 2 → Full(출판 품질 마감): Stage 3는 시각적 미세 정렬기(micro-aligner)로 작동한다. 초기 초안에서 드러난 공간 배치, 그래픽 렌더링, 요소 속성의 미묘한 결함을 시각 피드백 기반의 국소 조정으로 손본다. 이 집중적 정제가 VLM Score를 7.28의 최종 SOTA로 끌어올린다. 출판 준비 품질로 가는 마지막 간극을 메우는 역할이다.
6.3 정보 충실도 정량 평가
생성된 그림이 사용자의 원래 입력 정보를 얼마나 충실히 전달하는지를 별도로 측정했다. 세 단계 파이프라인이다. (1) VLM(GPT-4o)이 사전 문맥 없이 순수하게 시각적으로만 그림을 해석해 내용과 워크플로를 서술하고, (2) GPT-5가 이 시각 서술을 사용자의 원래 의도(정답 캡션 + 방법 서술)와 비교하고, (3) 0~5점의 Intent Conveyance Score를 매긴다. 핵심 방법론의 누락, 모듈 간 논리 관계의 정확성 같은 차원을 평가한다.
| Models | Average Intent Conveyance Score ↑ |
|---|---|
| Nano Banana | 4.3 |
| GPT-image-1.5 | 3.9 |
| Qwen-image | 2.8 |
| grok-2-image | 1.4 |
| imagen-4.0-ultra | 2.5 |
| Mermaid | 1.2 |
| Graphviz | 3.3 |
| Matplotlib | 2.7 |
| TikZ | 0.8 |
| HTML/CSS | 3.0 |
| LiveFigure (Ours) | 4.6 |
Table 4 (원논문): 모델별 Intent Conveyance Score 정량 비교.
LiveFigure가 4.6으로 1위, Nano Banana가 4.3으로 2위다. 사람 없이 VLM 파이프라인으로 재측정한 이 지표에서도 순위가 사람 선호도(Figure 5)와 대체로 일치한다는 점이 신뢰도를 높인다. 밑바닥을 보면 TikZ(0.8)와 Mermaid(1.2)가 최하위인데, 코드 기반 도구가 캔버스 비율이나 레이아웃을 제대로 못 잡아 원 의도를 왜곡한다는 뒤의 사례 분석과 맞물린다. 흥미로운 건 Graphviz(3.3)가 미적 점수(Table 1)에서는 낮았지만 의도 전달에서는 중위권이라는 점이다. 못생겼어도 노드-엣지 구조 자체는 논리를 어느 정도 보존하기 때문으로 읽힌다.
6.4 사례 연구 1 - UOL 교차 모델 비교
부록 B.3의 첫 사례는 ICLR 2024 논문 'Unsupervised Order Learning'(UOL)의 캡션과 방법 서술을 입력으로 준다. 이 알고리즘 시각화는 복잡한 중첩 논리를 요구한다. 바깥쪽 Alternating Optimization 루프 안에 두 개의 하위 모듈(Ordered k-means, Network Fine-tuning)이 들어 있는 구조다.
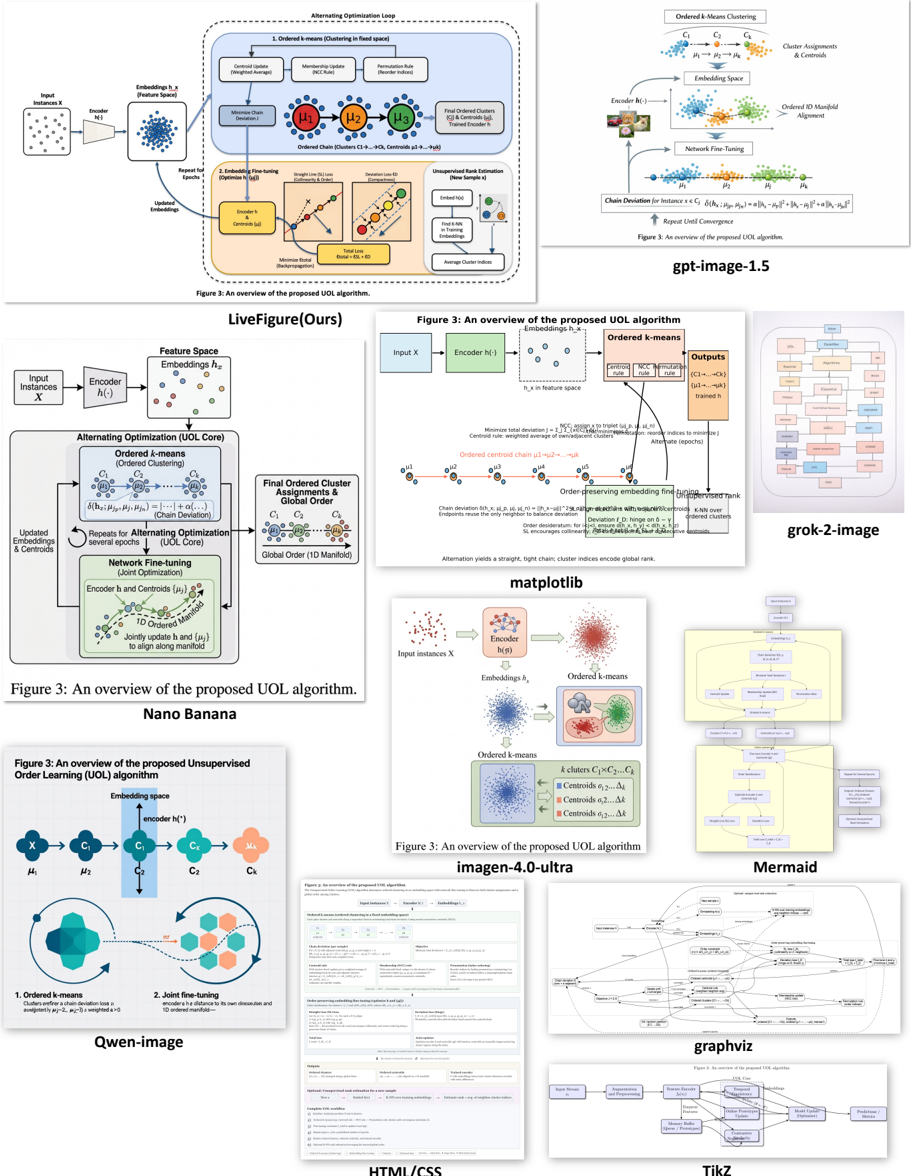
Figure 6 (원논문): UOL 논문에 대한 생성 그림의 정성 비교. LiveFigure를 SOTA 래스터 생성 모델 및 코드 기반 작도 도구와 비교한다.
Figure 6에서 LiveFigure(Ours, 좌상단)는 이 계층 논리를 성공적으로 포착한다. 하위 모듈들을 명확한 컨테이너 구조 안에 조직하고, 순차 의존성()을 적절한 공간 배치로 시각화한다. 특히 출판에 적합한 종횡비(4:3이나 16:9)를 유지해서 도식이 읽기 쉽고 조밀하다. 반면 베이스라인들은 레이아웃 제어와 종횡비 적응에서 뚜렷한 한계를 보인다. 코드 기반 도구(TikZ, Graphviz, Mermaid)는 규칙 기반 렌더링 엔진이라 캔버스 치수의 의미적 중요성을 무시하기 일쑤다. TikZ 예시(우하단)는 극단적으로 넓은 띠 모양 이미지를 만드는데, standalone 클래스가 노드를 딱 감싸는 크롭을 하기 때문에 출력 치수가 요소 흐름에 의해 결정돼버린다. 래스터 모델(Qwen-image, grok-2)은 API 제약으로 1:1 정사각형 같은 고정 종횡비에 갇혀서, 선형 워크플로를 억지로 정사각 캔버스에 쑤셔 넣다 보니 어수선한 레이아웃이나 뱀처럼 구불거리는 경로가 나온다. LiveFigure는 논리 생성과 레이아웃 렌더링을 분리(decouple)함으로써 구조적 충실도와 적응적/전문적 서식을 동시에 확보한다.
6.5 사례 연구 2 - EEG 교차 모델 비교
부록 B.4의 두 번째 사례는 ICLR 2024 논문 'Decoding Natural Images from EEG for Object Recognition'을 입력으로 준다. 더 고차원의 위상적 도전이다. 그림이 두 개의 구별되는 섹션 - 고수준 학습/추론 프레임워크(Panel A)와 세밀한 신경망 아키텍처(Panel B) - 으로 구성된 복합 레이아웃을 요구한다.
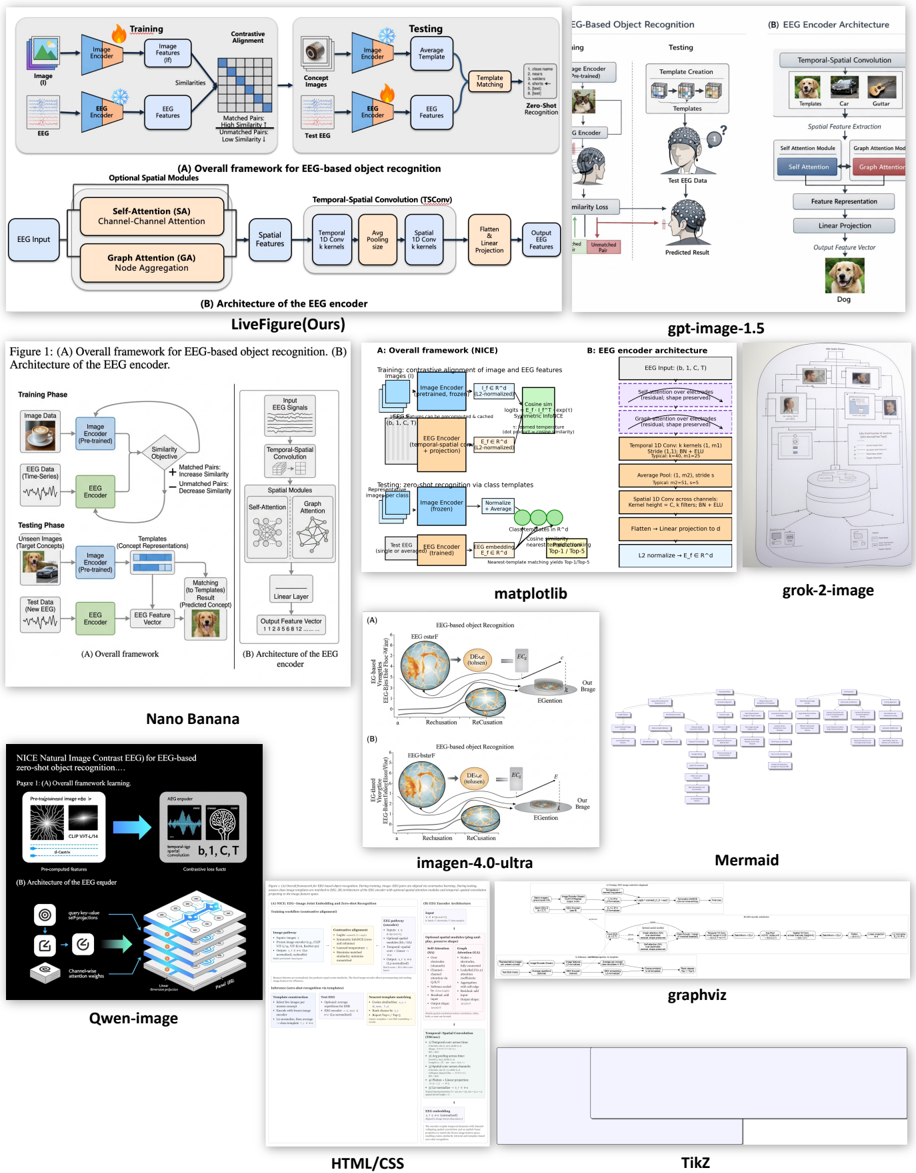
Figure 7 (원논문): EEG 기반 객체 인식 논문에 대한 생성 그림의 정성 비교.
Figure 7에서 LiveFigure(좌상단)는 이 복잡한 논리를 성공적으로 풀어낸다. 이분할(bipartite) 레이아웃의 필요성을 자율적으로 식별해서, 의미 계층을 존중하는 두 개의 뚜렷한 하위 그림을 생성한다. Panel A는 학습/테스트 단계를 분리한 대조 학습 설정을 깔끔하게 그리고, Panel B는 인코더의 내부 데이터 흐름을 재구성해 Temporal-Spatial Convolution, Graph Attention 같은 구체적 기술 모듈을 순차 배열한다. 고수준 추상화와 저수준 기술 명세를 완벽하게 균형 잡은, 출판 준비된 도식이다. 반면 래스터 모델(Qwen-image, Grok-2)은 이 구조적 분리를 유지하지 못한다. 고정 종횡비와 명시적 레이아웃 계획 부재 탓에 두 패널을 하나의 어수선한 장면으로 뭉뚱그리고, 엄밀한 기술 도표 대신 빛나는 뇌 렌더링 같은 'sci-fi' 스타일 삽화를 만든다. 존재하지 않는 연결을 환각하거나 핵심 내부 모듈(Panel B의 특정 어텐션 블록)을 빠뜨려서, 시각적으로는 인상적이지만 기술적으로 부정확한 결과를 낸다. 코드 기반 베이스라인 중 Matplotlib은 파국적 실패의 전형을 보여주는데, 도식 작도용 native primitive가 없어 아키텍처를 아예 렌더링하지 못하고 의미 없는 좌표축을 출력한다.
6.6 사례 연구 3 - 완전한 편집 가능성 검증
세 번째 사례는 출력의 세밀한 편집 가능성과 객체 지향적 성질을 명시적으로 검증한다.
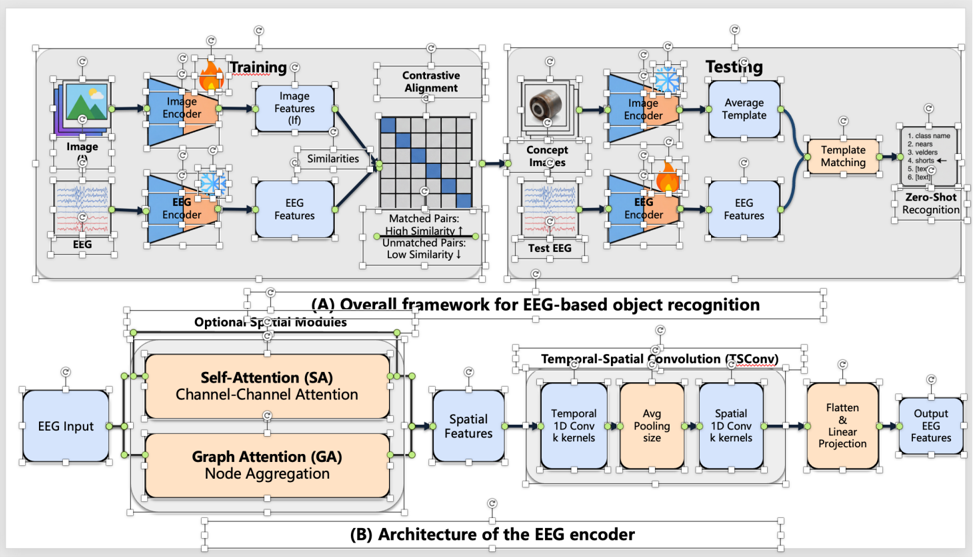
Figure 8 (원논문): 객체 수준 편집 가능성의 시각적 검증. 생성된 그림을 파워포인트에서 열어 모든 요소를 선택한 스크린샷으로, 바운딩 박스와 컨트롤 핸들이 출력이 납작한 래스터 이미지가 아니라 개별 조작 가능한 native 객체(도형, 텍스트 상자, 연결선)로 구성됐음을 확인해준다.
Figure 8은 생성된 EEG 프레임워크를 파워포인트에서 열어 전역 선택 명령을 적용한 원본 스크린샷이다. 빽빽하게 보이는 선택 핸들과 바운딩 박스가 출력이 개별 native 그래픽 primitive들 - 도형, 텍스트 상자, 스마트 연결선 - 로 이뤄졌음을 엄밀하게 증명한다. 정적 픽셀 행렬이 아니라는 것이다. 이 객체 수준 granularity가 연구자에게 모든 시각 요소에 대한 완전한 제어권을 준다. 모든 라벨이 독립 텍스트 상자로 인스턴스화되므로 복잡한 image inpainting 없이 오타를 고치거나 폰트 속성을 바꿀 수 있고, 연결 화살표는 도형 앵커에 붙은 동적 파워포인트 연결선이라 모듈을 옮기면(예: 'Spatial Features' 블록을 드래그) 화살표가 자동 재라우팅되어 도표의 위상 논리가 보존된다. 픽셀 모델과의 근본적 차이가 이 한 장의 스크린샷에 압축돼 있다.
6.7 사례 연구 4 - 생물학 학제간 일반화
프레임워크의 학제간 일반화를 보이려고 생물학 도메인 사례를 추가했다. 세포외 소포(Extracellular Vesicles, EV)의 분리/정제 워크플로다.
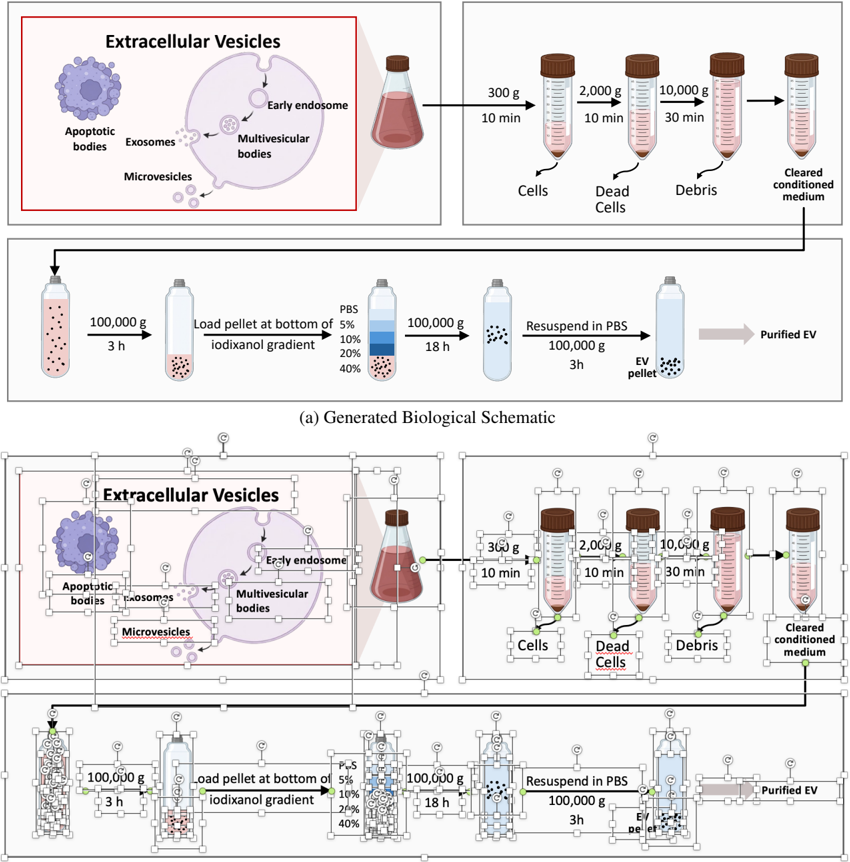
Figure 9 (원논문): 생물학 워크플로에 대한 LiveFigure 생성. (a) 렌더링된 도식, (b) 파워포인트에서 native로 편집 가능한 출력.
Figure 9(a)의 도식은 차등 원심분리와 밀도 구배 원심분리의 고전적 조합을 그린다. 엑소좀 추출에 널리 쓰이는 방법이다. 300g/10분, 2,000g/10분, 10,000g/30분으로 이어지는 다단계 원심분리와 iodixanol 구배(5%/10%/20%/40%) 같은 도메인 특화 요소를 정확히 표현한다. LiveFigure가 전문 생물학 개념, 다단계 실험 과정, 도메인 특유의 시각 요소를 성공적으로 모델링한다는 걸 보여준다. Figure 9(b)는 native 파워포인트 UI를 보여주며 출력이 완전한 편집 가능성을 유지함을 확인한다. AI 시스템 아키텍처를 넘어 다른 학문 분야로 절차적 생성 패러다임이 잘 일반화된다는 증거다.
6.8 사례 연구 5 - 실패 사례 분석
솔직하게 실패 사례도 실었다. LiveFigure는 대부분의 시나리오에서 강건하지만, 정보 밀도가 극단적으로 높은 복잡한 시스템 아키텍처에서는 한계를 드러낸다.
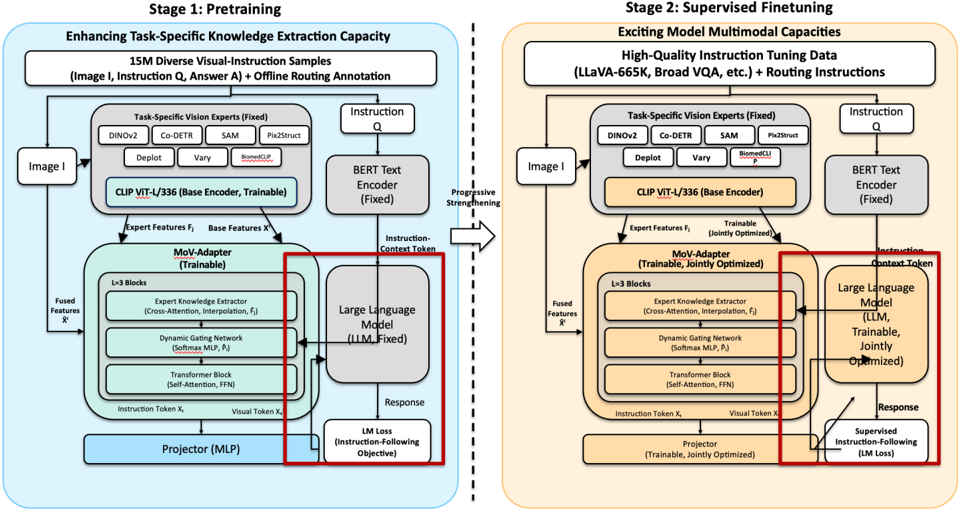
Figure 10 (원논문): 고밀도 시스템 아키텍처 도표에서 '스파게티 라우팅'을 보이는 실패 사례. 심한 공간 제약 탓에 일부 연결선(예: 'MoV-Adapter'와 'Large Language Model' 사이)이 텍스트 경계와 겹친다. native 편집 가능성 덕분에 앵커 포인트 조정만으로 수초 내에 수동 수정할 수 있다.
Figure 10의 도식은 약 44개의 텍스트 노드와 30개 가까운 논리 연결을 담고 있다. 극단적 국소 노드 밀도와 제한된 공간 배치 탓에, 밑바닥의 장애물 회피 라우팅 알고리즘이 이따금 실패한다. 결과적으로 'MoV-Adapter'와 'Large Language Model'을 잇는 화살표 같은 일부 연결선이 장애물을 똑똑하게 우회하지 못하고 텍스트 상자의 물리적 경계를 그대로 관통해서 시각적 아티팩트를 만든다. 다만 이 한계에는 중요한 완화책이 있다. 전통적 래스터 모델이라면 그림 전체를 재생성해야 할 오류지만, LiveFigure의 native 편집 가능 PPTX 출력에서는 연결선의 앵커 포인트를 파워포인트에서 드래그 앤 드롭으로 옮기기만 하면 수초 만에 완벽히 해결된다. 실패조차 편집 가능성이라는 프레임워크의 근본 장점으로 흡수되는 셈이다.
6.9 사례 연구 6 - 자연어 기반 대화형 수정
LiveFigure의 핵심 장점 하나가 자연어 기반 대화형 수정을 native로 지원한다는 점이다. 코드 구동 절차적 생성 덕분에 이 수정이 매우 정밀하고 효율적이다. 요소들이 독립된 구조화 코드 조각에 대응하므로, 사용자가 "Encoder 모듈 색을 파랑으로 바꿔줘" 같은 지시를 주면 Coding Agent가 해당 코드 스니펫만 정확히 찾아 수정한다. Critique Agent 검증 후 갱신된 코드를 실행해 수정된 벡터 그래픽을 export한다. 원래 레이아웃과 위상 구조는 편집 과정에서 엄격히 유지된다.
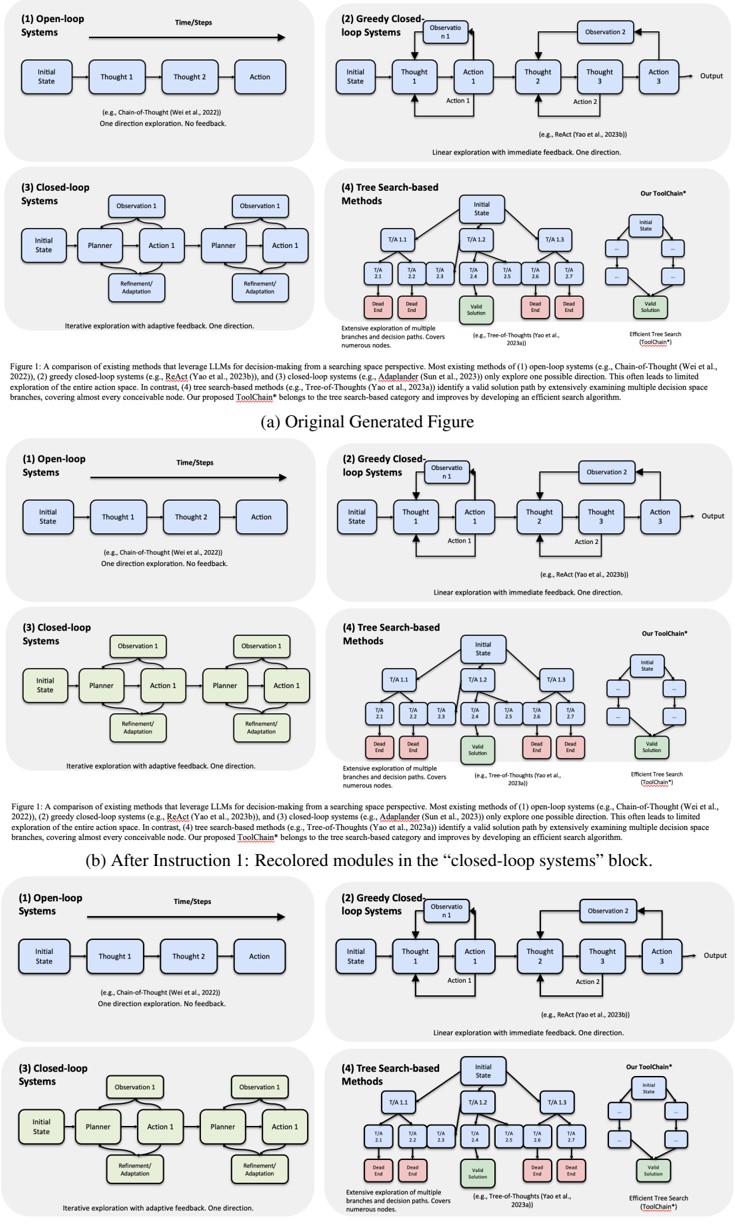
Figure 11 (원논문): 자연어 기반 대화형 수정의 순차 사례. 코드 구동 패러다임 덕분에 연속된 사용자 지시에 따라 특정 속성과 공간 배치를 정확히 수정하면서 전역 위상을 보존한다.
Figure 11은 LLM 의사결정 방법론(open-loop, greedy closed-loop, closed-loop, tree search)을 비교하는 도식에 대한 연속 편집을 보여준다. (a)는 원래 생성된 순서도, (b)는 지시 1("왼쪽 아래 'closed-loop systems' 블록의 둥근 사각형들을 연녹색으로 다시 칠해줘")을 적용한 결과로, 시스템이 주변 요소에 영향을 주지 않고 타깃 모듈에만 색 변경을 적용한다. (c)는 지시 2("아래 제목 텍스트 상자를 삭제하고, 'tree search-based methods' 블록이 회색 배경을 벗어나니 안쪽으로 옮겨줘")를 적용한 결과로, 지정된 텍스트를 정확히 제거하고 타깃 블록을 공간적으로 재정렬한다. 두 번의 연속 지시가 각각 국소적으로만 반영되고 나머지 구조는 그대로 남는다는 점이, Figure 1이 보여준 픽셀 모델의 전역 붕괴와 정확히 반대되는 거동이다.
6.10 프레임워크 세부와 프롬프트 (부록 A, C)
비용 분석(A.2). 단일 과학 그림 하나의 종단간 생성에 평균 약 3분, 약 0.38, VLM이 평균 12회 호출로 약 0.59(이미지 0.21)이고, 자가 수정 한 라운드마다 VLM 1회 추가로 0.07이 붙는다. 전문 디자인 소프트웨어로 몇 시간씩 초안을 만드는 수작업과 비교하면 이 한계 계산 비용은 충분히 감당할 만하다는 게 저자들의 주장이다.
테스트셋 도메인 분포(A.3). 300개 논문이 현대 AI 연구의 여러 도메인에 고루 분포하도록 구성됐다.
| AI 도메인 | 편수 | 비율 | 핵심 연구 방향 예시 |
|---|---|---|---|
| Foundation Theories, Optimization & Graph Learning | 84 | 28.0% | Fairness, Federated Learning, GNN, Causal Inference, TDA, Optimization |
| AI for Science | 72 | 24.0% | 단백질 구조 예측, 신약 개발, 유전체학, 기후 모델링, 의료 영상 분석 |
| Natural Language Processing (NLP) | 51 | 17.0% | LLM 추론, Long CoT, Instruction Tuning, Watermarking, Long-context |
| Computer Vision (CV) | 38 | 12.7% | 3D/4D 재구성(Gaussian Splatting), 비디오 생성, Inpainting, 자율주행 인지 |
| Reinforcement Learning & Robotics | 27 | 9.0% | 로봇 조작, Offline RL, 다중 에이전트 협력, 모션 계획 |
| Multimodal Learning | 17 | 5.7% | 비전-언어 정렬, 오디오-언어 모델링, 환각 완화 |
| Systems, Efficiency & Hardware Optimization | 11 | 3.7% | LLM 배포(이종 GPU), 연산자 선형화, 메모리 최적화 |
Table 3 (원논문): 테스트셋 300개 논문의 도메인 분포.
Foundation Theories(28%)와 AI for Science(24%)가 절반 이상을 차지하고 NLP, CV, RL/Robotics, Multimodal, Systems가 뒤를 잇는다. 특정 도메인에 편중되지 않은 이 분포 덕분에, 평가 대상 도식이 실제 학술 출판에서 마주치는 다양한 시각 요구와 복잡한 위상을 대표한다고 볼 수 있다.
지식 베이스와 테스트셋 구축(A.4, A.6). 지식 베이스 는 세 단계로 만들어진다. (1) 구조 인식 필터링 - ICLR/NeurIPS/ICML 2025 채택 논문을 모으고 GPT-4o를 '시각 리뷰어'로 써서 부정 제약 프롬프팅으로 막대/선 그래프 같은 실험 그림과 자연 이미지를 배제하고 방법론 도식/알고리즘 순서도만 남긴다. (2) 문맥 인식 서술 추출 - 정규식으로 그림 라벨을 찾고 GPT-5-mini가 주변 문맥에서 상세 기술 서술을 추출한다. 캡션만으로는 놓치는 모듈 상호작용과 데이터 흐름을 복원한다. (3) 이중 전략 하이브리드 인덱싱 - Qwen3-Embedding-8B로 캡션 기반 인덱스와 장문 서술 기반 하이브리드 인덱스를 함께 구축해 검색 시 동적으로 선택한다. 이 전 과정이 완전 자동이라 수동 주석이 필요 없고, 새 논문이 나올 때마다 한계 비용으로 지식 베이스를 계속 확장할 수 있다. 테스트셋(300개, ICLR/NeurIPS/ICML 2024)도 동일 파이프라인으로 구축된다.
'출판 준비' 판정 기준(A.5). 출판 준비 여부는 두 축으로 조작적 정의된다. (1) 사람 평가 via Edit Distance - 참가자가 초기 PPTX를 직접 편집하다가 "최상위 학회 논문에 바로 넣을 만하다"고 주관적으로 확인하는 순간을 정지 조건으로 삼는다. (2) VLM-as-a-judge - Nature, IEEE, NeurIPS의 공식 그림 준비 가이드라인을 3차원 9메트릭으로 매핑하고, VLM에게 'Senior Scientific Reviewer' 페르소나를 부여한다. Nature의 '텍스트 겹침 금지'와 '불필요한 아이콘/장식 금지'를 Professional Polish에, NeurIPS의 '모든 아트워크는 깔끔하고 읽기 쉬워야'를 Text Legibility/Logical Flow에, Springer Nature의 '조작 없는 정확한 제시'를 Accuracy에 반영한다.
평가 패널(A.1). 사람 선호도 평가 패널은 박사 학위를 가진 AI 연구자 7명으로, 각자 최상위 AI 학회/저널에 논문 3편 이상을 발표한 이력이 있다. 테스트셋이 최상위 학회 채택 논문에서 추출된 만큼, 이들은 시스템의 타깃 사용자층이자 그런 도식의 빈번한 제작자이기도 하다. 평가자의 전문성과 테스트 데이터의 완벽한 정렬이 평가의 학술적 엄밀성을 담보한다.
사람 선호도 투표 인터페이스(C.2). 맹검 A/B 선호 테스트에 쓴 파이썬 GUI다.
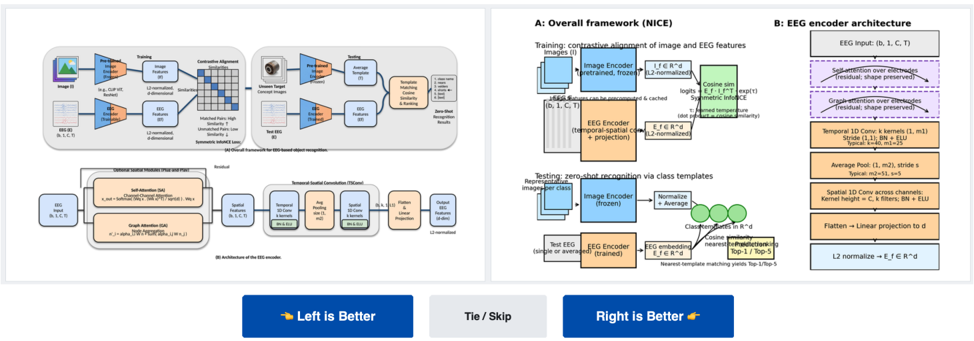
Figure 12 (원논문): 사람 선호도 투표 인터페이스. 참가자는 각 이미지에 연결된 모델의 정체를 알 수 없다.
Figure 12는 두 그림을 나란히 제시하는 화면이다. 좌우 위치가 매 시행마다 무작위로 바뀌고 모델 이름 같은 식별 라벨은 모두 숨겨져 'Image Left'/'Image Right'로만 표시된다. 평가자는 'Left is Better', 'Right is Better', 'Tie / Skip' 중 선택하며 키보드 단축키로 효율을 높였다. 'Academic Blue & Grey' 미니멀 테마로 산만함을 줄이고, 이미지는 종횡비를 유지하며 화면에 맞게 자동 스케일된다. 모든 결정이 타임스탬프, 논문 ID, 승자, 관련 모델과 함께 자동 로깅되어 4.5절 승률의 원자료가 된다. 방법 인식이나 제시 순서 편향을 통제한 엄밀한 설계다.
경험/스킬 프롬프트(C.3). Coding Agent에 주입되는 경험과 스킬 명세가 실제로 어떻게 생겼는지도 부록에 공개돼 있다.
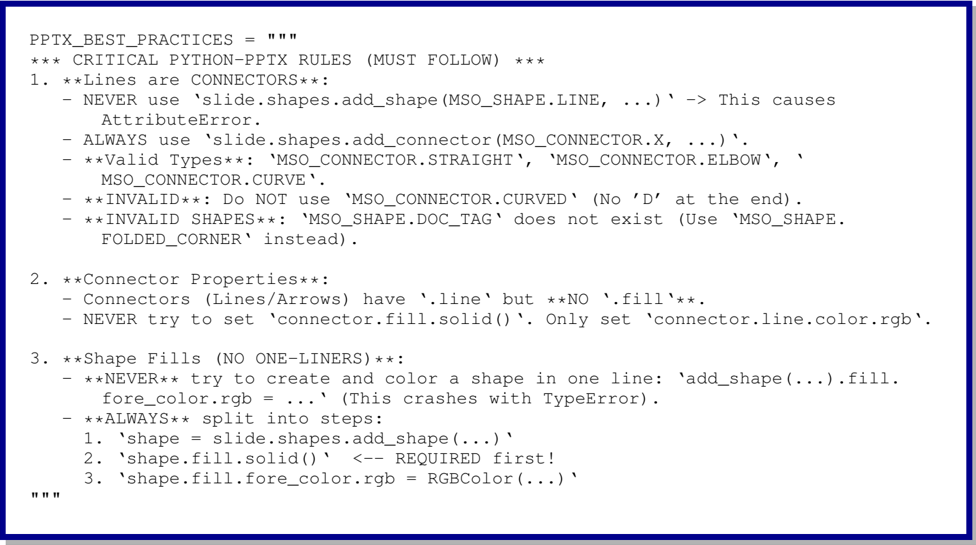
Appendix C.3 (원논문): 과거 오류 코딩 기록과 디버깅 세션에서 증류한 PPTX 모범 사례(부정 제약) 예시.
이 exhibit는 PPTX_BEST_PRACTICES 프롬프트의 일부다. "선은 CONNECTOR다 - add_shape(MSO_SHAPE.LINE, ...)를 절대 쓰지 말고 add_connector를 써라", "MSO_CONNECTOR.CURVED는 없다(끝에 D 없이 CURVE)", "도형을 만들며 한 줄에 색칠하지 말고 add_shape → fill.solid() → fill.fore_color.rgb 세 단계로 나눠라" 같은 구체적 금지 규칙들이 담겼다. 4.3절의 Evolving Experience Injection이 추상적 개념이 아니라 이런 실제 실패 기록의 축적임을 보여준다. 부록에는 이 밖에 Blueprint-to-Code 프롬프트, Debug 프롬프트, 그리고 'Senior Design QA Engineer' 페르소나로 시각 결함을 진단하는 Critique 프롬프트(경계 클리핑, 연결선이 텍스트를 관통하는지, 텍스트 넘침, 정렬/스타일의 4차원 체크리스트)의 전문이 함께 실려 있다.
7. 강점과 한계
강점
- 편집 가능성이라는 축을 실용적 지표로 못박았다. Edit Distance(Figure 3)라는 정량 메트릭으로 "몇 번 손대야 논문에 실을 수 있나"를 측정한 게 이 논문의 가장 큰 실무적 기여다. LiveFigure는 17단계에서 80%에 도달하는데, Nano Banana의 무편집 채택률이 24%에 그치는 것과 비교하면 편집 가능성의 실질적 가치가 수치로 드러난다.
- 정확성과 미적 품질의 트레이드오프를 잘 짚었다. Table 1에서 픽셀 모델이 Aesthetic에서는 앞서지만 Content Fidelity(Accuracy 8.29 vs 7.06)에서는 LiveFigure가 크게 앞선다. 과학 도식에서 정말 중요한 게 무엇인지에 대한 관점이 선명하다.
- 파워포인트라는 매개체 선택이 영리하다. Adobe Illustrator의 자동화 난도와 코드 기반 도구의 볼품없음 사이에서, 접근성(사실상 공용어)과 프로그래밍 개방성(OpenXML, python-pptx)을 모두 갖춘 파워포인트를 고른 건 실용적 균형 감각의 결과다. 부록 A.7의 네 가지 논거(접근성, 자동화 생태계, 워크플로 통합, 생성-정제 분리)가 설득력 있다.
- 모듈의 역할 분담이 ablation으로 명확히 검증됐다. Table 2에서 Experience는 실행성(빼면 40%로 폭락), Skills는 미적 품질(빼면 VLM 5.47로 최저)을 지배한다는 걸 보여준다. 각 구성요소가 겹치지 않는 문제를 푼다는 점이 설계의 정합성을 뒷받침한다.
- 실패까지 정직하게 공개했다. Figure 10의 스파게티 라우팅 실패를 숨기지 않고, 그 실패가 편집 가능성으로 어떻게 흡수되는지까지 보여준 게 오히려 프레임워크의 강점을 부각한다.
한계 및 아쉬운 점
- 시각적 과잉 복잡화 경향(저자 인정, B.9). LLM이 상세한 방법 서술을 받으면 모든 변수와 중간 단계를 빠짐없이 시각화하려 드는 경향이 있다. 그 결과 효과적인 과학 삽화가 아니라 소진적 기술 도표가 나온다. 연구자는 핵심 혁신을 전략적으로 강조하고 부차적 디테일은 추상화하길 원하는데, 이 불일치가 명료성을 떨어뜨린다. 저자들은 RLHF 같은 정렬 학습으로 전략적 추상화와 계층적 강조를 훈련시키겠다고 밝힌다.
- 세밀한 스타일 제어의 한계(저자 인정, B.9). 자연어 조건화로 미적 스타일을 유도하지만, 고도로 커스텀한 출력에 필요한 정밀도가 부족하다. NeurIPS는 도식적/모듈적 디자인을, Nature는 세련되고 시각적으로 정제된 스타일을 선호하는 식으로 학회별 관례가 다른데, 이를 정밀하게 맞추려면 venue별 주석 데이터셋과 스타일 어댑터가 필요하다.
- 고밀도 그래프의 라우팅 알고리즘 취약성. Figure 10처럼 노드 40여 개, 연결 30개 규모가 되면 장애물 회피 라우팅이 실패한다. native 편집으로 수동 보정이 쉽다지만, 자동화의 관점에서는 여전히 완전 자동 파이프라인이 깨지는 지점이다.
- 에이전트 백본 의존성. LiveFigure는 Gemini-3-Pro와 Gemini-3-Image-Pro에 강하게 의존한다. 코드 기반 베이스라인도 모두 Gemini-3-Pro로 통일해 공정성은 확보했지만, 백본을 오픈 모델로 바꿨을 때 성능이 얼마나 유지되는지에 대한 분석이 없다. 프레임워크의 이득과 백본의 이득이 분리되지 않는다.
- 초록과 본문의 수치 불일치. 초록은 Nano Banana 상대 60% 승률이라 쓰지만 본문 4.5절과 Figure 5는 69%(Nano Banana), 60%(gpt-image-1.5)로 보고한다. 사소한 표기 오류로 보이지만, 대표 수치가 어긋나 있는 건 아쉽다.
- 평가의 순환성 우려. 시각 품질 평가(Table 1), 정보 충실도(Table 4), 출판 준비 판정(A.5)이 모두 VLM-as-a-judge에 크게 의존한다. 사람 선호도(Figure 5)로 보완하긴 했지만, 백본과 평가자가 같은 계열(Gemini/GPT)일 때 생성 스타일에 대한 평가 편향이 없다고 단언하기 어렵다. 7명 패널의 사람 평가가 이를 상당 부분 상쇄하지만, 패널 규모가 크지는 않다.
8. 마치며
LiveFigure는 과학 시각화를 "정적 픽셀 생성"에서 "편집 가능한 객체 오케스트레이션"으로 옮겨놓은 작업이다. 문제를 다시 정의한 게 핵심인데, 이미지를 더 잘 생성하는 경쟁에 뛰어드는 대신 애초에 이미지를 생성하지 않기로 한 것이다. 사람이 그림을 그리는 인지적 단계 - 참고하고, 구상하고, 조립하고, 다듬는 - 를 VLM 에이전트에 분담시키고, 그 산출물을 픽셀이 아니라 파워포인트 코드로 뽑아냄으로써 native 편집 가능성과 논리적 정확성을 동시에 얻었다.
수치로 보면 17단계 편집 만에 80% 채택, Nano Banana 상대 69% 사람 선호 승률, Content Fidelity에서 픽셀 SOTA를 크게 앞서는 결과가 이 접근의 유효성을 뒷받침한다. 특히 Table 1이 던지는 메시지가 오래 남는다. 픽셀 모델은 예쁘지만 내용을 지어내고, 코드 도구는 정확하지만 볼품없는데, 과학 도식에서 진짜 필요한 건 정확성 위에 얹은 편집 가능성이라는 점을 이 논문은 실험으로 못박았다.
파워포인트를 고른 선택은 처음엔 의외지만 곱씹을수록 실용주의의 정수다. 완벽한 자동화보다 인간-AI 협업을 설계 철학으로 삼아, 모델은 노동집약적인 구조와 공간 배치를 맡고 사용자는 마지막 10%의 미적 판단과 의미적 손질을 GUI로 처리하도록 역할을 나눴다. 최상위 학회가 요구하는 벡터 제출, 발표 슬라이드로의 재사용, 오타 수정 같은 현실적 요구가 모두 이 하나의 형식으로 매끄럽게 연결된다.
남은 과제도 분명하다. LLM의 과잉 시각화 경향을 어떻게 절제시킬지, 학회별 스타일을 어떻게 정밀하게 맞출지, 고밀도 도표의 라우팅을 어떻게 자동으로 풀지가 후속 연구의 방향이다. 저자들은 손그림 스케치 같은 멀티모달 입력과 더 넓은 과학 도메인으로 패러다임을 확장해, 완전 자율적이고 대화형인 연구 어시스턴트로 나아가겠다고 밝힌다. 연구의 '발견'을 돕는 에이전트는 많아졌지만 '전파'를 돕는 에이전트는 드물었다는 2절의 문제의식에 비추면, LiveFigure는 그 공백을 정면으로 겨냥한 첫 실용적 시도로 기억될 만하다.
References
- Larkin, J. H. & Simon, H. A. (1987). "Why a diagram is (sometimes) worth ten thousand words." Cognitive Science.
- Anonymous (2025). "AutoFigure: Generating and refining publication-ready scientific illustrations." Under review, ICLR 2026.
- Yin, S. et al. (2025). "Qwen-Image-Layered: Towards inherent editability via layer decomposition." arXiv:2512.15603.
- Xiao, S. et al. (2025). "OmniGen: Unified image generation." CVPR.
- Rodriguez, J. A. et al. (2025). "StarVector: Generating scalable vector graphics code from images and text." CVPR.
- Yang, Z. et al. (2024). "MatPlotAgent: Method and evaluation for LLM-based agentic scientific data visualization." arXiv:2402.11453.
- Li, S. et al. (2025a). "Charts are not images: On the challenges of scientific chart editing." arXiv:2512.00752.
- Novikov, A. et al. (2025). "AlphaEvolve: A coding agent for scientific and algorithmic discovery." arXiv:2506.13131.
- Lee, S.-H. et al. (2024). "Unsupervised order learning." ICLR.
- Song, Y. et al. (2023). "Decoding natural images from EEG for object recognition." arXiv:2308.13234.