논문 리뷰
논문 리뷰: PaperBanana - Automating Academic Illustration for AI Scientists
논문 그림(방법론 다이어그램과 통계 플롯)을 자동으로 그려주는 에이전트 프레임워크. 참조 예시 검색, 콘텐츠·스타일 기획, 이미지 렌더링, 자기비평 기반 반복 수정을 5개 전문 에이전트로 분업시켜 사람이 그린 그림에 근접한 품질을 낸다.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | PaperBanana: Automating Academic Illustration for AI Scientists |
| 저자 | Dawei Zhu, Rui Meng, Yale Song, Xiyu Wei, Sujian Li, Tomas Pfister, Jinsung Yoon |
| 소속 | Peking University, Google Cloud AI Research |
| 공개 | arXiv 2026 (v2, 2026-03-24) |
| 논문 링크 | arXiv:2601.23265 |
| 프로젝트 | dwzhu-pku.github.io/PaperBanana |
1. 들어가며
자율 AI 과학자(autonomous AI scientist)라는 말이 더 이상 공상으로 들리지 않는 시대가 됐다. LLM 기반 에이전트는 문헌 조사를 하고, 아이디어를 내고, 실험을 반복하며 코드를 짜는 일까지 상당 부분 자동화하고 있다. 그런데 정작 연구를 "발표"하는 단계로 오면 이 자동화의 사슬이 뚝 끊긴다. 논문의 핵심 아이디어를 한 장에 압축해 보여주는 방법론 다이어그램(methodology diagram), 실험 결과를 담는 통계 플롯(statistical plot). 이런 그림들은 여전히 사람이 Illustrator나 PowerPoint를 붙잡고 몇 시간씩 씨름해서 만든다.
그림 그리기가 왜 그렇게 번거로운가를 생각해보면, 논문 그림은 단순히 예뻐서는 안 되기 때문이다. 방법론 다이어그램은 (1) 본문에 서술된 모듈과 데이터 흐름을 사실 그대로 옮겨야 하고(faithfulness), (2) 학술지 수준의 시각적 완성도를 갖춰야 한다. 두 요구는 종종 충돌한다. 정확하게 다 그리면 지저분해지고, 예쁘게 다듬으면 디테일이 빠진다. 이 논문은 바로 그 지점, 즉 "정확성과 미학을 동시에 만족하는 논문 그림을 자동으로 생성한다"는 문제를 정면으로 다룬다.
PaperBanana의 접근을 한 문장으로 요약하면, 최신 VLM(Gemini-3-Pro)과 이미지 생성 모델(Nano-Banana-Pro)을 5개의 전문 에이전트로 엮어, 참조 예시를 검색하고 → 콘텐츠와 스타일을 기획하고 → 이미지를 렌더링하고 → 스스로 비평하며 고치는 파이프라인이다. 재미있는 점은 이 논문 자체가 자기 방법의 광고판이라는 것이다. 논문 안에서 바나나 아이콘이 붙은 그림들(Figure 2부터 6까지 상당수)은 전부 PaperBanana가 그렸다. 프레임워크 개요도조차 프레임워크가 그린 셈이다.
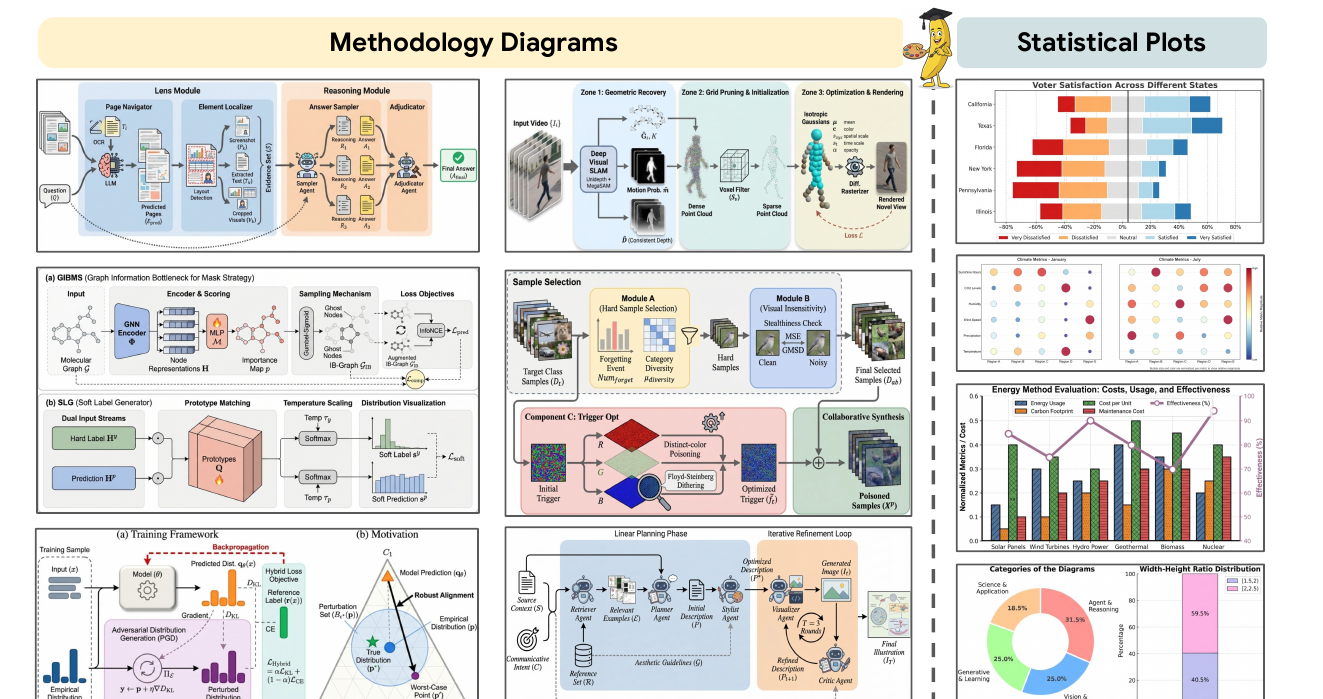
Figure 1 (원논문): PaperBanana가 생성한 방법론 다이어그램(좌)과 통계 플롯(우)의 예시. 학술 그림 자동 생성의 가능성을 보여준다.
Figure 1은 논문의 첫 인상을 결정하는 쇼케이스다. 왼쪽 6개의 방법론 다이어그램을 보면, GNN 기반 마스킹 전략, 딥 비주얼 SLAM 파이프라인, 적대적 분포 생성 학습 프레임워크처럼 서로 완전히 다른 도메인의 복잡한 구조를 각기 다른 색상 존(zone)과 아이콘으로 정리했다. 오른쪽 통계 플롯은 발산형 막대 그래프, 도트 매트릭스, 이중 축 막대-선 조합 등 실제 논문에서 흔히 쓰는 유형들이다. 눈여겨볼 대목은 텍스트 렌더링이다. 이미지 생성 모델의 고질적 약점이 글자를 깨뜨리는 것인데, 여기서는 수식 기호(, 등)와 모듈 라벨이 대체로 읽을 만하게 나온다. 이 그림 한 장이 "이미지 생성 모델로도 학술 그림이 가능하다"는 논문 전체의 주장을 압축한다.
2. 문제 정의: 학술 그림 생성이라는 과제
논문은 학술 그림 생성을 하나의 매핑 함수 학습 문제로 형식화한다. 소스 컨텍스트 (그림에 담을 핵심 정보, 예: 방법론 섹션 텍스트)와 소통 의도 (그림의 범위와 초점, 예: 그림 캡션 "Overview of our framework")가 주어졌을 때, 를 충실히 시각화하면서 를 만족하는 이미지 를 생성하는 것이 목표다.
여기에 참조 예시를 선택적으로 더할 수 있다. 개의 참조 예시 집합 을 두고, 각 예시 은 컨텍스트·의도·정답 그림의 삼중항이다. 이를 통합하면 과제 정의는 다음과 같아진다.
참조 예시를 쓰지 않는 제로샷 생성에서는 이 된다. 이 형식화가 왜 중요한가 하면, PaperBanana의 설계 철학이 바로 이 에 있기 때문이다. 사람이 좋은 그림을 그릴 때 백지에서 시작하지 않고 "이런 느낌의 그림"을 머릿속에 떠올리듯, 참조 예시가 구조적 논리와 시각적 스타일의 구체적 토대를 제공한다. 논문은 여러 학술 그림 유형 중에서도 방법론 다이어그램에 초점을 맞춘다. 통계 플롯은 데이터에서 규칙적으로 매핑되지만, 방법론 다이어그램은 복잡한 기술 개념과 논리 흐름을 텍스트에서 해석해 고품질 그림으로 옮겨야 하기에 훨씬 어렵다는 판단에서다.
3. 기존 연구의 한계
3.1 코드 기반 다이어그램 생성
학술 다이어그램 자동 생성은 오래된 숙제다. 기존 연구의 주류는 코드 기반 패러다임이었다. TikZ(DeTikZify, AutomaTikZ, TikZero)나 Python-PPTX(PPTAgent), SVG로 다이어그램을 프로그래밍적으로 합성하는 방식이다. 구조화된 콘텐츠에는 잘 맞지만, 현대 AI 논문에 흔한 정교한 시각 요소, 예를 들어 특수 아이콘이나 커스텀 도형을 표현하는 데는 근본적인 한계가 있다. 코드로 그릴 수 있는 것에 그림의 표현력이 갇히는 셈이다.
3.2 이미지 생성 모델의 가능성과 벽
반대편에는 최근 급성장한 이미지 생성 모델(Nano-Banana-Pro, GPT-Image, Qwen-Image 등)이 있다. 지시 따르기 능력과 시각적 품질이 크게 올라 유망한 대안으로 보이지만, 학술 기준을 일관되게 만족하는 그림을 뽑아내는 건 여전히 어렵다. 전문 도구를 다룰 줄 알아야 복잡한 아이디어를 자유롭게 표현할 수 있고, 결국 연구자가 그림 제작에 막대한 수작업을 쏟게 된다. 이것이 과학적 발견의 시각적 소통을 가로막는 병목이다.
같은 시기 연구인 AutoFigure와 AutoFigure-Edit는 과학 콘텐츠를 심볼릭 표현으로 바꾼 뒤 GPT-Image로 렌더링한다. PaperBanana는 이들과 비교해 적응형 검색(adaptive retrieval)과 학술 스타일 전이(academic-style transfer)로 더 넓은 일반화를 노리고, 방법론 다이어그램과 통계 플롯을 하나의 파이프라인에서 지원한다는 확장성을 강점으로 내세운다.
3.3 평가 벤치마크의 부재
자동 생성 다이어그램의 품질을 어떻게 잴 것인가도 미개척지였다. 가장 가까운 선행 연구는 SridBench로, 방법 섹션과 캡션으로부터의 다이어그램 생성을 컴퓨터과학·자연과학 도메인에서 평가한다(논문 작성 시점에 미공개였다). 평가 벤치마크의 공백이 엄밀한 비교를 막아왔고, 이것이 PaperBananaBench를 만든 직접적 동기다.
4. 핵심 아이디어
PaperBanana의 근본 통찰은 "무엇을 그릴지(구조 기획)"와 "어떻게 그릴지(미학 렌더링)"를 분리(decouple)하는 데 있다. 그리고 이 둘을 모두 참조 예시로부터 배운다. 검색(retrieval)이 모델에게 "어떤 유형의 그림을 그려야 하는지"를 알려주고, 자동 스타일 요약(automatic style summarization)이 "학술적 규범에 맞게 어떻게 그려야 하는지"를 가르친다. 이 참조 주도(reference-driven) 접근 덕분에 비싼 도메인별 파인튜닝 없이도 다양한 분야의 그림을 다룰 수 있다는 것이 저자들의 주장이다.
기존 코드 기반 방법이 "코드로 표현 가능한 것"에 갇혔다면, PaperBanana는 이미지 생성 모델의 자유로운 표현력을 쓰되, 그 약점인 사실성과 일관성을 에이전트 협업과 반복 비평으로 메운다. 한 번에 완벽한 그림을 뽑으려 하지 않고, VLM이 자기가 만든 그림을 뜯어보며 고쳐나가는 생성-비평 루프가 핵심 장치다. 이 구조가 실제로 어떤 효과를 내는지는 뒤의 Ablation에서 숫자로 드러난다.
5. 제안 방법: PaperBanana 프레임워크
PaperBanana는 5개의 전문 에이전트, 즉 Retriever(검색), Planner(기획), Stylist(스타일), Visualizer(시각화), Critic(비평)의 협업으로 원시 과학 콘텐츠를 출판 품질 그림으로 바꾼다. 전체 구조는 크게 두 단계, 선형 기획 단계(Linear Planning Phase)와 반복 수정 루프(Iterative Refinement Loop)로 나뉜다.
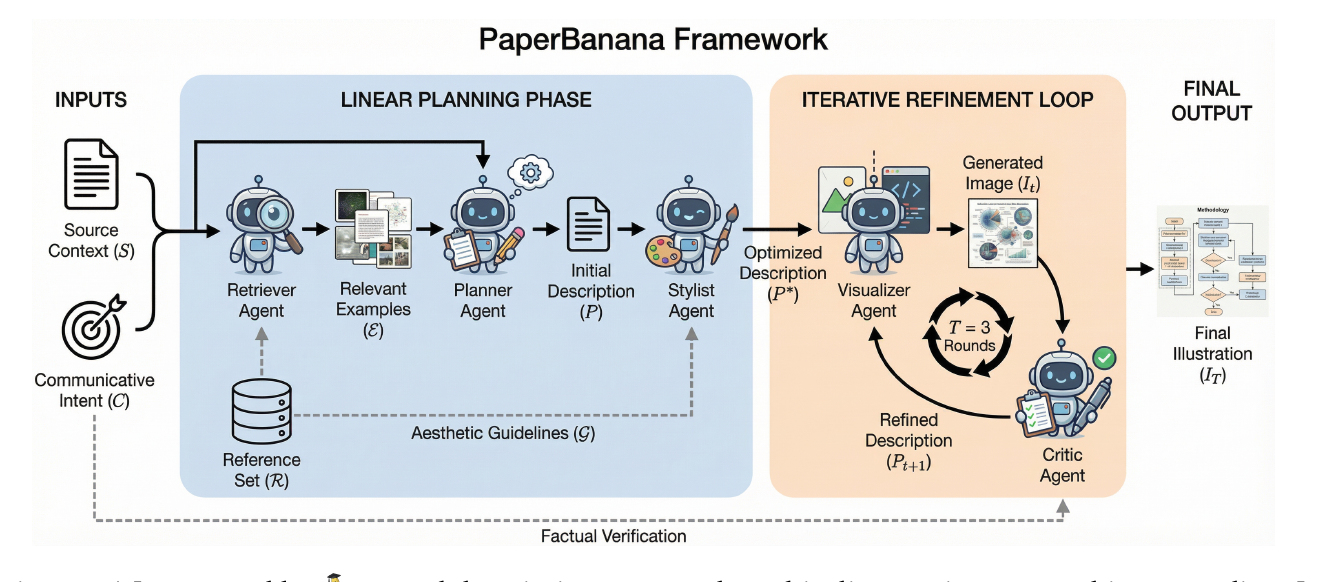
Figure 2 (원논문): PaperBanana 프레임워크 개요. 이 다이어그램 자체가 PaperBanana로 생성되었으며, 재현용 텍스트 설명은 부록 E에 있다. 소스 컨텍스트와 소통 의도가 들어오면 먼저 Linear Planning Phase에서 참조 예시를 검색하고 스타일 최적화된 설명을 합성한 뒤, Iterative Refinement Loop(Visualizer + Critic)에서 이를 시각 출력으로 바꾸고 여러 라운드 다듬어 최종 그림을 낸다.
Figure 2는 왼쪽부터 오른쪽으로 데이터가 흐른다. 입력(, )이 파란 존의 기획 단계를 지나며 검색-기획-스타일링을 거쳐 "스타일 최적화된 설명()"이 되고, 이것이 주황 존의 반복 루프로 들어가 Visualizer와 Critic이 라운드 주고받으며 최종 그림()을 만든다. 맨 아래를 가로지르는 회색 점선 "Factual Verification"이 눈에 띄는데, Critic이 원본 입력(, )을 계속 참조하며 사실 정합성을 확인한다는 것을 나타낸다. 각 에이전트를 귀여운 로봇 아바타로 그린 것도 이 그림이 자기 방법으로 그려졌다는 점을 은근히 자랑하는 장치다.
5.1 Retriever Agent: 참조 예시 검색
Retriever는 고정된 참조 집합 에서 현재 요구에 가장 관련 있는 개의 예시 을 골라 하위 에이전트들을 인도한다. 흥미로운 설계는 임베딩 유사도로 검색하지 않고, VLM의 추론 능력을 활용한 생성적 검색(generative retrieval)을 쓴다는 점이다. VLM이 후보 메타데이터를 보고 직접 선택하도록 지시한다.
구체적으로 VLM은 연구 도메인(예: Agent & Reasoning)과 다이어그램 유형(예: pipeline, architecture)을 함께 매칭하도록 지시받되, 주제 유사성보다 시각적 구조를 우선하도록 요구된다. 여기에 중요한 판단이 담겨 있다. 참조 예시가 필요한 이유는 "비슷한 주제의 논문"을 찾기 위해서가 아니라 "비슷한 구조와 스타일의 그림"을 찾기 위해서라는 것이다. 뒤의 Ablation에서 무작위 검색이 의미론적 검색과 맞먹는 성능을 내는 이유가 바로 여기서 예고된다.
5.2 Planner Agent: 콘텐츠 기획
Planner는 시스템의 인지 핵심(cognitive core)이다. 소스 컨텍스트 , 소통 의도 , 검색된 예시 를 받아, 의 시연으로부터 문맥 내 학습(in-context learning)을 수행하면서 의 비구조적/구조적 데이터를 그림에 대한 포괄적이고 상세한 텍스트 설명 로 번역한다.
이 단계의 산출물은 이미지가 아니라 "그림을 말로 그린 설계도"다. 어떤 모듈이 어디에 놓이고 어떤 화살표로 연결되는지를 텍스트로 명세한다. 이미지 생성을 텍스트 기획과 분리한 이 구조가 나중에 통계 플롯으로의 확장을 매끄럽게 만든다.
5.3 Stylist Agent: 스타일 최적화
Stylist는 디자인 컨설턴트 역할이다. 여기서 저자들이 정면으로 부딪힌 문제는 "학술 스타일"을 정의하는 일이 생각보다 어렵다는 것이다. 사람이 수동으로 정의한 스타일 규칙은 늘 불완전하다. 그래서 Stylist는 참조 집합 전체를 훑어 미학 가이드라인 를 자동으로 합성한다. 이 가이드라인은 색상 팔레트, 도형과 컨테이너, 선과 화살표, 레이아웃과 구성, 타이포그래피와 아이콘 같은 핵심 차원을 다룬다(요약된 가이드라인은 부록 F에 있다). 이렇게 얻은 로 초기 설명 를 스타일 최적화된 버전 로 다듬는다.
핵심은 스타일 규칙을 사람이 손으로 적지 않고 실제 학술 그림 292장에서 데이터 주도로 뽑아냈다는 점이다. "어떻게 그려야 학술적으로 보이는가"라는 암묵지를 명시적 텍스트 가이드로 증류한 것이다.
5.4 Visualizer & Critic Agent: 반복 수정 루프
스타일 최적화된 설명 를 받으면, Visualizer가 이미지 생성 모델로 이를 시각 출력으로 바꾼다. 반복 에서 설명 가 주어지면 다음을 생성한다.
초기 설명 는 로 설정된다. 그리고 Critic이 Visualizer와 폐루프(closed-loop) 수정 기제를 이룬다. Critic은 생성된 이미지 를 원본 컨텍스트 에 비추어 뜯어보며, 사실 불일치, 시각적 결함, 개선 여지를 찾아낸다. 그다음 타깃 피드백을 담아 수정된 설명 을 만든다.
이 수정된 설명이 다시 Visualizer로 들어가 재생성된다. Visualizer-Critic 루프는 라운드 반복하며, 최종 출력은 가 된다. 사람이 초안을 그린 뒤 "여기 화살표 방향이 틀렸네, 이 모듈이 빠졌네" 하며 고치는 과정을 VLM이 흉내 내는 셈이다. 이 루프가 실제로 사실성을 크게 끌어올린다는 것은 Ablation에서 확인된다.
5.5 통계 플롯으로의 확장
방법론 다이어그램과 달리 통계 플롯은 미학보다 수치 정확성이 절대적이다. 막대 하나의 높이가 데이터와 어긋나면 곧바로 오류다. 표준 이미지 생성 모델은 이 정밀성을 보장하지 못한다. 그래서 저자들은 Visualizer와 Critic 에이전트만 조정해 확장한다. Visualizer는 설명 를 실행 가능한 Python Matplotlib 코드로 변환하고(), Critic은 렌더링된 플롯을 평가해 부정확성을 바로잡는 수정 설명을 낸다(). 같은 라운드 반복이 적용된다. 즉 다이어그램은 이미지 생성, 플롯은 코드 생성이라는 서로 다른 백엔드를 같은 에이전트 골격 위에 얹은 것이다.
6. PaperBananaBench: 벤치마크 구축
엄밀한 평가를 위해 저자들은 PaperBananaBench를 만들었다. NeurIPS 2025 논문에서 큐레이션한 방법론 다이어그램 벤치마크로, 현대 AI 논문의 정교한 미학과 다양한 논리 구성을 담는다.
6.1 데이터 큐레이션
수집 파이프라인은 여러 단계의 필터링을 거친다. NeurIPS 2025의 5,275편 중 2,000편을 무작위 추출해 PDF를 받고, MinerU 툴킷으로 파싱해 방법론 섹션 텍스트와 모든 다이어그램·캡션을 뽑는다. 여기에 두 가지 필터를 건다. 첫째, 방법론 다이어그램이 없는 논문을 버려 1,359편의 유효 후보를 남긴다. 둘째, 가로세로비()를 로 제한한다. 1.5 미만은 방법론 다이어그램이 보통 넓은 가로 레이아웃을 요구하기에 제외하고, 2.5 초과는 현재 이미지 생성 모델이 지원하지 못한다. 이런 이상치를 포함하면 나란히 비교(side-by-side) 평가에서 사람이 그린 그림임이 드러나 편향이 생긴다는 점도 고려됐다. 이 단계에서 610개의 유효 후보가 각각 삼중항으로 남는다. 마지막으로 사람이 방법론 설명과 캡션을 검증·교정하고, 분류의 정확성을 확인하며, 시각 품질이 부족한 그림(지나치게 단순하거나 산만하거나 추상적인 것)을 걸러낸다. 이 과정을 거쳐 584개의 유효 샘플이 남고, 이를 절반씩 나눠 테스트셋()과 참조셋()으로 삼는다. 참조셋은 검색 증강 문맥 내 학습(retrieval-augmented in-context learning)에 쓰인다.
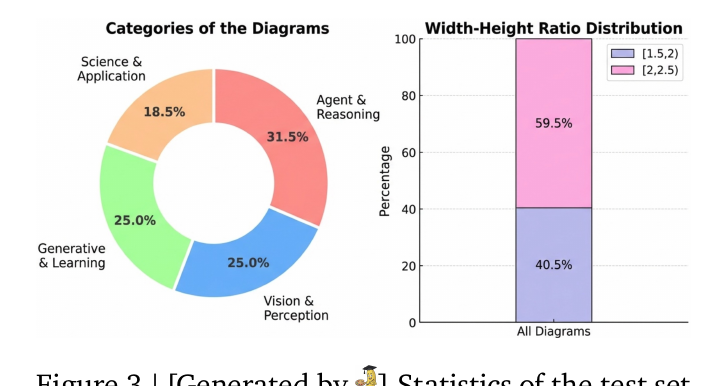
Figure 3 (원논문): PaperBananaBench 테스트셋(총 292 샘플)의 통계. 소스 컨텍스트/그림 캡션의 평균 길이는 각각 3,020.1 / 70.4 단어다. 이 그림도 PaperBanana로 생성되었다.
Figure 3의 왼쪽 도넛 차트는 다이어그램을 시각적 위상과 콘텐츠에 따라 나눈 네 범주의 분포다. Agent & Reasoning이 31.5%로 가장 많고, Vision & Perception과 Generative & Learning이 각각 25.0%, Science & Application이 18.5%로 뒤를 잇는다. 이 분포는 NeurIPS 2025의 연구 지형을 그대로 반영한다. 에이전트·추론 논문이 많고 그만큼 파이프라인형 다이어그램이 흔하다는 뜻이다. 오른쪽 막대는 가로세로비 분포로, 구간이 59.5%, 구간이 40.5%다. 방법론 다이어그램이 대체로 꽤 넓은 가로형이라는 사실이 수치로 확인된다. 소스 컨텍스트 평균이 3,020단어에 달한다는 점은, 그림 한 장을 위해 VLM이 소화해야 하는 텍스트가 그만큼 많다는 뜻이다.
방법론 다이어그램은 네 범주로 분류되며, 각 범주의 정의와 키워드는 부록 Table 3에 정리돼 있다. Gemini-3-Pro가 분류를 수행하되, 혼종 요소를 가진 샘플은 우세한 범주로 배정한다.
| 범주 | 정의 및 키워드 |
|---|---|
| 1. Agent & Reasoning | LLM 에이전트, 멀티 에이전트 시스템, 추론·계획·도구 사용, 지시 따르기, 문맥 내 학습, CoT, 코드 생성, 자율 시스템. 키워드: agent, llm, language model, reasoning, planning, prompt |
| 2. Vision & Perception | 컴퓨터 비전, 3D 재구성, 렌더링, 객체 탐지, 장면 이해, 깊이·포즈 추정, 시각 표현·특징 학습. 키워드: vision, image, 3d, gaussian, nerf, detection, segmentation, camera |
| 3. Generative & Learning | 생성 모델(diffusion, GAN, VAE, autoencoder), 강화학습·정책 학습, 최적화·학습 동역학. 키워드: diffusion, generative, gan, denoising, reinforcement, policy, reward |
| 4. Science & Applications | AI for Science(생물·화학·물리·의학), 그래프 신경망·구조적 데이터, 이론적 분석·수학적 증명, 도메인 특화 응용. 키워드: protein, molecule, biology, graph, node, theorem, theory |
Table 3 (원논문): 시각적 위상과 콘텐츠에 기반한 다이어그램 분류.
6.2 평가 프로토콜
평가는 VLM-as-a-Judge로 이뤄진다. 시각 디자인 평가에는 본질적 주관성이 있으므로, 참조 비교(referenced comparison) 방식을 쓴다. 심판(judge)이 모델 생성 그림과 사람이 그린 그림을 컨텍스트·캡션과 함께 놓고, 각 기준에서 어느 쪽이 더 나은지를 판정한다.
평가 차원은 두 관점으로 나뉜다. 콘텐츠 관점의 Faithfulness(소스 컨텍스트와 캡션에 대한 정합성)와 Conciseness(시각적 잡음 없이 핵심 정보에 집중), 그리고 표현 관점의 Readability(이해 가능한 레이아웃, 읽히는 텍스트, 과도한 선 교차 없음)와 Aesthetics(학술 규범 준수). 각 차원에서 VLM 심판은 Model wins / Human wins / Tie를 판정하고 이를 각각 100, 0, 50점으로 매핑한다.
전체 점수 집계에는 계층적 전략(hierarchical aggregation)을 쓴다. 정보 시각화가 무엇보다 "진실을 보여줘야 한다"는 원칙에 따라, Faithfulness와 Readability를 1차 차원, Conciseness와 Aesthetics를 2차 차원으로 둔다. 1차 차원에서 결정적 승자가 나오면(둘 다 이기거나, 하나를 이기고 하나가 무승부) 그것이 전체 승자다. 1차가 비기면(각각 하나씩 이기거나 둘 다 무승부) 같은 규칙을 2차 차원에 적용한다. 콘텐츠 충실성과 명료성이 미학과 간결성보다 우선한다는 가치 판단이 집계 규칙에 새겨져 있다.
7. 실험 결과
7.1 메인 결과
베이스라인은 세 가지다. (1) Vanilla는 이미지 생성 모델에 입력 컨텍스트를 직접 넣는 방식, (2) Few-shot은 Vanilla에 10개의 (방법론 설명, 캡션, 다이어그램) 삼중항 예시를 붙여 문맥 내 학습을 유도하는 방식, (3) Paper2Any는 논문의 고수준 아이디어를 그림으로 만드는 에이전트 프레임워크로 이 논문의 설정과 가장 가깝다. VLM 백본은 Gemini-3-Pro가 기본이고, 이미지 생성 모델로는 Nano-Banana-Pro와 GPT-Image-1.5를 실험한다.
| Method | Faithfulness ↑ | Conciseness ↑ | Readability ↑ | Aesthetic ↑ | Overall |
|---|---|---|---|---|---|
| Vanilla 설정 | |||||
| GPT-Image-1.5 | 4.5 | 37.5 | 30.0 | 37.0 | 11.5 |
| Nano-Banana-Pro | 43.0 | 43.5 | 38.5 | 65.5 | 43.2 |
| Few-shot Nano-Banana-Pro | 41.6 | 49.6 | 37.6 | 60.5 | 41.8 |
| 에이전트 프레임워크 | |||||
| Paper2Any (w/ Nano-Banana-Pro) | 6.5 | 44.0 | 20.5 | 40.0 | 8.5 |
| PaperBanana w/ GPT-Image-1.5 | 16.0 | 65.0 | 33.0 | 56.0 | 19.0 |
| PaperBanana w/ Nano-Banana-Pro | 45.8 | 80.7 | 51.4 | 72.1 | 60.2 |
| Human (참조) | 50.0 | 50.0 | 50.0 | 50.0 | 50.0 |
Table 1 (원논문): PaperBananaBench 메인 결과. 각 열의 최고 점수를 굵게 표시. Human 행(50점)은 사람이 그린 참조 그림 대비 상대 점수의 기준선이다.
숫자를 읽는 첫 감각은 이미지 생성 모델의 선택이 전부라는 것이다. GPT-Image-1.5는 Vanilla에서 Overall 11.5, PaperBanana를 붙여도 19.0에 그친다. 반면 Nano-Banana-Pro는 Vanilla 43.2에서 PaperBanana로 60.2까지 뛴다. 저자들은 GPT-Image의 부진을 지시 따르기와 텍스트 렌더링 능력의 열세로 설명한다. 학술 그림의 까다로운 요구를 애초에 맞추지 못한다는 것이다. 프레임워크가 아무리 좋아도 백본 이미지 모델이 글자를 못 그리면 방법론 다이어그램은 무너진다.
PaperBanana(w/ Nano-Banana-Pro)가 Vanilla Nano-Banana-Pro 대비 얻은 개선을 보면, Faithfulness +2.8%, Conciseness +37.2%, Readability +12.9%, Aesthetics +6.6%로 Overall +17.0%다. 특히 Conciseness의 43.5 → 80.7 도약이 압도적이다. Vanilla가 본문 텍스트를 그대로 그림에 쏟아붓는 반면, PaperBanana는 Planner와 Stylist가 핵심만 추려 시각적 잡음을 크게 줄인다는 뜻이다. Human 기준선(모든 차원 50)과 비교하면, Conciseness(80.7), Readability(51.4), Aesthetics(72.1)에서 사람 그림을 앞서지만 Faithfulness(45.8)에서는 여전히 사람에게 못 미친다. 이 Faithfulness 격차가 논문 전체를 관통하는 미해결 과제이며, 저자들도 이를 솔직히 인정한다.
Paper2Any가 Overall 8.5로 처참한 이유도 명확하다. Paper2Any는 논문의 고수준 아이디어 프레젠테이션을 지향하지, 특정 방법론 흐름의 충실한 묘사를 목표로 하지 않는다. 목표 자체가 이 평가 설정과 어긋나 저조한 결과가 나온 것이다. 벤치마크가 무엇을 재느냐에 따라 "좋은 방법"의 정의가 달라진다는 점을 보여주는 사례다.
범주별로 보면 Agent & Reasoning이 Overall 69.9%로 가장 높고, Science & Application 58.8%, Generative & Learning 57.0%, Vision & Perception 52.1%로 가장 낮다. Vision & Perception이 어려운 건 3D 재구성이나 포즈 추정처럼 공간적·기하적 관계가 촘촘한 다이어그램이 많아 사실성 확보가 까다롭기 때문으로 보인다.
7.2 심판의 신뢰성 검증
VLM 심판을 믿어도 되는가를 저자들은 두 갈래로 검증한다. Vanilla 25개, 자기 방법 25개, 총 50개 케이스를 무작위 표집해 확인한다.
모델 간 일치(일관성). Gemini-3-Pro 심판이 다른 VLM들과 얼마나 일치하는지를 본다. Gemini-3-Flash와의 Kendall's tau 상관은 네 차원(Faithfulness, Conciseness, Readability, Aesthetic)과 그 집계에서 각각 0.51, 0.60, 0.45, 0.56, 0.55이고, GPT-5와는 0.43, 0.47, 0.44, 0.42, 0.45다. 평가 프로토콜이 심판 모델에 크게 좌우되지 않는다는 것을 보인다.
사람과의 정렬(타당성). 두 명의 사람 주석자가 같은 50개 샘플에 같은 루브릭으로 독립 채점한 뒤 상충 케이스는 논의로 합의한다. Gemini-3-Pro와 사람 주석의 Kendall's tau 상관은 0.43, 0.57, 0.45, 0.41, 0.45다. 기존 문헌에서 tau가 0.4를 넘으면 비교적 강한 일치로 보므로, VLM 심판이 사람 인식과 잘 정렬된다는 근거가 된다. 여기에 더해, 50개 케이스에 대한 블라인드 사람 평가에서 PaperBanana는 3명의 심판 기준 평균 승/무/패 비율 72.7% / 20.7% / 6.6%로 Vanilla Nano-Banana-Pro를 앞선다. 자동 지표와 사람 평가가 같은 방향을 가리킨다는 점이 이 검증의 요지다.
8. Ablation Study
각 에이전트의 기여를 뜯어보기 위한 절제 실험이다. 결과는 아래 Table 2와 같다.
| # | Retriever | Planner | Stylist | Visualizer | Critic | Faithfulness ↑ | Conciseness ↑ | Readability ↑ | Aesthetic ↑ | Overall ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| ① | ✓ | ✓ | ✓ | ✓ | 3 iters | 45.8 | 80.7 | 51.4 | 72.1 | 60.2 |
| ② | ✓ | ✓ | ✓ | ✓ | 1 iter | 38.3 | 75.2 | 50.6 | 68.9 | 51.8 |
| ③ | ✓ | ✓ | ✓ | ✓ | - | 30.7 | 79.2 | 47.0 | 72.1 | 45.6 |
| ④ | ✓ | ✓ | - | ✓ | - | 39.2 | 61.7 | 47.9 | 67.4 | 49.2 |
| ⑤ | ◯(random) | ✓ | - | ✓ | - | 37.3 | 62.7 | 51.1 | 65.6 | 48.3 |
| ⑥ | - | ✓ | - | ✓ | - | 41.9 | 58.6 | 43.1 | 62.9 | 44.2 |
Table 2 (원논문): PaperBananaBench 절제 실험. ① 행(음영)이 PaperBanana의 기본 설정이다. ◯ 기호는 의미론적 검색 대신 10개를 무작위 선택하는 Random Retriever를 뜻한다.
Retriever의 영향(④-⑥ 행). 참조 예시가 아예 없는 무검색 설정(⑥)은 Conciseness(58.6), Readability(43.1), Aesthetics(62.9)에서 눈에 띄게 뒤처진다. 참조가 없으면 Planner가 장황하고 남김없이 나열하는 설명으로 흐르고, 학술 다이어그램 미학에 노출되지 못해 시각적으로 덜 다듬어진 결과를 낸다는 것이다. 그런데 정말 흥미로운 대목은 무작위 검색(⑤, Overall 48.3)이 의미론적 검색(④, Overall 49.2)과 거의 대등하다는 사실이다. 정밀한 콘텐츠 매칭보다 일반적인 구조·스타일 패턴을 제공하는 것이 더 중요하다는 뜻이다. 앞서 Retriever 설계에서 "주제 유사성보다 시각 구조를 우선"한다고 한 판단이 여기서 실증된다. 참조 예시의 역할은 "정답 베끼기"가 아니라 "학술 그림의 문법 감각 주입"에 가깝다.
Stylist와 Critic의 영향. ③과 ④를 비교하면 Stylist는 Conciseness를 +17.5%(61.7 → 79.2), Aesthetics를 +4.7%(67.4 → 72.1) 끌어올리지만 Faithfulness를 -8.5%(39.2 → 30.7) 떨어뜨린다. 시각적 다듬기가 때로 기술적 디테일을 생략하기 때문이다. 예쁘게 만들수록 정확성이 희생되는 이 긴장이 논문의 핵심 딜레마다. 그런데 Critic(① vs ③)이 이 격차를 메운다. Critic 없는 ③의 Faithfulness 30.7이 3라운드 Critic을 붙인 ①에서 45.8로 크게 회복된다. 반복 라운드를 더하면(② 1라운드 → ① 3라운드) 모든 지표가 함께 오른다. Stylist가 미학을 위해 사실성을 깎아먹으면, Critic이 원본과 대조하며 그 사실성을 되살리는 분업 구조인 것이다. 미학과 기술 정확성 사이의 균형이 이 두 에이전트의 밀고 당김에서 나온다.
9. 통계 플롯 생성으로의 확장
PaperBanana는 먼저 그림의 상세 설명을 합성한 뒤 이를 이미지로 시각화한다. 통계 플롯은 미학과 논리 정합성보다 엄밀한 수치 정밀성을 요구하므로 표준 이미지 생성 모델이 부적합하다. 그래서 실행 가능한 코드로 시각화하는 방식으로 확장한다.
테스트셋은 ChartMimic을 재활용해 구성한다. 원래 chart-to-code 생성용 데이터셋인데, 학술 논문의 통계 플롯과 Matplotlib 갤러리를 사람이 만든 Python 코드와 짝지어 담고 있다. Gemini-3-Pro로 코드에서 기저 표 데이터를 추출하고 각 플롯의 간단한 설명을 합성한다. 필터링과 표집을 거쳐 240개 테스트 케이스와 240개 참조 예시를 만들되, 막대·선·트리&파이·산점도·히트맵·레이더·기타 7개 범주와 easy/hard 2개 복잡도로 층화한다.
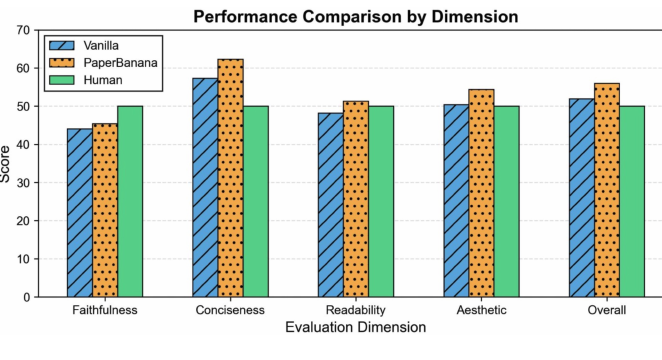
Figure 4 (원논문): 통계 플롯 생성에서 Vanilla Gemini-3-Pro와 PaperBanana의 비교. 이 그림도 PaperBanana로 생성되었다.
Figure 4는 Vanilla(파랑), PaperBanana(주황), Human(초록)을 다섯 차원에서 나란히 놓은 막대 그래프다. PaperBanana가 모든 차원에서 Vanilla를 앞서는데, Faithfulness +1.4%, Conciseness +5.0%, Readability +3.1%, Aesthetics +4.0%로 Overall +4.1% 개선이다. 다이어그램에서의 +17.0%에 비하면 개선폭이 작은데, 통계 플롯은 코드 기반이라 Vanilla도 애초에 꽤 잘하기 때문으로 읽힌다. 눈에 띄는 점은 PaperBanana가 Conciseness, Readability, Aesthetics에서 사람(초록 50 기준선)을 살짝 넘어서고 Faithfulness에서만 대등하다는 것이다. 수치 정확성이 코드로 보장되는 영역에서는 자동 생성이 사람 수준에 실질적으로 도달했다고 볼 수 있다.
10. 논의: 두 가지 흥미로운 확장
10.1 사람이 그린 다이어그램의 미학 개선
Stylist가 요약한 미학 가이드라인 를 놓고 자연스럽게 던질 수 있는 질문이 있다. 이 가이드라인으로 이미 존재하는 사람 그림의 미적 품질을 높일 수 있을까? 저자들은 간소한 파이프라인을 만든다. Gemini-3-Pro가 원본 다이어그램과 를 보고 최대 10개의 실행 가능한 제안을 만들면, Nano-Banana-Pro가 이를 실행해 이미지를 다듬는다. 292개 테스트 케이스에서 다듬은 그림은 원본 대비 미학에서 승/무/패 56.2% / 6.8% / 37.0%를 기록한다. 자동 요약한 미학 가이드라인이 실제로 사람이 그린 그림의 미적 품질을 끌어올릴 수 있다는 것이다.
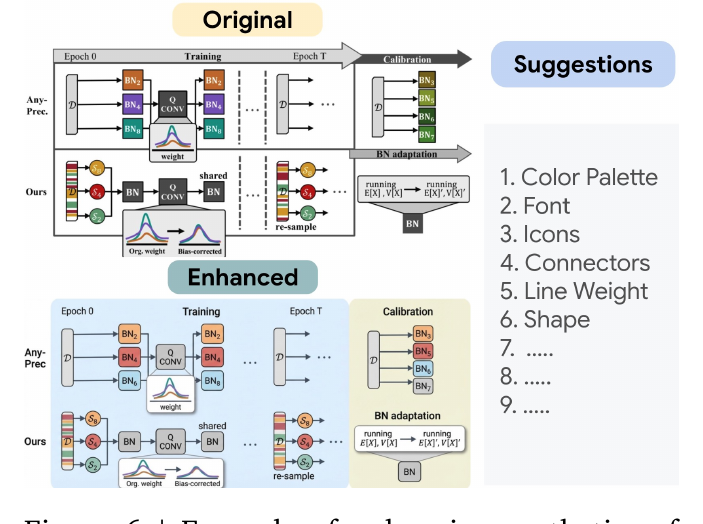
Figure 6 (원논문): 사람이 그린 다이어그램의 미학을 개선한 예시. 원본(Original)과 개선(Enhanced)을 비교하며, 오른쪽에 색상 팔레트·폰트·아이콘·커넥터·선 두께·도형 등의 제안 목록이 붙는다. 원본 그림은 Kim et al. (2025)에서 가져왔다.
Figure 6은 배치 정규화(BN) 관련 다이어그램의 before/after다. 위쪽 원본은 회색 톤에 밋밋한 박스 위주인데, 아래쪽 개선판은 파랑·노랑·초록의 존으로 기능 블록을 구분하고 아이콘을 덧붙여 훨씬 정돈돼 보인다. 오른쪽 제안 목록(1. Color Palette, 2. Font, 3. Icons, 4. Connectors, 5. Line Weight, 6. Shape...)이 개선의 축을 드러낸다. 다만 승률이 56.2%라는 점, 그리고 37.0%는 오히려 원본이 낫다고 판정됐다는 점은 이 개선이 만능이 아님을 보여준다. 자동 스타일링이 때로 원본의 의도된 구성을 흐트러뜨릴 수 있다는 신호다.
10.2 통계 플롯에서 코딩 vs 이미지 생성
통계 플롯에는 코드 기반이 효과적이라는 게 정설이지만, 최근 이미지 생성 모델의 충실도와 시각적 매력이 올라온 만큼 저자들은 둘을 정면 비교한다. Visualizer 에이전트를 코드 기반(Gemini-3-Pro)과 이미지 생성 기반(Nano-Banana-Pro)으로 바꿔 실험한다.
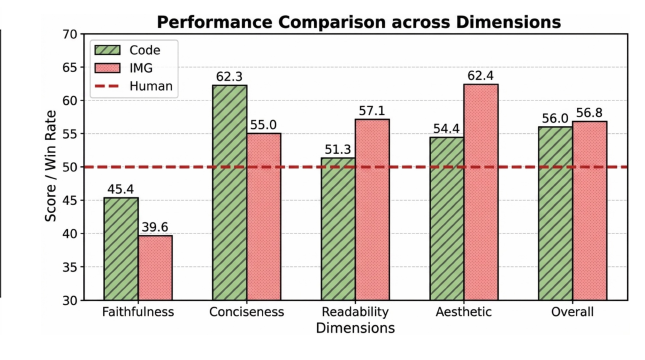
Figure 5 (원논문): 통계 플롯 시각화에서 코딩(Code)과 이미지 생성(IMG)의 비교. 빨간 점선은 사람(Human) 기준선(50)이다.
Figure 5는 뚜렷한 트레이드오프를 보여준다. 코드(초록)는 Faithfulness 45.4, Conciseness 62.3으로 콘텐츠 충실성에서 앞서고, 이미지 생성(빨강)은 Readability 57.1, Aesthetic 62.4로 표현 품질에서 앞선다. Overall은 코드 56.0, 이미지 56.8로 사실상 팽팽하다. 흥미로운 건 이미지 생성이 사람 기준선(50)을 Readability와 Aesthetic에서 넘지만 Faithfulness(39.6)에서는 크게 밑돈다는 점이다. 저자들의 수동 검사에 따르면 이미지 모델은 희소한(sparse) 플롯은 충실히 그리지만 조밀하거나 복잡한 데이터에서 수치 환각(numerical hallucination)이나 요소 반복(element repetition)을 일으킨다. 결론은 하이브리드다. 희소한 시각화는 이미지 생성, 조밀한 플롯은 코드를 쓰는 것이 최선의 균형일 수 있다는 것이다.
11. 부록 심층 분석: 케이스 스터디와 실패 사례
부록은 이 논문에서 특히 알찬 부분이다. 정성적 사례들이 정량 지표만으로는 안 보이는 그림을 채워준다.
11.1 다이어그램 생성 케이스 스터디 (Figure 7)
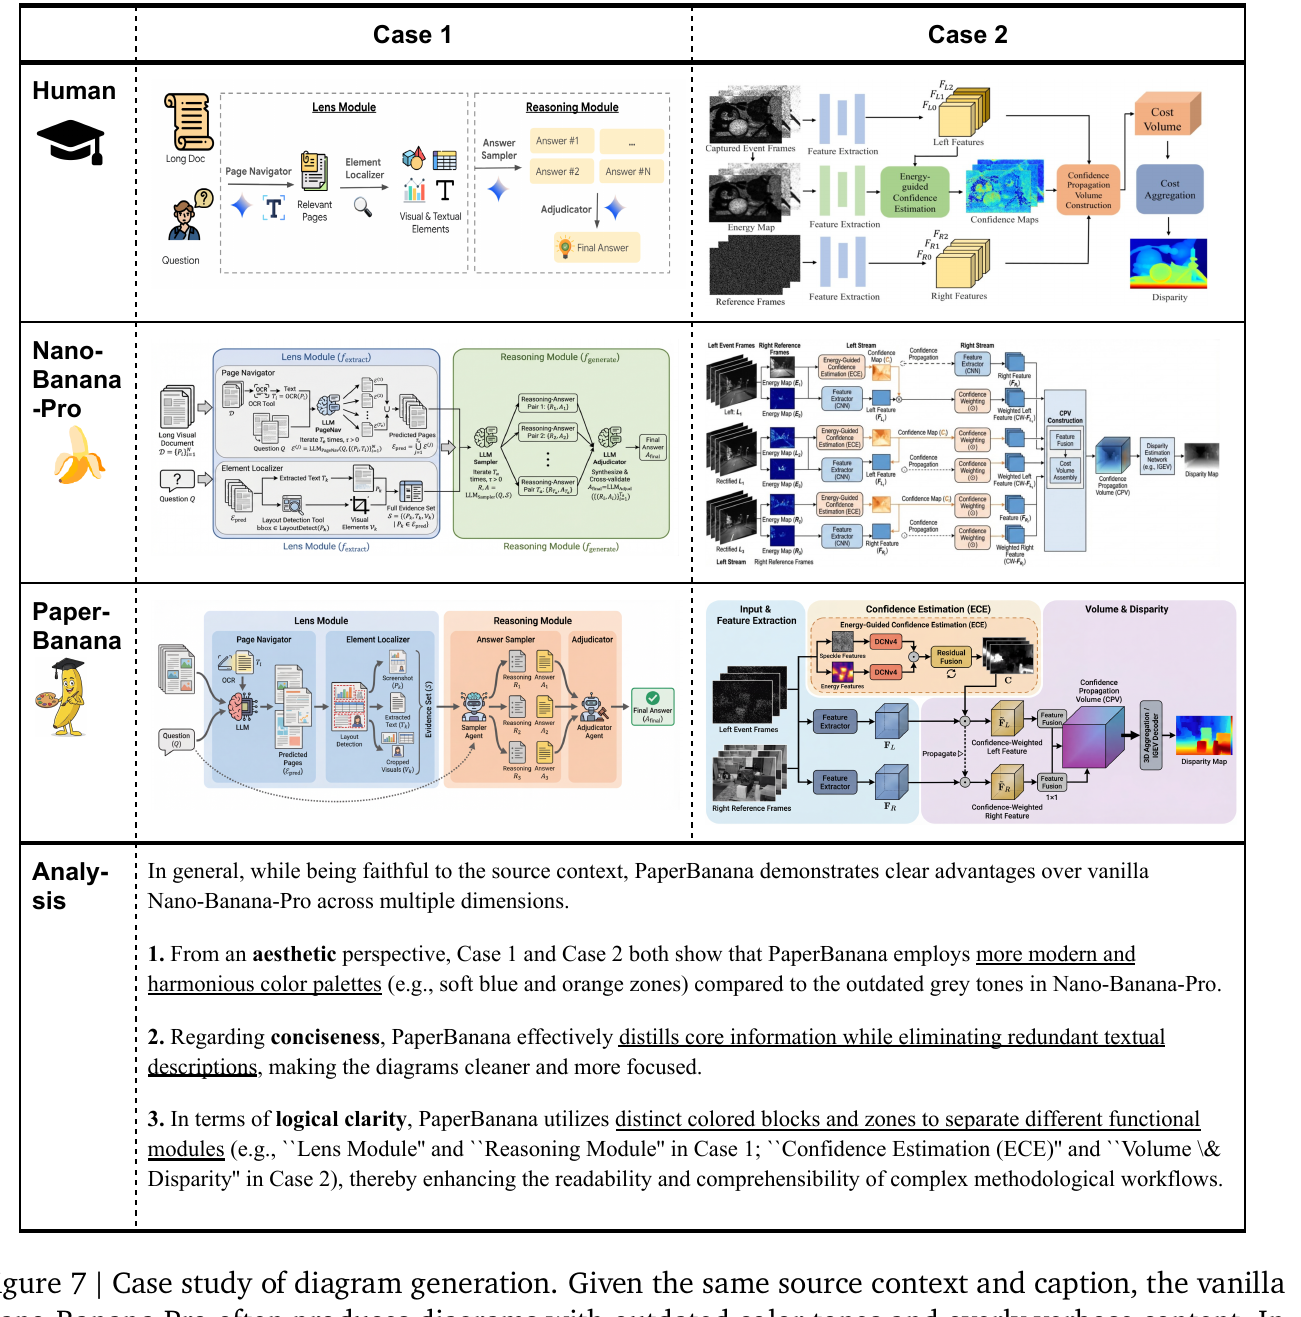
Figure 7 (원논문): 다이어그램 생성 케이스 스터디. 같은 소스 컨텍스트와 캡션에 대해 Vanilla Nano-Banana-Pro는 낡은 색조와 장황한 콘텐츠를 내는 반면, PaperBanana는 더 간결하고 미적으로 보기 좋으면서도 사실성을 유지한다.
Figure 7은 같은 입력에 대해 Human, Nano-Banana-Pro(Vanilla), PaperBanana의 결과를 두 케이스(Case 1: 문서 QA용 Lens/Reasoning 모듈, Case 2: 이벤트 카메라 disparity 추정)로 나란히 놓는다. 맨 아래 Analysis가 세 가지 이점을 짚는다. (1) 미학 측면에서 PaperBanana는 소프트 블루·오렌지 존 같은 현대적이고 조화로운 팔레트를 쓰는 반면 Vanilla는 낡은 회색 톤에 머문다. (2) 간결성 측면에서 중복 텍스트 설명을 제거해 깔끔하다. (3) 논리적 명료성 측면에서 서로 다른 색 블록과 존으로 기능 모듈을 분리한다. Vanilla의 결과를 보면 텍스트가 빽빽하고 색이 칙칙한데, PaperBanana는 같은 정보를 훨씬 읽기 쉽게 구조화한다. Table 1의 Conciseness 격차(+37.2%)가 무슨 의미인지 이 그림이 눈으로 설명해준다.
11.2 사람 그림 미학 개선 추가 사례 (Figure 8)
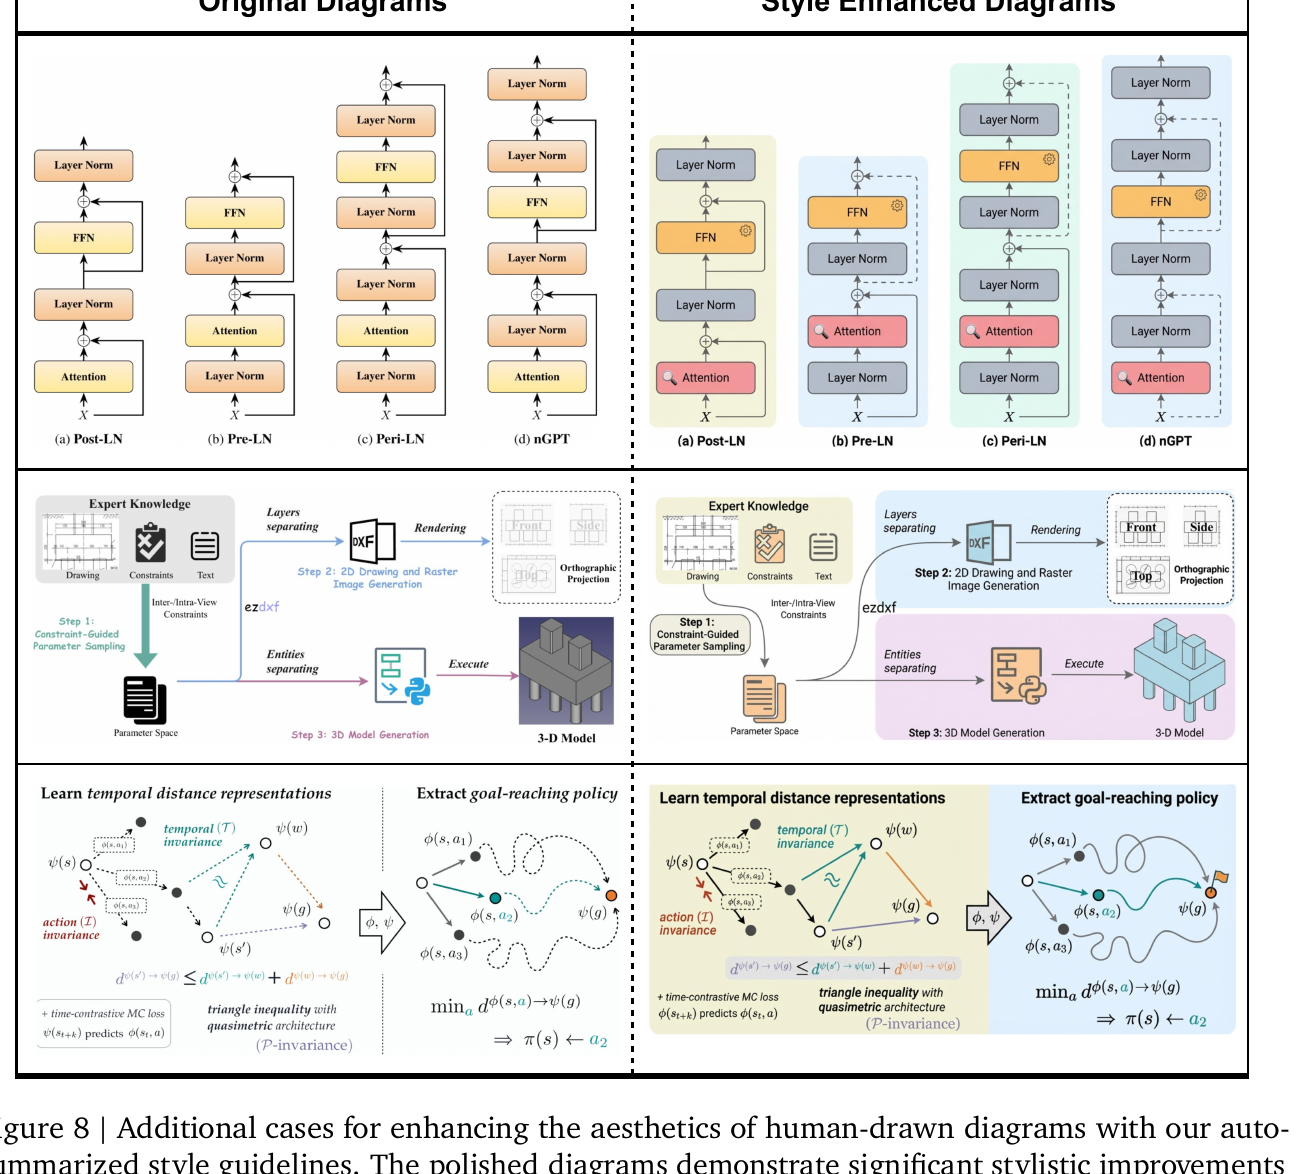
Figure 8 (원논문): 자동 요약 스타일 가이드라인으로 사람이 그린 다이어그램의 미학을 개선한 추가 사례. 색 구성, 타이포그래피, 그래픽 요소에서 뚜렷한 스타일 개선을 보인다.
Figure 8은 Section 10.1의 미학 개선을 세 가지 원본-개선 쌍으로 더 보여준다. 위: Transformer의 Layer Norm 배치 변형(Post-LN, Pre-LN, Peri-LN, nGPT) 다이어그램, 가운데: 3D 모델 생성 파이프라인, 아래: 목표 도달 정책 학습의 시간적 거리 표현. 개선판은 하나같이 배경 존에 옅은 색을 깔고, 박스에 색을 입히고, 아이콘을 더해 시각적 위계를 만든다. 왼쪽 원본이 흑백 선화에 가깝다면 오른쪽은 발표 슬라이드 수준으로 올라간다. 다만 정보 구조 자체는 그대로 유지된다는 점이 중요하다. 미학 개선이 콘텐츠를 건드리지 않고 스타일 레이어만 바꾼다는 설계 의도가 드러난다.
11.3 통계 플롯 코드 vs 이미지 생성 케이스 (Figure 9)
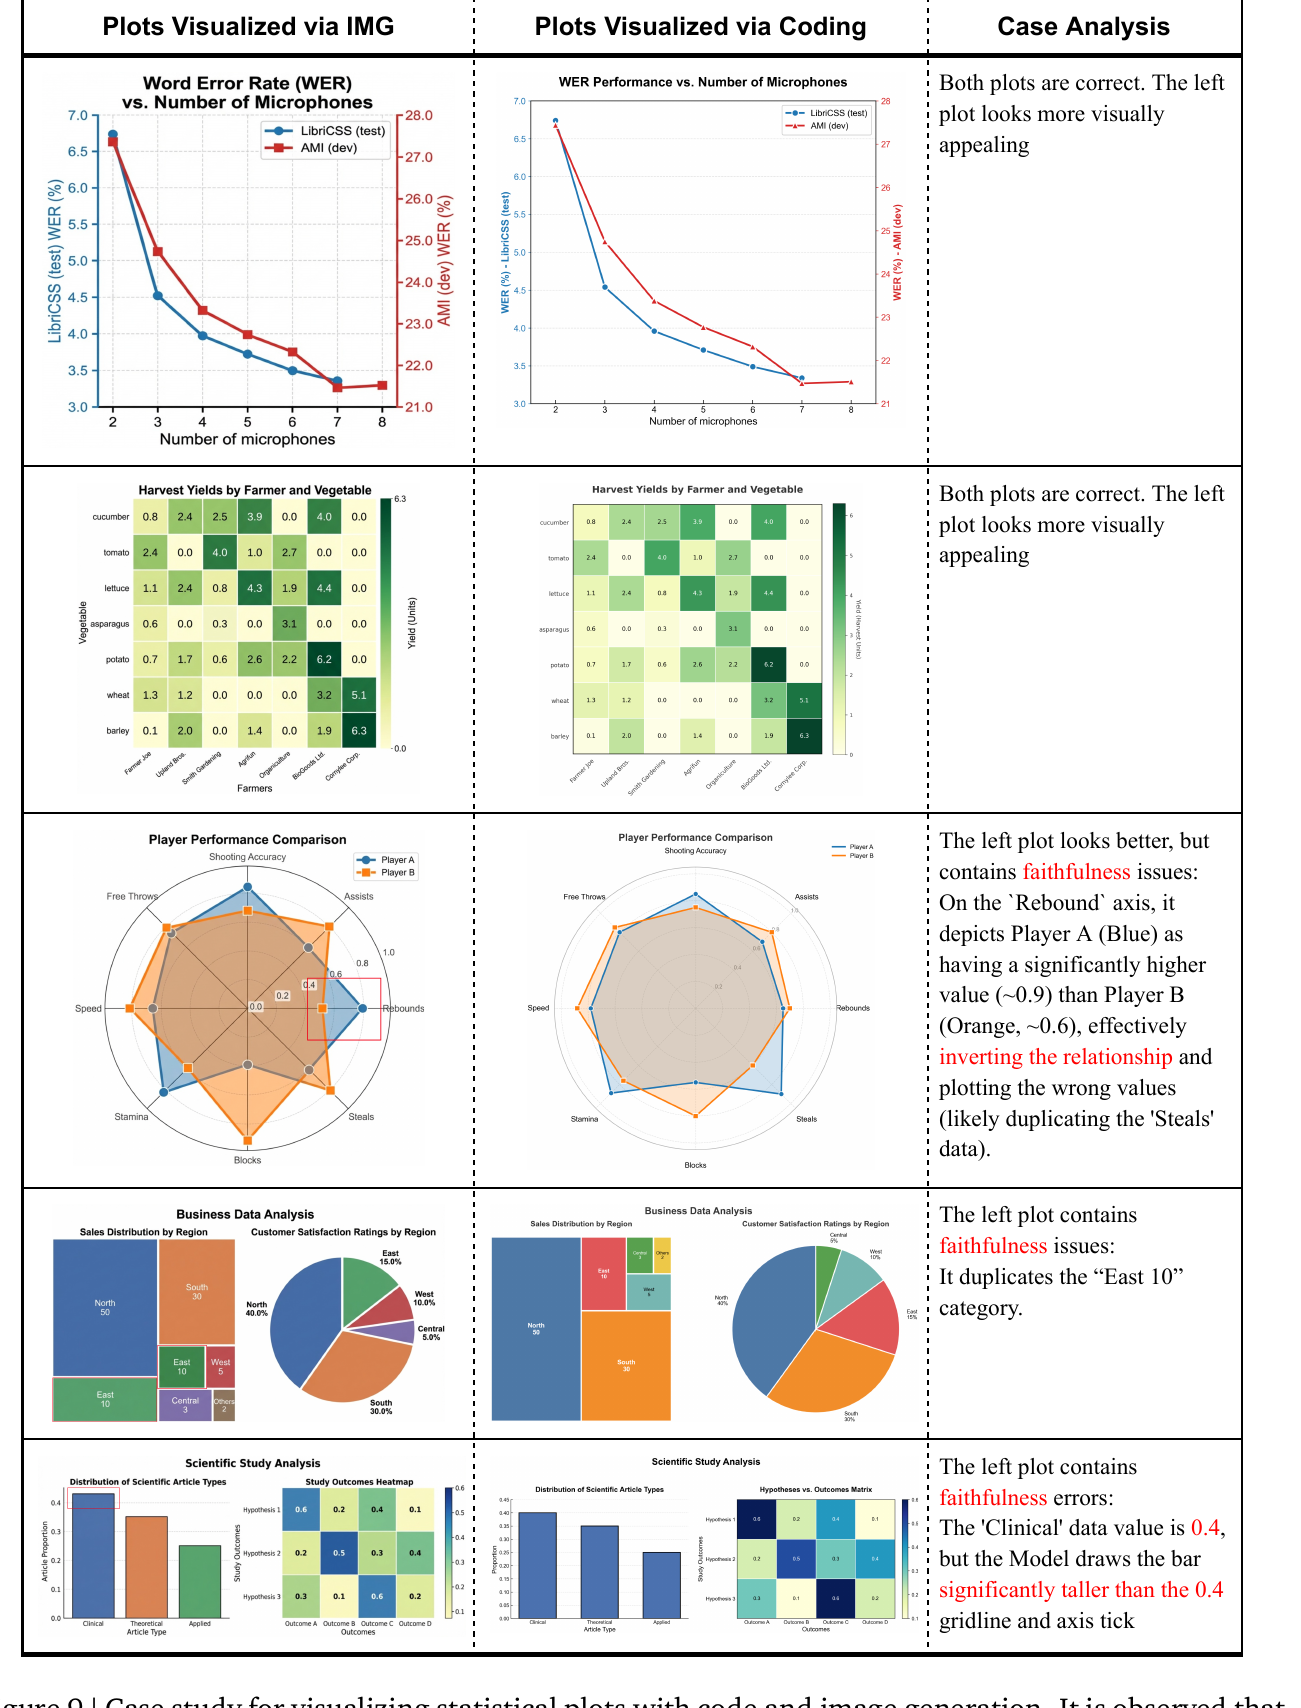
Figure 9 (원논문): 코드와 이미지 생성으로 통계 플롯을 시각화한 케이스 스터디. 이미지 생성 모델이 더 보기 좋은 플롯을 만들지만 수치 환각이나 요소 반복 같은 사실성 오류를 더 많이 낸다. 빨간 박스는 저자가 오류를 표시한 것이다.
Figure 9는 Section 10.2의 트레이드오프를 구체적 실패로 못박는다. 왼쪽(IMG)과 오른쪽(Coding)을 다섯 사례로 비교한다. 위 두 사례(WER 선 그래프, 수확량 히트맵)는 둘 다 정확하고 IMG가 더 예쁘다. 그런데 아래 세 사례에서 IMG의 사실성 오류가 드러난다. 레이더 차트에서는 Rebound 축의 Player A 값을 실제보다 높게 그려 관계를 역전시키고(Steals 데이터를 복제한 것으로 추정), 파이 차트에서는 "East 10" 범주를 중복 생성하며, 막대 그래프에서는 Clinical 값 0.4를 격자선보다 훨씬 높게 그린다. 빨간 박스가 이 오류들을 정확히 짚는다. 조밀한 데이터일수록 이미지 생성 모델이 숫자를 지어낸다는 것, 그래서 통계 플롯에는 코드가 안전하다는 결론이 사례로 뒷받침된다.
11.4 PaperBanana의 실패 사례 (Figure 10)
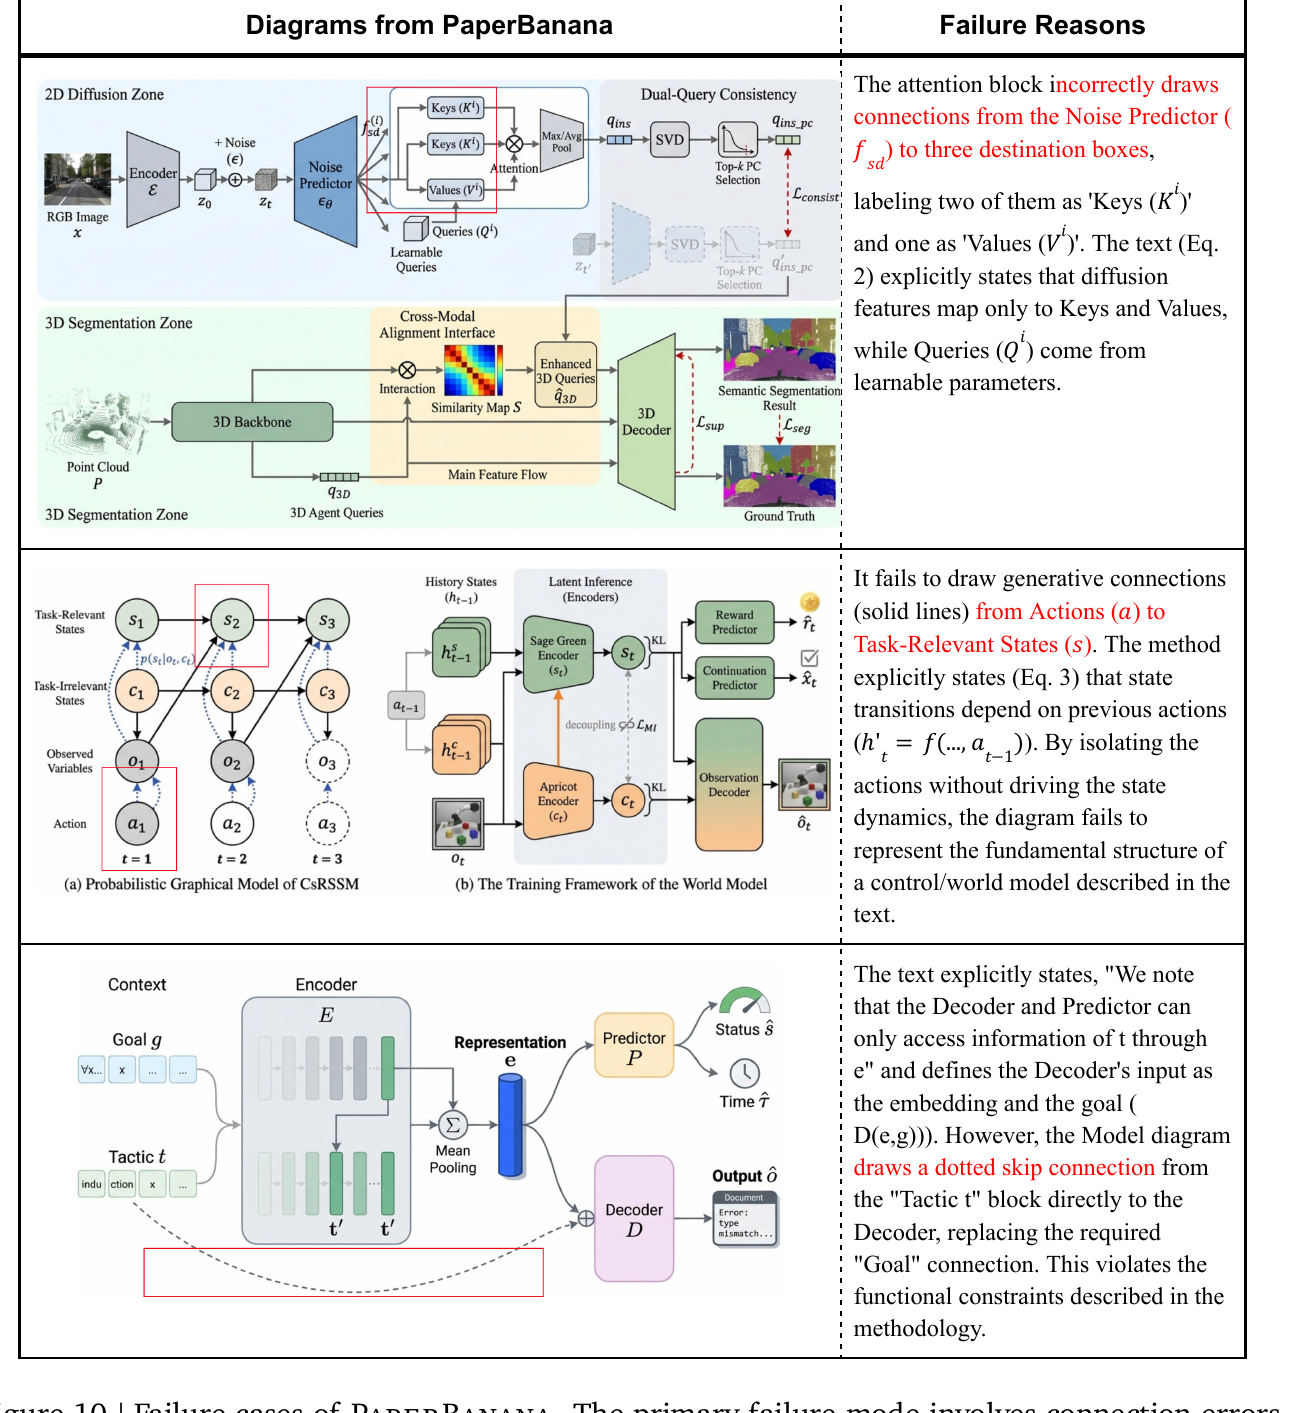
Figure 10 (원논문): PaperBanana의 실패 사례. 주된 실패 모드는 중복 연결이나 소스-타깃 노드 불일치 같은 연결(connection) 오류다. Critic 모델이 이런 연결 문제를 잡아내지 못하는 경우가 많은데, 이는 파운데이션 모델의 지각 한계에서 비롯된 것으로 보인다.
솔직히 이 그림이 논문에서 가장 정직하고 유용한 부분이다. Figure 10은 세 가지 실패를 오류 원인과 함께 보여준다. (1) 확산 모델 다이어그램에서 Noise Predictor가 세 박스(Keys 두 개, Values 하나)로 연결을 잘못 그렸다. 본문(Eq. 2)은 확산 특징이 Keys와 Values로만 매핑되고 Queries는 학습 파라미터에서 온다고 명시하는데 이를 어겼다. (2) 세계 모델 다이어그램에서 Action에서 Task-Relevant State로 가는 생성적 연결(실선)을 그리지 못했다. 상태 전이가 이전 행동에 의존한다는 구조를 놓친 것이다. (3) 인코더-디코더 다이어그램에서 Tactic 블록에서 Decoder로 가는 점선 스킵 연결을 잘못 그려 필수 Goal 연결을 대체했다.
세 실패의 공통분모는 연결 오류다. 노드는 맞게 그리는데 화살표의 출발-도착이 틀린다. 그리고 결정적으로 Critic이 이런 세밀한 연결 문제를 잡아내지 못한다. 저자들은 이 한계가 자기 수정 기제의 결함이 아니라 파운데이션 VLM의 미세 시각 지각(fine-grained visual perception) 한계에서 온다고 진단한다. 즉 Critic이 게을러서가 아니라, VLM이 애초에 화살표가 어디서 어디로 가는지를 정확히 못 본다는 것이다. Table 1에서 Faithfulness만 유독 사람에게 못 미친 이유가 여기 있다. 이 진단은 문제 해결이 프롬프트 엔지니어링이 아니라 기반 모델의 시각 능력 향상에 달렸음을 시사한다.
11.5 사람 평가 인터페이스 (Figure 11, 12)
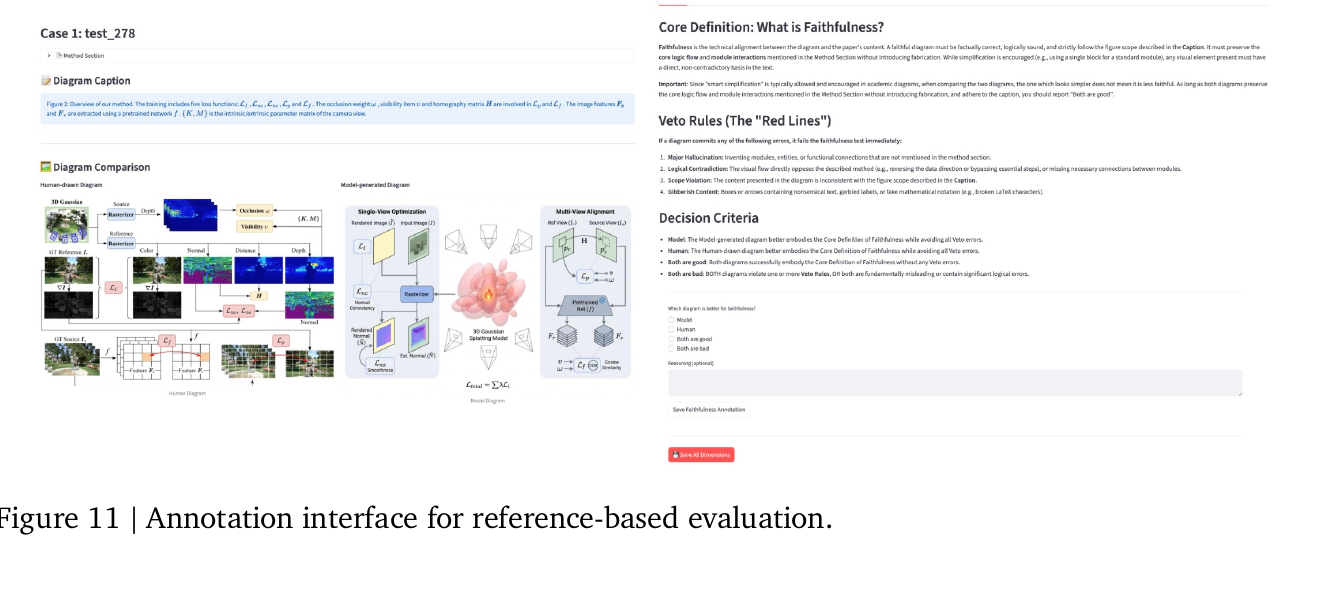
Figure 11 (원논문): 참조 기반 평가를 위한 주석 인터페이스. Streamlit으로 제작했으며, Faithfulness의 핵심 정의, Veto 규칙(레드 라인), 판정 기준을 주석자에게 제시한다.
Figure 11은 VLM-as-a-Judge 검증(Section 7.2)에 쓴 인터페이스다. 주석자는 방법 섹션, 캡션, 사람이 그린 참조 그림, 모델 생성 후보를 보고 네 차원을 채점한다. 화면 오른쪽에는 Faithfulness의 정의, 그리고 즉시 탈락시키는 Veto 규칙(주요 환각, 논리적 모순, 범위 위반, 알아볼 수 없는 콘텐츠)이 명시돼 있다. VLM 심판에게 준 것과 같은 루브릭을 사람에게도 그대로 적용해 자동 지표와 사람 평가의 정렬을 공정하게 측정하려는 설계다.
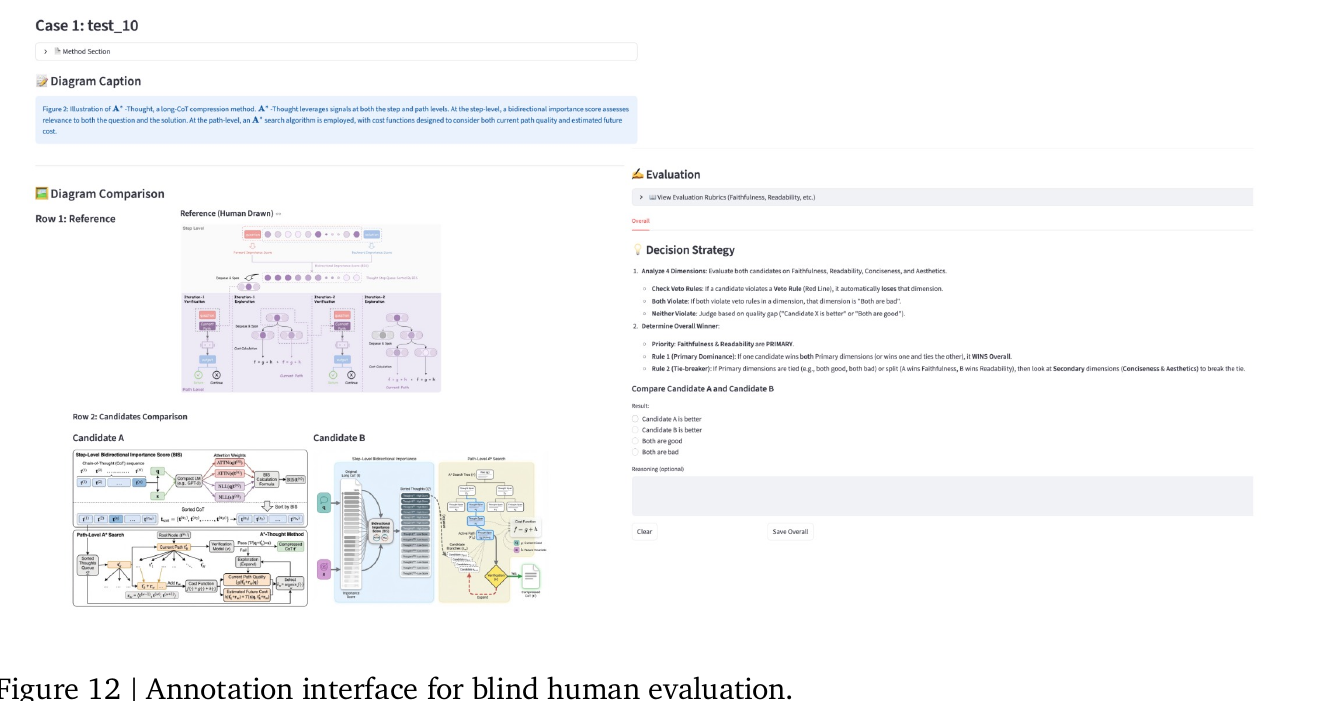
Figure 12 (원논문): 블라인드 사람 평가를 위한 주석 인터페이스. Reference(사람 그림)와 두 익명 후보(Candidate A/B)를 무작위 순서로 제시하고, 1차/2차 차원의 계층적 결정 전략을 따르게 한다.
Figure 12는 메인 결과의 블라인드 A/B 테스트(승/무/패 72.7%/20.7%/6.6%)에 쓴 인터페이스다. 세 명의 숙련된 연구자가 방법 섹션, 캡션, 사람 그림, 그리고 무작위 순서의 두 익명 후보(A/B)를 본다. 승자 결정은 VLM 프로토콜과 같은 계층 규칙을 따른다. 먼저 1차 차원(Faithfulness, Readability)을 보고, 비기면 2차 차원(Conciseness, Aesthetics)으로 넘어간다. 사람 평가조차 자동 평가와 동일한 우선순위 규칙을 강제해 콘텐츠 정확성과 명료성을 우선시하도록 한 것이다.
11.6 구현 디테일과 통계 플롯 큐레이션
부록 C의 구현 디테일 몇 가지가 실무적으로 유용하다. 모든 실험에서 생성 온도(temperature)를 1로 두고, 공정 비교를 위해 생성 이미지의 가로세로비를 사람 그림에 맞춘다(Nano-Banana-Pro의 경우 3:2, 16:9, 21:9 중 가장 가까운 값으로 반올림). 그리고 논문 안에서 바나나 아이콘이 붙은 그림들은 전부 PaperBanana로 생성했는데, 실전에서는 생성 모델의 변동성 때문에 여러 후보를 만들어 사람이 가장 좋은 것을 골랐다고 밝힌다. 이 "생성 후 선택(generate-and-select)" 워크플로를 실용적 활용법으로 권한다. 완전 자동이라기보다 사람이 최종 선별에 개입하는 반자동에 가깝다는 정직한 고백이다.
부록 D의 통계 플롯 테스트셋 큐레이션도 정리하면, ChartMimic의 "direct mimic" 부분집합 2,400개 플롯에서 시작해 재현 가능한 데이터와 표준 매핑 기준으로 필터링하고 가로세로비 로 제한해 914개를 남긴다. ChartMimic의 원래 22개 범주를 학술에서 흔한 7개(막대, 선, 트리&파이, 산점도, 히트맵, 레이더, 기타)로 통합하고, 범주당 80개(히트맵·레이더는 가용성 한계로 40개씩)를 표집해 총 480개를 만든 뒤 참조/테스트로 균등 분할한다. 어려운 케이스 비율을 의도적으로 높여 도전적인 테스트셋을 만들었다.
12. 저자가 밝힌 한계와 향후 방향
이 논문은 한계를 꽤 길고 구체적으로 논한다. 개척 연구답게 미해결 과제를 숨기지 않는다.
편집 가능한 그림을 향해. 가장 두드러진 한계는 출력이 래스터(raster) 이미지라는 것이다. 학술 맥락에서 선호되는 벡터 그래픽과 달리 래스터는 편집이 근본적으로 어렵다. 4K 해상도 생성이 임시방편이지만 생성 후 수정 문제를 해결하지는 못한다. 저자들은 세 가지 방향을 제시한다. 사소한 조정은 이미지 편집 모델(Nano-Banana-Pro), 구조적 수정은 OCR+SAM3 기반 재구성 파이프라인(Paper2Any, Edit Banana, AutoFigure-Edit처럼), 더 나아가 Illustrator 같은 벡터 도구를 자율 조작하는 GUI 에이전트다.
스타일 표준화와 다양성의 트레이드오프. 통합 스타일 가이드가 학술 표준 준수를 보장하지만 출력의 스타일 다양성을 줄인다. 모든 그림이 비슷한 톤으로 수렴하는 부작용이다.
세밀한 사실성의 도전. Figure 10에서 본 연결 오류가 여기서 다시 강조된다. 미세한 시작/끝점 어긋남, 잘못된 화살표 방향 같은 오류를 현재 Critic이 못 잡는다. 이 격차를 메우는 열쇠는 파운데이션 VLM의 미세 시각 지각 능력 향상이라는 것이 저자들의 일관된 진단이다.
평가 패러다임의 진화. 참조 기반 VLM-as-a-Judge에도 한계가 있다. 구조적 정확성을 정량화하기 어렵고, 미학 같은 주관적 차원은 텍스트 프롬프팅만으로 사람 선호에 맞추기 부족하다. 구조 기반·루브릭 기반 지표, 그리고 커스텀 보상 모델 학습을 미래 방향으로 든다.
다양한 선호를 위한 테스트 타임 스케일링. 현재는 쿼리당 단일 출력을 낸다. 생성 모델의 확률성과 미적 취향의 주관성을 고려하면, 다양한 스타일의 후보를 여럿 생성해 사람이나 선호 모델이 고르는 생성-선택 워크플로가 자연스러운 확장이다.
더 넓은 도메인으로. 저자들은 이 프레임워크가 일반화 가능한 패러다임이라고 본다. 검색으로 "무엇을 그릴지"를, 자동 스타일 요약으로 "어떻게 그릴지"를 가르치고, 구조 기획과 미학 렌더링을 분리함으로써 비싼 도메인 파인튜닝을 우회한다. UI/UX 디자인, 특허 도면, 산업 도식처럼 커뮤니티 표준 준수가 중요한 다른 영역에도 적용 가능하다는 것이다.
13. 비판적 관점
강점은 분명하다. 문제 정의가 실질적이고(연구자 누구나 그림 그리기에 시달린다), 참조 주도로 구조와 스타일을 분리한 설계가 우아하며, PaperBananaBench라는 재사용 가능한 자산을 남겼다. 무엇보다 자기 방법으로 자기 논문 그림을 그려 보인 셀프 데모가 설득력을 준다.
그럼에도 몇 가지는 아쉽다. 첫째, 평가의 순환성이다. 심판이 Gemini-3-Pro이고 생성의 두뇌도 Gemini-3-Pro다. Kendall's tau로 사람 정렬을 보였지만 검증 표본이 50개에 그쳐, 같은 계열 모델이 자기 취향의 그림을 후하게 볼 가능성을 완전히 배제하기 어렵다. 둘째, Faithfulness가 사람에 못 미친다는 사실은 학술 그림의 존재 이유(정확한 정보 전달)를 생각하면 치명적일 수 있다. Conciseness 80.7이 아무리 높아도 화살표 방향이 틀린 그림은 오히려 독자를 오도한다. 저자들도 인정하듯 이 문제는 프레임워크가 아니라 기반 모델에 달려 있어, 이 논문 자체로는 해결책을 제시하지 못한다. 셋째, "생성 후 사람이 선택"이라는 실전 워크플로는 완전 자동화라는 제목의 야심과 거리가 있다. 넷째, 래스터 출력의 비편집성은 실제 논문 작성에서 큰 걸림돌이다. 리비전 때 그림의 오타 하나 고치려고 전체를 재생성해야 한다면 실용성이 떨어진다.
포지셔닝을 보면, 같은 시기의 AutoFigure/AutoFigure-Edit가 심볼릭 표현을 거쳐 편집 가능성을 확보하려는 반면 PaperBanana는 직접 이미지 생성으로 표현력을 택했다. 표현력 대 편집성의 이 선택이 두 계열의 근본 차이다. 통계 플롯까지 통합했다는 확장성은 PaperBanana의 분명한 차별점이고, 코드 vs 이미지 생성 트레이드오프 분석(Figure 5, 9)은 후속 연구에 유용한 실증 데이터를 남겼다.
14. 마무리
PaperBanana는 "AI 과학자가 자기 발견을 스스로 그려 소통한다"는 그림의 마지막 조각을 겨냥한 첫 진지한 시도다. 참조 예시로 구조와 스타일을 가르치고, 5개 에이전트로 기획과 렌더링을 분업하며, 자기비평 루프로 사실성을 회복하는 설계는 각 부품이 왜 필요한지가 Ablation에서 깔끔하게 검증된다. Conciseness와 미학에서는 이미 사람을 앞서고, 통계 플롯에서는 코드 기반으로 사람 수준에 근접했다.
동시에 이 논문은 남은 벽이 어디인지도 정직하게 보여준다. Faithfulness, 특히 노드 사이 연결의 정확성은 프롬프트나 에이전트 구조로는 넘기 어렵고 파운데이션 VLM의 시각 지각 능력에 병목이 걸려 있다. 래스터 출력의 비편집성 역시 실무 도입의 실질적 장애물이다. 정리하면, PaperBanana는 학술 그림 자동화가 "가능하다"는 것을 설득력 있게 보였지만 "믿고 맡길 수 있다"까지는 아직 한 걸음 남았다. 그 한 걸음이 프레임워크가 아니라 기반 모델의 몫이라는 진단이, 어쩌면 이 논문이 남긴 가장 값진 통찰일지 모른다.