논문 리뷰
논문 리뷰: Let LRMs Break Free from Overthinking via Self-Braking Tuning
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Let LRMs Break Free from Overthinking via Self-Braking Tuning |
| 저자 | Haoran Zhao, Yuchen Yan, Yongliang Shen(교신저자) 외 (Zhejiang University, Tianjin University, Microsoft Research Asia) |
| 학회/저널 | arXiv preprint, 2025년 5월 |
| 논문 링크 | arXiv:2505.14604 |
| 코드 | github.com/ZJU-REAL/Self-Braking-Tuning |
| 프로젝트 | zju-real.github.io/SBT |
1. 들어가며
"2 더하기 3은?" 이 문제에 사람은 1초도 안 걸린다. 그런데 DeepSeek-R1이나 OpenAI o1 같은 대형 추론 모델(Large Reasoning Model, LRM)에게 물어보면 어떻게 될까? 이 논문의 Figure 1에 나오는 실제 사례를 보면, DeepSeek-R1-Distill-Qwen-7B는 이 간단한 질문에 무려 672개의 토큰을 쓰고 9번이나 답을 다시 확인한다. 답이 5라는 걸 이미 알고 나서도 "숫자선으로 다시 해볼까", "사과 2개에 3개를 더하면" 하는 식으로 검산을 반복하는 것이다.
o1과 R1이 열어젖힌 추론 모델의 시대는 긴 사고 사슬(chain of thought)을 생성해서 복잡한 수학, 논리 문제의 정확도를 크게 끌어올렸다. 문제는 이 성능 향상이 공짜가 아니라는 데 있다. 문제 하나에 수천 개의 토큰을 소모하는 일이 흔하고, 그중 상당수는 이미 정답에 도달한 뒤에 나오는 불필요한 재확인이다. 이 현상을 오버씽킹(overthinking, 과도한 사고)이라 부른다. 계산 비용과 지연 시간이 늘어나는 것은 물론이고, 장황한 재검토가 오히려 핵심 풀이를 흐려버리기도 한다. 실제 서비스에 배포하려는 입장에서는 골칫거리인 셈이다.
오버씽킹을 줄이려는 연구는 이미 많다. 그런데 이 논문이 던지는 질문은 조금 다르다. 기존 방법들이 대부분 토큰 예산을 강제로 걸거나, 추론 중간에 외부에서 생성을 끊는 식의 "외부 개입"에 의존한다면, 저자들은 이렇게 묻는다. 모델 스스로가 자기 추론이 과하다는 걸 알아차리고 적절한 시점에 멈추게 할 수는 없을까? 사람이 충분히 확신에 도달하면 자연스럽게 생각을 마무리하듯이, 모델도 내재적인 "브레이크"를 갖추게 하자는 것이다.
Self-Braking Tuning(SBT)이라는 이름은 여기서 나왔다. 외부에서 밟는 브레이크가 아니라 모델 자신이 밟는 브레이크. 이 프레임워크의 결과가 꽤 인상적인데, 정확도를 거의 그대로 유지하면서 토큰 소비를 최대 60%까지 줄였다. 이 리뷰에서는 SBT가 어떻게 오버씽킹을 정량적으로 정의하고, 어떤 데이터로 모델에게 "멈추는 법"을 가르치는지 하나씩 뜯어본다.
2. 기존 연구의 한계
효율적 추론(efficient reasoning)을 다루는 기존 연구는 크게 세 갈래로 나뉜다. 저자들은 이 세 갈래가 모두 본질적으로 외부 개입 패러다임에 속한다고 정리한다.
2.1 모델 최적화 (Model Optimization)
강화학습(RL)이나 지도 미세조정(SFT)을 후처리로 적용해서 모델에게 추론 길이를 조절하는 능력을 심어주는 방향이다. RL 계열은 길이에 민감한 보상(length-sensitive reward)을 설계해서 출력을 제한한다(L1, O1-Pruner 등). SFT 계열은 가변 길이의 CoT 데이터와 보조 제약을 써서 추론 경로를 짧게 만든다(CoT-Valve, C3oT, TokenSkip 등). 접근은 다양하지만 복잡한 최적화 전략에 의존한다는 공통점이 있다.
2.2 추론 출력 최적화 (Reasoning Output Optimization)
추론 시점(inference time)에 생성 전략 자체를 바꿔서 길이를 줄이는 방향이다. LightThinker는 중간 스텝을 압축하고, DEER는 높은 확신에 도달하면 곧바로 생성을 멈추며, NoThinking은 프롬프팅으로 추론 자체를 건너뛴다. 효과는 있지만 생성 과정에 개입하는 외부 메커니즘이 필요하다.
2.3 외부 제약 추가 (Adding External Restrictions)
토큰 예산(token budget)이나 프롬프트 제어 같은 외부 제약을 걸어 추론 행동을 규제하는 방향이다. Token-Budget-Aware, Chain of Draft(CoD)가 대표적이다. 가장 직접적이지만 그만큼 모델 외부에서 강제로 통제하는 방식이다.
세 갈래를 관통하는 한계는 분명하다. 전부 "바깥에서" 모델을 통제한다는 것이다. 복잡한 최적화를 돌리거나 추가 제약 장치를 붙일 뿐, 정작 모델이 스스로 오버씽킹을 억제할 수 있는 내재적 능력은 거의 탐구되지 않았다. SBT는 바로 이 빈틈을 파고든다.
3. 핵심 아이디어
SBT의 통찰은 한 문장으로 요약된다. LRM에게 "언제 더 생각하는 게 무의미해지는지"를 인식하는 내부 브레이킹 메커니즘을 학습시킬 수 있다는 것이다. 외부 제약을 씌우는 대신, 모델이 자기 추론 과정을 어떻게 인식하고 조절하는지를 근본적으로 다시 빚어낸다.
접근은 세 단계로 짜여 있다. 먼저 추론 궤적에서 오버씽킹 패턴을 체계적으로 식별하는 방법론을 세운다. 추론 효율 비율과 오버씽킹 마커 비율이라는 두 지표를 결합해서, 모델이 효과적인 추론에서 불필요한 계산으로 넘어가는 전환점을 정확히 짚어낸다. 이 분석을 바탕으로 두 가지 데이터 구성 전략을 만든다. 하나는 미리 정한 브레이킹 지점에서 불필요한 부분을 딱 잘라내는 SBT-Exact(SBT-E), 다른 하나는 스텝 단위로 모니터링하다가 오버씽킹 패턴이 나타나면 동적으로 멈추는 SBT-Dynamic(SBT-D)이다.
여기서 그치지 않고, 브레이킹 지점에 "브레이킹 프롬프트(braking prompt)"를 심는다. "잠깐, 같은 답을 여러 번 얻었으니 이제 생각을 끝낼 때다" 같은 자기 반성적 문장이다. 이런 자연어 신호가 모델에게 "충분히 생각했다"는 상태를 명시적으로 인식시켜서, 외부 신호 없이도 스스로 추론을 마무리하도록 유도한다. 기존 방법이 데이터를 "수집"하거나 생성을 "차단"했다면, SBT는 멈추는 법을 데이터에 새겨 넣어 모델에게 "가르친다"는 점이 근본적 차이다.
4. 제안 방법 (Method)
전체 파이프라인은 Figure 2에 잘 정리되어 있다. 데이터 구성(Stage 1), 학습(Stage 2), 추론(Stage 3)의 3단계 구조다.
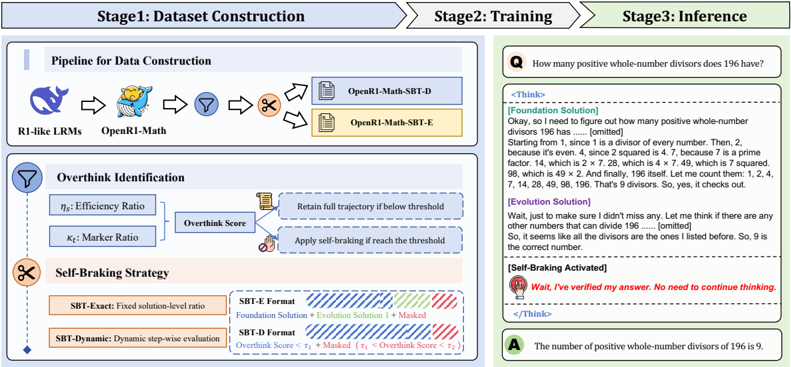
Figure 2: Self-Braking Tuning의 전체 개요. 왼쪽은 오버씽킹 식별과 자기 브레이킹 절단 전략을 포함한 데이터 구성 과정, 오른쪽은 학습된 모델이 추론을 자동으로 종료하는 예시다. (원논문)
Figure 2의 왼쪽 상단을 보면 데이터 구성 파이프라인이 그려져 있다. R1 계열 LRM이 생성한 OpenR1-Math 데이터를 받아서, 오버씽킹 식별 필터(깔때기 아이콘)를 거치고, 자기 브레이킹 절단(가위 아이콘)을 적용해 OpenR1-Math-SBT-D와 OpenR1-Math-SBT-E라는 두 데이터셋을 만든다. 중간의 Overthink Identification 블록에서는 효율 비율 와 마커 비율 를 합쳐 오버씽크 점수(overthink score)를 계산하고, 이 점수가 임계값 아래면 궤적을 그대로 두고 임계값에 도달하면 자기 브레이킹을 적용한다. 오른쪽 Stage 3의 추론 예시가 이 방법의 목표를 압축해서 보여준다. "196의 양의 약수는 몇 개인가?"라는 질문에 Foundation Solution으로 답(9개)을 구한 뒤, Evolution Solution으로 한 번 검산하고, "잠깐, 답을 검증했다. 더 생각할 필요 없다"는 자기 브레이킹을 발동시키고 종료한다.
4.1 R1 계열 모델의 추론 궤적 분석
방법론을 이해하려면 먼저 LRM이 실제로 어떻게 추론하는지를 봐야 한다. DeepSeek-R1 같은 모델의 궤적을 뜯어보면 하나의 문제에 대해 여러 개의 독립적인 풀이 시도(solution attempt)가 생성되는 공통 패턴이 보인다. 저자들은 이를 두 유형으로 나눈다.
Foundation Solution(기초 풀이): 추론 과정 맨 앞에 나오는 첫 번째 풀이다. 문제를 파악한 뒤 단계별로 풀어나가며, 이후 모든 진화 풀이의 토대가 된다.
Evolution Solution(진화 풀이): 추론 후반부에 나타나며 보통 "Wait", "Alternatively", "However" 같은 신호어로 시작한다. 기초 풀이를 반성하고 다듬고 보충하거나 요약하며, 때로는 새로운 접근을 제안한다. 자기 교정 능력을 부여하는 부분이기도 하지만, 동시에 오버씽킹이 가장 빈번하게 발생하는 곳이기도 하다.
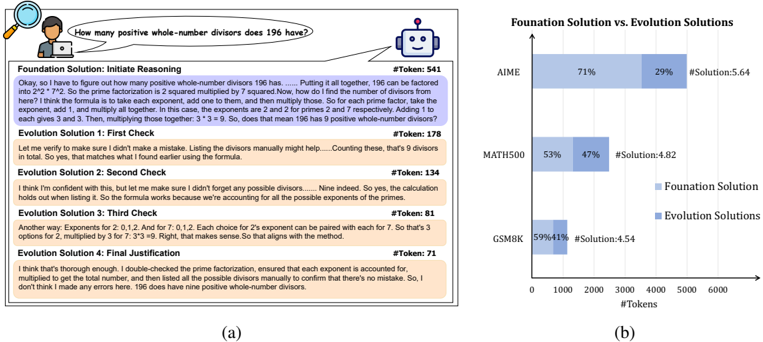
Figure 3: (a) DeepSeek-R1-Distill-Qwen-7B의 대표 예시. (b) GSM8K, MATH500, AIME 벤치마크에서 Foundation Solution과 Evolution Solution의 토큰 비중 분석. (원논문)
Figure 3의 (a)는 이 구조를 실제 궤적으로 보여준다. "196의 양의 약수는 몇 개인가?"라는 문제에서 Foundation Solution(초기 추론)이 541 토큰을 쓰고 정답을 구한다. 그 뒤로 Evolution Solution 1(첫 확인, 178 토큰), Evolution Solution 2(둘째 확인, 134 토큰), Evolution Solution 3(셋째 확인, 81 토큰), Evolution Solution 4(최종 정당화, 71 토큰)가 이어진다. 답은 이미 첫 풀이에서 나왔는데, 네 번의 진화 풀이가 사실상 같은 답을 반복 검증하며 464 토큰을 추가로 소비한 것이다. 오버씽킹의 전형이다.
(b)의 막대그래프가 더 흥미롭다. 난이도가 다른 세 벤치마크에서 Foundation Solution과 Evolution Solution의 토큰 비중을 보여주는데, AIME(매우 어려움)에서는 Foundation이 71%, 평균 풀이 수 5.64개이고, MATH500(중간)은 53% 대 47%로 풀이 수 4.82개, GSM8K(쉬움)는 59% 대 41%로 풀이 수 4.54개다. 여기서 읽어야 할 핵심은 문제 난이도와 무관하게 Foundation Solution이 결정적 역할을 한다는 점이다. 특히 어려운 AIME조차 정답의 대부분은 첫 풀이에서 이미 결정되고, 나머지 진화 풀이들은 상당 부분 잉여라는 것이다. 이 관찰이 "Foundation + 진화 풀이 하나만 남기면 충분하다"는 SBT-E의 절단 전략을 정당화한다.
4.2 오버씽킹 정량화 (Overthinking Identification)
문제는 "어디까지가 필요한 추론이고 어디부터가 오버씽킹인가"를 자동으로 판별하는 것이다. 저자들은 서로 다른 형태의 잉여를 포착하는 두 지표를 도입한다.
추론 효율 비율(Reasoning Efficiency Ratio) : 모델이 정답에 도달하기까지 쓴 스텝 수가 전체 사고 스텝 중 얼마나 되는지를 나타낸다.
여기서 (first correct steps)는 사고 구간(<think>와 </think> 태그 사이) 안에서 첫 정답에 도달하기까지 필요한 스텝 수, (total thinking steps)는 사고 구간 전체의 스텝 수다. 값이 1에 가까울수록 대부분의 스텝을 정답 도출 전에 썼다는 뜻이라 효율적이고, 0에 가까울수록 정답을 얻은 뒤에도 추론을 길게 이어갔다는 뜻이라 오버씽킹을 의심할 수 있다. 토큰이 아니라 스텝 단위로 계산하는 이유는 구현별 토큰 수에 영향받지 않고 추론의 구조적 효율을 재기 위해서다.
오버씽킹 마커 비율(Overthinking Marker Ratio) : 가 구조적 비효율을 잡는다면, 이 지표는 오버씽킹 특유의 언어적 패턴을 잡는다. 재고, 검증, 대안 탐색을 신호하는 단어들("Wait", "However", "Let me verify" 등)의 밀도다.
은 저자들이 큐레이션한 오버씽킹 마커 어휘 집합(전체 목록은 Appendix E), (Total Tokens)는 사고 구간의 전체 토큰 수, 는 토큰 가 에 속하면 1, 아니면 0인 지시 함수다. 가 높다는 건 재고와 검증 언어가 많다는 뜻이고, 이는 보통 잉여 추론 패턴과 상관이 높다.
오버씽크 점수(Overthink Score): 두 지표를 가중 결합해서 종합 점수를 만든다.
는 높을수록 효율적(오버씽킹이 적음)이므로 방향을 맞추기 위해 로 변환했다. 는 높을수록 오버씽킹이 강하다. 가중 파라미터 가 두 성분의 기여를 조절하는데, 저자들은 로 설정했다. 즉 구조적 효율 성분 에 90%, 언어적 마커 에 10%를 준 것이다. 근거는 두 가지다. 정답에 일찍 도달하는 것이 계산 자원과 지연을 직접 줄이므로 를 주 성분으로 삼되, 는 프롬프트 형식이나 코퍼스 특성, 모델별 출력 패턴에 민감해서 노이즈가 끼기 쉬우므로 낮은 가중치로 노이즈 증폭을 억제한다는 것이다.
4.3 적응형 추론 데이터 구성 (SBT-E와 SBT-D)
오버씽킹을 정량화했으니, 이제 이를 이용해 "적절한 길이"의 학습 데이터를 만든다. 두 전략의 차이가 SBT의 핵심 설계다.
SBT-Exact (SBT-E): 풀이(solution) 단위로 일관되게 절단하는 전략이다. 오버씽킹을 보이는 궤적마다 Foundation Solution + Evolution Solution 하나를 보존하고, 그 뒤에 작은 마스킹 구간을 붙인다. Foundation Solution이 문제에 대한 초기 구조화된 접근을 담고, 추가된 진화 풀이 하나가 자기 교정 능력을 보존한다. 마스킹 구간은 다음 진화 풀이의 시작 부분으로, 여기서부터 추론이 잉여가 된다는 브레이킹 신호 역할을 한다. 이 마스킹 구간은 손실 함수에 기여하지 않으므로(loss masking) 오버씽킹 패턴이 강화되는 걸 막는다. 형식적 절차는 Appendix의 Algorithm 1에 있다.
SBT-Dynamic (SBT-D): 균일하게 자르는 SBT-E와 달리, 문제마다 추론 길이를 맞춤 조절하는 스텝별 적응 전략이다. Foundation Solution을 완전히 보존한 상태에서 시작해, 스텝을 하나씩 추가할 때마다 오버씽크 점수를 다시 계산한다. 점수가 1차 임계값 (0.2로 설정)을 넘을 때까지 추론을 이어간다. 덕분에 복잡한 문제는 더 많은 스텝을 남기고 단순한 문제는 일찍 종료된다. 그다음 과 2차 임계값 (, 즉 0.25) 사이의 점수를 가진 스텝들을 마스킹 구간으로 정의한다. 이 구간은 손실 계산에서 제외되지만 모델에게 오버씽킹 패턴을 노출시키기 위해 유지된다. 전체 절차는 Algorithm 2에 있다.
두 전략을 OpenR1-Math의 고품질 추론 궤적에 적용해 OpenR1-Math-SBT-E와 OpenR1-Math-SBT-D 두 데이터셋을 만들었고, 각각 92,064개의 예시를 담고 있다.
4.4 자기 조절 브레이킹 전략
적응형 길이 데이터만으로는 부족하다. 저자들은 모델의 자율 종료 능력을 강화하는 두 가지 학습 메커니즘을 추가한다.
마스킹된 잉여 사고(Masked Redundant Thinking, MRT): 최적 절단 지점에서 그냥 잘라버리면 모델은 오버씽킹을 "탐지"하는 법을 배우지 못한다. 대신 잉여 추론을 조금 남겨두고 손실 마스킹을 적용한다. SBT-E에서는 두 번째 진화 풀이의 시작 부분, SBT-D에서는 과 사이 점수의 스텝들이 이 마스킹 구간이 된다. 손실을 계산하지 않으면서 오버씽킹 패턴을 보여주면, 모델은 그래디언트 강화 없이 생산적 추론과 잉여를 구분하는 법을 배운다. 저자들은 이를 "강화 없는 노출(exposure without reinforcement)" 원리라 부른다. 마스킹 구간은 부드러운 경계 신호가 되어 모델이 추론 중 스스로 멈추도록 유도한다.
자연어 가이드(Natural Language Guidance): 추론 종료 지점에 명확한 자연어 신호를 심는다. 추론을 마쳤다는 자각을 보여주는 자기 반성적 문장, 예컨대 "잠깐, 같은 답을 여러 번 얻었으니 이제 생각을 끝낼 때다" 같은 것이다. 보존된 내용과 마스킹된 내용의 경계에 놓여 멈춤 결정의 언어적 앵커 역할을 한다. 특수 토큰이나 외부 규칙과 달리, 자연어 신호는 모델의 기존 능력과 자연스럽게 맞물리고 명시적인 메타인지 힌트를 제공하며 추론의 흐름을 유지하면서 멈출 시점을 분명히 알려준다.
5. 실험
5.1 실험 설정
데이터와 학습: OpenR1-Math에서 16K 컨텍스트 제한을 적용하고 문제 있는 샘플(예: </think> 태그가 여러 개인 경우)을 걸러 92K개의 고품질 인스턴스를 큐레이션했다. 이 필터링된 데이터셋이 베이스라인이 되고, 여기에 4.3절의 방법으로 SBT-E, SBT-D 변형을 구성한다. 미세조정은 수학 특화 모델(Qwen2.5-Math-1.5B/7B-Instruct)과 범용 모델(Llama-3.2-1B, Llama-3.1-8B-Instruct) 모두에 적용했다. Megatron-LM으로 3 에폭, 초기 학습률 1e-5, 코사인 감쇠, 0.03 워밍업 비율, 최대 시퀀스 길이 16,384 토큰으로 학습했으며, 하드웨어는 Ascend H910B-64G 64대를 썼다.
평가 벤치마크: 난이도가 다른 네 개의 수학 추론 벤치마크를 쓴다. AIME(24&25, 경시대회 수준 대수 문제), AMC23(대학 이전 수학), MATH500(다양한 수학 문제), GSM8K(초등 수학 문장제)다. 추론은 vLLM으로 temperature 0.7, 문제당 8개 샘플을 생성해 평균 정확도를 보고하며, NVIDIA A100 GPU에서 수행했다.
5.2 메인 결과
핵심 결과부터 보자. 아래 표가 네 모델에 SBT를 적용한 성능을 네 벤치마크에서 정리한 것이다.
| Base Model | Method | GSM8K Acc | GSM8K #Tok | MATH500 Acc | MATH500 #Tok | AIME Acc | AIME #Tok | AMC23 Acc | AMC23 #Tok | Avg Acc | Avg #Tok |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Qwen2.5-Math-1.5B-Instruct | Baseline | 85.00 | 514 | 80.25 | 1712 | 16.25 | 7381 | 55.94 | 3503 | 59.36 | 3277 |
| SBT-E | 84.85 | 426 | 77.10 | 1121 | 13.75 | 3101 | 55.63 | 2044 | 57.83 | 1673 | |
| SBT-D | 84.87 | 414 | 77.30 | 1046 | 14.17 | 3381 | 50.31 | 1888 | 56.66 | 1682 | |
| Qwen2.5-Math-7B-Instruct | Baseline | 96.11 | 1460 | 92.67 | 3816 | 40.83 | 11904 | 83.13 | 6937 | 78.19 | 6029 |
| SBT-E | 95.45 | 997 | 90.77 | 2501 | 38.75 | 8772 | 77.19 | 4443 | 75.54 | 4178 | |
| SBT-D | 95.37 | 956 | 91.15 | 2629 | 38.38 | 9778 | 80.06 | 5208 | 76.24 | 4643 | |
| Llama-3.2-1B | Baseline | 41.85 | 1639 | 25.22 | 6624 | 1.25 | 13150 | 9.38 | 10210 | 19.43 | 7906 |
| SBT-E | 39.96 | 1056 | 24.35 | 3180 | 0.42 | 6615 | 9.06 | 4708 | 18.45 | 3890 | |
| SBT-D | 41.21 | 698 | 25.07 | 2591 | 1.04 | 6821 | 13.13 | 4388 | 20.11 | 3624 | |
| Llama-3.1-8B-Instruct | Baseline | 88.03 | 1593 | 59.98 | 9304 | 9.58 | 13663 | 36.75 | 9742 | 48.59 | 8576 |
| SBT-E | 85.03 | 777 | 57.60 | 2292 | 6.84 | 5658 | 33.44 | 4045 | 45.73 | 3193 | |
| SBT-D | 88.27 | 997 | 62.60 | 3847 | 7.70 | 5845 | 38.12 | 6476 | 49.17 | 4291 |
Table 1 (원논문): 네 모델에 SBT를 적용한 GSM8K, MATH500, AMC23, AIME(24&25 포함) 성능. Acc는 정확도(%), #Tok은 평균 토큰 수.
이 표에서 읽어야 할 흐름이 세 가지다.
첫째, 정확도를 지키면서 토큰을 크게 줄인다. Qwen2.5-Math-7B에서 SBT-E와 SBT-D는 각각 토큰을 30.7%, 23.0% 줄이면서 정확도 하락은 2.65%p, 1.95%p에 그쳤다(78.19 → 75.54, 76.24). Llama-3.1-8B에서는 SBT-E가 토큰을 62.8% 줄이면서 베이스라인 정확도의 94.1%(48.59 → 45.73)를 보존했다. 절반 이상을 쳐냈는데도 성능은 거의 그대로다.
둘째, 모델 유형에 따라 효율 이득이 갈린다. Llama 같은 범용 모델은 클수록 이득이 커진다(1B의 50.8%에서 8B의 62.8%로). 반면 수학 특화 모델은 클수록 이득이 작아진다(1.5B의 48.9% vs 7B의 30.7%). 이건 직관적으로 말이 된다. 특화 모델은 이미 더 집중되고 효율적인 추론을 하도록 훈련되어 있어서 압축할 여지가 적기 때문이다. SBT의 자기 조절 이득이 단순히 모델 크기만이 아니라 범용/도메인 특화 여부에도 달려 있다는 뜻이다.
셋째, SBT-E와 SBT-D는 성격이 다르다. SBT-E는 대체로 토큰 감소가 더 크지만(전 모델 평균 48.3% vs SBT-D의 43.9%) 정확도 하락도 조금 더 크다. SBT-D는 더 균형 잡힌 성능을 보이며, 특히 가장 어려운 AIME와 MATH500에서 강하다. 눈에 띄는 건 Llama-3.1-8B에서 SBT-D가 MATH500 정확도를 오히려 2.62%p 올리면서(59.98 → 62.60) 토큰을 58.7% 줄였다는 점이다. 동적 절단이 단순히 잉여 추론만 제거하는 게 아니라, 어떤 경우엔 성능을 갉아먹는 "해로운 오버씽킹"까지 걷어낼 수 있음을 시사한다.
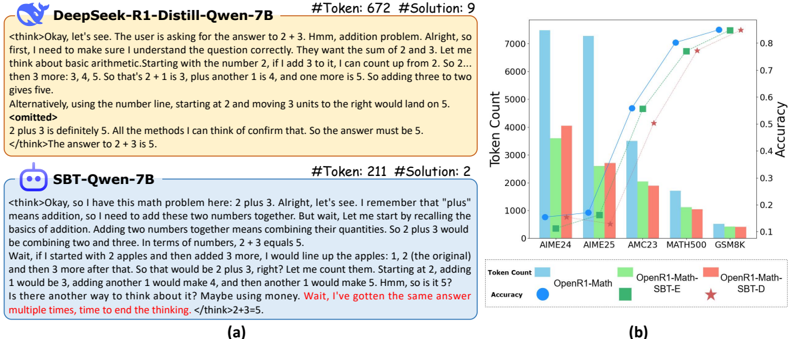
Figure 1: SBT 효과의 시연. (a) 단일 예시에서 SBT 튜닝 모델이 오버씽킹을 자발적으로 종료하고 토큰을 크게 줄인다. (b) 주요 수학 벤치마크에서 OpenR1-Math를 SFT 데이터로 쓴 경우 대비, SBT 튜닝된 Qwen2.5-Math-1.5B-Instruct가 정확도를 유지하면서 토큰 소비를 대폭 줄인다. (원논문)
Figure 1이 이 결과를 시각적으로 압축한다. (a)의 "2 더하기 3" 예시에서 원본 모델은 672 토큰에 9개 풀이를 쓰지만, SBT-Qwen-7B는 211 토큰에 2개 풀이만 쓰고 "잠깐, 같은 답을 여러 번 얻었으니 이제 생각을 끝낼 때다"라며 스스로 종료한다. (b)의 막대그래프는 다섯 벤치마크에서 토큰 수(막대)와 정확도(마커)를 함께 보여주는데, SBT-E와 SBT-D의 토큰 막대가 원본(OpenR1-Math) 대비 확연히 낮으면서도 정확도 마커는 비슷한 높이에 머문다. 토큰은 반토막인데 정확도 점은 거의 겹친다는 것이 이 그림의 메시지다.
5.3 분석 실험
메인 결과 이후로는 SBT의 각 설계 선택이 실제로 필요한지를 검증하는 분석 실험들이 이어진다. 아래 분석은 모두 Qwen2.5-Math-1.5B-Instruct 기준이며, 베이스라인은 정확도 59.36%, 토큰 3277이다.
5.3.1 오버씽킹 임계값의 영향
오버씽킹으로 분류하는 임계값이 데이터 구성과 성능에 미치는 영향을 본다. 임계값 0.2, 0.3, 0.4가 각각 약 60%, 50%, 40%의 샘플을 오버씽킹으로 분류한다.
| Method | Threshold | Acc | #Tok |
|---|---|---|---|
| Baseline | - | 59.36 | 3278 |
| SBT-E | 0.2 | 57.83 | 1673 |
| SBT-E | 0.3 | 56.70 | 1755 |
| SBT-E | 0.4 | 57.38 | 1834 |
| SBT-D | 0.2 | 56.66 | 1682 |
| SBT-D | 0.3 | 57.47 | 1917 |
| SBT-D | 0.4 | 57.36 | 1902 |
Table 2 (원논문): 오버씽크 점수 임계값별 성능. 상세 결과는 Appendix Table 12.
임계값 0.2가 SBT-E에서 최적으로, 토큰 49% 감소와 베이스라인 정확도의 97.4% 보존이라는 균형을 낸다. 여기서 나오는 통찰이 흥미롭다. 공격적인 오버씽킹 식별(낮은 임계값)이 비례적인 정확도 손실 없이 더 큰 효율 이득을 낸다는 것이다. 뒤집어 말하면 LRM 추론의 상당 부분이 진짜로 잉여이며, 문제 해결 능력을 해치지 않고도 걷어낼 수 있다는 뜻이다. 약 60%의 추론 인스턴스에서 오버씽킹을 식별해 처리하는 것이 SBT의 최적 작동점으로 보인다.
5.3.2 보존 추론과 잉여 마스킹의 트레이드오프
효과적인 자기 브레이킹을 학습하려면 모델이 "언제 계속하고 언제 멈출지"를 함께 배워야 한다. 보존(비마스킹)과 마스킹 내용의 조합을 바꿔가며 실험했다.
| Reservations & Masked Content | Acc | #Tok |
|---|---|---|
| Baseline | 59.36 | 3277 |
| 1 solution & A few sentences | 56.95 | 1700 |
| 1 solution & 1 solution | 57.69 | 1697 |
| 2 solutions & A few sentences | 57.83 | 1673 |
| 2 solutions & 1 solution | 57.45 | 1684 |
Table 3 (원논문): 보존 추론과 마스킹된 잉여 내용의 조합별 성능. 상세 결과는 Appendix Table 13.
완전한 풀이 두 개를 보존하고 몇 문장만 마스킹하는 조합이 최적이다(토큰 49% 감소, 정확도 97.4% 보존). 두 가지 시사점이 나온다. 첫째, 풀이 반복이 자연스러운 종료 신호가 된다. 모델이 같은 답을 두 번 도출하면 이것이 추론을 마무리하라는 강한 신호임을 학습한다. 둘째, 보존과 마스킹 사이에 역관계가 있다. 보존 추론이 많으면(풀이 2개) 마스킹은 적은 게 낫고, 보존이 적으면(풀이 1개) 마스킹이 많은 게 낫다. 모델이 강건한 문제 해결 능력을 갖추려면 일정한 "추론 할당량"이 필요한데, 이는 보존 추론이나 마스킹 노출 어느 쪽으로든 채울 수 있다는 것이다. 다만 "풀이 2개 + 최소 마스킹"이 최고 성능이라는 건, 명확하게 구분된 완전한 추론 경로가 마스킹 노출보다 더 강한 학습 신호를 준다는 뜻이다.
5.3.3 마스킹된 잉여 사고(MRT)의 유무
MRT 자체가 필요한지를 검증하기 위해, 마스킹 구간을 두는 SBT-E와 그냥 잘라버리는 변형을 비교했다.
| Config. | Acc | #Tok |
|---|---|---|
| Baseline | 59.36 | 3277 |
| w/ MRT | 57.83 | 1673 |
| w/o MRT | 58.02 | 2306 |
Table 4 (원논문): MRT 유무 비교. 상세 결과는 Appendix Table 14.
MRT를 제거하면 정확도는 미미하게 오르지만(+0.19%p) 효율은 크게 나빠진다(토큰 +37.8%, 1673 → 2306). 이유는 명확하다. 마스킹된 오버씽킹 패턴에 노출되지 않으면 모델은 무엇이 잉여인지를 내재화하지 못한다. 그냥 잘라버리면 모델은 추론이 "어디서" 끝나는지는 보지만 "왜" 끝나는지는 모른다. 마스킹 구간은 명시적인 음성 예시(negative example) 역할을 해서, 모델이 그래디언트 강화 없이 오버씽킹을 관찰하고 종료 경계를 변별적으로 학습하게 한다. "강화 없는 노출" 원리가 자기 조절에 필수적임을 보여주는 결과다.
5.3.4 오버씽크 점수의 민감도
오버씽크 점수에서 구조적 효율 와 언어적 마커 의 균형을 잡는 의 민감도를 본다.
| Method | β | Acc | #Tok |
|---|---|---|---|
| Baseline | - | 59.36 | 3277 |
| SBT-E | 0.05 | 56.48 | 1762 |
| SBT-E | 0.1 | 57.83 | 1673 |
| SBT-E | 0.15 | 56.52 | 1874 |
| SBT-E | 0.2 | 55.86 | 1809 |
| SBT-D | 0.05 | 56.24 | 1678 |
| SBT-D | 0.1 | 56.66 | 1682 |
| SBT-D | 0.15 | 56.21 | 1784 |
| SBT-D | 0.2 | 55.74 | 1814 |
Table 5 (원논문): 오버씽크 점수 가중치 별 성능. 상세 결과는 Appendix Table 15.
이 두 변형 모두에서 일관되게 최적이다(SBT-E 57.83%, SBT-D 56.66%, 토큰 1673/1682). 낮은 값()은 언어적 마커를 과대평가해 정확도를 0.4-1.4점 떨어뜨리고 토큰 절감도 미미하다. 높은 값()은 언어적 기여를 줄여 정확도가 1.3-2.0점 하락하고 토큰이 오히려 늘어난다. 구조적 효율에 90%, 언어적 신호에 10%를 주는 설계가 프롬프트 민감성 없이 강건한 탐지를 낸다는 걸 정량적으로 뒷받침한다.
5.3.5 스텝 단위 vs 토큰 단위 탐지, 그리고 가이드 방식
마지막 두 분석은 탐지 단위와 종료 신호 방식을 다룬다. 왼쪽은 오버씽킹을 스텝 단위로 탐지할지 토큰 단위로 탐지할지(, 는 첫 정답까지의 토큰 수)의 비교, 오른쪽은 종료 신호를 자연어로 줄지 특수 토큰(<stop_overthinking>)으로 줄지 아니면 아예 안 줄지의 비교다.
| Level | Acc | #Tok | Guiding Mode | Acc | #Tok | |
|---|---|---|---|---|---|---|
| Baseline | 59.36 | 3277 | Baseline | 59.36 | 3277 | |
| Step-Level | 56.66 | 1682 | Natural Language | 56.66 | 1682 | |
| Token-Level | 56.24 | 1753 | Special Token | 56.61 | 1797 | |
| No Guidance | 56.39 | 1801 |
Table 6, 7 (원논문): (좌) 스텝 단위 vs 토큰 단위 탐지, (우) 종료 가이드 방식 비교. 상세 결과는 각각 Appendix Table 16, 17.
스텝 단위 탐지가 토큰 단위보다 정확도도 높고 토큰도 적다. 추론의 논리적 단위를 온전히 유지할 때 일관성이 더 잘 보존된다는 가설을 확인한 것이다. 토큰 단위 절단은 더 세밀하지만 추론의 논리적 단위를 중간에 끊어버려서, 조각나거나 불완전한 사고 패턴을 만들 위험이 있다.
가이드 방식에서는 자연어 가이드가 최적이다(56.66%, 1682 토큰). 가이드가 아예 없으면 정확도(-0.27%p)와 효율(+7.1% 토큰)이 모두 나빠져서 명시적 종료 신호의 필요성이 확인된다. 특수 토큰(56.61%, 1797 토큰)과 비교하면 자연어 가이드는 비슷한 정확도에 토큰을 6.4% 더 줄인다. 인위적인 제어 규약을 새로 학습시키는 대신 모델이 이미 가진 논리적 전환에 대한 의미 이해를 활용하기 때문이다. 개인적으로는 이 결과가 SBT 설계 철학을 가장 잘 대변한다고 본다. 특수 토큰이라는 "외부 장치"보다 자연어라는 "모델의 모국어"로 멈춤을 가르치는 게 더 잘 통한다는 것이니까.
6. 부록 (Appendix) 심층 분석
부록에는 SBT의 작동 원리를 뒷받침하는 중요한 분석들이 담겨 있어서 별도로 정리한다.
6.1 학습된 모델의 자율적 추론 조절 (Appendix B)
중요한 구분이 하나 있다. SBT-E와 SBT-D는 데이터 구성 전략이지 추론 시점의 제어 메커니즘이 아니다. 학습이 끝나면 모델은 외부 개입 없이 스스로 추론 깊이를 문제 난이도에 맞춰 조절한다. 이를 검증하려고 Qwen2.5-Math-7B-Instruct-SBT-E의 AIME 추론 패턴을 분석했다.
| Dataset | Exit Type | % of Cases | Acc | #Tok |
|---|---|---|---|---|
| AIME24 | Early Exit | 50.83% | 41.80% | 5,692 |
| AIME24 | No Early Exit | 49.17% | 38.98% | 11,084 |
| AIME25 | Early Exit | 49.17% | 41.53% | 6,483 |
| AIME25 | No Early Exit | 50.83% | 32.79% | 12,201 |
Table 8 (원논문): SBT 학습 모델의 AIME에서의 자율적 조기 종료 분석. 약 50%의 경우에서 자연스럽게 종료하며, 48-51%의 토큰 감소와 함께 더 높은 정확도를 달성한다.
이 표가 SBT의 작동을 가장 설득력 있게 보여준다. 조기 종료가 강제된 게 아닌데도, 조기 종료한 경우가 종료하지 않은 경우보다 정확도가 높으면서 토큰은 절반 수준이다. AIME25에서 특히 극적인데, 조기 종료(41.53%, 6483 토큰)가 미종료(32.79%, 12201 토큰)보다 정확도가 8.7%p나 높다. 모델이 추가 추론이 역효과가 되는 시점을 학습으로 인식하게 됐다는 강력한 증거다. 오래 생각한다고 잘 푸는 게 아니라는 것이다.
| Dataset | Difficulty | Avg Steps |
|---|---|---|
| GSM8K | Easy | 27.78 |
| MATH500 | Medium | 51.32 |
| AMC23 | Hard | 106.40 |
| AIME25 | Very Hard | 202.23 |
Table 9 (원논문): Qwen2.5-Math-7B-Instruct-SBT-E의 난이도별 적응형 추론 깊이.
이 표는 자율 조절을 다른 각도에서 확인한다. GSM8K(쉬움)에서 평균 27.78 스텝, AIME25(매우 어려움)에서 202.23 스텝으로 7.3배 차이가 난다. 외부 난이도 지표나 태스크별 프롬프트 없이 이런 변화가 나타난다는 건, 모델이 문제 복잡도를 내부적으로 평가하고 있다는 뜻이다. 저자들은 자연어 브레이킹 프롬프트가 표현 공간(representation space)의 앵커 포인트 역할을 해서, 추론 중 유사한 상태를 인식하면 종료 행동을 촉발한다고 가설을 세운다. AIME에서 조기 종료율이 개별 문제에 걸쳐 ~50%로 일관된다는 점이 이 행동이 훈련 예시 암기를 넘어 일반화됨을 시사한다.
6.2 도메인 외 일반화 (Appendix C)
SBT가 수학을 넘어 일반화되는지 확인하기 위해, 수학 데이터로만 학습한 모델을 두 개의 도메인 외(out-of-domain) 벤치마크에서 평가했다. MMLU-Redux(일반 지식과 추론)와 GPQA-Diamond(대학원 수준 과학)다.
| Base Model | Method | MMLU-Redux Acc | MMLU-Redux #Tok | GPQA-Diamond Acc | GPQA-Diamond #Tok | Avg Acc | Avg #Tok |
|---|---|---|---|---|---|---|---|
| Qwen2.5-Math-1.5B | Baseline | 45.84 | 2,061 | 24.75 | 5,485 | 35.30 | 3,773 |
| SBT-E | 43.12 | 1,403 | 25.06 | 3,194 | 34.09 | 2,299 | |
| SBT-D | 43.28 | 1,566 | 26.20 | 3,002 | 34.74 | 2,284 | |
| Qwen2.5-Math-7B | Baseline | 67.04 | 3,229 | 41.15 | 8,892 | 54.10 | 6,061 |
| SBT-E | 65.84 | 1,927 | 40.40 | 6,205 | 53.12 | 4,066 | |
| SBT-D | 66.39 | 1,998 | 41.29 | 6,706 | 53.84 | 4,352 | |
| Llama-3.2-1B | Baseline | 35.62 | 1,933 | 17.99 | 9,321 | 26.81 | 5,627 |
| SBT-E | 32.24 | 770 | 24.24 | 3,516 | 28.24 | 2,143 | |
| SBT-D | 33.12 | 725 | 23.48 | 3,157 | 28.30 | 1,941 | |
| Llama-3.1-8B | Baseline | 80.53 | 2,481 | 37.31 | 8,918 | 58.92 | 5,699 |
| SBT-E | 77.46 | 1,646 | 36.30 | 5,346 | 56.88 | 3,496 | |
| SBT-D | 77.74 | 1,668 | 36.91 | 6,717 | 57.33 | 4,192 |
Table 10 (원논문): MMLU-Redux와 GPQA-Diamond에서의 도메인 외 평가. 수학 데이터로만 학습한 모델이 비수학 태스크에서도 26-65% 토큰 감소를 보이며, 정확도 하락은 대개 1-3%p에 그친다.
이 결과가 SBT의 가장 놀라운 부분이다. 수학으로만 학습했는데 일반 지식과 과학 추론에서도 26-65%의 토큰 감소가 나타난다. 특히 Llama-3.2-1B는 GPQA-Diamond에서 SBT-E가 정확도를 6.25%p나 올린다(17.99% → 24.24%). 작은 모델에서는 오버씽킹 억제가 어려운 도메인 외 태스크의 성능을 오히려 끌어올린 것이다. 효율 이득은 모델 크기와 역관계로, 작은 모델(Llama-3.2-1B)이 65% 감소를, 큰 모델이 26-40% 감소를 보인다. 도메인 특화 모델과 범용 모델이 비슷하게 이득을 본다는 점은 자기 브레이킹이 태스크별 적응이 아니라 전이 가능한 메타인지 능력임을 뒷받침한다. 수학에서 배운 "추론을 적절히 멈추는 감각"이 다른 도메인으로 넘어간다는 것이다.
6.3 확장 임계값 분석 (Appendix D)
로 임계값 범위를 넓혀 탐지 메커니즘의 강건성을 본다. Overthink %는 각 임계값에서 오버씽킹으로 분류된 샘플 비율이다.
| Method | Threshold | Overthink % | Accuracy | #Tokens | Reduction |
|---|---|---|---|---|---|
| Baseline | - | - | 59.36 | 3,277 | - |
| SBT-E | 0.05 | 75.20 | 55.14 | 1,407 | 57.1% |
| SBT-E | 0.1 | 65.40 | 55.59 | 1,427 | 56.5% |
| SBT-E | 0.2 | 60.30 | 57.83 | 1,673 | 48.9% |
| SBT-E | 0.3 | 50.20 | 56.70 | 1,755 | 46.4% |
| SBT-E | 0.4 | 41.00 | 57.38 | 1,834 | 44.0% |
| SBT-E | 0.5 | 2.06 | 57.12 | 2,602 | 20.6% |
| SBT-D | 0.05 | 74.20 | 54.90 | 1,215 | 62.9% |
| SBT-D | 0.1 | 62.30 | 55.90 | 1,251 | 61.8% |
| SBT-D | 0.2 | 62.50 | 56.66 | 1,682 | 48.7% |
| SBT-D | 0.3 | 50.90 | 57.47 | 1,917 | 41.5% |
| SBT-D | 0.4 | 40.10 | 57.36 | 1,902 | 42.0% |
| SBT-D | 0.5 | 0.19 | 57.09 | 2,696 | 17.7% |
Table 11 (원논문): 에서의 확장 임계값 분석. GSM8K, MATH500, AIME, AMC23 평균.
저자들은 세 가지 성능 영역을 구분한다. **공격적 가지치기()**는 62-75%를 오버씽킹으로 분류해 최대 토큰 감소(57-63%)를 내지만 정확도가 2.5-4.5%p 하락한다. 에서는 복잡한 문제의 필요한 탐색 스텝까지 잘라버린다. **균형 작동()**은 40-62%를 분류하며 정확도 변동 1.2%p 미만으로 안정적이고 41-49% 토큰 감소를 유지한다. 이 범위 내에서 정확한 임계값에 둔감하다는 것이 탐지의 강건성을 보여준다. **보수적 가지치기()**는 0.2-2%만 분류해서 사실상 베이스라인으로 퇴화하고, 토큰 감소가 18-21%로 떨어진다. 를 기본값으로 택한 이유는 균형 영역에서 최고 정확도를 내면서, 약 60%는 SBT 처리하고 40%는 원본을 남겨 "언제 멈출지"와 "언제 계속할지"를 함께 학습시키는 균형 노출을 만들기 때문이다.
6.4 오버씽킹 마커 목록 (Appendix E)
계산에 쓰이는 마커 집합 의 전체 목록이다. 재고, 주저, 되짚기를 신호하는 단어들이다.
| Another | Backtrack | But |
| Check | Going back | Hmm |
| Hmmm | However | Hold on |
| Instead of | Just to be thorough | Just to make sure |
| Let me check | Let me just double-check | Let me try another |
| Let me verify | Maybe | Maybe I can consider |
| Maybe I should consider | Might | Not sure |
| Perhaps | Recheck | Retry |
| Trace back | Wait |
Table (원논문 Appendix E): 오버씽크 마커 어휘 집합 .
"Wait", "However", "Let me verify" 같은 단어들이 반복 검증, 대안 가설 형성, 추론 경로 되짚기 같은 행동과 자주 함께 나타나기 때문에 언어적 잉여 지표로 삼았다. Figure 3(a)의 예시에서 각 진화 풀이가 "Let me verify", "But let me make sure", "Another way" 같은 표현으로 시작하는 걸 떠올리면 이 마커들의 선택이 자연스럽다.
6.5 SBT 알고리즘 (Appendix F)
데이터 구성의 형식적 절차가 두 알고리즘으로 제시된다.
Algorithm 1 (SBT-E): 추론 궤적 에서 Foundation Solution 와 진화 풀이들 이 주어질 때,
- 보존 구간
- 진화 풀이가 2개 이상이면 마스킹 구간 의 처음 10-20%
- 아니면 마스킹 구간
- 보존 구간 + 마스킹 구간 (마스킹 구간에 loss masking 적용)
즉 Foundation과 첫 진화 풀이는 항상 남기고, 두 번째 진화 풀이의 앞부분만 살짝 보여주되 손실은 계산하지 않는다.
Algorithm 2 (SBT-D): 스텝들 과 임계값 가 주어질 때,
- 보존 사고 Foundation Solution
- Foundation 다음 스텝부터 시작해서, 오버씽크 점수가 미만인 동안 스텝을 계속 보존 사고에 추가
- 그 뒤 오버씽크 점수가 미만인 동안의 스텝들을 마스킹 사고로 추가
- 보존 사고 + 마스킹 사고 (마스킹 사고에 loss masking 적용)
두 알고리즘 모두 잉여 구간에 손실 마스킹을 걸어, 모델이 오버씽킹 패턴을 "보되 배우지 않게(그래디언트 업데이트 없이)" 한다는 원리를 공유한다. SBT-E는 균일한 구조적 경계에서, SBT-D는 문제별 점수 기반으로 자른다는 차이만 있다.
6.6 상세 실험 결과 (Appendix G)
본문 5.3절의 분석 표들(Table 2-7)은 벤치마크 평균만 보여준 것이고, Appendix G에 벤치마크별 세부 수치(Table 12-17)가 담겨 있다. 여기서는 본문 평균 뒤에 가려진 태스크별 패턴을 확인한다.
임계값별 상세(Table 12)를 보면, 쉬운 GSM8K는 임계값에 걸쳐 정확도가 안정적인 반면 어려운 AIME는 높은 임계값(0.3-0.4)에서 토큰이 늘면서 정확도가 소폭 개선된다. 가지치기 공격성에 대한 민감도가 태스크 난이도에 따라 다른 것이다.
| Method | Threshold | GSM8K Acc | GSM8K #Tok | MATH500 Acc | MATH500 #Tok | AIME Acc | AIME #Tok | AMC23 Acc | AMC23 #Tok | Avg Acc | Avg #Tok |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Baseline | - | 85.00 | 514 | 80.25 | 1712 | 16.25 | 7381 | 55.94 | 3503 | 59.36 | 3277 |
| SBT-E | 0.2 | 84.85 | 426 | 77.10 | 1121 | 13.75 | 3101 | 55.63 | 2044 | 57.83 | 1673 |
| SBT-E | 0.3 | 85.16 | 424 | 77.25 | 1113 | 15.63 | 3353 | 48.75 | 2132 | 56.70 | 1755 |
| SBT-E | 0.4 | 84.73 | 421 | 77.40 | 1130 | 12.71 | 3795 | 54.69 | 1988 | 57.38 | 1834 |
| SBT-D | 0.2 | 84.87 | 414 | 77.30 | 1046 | 14.17 | 3381 | 50.31 | 1888 | 56.66 | 1682 |
| SBT-D | 0.3 | 84.58 | 410 | 78.00 | 1125 | 12.92 | 3710 | 54.37 | 2422 | 57.47 | 1917 |
| SBT-D | 0.4 | 85.07 | 407 | 78.73 | 1187 | 14.38 | 3593 | 51.25 | 2421 | 57.36 | 1902 |
Table 12 (원논문): 오버씽크 점수 임계값별 벤치마크 세부 성능.
보존/마스킹 조합의 세부(Table 13)에서는 GSM8K 같은 단순 태스크는 최소 보존으로도 효과적 종료를 학습하는 반면, AIME 같은 어려운 태스크는 완전한 풀이를 여러 개 노출하는 게 더 유리하다는 게 드러난다.
| Reservations & Masked | GSM8K Acc | GSM8K #Tok | MATH500 Acc | MATH500 #Tok | AIME Acc | AIME #Tok | AMC23 Acc | AMC23 #Tok | Avg Acc | Avg #Tok |
|---|---|---|---|---|---|---|---|---|---|---|
| Baseline | 85.00 | 514 | 80.25 | 1712 | 16.25 | 7381 | 55.94 | 3503 | 59.36 | 3277 |
| 1 sol & A few sentences | 85.23 | 416 | 78.00 | 1103 | 12.71 | 3132 | 51.88 | 2148 | 56.95 | 1700 |
| 1 sol & 1 sol | 85.06 | 432 | 78.60 | 1101 | 13.96 | 3178 | 53.12 | 2076 | 57.69 | 1697 |
| 2 sol & A few sentences | 84.85 | 426 | 77.10 | 1121 | 13.75 | 3101 | 55.63 | 2044 | 57.83 | 1673 |
| 2 sol & 1 sol | 84.77 | 411 | 77.82 | 1034 | 12.50 | 3092 | 54.69 | 2197 | 57.45 | 1684 |
Table 13 (원논문): 보존/마스킹 조합별 벤치마크 세부 성능.
MRT 세부(Table 14)는 MRT 제거의 타격이 태스크 난이도에 비례함을 보여준다. GSM8K는 토큰 +9.6%로 미미하지만, AIME는 +46.5%(3101 → 4544), AMC는 +36.4%로 복잡한 추론 태스크일수록 효율 저하가 심하다.
| Configuration | GSM8K Acc | GSM8K #Tok | MATH500 Acc | MATH500 #Tok | AIME Acc | AIME #Tok | AMC Acc | AMC #Tok | Avg Acc | Avg #Tok |
|---|---|---|---|---|---|---|---|---|---|---|
| Baseline | 85.00 | 514 | 80.25 | 1712 | 16.25 | 7381 | 55.94 | 3503 | 59.36 | 3277 |
| w/ MRT | 84.85 | 426 | 77.10 | 1121 | 13.75 | 3101 | 55.63 | 2044 | 57.83 | 1673 |
| w/o MRT | 85.05 | 467 | 78.30 | 1425 | 14.38 | 4544 | 54.37 | 2788 | 58.02 | 2306 |
Table 14 (원논문): MRT 유무의 벤치마크 세부 성능.
세부(Table 15)에서는 가 쉬운 GSM8K에서 정확도를 최대화하고 MATH500에서 토큰을 최소화하는 반면, 이 복잡한 AIME, AMC23에서 우세하다. 태스크 복잡도별로 최적 가 조금씩 다르지만 평균적으로 0.1이 강건한 기본값이다.
| Method | β | GSM8K Acc | GSM8K #Tok | MATH500 Acc | MATH500 #Tok | AIME Acc | AIME #Tok | AMC23 Acc | AMC23 #Tok | Avg Acc | Avg #Tok |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Baseline | - | 85.00 | 514 | 80.25 | 1712 | 16.25 | 7381 | 55.94 | 3503 | 59.36 | 3277 |
| SBT-E | 0.05 | 84.92 | 433 | 76.45 | 1089 | 13.13 | 3198 | 51.42 | 2328 | 56.48 | 1762 |
| SBT-E | 0.1 | 84.85 | 426 | 77.10 | 1121 | 13.75 | 3101 | 55.63 | 2044 | 57.83 | 1673 |
| SBT-E | 0.15 | 84.78 | 448 | 76.80 | 1243 | 13.54 | 3487 | 50.96 | 2318 | 56.52 | 1874 |
| SBT-E | 0.2 | 84.61 | 441 | 76.05 | 1198 | 12.92 | 3421 | 49.86 | 2176 | 55.86 | 1809 |
| SBT-D | 0.05 | 84.89 | 421 | 76.50 | 1087 | 13.33 | 3289 | 50.24 | 1915 | 56.24 | 1678 |
| SBT-D | 0.1 | 84.87 | 414 | 77.30 | 1046 | 14.17 | 3381 | 50.31 | 1888 | 56.66 | 1682 |
| SBT-D | 0.15 | 84.83 | 437 | 76.95 | 1178 | 13.75 | 3598 | 49.31 | 1923 | 56.21 | 1784 |
| SBT-D | 0.2 | 84.71 | 429 | 76.30 | 1154 | 13.13 | 3701 | 48.82 | 1972 | 55.74 | 1814 |
Table 15 (원논문): 값별 벤치마크 세부 성능.
탐지 단위 세부(Table 16)는 스텝 단위가 모든 데이터셋에서 토큰을 덜 쓰고(GSM8K 414 vs 431, AMC23 1888 vs 2091), 특히 어려운 AIME에서 정확도가 확연히 앞선다(14.17% vs 11.34%)는 걸 보여준다. 완전한 추론 스텝을 보존하는 것이 복잡한 문제 해결에서 더 나은 효율-정확도 트레이드오프를 낸다는 뜻이다.
| Level | GSM8K Acc | GSM8K #Tok | MATH500 Acc | MATH500 #Tok | AIME Acc | AIME #Tok | AMC23 Acc | AMC23 #Tok | Avg Acc | Avg #Tok |
|---|---|---|---|---|---|---|---|---|---|---|
| Baseline | 85.00 | 514 | 80.25 | 1712 | 16.25 | 7381 | 55.94 | 3503 | 59.36 | 3277 |
| Step-Level | 84.87 | 414 | 77.30 | 1046 | 14.17 | 3381 | 50.31 | 1888 | 56.66 | 1682 |
| Token-Level | 85.09 | 431 | 78.23 | 1088 | 11.34 | 3399 | 50.31 | 2091 | 56.24 | 1753 |
Table 16 (원논문): 스텝 단위 vs 토큰 단위 탐지의 벤치마크 세부 성능.
가이드 방식 세부(Table 17)는 자연어 가이드가 AIME(3381 vs 특수토큰 3647)와 AMC(1888 vs 2007)에서 토큰을 아끼며 일관되게 최고의 효율-정확도 균형을 낸다는 걸 확인한다.
| Guiding Mode | GSM8K Acc | GSM8K #Tok | MATH500 Acc | MATH500 #Tok | AIME Acc | AIME #Tok | AMC Acc | AMC #Tok | Avg Acc | Avg #Tok |
|---|---|---|---|---|---|---|---|---|---|---|
| Baseline | 85.00 | 514 | 80.25 | 1712 | 16.25 | 7381 | 55.94 | 3503 | 59.36 | 3277 |
| Natural Language | 84.87 | 414 | 77.30 | 1046 | 14.17 | 3381 | 50.31 | 1888 | 56.66 | 1682 |
| Special Token | 84.94 | 413 | 77.92 | 1120 | 12.34 | 3647 | 51.25 | 2007 | 56.61 | 1797 |
| No Guidance | 84.73 | 421 | 77.05 | 1098 | 13.54 | 3523 | 50.24 | 2162 | 56.39 | 1801 |
Table 17 (원논문): 종료 가이드 방식별 벤치마크 세부 성능.
세부 표들을 관통하는 패턴은 하나다. SBT의 각 설계 선택(임계값 0.2, 풀이 2개 보존, MRT, , 스텝 단위, 자연어 가이드)이 만드는 효과 차이가 쉬운 태스크(GSM8K)에서는 작고 어려운 태스크(AIME)에서는 크게 벌어진다. 오버씽킹이 원래 어려운 문제에서 심하니, 그걸 다루는 설계의 중요성도 어려운 문제에서 더 드러나는 것이다.
7. 강점과 한계
강점
- 외부 개입 없는 내재적 조절: 토큰 예산이나 추론 중단 같은 외부 장치 없이, 학습된 모델이 스스로 멈춘다. Table 8에서 조기 종료가 강제 없이 발생하며 오히려 정확도가 높다는 것이 이를 뒷받침한다. 배포 시 추가 제어 로직이 필요 없다는 실무적 이점이 크다.
- 강력한 효율-정확도 트레이드오프: 최대 62.8% 토큰 감소에도 정확도 94% 이상 보존(Table 1). 특히 Llama-3.1-8B에서 SBT-D가 MATH500 정확도를 오히려 올리면서 토큰을 58.7% 줄인 사례는 "해로운 오버씽킹" 제거의 가능성을 보여준다.
- 도메인 외 전이: 수학으로만 학습했는데 MMLU-Redux, GPQA-Diamond에서도 26-65% 토큰 감소(Table 10). 자기 브레이킹이 태스크 특화가 아닌 전이 가능한 메타인지 능력임을 입증했다. Llama-3.2-1B가 GPQA에서 정확도까지 6.25%p 오른 건 특히 인상적이다.
- 철저한 ablation: 임계값, 보존/마스킹 조합, MRT, , 탐지 단위, 가이드 방식까지 설계의 모든 축을 정량적으로 검증했다(Table 2-7, 11-17). 각 선택의 근거가 데이터로 뒷받침된다.
- 재현성: 알고리즘(Algorithm 1, 2)과 마커 목록(Appendix E)을 공개하고 코드도 오픈했다. 방법을 그대로 따라 할 수 있다.
한계 및 아쉬운 점
저자들이 Appendix A에서 스스로 밝힌 한계에 리뷰어 관점을 더하면 이렇다.
- 수학 도메인 편중: 주 실험이 수학 추론에 집중되어 있다. 도메인 외 실험(Table 10)이 일반화 가능성을 보여주긴 하지만, 개방형 생성이나 상식 추론, 멀티모달 추론처럼 잉여 패턴이 다를 수 있는 영역에서의 검증은 여전히 부족하다.
- 고정 임계값 의존: SBT-E/D 모두 오버씽킹 탐지에 고정 임계값( 등)을 쓴다. 태스크가 바뀌면 수동 튜닝이 필요할 수 있어 동적 적응을 저해한다. 자동 임계값 조정 파이프라인이 후속 과제로 남는다.
- 오버씽킹 신호 정의의 한계: 와 가 잉여의 모든 형태를 포착하진 못한다. 겉보기엔 잉여인 스텝이 실은 모델이 추론을 조직하거나 추상적 패턴을 암묵적으로 표현하는 숨은 역할을 할 수도 있다.
- 종료 결정의 불투명성: 손실 마스킹으로 부드러운 제약을 걸지만, 모델이 종료를 결정하는 내부 과정은 여전히 블랙박스다. 이 결정을 추적하거나 제어할 명시적 메커니즘이 없어서 교육, 의료 같은 고신뢰 응용에서는 걸림돌이 될 수 있다.
- 복잡 태스크에서의 조기 종료 위험: 정리 증명처럼 깊은 다단계 추론이 필요한 태스크에서는 조기 종료가 결정적 스텝을 빠뜨릴 위험이 있다. 대부분 정확도를 지키지만, 완전한 추론 체인이 필수인 시나리오에서는 성능이 떨어질 수 있다.
- 데이터 규모의 제약: 계산 자원 문제로 실험이 92K 예시에 한정됐다. 수백만 규모로 확장했을 때의 효과는 미검증이다. Table 1의 Llama-3.2-1B 결과에서 AIME 정확도가 원래 1점대로 매우 낮아, 이 크기 모델에서의 결론은 신중히 볼 필요가 있다.
8. 마치며
이 논문의 미덕은 문제를 다시 정의한 데 있다. 기존 연구가 "어떻게 모델을 밖에서 멈출까"를 물었다면, SBT는 "어떻게 모델이 스스로 멈추게 가르칠까"를 물었다. 그리고 그 답으로 오버씽킹을 와 라는 두 지표로 정량화하고, 브레이킹 지점에 자연어 신호를 심은 데이터로 미세조정하는 깔끔한 레시피를 내놓았다. 결과는 최대 60% 토큰 감소에 정확도 유지라는, 실무에 바로 와닿는 숫자다.
가장 흥미로운 발견은 Table 8이다. 조기 종료가 강제가 아닌데도 조기 종료한 경우가 오히려 정확도가 높다는 것. 이는 "더 오래 생각하면 더 잘 푼다"는 LRM에 대한 흔한 직관이 항상 옳지는 않음을 보여준다. 어떤 오버씽킹은 단순히 비효율적인 게 아니라 실제로 답을 흐린다. SBT가 잉여 추론뿐 아니라 이 "해로운 오버씽킹"까지 걷어낼 수 있다는 점(Llama-3.1-8B의 MATH500 정확도 상승)은 효율성을 넘어 성능 자체에 대한 함의를 던진다.
물론 수학 도메인 편중, 고정 임계값, 종료 결정의 불투명성 같은 한계는 남는다. 그럼에도 "모델이 자기 추론을 스스로 조절한다"는 방향을 데이터 구성만으로 구현하고 도메인 외 전이까지 확인한 점에서, 효율적 추론 연구에 실용적이면서도 개념적으로 명확한 이정표를 세웠다고 본다. 추론 모델의 비용이 실배포의 병목이 되어가는 지금, 외부 장치 없이 모델 안에 브레이크를 심는다는 접근은 앞으로 더 주목받을 만하다.