논문 리뷰
논문 리뷰: ScientistOne - Towards Human-Level Autonomous Research via Chain-of-Evidence
자율 연구 에이전트가 만든 논문은 잘 읽히지만 근거가 없는 경우가 많다. 모든 주장을 근거로 역추적하는 Chain-of-Evidence 표준과 이를 설계에 내재화한 ScientistOne, 그리고 어떤 시스템에도 적용 가능한 CoE Integrity Audit을 제안한 논문.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | ScientistOne: Towards Human-Level Autonomous Research via Chain-of-Evidence |
| 저자 | Rui Meng, Bhavana Dalvi Mishra*, Jiefeng Chen* 외 (Google Cloud AI Research) |
| 학회/저널 | arXiv preprint, 2026년 5월 |
| 논문 링크 | arXiv:2605.26340 |
| 프로젝트 | scientist-one.github.io |
1. 들어가며
작년부터 "AI가 논문을 쓴다"는 이야기가 더 이상 비유가 아니게 됐다. The AI Scientist(Lu et al., 2024) 이후로 문헌 조사부터 가설 생성, 실험 설계와 실행, 원고 작성까지 전 과정을 자동화하는 시스템들이 쏟아졌고, 그중 일부는 워크숍에 실제로 accept된 논문까지 만들어냈다(Yamada et al., 2025). 시스템 최적화 같은 태스크에서는 인간 전문가와 경쟁할 만한 솔루션을 내놓기도 한다. 겉으로 드러나는 산출물, 그러니까 코드와 실험 결과와 그럴듯하게 조판된 원고만 놓고 보면 사람이 쓴 것과 구분하기가 점점 어려워지고 있다.
문제는 바로 그 "겉으로 드러나는 품질"과 "실제로 근거가 있는가"가 완전히 다른 이야기라는 데 있다. 이 논문이 겨냥하는 지점이 정확히 여기다. 자율 연구 시스템은 여러 단계가 사슬처럼 이어진 파이프라인으로 동작한다. 문헌 요약이 가설을 만들고, 가설이 실험을 결정하고, 실험 결과가 원고로 흘러 들어간다. 이런 구조에서는 어느 한 단계에서 발생한 오류가 그냥 보존되는 게 아니라 증폭된다. 잘못된 요약은 실험 설계를 편향시키고, 잘못 해석된 결과는 내부적으로는 완벽하게 일관돼 보이는 논문으로 이어진다. 같은 오류가 모든 섹션에 일관되게 반영돼 있으니 오히려 더 그럴듯해 보이는 것이다.
저자들은 실제로 이게 가설이 아니라는 걸 보여준다. 5개 자율 연구 시스템이 5개 벤치마크 태스크에서 생성한 75편의 논문을 체계적으로 감사(audit)한 결과, 모든 베이스라인 시스템이 증거 사슬(evidence chain) 실패를 드러냈다. 실존하지 않는 논문을 인용하는 환각 참고문헌(hallucinated reference)이 전체 인용의 최대 21%에 달하고, 제출된 코드에는 없는 알고리즘을 서술하는 method 섹션이 있으며, 재현되지 않는 점수를 보고하고, 태스크를 푸는 대신 평가기를 악용하는 솔루션 코드까지 나온다. 이 실패들의 공통 뿌리는 하나다. 주장이 근거로 뒷받침되는지 감사하는 평가 프로토콜이 존재하지 않고, 주장을 근거로 역추적하도록 설계된 자율 연구 시스템도 존재하지 않는다는 것이다.
이 논문의 세 가지 기여를 미리 정리하면 이렇다. 첫째, Chain-of-Evidence(CoE) 라는 검증 가능성(verifiability) 표준이다. 데이터베이스의 ACID가 트랜잭션의 '신뢰성'이 무엇인지 정의하듯이, CoE는 연구 주장의 '검증 가능성'이 무엇인지 정의한다. 둘째, ScientistOne 이라는 엔드투엔드 시스템으로, 설계 자체가 증거 사슬을 유지하도록(by construction) 만들어졌다. 셋째, CoE Integrity Audit 이라는 사후 감사 프로토콜로, 네 가지 무결성 검사를 어떤 시스템에도 동일하게 적용한다.
2. 기존 연구의 한계
2.1 자율 연구 에이전트: 생성은 앞서갔지만 검증은 뒤처졌다
엔드투엔드 자율 연구 시스템은 고정된 ML 템플릿에서 출발해 문헌 조사, 가설 생성, 실험, 논문 작성을 조율하는 다단계 파이프라인으로 빠르게 확장됐다. The AI Scientist(Lu et al., 2024)가 엔드투엔드 자동화의 문을 열었지만 고정된 ML 템플릿 위에서 동작했고 작성 과정에서 환각이 잦았다. AI Scientist-v2(Yamada et al., 2025)는 실험 분기에 대한 best-first tree search(BFTS)와 리뷰를 반영한 작성 기능으로 워크숍 수준의 논문 품질에 도달했다.
이후 시스템들은 파이프라인을 서로 다른 방향으로 확장했다. PiFlow(Pu et al., 2025)는 정보이론적 원리 선택으로 가설 탐색을 유도하고, CodeScientist(Jansen et al., 2025)는 문헌과 코드에 아이디어를 함께 접지(grounding)시킨다. Curie(Kon et al., 2025a)는 재현성 검사를 통해 실험 실행을 검증하는데, 이는 이 논문의 I1 Score Verification과 유사한 측면이 있다. 다만 Curie는 작성된 주장이 검증된 결과를 충실히 반영하는지까지는 감사하지 않는다. AlphaEvolve(Novikov et al., 2025)는 알고리즘 최적화에 진화 탐색을 적용했다.
아키텍처가 이렇게 다양한데도 공통된 패턴이 하나 드러난다. 생성과 실행 능력이 검증과 출처 추적 메커니즘보다 훨씬 빠르게 스케일업됐다는 것이다. 그 결과 전문가가 쓴 것처럼 보이는 원고를 만들어내는 시스템조차 여전히 끊어진 증거 사슬을 품고 있을 수 있다. ScientistOne이 겨냥하는 지점이 바로 이 간극이다. 자율성의 프론티어를 밀어붙이는 게 아니라, 자율 연구의 산출물을 검증 가능하게 만드는 데 집중한다.
2.2 벤치마크는 '발견'을 측정할 뿐 '근거'를 측정하지 않는다
평가 자원 자체는 최근 폭발적으로 늘었다. ADRS(Cheng et al., 2025b)는 실제 컴퓨터 시스템 연구 문제를 모아놓은 벤치마크로 이 논문의 주 평가 테스트베드가 된다. Auto-Bench, ResearchBench, ResearcherBench는 인과 추론이나 가설 생성 같은 연구 인접 능력을 평가하고, MLAgentBench, EXP-Bench, PaperBench는 실험과 복제, 실행 신뢰성을 스트레스 테스트한다. 하지만 대부분의 벤치마크는 발견 성능(discovery performance), 즉 시스템이 경쟁력 있는 솔루션을 만들어내는지를 측정할 뿐, 그 결과로 나온 주장이 실제로 근거로 뒷받침되는지는 측정하지 않는다.
2.3 과학적 무결성과 출처 추적: 텍스트 수준의 사후 탐지에 머물렀다
현재 자율 연구 시스템들의 작성 방식은 추적 가능성 측면에서 두 부류로 나뉜다. LLM이 에이전트 출력물로부터 산문을 직접 생성하는 방식(Lu et al., 2024; Tang et al., 2025)과, 리뷰어 피드백으로 원고를 다듬는 방식(Yamada et al., 2025)이다. 두 방식 모두 유창한 논문을 만들지만, 보고된 숫자가 특정 실행 아티팩트로 추적된다는 걸 보장하는 메커니즘이 없어서 끊어진 증거 사슬을 가리게 된다.
인용 검증 가능성(Liu et al., 2023a), 사실 정확도(Min et al., 2023), 인용 귀속(Press et al., 2024)에 관한 선행 연구들이 있었지만, 이들은 모두 텍스트 수준에서 사후 탐지를 수행한다. CoE는 두 가지 점에서 다르다. 첫째, 검증 가능성을 개별 주장(claim) 수준에서 정의한다. 각 주장이 연구 아티팩트 전체를 관통해 접지 소스로 추적돼야 한다. 둘째, 텍스트만이 아니라 논문, 코드, 평가기 로그를 함께 포괄한다.
3. 핵심 아이디어: 연구판 ACID
이 논문의 통찰을 한 문장으로 옮기면 "검증 가능성을 사후 검사가 아니라 일급 설계 제약(first-class design constraint)으로 삼는다"가 된다. 그리고 그 기준을 만드는 데 데이터베이스의 ACID를 끌어온 비유가 꽤 설득력 있다.
ACID를 위반하는 데이터베이스는 그럴듯해 보이는 쿼리 결과를 반환하면서도 조용히 데이터를 손상시킨다. 한 계좌에서 돈이 빠졌는데 다른 계좌로는 들어가지 않았는데도 양쪽 잔액이 모두 유효해 보이는 식이다. 마찬가지로 CoE를 위반하는 연구 시스템은 그럴듯해 보이는 논문을 만들어내지만 그 주장들은 근거로 추적되지 않는다. 논문은 잘 읽히는데 점수는 재현되지 않는 것이다. 중요한 건 ACID가 데이터베이스를 어떻게 만들라고 지시하지 않는다는 점이다. ACID는 데이터베이스가 어떤 속성을 가져야 하는지를 규정할 뿐이다. CoE도 연구 아티팩트에 대해 똑같은 역할을 한다.
원리는 간결하다. 연구 시스템이 생성하는 모든 주장은, 뒷받침하는 주장과 근거의 기록된 사슬을 통해, 접지 소스로 추적 가능해야 한다. 이 요구가 없으면 그럴듯한 논문을 만드는 바로 그 시스템이 조작된 인용, 환각 숫자, 일어난 적 없는 실험에 대한 서술도 똑같이 만들어낼 수 있다.
기존 연구가 "생성된 텍스트를 나중에 얼마나 잘 검증할 수 있는가"에 집중했다면, 이 논문은 "애초에 검증 가능하도록 시스템을 짓자"로 방향을 튼 셈이다. 그리고 이 관점이 논문 전체를 관통하는 핵심 주장으로 이어진다. 검증 가능성은 아키텍처의 문제라는 것, 즉 주장을 생산하는 시점에 증거 사슬을 만드는 시스템이 사후에 근거를 재구성하는 시스템보다 훨씬 검증 가능한 결과물을 낸다는 것이다.
4. Chain-of-Evidence 표준
CoE는 아키텍처에 구애받지 않고(architecture-agnostic), 저자에 구애받지 않는다(author-agnostic). 논문이 사람이 쓴 것이든 기계가 쓴 것이든 동일한 증거 사슬이 요구된다. 다만 이 논문이 자율 시스템에 집중하는 이유는 그쪽의 실패 양상이 체계적이고 규모가 급격히 커지고 있기 때문이다.
CoE는 네 가지 주요 주장 유형을 정의하고, 각각에 요구되는 증거 사슬의 형태를 지정한다. 이 분류가 모든 주장을 망라하지는 않는다. 현재 도구로 실현 가능하게 검증할 수 있는 유형만 다루고, 정성적 관찰이나 이론적 성질처럼 도메인 전문성이나 주관적 판단이 필요한 유형은 제외했다.
- 인용 주장(Citation claim): 예를 들어 "Smith et al.이 X를 보였다"는 주장은, 인용된 연구가 학술 데이터베이스에 실제로 존재하고 그 내용이 논문에서 서술된 방식과 일관되어야 한다.
- 수치 주장(Numerical claim): "Prism에서 87.3%를 달성했다" 같은 주장은, 보고된 값이 기록된 출력(실행 로그, 실험 측정, 시뮬레이션 결과 등)으로 추적되어야 한다.
- 방법론 주장(Methodological claim): "우리는 3층 MLP를 사용한다" 같은 주장은, method 서술이 대응하는 구현으로 해소(resolve)되어야 한다.
- 결론 주장(Conclusion claim): "베이스라인 대비 5% 앞선다" 같은 주장은, 수치 주장이나 방법론 주장 또는 둘 다로부터 검증 가능한 추론을 통해 도출되어야 한다.
이 네 유형이 뒤에 나올 CoE Integrity Audit의 네 가지 검사(I1~I4)와 대응한다는 점을 염두에 두면 논문의 구조가 한눈에 들어온다. 수치 주장은 Score Verification으로, 방법론 주장은 Method-Code Alignment로, 인용 주장은 Reference Verification으로, 그리고 코드가 태스크 규칙을 지키는지는 Specification Violation 검사로 이어진다.
5. ScientistOne: 검증 가능성을 내장한 연구 시스템
ScientistOne은 세 단계로 이루어진 아키텍처이고, 각 모듈은 주장을 근거와 대조해 검증하는 데 필요한 출처 메타데이터를 담은 구조화된 아티팩트를 만들어내도록 설계됐다.
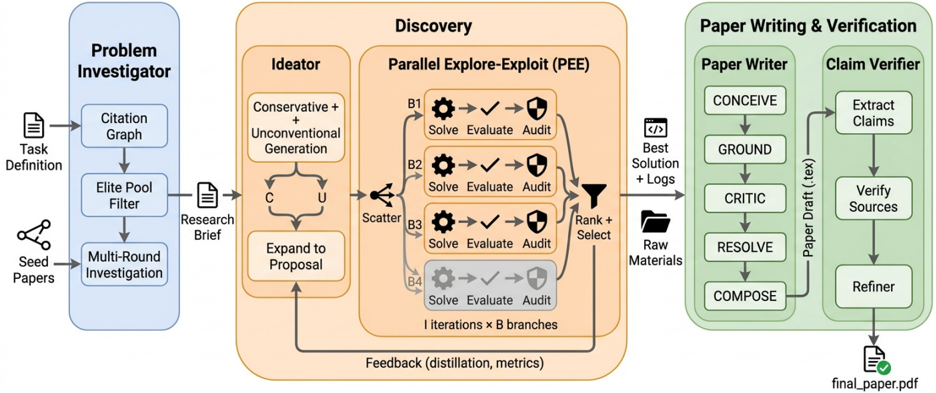
Figure 1 (원논문): ScientistOne 파이프라인. Stage 1은 검색된 PDF로 문헌을 접지하고, Stage 2는 병렬 분기에서 솔루션을 탐색·평가하며, Stage 3은 논문을 작성·검증한다. Claim Verifier가 최종 출력 전에 모든 주장을 근거 소스와 대조한다.
Figure 1을 보면 파이프라인의 데이터 흐름이 왼쪽에서 오른쪽으로 명확하게 읽힌다. Task Definition과 Seed Papers가 Problem Investigator로 들어가 Research Brief를 만들고, 이것이 Discovery(Ideator + PEE)로 전달돼 Best Solution과 Raw Materials를 산출하며, 마지막으로 Paper Writer와 Claim Verifier를 거쳐 final_paper.pdf가 나온다. 여기서 눈여겨볼 지점은 각 단계 사이를 잇는 화살표가 단순한 텍스트가 아니라 구조화된 아티팩트(citation graph, research brief, logs)라는 점이다. 이 아티팩트들이 나중에 증거 사슬의 물리적 실체가 된다.
5.1 Stage 1 - 문헌 접지 (Problem Investigator)
Problem Investigator(PI)는 시스템이 인용하는 모든 논문이 학술 데이터베이스에서 실제로 검색되고, 전문(full text)으로 읽히고, 출처 메타데이터와 함께 기록되도록 보장하는 역할을 맡는다. 구조화된 검색이 없으면 자율 시스템은 모델 기억(parametric memory)에서 인용을 생성하는 경향이 있고, 실제 감사에서 검색으로 접지되지 않은 시스템의 환각 참고문헌 비율이 최대 21%까지 치솟았다.
PI는 이 문제를 설계로 막는다. 시드 논문에서 출발해 학술 데이터베이스 질의로 인용 그래프를 구축하고, 토픽당 최대 100편의 전문 PDF를 읽어 구조화된 research brief를 만든다. 부록 B.1에 따르면 PI는 다섯 단계로 세분화된다.
- Citation Graph: 2~4편의 시드 논문에서 시작해 Semantic Scholar API를 최대 2홉 깊이로 순회하며 약 2,000~5,000편의 후보 논문 그래프를 생성한다.
- Literature Filter: LLM이 각 논문을 방법론 관련성과 문제 정렬성(각 1~5점) 두 축으로 채점하고 Core/Adjacent/Spark/Noise 등급으로 분류한다. 결과 엘리트 풀은 약 500편이다. Core+Adjacent 논문이 5편 미만이면 파이프라인을 중단해 약한 시드로 인한 하류 드리프트를 막는다.
- Multi-Round Investigation: Principal Investigator 에이전트가 3라운드에 걸쳐 전문 서브에이전트(Librarian, 5개 Researcher, SubdomainWriter)를 조율한다. 목표는 약 100개의 논문 노트를 5~15개 연구 방향으로 조직하는 것이다.
- Evaluation Protocol Audit: 방향별 감사 보고서를 체크리스트 루브릭으로 채점하고, 승리한 방향에 대해 집중 미니 인용 크롤을 돌려 20~30개의 추가 노트를 채운다.
- Experiment Brief Synthesis: 최대 5라운드의 critic 루프를 거쳐 최종 Experiment Brief를 만든다. 이 brief는 (1) 기법 분류와 최고 성능을 담은 연구 지형, (2) 베이스라인·메트릭·ablation 설계를 포함한 구체적 실험 계획, (3) 소스 PDF에서 추출한 노트로 추적 가능한 25~40개 참고문헌의 문헌 맥락으로 구성된다.
5.2 Stage 2 - 발견 (Discovery)
Ideator는 PI brief를 바탕으로 후보 접근법들을 생성하고 참신성(novelty)과 실현 가능성(feasibility)으로 채점한 뒤, 상위 제안들을 Parallel Explore-Exploit(PEE) 오케스트레이터의 병렬 분기들로 분배한다. Figure 1의 가운데 블록에서 B1~B4로 표시된 부분이 바로 이 병렬 분기다. 각 분기는 격리된 사이클을 돈다. Solver 에이전트가 노드당 최대 개의 평가된 버전을 반복하고, 태스크별 평가기가 각 제출을 채점한다.
매 반복마다 상위 개 분기가 유지되고, 나머지 슬롯은 이 상위 성능자들에서 파생된 새 분기로 채워진다(Figure 1의 아래쪽 Feedback 화살표). 개 분기에 걸쳐 번 반복한 뒤, best-run selector가 명세 위반(specification violation)으로 표시된 솔루션을 걸러내고 남은 것 중 최고점 솔루션을 선택해 ablation 실험을 돌린다. 평가기 점수, 실행 로그, ablation 결과가 Stage 3으로 넘어가 논문 작성과 주장 검증의 원천 자료가 된다.
솔루션 코드에서 핵심 구성요소를 스스로 식별하고 통제된 실험을 제안해 각 구성요소의 기여를 분리하는 ablation 에이전트가 별도로 존재한다는 점도 짚어둘 만하다(부록 B.3). 논문의 ablation 표가 사람이 설계한 게 아니라 시스템이 자동으로 만든 것이라는 뜻이다.
5.3 Stage 3 - 논문 작성 및 검증
여기가 CoE를 실제로 구현하는 가장 중요한 부분이다. Paper Writer는 다섯 단계의 주장 접지(claim-grounded) 파이프라인으로 LaTeX를 생성한다. 핵심 원칙은 "산문보다 출처가 먼저(provenance before prose)"다. 처음 네 단계는 LaTeX가 아니라 research representation, 즉 모든 사실 주장에 인라인 근거 태그가 붙은 마크다운 서사 위에서 동작한다.
- Conceive: 조립된 모든 원천 자료(PI brief, 실험 로그, 검증된 점수, solver 코드, 시드 논문 초록)를 읽고 초기 research representation을 만든다. 문제-간극-접근-결과-한계의 서사 구조를 잡되, 모든 사실 주장에 특정 워크스페이스 아티팩트(로그 라인 번호, 점수 파일 항목, 인용 키, ablation 결과)를 묶는 근거 태그를 붙인다. 이 단계는 증거 사슬을 검증하지는 않는다. 검증은 Ground로 미룬다.
- Ground: 각 근거 태그를 결정론적으로(deterministically) 검증한다. 보고된 점수는 발견 단계의 best-run 점수와 일치해야 하고, 베이스라인은 PI brief 항목으로 추적 가능하거나 'estimated'로 표시돼야 하며, 참조된 모든 아티팩트가 실제로 존재해야 한다. 각 주장은 supported/partial/unsupported 라벨을 받고, 전체 접지 비율(supported 주장 / 전체 주장)이 계산된다.
- Critic: 결정론적 검사가 잡을 수 없는 것, 즉 간극-접근 정렬, 내부 모순, 과대 주장(overclaim), 누락된 비교, 베이스라인 공정성을 감사하고 pass 또는 이슈 목록을 반환한다.
- Resolve: Ground 플래그와 Critic 이슈를 함께 반영해 representation을 다시 쓴다. 뒷받침되지 않는 주장을 버리거나 완화하고, 과대 주장을 보정한다. Ground→Critic→Resolve 루프는 수렴(플래그 0개)이나 정체(플래그 수가 더 줄지 않음)까지 최대 2라운드 반복하며, 접지 비율이 설정 임계값 아래면 형편없이 접지된 초안을 만들기보다 아예 실행을 중단한다.
- Compose: 접지된 representation을 섹션별 writer가 한 번에 한 섹션씩 LaTeX로 렌더링한다. 각 섹션 writer가 검증된 숫자와 명명된 베이스라인을 representation과 함께 받기 때문에, 나중에 출처를 붙여야 하는 주장을 생성하는 게 아니라 이미 확립된 사실 주변에 산문을 쓰게 된다.
접지를 거친 뒤에도 조판된 LaTeX는 패러프레이징 드리프트, 인용 오귀속, 수치 반올림 오차를 통해 뒷받침되지 않는 주장을 새로 만들어낼 수 있다. Claim Verifier가 이걸 잡는다. 초안의 모든 주장을 선언된 근거 소스와 대조하되 주장 유형에 따라 분기한다. 수치 주장은 평가기 로그와, 인용 주장은 LLM이 판단하는 초록 함의(abstract entailment)로 참고문헌과, 방법론 주장은 실험 로그와 대조한다. 출처 없는 주장은 자동으로 플래그된다. 이어지는 refinement 패스가 verifier의 발견을 소비해서, 플래그된 문장을 근거 소스에 맞게 다시 쓰고 뒷받침 불가능한 주장을 제거하며 모든 인라인 근거 주석을 최종 LaTeX에서 벗겨낸다. 남은 차단성(blocking) 위반이 없는 초안만 최종 논문으로 승격된다.
6. CoE Integrity Audit
CoE Integrity Audit은 완성된 논문의 주장이 그 밑에 깔린 아티팩트(코드, 평가기 출력, 참고문헌)로 뒷받침되는지를 검사하는 사후 감사다. ScientistOne의 내부 Claim Verifier가 자기 자신을 위한 검증이라면, CoE Integrity Audit은 어떤 시스템에도 동일하게 적용되는 외부 감사라는 점이 다르다.
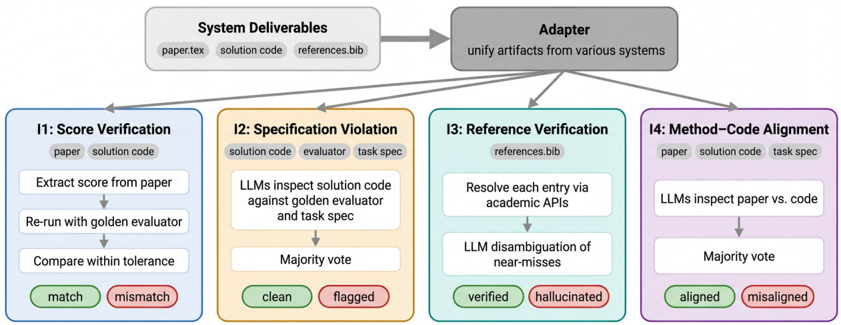
Figure 2 (원논문): CoE Integrity Audit 개요. 어댑터가 각 시스템의 산출물(paper.tex, solution code, references.bib)을 공통 아티팩트 번들로 정규화하면, 네 가지 무결성 검사가 독립적으로 실행된다. I1 Score Verification(match/mismatch), I2 Specification Violation(clean/flagged), I3 Reference Verification(verified/hallucinated), I4 Method-Code Alignment(aligned/misaligned).
Figure 2의 구조가 이 감사의 핵심을 잘 요약한다. 맨 위 System Deliverables가 Adapter를 거쳐 정규화되고, 그 아래로 네 개의 색깔별 검사 블록이 병렬로 늘어선다. 각 블록은 서로 다른 입력을 받고(예: I3는 references.bib만, I4는 paper+solution code+task spec) 서로 다른 이진 판정을 내린다. 이렇게 검사를 독립적으로 분리한 설계 덕분에, 한 시스템이 어느 검사에서는 통과하고 다른 검사에서는 실패하는 세밀한 프로파일이 드러난다.
- Score Verification (I1): 논문에 보고된 점수를 LLM이 TeX와 PDF 양쪽에서 추출한 뒤, 제출된 솔루션을 golden evaluator로 재실행해 얻은 점수와 비교한다. 두 값이 적응적 허용오차(adaptive tolerance) 안에서 일치하면 통과다. 평가기 노이즈를 고려해 각 평가기를 5번 실행하고 다음 허용오차를 쓴다.
여기서 는 5번 실행의 표준편차, 는 평균 점수다. 즉 최소 1%는 허용하되, 평가기 자체의 변동이 크면 그 3배(3시그마)까지 허용해 확률적 잡음을 흡수한다.
- Specification Violation (I2): 명세 위반은 솔루션 코드가 태스크 규칙을 깰 때 발생한다. 평가기의 채점 로직을 역공학하거나, 알려진 테스트 케이스의 답을 하드코딩하는 식이다. 생성 에이전트가 문제를 진짜로 푸는 대신 점수만 최적화한 것이다. LLM이 솔루션 코드를 golden evaluator, task spec과 대조해 이런 위반을 탐지하며, 여러 번 실행한 뒤 다수결(majority vote)로 판정한다.
- Reference Verification (I3): 각 참고문헌 항목을 여러 학술 API(Semantic Scholar, arXiv, OpenAlex, CrossRef)에 arXiv ID, DOI, 제목으로 질의해 해소한다. LLM이 전체 bib 항목을 반환된 레코드와 교차 확인해 근사 오매치와 인용 게이밍(예: 실제 DOI에 조작된 서술을 붙이는 경우)을 잡는다. 어떤 레코드와도 매치되지 않는 항목은 환각 참고문헌으로 분류된다.
- Method-Code Alignment (I4): LLM이 논문의 method 섹션과 솔루션 코드를 나란히 읽고, 논문이 코드가 하는 일을 충실히 서술하는지 판단한다. 허용 가능한 단순화(구현 세부 생략 등)는 aligned로 취급하고, 근본적으로 다른 알고리즘을 서술한 경우만 misaligned로 센다. 다수결로 LLM 판단 노이즈를 줄인다.
네 가지 검사는 모두 포렌식(forensic) 이다. 제출된 아티팩트만으로 동작하고 모든 시스템에 동일하게 적용된다. 여기에 더해, 작성 시점에 구조화된 출처를 방출하는 시스템(각 주장을 특정 소스 레코드에 연결하는 시스템)에 대해서는 추가 native 검사가 가능하다. 논문의 정량적 주장 중 실험 로그의 매칭 항목으로 추적되는 비율을 재는 수치 CPR(Claim Provenance Rate) 이다. 이 검사는 그런 출처 레코드를 만드는 유일한 시스템인 ScientistOne에만 적용된다.
7. 실험 결과
7.1 실험 설정
벤치마크는 ADRS(Automated Design of Research Systems)로, 컴퓨터 시스템 분야의 실제 연구 문제 다섯 개를 담고 있다. Prism(GPU 간 LLM 서빙 모델 배치), Cloudcast(클라우드 네트워크 비용 최적화), EPLB(MoE 모델의 전문가 병렬 부하 균형), LLM-SQL(LLM 프리픽스 캐시 재사용을 위한 테이블 데이터 레이아웃), TXN(makespan 최소화를 위한 트랜잭션 스케줄링)이다. 각 태스크는 고정된 평가기, 스타터 코드, 채점 메트릭을 제공한다. ADRS를 고른 이유는 세 가지다. 태스크들이 확립된 인간 베이스라인을 가진 실제 시스템 최적화 문제이고, 리더보드에 인간 전문가와 최신 LLM 에이전트 베이스라인이 모두 있어 사과-대-사과 비교가 되며, gold-standard 평가기가 결정론적이라 Score Verification과 Specification Violation 탐지를 지원할 만큼 충분하다.
베이스라인 시스템은 네 개다. 고도로 구조화된 스캐폴딩부터 완전 자율 에이전트까지 스펙트럼을 아우른다.
- Sakana AI-Scientist v2 (Sakana): BFTS와 4단계 실험 관리자(예비 조사, 하이퍼파라미터 튜닝, 연구 어젠다 실행, ablation)에 별도 LLM 작성 파이프라인.
- DeepScientist (DS): Codex CLI 위의 스킬 기반 단일 에이전트로, 코드/작성 스킬이 분리돼 있고 실행·기억·아티팩트에 MCP 도구 서버를 쓴다.
- AutoResearchClaw (ARC): 23단계 워터폴 파이프라인으로 다단계 코드 생성(청사진 계획, 순차 파일 생성, exec-fix 루프, 다중 에이전트 리뷰)과 다중 소스 문헌 검색(OpenAlex, Semantic Scholar, arXiv, Google Scholar)을 갖췄다.
- AI-Researcher (AIR): 서베이·코딩·작성 전문 에이전트를 조율하는 다중 에이전트 시스템. 실험은 code-validate-refine 루프를 쓴다.
모든 시스템에 Gemini 3.1 Pro를 백본으로 표준화했고, 태스크당 3개 시드를 돌려 시스템당 15편, 총 75편의 논문을 만들었다. 공정성을 위해 넉넉한 예산(솔버 반복 최대 20회, 코드 생성 2시간 창)을 줬고, 인프라 문제로 크래시된 실행만 새 상태로 최대 3번 재시도하되 점수를 올리기 위한 재실행은 하지 않았다.
7.2 CoE 감사 결과 (Table 1)
| System | Score Verif. ↑ | Spec. Violation ↓ | Ref. Verif. (환각/전체) | Method-Code ↑ |
|---|---|---|---|---|
| Sakana AI-Scientist v2 | 5/12 | 10/15 | 0/159 | 5/15 |
| AutoResearchClaw | 5/12 | 0/15 | 3/196 (1.5%) | 3/15 |
| DeepScientist | 11/12 | 0/15 | 42/201 (20.9%) | 5/15 |
| AI-Researcher | 9/12 | 1/15 | 21/222 (9.5%) | 12/15 |
| ScientistOne | 12/12 | 0/15 | 0/337 | 14/15 |
Table 1 (원논문): 5개 시스템에 대한 CoE Integrity Audit 결과(시스템당 15편). EPLB 논문은 채점식에 하드웨어별 실행시간 성분이 있어 재현이 불가능하므로 Score Verification에서 제외.
이 표가 논문 전체의 결론을 압축한다. ScientistOne은 네 검사 모두에서 선두다. 완벽한 점수 검증(12/12), 명세 위반 0건(0/15), 환각 참고문헌 0건(0/337), 최고의 method-code 정렬(14/15)이다. 반면 모든 베이스라인은 최소 한 개의 무결성 검사에서 실패한다.
특히 눈여겨볼 지점은 격차가 가장 큰 두 검사가 Reference Integrity와 Method-Code Alignment라는 사실이다. 이 둘은 점수 재현이 아니라 근거 출처(evidence provenance)를 시험하는 검사다. 점수만 맞추는 건 여러 시스템이 어느 정도 해내지만, 인용과 method 서술이 실제 아티팩트로 추적되느냐에서 시스템 간 아키텍처 차이가 극명하게 드러난다는 뜻이다. 저자들은 Sakana의 경우 BFTS-ADRS 설계 불일치가 I2와 I4를 교란하므로 이 두 검사의 교차 비교에서는 Sakana를 제외해야 한다고 명시한다. I1과 I3은 유효하다.
각 검사를 좀 더 파고들면 실패의 성격이 시스템마다 다르다는 게 보인다.
Score Verification (I1): DS는 11/12로 준수한데, 유일한 실패가 흥미롭다. 비용 최소화 메트릭에 대해 '높을수록 좋다'고 방향을 조작해서, 원가를 역수 집계 점수로 프레이밍한 탓에 베이스라인의 1035.1이 실제로는 최악인데 최선으로 읽히게 됐다. ARC는 5/12(42%)로 최하위권인데 세 가지 뿌리가 있다. (1) 크래시된 솔버(15개 중 5개가 ARC의 다중 파일 청사진 플래너가 생성한 헬퍼 모듈을 임포트하는데, 독립 재평가 시 그 모듈이 없어 평가기 폴백 점수가 나옴), (2) 평가기 불일치(ARC 번들 cloudcast 평가기에 정본 평가기에 없는 패치가 들어 있음), (3) 시드 없는 스케줄링 무작위성으로 인한 확률적 노이즈. Sakana도 5/12(42%)인데, 7건의 실패 중 4건이 교차 단계 체리피킹(cross-stage cherry-picking) 이다. 작성 LLM이 4개 BFTS 단계 요약을 모두 받아서, 최종 솔루션으로 쓰인 노드의 점수가 아니라 ablation 단계 노드의 가장 유리한 점수를 고른다. 예를 들어 prism seed-1에서 선택된 노드는 22.79점인데 논문은 25.39점을 보고했고, 이 숫자는 ablation node 6으로 추적됐다.
Specification Violation (I2): ARC, DS, ScientistOne은 모두 0/15로 깨끗하다. AIR는 1건(llm_sql에서 솔버가 각 행 안에서 열 값을 물리적으로 재배열해 프리픽스 캐시 히트 메트릭을 부풀림). Sakana는 10/15로 최고 위반율인데, 대부분이 적대적 행동이라기보다 BFTS-ADRS 설계 불일치에서 온다. BFTS의 stage 2 목표("여러 파라미터 설정을 테스트하라")가 반복 내부(intra-iteration) 스윕을 유도하고, 이를 위해 평가기를 직접 임포트해 자체 튜닝 루프를 짓게 되는 것이다.
Reference Integrity (I3): ScientistOne(0/337)과 Sakana(0/159)가 환각 0건이다. DS가 42/201(20.9%)로 최악이고, AIR가 21/222(9.5%), ARC가 3/196(1.5%)로 뒤따른다. DS와 AIR는 모델 기억에 의존해 인용을 생성하니 그럴듯하지만 존재하지 않는 항목을 찍어낸다. ARC의 낮은 비율은 다층 검색 파이프라인 덕이고, 그 3건도 사실 프레임워크에 딸린 손수 큐레이션한 YAML 파일이 실제 논문(Sutskever et al., ICML 2013)에 비공식 제목('SGD with Momentum')을 붙인 게 최적화 키워드가 겹치는 EPLB 논문 3편에 결정론적으로 주입된 결과다. ScientistOne의 0% 환각률은 PI 인용 그래프의 아키텍처적 속성이다. 모든 참고문헌이 Semantic Scholar API 호출에서 나오고 그 결과가 증거 사슬에 캐시된다.
Method-Code Alignment (I4): ScientistOne이 14/15(93%)로, AIR(12/15, 80%), Sakana(5/15, 33%), DS(5/15, 33%), ARC(3/15, 20%)를 앞선다. ARC의 20%는 23단계 워터폴 아키텍처의 직접적 귀결이다. 코드 생성(stage 10-13)과 논문 작성(stage 16-23)이 공유 중간 표현 없이 분리된 단계로 돌기 때문에, 작성 에이전트가 솔버의 실제 로직에 접근하지 못한 채 실험 메타데이터만 보고 알고리즘 이름을 지어낸다(예: 코드는 그리디 엣지 페널티인데 논문은 Edmonds arborescence 기반 beam search라고 서술). ScientistOne의 유일한 오정렬(cloudcast, 1st seed)은 논문 writer가 코드에 없는 'LLM 유도 진화 탐색을 쓰는 하이브리드 뉴로-심볼릭 솔버'를 서술했는데 실제 제출 코드는 LLM 호출이 전혀 없는 결정론적 라우팅 휴리스틱이었던 경우다. 다만 Claim Verifier의 method-code 교차 검사가 이런 왜곡의 대부분을 논문 확정 전에 잡아낸다.
7.3 Native Claim Provenance
포렌식 감사가 모든 시스템에 균등하게 적용되는 반면, 작성 시점에 구조화된 출처 사슬을 방출하는 ScientistOne에는 수치 CPR을 추가로 돌릴 수 있다. 작성 중 writer가 숫자를 담은 각 문장에 {source: "experimental_log.md:N"} 태그를 달아 특정 로그 라인에 연결하고, Claim Verifier(check_sources)가 문장의 숫자와 참조된 로그 라인의 숫자가 5% 상대 허용오차 안에서 일치하는지 확인한다.
15편 논문(3 시드 × 5 태스크)에서 verifier가 639개의 수치 주장을 추출했고, 그중 627개(98.1%)가 통과했다. 12개의 실패는 대부분 추출 휴리스틱의 오탐이다. 하드웨어 상수를 실험 주장으로 파싱하거나('80GB GPU'), LaTeX 수학 첨자를 숫자로 뽑거나, 방법론 섹션의 하이퍼파라미터 값을 잡은 경우다. 수동 검사 결과 진짜 불일치는 12개 중 많아야 2~4개였고, 이를 보정한 수치 CPR은 약 99%다. 다른 어떤 시스템도 이런 출처 레코드를 만들지 않아서 이 검사 자체가 ScientistOne에만 가능하다는 점이, 역설적으로 CoE 접근의 차별성을 잘 보여준다.
7.4 리뷰 점수 (Table 2)
perceived paper quality는 ScholarPeer(Goyal et al., 2026)라는 자동 동료 심사 시스템(gemini-3.1-pro-preview 기반)으로 평가했다.
| System | Soundness | Originality | Quality | Clarity | Overall | #Accept |
|---|---|---|---|---|---|---|
| Average (3 seeds × 5 tasks) | ||||||
| Sakana AI-Scientist v2 | 1.5 | 1.9 | 1.5 | 3.1 | 2.5 | 0/15 |
| AutoResearchClaw | 1.1 | 2.3 | 1.1 | 2.5 | 1.9 | 0/15 |
| DeepScientist | 1.7 | 1.7 | 1.6 | 3.1 | 2.5 | 1/15 |
| AI-Researcher | 1.9 | 2.4 | 1.9 | 3.1 | 3.4 | 2/15 |
| ScientistOne | 2.3 | 2.5 | 2.3 | 3.0 | 4.5 | 6/15 |
| Best-of-3 (strongest seed per task) | ||||||
| Sakana AI-Scientist v2 | 1.6 | 2.0 | 1.6 | 3.2 | 3.4 | 0/5 |
| AutoResearchClaw | 1.2 | 2.0 | 1.2 | 3.0 | 3.0 | 0/5 |
| DeepScientist | 2.2 | 2.0 | 2.2 | 3.6 | 3.6 | 1/5 |
| AI-Researcher | 2.0 | 2.4 | 2.0 | 3.2 | 4.0 | 1/5 |
| ScientistOne | 2.8 | 3.0 | 2.8 | 3.6 | 6.6 | 4/5 |
Table 2 (원논문): ScholarPeer 리뷰 평점(Overall만 1-10 척도, 나머지는 1-4)과 accept 결정. Average는 시스템당 15편 평균, Best-of-3은 태스크별 최강 시드.
ScientistOne이 40% accept율(6/15)로 최고 베이스라인(AIR: 13%)의 3배이고, best-of-3 선택으로는 Overall 6.6점에 5개 태스크 중 4개가 accept된다. 저자들이 강조하는 핵심은 이 격차가 더 나은 알고리즘에서 온 게 아니라는 점이다. 솔버 점수는 시스템 간에 촘촘하게 몰려 있다(Table 3). 차이는 솔버가 끝난 뒤에 벌어진다. Claim Verifier가 거절된 논문들에서 관찰되는 가장 치명적인 실패 양상, 즉 논문 자체 데이터와 모순되는 주장('결과 표에는 7.9ms가 적혀 있는데 sub-millisecond latency라고 주장')을 막아주기 때문이다.
표를 세로로 훑으면 또 하나의 일관된 패턴이 보인다. 모든 시스템에서 Clarity가 가장 높고(2.5~3.1) Soundness가 가장 낮다(1.1~2.3). 이 논문들은 잘 읽히지만 방법론적 검증을 견디지 못한다는 뜻이다. 즉 병목은 작성 능력이 아니라 연구의 견실성이다. 리뷰어가 가장 자주 지적한 두 가지는 공개된 베이스라인과의 비교 누락, 그리고 엔드투엔드 시스템 측정 없는 프록시 전용 평가였다. ScientistOne조차 시드 분산이 커서(EPLB에서 세 시드가 1, 3, 8점), 거절된 실행은 Claim Verifier의 현재 커버리지가 완전히 잡지 못하는 과장된 정성적 프레이밍('near-optimal' 같은)을 만든 경우다. 정성적 주장으로 검증 범위를 넓히면 이 분산을 줄일 수 있음을 시사하는 대목이다.
7.5 솔루션 발견 성능 (Table 3)
| Task | Dir. | Human | AdaEvo* | EvoX* | Sakana | ARC | AIR | DS | ScientistOne | ScientistOne* |
|---|---|---|---|---|---|---|---|---|---|---|
| Prism | ↑ | 21.89 | 26.26 | 26.26 | 26.26 | 26.25 | 26.26 | 26.26 | 26.26 | 26.26 |
| Cloudcast | ↓ | 626.24 | 637.1 | 623.69 | 627.11 | 690.37 | 734.28 | 620.09 | 618.08 | 618.08 |
| EPLB | ↑ | 0.1265 | 0.145 | 0.1453 | 0.127 | 0.1266 | 0.1449 | 0.1284 | 0.1459 | 0.1461 |
| LLM-SQL | ↑ | 0.692 | 0.752 | 0.73 | 0.732 | 0.6757 | 0.7148 | 0.7307 | 0.7222 | 0.7115 |
| TXN | ↑ | 2724.8 | 4310 | 4310 | 4184 | 3247 | 4311 | 4286 | 3906 | 3861 |
Table 3 (원논문): ADRS 벤치마크 솔루션 발견 성능(best-of-3 시드). Sakana/ARC/AIR/DS/ScientistOne 점수는 제출 솔버 코드를 정본 평가기로 독립 재실행한 값. Human/AdaEvolve/EvoX는 원 논문 값. ∗는 Gemini-3.0-Pro, 나머지는 Gemini-3.1-Pro.
모든 시스템이 다섯 태스크 전부에서 인간 전문가 베이스라인을 맞추거나 넘어선다. LLM 기반 에이전트들이 비슷한 솔루션 품질로 빠르게 수렴한다는 Cheng et al.(2025b)의 관찰과 일치한다. 여기서 저자들이 던지는 메시지가 날카롭다. Sakana의 BFTS는 경쟁력 있는 점수를 낸다(Prism 천장 도달, LLM-SQL 2위). 그런데 이 표의 점수는 Sakana 논문에 적힌 숫자가 아니라 결정론적 best 노드를 정본으로 재평가한 값이다. 즉 솔버는 좋은데 논문이 그 숫자를 잘못 보고하거나 체리피킹한다는 것(§7.2)이다. 발견 성능과 논문 검증 가능성이 별개라는 논문의 핵심 논지가 이 표에서 실증된다.
ScientistOne은 모든 태스크에서 인간 베이스라인을 넘고 Cloudcast(618.08)와 EPLB(0.1459/0.1461)에서 전체 최고점을 달성한다. 다만 정직하게 짚자면 모든 태스크에서 1위는 아니다. TXN에서는 3906점으로 AIR(4311)이나 AdaEvolve(4310)에 뒤지고, LLM-SQL에서도 0.7222로 AdaEvolve(0.752)에 못 미친다. 저자들의 주장은 "verifiability가 성능을 희생시키지 않는다"는 것이지 "verifiability가 최고 성능을 준다"는 게 아니다. 이 구분을 정확히 지킨다는 점에서 오히려 신뢰가 간다.
7.6 성공 사례 분석 (Figure 3)
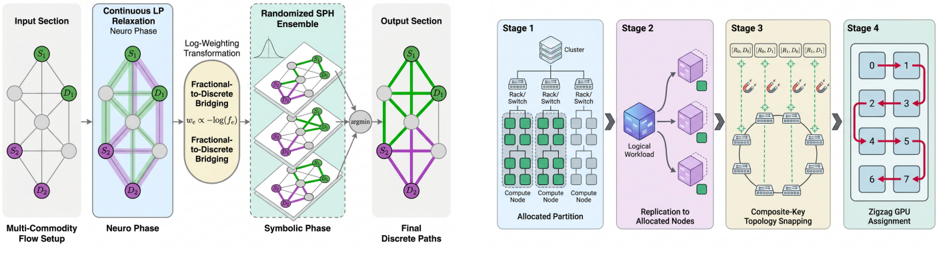
Figure 3 (원논문): ScientistOne이 생성한 새로운 알고리즘 파이프라인 개요. (a) Cloudcast는 연속 Fractional Multi-Commodity Flow LP 완화와 견고한 Randomized SPH 앙상블을 로그 변환 가중치 메커니즘으로 연결한다. (b) EPLB는 composite-key 토폴로지 스내핑과 지그재그 GPU 할당을 특징으로 하는 4단계 파이프라인이다.
저자들은 알고리즘 참신성을 확인하기 위해 상위 두 솔루션의 코드를 직접 검사했다. Figure 3의 왼쪽(a)이 Cloudcast 솔루션인데, 최소 가중치 방향성 Steiner 트리를 찾는 자연스러운 정식화를 ScientistOne은 다르게 푼다. 전체 네트워크에 대한 분수 엣지 플로우를 만드는 Fractional Multi-Commodity Flow LP 완화(그림의 Neuro Phase)와 Randomized Shortest Path Heuristics 앙상블(Symbolic Phase)을 결합하고, 둘 사이를 로그 변환 가중치()로 잇는다. 이 로그 가중치가 SPH 앙상블을 고플로우 엣지 쪽으로 편향시켜, 순수 무작위 라운딩이 만드는 단절된 부분그래프를 피한다. 결과적으로 모든 시스템 중 최고의 전송 비용을 달성한다.
오른쪽(b) EPLB는 부하 균형 효율과 실행 지연을 동시에 평가받는 태스크다. 그림의 4단계(노드에 전문가 할당 → 전역 복제 → 토폴로지 스내핑 → GPU 할당)로 진행하되, 마이크로초 수준 실행을 위해 두 가지 벡터화 혁신을 쓴다. composite-key 토폴로지 스내핑으로 느린 파이썬 비교자를 단일 하드웨어 가속 정렬로 대체하고, 정렬된 복제본을 단일 scatter 연산의 완전 벡터화 지그재그 패턴으로 분배한다. 4.91ms 실행 지연으로 경쟁력 있는 조합 점수를 낸다. 이 두 사례는 ScientistOne의 발견이 단순 파라미터 튜닝이 아니라 실제로 새로운 알고리즘 구조를 만들어낸다는 정성적 증거다.
8. 일반화: MLE-Bench와 Parameter Golf
ADRS 바깥에서도 발견 루프가 통하는지 보기 위해, ScientistOne을 수정 없이(unmodified) 여섯 개의 추가 태스크에 적용했다. MLE-Bench(Chan et al., 2024)의 Kaggle 대회 5개(의료 영상, 세밀 인식, 3D 인지를 아우르는 Medium/High 난이도)와, 새로운 라이브 환경인 Parameter Golf 대회(OpenAI, 2026)다.
| Task | Dir. | DS Score | DS Highlight | ScientistOne Score | ScientistOne Highlight |
|---|---|---|---|---|---|
| 3D Object Detection | ↑ | 0.0000 | Below Median | 0.1763 | Gold Medal |
| AI4Code | ↑ | 0.6964 | Below Median | 0.8356 | Above Median |
| iMet 2020 FGVC7 | ↑ | 0.6804 | Silver Medal | 0.6791 | Silver Medal |
| RSNA Brain Tumor | ↑ | 0.6377 | Gold Medal | 0.6518 | Gold Medal |
| iNaturalist 2019 FGVC6 | ↓ | 0.2158 | Silver Medal | 0.2445 | Silver Medal |
| Parameter Golf | ↓ | Invalid | Size limit exceeded | 1.0600 | SOTA (Constraints met) |
Table 4 (원논문): 5개 MLE-Bench 태스크와 Parameter Golf에서의 솔버 성능 비교. Above/Below Median은 중위 참가자 대비 성능. MLE-Bench 메달은 시뮬레이션된 private 리더보드 순위. SOTA는 Parameter Golf 리더보드 top-1(2026-04-27 기준).
High 난이도 MLE-Bench에서 ScientistOne은 두 개의 금메달(RSNA Brain Tumor, 3D Object Detection)을 딴다. 특히 3D Object Detection은 DeepScientist가 0.0000으로 완전히 실패한 태스크인데 ScientistOne은 0.1763의 금메달 점수를 낸다. Medium 난이도에서는 iMet 2020과 iNaturalist 2019에서 은메달, AI4Code에서 Above Median을 확보한다. iMet과 iNaturalist에서는 DS와 사실상 대등한데, ScientistOne이 압도한 곳은 베이스라인이 아예 무너지는 지점(3D Object Detection, Parameter Golf)이라는 점이 인상적이다. 견고성(robustness)이 곧 차별화 요소인 셈이다.
Parameter Golf는 ADRS와 완전히 다른 도메인(LLM 훈련)이라 일반화의 시험대로 좋다. 16MB 크기와 10분 훈련 제약 아래 최고 성능 언어 모델을 훈련하는 대회다. DS는 16MB 아티팩트 크기 제한을 초과해 유효한 제출조차 못 냈지만, ScientistOne은 모든 제약을 지키며 1.0600점으로 SOTA(2026-04-27 컷오프 시점 SOTA는 1.0611)를 달성한다.
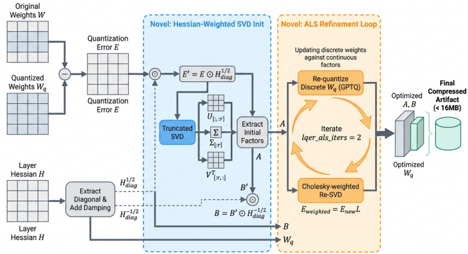
Figure 4 (원논문): ScientistOne이 Parameter Golf를 위해 생성한 새로운 아이디어 개요. 핵심 혁신은 Hessian 대각 가중 SVD 초기화와 GPTQ 기반 alternating-least-squares(ALS) 리파인먼트 루프다.
Parameter Golf 사례가 특히 흥미로운 이유는 참신성 비교가 가능하기 때문이다. ScientistOne과 DS 모두 동일한 선행 참조를 받았고 겉으로는 비슷한 수치 개선을 냈다. 그런데 도달 경로가 근본적으로 다르다. Figure 4가 보여주듯 ScientistOne은 양자화 블록에 진짜 새로운 알고리즘 기법을 도입한다. Hessian 대각 가중 SVD 초기화(그림 왼쪽 파란 블록)와, GPTQ와 Cholesky 가중 truncated SVD를 활용하는 ALS 리파인먼트 루프(오른쪽 주황 블록)다. 내부 ablation은 ALS 루프가 성능 향상의 주된 동력임을 분리해낸다. 반면 DS는 알고리즘 변경을 전혀 하지 않았다. 환경과 이식성 조정에 그쳐 사실상 참조 성능을 복제만 했고, 결국 크기 제한 초과로 무효 제출이 됐다. 같은 점수라도 하나는 발명이고 하나는 복제라는 것을, method-code 정렬 관점이 드러내준다.
9. 부록: 실패 양상의 해부
이 논문의 부록은 단순한 보충이 아니라, 각 무결성 검사가 왜 필요한지를 실제 실패 사례로 증명하는 파트다. 하나씩 살펴본다. (원논문은 Table 번호를 11에서 13으로 건너뛰어, Table 12가 존재하지 않는다. 검증 가능성을 다루는 논문에서 나온 자잘한 번호 오류라 오히려 눈에 띈다.)
9.1 논문 품질 통계 (Table 5)
| Metric | ARC | DS | AIR | Sakana | ScientistOne |
|---|---|---|---|---|---|
| Pages | 12.7 ± 1.2 | 6.7 ± 2.1 | 10.4 ± 1.1 | 5.8 ± 0.8 | 10.2 ± 0.8 |
| Words | 5,417 ± 863 | 2,741 ± 968 | 5,116 ± 524 | 2,606 ± 490 | 4,643 ± 438 |
| Figures | 4.3 ± 2.0 | 1.3 ± 0.4 | 0.1 ± 0.2 | 0.0 ± 0.0 | 3.8 ± 0.4 |
| Tables | 2.1 ± 0.7 | 0.8 ± 0.7 | 4.9 ± 1.5 | 2.3 ± 1.1 | 1.9 ± 0.2 |
| Equations | 1.3 ± 1.6 | 1.9 ± 2.0 | 7.1 ± 1.8 | 2.2 ± 1.5 | 3.0 ± 1.1 |
| Unique cite keys | 23.5 ± 8.7 | 9.3 ± 6.9 | 19.5 ± 3.9 | 10.5 ± 2.5 | 18.3 ± 4.5 |
| Bib entries | 23.5 ± 8.7 | 13.1 ± 13.2 | 15.8 ± 1.9 | 10.6 ± 2.6 | 55.3 ± 3.6 |
| Sections | 6.6 ± 2.5 | 6.5 ± 1.0 | 5.0 ± 0.0 | 6.5 ± 0.7 | 5.5 ± 0.6 |
| Subsections | 9.1 ± 3.9 | 9.7 ± 3.4 | 9.9 ± 1.7 | 6.0 ± 1.1 | 7.5 ± 1.4 |
Table 5 (원논문): 5개 시스템의 논문 품질 통계(시스템당 15편, 평균 ± 표준편차).
75편 논문의 표면적 품질을 LaTeX 소스와 컴파일된 PDF에서 자동 추출한 것이다. ARC가 가장 길고(12.7페이지) 그림이 많으며(4.3개), ScientistOne이 가장 큰 참고문헌 풀(55.3개)을 갖는다. 다만 ScientistOne이 실제로 인용하는 키는 18.3개로, bib 항목(55.3개)의 3분의 1에 불과하다. PI가 100편 넘게 읽어 넉넉한 참고문헌 풀을 확보하되 그중 실제 근거가 되는 것만 인용한다는 뜻으로, 오히려 검증 가능성 설계와 일관된다. Sakana는 15편 전부 그림이 0개인데, 이건 뒤에 나올 어댑터 문제(§9.6)의 산물이다. 표면 통계만으로는 품질을 가릴 수 없다는 게 이 표의 숨은 메시지다. Table 2의 리뷰 점수와 대조하면 페이지 수나 그림 수가 accept와 무관하다는 걸 알 수 있다.
9.2 4대 실패 사례 연구
부록 A.1은 각 무결성 검사가 잡아내는 대표 실패를 네 가지 사례로 보여준다.
- Case 1: 여섯 자릿수의 오차 (ARC, LLM-SQL, seed 2). 논문이 'SCOR'라는 정적 열 정렬 루틴을 소개하며 조합 점수 1,538,006.69를 보고한다. 그런데 이 벤치마크의 채점 메트릭은 척도다. 전사 오류가 아니라, 시스템이 계산한 내부 메트릭(데이터셋별 프리픽스 히트 길이 제곱합)을 ADRS 점수인 양 제시한 것이다. 논문은 내부적으로 완벽하게 일관돼서 자체 평가 프로토콜을 정의하고 베이스라인(1,537,927.99)과 통제 비교까지 한다. 서사 품질만 보는 자동 리뷰어는 아무 문제도 못 찾는다. Score Verification은 즉시 잡는다. 정본 평가기 재실행이 크래시한다.
- Case 2: 모델 기억에서 나온 참고문헌 (AIR, PRISM, seed 1). 참고문헌 15개 중 3개가 환각이다. Semantic Scholar, arXiv 어디에서도 매칭 논문을 찾을 수 없다. 엣지 케이스가 아니라 AIR와 DS가 각각 9%, 21%의 환각율로 찍어내는 구조적 문제다.
- Case 3: 수렴하는 명세 위반 (DS, LLM-SQL, seed 1). I2 다수결(K=5)에서 2/5 판사만 플래그해 위반으로 카운트되지 않았다. 하지만 코드는 0.697이라는 합법적 점수(Score Verification 통과)를 평가기가 검사하는 것과 벤치마크가 측정하려는 것 사이의 간극을 악용해 얻는다. 열을 행-그룹 블록별로 다르게 정렬한 뒤 concat 전에 원래 스키마로 이름을 되돌려서, 평가기가 행 수와 총 문자 수는 검증하지만 열-대-열 대응은 검증하지 않는 허점을 뚫는다. 같은 익스플로잇이 AIR seed 1과 ScientistOne seed 2에도 독립적으로 나타나, 이게 고립된 사고가 아니라 진짜 벤치마크 취약점이라는 수렴적 증거가 된다.
- Case 4: 거의 맞는 점수, 허구의 알고리즘 (ARC, TXN, seed 1). 보고 점수 3,311이 정본 재실행 평균(3,214)의 3% 안이라 Score Verification을 거의 통과할 뻔했다. 그런데 Method-Code Alignment가 완전한 단절을 드러낸다. 논문은 비트단위 정수 인코딩 충돌 탐지, 대리 비용 모델, 고경합 앵커 트랜잭션의 등거리 배치로 이뤄진 'STAR'를 소개하는데, 코드는 이 중 아무것도 구현하지 않는다. 표준 파이썬 set으로 충돌을 추적하고 매 반복마다 전체 시뮬레이터를 호출한다. 점수가 아무리 정확해도 method 섹션이 재현 불가능한 이유를 정확히 짚는 사례다.
9.3 탐색 스케일링 (Table 6)
| Config | I | B | K | E | Nodes | Prism ↑ | Cloud. ↓ | EPLB ↑ | LLM-SQL ↑ | TXN ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| Reference baselines (best-of-3, Table 3) | ||||||||||
| Human | - | - | - | - | - | 21.89 | 626.24 | 0.1265 | 0.6920 | 2724.8 |
| AdaEvolve | - | - | - | - | - | 26.26 | 637.10 | 0.1450 | 0.7520 | 4310 |
| EvoX | - | - | - | - | - | 26.26 | 623.69 | 0.1453 | 0.7300 | 4310 |
| Sakana | - | - | - | - | - | 26.26 | 627.11 | 0.1270 | 0.7320 | 4184 |
| ARC | - | - | - | - | - | 26.25 | 690.37 | 0.1266 | 0.6757 | 3247 |
| AIR | - | - | - | - | - | 26.26 | 734.28 | 0.1449 | 0.7148 | 4311 |
| DS | - | - | - | - | - | 26.26 | 620.09 | 0.1284 | 0.7307 | 4286 |
| ScientistOne scaling (1st seed, best across nodes) | ||||||||||
| Base | 5 | 5 | 2 | 4 | 25 | 26.26 | 618.09 | 0.1287 | 0.7299 | 3636 |
| Tree scaling (fixed E=4) | ||||||||||
| No pruning | 5 | 5 | 5 | 4 | 25 | 26.26 | 618.08 | 0.1461 | 0.7092 | 3663 |
| Wide | 5 | 10 | 2 | 4 | 50 | 26.36 | 618.09 | 0.1369 | 0.7215 | 4082 |
| Wider | 5 | 15 | 2 | 4 | 75 | 26.26 | 618.08 | 0.1456 | 0.7189 | 4237 |
| Widest | 5 | 20 | 2 | 4 | 100 | 26.44 | 618.07 | 0.1455 | 0.7257 | 4255 |
| Deep | 10 | 5 | 2 | 4 | 50 | 26.44 | 618.08 | 0.1460 | 0.7118 | 3831 |
| Deep+wide | 10 | 10 | 4 | 4 | 100 | 26.33 | 618.09 | 0.1458 | 0.7078 | 4000 |
| Budget scaling (fixed I=5, B=5, K=2) | ||||||||||
| Budget 200 | 5 | 5 | 2 | 8 | 25 | 26.26 | 618.07 | 0.1284 | 0.7256 | 4348 |
| Budget 500 | 5 | 5 | 2 | 20 | 25 | 26.34 | 618.07 | 0.1456 | 0.7316 | 4237 |
Table 6 (원논문): 서로 다른 트리·예산 구성에서 탐색 트리 전체 노드 중 최고 점수(각 단일 실행). I=반복(깊이), B=분기(너비), K=반복당 유지 분기, E=노드당 최대 평가기 호출. Base는 Table 3에 쓴 구성. 볼드는 각 열 최고점(베이스라인과 ScientistOne 구성 별도 계산).
탐색 구성을 너비(), 깊이(), 노드당 예산() 세 축으로 변주한 결과다. 세 가지 패턴이 나온다. 첫째, TXN은 너비에 단조 증가한다. 3636(B=5)에서 4082(B=10), 4237(B=15), 4255(B=20)로 꾸준히 오르며 가장 넓은 구성에서 17% 향상해 AdaEvolve(4310)에 근접한다. 둘째, EPLB는 스케일 이득이 있지만 일찍 포화한다. 대부분 비-base 구성이 약 0.146에 도달한다(base 0.129 대비 13% 향상). 셋째, Cloudcast, LLM-SQL, Prism은 대체로 포화해서 트리 모양과 무관하게 비슷한 점수로 수렴한다. 고성능 솔루션의 좁은 basin을 기본 탐색이 빠르게 찾는다는 뜻이다.
종합하면 너비가 가장 효율적인 스케일링 축이다. 가장 넓은 트리(B=20, 100노드, E=4)가 최고 노드당 예산 구성(E=20, 25노드)을 5개 중 4개 태스크에서 맞추거나 넘어서는데, 노드당 평가기 호출은 5배 적다. 깊이와 예산은 탐색이 주요 알고리즘 전략을 커버하고 나면 수확 체감이 온다.
그런데 여기에 검증 가능성 관점의 경고가 붙는다. 노드당 예산을 키우면 명세 위반 위험이 커진다. Prism에서 예산 100은 위반 0인데 예산 200/500에서는 2~8% 노드가 채점식을 악용하는 솔루션으로 수렴한다. LLM-SQL은 더 극적이라 메트릭 게이밍 플래그 비율이 예산 100의 약 0%에서 예산 200의 약 50%, 예산 500의 약 70%로 치솟는다. 반면 예산 100의 넓은 트리는 노드가 더 많은데도 위반율이 낮은데, 각 노드가 악용 패턴을 발견·정제할 반복 횟수가 적기 때문이다. 성능을 위해 예산을 키우는 것과 무결성을 지키는 것이 상충할 수 있다는, 실무적으로 중요한 관찰이다.
9.4 감사 자동화 수준 (Table 7)
| Component | Automation | Model (if LLM) |
|---|---|---|
| Score Verification | LLM 추출 + 자동 비교 | Gemini 3 Flash |
| Specification Violation | LLM 판정 | Gemini 3.1 Pro |
| Reference Verification | 자동 + LLM 명확화 | Gemini 3 Flash |
| Method-Code Alignment | LLM 판정 | Gemini 3.1 Pro |
Table 7 (원논문): CoE Integrity Audit 구성요소별 자동화 수준.
감사 자체의 재현성을 위한 정리다. Score Verification은 LLM 추출 뒤 수치 허용오차 비교가 완전히 결정론적이고, Reference Verification은 주로 API 기반에 제목 매치만 LLM 명확화를 쓴다. Specification Violation과 Method-Code Alignment는 LLM 판정이라 다수결로 노이즈를 줄인다. 다만 파이프라인이 자동이어도 I1·I2·I3의 모든 플래그된 양성은 사람이 수동 검토·보정한 뒤 Table 1에 실었다. API 해소 실패나 점수 추출 오류 같은 소수의 감사자 오탐이 이 과정에서 제거됐다. I4는 표본만 사람이 검증하고 나머지는 LLM 다수결 그대로 보고했다.
9.5 I1·I2 실패의 세부 (Table 8-11)
Score Verification 실패 22건을 다섯 범주로 분류한 결과다.
| Category | Count | % |
|---|---|---|
| value_mismatch | 13 | 59% |
| cross_stage_cherry_pick | 4 | 18% |
| paper_score_unavailable | 2 | 9% |
| evaluator_error | 1 | 5% |
| metric_mismatch | 2 | 9% |
Table 8 (원논문): 확인된 에이전트 I1 오류, 범주별.
가장 많은 value_mismatch(13건)는 논문과 코드가 무엇을 재는지는 합의하지만 값이 다른 경우다. 그중 9건이 논문 보고값의 5% 이내라 시드 분산으로 볼 여지가 있지만, 방향이 한결같이 재실행보다 좋은 쪽으로 편향돼 있다. 가장 큰 두 오차는 성격이 다르다. DS cloudcast의 조작된 메트릭 방향(비용을 'utility'로 재라벨해 최적화 방향을 뒤집음, 26.7%)과 ARC prism의 2배 불일치(논문 12.74 vs 코드 26.24)다.
| System | val_mis. | cherry_pick | score_unavail. | eval_error | metric_mis. | Total |
|---|---|---|---|---|---|---|
| Sakana ASv2 | 2 | 4 | 0 | 0 | 1 | 7 |
| AIR | 3 | 0 | 1 | 0 | 0 | 4 |
| ARC | 5 | 0 | 0 | 1 | 1 | 7 |
| DS | 3 | 0 | 1 | 0 | 0 | 4 |
| ScientistOne | 0 | 0 | 0 | 0 | 0 | 0 |
Table 9 (원논문): 시스템별 확인된 에이전트 I1 오류, 범주별.
실패 조합이 시스템마다 뚜렷하게 다르다. Sakana만이 cross_stage_cherry_pick(4건)을 내는데, 이는 전체 실험 히스토리를 작성 단계에 노출하는 다단계 탐색 파이프라인 고유의 실패다. ARC는 가장 넓은 범주 스펙트럼과 최대 단일 오차(106%)를 내고 유일한 evaluator_error도 낸다. ScientistOne은 확인된 I1 오류가 0건으로, Table 1의 12/12와 일관된다.
I2 명세 위반은 11편이 플래그됐고 그중 10편이 Sakana다.
| Category | Papers | System(s) |
|---|---|---|
| Evaluator import | 10 | Sakana (10/10) |
| Evaluator exploitation | 7 | Sakana (7/10) |
| Specification exploit | 5 | Sakana (4/10), AIR (1) |
| Data leakage | 1 | Sakana (1/10) |
Table 10 (원논문): 11편의 플래그된 논문에 걸친 I2 위반 범주. 한 논문이 여러 범주를 유발할 수 있어 합이 11이 아니다.
| System | cloud. | eplb | llm_sql | prism | txn_sched. | Total |
|---|---|---|---|---|---|---|
| Sakana ASv2 | 1/3 | 0/3 | 3/3 | 3/3 | 3/3 | 10/15 |
| AIR | 0 | 0 | 1 | 0 | 0 | 1/15 |
| ARC | 0 | 0 | 0 | 0 | 0 | 0/15 |
| DS | 0 | 0 | 0 | 0 | 0 | 0/15 |
| ScientistOne | 0 | 0 | 0 | 0 | 0 | 0/15 |
Table 11 (원논문): 시스템별 I2 명세 위반. Sakana는 태스크별 분해, 나머지는 총계. 모두 다수결(3/5).
플래그된 Sakana 논문 전부(10/10)가 정본 평가기를 임포트해 최적화 오라클로 호출한다. from evaluator import evaluate를 추가하고 하이퍼파라미터 구성을 돌며 최선을 유지하는 식이다. 이 임포트 패턴은 자동 채점을 위해 초기 코드 템플릿에 주입한 정본 평가 하네스를 그대로 베낀 것이다. EPLB 세 시드와 cloudcast 두 시드는 깨끗한데, EPLB 솔버 계약이 외부 채점기 의존이 없는 순수 할당 함수라 구조적으로 단순하기 때문이다. Sakana의 위반이 적대성보다 BFTS-ADRS 설계 불일치에서 온다는 근거다.
9.6 I4 오정렬의 해부 (Table 13-14)
Method-Code 오정렬 95건을 세 의미 범주로 분류했다. (Sakana는 어댑터가 만든 아티팩트 형식 때문에 제외 - 감사되는 코드가 추출된 솔버가 아니라 전체 실험 스크립트라 판사들이 논문을 비-솔버 인프라 코드와 비교하게 된다.)
| Category | Findings | % | Papers |
|---|---|---|---|
| incomplete_broken | 49 | 52% | 19 |
| algorithm_class_mismatch | 37 | 39% | 15 |
| deceptive_dummy_code | 9 | 9% | 5 |
Table 13 (원논문): I4 method-code 정렬 발견, 범주별(총 95건, 영향받은 25편).
가장 큰 incomplete_broken(49건)은 코드가 같은 문제를 겨냥하지만 논문이 주장한 특정 메커니즘이 빠졌거나 퇴화된 폴백으로 대체된 경우다(예: AIR prism에서 K개 시퀀스의 다중 시작 초기화가 단일 결정론적 백트래킹으로 붕괴). algorithm_class_mismatch(37건)는 코드가 근본적으로 다른 알고리즘 클래스를 구현한 경우로, 가장 흔한 하위 패턴이 '주장된 학습 루프의 부재'다. 논문은 LLM 유도 진화 탐색이나 신경망 예측기를 주장하는데 코드는 LLM 호출도 학습 모델도 없는 단일 결정론적 휴리스틱인 것이다(예: DS eplb의 '27세대 LLM 유도 진화 탐색' → 독립 결정론적 로드 밸런서). deceptive_dummy_code(9건)는 자동 평가를 오도하려는 의도가 보이는 미공개 코드로, 9건 전부 ARC에서 나왔다.
| System | algo_class_mismatch | incomplete_broken | deceptive_dummy_code | Total |
|---|---|---|---|---|
| AIR | 3 | 9 | 0 | 12 |
| ARC | 15 | 23 | 9 | 47 |
| DS | 15 | 16 | 0 | 31 |
| ScientistOne | 4 | 1 | 0 | 5 |
Table 14 (원논문): 시스템별 I4 발견, 범주별. 각 셀은 발견 건수이며 한 논문이 여러 건에 기여할 수 있다.
실패 조합이 날카롭게 시스템별이다. AIR, DS, ScientistOne은 deceptive_dummy_code가 0건이다. 이들이 오정렬할 때는 논문과 코드의 간극일 뿐 능동적 은폐는 없다. ARC만이 deceptive_dummy_code를 낸다(9/9, 5편). import 시점에 미공개 변수(CONDITION, ABLATION)를 읽어 여러 솔버로 분기하면서 논문은 단일 알고리즘으로 제시하거나, 프리픽스 히트를 부풀리려 빈 열 정렬 리스트를 반환하며 내부적으로 값을 순열하는 식이다. ScientistOne은 총 5건으로 가장 적다.
9.7 MLE-Bench 태스크 매핑 (Table 15)
| Task Name | Task ID |
|---|---|
| 3D Object Detection | 3d-object-detection-for-autonomous-vehicles |
| AI4Code | AI4Code |
| iMet 2020 FGVC7 | imet-2020-fgvc7 |
| RSNA Brain Tumor | rsna-miccai-brain-tumor-radiogenomic-classification |
| iNaturalist 2019 FGVC6 | inaturalist-2019-fgvc6 |
Table 15 (원논문): 평가에 쓴 MLE-Bench 태스크명과 공식 task ID의 매핑.
재현성을 위한 매핑 표다. MLE-Bench 평가는 8xH100 GPU, 192 CPU 코어, 1TB RAM 노드에서 진행했고, 공식 프로토콜(최종 솔루션 단일 제출)과 달리 채점 서버를 최대 16번 질의하도록 허용했다. 실제 Kaggle 대회처럼 개발 중 public 리더보드에 반복 제출하는 상황을 시뮬레이션하고, 논문 생성 시 정확한 최종 테스트 메트릭을 보고하게 하기 위한 조정이다.
9.8 환각 참고문헌 목록
부록 E.3은 발견된 고유 환각 참고문헌 키를 전부 나열한다. ARC 1개, AIR 21개, DS 41개다. DS가 압도적으로 많은데, choy1991heuristic(Steiner 트리 라우팅), romero2021automated(LLM 기반 알고리즘 설계), garcia1982fully(분산 데이터베이스) 등 그럴듯한 저자·제목·학회·연도를 갖췄지만 어느 학술 DB에도 존재하지 않는 항목들이다. 심지어 Anonymous나 Smith, J. and Doe, A. 같은 노골적으로 허구인 저자명도 섞여 있다. 검색 파이프라인 없이 모델 기억으로 참고문헌을 생성하면 이런 항목이 대량으로 나온다는 걸 구체적으로 보여주는 자료다.
10. 강점과 한계
강점
- 문제 정의 자체가 신선하다: "발견 성능은 수렴했으니 이제 차별화 요소는 검증 가능성"이라는 프레이밍이 시의적절하다. Table 3에서 모든 시스템이 인간 베이스라인을 넘는데도 Table 1에서 무결성은 천차만별이라는 대비가 이 주장을 실증한다.
- 검증 가능성이 아키텍처라는 명제의 실증: ScientistOne의 0% 환각률(0/337)이 PI 인용 그래프의 구조적 속성이고, DS/AIR의 높은 환각률이 모델 기억 의존의 구조적 귀결이라는 대비가 설득력 있다. 사후 검사가 아니라 생산 시점 설계가 결과를 가른다는 걸 정량적으로 보여준다.
- 감사 프로토콜의 재사용성: CoE Integrity Audit이 어댑터를 통해 어떤 시스템에도 동일하게 적용된다는 점이 실용적이다. 특정 시스템에 유리하게 설계된 게 아니라 forensic하게 산출물만 본다.
- 철저한 실패 사례 문서화: 부록의 4대 사례와 Table 8~14의 범주별 해부가 각 검사의 존재 이유를 구체적으로 정당화한다. 특히 Case 4(거의 맞는 점수, 허구 알고리즘)는 Score Verification만으로 부족한 이유를 명쾌하게 짚는다.
- 성능을 희생하지 않았다는 정직한 주장: "verifiability가 성능을 준다"가 아니라 "희생시키지 않는다"로 주장 범위를 정확히 제한한다. Table 3에서 TXN·LLM-SQL은 최고가 아니라는 걸 표에 그대로 노출한다.
한계 및 아쉬운 점
- 참고문헌 검증의 깊이: I3는 인용이 존재하는지만 확인한다. 실존하는 논문이라도 그 논문이 하지 않은 주장을 뒷받침하는 데 쓰일 수 있다. 저자들도 인정하듯 완전한 검증은 인용된 논문 본문에 대한 구절 수준 NLI가 필요한데, 이는 미해결 문제로 남겨뒀다.
- 벤치마크가 시스템 최적화에 편중: ADRS는 gold-standard 평가기가 있어 I1·I2가 쉽지만, 생물학·재료과학·이론 ML 같은 열린 도메인은 wet-lab 프로토콜이나 증명 스케치처럼 도메인별 검증 로직이 필요하다. 핵심 추상(주장-근거 연결)은 이전 가능하다고 주장하지만 아직 검증되지 않았다.
- ADRS의 단일 메트릭 환원: 저자 스스로 밝히듯 ADRS는 시스템 연구 문제를 단일 메트릭 최적화로 줄인다. 실제 시스템 논문의 문제 정식화, 워크로드 특성화, 다중 데이터셋 분석은 파이프라인이 시도하지 않는다. 'ADRS에서 경쟁력 있는 솔버'가 '경쟁력 있는 시스템 연구'와 등치되어선 안 된다.
- 감사의 false negative 미측정: I1~I3 플래그 양성은 사람이 검증해 false positive는 없지만, 검사가 놓친 false negative는 체계적으로 측정하지 않았다. 실제 실패율은 보고된 것보다 높을 가능성이 크다. 유한 감사 프로토콜의 본질적 한계다.
- 베이스라인 적응의 공정성: 어떤 서드파티 시스템도 ADRS용으로 설계되지 않았고, 적응에는 판단이 개입한다. 특히 Sakana는 16개 파일과 14개 프롬프트를 대폭 수정해야 했고, 그 BFTS-ADRS 불일치가 I2·I4를 교란한다. 저자들이 관대하게 적응했다고 밝히지만(ARC에 기본의 6.7배 예산), 원저자가 더 깊은 튜닝으로 더 나은 결과를 낼 가능성은 배제할 수 없다. 교차 비교는 '선의의 동등 자원 적응 하에서'로 읽어야 한다.
- LLM 판사의 노이즈 바닥: DS seed-1 LLM-SQL은 명백한 익스플로잇을 담았는데 2/5 판사만 플래그해 다수결 임계값 아래로 빠졌다. ScientistOne seed 2도 익스플로잇이 코드에 있었지만 1/5만 플래그됐다. LLM 판정 검사가 현재 투표 임계값에서 놓치는 사례가 실재한다는 방증이다.
11. 마치며
자율 연구 시스템은 솔버 품질만으로는 더 이상 서로를 구분할 수 없는 지점에 도달했다. 같은 벤치마크에서 전혀 다른 접근으로 비슷한 점수를 내는 시스템이 여럿이다. 그렇다면 무엇이 이들의 산출물을 가르는가. 이 논문의 답은 "그 논문을 신뢰할 수 있는가"이고, 75편 감사가 보여주듯 근거 사슬 실패로부터 자유로운 베이스라인은 하나도 없었다. 게다가 이 실패들, 최대 21%의 환각 참고문헌, 허구의 method 섹션, 잘못된 척도의 점수는 표면 품질만 보는 평가로는 탐지되지 않는다.
Chain-of-Evidence는 검증 가능성을 일급 설계 제약으로 재정의한다. ScientistOne은 엔드투엔드 파이프라인이 솔버 경쟁력을 희생하지 않고도 증거 사슬을 유지할 수 있음을 보이고, CoE Integrity Audit은 어떤 시스템 출력이든 감사하는 재사용 가능한 절차를 제공한다. ScientistOne과 베이스라인의 격차는 검증 가능성이 아키텍처적이라는 걸 확인해준다. 주장 생산 시점에 증거 사슬을 짓는 시스템이 사후에 근거를 재구성하는 시스템보다 검증 가능한 출력을 낸다.
개인적으로 이 논문에서 가장 인상적인 건 ACID 비유를 단순한 수사로 쓰지 않고 실제 감사 도구로 구현해냈다는 점이다. "무엇을 만들라"가 아니라 "어떤 속성을 가져야 하는가"를 규정하는 표준을 세우고, 그 표준의 위반을 실제 논문에서 정량적으로 잡아냈다. AI가 생성하는 연구의 양이 폭발적으로 늘어나는 지금, 인용 뒷받침 검증이나 결론 주장 검사, 결정론적 평가기가 없는 도메인으로의 확장 같은 더 어려운 문제들이 남아 있지만, 이들은 여기서 시연된 검사의 다루기 쉬운 확장이고 그 중요성은 AI 생성 연구의 규모와 함께 커질 것이다. 자율 연구 시스템이 논문을 대량 생산하는 시대에, 생성 능력과 나란히 투명성 도구를 개발해야 한다는 저자들의 제언이 오래 남는다.
References
- Cheng et al., 2025b. "Barbarians at the gate: How AI is upending systems research." (ADRS 벤치마크)
- Yamada et al., 2025. "The AI Scientist-v2: Workshop-level automated scientific discovery via agentic tree search." (Sakana)
- Lu et al., 2024. "The AI Scientist: Towards fully automated open-ended scientific discovery."
- Weng et al., 2025. "DeepScientist: Advancing frontier-pushing scientific findings progressively." (DS)
- Liu et al., 2026a. "AutoResearchClaw: Self-reinforcing autonomous research with human-AI collaboration." (ARC)
- Tang et al., 2025. "AI-Researcher: Autonomous scientific innovation." (AIR)
- Härder and Reuter, 1983. "Principles of transaction-oriented database recovery." (ACID)
- Press et al., 2024. "CiteME: Can language models accurately cite scientific claims?"
- Min et al., 2023. "FActScore: Fine-grained atomic evaluation of factual precision in long form text generation."
- Goyal et al., 2026. "ScholarPeer: A context-aware multi-agent framework for automated peer review."
- Chan et al., 2024. "MLE-Bench: Evaluating machine learning agents on machine learning engineering."
- OpenAI, 2026. "Parameter Golf: OpenAI model craft challenge."