논문 리뷰
논문 리뷰: Learning to Select: Query-Aware Adaptive Dimension Selection for Dense Retrieval
1. 들어가며
Dense retrieval에서 임베딩 차원을 늘리면 성능이 좋아진다는 건 거의 상식처럼 통용된다. Qwen-Embedding-8B는 4096차원, OpenAI text-embedding-3-large는 3072차원을 쓴다. 그런데 이 고차원 벡터의 모든 좌표가 검색에 도움이 될까? 이 논문의 출발점은 "그렇지 않다"는 관찰이다. 특정 질의(query)에 대해서는 일부 차원만 관련성 판단에 기여하고, 나머지는 무관하거나 오히려 랭킹을 망가뜨린다는 것이다.
이 아이디어 자체는 새롭지 않다. DIME(Dimension Importance Estimation) 계열 연구가 이미 "질의마다 중요한 차원이 다르다"는 점을 파고들었다. 다만 기존 방법은 라벨 없이 동작하기 위해 가짜 신호(pseudo-relevance feedback)에 의존했고, 이 신호가 노이즈에 취약하다는 한계가 있었다. 반대편에는 라벨을 활용해 임베딩 공간 자체를 다시 빚는 supervised adapter 계열이 있는데, 이쪽은 모든 질의에 동일한 전역 변환을 적용하기 때문에 "질의별 차원 중요도"라는 개념 자체를 모델링하지 못한다.
Beihang University의 Zhanyu Wu, Zhijie Nie, Richong Zhang이 쓴 이 논문은 두 진영의 장점을 합치려 한다. 지도 라벨로부터 질의별 차원 중요도의 "정답 분포(oracle distribution)"를 만들어내고, 이 분포를 예측하는 작은 예측기(predictor)를 오프라인에서 학습시킨다. 추론 시점에는 질의 임베딩만 보고 상위 k개 차원을 골라 유사도를 계산한다. 문서 임베딩과 ANN 인덱스는 손대지 않으므로, 이미 구축된 FAISS 인덱스를 그대로 두고 질의 쪽만 마스킹하면 된다는 게 실무적으로 매력적인 지점이다.
결과부터 말하면, 전체 차원의 20-40%만 남겨도 full-dimensional 베이스라인을 넘어서고, 상당수 설정에서 supervised adapter와 PRF 기반 마스킹을 모두 앞선다. 차원을 줄이는 게 효율이 아니라 효과(effectiveness)를 위한 선택이라는 점이 이 논문의 관점을 다른 차원 축소 연구와 구분 짓는다.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Learning to Select: Query-Aware Adaptive Dimension Selection for Dense Retrieval |
| 저자 | Zhanyu Wu, Zhijie Nie, Richong Zhang (Beihang University, China) |
| 분야 | Information Retrieval / Dense Retrieval |
| 논문 링크 | arXiv:2602.03306 |
| 핵심 키워드 | Query-aware dimension selection, Label distillation, KL divergence, Dense retrieval |
2. 기존 연구의 한계
이 논문의 문제의식을 제대로 이해하려면 dense retrieval에서 차원 중복(dimension redundancy)을 다뤄온 두 갈래를 먼저 짚어야 한다.
2.1 DIME 계열: 질의별 마스킹, 그러나 가짜 라벨에 의존
DIME(Faggioli et al., 2024, 2025; Campagnano et al., 2025)은 질의마다 중요한 차원의 부분집합을 골라 그 좌표에서만 유사도를 계산한다. 각 차원 의 중요도를 질의-양성 정렬(query-positive alignment)로 추정하는데, 문제는 이 "양성 문서"를 어디서 얻느냐다. DIME은 (i) LLM이 생성한 pseudo-relevant 문서를 쓰거나, (ii) 상위 개 검색 결과를 그냥 양성으로 간주하는 pseudo-relevance feedback(PRF) 방식을 쓴다. Eclipse(D'Erasmo et al., 2025)는 여기서 한 발 더 나아가 pseudo-negative까지 대조(contrastive)에 활용한다.
이 접근의 두 가지 약점이 논문 전체의 동기가 된다. 첫째, 이 신호들은 어디까지나 가짜 라벨이라 노이즈가 섞인다. 상위 검색 결과가 실제로 관련 문서라는 보장이 없기 때문이다. 둘째, 이 방법들은 추론 시점에 돌아가는 별도의 휴리스틱 단계로 구현된다. 즉 이미 존재하는 지도 라벨(supervised relevance label)을 직접 활용하도록 학습되는 게 아니라, 매 질의마다 즉석에서 추정하는 test-time 절차인 것이다.
2.2 Supervised Adapter: 라벨을 쓰지만 전역 변환에 그침
반대 진영인 Search Adapter(Yoon et al., 2024a)는 얼어붙은(frozen) 인코더 위에 학습 가능한 변환 를 얹어 임베딩 공간을 재조정한다. 라벨을 직접 쓰기 때문에 full-dimensional 성능은 원본 인코더보다 크게 좋아지는 경우가 많다. 하지만 이 변환은 모든 질의와 문서에 공유되는 단일한 전역(global) 변환이다. 지도 신호가 코퍼스 수준의 구조를 다듬는 데 쓰일 뿐, "이 질의에는 이 차원이 중요하다"는 질의별 패턴을 명시적으로 잡아내지는 못한다.
Matryoshka 계열(Kusupati et al., 2022; Yoon et al., 2024b; Zhang et al., 2025a)도 관련이 있지만 목적이 다르다. MRL은 임베딩을 차원 순서로 중첩(nested)되게 학습시켜 앞쪽 prefix만 잘라 써도 성능이 유지되도록 한다. 즉 효율을 위한 차원 축소가 목표이고, full-dimensional peak 성능은 대체로 Search Adapter와 비슷한 수준에 머문다.
정리하면, 라벨을 안 쓰는 DIME은 질의별 선택은 하지만 노이즈에 약하고, 라벨을 쓰는 Adapter는 정확하지만 질의별 선택을 못 한다. 이 논문은 "라벨로부터 질의별 차원 중요도를 직접 배우자"는 지점에서 두 계열의 빈틈을 정확히 겨냥한다.
3. 핵심 아이디어
발상은 지식 증류(knowledge distillation)의 구조를 빌려온 것으로 볼 수 있다. 라벨이 알려주는 "정답에 가까운" 질의별 차원 중요도를 먼저 계산해 교사(teacher) 분포로 삼고, 질의 임베딩만 입력으로 받는 작은 예측기를 학생(student)으로 두어 그 분포를 흉내 내게 한다.
이 구조가 영리한 이유는 라벨이 필요한 시점을 학습 단계로 밀어냈다는 데 있다. DIME은 추론 때마다 양성/음성 신호를 새로 추정해야 하지만, 여기서는 라벨로 만든 oracle 분포를 한 번 계산해 예측기에 증류해 두면, 추론 때는 질의 임베딩 하나만 예측기에 통과시키면 끝난다. 문서를 다시 검색해 PRF를 돌릴 필요도, 라벨을 참조할 필요도 없다.
또 하나 실무적으로 중요한 설계는 마스킹을 질의 쪽에만 적용한다는 점이다. 선택되지 않은 질의 차원을 0으로 채워 질의를 여전히 차원 벡터로 유지하고, 문서 임베딩과 ANN 인덱스는 전혀 건드리지 않는다. 덕분에 재인덱싱 없이 기존 검색 파이프라인에 그대로 얹을 수 있다.
4. 제안 방법 (Method)
전체 파이프라인은 Figure 1에 압축돼 있다.
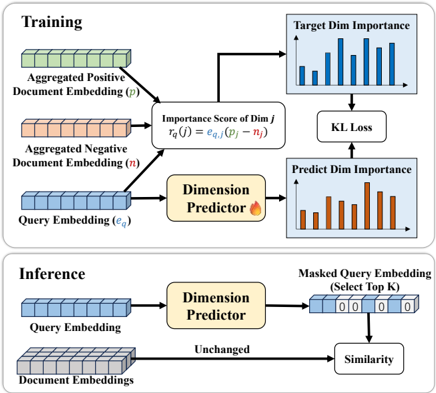
Figure 1 (원논문): 질의별 차원 선택 파이프라인. 학습 단계(위)에서는 관련 문서를 모은 양성 임베딩 와 하드 네거티브를 모은 음성 임베딩 을 대조해 질의별 차원 중요도 타깃을 만들고, 질의 임베딩만 입력받는 예측기를 KL divergence로 학습시킨다. 추론 단계(아래)에서는 예측된 중요도로 상위 k개 질의 차원을 고르고(나머지는 마스킹), 문서 임베딩과 ANN 인덱스는 그대로 둔다.
그림 위쪽 학습 파트를 보면, 양성 문서 임베딩 와 음성 문서 임베딩 , 그리고 질의 임베딩 세 가지가 만나 차원별 중요도 점수 를 만들어낸다. 이게 타깃 분포(Target Dim Importance)가 되고, 예측기가 내놓는 분포(Predict Dim Importance)와의 KL Loss를 최소화한다. 아래쪽 추론 파트는 질의 임베딩을 예측기에 넣어 상위 K개 차원만 남긴 마스킹 질의를 만들고, 손대지 않은 문서 임베딩과 유사도를 계산하는 흐름이다. 방법은 크게 두 단계, 오라클 차원 중요도 계산과 예측기 학습으로 나뉜다.
4.0 사전 준비: 표기와 정규화
먼저 dual-encoder 세팅을 정리하면, 질의 와 문서 는 각각 인코더 를 거쳐 차원 임베딩이 된다.
관련성은 유사도 함수 로 추정하며, 보통 코사인 유사도를 쓴다.
이 논문은 모든 임베딩을 정규화()해서 사용한다. 참고로 비교 대상인 Search Adapter는 학습 가능한 투영 로 임베딩 자체를 변환한다.
Search Adapter가 선형 층으로 임베딩을 "변환"한다면, 이 논문의 선형 층은 임베딩을 변환하는 게 아니라 가장 유용한 차원을 "선택"하는 데 쓰인다는 점이 대비된다.
DIME의 차원 중요도 추정도 짚어두면, 각 차원 의 중요도를 질의-양성 정렬로 계산한다.
여기서 는 질의 에 대한 관련 문서 집합이고, DIME은 이걸 LLM 생성 문서나 PRF로 얻는다. 그리고 목표 차원 수 에 대해 중요도 상위 개 좌표 집합 에서만 유사도를 계산한다. 이 논문의 방법도 큰 골격은 같지만, 를 가짜가 아닌 진짜 라벨에서 얻고 그 결과를 예측기에 증류한다는 점이 다르다.
4.1 오라클 차원 중요도 계산
학습 데이터는 삼중항 로 주어진다. 는 문서 가 질의 에 대해 갖는 다단계(multi-level) 관련성 라벨이다. 직관은 이렇다. 어떤 차원이 질의-양성 유사도에는 강하게 기여하면서 질의-음성 유사도에는 약하게(또는 음으로) 기여한다면, 그 차원은 관련 문서와 비관련 문서를 잘 구별해 주는 값진 차원이다.
먼저 관련 문서 집합 을 모은다(관련 문서가 하나도 없는 질의는 건너뛴다). 각 문서에 DCG 스타일의 이득 점수(gain score) 을 부여하고, 이를 정규화해 가중치로 만든다.
이 가중치로 양성 문서들의 가중 중심(centroid)을 구한다.
관련성이 높은 문서일수록 가 커지므로 중심 계산에 더 크게 반영되는 구조다. 다단계 라벨을 그냥 평균 내지 않고 등급에 따라 차등 가중한 게 뒤에서 볼 ablation의 성능 향상 요인 중 하나다.
음성 쪽은 하드 네거티브(hard negative)로 만든다. 모든 문서를 유사도 로 정렬해 상위 개의 비관련 문서를 뽑고, 그중 개를 균등 샘플링해 를 구성한다(은 튜닝 가능한 하이퍼파라미터). 음성 임베딩은 단순 평균으로 둔다.
여기서 "상위 K개의 비관련 문서"라는 게 하드 네거티브의 정의다. 질의와 유사도가 높은데도 실제로는 관련이 없는 문서, 즉 모델이 헷갈리기 쉬운 어려운 음성이다. 이런 문서와 양성을 가장 잘 갈라주는 차원을 찾겠다는 의도다.
이제 각 차원 에 대해 양성-음성 정렬 차이를 원점수(raw discrimination score)로 계산한다.
이 값은 차원 가 관련 매칭을 얼마나 강하게 지지하면서 동시에 음성을 얼마나 밀어내는지를 정량화한다. 질의 좌표 가 양성 중심과 음성 중심의 차이 와 같은 부호로 크게 정렬될수록 그 차원의 점수가 높아진다. 마지막으로 차원 방향으로 온도 조절 softmax를 걸어 중요도 분포로 만든다.
는 분포의 날카로움(sharpness)을 조절한다. 가 작으면 소수 차원에 확률이 집중되고, 크면 완만하게 퍼진다. 뒤에서 보겠지만 최적값이 근처라는 건 상당히 뾰족한 분포, 즉 극소수 차원에 중요도를 몰아주는 게 유리하다는 뜻이다.
4.2 차원 중요도 예측기 학습
예측기는 놀랄 만큼 단순하다. 완전연결층 하나, 가 전부다. 얼어붙은 질의 임베딩 를 받아 로짓 를 내고 log-softmax로 예측 분포를 만든다.
학습 목표는 오라클 타깃 분포와 예측 분포 사이의 KL divergence 최소화다.
여기서 중요한 건 입력이 오직 질의 임베딩뿐이라는 점이다. 오라클 를 만들 때는 양성/음성 문서가 필요했지만, 예측기는 질의만 보고 그 결과를 재현하도록 배운다. 이 비대칭이 추론을 가볍게 만드는 열쇠다.
추론 시점에는 예측된 중요도 에서 상위 개 차원을 고른다.
이 마스크 으로 질의 임베딩을 가려 마스킹 질의를 만들고, 손대지 않은 문서 임베딩과 유사도를 계산한다.
결국 선택된 차원에서만 유사도를 평가하는 것과 같으면서도, 문서 임베딩과 ANN 인덱스는 재학습이나 재인덱싱 없이 그대로 유지된다. 참고로 마스킹 후 질의를 다시 정규화하지 않는데, 이건 점수를 질의별 상수배만 할 뿐 랭킹에는 영향을 주지 않기 때문이다.
5. 실험 설정
5.1 모델과 데이터셋
저자들은 성격이 다른 여러 dense retriever를 골고루 실험에 넣었다. MRL(Matryoshka) 목적함수로 학습된 인코더로는 Qwen-Embedding-0.6B(=1024), 4B(=2560), 8B(=4096)와 OpenAI text-embedding-3-large(=3072)를 쓰고, 명시적 다중 스케일 제약 없이 학습된 인코더로는 LLM2Vec-Mistral-7B, LLM2Vec-Llama3-8B, GritLM-Mistral-7B(모두 =4096)를 넣었다. 본문에서는 Qwen-Embedding을 Qwen, LLM2Vec을 L2V로 줄여 부른다.
MRL로 학습된 모델과 아닌 모델을 함께 넣은 건 의도적인 설계로 보인다. 만약 MRL 모델에서만 차원 선택이 통한다면 "그건 MRL이 앞쪽 차원에 정보를 몰아둔 덕분"이라는 반론이 가능하다. MRL이 아닌 모델에서도 통해야 "차원 중복은 dense 임베딩의 일반적 성질"이라는 주장이 선다.
데이터셋은 SciFact, NFCorpus, MS MARCO 세 가지다. BEIR가 제공하는 in-domain train/test 스플릿을 쓰며 도메인 간 전이(cross-domain transfer)는 하지 않는다. MS MARCO는 학습용으로 5만 개 질의-문서 쌍을 서브샘플링하고, 모든 데이터셋에서 학습 세트의 10%를 검증용으로 뗀다. SciFact는 단일 레벨 라벨, NFCorpus는 다단계 라벨을 갖는다는 차이가 있어 앞서 본 다단계 가중치 설계를 검증하기에 적절하다.
5.2 베이스라인
- Full: 자르지 않은 full 차원 임베딩 (무처리 베이스라인)
- Cutoff: 원본 임베딩의 앞쪽 개 좌표만 남기는 정적 prefix
- Norm: 질의 좌표의 절댓값 이 큰 상위 개 차원을 남기는 질의별 베이스라인
- DIME-PRF(Faggioli et al., 2024): 상위 1개 검색 문서를 pseudo-positive로 써서 차원 중요도를 추정하는 DIME 재현
- Eclipse-PRF(D'Erasmo et al., 2025): DIME-PRF에 PRF 집합의 pseudo-negative를 더해 대조적으로 채점하는 확장
- Adapter(Yoon et al., 2024a): supervised search adapter 재현. full 차원 성능을 최적화하도록 학습되므로 full 차원에서만 보고
DIME-PRF와 Eclipse-PRF는 여러 PRF 설정을 탐색한 결과 상위 1개 문서를 pseudo-positive로 쓸 때가 가장 좋았다고 한다. PCA나 다중 레벨 MRL adapter처럼 차원 축소 자체를 최적화하는 방법은 베이스라인에서 뺐는데, 이들은 애초에 축소된 표현이 원본 full 차원 성능을 넘어서리라 기대하지 않는 방법이기 때문이다. 이 논문의 목표는 어디까지나 full 차원에서의 peak 효과를 끌어올리는 것이다.
5.3 하이퍼파라미터
모델-데이터셋 쌍마다 검증 스플릿에서 튜닝하는데, 남긴 차원 수 에서의 NDCG@10 합을 최대화하는 설정을 고른다. 온도 는 그리드 탐색으로 조정하고, 음성 샘플링 파라미터는 (하드 네거티브 풀 크기), (in-batch 음성 수)로 고정한다. 평가 시에는 남긴 차원 비율 를 의 2%부터 100%까지 2% 간격으로 훑고, 각 방법·모델별 peak NDCG@10을 보고한다.
6. 메인 결과
Table 1은 이 논문의 심장이다. 각 셀은 모든 값 중 최고 NDCG@10과, 그때 남긴 차원 비율 를 괄호 안에 함께 보여준다. 위첨자 는 완전 비지도, 는 PRF 기반, 는 라벨 지도 방식을 뜻한다.
SciFact
| Method | Qwen-0.6B | Qwen-4B | Qwen-8B | OpenAI | L2V-Mistral | L2V-LLaMA | GritLM |
|---|---|---|---|---|---|---|---|
| Baseline | 0.702 (100%) | 0.785 (100%) | 0.783 (100%) | 0.776 (100%) | 0.773 (100%) | 0.787 (100%) | 0.786 (100%) |
| Cutoff | 0.702 (100%) | 0.788 (86%) | 0.784 (98%) | 0.776 (98%) | 0.773 (100%) | 0.788 (84%) | 0.792 (60%) |
| Norm | 0.706 (64%) | 0.789 (40%) | 0.785 (32%) | 0.778 (80%) | 0.774 (62%) | 0.787 (92%) | 0.791 (28%) |
| DIME | 0.705 (98%) | 0.787 (94%) | 0.785 (94%) | 0.781 (82%) | 0.773 (100%) | 0.788 (98%) | 0.787 (98%) |
| Eclipse | 0.704 (98%) | 0.787 (98%) | 0.785 (94%) | 0.783 (94%) | 0.773 (100%) | 0.788 (98%) | 0.787 (98%) |
| Adapter | 0.774 (100%) | 0.849 (100%) | 0.883 (100%) | 0.871 (100%) | 0.843 (100%) | 0.882 (100%) | 0.883 (100%) |
| Ours | 0.845 (32%) | 0.899 (56%) | 0.883 (32%) | 0.897 (32%) | 0.830 (20%) | 0.884 (10%) | 0.906 (40%) |
| Ours@30% | 0.839 (30%) | 0.895 (30%) | 0.881 (30%) | 0.897 (30%) | 0.823 (30%) | 0.881 (30%) | 0.902 (30%) |
MS MARCO
| Method | Qwen-0.6B | Qwen-4B | Qwen-8B | OpenAI | L2V-Mistral | L2V-LLaMA | GritLM |
|---|---|---|---|---|---|---|---|
| Baseline | 0.562 (100%) | 0.683 (100%) | 0.646 (100%) | 0.681 (100%) | 0.613 (100%) | 0.562 (100%) | 0.536 (100%) |
| Cutoff | 0.562 (100%) | 0.683 (100%) | 0.651 (52%) | 0.690 (74%) | 0.623 (76%) | 0.565 (94%) | 0.554 (54%) |
| Norm | 0.575 (52%) | 0.687 (42%) | 0.653 (62%) | 0.688 (10%) | 0.617 (40%) | 0.569 (48%) | 0.537 (86%) |
| DIME | 0.595 (84%) | 0.701 (14%) | 0.664 (40%) | 0.702 (10%) | 0.638 (70%) | 0.582 (64%) | 0.566 (64%) |
| Eclipse | 0.602 (18%) | 0.702 (28%) | 0.668 (84%) | 0.700 (32%) | 0.641 (86%) | 0.588 (50%) | 0.565 (76%) |
| Adapter | 0.607 (100%) | 0.682 (100%) | 0.698 (100%) | 0.680 (100%) | 0.621 (100%) | 0.576 (100%) | 0.593 (100%) |
| Ours | 0.609 (44%) | 0.699 (20%) | 0.714 (20%) | 0.700 (34%) | 0.638 (24%) | 0.600 (26%) | 0.632 (40%) |
| Ours@30% | 0.601 (30%) | 0.693 (30%) | 0.709 (30%) | 0.696 (30%) | 0.634 (30%) | 0.593 (30%) | 0.631 (30%) |
NFCorpus
| Method | Qwen-0.6B | Qwen-4B | Qwen-8B | OpenAI | L2V-Mistral | L2V-LLaMA | GritLM |
|---|---|---|---|---|---|---|---|
| Baseline | 0.377 (100%) | 0.426 (100%) | 0.432 (100%) | 0.440 (100%) | 0.407 (100%) | 0.432 (100%) | 0.429 (100%) |
| Cutoff | 0.379 (86%) | 0.426 (100%) | 0.435 (32%) | 0.440 (100%) | 0.411 (62%) | 0.434 (56%) | 0.432 (62%) |
| Norm | 0.379 (62%) | 0.426 (96%) | 0.433 (80%) | 0.440 (90%) | 0.410 (58%) | 0.436 (60%) | 0.430 (92%) |
| DIME | 0.384 (94%) | 0.432 (80%) | 0.436 (86%) | 0.449 (84%) | 0.414 (50%) | 0.433 (98%) | 0.433 (24%) |
| Eclipse | 0.384 (90%) | 0.432 (50%) | 0.435 (40%) | 0.449 (78%) | 0.415 (56%) | 0.434 (94%) | 0.434 (94%) |
| Adapter | 0.371 (100%) | 0.427 (100%) | 0.419 (100%) | 0.428 (100%) | 0.417 (100%) | 0.442 (100%) | 0.434 (100%) |
| Ours | 0.396 (62%) | 0.451 (22%) | 0.455 (38%) | 0.459 (38%) | 0.412 (54%) | 0.445 (16%) | 0.462 (58%) |
| Ours@30% | 0.388 (30%) | 0.447 (30%) | 0.449 (30%) | 0.455 (30%) | 0.405 (30%) | 0.442 (30%) | 0.461 (30%) |
Table 1 (원논문): 전체 모델에 대한 peak 검색 효과(NDCG@10, 높을수록 좋음)와 그때 사용한 차원 비율(괄호). 위첨자 =완전 비지도, =PRF 기반, =라벨 지도. 각 데이터셋 블록의 마지막 행은 30% 고정 비율에서의 Ours 성능.
이 표에서 가장 먼저 눈에 들어오는 건 비지도 계열의 무력함이다. Cutoff, Norm, DIME, Eclipse는 SciFact에서 baseline 대비 거의 움직이지 못한다. Qwen-8B SciFact를 보면 baseline 0.783에서 DIME 0.785, Eclipse 0.785로 소수점 셋째 자리 수준의 변화에 그친다. 반면 라벨을 쓰는 Ours는 0.883까지 뛴다. +0.10에 이르는 이 격차가 논문 주장의 핵심 근거다. 가짜 신호로는 잡을 수 없는 선택 패턴이 라벨 증류로는 잡힌다는 것이다.
두 번째로 흥미로운 건 supervised adapter조차 이기지 못하는 지점들이다. 통념상 Adapter는 full 차원을 라벨로 최적화하니 강력할 것 같지만, MS MARCO와 NFCorpus에서는 오히려 baseline보다 떨어지는 경우가 적지 않다. NFCorpus Qwen-8B에서 Adapter는 0.419로 baseline 0.432보다 낮고, MS MARCO Qwen-4B에서도 0.682로 baseline 0.683에 못 미친다. 전역 변환이 특정 데이터셋에서는 오히려 정보를 뭉갤 수 있다는 신호다. 같은 설정에서 Ours는 NFCorpus Qwen-8B 0.455, MS MARCO Qwen-4B 0.699로 안정적으로 baseline을 넘어선다. 질의별 선택이 전역 변환보다 견고하다는 증거로 읽힌다.
세 번째는 사용 차원 비율이다. Ours가 peak를 찍는 지점이 대체로 20-40% 구간에 몰려 있다. L2V-LLaMA SciFact는 겨우 10%(0.884)에서, Qwen-8B MS MARCO는 20%(0.714)에서 최고점을 낸다. 절반 이상을 버려도 되는 게 아니라, 절반 이상을 버려야 더 좋아진다는 것이다. 이건 많은 차원이 단순히 중복(redundant)인 게 아니라 검색에 해로운(harmful) 노이즈라는 논문의 표현을 뒷받침한다.
다만 솔직하게 짚을 부분도 있다. L2V-Mistral에서는 이야기가 다르다. SciFact에서 Adapter(0.843)가 Ours(0.830)를 앞서고, NFCorpus에서는 Ours@30%(0.405)가 baseline(0.407)에도 못 미친다. 모든 인코더에서 일관되게 이긴다는 서술은 L2V-Mistral 앞에서는 조금 물러서야 한다. 저자들도 "consistently matches or improves ... often surpasses"라는 신중한 표현을 쓴 이유가 여기 있어 보인다.
마지막으로 실무적으로 반가운 결과는 Ours@30% 행이다. 30%라는 단일 고정 비율만 써도 설정별 peak에 근접한다. 예컨대 GritLM SciFact는 peak 0.906(40%)인데 30%에서도 0.902를 낸다. 를 데이터셋마다 정밀하게 튜닝하지 않아도 30%를 기본값으로 두면 대부분 잘 동작한다는 뜻이라, 배포 관점에서 이 안정성이 상당히 유용하다.
7. 남긴 차원 비율의 효과
Figure 2는 남긴 차원 비율 의 함수로 검색 효과가 어떻게 변하는지를 6개 모델에 대해 그린다.
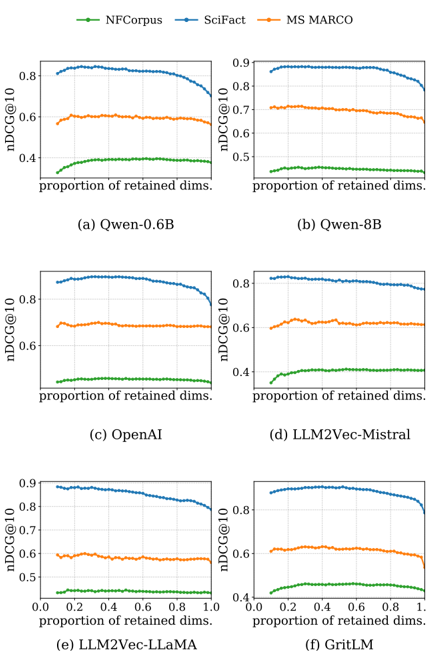
Figure 2 (원논문): 남긴 차원 비율 에 따른 NDCG@10. 각 패널은 하나의 모델(Qwen-0.6B, Qwen-8B, OpenAI, LLM2Vec-Mistral, LLM2Vec-LLaMA, GritLM)에 대응하며, 초록=NFCorpus, 파랑=SciFact, 주황=MS MARCO. 대체로 20-50% 구간에서 정점에 도달한 뒤 평평해진다.
여섯 패널이 놀랄 만큼 비슷한 모양을 그린다. 비율을 0에서 올리면 성능이 가파르게 오르다가 대략 20-40% 지점에서 정점을 찍고, 그 뒤로는 평평한 고원(plateau)을 형성한다. 50%를 넘어가면 차원을 더 넣어봐야 이득이 거의 없고, 일부 경우엔 오히려 살짝 떨어진다. 특히 LLM2Vec-Mistral(패널 d)의 SciFact 곡선처럼 100%에 가까워질 때 눈에 띄게 하락하는 모양은, 뒤쪽 차원들이 노이즈로 작용한다는 걸 시각적으로 보여준다.
이 고원이 실무적으로 중요한 이유는, 정확한 최적 를 몰라도 20-40% 사이 아무 값이나 잡으면 peak에 근접한 성능이 나온다는 뜻이기 때문이다. 예측기가 질의 정보를 소수의 고가치 차원에 집중시키고 덜 중요한 성분은 안전하게 버린다는 해석과 맞물린다. MRL로 학습된 Qwen 계열뿐 아니라 MRL이 아닌 GritLM, LLM2Vec에서도 같은 패턴이 나온다는 게, 차원 중복이 특정 학습 방식의 부산물이 아니라 dense 임베딩의 일반적 성질임을 시사한다.
8. Discussion
8.1 오라클 차원 중요도의 Ablation
여기서 던지는 질문은 "라벨이 있을 때 오라클로 고를 수 있는 성능의 상한선은 어디까지이며, 양성 가중치와 하드 네거티브 마이닝이 그 상한선을 얼마나 끌어올리는가"다. SciFact(단일 레벨)와 NFCorpus(다단계)에서 Qwen과 OpenAI로 재검증한 결과가 Figure 3다.
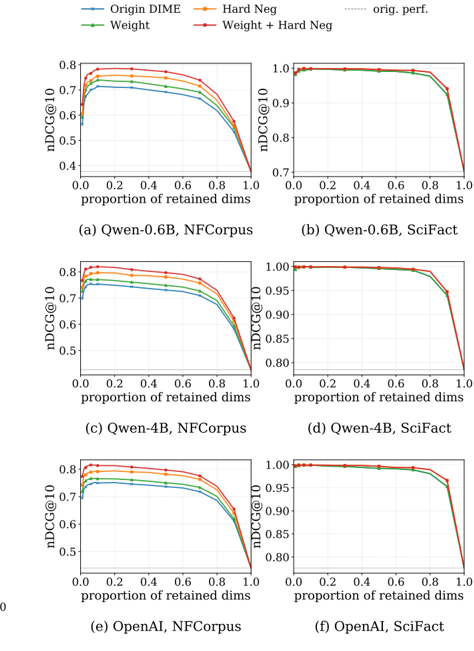
Figure 3 (원논문): 오라클 방식 차원 선택의 상한선 분석. Origin DIME(파랑), Weight(양성 가중치 추가, 초록), Hard Neg(하드 네거티브 추가, 주황), Weight + Hard Neg(둘 다, 빨강)를 남긴 차원 비율에 따라 비교. 회색 점선은 원본 full 차원 성능(orig. perf.). 이득은 20% 부근에서 정점을 찍고, 양성 가중치와 하드 네거티브가 상한선을 추가로 끌어올린다.
세 가지가 읽힌다. 첫째, 오라클 이득이 약 20% 차원 선택에서 정점을 찍고 20-80% 구간에서 안정적으로 유지된다. 이는 원조 DIME 논문에서 보고된 경향과 일치하므로, 저자들이 자신들의 세팅에서 DIME의 기본 관찰을 재현하는 데 성공했다는 뜻이다. 둘째, 네 곡선의 순서가 일관되다. Origin DIME이 가장 아래, 여기에 양성 가중치(Weight)나 하드 네거티브(Hard Neg)를 각각 더하면 위로 올라가고, 둘을 합친 Weight + Hard Neg(빨강)가 가장 높다. 4.1절에서 도입한 두 설계가 각각 독립적으로, 그리고 함께 오라클 상한선을 밀어올린다는 걸 보여준다. 셋째, NFCorpus(다단계 라벨) 패널에서 개선폭이 SciFact(단일 레벨)보다 커 보이는데, 다단계 라벨이 있을 때 등급별 가중치 가 더 풍부한 신호를 준다는 설계 의도와 부합한다.
이 ablation의 위치를 짚어두면, 이건 예측기 성능이 아니라 오라클(교사)의 품질을 검증하는 실험이다. 교사가 좋아야 학생이 배울 게 있으므로, 양성 가중치와 하드 네거티브가 교사 분포를 더 좋게 만든다는 사실이 방법 전체의 토대가 된다.
8.2 하이퍼파라미터 강건성
실용성을 가르는 건 결국 "이 방법이 세팅에 얼마나 예민한가"다. 저자들은 모든 모델-데이터셋 쌍에서 강건성을 점검하되, 대표로 Qwen-8B와 SciFact 조합의 민감도 곡선을 본문에 제시한다(전체는 Appendix A.1). 온도 , 하드 네거티브 풀 크기 , in-batch 음성 수 , 학습 epoch를 하나씩 바꿔가며 여러 차원 수에서 평가하는 one-at-a-time 방식이다.
정리하면, 와 은 차원 수 전반에 걸쳐 영향이 미미해서 보수적으로 , 를 기본값으로 고정했다. 최고 성능은 근처에서 나오고, 성능은 대략 100 epoch 이후 포화된다. 무작위 시드 민감도 실험(기본 설정으로 시드만 바꿔 10회 반복)에서는 NDCG@10 변동이 미미해, 초기화 무작위성에 크게 흔들리지 않는다는 걸 확인했다. 구체적인 곡선들은 Appendix 섹션에서 다룬다.
8.3 차원 선택의 일관성 분석
예측기가 그럴듯한 구조를 학습했다면, 비슷한 질의는 비슷한 차원을 고르고 다른 질의는 다른 차원을 골라야 한다. 이 해석 가능성(interpretability)을 정량화하기 위해, 각 모델(Qwen-4B, Qwen-8B, OpenAI, GritLM)과 데이터셋(SciFact, NFCorpus)에서 테스트 스플릿의 모든 질의 쌍을 놓고 고정 차원 로 실험한다. 질의 쌍 에 대해 질의 유사도 와 선택된 차원 집합의 Jaccard 유사도 를 구하고, 둘 사이의 Pearson 상관을 잰다.
| Model | Dataset | Pearson |
|---|---|---|
| Qwen-4B | SciFact | 0.541 |
| Qwen-8B | SciFact | 0.415 |
| OpenAI | SciFact | 0.498 |
| GritLM | SciFact | 0.478 |
| Qwen-4B | NFCorpus | 0.335 |
| Qwen-8B | NFCorpus | 0.361 |
| OpenAI | NFCorpus | 0.387 |
| GritLM | NFCorpus | 0.319 |
Table 2 (원논문): 질의 유사도 와 선택 차원의 Jaccard 유사도 사이의 Pearson 상관(), SciFact와 NFCorpus 테스트 세트 기준.
상관은 대체로 0.3-0.5 구간의 중간 정도 양의 값이다. 비슷한 질의가 비슷한 차원을 공유하는 경향이 있고, 예측기가 이 구조를 학습되지 않은 테스트 질의에서도 잡아낸다는 뜻이다. 흥미로운 대비는 SciFact(0.42-0.54)가 NFCorpus(0.32-0.39)보다 상관이 높다는 점이다. SciFact가 좁은 과학 주장 검증 도메인이라 질의 간 의미 구조가 더 규칙적이고, 그래서 차원 선택 패턴도 더 예측 가능해지는 것으로 볼 수 있다. 다만 상관이 완벽하지 않은 만큼, 예측기가 순전히 질의 유사도만 따라가는 게 아니라 질의별로 어느 정도 특화된 선택도 한다는 해석이 가능하다.
8.4 LLM 생성 질의로 학습하기
지도 라벨 없이도 이 예측기를 학습할 수 있을까? 저자들은 문서에서 LLM으로 pseudo-query를 생성하는() 합성 학습 세트를 만든다. 각 pseudo-query를 원본 문서와 짝지어 양성으로 삼고, 나머지 코퍼스에서 음성을 샘플링한 뒤, 지도 세팅과 동일한 오라클 구성과 손실로 예측기를 학습시킨다.
| Model | Dataset | Full | Unsup | Supervised |
|---|---|---|---|---|
| GritLM | SciFact | 0.786 | 0.790 | 0.902 |
| GritLM | NFCorpus | 0.439 | 0.441 | 0.459 |
| GritLM | MS MARCO | 0.536 | 0.602 | 0.626 |
| Qwen-8B | SciFact | 0.783 | 0.785 | 0.899 |
| Qwen-8B | NFCorpus | 0.432 | 0.435 | 0.455 |
| Qwen-8B | MS MARCO | 0.646 | 0.697 | 0.715 |
| OpenAI | SciFact | 0.776 | 0.778 | 0.897 |
| OpenAI | NFCorpus | 0.440 | 0.441 | 0.459 |
| OpenAI | MS MARCO | 0.681 | 0.694 | 0.700 |
Table 3 (원논문): Full 임베딩, LLM 생성 pseudo-query로 학습한 Unsup 예측기, 라벨로 학습한 Supervised 예측기의 최고 성능 비교. NDCG@10(테스트 스플릿), 모델/데이터셋별 최고값 볼드.
결과가 데이터셋 성격에 따라 확 갈린다. MS MARCO에서는 Unsup이 상당한 이득을 낸다. GritLM은 0.536에서 0.602로, Qwen-8B는 0.646에서 0.697로 뛰어, 지도 학습이 얻은 개선폭의 큰 부분을 라벨 없이 회수한다. 반면 SciFact와 NFCorpus에서는 Unsup의 개선이 소수점 셋째 자리 수준으로 미미하다. GritLM SciFact는 Full 0.786 → Unsup 0.790에 그친다.
이 대비의 원인은 pseudo-query의 분포에 있다. MS MARCO는 웹 스타일의 일반적 자연어 질문이 많고 데이터도 풍부해서, LLM이 만든 합성 질의가 실제 질의 분포와 가깝다. 반면 SciFact 같은 좁은 과학 도메인에서는 LLM 생성 질의가 실제 도메인 질의를 잘 흉내 내지 못한다. 저자들의 결론은 명확하다. 합성 질의는 타깃 질의 분포가 일반적 자연어 질문에 가깝고 데이터가 충분할 때 효과적이며, 전문적이고 저자원인 도메인에서는 고품질 태스크별 라벨이 여전히 중요하다는 것이다. 이건 8절 한계에서 다시 언급되는 지점이기도 하다.
8.5 Adapter와 질의별 선택의 결합
Adapter(임베딩 공간의 전역 품질 개선)와 이 논문의 방법(질의별 차원 선택)은 성격이 상보적이다. 그렇다면 둘을 쌓으면 더 좋아질까? 저자들은 두 가지 하이브리드를 실험한다. (i) supervised adapter 위에 DIME-PRF나 Eclipse-PRF를 얹기, (ii) 베이스 인코더 대신 adapter 출력 위에서 차원 선택기를 학습하기.
| Method | MS MARCO Qwen-8B | MS MARCO GritLM | SciFact Qwen-8B | SciFact GritLM |
|---|---|---|---|---|
| Baseline | 0.646 | 0.536 | 0.783 | 0.786 |
| A (Adapter) | 0.698 | 0.593 | 0.883 | 0.883 |
| E (Eclipse) | 0.668 | 0.565 | 0.785 | 0.787 |
| O (Ours) | 0.714 | 0.632 | 0.883 | 0.906 |
| A + E | 0.704 | 0.605 | 0.883 | 0.883 |
| A + O | 0.731 | 0.637 | 0.883 | 0.883 |
Table 4 (원논문): Adapter와 질의별 차원 선택 결합 효과. 두 대표 데이터셋·모델에서의 Peak NDCG@10. A=Adapter, E=Eclipse, O=Ours이며 A+E, A+O는 각각의 조합.
MS MARCO에서는 결합이 통한다. Adapter+Ours가 Qwen-8B 0.731, GritLM 0.637로 전체 최고를 찍는다. 단독 Ours(0.714, 0.632)나 단독 Adapter(0.698, 0.593)보다 확실히 높다. 그런데 SciFact에서는 정반대다. 단독 Ours가 GritLM에서 0.906으로 가장 좋은데, Adapter+Ours는 0.883으로 오히려 adapter 수준으로 되돌아간다. 결합이 항상 이득이 아니라 데이터셋에 따라 손해가 될 수도 있다는 것이다.
왜 이런 차이가 날까? 저자들은 adapter가 "중요한 질의 차원"의 분포를 어떻게 바꾸는지를 분석한다. GritLM과 Qwen-8B로 MS MARCO와 SciFact에서, 선택기가 고른 상위 2048개 차원 집합의 Jaccard 유사도를 잰다. 각 데이터셋에서 학습 세트로부터 질의 쌍 2만 개를 샘플링해, adapter가 있을 때와 없을 때의 질의 간 차원 겹침을 비교한다.
| Method | MS MARCO Qwen-8B | MS MARCO GritLM | SciFact Qwen-8B | SciFact GritLM |
|---|---|---|---|---|
| O (Ours) | 0.369 | 0.360 | 0.339 | 0.336 |
| A + O | 0.392 | 0.397 | 0.479 | 0.506 |
Table 5 (원논문): 질의 쌍 사이 선택된 중요 차원의 평균 Jaccard 유사도. 데이터셋별 2만 개 질의 쌍으로 계산. 높을수록 겹침이 큼. A=Adapter, O=Ours, A+O는 조합.
이 표가 앞의 모순을 깔끔하게 설명한다. Adapter 없이는 Jaccard가 데이터셋 전반에서 0.34-0.37로 비슷하다. Adapter를 더하면 MS MARCO는 0.36 → 0.39로 소폭만 오르는데, SciFact는 0.34 → 0.48-0.51로 크게 뛴다. SciFact에서는 adapter가 "중요 차원"이라는 개념을 질의 전반에 걸쳐 균질화(homogenize)해 버린다는 뜻이다. 질의마다 다른 차원을 고를 여지가 줄어드니, 그 위에 질의별 선택기를 또 얹어봐야 특화할 게 별로 없다. 반대로 MS MARCO는 adapter를 얹어도 질의 간 이질성이 유지되므로, 질의별 선택기가 여전히 추가 이득을 낸다.
이 분석이 개인적으로 이 논문에서 가장 설득력 있는 부분이다. Table 4의 얼핏 모순돼 보이는 결과를 Table 5의 Jaccard 지표로 메커니즘 수준에서 풀어냈다. 질의별 선택이 언제 도움이 되는지(질의 간 이질성이 클 때)를 정량 지표로 짚어준 셈이다.
9. Appendix: 하이퍼파라미터 상세와 민감도
부록 A.1은 Qwen-8B와 SciFact 조합에서 하이퍼파라미터를 하나씩 바꿔가며 여러 차원 수에서 성능을 측정한 민감도 곡선들을 담고 있다. 탐색 범위는 epoch (기본 100), 온도 (기본 0.01), 하드 네거티브 풀 크기 (기본 1000), in-batch 음성 수 (기본 64)이다.
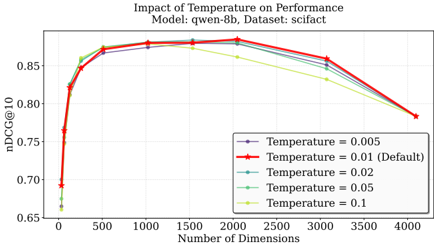
Figure 4 (원논문): 온도 의 영향(Qwen-8B, SciFact). x축은 남긴 차원 수, y축은 NDCG@10.
온도 곡선을 보면 어느 든 500-2000차원 구간에서 봉우리를 이루는 공통 모양이 나오지만, 세부적으로는 (빨강, 기본값)이 넓은 구간에서 가장 안정적으로 높다. 가 0.1처럼 커지면(연노랑) 전반적으로 곡선이 아래로 처지는데, 분포가 너무 완만해져 소수 고가치 차원에 중요도를 몰아주지 못하기 때문이다. 앞서 4.1절에서 최적값이 뾰족한 분포 쪽이라고 한 관찰이 여기서 시각적으로 확인된다.
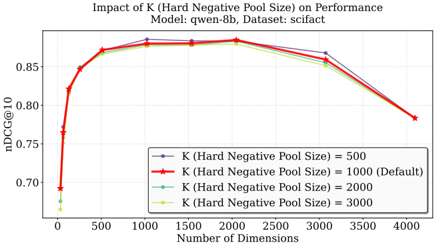
Figure 5 (원논문): 하드 네거티브 풀 크기 의 영향(Qwen-8B, SciFact).
곡선들은 거의 포개진다. 500이든 3000이든 곡선이 사실상 구분되지 않을 만큼 겹친다. 하드 네거티브 풀 크기가 성능에 미치는 영향이 미미하다는 8.2절의 서술 그대로다. 그래서 보수적으로 을 기본값으로 고정할 수 있었다.
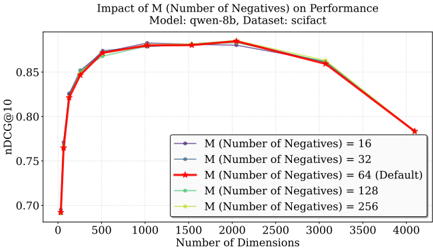
Figure 6 (원논문): in-batch 음성 수 의 영향(Qwen-8B, SciFact).
역시 16부터 256까지 곡선이 거의 하나로 뭉친다. 음성 개수에도 둔감하다는 뜻이라, 이 방법이 음성 샘플링 세부 설정에 크게 의존하지 않는다는 걸 보여준다. 와 모두에 둔감하다는 건 실무 배포에서 반가운 성질이다. 이 두 개는 대충 잡아도 된다는 뜻이기 때문이다.
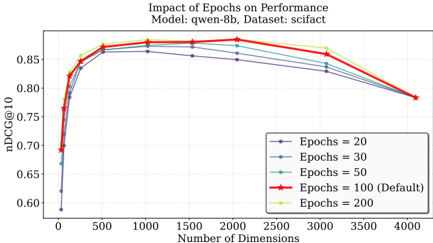
Figure 7 (원논문): 학습 epoch 수의 영향(Qwen-8B, SciFact).
epoch는 앞의 두 파라미터와 달리 눈에 띄는 차이를 만든다. 20 epoch(진보라)는 확연히 아래에 깔리고, 100(빨강, 기본값)과 200(연노랑)이 위쪽에 모인다. 대략 100 epoch 이후 성능이 포화된다는 서술과 일치한다. 학습을 충분히 돌리는 게 튜닝보다 중요하다는 실무적 함의가 읽힌다.
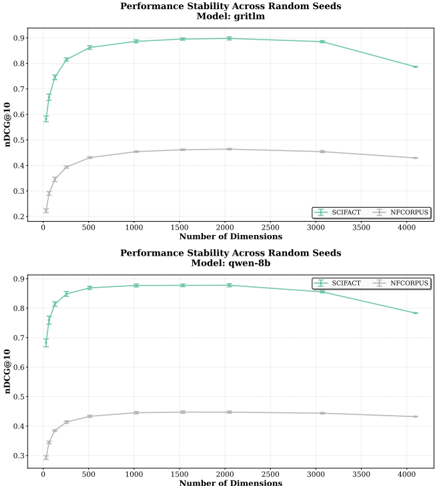
Figure 8 (원논문): 무작위 시드 민감도(위: GritLM, 아래: Qwen-8B). SciFact(초록)와 NFCorpus(회색)에서 오차 막대는 시드 간 NDCG@10의 ±1 표준편차. 변동이 미미해 전반적 강건성을 보여준다.
시드 민감도 그림에서 오차 막대가 대부분 점 크기와 비슷할 만큼 작다. 10개 시드로 반복해도 NDCG@10 변동이 미미하다는 뜻이다. 특히 봉우리 구간(500-2000차원)에서 표준편차가 눈에 띄지 않을 정도라, 예측기 학습이 초기화 무작위성에 안정적이라는 주장을 뒷받침한다. 완전연결층 하나짜리 단순한 모델이라 학습이 잘 수렴한다는 점도 이 안정성에 기여했을 것이다.
부록 A.2는 전체 하이퍼파라미터 탐색 범위를 정리한다.
| Hyperparameter | Search range / Value |
|---|---|
| 탐색(검증 세트로 모델 선택) | |
| Temperature | {0.0001, 0.0002, 0.0005, 0.001, 0.002, 0.005, 0.01, 0.02, 0.05} |
| Training epochs | {20, 30, 50, 75, 100, 200} |
| 고정(모든 모델·데이터셋 공유) | |
| Optimizer | AdamW |
| Learning rate | 1e-4 |
| Weight decay | 0.01 |
| Batch size | 256 |
| Dropout | 0.1 |
| Hard-negative pool size | 1000 |
| In-batch negatives | 64 |
Table 6 (원논문): 실험에 사용한 하이퍼파라미터 탐색 범위.
이 표에서 눈여겨볼 건 실제 검증 세트로 탐색한 파라미터가 온도와 epoch 딱 두 개뿐이라는 점이다. 나머지는 모든 모델과 데이터셋에 공통으로 고정했다. 앞서 본 민감도 분석이 이 결정을 정당화한다. 이 성능에 둔감하니 굳이 데이터셋마다 탐색할 필요가 없다는 것이다. 튜닝 부담이 작다는 건 방법의 실용성을 높이는 요소다.
10. 한계
저자들이 밝힌 한계는 두 가지다. 첫째, 오라클 차원 중요도 점수를 만들려면 지도 관련성 신호가 필요하다. LLM 생성 pseudo-query로 대체를 시도했지만, 8.4절에서 봤듯 작고 전문적인 도메인에서는 고품질 라벨이 여전히 중요하다. 둘째, 이 방법은 얼어붙은 임베딩 위에서 질의별 차원 선택만 수행할 뿐 베이스 인코더 자체를 개선하지 못한다. 그래서 전체 효과의 상한선이 베이스 retriever의 품질에 묶인다.
리뷰어 관점에서 몇 가지를 더 보태면,
먼저 in-domain 평가만 했다는 점이 마음에 걸린다. BEIR의 train/test 스플릿을 쓰되 도메인 간 전이는 하지 않았다. SciFact에서 baseline 0.78이 Ours 0.90으로 +0.12나 뛰는 큰 폭의 개선이, 같은 데이터셋 내에서 학습·평가한 결과라는 점을 감안하면 조심스럽게 읽어야 한다. dense retrieval의 실전 가치는 대체로 zero-shot 일반화에서 나오는데, 학습한 도메인 밖에서도 이 차원 선택 패턴이 통하는지는 이 논문만으로는 알 수 없다. 예측기가 도메인 특유의 지름길(shortcut)을 학습했을 가능성을 배제하기 어렵다.
다음으로 성능이 항상 일관되지는 않는다. 앞서 봤듯 L2V-Mistral에서는 SciFact에서 Adapter에 지고 NFCorpus@30%에서는 baseline에도 못 미친다. "모든 인코더에서 개선"이라기보다 "대부분의 인코더에서 개선"이 정확한 서술이다.
마지막으로 효율 이야기가 빠져 있다. 20-40% 차원만 쓴다는 건 유사도 계산 비용이 준다는 뜻일 수 있지만, 마스킹 방식이 선택되지 않은 차원을 0으로 채워 여전히 차원 벡터를 유지하므로, ANN 인덱스 상에서 실제 연산량이나 지연시간(latency)이 얼마나 줄어드는지는 보고되지 않았다. 이 논문의 목표가 효율이 아닌 효과라는 걸 감안해도, 차원을 줄인다는 프레이밍을 쓰는 이상 실측 효율 수치가 있었다면 설득력이 더 컸을 것이다.
11. 강점과 의의
비판을 했지만 이 논문의 기여는 분명하다.
가장 큰 강점은 문제를 정확히 겨냥한 단순함이다. DIME의 질의별 선택과 Adapter의 라벨 활용, 두 계열의 빈틈을 "라벨로 만든 오라클을 예측기에 증류한다"는 한 문장으로 메웠다. 예측기가 완전연결층 하나라는 점이 특히 인상적이다. 무겁지 않으면서도 supervised adapter와 PRF 방법을 여러 설정에서 앞선다.
배포 친화성도 실질적이다. 문서 임베딩과 ANN 인덱스를 건드리지 않고 질의 쪽만 마스킹하므로, 이미 FAISS 같은 인덱스를 운영 중인 시스템에 재인덱싱 없이 얹을 수 있다. 게다가 30% 고정 비율이 설정별 peak에 근접하고, 에 둔감하며, 시드에도 안정적이라 튜닝 부담이 작다. 실무 채택 관점에서 이 안정성 묶음은 과소평가되기 쉬운 미덕이다.
관점의 전환도 짚을 만하다. Matryoshka 계열이 "성능을 유지하면서 차원을 줄이자"였다면, 이 논문은 "차원을 줄여서 성능을 올리자"로 방향을 뒤집었다. 많은 차원이 중복이 아니라 검색에 해로운 노이즈라는 주장을, 여섯 개 인코더에 걸친 일관된 봉우리-고원 패턴(Figure 2)으로 뒷받침한다.
마지막으로 분석의 성실함이다. 오라클 ablation(Figure 3), 일관성 상관(Table 2), 라벨 없는 학습(Table 3), Adapter 결합의 조건부 이득을 Jaccard로 설명한 부분(Table 4, 5)까지, 단순히 "우리가 이겼다"에 그치지 않고 "언제, 왜 통하는가"를 파고든다. 특히 8.5절에서 결합이 SciFact에서는 손해가 되는 이유를 차원 겹침의 균질화로 풀어낸 분석은, 질의별 선택이라는 접근의 작동 조건을 명확히 해준다는 점에서 후속 연구에도 유용한 통찰이다.
정리하면, 이 논문은 화려한 신규 아키텍처 없이 기존 두 계열의 장점을 영리하게 조합해, 얼어붙은 dense 임베딩에서 질의별로 유용한 차원만 골라내는 가볍고 실용적인 방법을 제시했다. In-domain 세팅과 일부 인코더에서의 비일관성이라는 유보를 달더라도, "지도 라벨로부터 질의 단위 차원 중요도를 직접 학습해 질의만으로 마스킹한다"는 접근을 처음으로 실증했다는 점에서 dense retrieval의 차원 중복 연구에 뚜렷한 한 걸음을 보탰다.