논문 리뷰
논문 리뷰: LoRAMoE: Alleviating World Knowledge Forgetting in Large Language Models via MoE-Style Plugin
명령어 데이터를 대규모로 늘리면 다운스트림 태스크 성능은 오르지만 사전학습에서 얻은 세계 지식(world knowledge)이 무너진다. LoRAMoE는 백본을 얼린 채 여러 LoRA를 전문가로 삼고 라우터로 묶는 MoE 스타일 플러그인으로, 전문가 일부를 세계 지식 전담으로 "부드럽게" 밀어붙여 두 마리 토끼를 동시에 잡는다.
1. 들어가며
대형 언어 모델(LLM)을 실제 서비스에 붙일 때 거의 예외 없이 거치는 단계가 지도 미세조정(Supervised Fine-Tuning, SFT)이다. 사전학습된 모델은 문장을 이어 쓰는 능력은 뛰어나지만 사람의 지시를 따르는 데는 서툴기 때문에, 명령어-응답 쌍으로 한 번 더 학습시켜 정렬(alignment)을 맞춘다. 그리고 "더 많은 태스크를 잘하게 하려면 데이터를 더 넣으면 되지 않을까?"라는 생각은 지극히 자연스럽다. 실제로 요약, 번역, 자연어 추론 같은 태스크는 데이터를 늘릴수록 성능이 좋아진다.
문제는 그 대가다. 이 논문은 명령어 데이터를 10K에서 3M, 심지어 10M까지 밀어붙이면 다운스트림 성능은 확실히 오르는데, 그 과정에서 모델이 사전학습 때 흡수한 사실 지식(fact/world knowledge)이 급격히 망가진다는 것을 정량적으로 보여준다. TriviaQA, Natural Questions 같은 폐쇄형 질의응답(Closed-Book QA, CBQA) 벤치마크 점수가 베이스라인 아래로 곤두박질치는 것이다. SFT를 통해 얻는 것과 잃는 것 사이에 근본적인 충돌이 있다는 얘기다.
Fudan 대학과 Hikvision 연구진이 ACL 2024에 발표한 LoRAMoE는 이 충돌을 정면으로 다룬다. 접근은 이름 그대로다. 백본 모델은 통째로 얼려서(freeze) 사전학습 지식을 그대로 보존하고, 여러 개의 저랭크 어댑터(LoRA)를 전문가(expert)로 붙인 뒤 라우터 네트워크로 묶는 - Mixture-of-Experts(MoE)의 플러그인 버전이다. 여기에 "Localized Balancing Constraint"라는 손실 항을 하나 더 얹어, 전문가 그룹의 절반은 세계 지식 관련 태스크를, 나머지 절반은 그 외 다운스트림 태스크를 담당하도록 부드럽게 유도한다. 결과적으로 데이터를 아무리 늘려도 세계 지식은 지키면서 멀티태스크 성능은 끌어올리는 구조를 만들어낸다.
개인적으로 이 논문이 좋았던 지점은, 방법론 자체의 참신함보다 "문제를 얼마나 깔끔하게 진단했느냐"에 있다. 망각이 일어난다는 관찰에서 그치지 않고, 그것이 되돌릴 수 없는(irreversible) 손상임을 통제된 실험으로 못 박은 뒤 해법을 제시하는 흐름이 설득력 있다.
2. 논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | LoRAMoE: Alleviating World Knowledge Forgetting in Large Language Models via MoE-Style Plugin |
| 저자 | Shihan Dou*, Enyu Zhou*, Yan Liu, Songyang Gao 외 (Fudan University, Hikvision Inc.) |
| 학회 | ACL 2024 (Long Papers), Bangkok, Thailand |
| 코드 | github.com/Ablustrund/LoRAMoE |
| 백본 | LLaMA-2-7B |
3. 동기: 데이터를 늘리면 지식이 무너진다
논문의 출발점은 하나의 관찰이다. 명령어 데이터를 늘리면 태스크마다 반응이 정반대로 갈린다는 것.
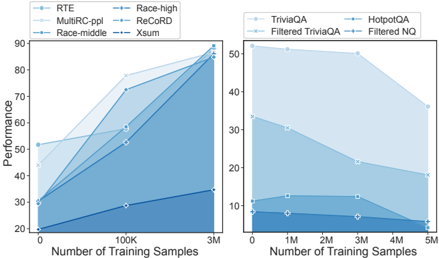
Figure 1 (원논문): (왼쪽) 미세조정 데이터를 10K에서 3M으로 늘리면 여러 다운스트림 태스크(RTE, MultiRC, Race, ReCoRD, Xsum 등)의 성능이 크게 향상된다. (오른쪽) 반대로 세계 지식을 측정하는 벤치마크(TriviaQA, NQ, HotpotQA 등)는 데이터가 늘수록 성능이 지속적으로 하락한다.
Figure 1의 왼쪽과 오른쪽을 나란히 놓고 보면 대비가 선명하다. 왼쪽에서 RTE, Race-middle, ReCoRD 같은 다운스트림 태스크들은 0에서 3M으로 데이터가 늘수록 성능 곡선이 우상향한다. 반면 오른쪽의 세계 지식 벤치마크들은 0에서 5M까지 데이터가 늘수록 오히려 우하향한다. 특히 TriviaQA는 완만하지만 꾸준히 떨어지고, train-test 중복을 제거한 Filtered TriviaQA는 초반부터 꺾인다. 같은 학습 과정이 어떤 능력은 키우고 어떤 능력은 깎아먹는, 전형적인 트레이드오프다.
여기서 CBQA를 "세계 지식의 척도"로 쓰는 이유를 짚고 넘어갈 필요가 있다. 폐쇄형 QA는 문서를 참조하지 않고 모델 파라미터 안에 저장된 지식만으로 답해야 하는 태스크다. 즉 이 점수가 떨어진다는 건 모델이 파라미터에 담고 있던 사실 지식이 훼손되고 있다는 신호로 읽을 수 있다.
3.1 발산하는 추세 (A Diverging Trend)
저자들은 이 현상을 더 넓은 태스크 범위에서 재확인한다. 7개 카테고리, 총 500만 개 샘플로 구성한 데이터셋으로 LLaMA-2-7B를 SFT하면서 데이터 양을 늘려가며 태스크별 성능을 추적했다.
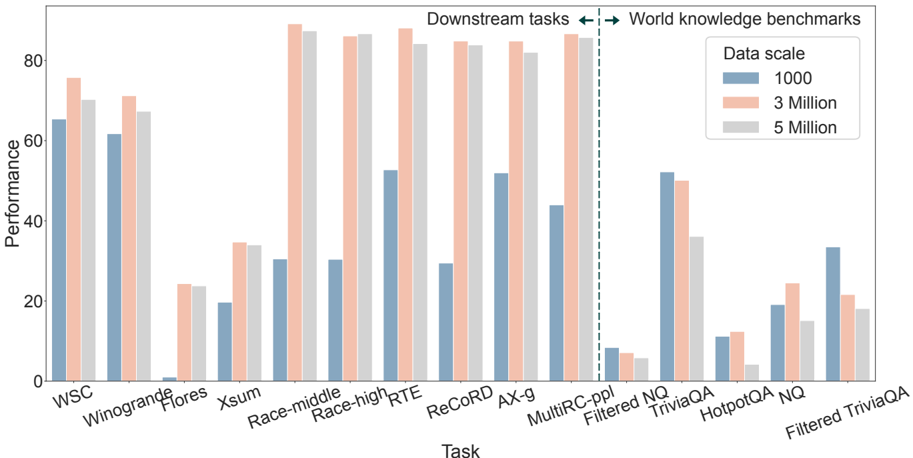
Figure 2 (원논문): 미세조정 데이터를 1000 / 3M / 5M으로 늘렸을 때 태스크별 성능. 점선 왼쪽은 다운스트림 태스크, 오른쪽은 세계 지식 벤치마크. 다운스트림 태스크는 향상 후 안정화되는 반면, 세계 지식 벤치마크는 큰 폭으로 하락한다.
Figure 2는 데이터 규모(1000, 3 Million, 5 Million)를 색으로 구분해 15개 태스크의 성능을 막대로 보여준다. 점선 왼쪽 다운스트림 태스크 군을 보면, 대부분 1000개(파란색)에서 3M(주황색)으로 갈 때 크게 뛰고 5M(회색)에서는 비슷하게 유지된다. Race-middle이 30에서 89로, Flores가 0.1에서 24로 뛰는 식이다. 성능이 어느 지점에서 포화되며 안정된다는 것이 이 그림의 메시지다.
반대로 점선 오른쪽의 세계 지식 벤치마크는 데이터가 늘수록 막대가 낮아진다. TriviaQA는 3M에서 5M으로 갈 때 눈에 띄게 주저앉고, HotpotQA와 Filtered TriviaQA도 마찬가지다. 다운스트림 태스크가 포화 후 정체되는 것과 달리, 세계 지식은 정체가 아니라 하락한다는 점이 이 그림의 핵심 관찰이다. 데이터를 더 넣는 것이 세계 지식에는 순수한 손해라는 뜻이다.
3.2 되돌릴 수 없는 지식 망각 (Irreversible Knowledge Forgetting)
여기서 저자들은 한 걸음 더 들어간다. CBQA 점수가 떨어지는 게 정말 "지식이 파괴되어서"인지, 아니면 단지 "지시 정렬이 안 맞아서"인지 구분해야 하기 때문이다. 이 둘은 처방이 완전히 다르다.
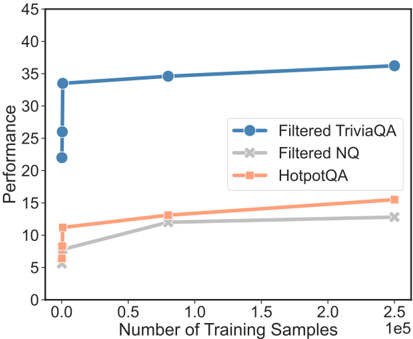
Figure 3 (원논문): CBQA 데이터만으로 학습했을 때 세계 지식 벤치마크 성능. 아주 적은 샘플로도 성능이 크게 오른 뒤 이후로는 거의 평평하게 유지된다.
먼저 Figure 3. CBQA 데이터 25만 개만으로 미세조정하되, train-test 중복이 없는 테스트셋(Filtered NQ, Filtered TriviaQA)으로 평가했다. 곡선을 보면 초반 1%(약 1000개) 샘플에서 성능이 급등하고 그 뒤로는 데이터를 아무리 부어도 거의 평평하다. 이건 무엇을 의미하는가. 초반의 급등은 "이미 모델 안에 있던 지식"을 인간의 지시 형식에 맞춰 정렬하는 과정이고, 그 정렬이 끝나면 - 테스트셋에 중복이 없으니 - 새 샘플을 넣어도 더 배울 게 없다는 것이다. 결국 벤치마크 점수는 사전학습에서 얻은 지식의 양에 좌우된다는 결론이 나온다.
그렇다면 대규모 SFT 후 CBQA 점수가 떨어지는 건 지식 자체가 손상되었기 때문이라는 가설이 자연스럽게 선다. 이를 검증하기 위해 저자들은 2단계 실험을 설계했다. 먼저 CBQA를 제외한 3M 데이터로 미세조정한 뒤, 그 모델을 다시 CBQA 데이터로 미세조정한다. 만약 지식이 멀쩡한데 정렬만 틀어진 거라면, 2단계에서 CBQA로 다시 정렬하면 점수가 회복되어야 한다.
| Task Name | Baseline (LLaMA-2-7B) | SFT solely on CBQA | Two-stage Fine-tuning |
|---|---|---|---|
| Filtered TriviaQA | 33.5 | 36.22 | 13.7 |
| Filtered NQ | 7.8 | 12.8 | 3.6 |
| HotpotQA | 11.2 | 16.1 | 7.1 |
Table 1 (원논문): 왼쪽부터 원본 LLaMA-2-7B, CBQA만으로 튜닝한 모델, 3M 명령어로 튜닝한 뒤 CBQA로 튜닝한 2단계 모델. 대규모 SFT를 거친 모델은 이후 CBQA로 재정렬해도 지식 응답 능력이 회복되지 않고 베이스라인 아래에 머문다.
결과는 가설을 뒷받침한다. 'SFT solely on CBQA' 열은 원본 모델을 CBQA로만 정렬한 경우로, 세 벤치마크 모두 베이스라인보다 오른다(예: Filtered TriviaQA 33.5 → 36.22). 그런데 대규모 SFT를 먼저 거친 뒤 CBQA로 재정렬한 2단계 모델은 세 벤치마크 모두 베이스라인보다도 한참 낮다(Filtered TriviaQA 33.5 → 13.7, Filtered NQ 7.8 → 3.6). 회복은커녕 반토막 이하다.
해석은 명확하다. 1단계의 대규모 미세조정이 이미 파라미터 안의 지식을 훼손했기 때문에, 2단계에서 아무리 CBQA로 다시 정렬하려 해도 "정렬할 지식 자체가 사라져" 손을 쓸 수 없다는 것이다. 즉 이건 표면적인 정렬 문제가 아니라 되돌릴 수 없는 지식 망각이다. 다운스트림 성능을 위해 데이터를 늘리는 행위와 세계 지식 보존이 바닐라 SFT에서는 근본적으로 양립 불가능하다는 진단이 여기서 완성된다.
4. LoRAMoE: 방법론
진단이 명확하면 처방도 방향이 잡힌다. 지식이 파라미터 안에 있고 대규모 학습이 그걸 덮어쓰는 게 문제라면, 백본 파라미터를 아예 건드리지 않으면 된다. 그러면서도 다운스트림 성능은 올려야 하니, 학습 가능한 별도의 모듈을 붙여 그쪽에서 태스크를 처리하게 한다. 이것이 LoRAMoE의 기본 설계 사상이다.
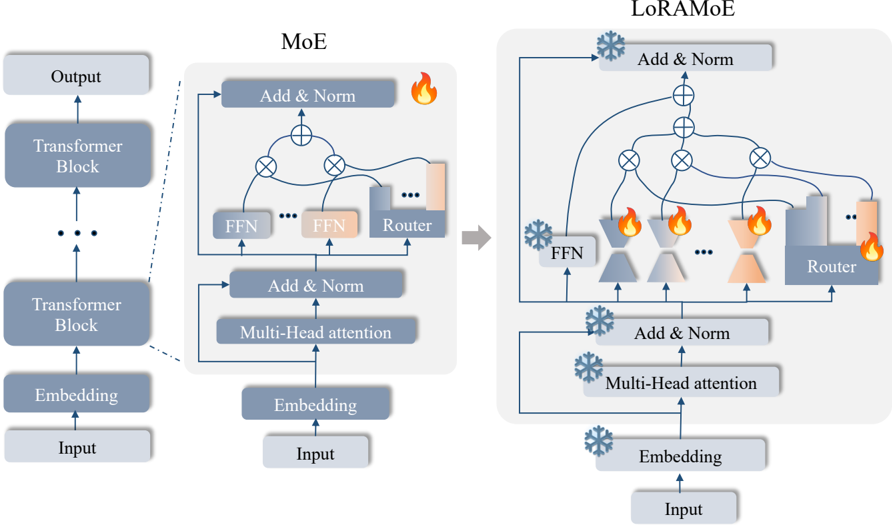
Figure 4 (원논문): 고전적 MoE(가운데)와 LoRAMoE(오른쪽)의 비교. LoRAMoE는 여러 LoRA를 조정 가능한 전문가로 두고 라우터로 게이팅하며, 이를 모든 트랜스포머 블록의 FFN 레이어에 삽입한다. 학습 시에는 전문가와 라우터만 최적화되고(불꽃 표시), 나머지 백본은 모두 얼려진다(눈송이 표시).
Figure 4의 오른쪽 그림에서 눈송이(❄️)와 불꽃(🔥) 아이콘이 이 방법의 전부를 요약한다. 임베딩, 멀티헤드 어텐션, Add & Norm, 원래의 FFN까지 - 백본의 모든 것이 눈송이, 즉 얼려져 있다. 학습되는 것은 불꽃으로 표시된 여러 개의 LoRA 전문가와 이들을 묶는 라우터뿐이다. 고전 MoE(가운데)가 FFN 자체를 여러 개의 전문가 FFN으로 통째로 교체하는 것과 달리, LoRAMoE는 기존 FFN을 그대로 둔 채 그 옆에 LoRA 전문가들을 병렬로 얹는 "플러그인" 형태라는 점이 구조적 차이다.
4.1 아키텍처 (Architecture)
수식으로 따라가 보자. 전통적인 트랜스포머에서 선형 레이어의 순전파는 백본 파라미터 와 학습 중 갱신되는 파라미터 의 합으로 표현된다.
여기서 는 백본 모델의 파라미터 행렬이고, 는 학습 단계에서 업데이트되는 부분이다. LoRAMoE는 FFN 블록의 이 선형 레이어를 MoE 스타일 플러그인으로 대체한다. 학습 시에는 를 얼려 세계 지식을 지키고 만 갱신한다.
개의 전문가 를 가진 LoRAMoE 레이어의 순전파는 다음과 같다.
는 번째 전문가, 는 라우터를 나타낸다. 는 라우터 네트워크의 학습 가능한 파라미터 행렬이다. 라우터가 각 전문가에게 가중치를 배분하고 전문가들이 협업하여 다양한 태스크를 처리하는, 표준적인 MoE 게이팅 구조다.
여기에 효율성을 위해 각 전문가를 LoRA로 구현한다. 전문가 의 파라미터 행렬 를 두 개의 저랭크 행렬 곱으로 분해하는 것이다.
, 이고 랭크 이다. 이렇게 하면 학습 가능한 파라미터 수가 급감해 미세조정의 비용과 자원 소모가 크게 줄어든다. 실제로 뒤의 Table 3을 보면 6개 전문가 · 랭크 4 설정에서 학습 파라미터가 전체의 0.57%에 불과하다.
전체를 종합하면, 전통적 FFN 레이어를 대체한 LoRAMoE 레이어의 순전파는 다음과 같이 정리된다.
는 번째 전문가의 (라우터가 부여한) 가중치이고, 는 학습률에 준하는 상수 하이퍼파라미터다. 요점은 첫 항 가 얼려진 백본의 출력이고, 두 번째 항이 학습되는 LoRA 전문가들의 가중합이라는 점이다. 지식은 첫 항이 붙들고, 새 태스크 적응은 둘째 항이 담당하는 역할 분담이 수식에 그대로 드러난다.
4.2 Localized Balancing Constraint
여기까지가 "MoE 스타일 플러그인" 부분이다. 그런데 MoE에는 고질적인 문제가 하나 있다. 전문가 활용의 불균형(imbalance)이다.
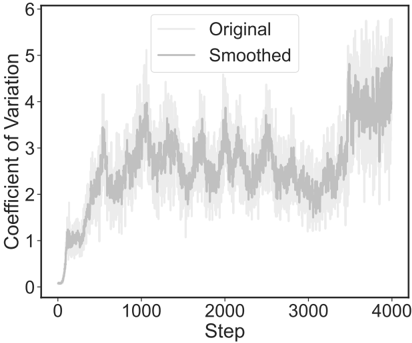
Figure 5 (원논문): 제약이 없는 LoRAMoE에서 전문가 중요도의 변동계수(coefficient of variation)가 학습이 진행될수록 점점 커져 약 3 부근의 높은 값으로 유지된다. 라우터가 소수의 특정 전문가에게만 큰 가중치를 몰아주고 있다는 뜻이다.
Figure 5는 아무 제약 없이 LoRAMoE를 학습했을 때 전문가 중요도의 변동계수가 학습 스텝에 따라 어떻게 변하는지를 보여준다. 초반에 0에서 시작해 500스텝 무렵 2 부근까지 급등하고, 이후 2~3 사이에서 요동치다 3500스텝 이후 다시 치솟는다. 변동계수가 크다는 것은 전문가들이 받는 중요도의 편차가 크다는 뜻, 즉 소수 전문가에게 가중치가 쏠린다는 신호다. Shazeer et al. (2016)이 원조 MoE에서 보고한 것과 같은 현상이다. 초기에 우연히 높은 가중치를 받은 전문가가 더 빨리 최적화되고, 그래서 라우터가 더 선호하게 되는 양의 피드백 루프가 원인이다.
전통적 해법은 전문가 중요도의 변동계수 자체를 손실 함수로 넣어 활용을 균등화하는 것이다(load balancing). 그런데 저자들은 이 방법에 결함이 있다고 지적한다. 이 손실은 모든 학습 샘플이 동일한 분포에서 온다고 가정하는데, 실제 SFT 데이터는 질의응답 태스크와 다른 다운스트림 태스크처럼 성격이 완전히 다른 분포가 섞여 있다는 것이다(자세한 개념적 증명은 Appendix C). 성격이 다른 데이터를 모든 전문가에게 똑같이 나눠주는 균등화는 오히려 파라미터 추정을 왜곡할 수 있다.
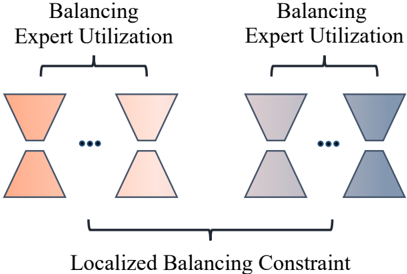
Figure 6 (원논문): Localized balancing constraint. 전문가를 두 유형으로 부드럽게 나눈다. 한 유형은 관련 태스크 학습을 통해 세계 지식을 활용하는 데, 다른 유형은 그 외 다운스트림 태스크에 집중한다. 같은 유형 안의 전문가들끼리는 활용도가 균형을 이룬다.
그래서 나온 것이 Localized Balancing Constraint다. Figure 6이 개념을 잘 보여주는데, 전체 전문가를 두 그룹으로 나눈 뒤 (그림의 주황색 그룹과 파란색 그룹) - 그룹 하나는 세계 지식 관련 태스크에, 다른 하나는 그 외 다운스트림 태스크에 집중하도록 유도한다. 그리고 같은 그룹 안에서는 기존의 load balancing처럼 활용도를 균등하게 맞춘다. 즉 "그룹 간에는 전문화, 그룹 내에서는 균형"이라는 이중 구조다. 그림 위쪽의 "Balancing Expert Utilization" 괄호가 그룹 내 균형을, 아래쪽의 "Localized Balancing Constraint" 괄호가 그룹 간 분업을 나타낸다.
이를 수식화하기 위해 먼저 중요도 행렬 를 정의한다. 은 배치 내 번째 학습 샘플에 대해 번째 전문가가 받은 라우터 값의 합이다.
은 전문가 수, 은 번째 샘플의 토큰 수, 는 번째 토큰의 은닉 입력이다. 이어서 와 같은 크기의 계수 행렬 를 정의한다.
은 전문가 유형 간 불균형의 정도를 조절한다. 은 번째 전문가에게 미리 지정된 목표 유형이고, 은 번째 샘플의 태스크 유형이다. 전문가의 담당 유형과 샘플의 유형이 일치하면 계수가 로 커지고, 어긋나면 로 작아진다. 같은 그룹의 전문가들끼리는 계수 값이 동일하고(), 다른 그룹이면 값이 다르다.
이제 가중 중요도 행렬 (원소별 곱)의 분산 정도를 측정하는 것이 Localized Balancing Constraint 손실 다.
와 는 각각 의 분산과 평균이다. 이 손실을 줄인다는 게 어떤 효과를 내는지 따라가 보면 설계 의도가 보인다. 어떤 샘플이 세계 지식 관련 데이터셋에서 왔다면, 그 유형을 담당하는 전문가들의 계수 값이 커진다(). 를 최소화하려면 이 전문가들이 해당 샘플로부터 더 많이 학습하고 라우터로부터 더 큰 가중치를 받게 되는 방향으로 움직인다. 동시에 같은 유형을 처리하는 전문가끼리는 균형이 맞춰진다. 이 제약이 "부드러운(soft)" 이유는 완전히 강제하지 않고 협업의 여지를 남겨 일반화 능력을 보존하기 위해서다.
최종 손실은 다음-토큰 예측 손실 에 를 로 가중해 더한 형태다.
는 Localized Balancing Constraint의 강도를 조절한다. 추론 단계에서는 라우터가 자동으로 모든 전문가에게 가중치를 배분하므로, 사용자가 데이터 유형을 미리 지정해줄 필요가 없다는 점이 실용적으로 중요하다. 뒤에서 다룰 MOELoRA 같은 선행 연구가 추론 시 데이터 유형 입력을 요구했던 것과 대비되는 지점이다.
5. 실험
5.1 실험 설정
메인 실험 설정을 요약하면 이렇다. FFN의 선형 레이어만 LoRAMoE 레이어로 교체하고, 각 레이어에 전문가 6개를 둔다. 이 중 3개는 다운스트림 태스크 전담, 나머지 3개는 백본의 세계 지식을 활용하는 전담이다. 제약 강도 와 불균형 정도 는 둘 다 0.1로 둔다. LoRA의 , 랭크 , dropout 0.05, 학습률 2e-4. 학습 데이터는 Appendix A의 3M 세트이며, 백본은 얼리고 전문가와 라우터만 학습한다.
5.2 메인 결과
메인 결과 테이블이 이 논문의 하이라이트다. 15개 태스크에 대해 다섯 가지 학습 방식 - 원본 베이스라인, CBQA 단독 SFT, 전체 SFT, 단일 LoRA, LoRAMoE, 그리고 를 적용한 LoRAMoE - 를 비교한다.
| Task Name | Baseline | SFT (CBQA only) | SFT | LoRA | LoRAMoE | LoRAMoE (w/ ) |
|---|---|---|---|---|---|---|
| WSC | 65.4 | - | 76.0 | 65.4 | 71.2 | 70.2 |
| winogrande | 61.7 | - | 71.2 | 64.3 | 66.3 | 69.6 |
| Flores | 0.1 | - | 24.3 | 26.6 | 26.4 | 25.9 |
| Xsum | 19.7 | - | 34.7 | 34.5 | 34.8 | 33.2 |
| Race-middle | 30.5 | - | 89.1 | 78.8 | 84.5 | 90.0 |
| Race-high | 30.4 | - | 86.1 | 75.3 | 80.6 | 86.5 |
| RTE | 52.7 | - | 88.1 | 77.3 | 80.9 | 87.4 |
| ReCoRD | 29.4 | - | 84.8 | 83.2 | 84.3 | 85.9 |
| AX-g | 52.0 | - | 84.8 | 76.1 | 81.7 | 87.1 |
| multiRC | 44.0 | - | 86.7 | 81.4 | 87.3 | 87.9 |
| TriviaQA | 52.2 | 57.8 | 51.1 | 47.8 | 55.3 | 58.1 |
| NQ | 18.5 | 28.6 | 24.5 | 16.2 | 23.8 | 28.0 |
| Filtered TriviaQA | 33.5 | 36.2 | 21.6 | 33.4 | 38.5 | 35.4 |
| Filtered NQ | 7.8 | 12.8 | 7.3 | 11.6 | 13.4 | 12.0 |
| HotpotQA | 11.2 | 16.1 | 13.4 | 10.7 | 14.4 | 16.1 |
Table 2 (원논문): LoRAMoE의 결과. 상단 10개는 다운스트림 태스크, 하단 5개는 세계 지식 벤치마크. 직접 전체 미세조정(SFT)이나 단일 LoRA 튜닝이 학습 후 세계 지식 벤치마크에서 성능이 떨어지는 것과 달리, LoRAMoE는 세계 지식과 다운스트림 태스크를 동시에 끌어올린다.
이 표에서 가장 먼저 봐야 할 것은 하단 5개 세계 지식 벤치마크의 'SFT' 열과 'LoRAMoE' 열 대비다. 바닐라 SFT는 Filtered TriviaQA를 33.5 → 21.6으로, Filtered NQ를 7.8 → 7.3으로 깎아먹는다. 2절에서 진단한 망각이 그대로 재현된 것이다. 반면 를 적용한 LoRAMoE는 Filtered TriviaQA를 35.4로, Filtered NQ를 12.0으로 끌어올린다. 바닐라 SFT 대비 Filtered TriviaQA에서 (35.4-21.6)/21.6 ≈ 63.9%의 향상으로, 논문이 강조하는 "최대 63.9% 향상, 평균 35.3% 향상"의 근거가 이 열이다. 심지어 CBQA만으로 정렬한 모델(그 자체가 세계 지식에 유리한 설정)에 준하거나 그를 넘어서는 경우도 있다.
동시에 다운스트림 태스크(상단 10개)에서도 손해를 보지 않는다는 점이 핵심이다. Race-middle 90.0, Race-high 86.5, multiRC 87.9처럼 읽기 이해 태스크 전반에서 오히려 바닐라 SFT를 앞선다. 세계 지식을 지키느라 다운스트림을 희생한 게 아니라 둘 다 챙겼다는 뜻이다.
단일 LoRA와의 비교도 의미가 있다. 'LoRA' 열을 보면 단일 LoRA 역시 세계 지식이 무너진다(Filtered NQ는 그나마 11.6로 버티지만 TriviaQA는 52.2 → 47.8로 하락). 단일 LoRA가 본질적으로 바닐라 SFT와 같은 방식이기 때문이다. 여러 LoRA를 협업시킨 LoRAMoE는 단일 LoRA 대비 세계 지식에서 평균 30.9%, 다운스트림에서 평균 8.4% 향상을 보인다. 전문가를 여럿 두고 협업시키는 것 자체가 이득이라는 근거다.
마지막으로 'LoRAMoE' 열과 'LoRAMoE (w/ )' 열의 비교가 Localized Balancing Constraint의 순수 기여도를 보여주는 사실상의 ablation이다. 를 켜면 대부분의 태스크에서 점수가 오른다. WSC(71.2 → ... winogrande 66.3 → 69.6), RTE(80.9 → 87.4), AX-g(81.7 → 87.1) 등 읽기 이해와 NLI, 그리고 원본 CBQA에서 이득이 두드러진다(최대 17.6%). 전문가 그룹을 능력별로 분할하는 것이 멀티태스크 학습에 실질적으로 도움이 된다는 증거다. 다만 Filtered TriviaQA(38.5 → 35.4)처럼 없는 쪽이 더 높은 경우도 있어, 이 제약이 모든 태스크에 만능은 아니라는 점도 표에 드러난다.
5.3 파라미터 민감도 분석
전문가 수와 LoRA 랭크를 바꿔가며 전체 테스트셋 평균 성능을 본 것이 Table 3이다.
| # Experts | # LoRA Rank | # Trainable Param. | Avg. Results |
|---|---|---|---|
| 6 | 4 | 0.57% | 58.21 |
| 4 | 4 | 0.38% | 55.84 |
| 8 | 4 | 0.76% | 56.58 |
| 6 | 8 | 1.07% | 58.11 |
| 6 | 16 | 2.08% | 58.86 |
Table 3 (원논문): 전문가 수와 LoRA 랭크에 따른 LoRAMoE의 전체 테스트셋 평균 성능. 파라미터 변화에 대해 안정적인 모습을 보인다.
이 표에서 흥미로운 건 "많을수록 좋다"가 성립하지 않는다는 점이다. 전문가를 6개에서 8개로 늘리면 오히려 58.21에서 56.58로 떨어지고, 4개로 줄여도 55.84로 하락한다. 6개가 스위트 스팟이라는 얘기다. 세계 지식 3 + 다운스트림 3의 대칭 구조가 우연이 아닌 셈이다. 랭크를 4에서 8, 16으로 키우면 성능이 58.21 → 58.11 → 58.86으로 미세하게 오르긴 하지만, 학습 파라미터는 0.57%에서 2.08%로 거의 4배 뛴다. 성능 대비 비용이 맞지 않는다. 전체적으로 성능이 파라미터 변화에 크게 흔들리지 않아 방법이 견고하다는 점, 그리고 0.57%라는 극소량의 파라미터로 이 성능을 낸다는 점이 이 표의 메시지다.
5.4 전문가 활용도 시각화
방법이 의도대로 작동하는지 - 정말로 전문가들이 두 유형으로 전문화되었는지 - 를 라우터 가중치 시각화로 확인한다.
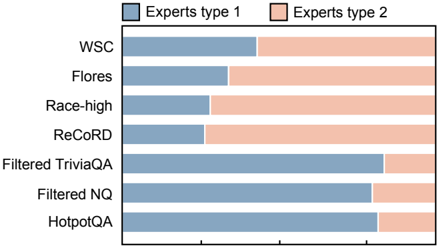
Figure 7 (원논문): 서로 다른 유형의 데이터에 대한 라우터 가중치 시각화. type 1은 백본의 세계 지식을 인간 지시에 정렬하는 전담 전문가, type 2는 다운스트림 태스크 전담 전문가. 태스크에 따라 두 유형의 활용률이 확연히 갈린다.
Figure 7은 태스크별로 두 유형 전문가(파란색 type 1 = 세계 지식, 주황색 type 2 = 다운스트림)의 활용 비율을 누적 막대로 보여준다. 세계 지식 벤치마크인 Filtered TriviaQA, Filtered NQ, HotpotQA에서는 파란색(type 1)이 막대의 대부분을 차지한다. 세계 지식을 담당하도록 유도된 전문가가 실제로 세계 지식 태스크에서 크게 활용된다는 것으로, 2절에서 "SFT가 사전 저장된 지식과 지시를 연결해준다"고 한 주장과 정확히 맞아떨어진다.
반대로 ReCoRD, Race-high 같은 다운스트림 태스크에서는 주황색(type 2)의 비중이 커진다. 라우터가 추론 단계에서 태스크 성격에 맞는 전문가에게 자동으로 일을 배분한다는 뜻이다. 다만 완벽히 이분법적이지는 않다는 점도 눈여겨볼 만하다. WSC 같은 언어 기반 태스크에서는 라우터가 세계 지식 전문가(type 1)에 평균 약 45%의 주의를 배분한다. 읽기 이해나 상식 추론 태스크에서는 사전학습으로 얻은 지식이 사실 판단에 도움이 되기 때문으로, 유형 간 협업이 실제로 일어나고 있음을 보여준다. 완전한 분리가 아니라 "부드러운" 제약을 건 설계 의도가 이 그림에서 정당화되는 셈이다.
6. Appendix: 보충 실험
6.1 학습 데이터 구성 (Appendix A)
3M 미세조정 데이터셋이 어떤 태스크로 구성되었는지가 Table 4다. 7개 카테고리 - CBQA, 상호참조 해결, NLI, 요약, 다국어 번역, 읽기 이해, 텍스트 분류 - 를 아우른다.
| Task Name | # Train | # Test | Task Type |
|---|---|---|---|
| TriviaQA | 78,785 | 254 | closed-book QA |
| NQ | 104,071 | 357 | closed-book QA |
| HotpotQA | 72,798 | 5,622 | closed-book QA |
| WSC | 554 | 146 | coreference resolution |
| WinoGrande | 40,398 | 1,767 | coreference resolution |
| Flores | 0 | 1,600 | machine translation |
| WMT | 500,000 | - | machine translation |
| RTE | 2,490 | 3,000 | NLI |
| ReCoRD | 100,730 | 10,000 | reading comprehension |
| AX-g | 0 | 356 | NLI |
| multiRC | 27,243 | 9,693 | reading comprehension |
| anli r1/r2/r3 | 162,874 | - | NLI |
| qqp | 363,846 | - | NLI |
| Xsum | 204,045 | 11,334 | single-document summarization |
| Race | 87,866 | 4,934 | reading comprehension |
| duorc-selfRC | 60,721 | - | reading comprehension |
| AG-news | 120,000 | - | topic classification |
| yelp review | 650,000 | - | sentiment classification |
| openai tldr | 232,188 | - | summarization |
Table 4 (원논문): 미세조정 데이터셋의 태스크 구성. "-"는 해당 데이터셋의 테스트셋을 평가에 쓰지 않았다는 의미. Flores와 AX-g는 학습 샘플이 0으로, 순수 제로샷 일반화를 평가하는 태스크다.
Flores와 AX-g의 학습 샘플이 0이라는 점이 눈에 띈다. 이 두 태스크는 학습 없이 평가만 하는, 사실상 제로샷 일반화 능력을 재는 항목이다. 데이터 규모는 yelp review(65만), WMT(50만), qqp(36만)처럼 태스크마다 편차가 크다. 이렇게 성격과 규모가 이질적인 데이터가 섞여 있다는 사실이, 4.2절에서 "단일 분포 가정이 틀렸다"고 지적한 근거를 데이터 차원에서 뒷받침한다.
6.2 데이터를 더 늘리면 (10M) 망각은 더 심해진다 (Appendix B)
Appendix B는 2절의 진단을 극단으로 밀어붙인다. 태스크를 더 추가해(NER, Program Execution, Question Generation, Text2SQL, Toxic Classification) 1000만 샘플 데이터셋을 만든 뒤 바닐라 SFT를 돌린 결과다.
| Task Name | Baseline | Result (10M SFT) |
|---|---|---|
| NER | 42.1 | 82.2 |
| Program Execution | 18.7 | 78.5 |
| Toxic Classification | 96.0 | 97.4 |
| Question Generation | 46.2 | 61.1 |
| Text2sql | 56.0 | 96.2 |
| WSC | 65.4 | 70.2 |
| winogrande | 61.7 | 66.1 |
| Flores | 0.1 | 26.0 |
| Xsum | 19.7 | 33.2 |
| Race-middle | 30.5 | 87.0 |
| Race-high | 30.4 | 83.3 |
| RTE | 52.7 | 87.4 |
| ReCoRD | 29.5 | 56.6 |
| AX-g | 52.0 | 87.9 |
| multiRC | 44.0 | 86.0 |
| TriviaQA | 52.2 | 30.9 |
| NQ | 18.5 | 14.2 |
| Filtered TriviaQA | 33.5 | 15.7 |
| Filtered NQ | 7.8 | 5.0 |
| HotpotQA | 11.2 | 7.6 |
Table 5 (원논문): 1000만 샘플 데이터셋으로 바닐라 SFT한 LLaMA-2-7B의 성능. CBQA 태스크에서 훨씬 심각한 하락이 나타나는 반면, 다른 태스크에서는 베이스라인 대비 큰 향상을 보인다.
이 표는 트레이드오프의 극단을 보여준다. 새로 추가된 태스크들은 폭발적으로 좋아진다. Program Execution 18.7 → 78.5, Text2SQL 56.0 → 96.2, NER 42.1 → 82.2. 반면 하단의 세계 지식 벤치마크는 3M 때보다 더 처참하다. TriviaQA는 52.2 → 30.9로 3M SFT(51.1)보다 훨씬 낮고, Filtered TriviaQA는 33.5 → 15.7, HotpotQA는 11.2 → 7.6. 데이터를 3M에서 10M으로 늘릴수록 다운스트림은 더 좋아지고 세계 지식은 더 무너진다 - 즉 망각은 데이터 양에 비례해 심해지는 단조적 현상이라는 것을 이 표가 못 박는다. 문제가 우연이나 특정 데이터셋의 부작용이 아니라 규모에 따라 악화되는 구조적 현상임을 보여주는, 논문에서 가장 인상적인 보충 실험이다.
6.3 혼합 분포에서의 균형 딜레마 (Appendix C)
Appendix C는 4.2절에서 "전통적 load balancing이 단일 분포를 가정해서 문제"라고 한 주장에 대한 개념적 증명을 담고 있다. 논의를 단순화하기 위해 학습 데이터가 두 개의 가우시안 분포의 혼합에서 샘플링된다고 가정한다. 각 분포의 평균 과 분산 은 잠재적이며, 각 분포에서 온 데이터의 비율을 (, 일반성을 잃지 않고 로 가정)로 둔다.
MoE 모델이 균형 가중치 으로 이 분포를 적합할 때의 우도(likelihood)를 전개하고 미분 조건을 따져보면, 이상적인 라우팅 네트워크에서는 데이터가 실제 샘플링 분포의 한 봉우리와 독립 동일 분포를 이루도록 배분되어야 한다는 결론에 도달한다. 핵심 결과는, 사전 분포의 혼합 계수 이 실제 샘플링 분포의 가중치 과 일치할 때에만 최적의 학습 오차가 달성된다는 것이다. 다시 말해 데이터가 이질적 분포의 혼합인데도 모든 전문가에게 균등하게(을 고정된 균등값으로) 배분하면 파라미터 추정이 편향된다. 데이터의 실제 구성 비율을 반영해 전문가별로 차등 배분해야 한다는 것이 Localized Balancing Constraint의 이론적 정당화다. 이 부분은 논문이 단순한 휴리스틱이 아니라 나름의 근거를 갖고 제약을 설계했음을 보여주는 대목인데, 다만 두 가우시안이라는 강한 단순화 위에서의 논증이라 실제 언어 데이터 분포에 얼마나 직결되는지는 다소 느슨하게 남아 있다.
6.4 민감도 분석 상세 결과 (Appendix D)
5.3절 Table 3의 평균 뒤에 가려진 태스크별 상세 수치가 Table 6이다.
| Task Name | #Expert=8, r=4 | #Expert=4, r=4 | #Expert=6, r=8 | #Expert=6, r=16 |
|---|---|---|---|---|
| WSC | 71.2 | 76.0 | 70.2 | 76.9 |
| winogrande | 69.8 | 56.0 | 69.5 | 70.9 |
| Flores | 25.0 | 25.8 | 26.1 | 26.3 |
| Xsum | 32.8 | 33.3 | 33.7 | 34.0 |
| Race-middle | 90.3 | 84.2 | 90.3 | 90.5 |
| Race-high | 87.1 | 80.7 | 87.3 | 87.2 |
| RTE | 84.5 | 80.1 | 88.1 | 85.2 |
| ReCoRD | 85.6 | 85.5 | 86.0 | 86.1 |
| AX-g | 88.8 | 77.5 | 88.2 | 85.7 |
| multiRC | 77.2 | 87.6 | 81.1 | 87.3 |
| TriviaQA | 54.4 | 57.8 | 58.2 | 58.9 |
| NQ | 25.6 | 27.9 | 27.8 | 28.2 |
| Filtered TriviaQA | 30.7 | 35.8 | 36.7 | 34.3 |
| Filtered NQ | 11.5 | 13.4 | 12.0 | 15.4 |
| HotpotQA | 14.5 | 16.0 | 16.4 | 16.5 |
Table 6 (원논문): 민감도 분석의 태스크별 상세 결과.
세부를 보면 전문가를 4개로 줄인 설정(두 번째 열)이 특히 불안정하다. winogrande가 56.0, AX-g가 77.5, multiRC는 오히려 87.6으로 태스크별 편차가 크다. 전문가가 부족하면 유형별 분업이 제대로 안 되어 태스크마다 성능이 들쭉날쭉해진다는 해석이 가능하다. 반대로 랭크를 16으로 키운 마지막 열은 대체로 고르게 높지만, 앞서 봤듯 파라미터 비용이 4배라 실용성이 떨어진다. 6개 전문가 · 랭크 4가 성능-비용 균형에서 왜 기본값으로 선택되었는지가 이 상세 표에서 다시 확인된다.
7. 강점과 약점
먼저 강점. 이 논문의 가장 큰 미덕은 문제 진단의 엄밀함이다. "망각이 일어난다"는 관찰에서 멈추지 않고, CBQA 단독 학습(Figure 3)과 2단계 학습(Table 1)이라는 통제 실험으로 그것이 정렬 문제가 아니라 되돌릴 수 없는 지식 손상임을 분리해 증명했다. 여기에 10M 규모 실험(Table 5)으로 망각이 데이터 양에 단조적으로 악화된다는 것까지 보인 점은, 해법을 제시하기 전에 문제의 성격을 완전히 규명하려는 태도로 읽힌다. 방법 자체도 실용적이다. 백본을 얼리고 0.57%의 파라미터만 학습하니 저렴하고, 추론 시 데이터 유형을 지정할 필요가 없어 배포가 간단하다. 기존 MoELoRA가 추론 시 유형 입력을 요구했던 제약을 라우터 자동 배분으로 풀어낸 것도 실무적으로 의미가 크다.
약점도 분명하다. 첫째, 저자 스스로 밝혔듯 모델 크기가 7B에 묶여 있다. 대규모 SFT의 망각 현상과 LoRAMoE의 효과가 13B, 70B에서도 같은 양상일지는 검증되지 않았다. 둘째, 전문가를 "세계 지식 vs 다운스트림"이라는 단 두 유형으로만 나눴다. 실제 태스크는 훨씬 세분화되어 있는데, 더 미세한 유형 분할이 필요한 경우는 다루지 못했다(이 역시 저자가 한계로 인정한 부분이다). 셋째, 전문가의 유형 지정 자체가 수동이라는 점이다. 어떤 태스크를 "세계 지식 관련"으로 볼지를 사람이 사전에 라벨링해야 하고(), 이 분류가 애매한 태스크에서는 제약이 오히려 방해가 될 수 있다. Table 2에서 Filtered TriviaQA가 를 껐을 때 더 높았던 것이 그 신호일지 모른다. 넷째, Appendix C의 이론적 정당화가 두 가우시안 혼합이라는 강한 단순화 위에 있어, 고차원 언어 표현 공간으로의 일반화는 논증되지 않았다.
8. 관련 연구 속에서의 위치
LoRAMoE는 세 갈래의 연구 흐름이 만나는 지점에 있다. 파라미터 효율적 미세조정(PEFT) 계열에서는 LoRA를 전문가 구조에 이식해 자원 소모를 줄였고, MoE 계열에서는 - 기존 연구가 모델을 키우거나 라우터 선택 문제를 푸는 데 집중한 것과 달리 - 멀티태스크 학습과 세계 지식 보존이라는 새로운 목적에 MoE 구조를 가져다 썼다.
가장 직접적인 비교 대상은 Multi-LoRA 계열이다. LoraHub(Huang et al., 2023)는 태스크 일반화를 위해 여러 LoRA 조합을 선택하고, MOELoRA(Liu et al., 2023)는 LoRA와 MoE를 결합해 의료 분야의 멀티태스크 튜닝을 다뤘다. 그러나 이들은 추론 단계에서 데이터 유형을 입력으로 요구해 적용 범위가 제한적이었다. LoRAMoE는 라우터가 유형을 자동 판별하게 함으로써 이 제약을 없앴고, 무엇보다 "세계 지식 망각"이라는 다른 연구들이 정면으로 다루지 않은 문제를 타깃으로 삼았다는 점에서 포지셔닝이 뚜렷하다. Octavius(Chen et al., 2023b)가 멀티모달 학습의 태스크 간섭을 MoE로 완화한 것과도 궤를 같이하지만, 대상이 세계 지식 보존이라는 점에서 갈린다.
9. 마무리
LoRAMoE의 이야기를 한 문장으로 압축하면, "무엇을 지키고 무엇을 바꿀지를 아키텍처 레벨에서 분리한 것"이다. 사전학습 지식은 얼려진 백본이 붙들고, 새 태스크 적응은 학습 가능한 LoRA 전문가들이 담당하며, Localized Balancing Constraint가 그 전문가들을 두 진영으로 부드럽게 갈라 각자의 몫을 하게 만든다. 대규모 SFT의 고질적 트레이드오프를 우회하는 방식이 우아하다.
물론 7B 한정, 두 유형 고정, 수동 라벨링이라는 제약이 남아 있고, 이론적 정당화도 더 다져질 여지가 있다. 그럼에도 이 논문이 던지는 메시지 - "명령어 데이터를 무작정 늘리는 것은 공짜가 아니며, 사전학습 지식은 능동적으로 보호해야 하는 자산"이라는 관점은 SFT를 설계하는 모든 실무자가 새겨둘 만하다. 데이터를 늘렸는데 QA 성능이 이상하게 떨어진 경험이 있다면, 이 논문이 그 원인과 처방을 동시에 제시해줄 것이다.