논문 리뷰
논문 리뷰: Dynamic Expert Specialization: Towards Catastrophic Forgetting-Free Multi-Domain MoE Adaptation
여러 도메인을 하나의 MoE 모델에 학습시킬 때 생기는 파국적 망각(catastrophic forgetting)을, 도메인마다 다른 전문가(expert)를 동적으로 골라 격리하는 방식으로 잡아낸 통합 파인튜닝 프레임워크 DES-MoE.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Dynamic Expert Specialization: Towards Catastrophic Forgetting-Free Multi-Domain MoE Adaptation |
| 저자 | Junzhuo Li, Bo Wang, Xiuze Zhou, Xuming Hu (HKUST-Guangzhou / HKUST) |
| 학회/저널 | EMNLP 2025 (Main) |
| 논문 링크 | ACL Anthology 2025.emnlp-main.932 |
1. 들어가며
Mixture-of-Experts(MoE)는 요즘 대형 언어 모델 확장의 사실상 표준 아키텍처가 됐다. Mixtral, DeepSeek-V2/V3, Qwen1.5-MoE, Hunyuan-Large까지, 수천억에서 조 단위 파라미터를 감당하면서도 실제 연산량은 그 일부만 쓰는 비결이 바로 여기에 있다. 토큰마다 희소 게이팅(sparsely-gated routing)으로 전체 전문가 중 극소수만 활성화하니, 파라미터 수와 연산 비용을 분리(decouple)할 수 있는 것이다.
그런데 이렇게 만들어진 MoE를 새로운 도메인에 적응시키는 일은 생각보다 까다롭다. 희소 라우팅은 효율적인 대신 경직돼 있다. 어떤 도메인은 특정 전문가 집합을 집중적으로 쓰고, 다른 도메인은 또 다른 전문가에 의존한다. 이 상태에서 여러 도메인 데이터를 한꺼번에 넣고 순진하게(naïvely) 파인튜닝하면 문제가 생긴다. 일부 전문가는 특정 도메인에 과도하게 특화되고 나머지는 놀게 되며, 학습이 불안정해지고 일반화 성능도 떨어진다. 더 근본적으로는, 도메인 A를 학습하면서 도메인 B에 필요했던 표현이 덮어써지는 파국적 망각(catastrophic forgetting)이 발생한다.
이 문제에 정면으로 답한 대표적 선행 연구가 ESFT(Expert-Specialized Fine-Tuning, Wang et al., 2024)다. 타깃 도메인과 가장 관련 있는 전문가만 골라 업데이트하고 나머지는 얼려버리는 방식인데, 전체 파인튜닝에 맞먹거나 오히려 능가하는 성능을 훨씬 적은 비용으로 낸다. "전문가마다 다른 지식을 담고 있으니, 관련된 전문가에만 집중하면 효율적으로 적응할 수 있다"는 직관을 검증한 셈이다.
문제는 ESFT가 태생적으로 한 번에 한 도메인만 다룬다는 점이다. 새 도메인이 생길 때마다 전문가 부분집합을 새로 정하고 처음부터 다시 파인튜닝해야 한다. 도메인 수가 늘면 모델 개수도 비례해서 늘어난다. 게다가 정적(static) 전문가 할당은 도메인 간 공통점을 활용하지 못한다. 한 도메인용으로 튜닝한 전문가를 다른 도메인이 재사용하기 어렵기 때문이다.
이 논문이 던지는 질문은 명확하다. 도메인마다 모델을 따로 만들지 않고, 하나의 MoE 모델에 여러 도메인을 학습시키면서도 파국적 망각을 피할 수는 없을까? DES-MoE(Dynamic Expert Specialization)는 이 질문에 "전문가 할당을 정적으로 고정하지 말고 배치마다 동적으로 다시 계산하자"는 답을 내놓는다. 여섯 개 도메인(수학, 코드, 법률 등)에서 단일 도메인 ESFT에 맞먹는 성능을 하나의 통합 모델로 달성하면서, 도메인이 2개에서 6개로 늘어날 때 전체 파인튜닝 대비 망각을 89% 줄이고 68% 빠르게 수렴한다는 것이 핵심 결과다.
2. 기존 연구의 한계
2.1 파라미터 효율적 파인튜닝(PEFT)
거대 모델을 다운스트림 태스크에 적응시킬 때 전체 파라미터를 다 건드리는 건 비용이 너무 크다. 그래서 나온 것이 PEFT(Parameter-Efficient Fine-Tuning)인데, dense 아키텍처를 대상으로 한 기존 방법은 대략 세 갈래로 나뉜다.
첫째는 추가 후 동결(augment-and-freeze) 계열이다. 새 파라미터를 소량 삽입해 그것만 학습한다. 프롬프트 튜닝(Lester et al., 2021), 프리픽스 튜닝(Li & Liang, 2021), 어댑터(Houlsby et al., 2019) 같은 방법들이 여기 속한다. 둘째는 선택적 파인튜닝(selective fine-tuning) 으로, 기존 가중치 중 일부만 골라 업데이트한다(Guo et al., 2021 등). 셋째는 저랭크 적응(low-rank adaptation), 즉 LoRA(Hu et al., 2022)와 그 수많은 변형들이다.
이 방법들은 dense 모델에서는 잘 작동하지만, 희소 MoE로 가져오면 이야기가 달라진다. MoE의 조건부 연산(conditional computation) 구조를 고려하지 않고 저랭크 부분공간 하나에 모든 도메인의 변화를 욱여넣으려 하면, 서로 충돌하는 다중 도메인 그래디언트를 감당하지 못한다.
2.2 Mixture-of-Experts
MoE 아키텍처(Fedus et al., 2021; Lepikhin et al., 2021; Dai et al., 2024)는 입력마다 전문가의 부분집합만 활성화함으로써 연산 비용과 파라미터 수를 분리한다. 최근 흐름은 소수의 고차원 전문가를 두는 조립식(coarse-grained) MoE(Mixtral 등)에서, 다수의 저차원 전문가를 두는 세분화(fine-grained) MoE(DeepSeekMoE 등)로 옮겨가고 있다. 전문가를 잘게 쪼갤수록 더 정밀한 전문가 선택과 효율적인 태스크 특화 튜닝이 가능해진다. DES-MoE가 백본으로 쓰는 DeepSeek-V2-Lite도 이 세분화 계열이다(레이어당 전문가 66개).
2.3 ESFT와 그 한계
PEFT를 희소 MoE로 확장하는 연구는 아직 많지 않다. 그중 ESFT(Wang et al., 2024)가 도메인-전문가 친화도(affinity)를 근거로 특정 다운스트림 태스크에 가장 관련 있는 전문가만 파인튜닝하는 방법을 제안했다. 태스크 성능을 높이면서 파국적 망각도 어느 정도 완화한다.
다만 앞서 언급한 대로 ESFT의 결정적 약점은 도메인마다 별도 모델을 학습해야 한다는 점이다. 도메인이 늘면 연산과 저장 비용이 감당하기 어려운 수준으로 커진다. DES-MoE는 여기서 출발한다. 다운스트림 태스크 친화도에 따라 전문가를 동적으로 선택·업데이트해서, 태스크별 모델 복제 없이 희소 MoE의 다중 도메인 적응을 가능하게 하겠다는 것이다.
3. 핵심 아이디어
ESFT와 DES-MoE의 차이를 한 문장으로 요약하면, "전문가 할당을 언제 정하느냐" 다. ESFT는 단일 도메인 데이터로 전문가 부분집합을 미리 정해두고 학습 내내 고정한다. 반면 DES-MoE는 배치가 들어올 때마다 그 도메인에 맞는 전문가를 다시 계산한다. 정적 지도(static map) 대신 살아 움직이는 상관 지도(correlation map)를 쓰는 셈이다.
이 발상이 왜 효과적인가? 여러 도메인을 섞어 학습할 때 진짜 문제는 라우팅 분포가 도메인마다 다르게 이동한다는 데 있다. 수학 문제를 처리할 때 활성화되는 전문가와 법률 문서를 처리할 때 활성화되는 전문가가 다른데, 정적 할당은 이 이동을 따라가지 못한다. 단일 도메인에서 정한 전문가 집합이 태스크가 뒤섞이는 순간 어긋나 버리는 것이다.
DES-MoE의 접근은 세 장치의 조합으로 이루어진다. (1) 사전학습된 라우터를 그대로 얼리지도, 전부 덮어쓰지도 않고 증류(distillation)로 균형을 잡는 적응형 경량 라우터(ALR), (2) 실시간으로 도메인-전문가 상관관계를 추적해 도메인별 그래디언트를 격리하는 도메인 유도 전문가 특화(DGES), (3) 학습이 진행되면서 비특화 파라미터를 점진적으로 얼리는 3단계 적응형 파인튜닝 스케줄이다. 세 장치는 각각 "어떻게 라우팅할지", "누구를 업데이트할지", "언제 무엇을 얼릴지"를 담당한다.
기존 PEFT가 "적은 파라미터로 적응하자"에 머물렀다면, DES-MoE는 "MoE의 조건부 연산 구조 자체를 존중하면서, 도메인별 전문성을 격리해 통합 학습에서도 망가지지 않게 하자"로 문제를 재정의한 것이다.
4. 제안 방법 (DES-MoE)
4.0 배경: MoE 트랜스포머 (Appendix A)
본론에 들어가기 전에 MoE 트랜스포머의 동작을 짚어둘 필요가 있다. 논문 부록 A에 정리된 내용이다. MoE 트랜스포머에서는 각 블록의 표준 FFN(feed-forward network)이 MoE 레이어로 대체된다. 즉 self-attention의 출력을 dense FFN 하나로 보내는 대신, 여러 개의 병렬 FFN(전문가)과 게이팅 네트워크(라우터)로 구성된 MoE 레이어로 보낸다.
레이어 에서 토큰 의 입력 표현 이 게이팅 네트워크를 통해 개 전문가로 라우팅된다. 각 전문가 은 하나의 FFN이다. 라우터는 보통 선형 레이어 + Softmax로 된 작은 네트워크로, 각 전문가에 대한 점수(logit)를 계산한 뒤 Softmax로 정규화해 확률 분포 을 만든다. 이 분포에서 상위 개 전문가의 인덱스 집합을 이라 하면, MoE 레이어의 최종 출력은 선택된 전문가 출력들의 가중합이다.
DeepSeekMoE처럼 항상 선택되는 공유 전문가(shared experts) 를 두는 경우도 있는데, 이때는 공유 전문가의 출력 이 위 합에 더해진다. DES-MoE는 이 공유 전문가 풀을 도메인 간 공통 지식 전달 통로로 활용한다.
4.1 전체 구조
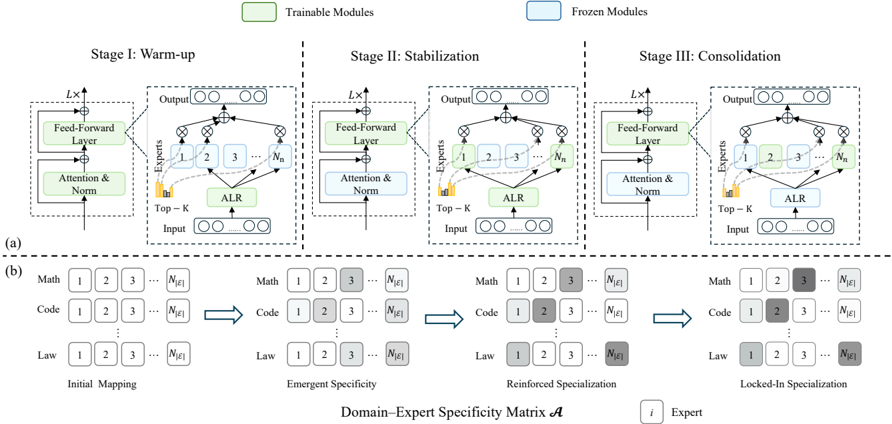
Figure 1: DES-MoE 프레임워크. (a) 점진적 파라미터 특화 스케줄. Stage I(Warm-up)에서는 라우터와 전문가 파라미터가 모두 학습 가능하고, Stage II(Stabilization)에서는 적응형 라우터와 도메인 관련 전문가만 업데이트되며, Stage III(Consolidation)에서는 라우터와 무관한 전문가를 얼리고 최종 도메인 특화 전문가만 학습된다. (b) 도메인-전문가 특이성 행렬 의 진화. 각 셀의 음영은 특정 전문가가 특정 도메인과 얼마나 강하게 연결됐는지를 나타내며, 균일한(빈) 매핑에서 시작해 특이성이 창발·강화되고 최종적으로 고정(locked-in)된 매핑으로 진행된다. (원논문)
Figure 1은 DES-MoE의 두 축을 한눈에 보여준다. 위쪽 (a)는 학습이 3단계로 진행되면서 어떤 모듈이 학습 가능(초록)하고 어떤 모듈이 동결(파랑)되는지를, 아래쪽 (b)는 그 과정에서 도메인-전문가 매핑이 어떻게 선명해지는지를 나타낸다.
특히 (b)의 진화 과정이 이 방법의 핵심 서사를 담고 있다. 학습 초기(Initial Mapping)에는 어떤 전문가가 어떤 도메인에 속하는지 아무 구분이 없다(모든 셀이 비어 있다). 학습이 진행되면서 도메인마다 특정 전문가에 음영이 짙어지고(Emergent Specificity → Reinforced Specialization), 마지막에는 각 도메인이 자기 전용 전문가 집합을 확고히 갖는 상태(Locked-In Specialization)로 수렴한다. Math·Code·Law가 서로 다른 전문가에 자리 잡는 모습이 시각적으로 드러난다. 정적 ESFT가 이 매핑을 처음부터 고정한다면, DES-MoE는 학습을 통해 매핑이 스스로 자라나게 둔다는 점이 대비된다.
이제 세 구성요소를 하나씩 뜯어본다.
4.2 적응형 경량 라우터 (Adaptive Lightweight Router, ALR)
사전학습 때 배운 정적 라우팅은 다중 태스크 파인튜닝에서 마주치는 도메인 이동을 잘 감당하지 못한다. 그렇다고 원래 라우터를 통째로 업데이트하면 값진 사전학습 지식을 덮어쓰게 되고, 반대로 완전히 얼려버리면 새 도메인에 적응할 수 없다. ALR은 이 딜레마를 사전학습된 선형 라우터에 얕은 학습 가능 MLP를 덧붙이는 방식으로 푼다.
토큰 표현 가 주어지면 적응형 라우터는 다음과 같이 정의된다.
여기서 , 이 은닉층을 이루고, , 가 전문가 로짓으로 투영한다(는 전체 전문가 수). 설계에서 눈여겨볼 디테일은 초기화다. 는 사전학습된 라우터의 가중치를 복사해서 채우고, 에만 Kaiming 초기화(He et al., 2015)를 적용한다. 이렇게 하면 파인튜닝 시작 시점에 MLP가 사실상 항등에 가깝게 동작해서 원래 라우터의 행동을 그대로 보존한다. 학습 가능한 라우터 파라미터 집합은 다.
학습은 두 개의 상보적 손실로 이루어진다. 첫째는 지식 증류 손실 인데, 적응형 라우터가 사전학습된 라우팅 패턴을 흉내 내도록 유도한다(온도 ). 사전학습 라우터의 출력 분포를 소프트 타깃으로 삼아 적응형 라우터가 거기서 멀어지지 않게 잡아주는 역할이다. 둘째는 태스크 적응 손실 로, 다운스트림 목표를 향해 특화를 밀어붙인다.
두 손실은 시간 의존 가중치로 결합된다.
여기서 는 파인튜닝이 얼마나 진행됐는지를 나타내는 비율이다. 학습 초기()에는 라우터가 사전학습 상태에 바싹 붙어 있고, 중간 단계()에는 도메인 특화 라우팅 선호를 점차 배우며, 마지막()에는 태스크 성능만을 위해 완전히 최적화된다. 증류에서 시작해 태스크 적응으로 부드럽게 넘어가는 이 곡선이, 일반 지식에서 특화 행동으로의 전환을 매끄럽게 통제한다.
정리하면 ALR은 "라우터를 얼릴 것이냐 학습할 것이냐"라는 이분법을, 시간에 따라 증류 비중을 낮춰가는 연속적 스케줄로 대체한 것이다. 초기에는 사전학습 지식의 안전벨트로, 후반에는 태스크 특화의 엔진으로 작동한다.
4.3 도메인 유도 전문가 특화 (Domain-Guided Expert Specialization, DGES)
여러 도메인에서 공동으로 학습된 전문가는 파괴적 간섭(destructive interference)에 시달린다. 한 도메인의 그래디언트 업데이트가 다른 도메인용으로 배운 지식을 덮어쓰기 때문이다. DGES는 이를 세 단계로 막는다. (i) 각 도메인이 선호하는 전문가를 찾아내고, (ii) 업데이트를 그 전문가로 제한하며, (iii) 도메인 간 전이를 위한 범용 공유 전문가 풀을 남겨둔다.
도메인-전문가 친화도. 학습 데이터가 도메인별로 로 나뉘고 라 하자. 초기 워밍업 단계에서 각 전문가 가 도메인 의 입력에 대해 얼마나 자주 선택되는지를 기록해 친화도 를 만든다. 대략 다음과 같은 형태다.
는 도메인 의 학습 쌍, 는 지시 함수, 는 토큰당 라우팅되는 전문가 수다. 직관적으로 는 도메인 와 전문가 사이의 친화도를 포착한다. 어떤 전문가가 특정 도메인 토큰에서 자주 뽑히면 그 값이 커진다.
이진 특화 행렬. 이 친화도 행렬 의 각 행을 임계값으로 잘라 이진 특화 행렬 을 정의한다. 상대 임계값(relative threshold) 을 쓴다.
즉 도메인 에서 가장 활성화되는 전문가 대비 상대적으로 충분히 자주 뽑히는 전문가만 그 도메인의 "전용 전문가"로 표시된다.
선택적 그래디언트 마스킹. 이후 파인튜닝 단계에서 도메인 의 배치를 처리할 때, 인 전문가 만 0이 아닌 그래디언트를 받는다. 나머지 전문가는 얼어 있다. 이것이 간섭을 막는 핵심 메커니즘이다. 법률 도메인 업데이트가 수학 추론에 중요한 전문가를 건드리지 못하게 하고, 그 반대도 마찬가지다.
토큰 단위 마스킹. 도메인이 섞인 배치에서는 예제를 도메인별로 묶거나, 필요하면 토큰 단위로 마스킹을 적용한다.
여기서 는 도메인 라벨 를 가진 토큰 에 대해 선택된 전문가 집합이다. 다시 말해 는 전문가 가 실제로 참여한 토큰별 그래디언트만 더한다. 어떤 토큰에서 마스킹된() 전문가는 그 토큰의 업데이트에 전혀 기여하지 않는다.
주기적 갱신과 전문가 복제. 특화 행렬 은 스텝마다 모멘텀 방식으로 갱신된다.
모멘텀 로 최근 통계를 반영한 뒤 을 다시 계산한다. 여기서 흥미로운 장치가 하나 더 있다. 만약 어떤 전문가가 둘 이상의 도메인에서 동시에 강하게 활성화되면(즉 ), 그 전문가를 복제(duplicate) 해서 도메인마다 별개의 특화 사본을 유지한다. 다른 도메인의 용량을 줄이지 않으면서 충돌을 해소하는 방식이다. 하나의 전문가가 두 도메인 사이에서 줄다리기하다 어느 쪽도 제대로 못 배우는 상황을, 사본을 나눠줌으로써 회피하는 것이다.
4.4 점진적 파라미터 특화 스케줄 (Progressive Parameter Specialization Schedule)
빠른 도메인 적응과 안정성, 파라미터 효율을 동시에 잡기 위해, 파인튜닝을 세 단계로 나눈다. Warm-Up, Stabilization, Consolidation 순서로 라우터·백본·전문가 파라미터에 점점 더 엄격한 업데이트 마스크를 씌운다(Figure 1a).
전체 학습 스텝을 라 하고, 라우터 파라미터 , 백본 파라미터 , 전문가 의 파라미터 를 구분하자. 스텝 에서 이진 마스크 벡터 를 정의해 파라미터 업데이트를 다음과 같이 제어한다.
는 원소별 곱, 는 학습률이다. 마스크가 0인 파라미터는 그래디언트가 아무리 커도 업데이트되지 않는다. 학습 구간을 , , 셋으로 나누되 경계는 의 비율로 잡는다(, ). 는 현재 미니배치 의 도메인 에 해당하는 전문가 부분집합이다(§4.3).
Warm-Up (): 전문가를 제외한 모든 파라미터(, 포함)를 열어둔다(에 가깝게). 이 단계에서 모델이 도메인 신호를 빠르게 배우고 전문가-도메인 매핑을 초기화한다.
Stabilization (): 백본 를 얼리고, 와 에 속한 전문가만 학습 가능하게 둔다. 업데이트를 도메인 관련 전문가로 제한해 간섭을 줄이면서도, 라우터는 계속 게이팅을 다듬어 도메인 분리를 개선한다.
Consolidation (): 인 전문가 파라미터 만 학습 가능하고, 와 는 완전히 얼린다. 라우팅 행동과 백본 표현을 "고정(lock in)"하고, 남은 업데이트를 최종 도메인 특화 전문가 적응에만 집중시킨다.
마스크를 점점 조여가는 이 스케줄이 세 가지를 동시에 달성한다. (1) 초기 광범위 업데이트로 빠른 수렴, (2) 선택적 동결로 도메인 간 간섭 감소, (3) 소수 전문가에 집중하는 파라미터 효율적 최종 튜닝. Figure 1a의 초록/파랑 색 변화가 정확히 이 세 단계의 파라미터 개폐를 그린 것이다.
5. 실험 결과
5.1 실험 설정
백본. 모든 실험은 DeepSeek-V2-Lite를 백본으로 쓴다. 26개 레이어, 각 MoE 레이어당 전문가 66개, 토큰당 8개 전문가를 활성화하는 세분화 MoE다. 초기 가중치는 Wang et al.(2024)이 공개한 ESFT 체크포인트에서 가져오는데, 이 체크포인트는 대화·태스크 수행 데이터로 정렬(alignment) 학습을 거쳤지만 수학·코드 예제는 의도적으로 배제했다. 덕분에 일반 정렬 능력은 갖추되 수학·코드에는 특화되지 않은 중립적 출발점을 확보한다. 이는 수학·코드 평가에서 데이터 누출(data leakage)을 막는 장치이기도 하다.
태스크와 데이터셋. 여섯 개 도메인에 걸쳐 in-domain / out-of-domain 평가를 수행한다.
- 수학 추론: MetaMathQA로 학습, GSM8K·MATH로 평가
- 코드 생성: CodeAlpaca(Python)로 학습, HumanEval·MBPP로 평가
- 의도 인식(Intent): BDCI-19 자연어→JSON 파싱, exact-match 정확도
- 요약(Summary): BDCI-21 고객 상담 요약
- 법률(Law): BDCI-21 법률 판결 예측
- 번역(Translation): ChrEn 체로키어→영어 저자원 번역
요약·법률·번역처럼 정답이 개방형인 태스크는 gpt-4-1106-preview가 참조 답안과 비교해 0~10점으로 채점한다(§C.2).
일반 능력(망각 측정): CLUEWSC, TriviaQA, IFEval, MMLU, CEval, HellaSwag, ARC-Challenge 일곱 개 벤치마크. 파인튜닝 후 이 점수가 얼마나 유지되는지로 파국적 망각을 측정한다.
베이스라인. FFT(전체 파인튜닝), LoRA, ESFT(-Token, -Gate 두 변형)를 비교한다. 각 베이스라인은 두 체제로 평가된다. 단일 도메인(single-domain) 체제는 도메인마다 모델을 따로 학습하고, 혼합 도메인(mixed-domain) 체제는 여섯 태스크를 동일 비율로 합쳐 하나의 데이터셋으로 학습한다. 배치 크기·시퀀스 길이·학습률 스케줄·평가 간격은 공정 비교를 위해 Wang et al.(2024)과 동일하게 맞췄다.
하이퍼파라미터(§C.5). 배치 32, 최대 시퀀스 4096 토큰, 최대 500 스텝(수렴에 충분), 100 스텝마다 검증. 학습률은 {1e-5, 3e-5, 1e-4, 3e-4}에서 탐색해 FFT 3e-5, LoRA 1e-4, ESFT 1e-5, DES-MoE 1e-4를 선택했다. LoRA는 rank=8, scaling=2. 인프라는 2대 서버 × 8 × A100 40GB, 총 16 GPU다.
5.2 다운스트림 태스크 성능
혼합 도메인 학습에서 전통적 방법들이 얼마나 무너지는지가 첫 번째 관전 포인트다.
| MATH | GSM8K | HumanEval | MBPP | Intent | Summary | Law | Translation | Average | |
|---|---|---|---|---|---|---|---|---|---|
| Vanilla LM | 19.6 | 55.9 | 42.1 | 44.6 | 16.8 | 58.6 | 17.1 | 14.5 | 33.6 |
| 단일 도메인 (도메인마다 별도 모델) | |||||||||
| FFT | 23.4 | 66.4 | 42.1 | 42.2 | 78.8 | 69.4 | 47.0 | 38.4 | 51.0 |
| LoRA | 20.6 | 58.9 | 39.6 | 44.8 | 67.8 | 64.7 | 39.7 | 23.1 | 44.9 |
| ESFT-Token | 22.6 | 66.0 | 41.5 | 42.6 | 75.6 | 65.4 | 45.7 | 36.2 | 49.4 |
| ESFT-Gate | 23.2 | 64.9 | 43.3 | 41.8 | 78.6 | 65.8 | 49.1 | 35.2 | 50.2 |
| 혼합 도메인 (통합 다중 도메인 데이터) | |||||||||
| FFT (Mixed) | 22.0 | 63.0 | 40.2 | 40.1 | 71.3 | 63.5 | 41.2 | 31.8 | 46.6 |
| LoRA (Mixed) | 20.9 | 59.5 | 38.7 | 43.1 | 65.4 | 61.2 | 37.9 | 24.6 | 43.9 |
| ESFT-Token (Mixed) | 21.8 | 62.4 | 40.8 | 41.3 | 70.1 | 62.8 | 42.5 | 32.4 | 46.8 |
| ESFT-Gate (Mixed) | 22.5 | 61.7 | 41.9 | 40.5 | 73.8 | 63.1 | 45.3 | 33.1 | 47.7 |
| DES-MoE | 24.1 | 65.8 | 43.5 | 43.7 | 79.2 | 69.2 | 49.5 | 37.6 | 51.6 |
Table 1 (원논문): 다운스트림 태스크 성능. 상단은 단일 도메인 파인튜닝 베이스라인(도메인당 모델 1개), 중단은 같은 방법을 혼합 도메인에서 학습한 결과, 하단은 제안 방법의 통합 다중 도메인 파인튜닝. 최고값 볼드.
이 표에서 가장 먼저 눈에 들어오는 건 단일 → 혼합 전환에서의 성능 붕괴다. FFT는 단일 도메인 51.0에서 혼합 46.6으로 평균 4.4점 떨어진다. 도메인별로 뜯어보면 Law가 47.0 → 41.2로 5.8점이나 빠져 가장 심하게 무너진다. 모든 파라미터를 무차별적으로 업데이트하니 한 도메인의 그래디언트가 다른 도메인의 표현을 덮어쓰는, 전형적인 파국적 망각이다.
LoRA는 파라미터 효율적이지만 오히려 더 취약하다(44.9 → 43.9, 다만 단일에서도 이미 낮다). 저차원 공유 부분공간 하나로는 수학·코드·법률이 요구하는 다양한 패턴을 동시에 담지 못한다. 특히 번역(Translation)에서 단일 23.1로 이미 약한데, 이건 저자원 체로키어라는 태스크 난이도 탓이 크다.
정적 ESFT 변형들은 대부분의 전문가를 얼리고 고정된 부분집합만 튜닝하니 붕괴를 어느 정도 막는다(ESFT-Gate 50.2 → 47.7). 하지만 단일 도메인 데이터로 정한 전문가 할당이 태스크가 뒤섞이면 일반화되지 못한다. 특히 수학처럼 다중 태스크 압력에서 라우팅 분포가 크게 이동하는 도메인에서 여전히 몇 점씩 잃는다.
반면 DES-MoE는 51.6로, 혼합 FFT를 5.0점 앞선다. 더 놀라운 대목은 단일 도메인 FFT(51.0)마저 넘어선다는 점이다. 도메인마다 모델을 따로 학습한 것보다, 하나의 통합 모델이 오히려 더 낫다. Law(49.5)와 Translation(37.6)처럼 까다로운 도메인에서 단독 학습 수준을 유지하거나 개선한다. 배치마다 어떤 전문가가 필요한지 다시 추정하고 무관한 파라미터를 단계적으로 얼리는 전략이, 법률 업데이트가 수학 전문가를 흔들지 못하게 막은 결과다. 조건부 연산 패러다임을 존중하면 통합 학습에서도 전문성이 보존된다는 것을 수치로 보여준다.
5.3 일반 능력 유지
특화 태스크를 잘하는 것과 별개로, 파인튜닝이 모델의 폭넓은 언어·추론 능력을 갉아먹지 않는지가 두 번째 질문이다.
| CLUEWSC | TriviaQA | IFEval | MMLU | CEval | HellaSwag | ARC | Average | |
|---|---|---|---|---|---|---|---|---|
| Vanilla LM | 81.5 | 67.7 | 42.5 | 57.5 | 59.9 | 74.0 | 53.7 | 62.4 |
| 단일 도메인 (도메인마다 별도 모델) | ||||||||
| FFT | 80.9 ± 1.1 | 65.9 ± 0.7 | 34.2 ± 4.1 | 55.5 ± 1.0 | 58.8 ± 0.9 | 67.9 ± 3.8 | 48.4 ± 2.4 | 58.8 ± 1.3 |
| LoRA | 74.3 ± 7.7 | 63.4 ± 5.4 | 38.7 ± 2.5 | 55.5 ± 1.2 | 57.0 ± 1.5 | 72.8 ± 1.9 | 51.8 ± 2.3 | 59.1 ± 2.5 |
| ESFT-Token | 80.9 ± 0.9 | 66.7 ± 1.8 | 40.7 ± 1.3 | 57.1 ± 0.5 | 59.6 ± 0.8 | 72.3 ± 3.6 | 52.9 ± 1.5 | 61.5 ± 1.1 |
| ESFT-Gate | 81.4 ± 1.1 | 66.5 ± 2.3 | 40.2 ± 1.5 | 57.0 ± 0.4 | 59.5 ± 0.8 | 68.2 ± 9.9 | 51.5 ± 3.1 | 60.6 ± 2.3 |
| 혼합 도메인 (통합 다중 도메인 데이터) | ||||||||
| FFT (Mixed) | 76.2 | 61.3 | 30.8 | 53.1 | 55.4 | 65.7 | 45.9 | 55.5 |
| LoRA (Mixed) | 73.5 | 60.8 | 34.6 | 54.3 | 54.9 | 70.2 | 48.7 | 56.7 |
| ESFT-Token (Mixed) | 78.4 | 63.5 | 36.1 | 55.7 | 56.3 | 69.8 | 49.2 | 58.4 |
| ESFT-Gate (Mixed) | 79.1 | 64.2 | 37.9 | 56.0 | 57.1 | 68.5 | 50.3 | 59.0 |
| DES-MoE | 81.7 | 67.3 | 42.9 | 58.2 | 60.5 | 73.3 | 53.1 | 62.4 |
Table 2 (원논문): 혼합 도메인 파인튜닝 하 일반 능력 평가. 제안 방법은 동적 전문가 격리를 통해 원래 능력을 유지하는 반면, 전통적 방법은 혼합 도메인 학습 시 파국적 망각을 겪는다.
여기서 DES-MoE의 강점이 극적으로 드러난다. 혼합 FFT는 평균 62.4(Vanilla) 기준에서 55.5까지 무너진다. 무제한 파라미터 업데이트가 사전학습 지식을 침식한 것이다. LoRA도 완전히 절연하지 못해 56.7에 그친다. 정적 ESFT는 좀 낫지만(ESFT-Gate 59.0), 개별 도메인에서 정한 고정 전문가 선택이 여러 태스크를 저글링할 때 부서진다.
DES-MoE는 평균 62.4로, Vanilla LM과 사실상 동일하다. 망각이 거의 0이다. 세부적으로 보면 MMLU(57.5 → 58.2)와 CEval(59.9 → 60.5)에서는 오히려 원본을 넘어선다. Consolidation 단계에서 비선택 전문가와 백본을 얼려 일반 지식을 "잠가둔" 덕분이고, 라우터의 증류 손실이 게이팅을 사전학습 분포 근처로 정규화한 효과이기도 하다. 새 도메인 증거가 정당화할 때만 라우팅이 벗어나고, 그렇지 않으면 원래 분포에 머무는 것이다. HellaSwag(73.3)와 ARC(53.1)도 원본과 거의 같다. 특화와 일반화를 하나의 MoE 모델 안에서 조화시킨다는 주장을, 이 표가 정면으로 뒷받침한다.
한 가지 덧붙이면, 단일 도메인 LoRA의 CLUEWSC 표준편차가 ±7.7, ESFT-Gate의 HellaSwag가 ±9.9로 유독 크다. 정적 방법들은 도메인에 따라 일반 능력 유지가 들쭉날쭉한데, DES-MoE는 혼합 학습 하나로 이 변동성 문제 자체를 우회한다.
5.4 도메인 수 증가에 따른 일반 능력 유지
파국적 망각의 진짜 시험대는 도메인이 늘어날 때다. 수학·코드 두 도메인에서 시작해 의도 인식, 요약, 법률, 번역을 임의 순서로 하나씩 추가하며, 매번 일곱 개 일반 벤치마크 평균을 측정했다.
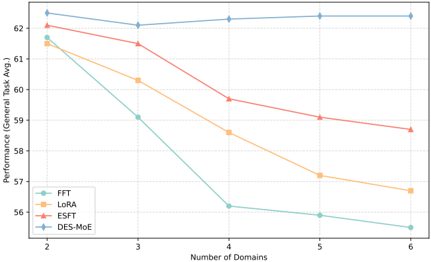
Figure 2: 도메인 수 (2에서 6)을 늘려가며 파인튜닝한 후의 일반 벤치마크 평균 점수(MMLU, TriviaQA, HellaSwag, ARC, IFEval, CEval, CLUEWSC). (원논문)
곡선의 기울기가 모든 것을 말해준다. FFT는 가파르고 가속되는 망각을 보인다. 에서 61.7이던 점수가 에서 55.5로 6.2점 떨어진다. 도메인당 기울기가 구간의 약 -1.3점에서 구간의 -2.1점으로 악화된다. 모든 파라미터를 함께 업데이트할수록 도메인이 추가될 때마다 그래디언트 충돌이 심해지고, 간섭이 복리로 쌓인다는 뜻이다.
LoRA와 정적 ESFT는 각각 약 4.8점, 3.4점을 잃으며 FFT보다는 낫지만 여전히 꾸준히(도메인당 약 -1.4점) 하락한다. 저랭크 어댑터나 고정 전문가 선택이 부분적 보호막은 되지만, 태스크 종류가 늘어날 때 도메인별 용량을 다시 격리할 유연성이 없어 결국 지식이 도메인 사이로 새어 나간다.
DES-MoE는 놀라울 만큼 평평하다. 에서 62.5로 시작해 까지 0.3점 이내로만 흔들리다 62.4로 마무리한다. 순 감소 0.1점. 동적 라우팅과 단계적 동결이 새로 추가된 도메인과 무관한 전문가를 보호하기 때문이다. 확장 단계마다 적응형 라우터가 각 도메인에 맞는 전문가를 빠르게 재식별하고, 선택적 업데이트가 이미 보호된 전문가를 건드리지 않는다. 논문이 초록에서 내세운 "도메인 2→6 확장 시 FFT 대비 망각 89% 감소"의 근거가 바로 이 그래프다(FFT는 6.2점 하락, DES-MoE는 0.1점 이하 감소이므로 대략 이 비율에 해당한다). 동적 전문가 격리가 확장 가능한 다중 도메인 MoE 파인튜닝의 강력한 메커니즘임을 보여주는 대목이다.
5.5 Ablation Study
두 핵심 구성요소(ALR, DGES)가 각각 얼마나 기여하는지, 그리고 순진한 조합이 왜 위험한지를 분리해서 본다.
| Down. (Avg.) | ∆ | Gen. (Avg.) | ∆ | |
|---|---|---|---|---|
| DES-MoE | 51.6 | - | 62.4 | - |
| w/o ALR | 48.9 | -2.7 | 59.8 | -2.6 |
| w/o DGES | 47.3 | -4.3 | 55.6 | -6.8 |
| ESFT-Mixed | 47.2 | - | 58.6 | - |
| w/ ALR | 46.8 | -0.4 | 57.3 | -1.3 |
Table 3 (원논문): Ablation study. Down.: 다운스트림 태스크 성능, Gen.: 일반 태스크 성능.
ALR을 빼면(w/o ALR) 다운스트림이 2.7점(51.6→48.9), 일반 벤치마크가 2.6점(62.4→59.8) 떨어진다. ALR이 진화하는 도메인 특징을 포착하는 역할을 한다는 증거다. 증류 제약과 태스크 손실을 섞어 사전학습 게이팅 분포를 안정시키면서도 라우터가 새 도메인에 점진적으로 적응하게 하는데, 이 장치가 없으면 라우팅 결정이 널뛰면서 특화와 일반 능력이 함께 무너진다.
DGES를 빼면(w/o DGES) 손상이 훨씬 심하다. 다운스트림 4.3점 급락, 일반 성능은 무려 6.8점 붕괴(62.4→55.6)다. 논문이 제시한 정량 근거가 인상적인데, DGES 없이는 Law와 Code 태스크 간 전문가 사용 중복이 0.18에서 0.47로 치솟는다. 전문가가 도메인 사이에서 마구 공유되면서 도메인별 지식의 명확한 할당이 무너지고, 곧바로 파국적 망각으로 이어진다. 두 구성요소 중 DGES가 망각 방지의 더 무거운 축이라는 점을 이 수치가 말해준다.
가장 흥미로운 건 마지막 두 행이다. 정적 ESFT에 ALR만 갖다 붙이면(ESFT w/ ALR) 오히려 성능이 나빠진다. 다운스트림 0.4점, 일반 벤치마크 1.3점 하락이다. 적응형 라우터를 고정된 전문가 부분집합에 붙이면 라우팅 할당 오류가 +37% 증가하고, 미리 정해진 전문가 매핑과 충돌하기 때문이다. 동적 라우팅은 호환되는 업데이트 스케줄과 짝을 이뤄야 한다는 것이다. DES-MoE의 성능이 ALR의 안정적·점진적 적응과 DGES의 표적 전문가 격리가 맞물린 시너지에서 나오며, 각 요소 단독으로는 부족하고 순진한 결합은 역효과를 낸다는 점을 이 ablation이 분명히 한다.
5.6 학습 시간 효율
성능과 별개로 벽시계 시간(wall-clock)도 실무에서는 중요한 기준이다.
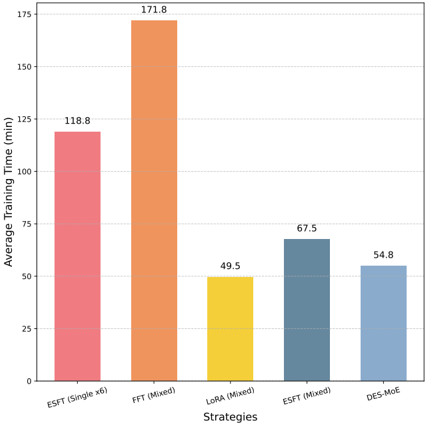
Figure 3: 여섯 개 도메인을 순차적으로 통합하는 데 필요한 총 학습 시간(분). FFT, LoRA, ESFT, DES-MoE 비교. DES-MoE는 성능을 유지하면서 FFT 대비 학습 시간을 3분의 2 이상 줄인다. (원논문)
막대들을 훑어보면 트레이드오프의 지형이 한눈에 들어온다. 혼합 데이터에 대한 FFT가 171.8분으로 압도적으로 비싸다. 모든 파라미터를 업데이트하니 당연하다. 정적 ESFT를 도메인마다 독립 실행하면 개별 실행은 빠르지만 여섯 번을 합치면 118.8분으로 누적 비용이 크다.
ESFT를 통합 혼합 체제로 돌린 Mixed-ESFT는 67.5분으로, 단일 도메인 누적 대비 43.2% 줄어든다. 하지만 이 속도의 대가로 개별 단일 도메인 모델보다 성능이 낮다(Table 1의 47.7 vs 단일 50.2). DES-MoE는 54.8분으로 Mixed-ESFT보다 20%가량 더 빠르다. 무관한 전문가를 동적으로 잘라내 매 업데이트가 건드리는 파라미터를 줄인 결과다. 게다가 DES-MoE는 속도를 얻으면서도 단일 도메인 성능을 맞추거나 넘어선다. 즉 효율과 효과를 동시에 가져간다.
가장 빠른 건 혼합 LoRA(49.5분)지만, 5.2·5.3절에서 봤듯 이 속도 이점은 혼합 도메인 파인튜닝에서 상당한 성능 저하를 대가로 한다. 결국 FFT의 171.8분을 DES-MoE의 54.8분으로 줄이면 3분의 2 이상 절감이고, 이것이 논문이 말하는 "68% 빠른 수렴"의 근거다. 성능을 희생하지 않고 이 정도 시간을 아낀다는 점에서 확장 가능한 혼합 도메인 적응의 실용적 경로가 된다.
6. 부록 (Appendix)
6.1 프레임워크 수준의 재사용성 (Appendix B)
부록 B는 DES-MoE를 프레임워크 관점에서 다시 정리한다. 별도의 전문가 부분집합이나 도메인별 모델을 학습하는 방법들과 달리, DES-MoE는 하나의 MoE 모델을 여러 도메인에 걸쳐 파인튜닝해 통합 다중 도메인 전문가 모델을 만든다. 공유 전문가로 도메인 공통 지식을 담고, 적응형 라우터로 동적 특화를 허용하는 구조다. 도메인마다 독립적으로 파인튜닝할 필요가 없어지고 희소 업데이트로 도메인당 소수 파라미터만 갱신하니, 효율 이득이 상당하다.
저자들은 여기서 한 가지 반론을 미리 방어한다. DES-MoE가 미니배치 구성을 위해 명시적 도메인 라벨에 의존하는 건 맞지만, 이 라벨은 전처리 단계에서 비지도 클러스터링으로도 얻을 수 있다는 것이다. MoE 모델이 도메인마다 별도 모델을 학습하는 부담 없이 이질적 다중 도메인 데이터에 효과적으로 적응할 수 있으며, 그것도 연산 비용의 일부만으로 가능하다는 게 이 절의 결론이다.
6.2 실험 세부 설정 (Appendix C)
부록 C는 본문 실험 설정을 상세화한다. 모델 강화 태스크(§C.1) 로 수학(MetaMathQA → GSM8K/MATH)과 코드(CodeAlpaca → HumanEval/MBPP)를, 모델 적응 태스크(§C.2) 로 체로키어-영어 번역·의도 인식·요약·법률 판결을 다룬다. 의도 인식은 출력이 정확히 일치해야 하는 JSON 구조라 exact-match 정확도를 쓰고, 나머지 개방형 태스크 셋은 GPT-4로 0~10점 채점한다.
일반 능력 평가(§C.3) 는 CLUEWSC·TriviaQA·IFEval·MMLU·CEval·HellaSwag·ARC-Challenge로 영어·중국어를 아우르는 언어 이해·지식 회상·추론을 측정한다. 백본(§C.4) 은 앞서 설명한 대로 DeepSeek-V2-Lite(26레이어, 레이어당 66전문가, top-8 활성화)이며, 수학·코드를 배제한 ESFT 정렬 체크포인트에서 출발한다. 하이퍼파라미터(§C.5) 는 배치 32, 시퀀스 4096, 최대 500스텝, 방법별 최적 학습률(FFT 3e-5 / LoRA 1e-4 / ESFT 1e-5 / DES-MoE 1e-4), 16 × A100 40GB 환경이다.
6.3 특화 태스크 평가 지침 (Appendix D)
개방형 태스크(요약·법률·번역)를 GPT-4로 채점할 때 쓴 실제 프롬프트가 부록 D의 Table 4에 담겨 있다. 채점 기준을 명시한 지침으로, 요약과 법률은 중국어, 번역은 영어로 작성돼 있다.
| Task | Evaluation Instruction (요지) |
|---|---|
| Summary | 전화 상담 요약을 10점 만점으로 채점. ① 내용 정확성(고객 문제·불만의 핵심 반영, 오기·누락 여부) ② 상세도/완전성(참조 답안의 중요 포인트 커버) ③ 내용 중복도(간결성·문체 일치) ④ 행동 지침 정확성(후속 처리 제안 일치) 항목별로 감점 후 총점 산출. {prediction}, {ground_truth} 대입. |
| Law | 법률 판결 예측을 10점 만점으로 채점. ① 관련성(가장 중요, 예측 판결과 표준 답안의 일치도) ② 완전성(당사자·금액·책임 판정·비용 부담 등 핵심 포인트 커버) ③ 정확성(세부·수치·날짜·법적 근거의 일치) ④ 객관성·전문성(적절한 법률 용어 사용). 판결 내용이 없으면 10점 감점. |
| Translation | 기계 번역을 10점 만점으로 채점. Content accuracy(핵심 반영), level of detail/completeness(중요 포인트 커버), content redundancy(간결성·문체 일치)를 평가하고 "Content accuracy x points, ..., total score: x points" 형식으로 응답. 총점은 각 점수의 평균. |
Table 4 (원논문): 모델 성능 평가를 위한 태스크 지침. {prediction}과 {ground_truth}는 각각 모델 예측과 참조 답안을 나타낸다.
이 지침들이 중요한 이유는, 요약·법률·번역 점수가 자동 채점 프롬프트의 설계에 상당히 의존한다는 점 때문이다. 항목별 감점 방식(내용 정확성·완전성·중복도·행동 지침)을 명시함으로써 GPT-4 채점의 일관성을 확보하려는 의도가 읽힌다. 다만 뒤집어 보면, Table 1의 개방형 태스크 점수는 이 채점 프롬프트와 GPT-4 버전에 종속적이라는 뜻이기도 하다. 재현 시 이 프롬프트를 그대로 써야 수치가 맞아떨어진다.
7. 논의: 도메인 라벨 없는 확장 (Discussion)
DES-MoE의 성능은 명시적 도메인 라벨에 기댄다. 현실에서는 도메인 경계가 흐릿한 경우가 많으니, 논문은 두 방향의 확장을 제안한다.
첫째, 완전 비지도 설정에서는 특징 공간 클러스터링으로 잠재 도메인 구조를 추론할 수 있다. [CLS] 토큰 표현이나 전문가 활성화 패턴에 k-means를 돌리는 방식이다. 다만 도메인들이 서로 매우 유사할 때(예: 역사 소설과 SF 소설) 전문가 특화 메커니즘이 뚜렷한 라우팅 패턴을 세우지 못해 격리 효과가 떨어지는 한계가 있다.
둘째, 약지도 설정에서는 유사도 인식 라우팅(similarity-aware routing)을 개발할 수 있다. 게이팅 네트워크에 도메인 친화도 지표를 넣어, 의미적으로 가까운 도메인끼리는 용량을 공유하고 갈라지는 도메인끼리는 격리를 유지하는 것이다.
물론 이 해법들도 새 난제를 낳는다. 클러스터링 품질이 곧 전문가 특화 품질을 좌우하고, 불완전한 클러스터는 오류를 학습 과정 전체로 전파한다. 겹치는 도메인이 많으면 전문가 격리의 이점 자체가 근본적으로 제한될 수 있어서, 전문가 특화와 공유 적응 컴포넌트를 결합한 하이브리드가 필요할 수 있다. 아키텍처 특화와 실용성 사이의 긴장을 저자들이 솔직하게 인정하는 대목이다.
8. 강점과 한계
강점
- 통합 모델로 단일 도메인 성능을 넘어선다. Table 1에서 DES-MoE(51.6)가 혼합 FFT(46.6)를 5.0점, 단일 도메인 FFT(51.0)마저 앞선다. 도메인마다 모델을 따로 만드는 ESFT의 근본 제약을 하나의 모델로 해소한 것이 가장 큰 실용적 기여다.
- 망각을 거의 완전히 억제한다. Table 2에서 DES-MoE의 일반 능력 평균(62.4)이 Vanilla LM(62.4)과 동일하고, MMLU·CEval에서는 오히려 원본을 넘는다. Figure 2의 평평한 곡선(2→6 도메인에서 0.1점 감소)은 확장성 측면에서 특히 인상적이다.
- 효율과 효과를 동시에 잡는다. Figure 3에서 FFT 171.8분을 54.8분으로 줄이면서(3분의 2 이상 절감) 성능은 오히려 올라간다. LoRA만 더 빠르지만 성능을 크게 희생한다.
- 각 설계의 기여가 정량적으로 검증됐다. Ablation(Table 3)에서 ALR·DGES의 개별 기여뿐 아니라, "정적 ESFT + ALR" 조합이 역효과라는 반례까지 제시해 두 메커니즘의 시너지를 설득력 있게 보인다. DGES 제거 시 Law-Code 전문가 중복이 0.18→0.47로 튀는 수치가 특히 구체적이다.
한계 및 아쉬운 점
- 명시적 도메인 라벨 의존. 저자도 인정하듯 DES-MoE는 도메인 라벨로 전문가-도메인 매핑을 만든다. 라벨이 없거나 경계가 흐릿한 실제 데이터에서는 바로 쓰기 어렵다. 비지도 클러스터링으로 대체할 수 있다지만, 7절에서 스스로 밝히듯 유사 도메인에서는 클러스터 품질이 격리 효과를 무너뜨릴 위험이 있다. 이 부분은 아이디어 수준의 제안에 그친다.
- 단일 백본·소규모 도메인에서만 검증. DeepSeek-V2-Lite에서 최대 6개 도메인까지만 실험했다. 수백 개의 불균형한 도메인이나 다른 MoE 아키텍처(Mixtral, Switch 등)로 확장했을 때도 동일한 안정성이 유지될지는 열려 있다.
- 하이퍼파라미터가 많다. 증류 가중치, 선택 임계값 , 모멘텀 , 단계 경계 · 등 도메인 집합이나 모델 크기가 바뀌면 재튜닝이 필요할 수 있는 값들이 여럿이다. 이 값들의 민감도 분석이 본문에 없어, 다른 세팅으로 옮길 때의 안정성을 가늠하기 어렵다.
- 동적 라우팅 통계의 오버헤드. 친화도 추적과 특화 행렬 갱신 자체가 연산을 요구한다. 자원이 빠듯한 환경에서는 이 오버헤드가 효율 이득을 상쇄할 수 있다고 저자도 한계에서 언급한다. Figure 3의 벽시계 시간에는 이 비용이 포함돼 있겠지만, 별도 분해 분석은 없다.
- 전문가 복제의 비용이 불명확하다. 두 도메인에서 겹치는 전문가를 복제한다는 장치는 깔끔하지만, 복제가 잦아지면 파라미터 수가 늘어난다. 도메인 수가 커질 때 복제로 인한 메모리 증가가 어느 정도인지 정량 보고가 없다.
- 개방형 태스크 채점의 GPT-4 의존. 요약·법률·번역 점수가 GPT-4 채점(Table 4 프롬프트)에 종속적이라, 절대 수치의 재현성과 안정성에 불확실성이 남는다.
9. 마치며
DES-MoE는 "전문가 할당을 미리 정해 고정하지 말고, 배치마다 동적으로 다시 계산하자"는 단순하지만 강력한 발상을, 세 개의 맞물린 장치로 구현한 프레임워크다. 증류로 균형 잡힌 적응형 라우터(ALR), 실시간 도메인-전문가 상관 추적과 그래디언트 격리(DGES), 그리고 라우터·백본·전문가를 순차적으로 얼리는 3단계 스케줄이 함께 작동해, 여섯 개 도메인을 하나의 MoE 모델에 담으면서도 파국적 망각을 거의 0으로 눌렀다.
수치로 다시 정리하면, 단일 도메인 ESFT급 성능을 통합 모델로 달성하면서, 도메인 2→6 확장 시 전체 파인튜닝 대비 망각을 89% 줄이고, 일반 능력의 98%를 보존하며, 68% 빠르게 수렴한다. 특히 Figure 2의 평평한 유지 곡선은 도메인이 늘어날수록 정적 방법들과의 격차가 벌어진다는 점에서, 확장성이 필요한 실무 시나리오에 직접적인 함의를 준다.
MoE를 여러 다운스트림 도메인에 배포해야 하는 팀이라면, 도메인마다 모델을 복제하는 대신 하나의 통합 모델을 유지하는 선택지를 진지하게 검토할 만하다. 남은 숙제는 명확하다. 도메인 라벨 없이도 작동하는 비지도 도메인 발견, 하이퍼파라미터 자동 튜닝, 그리고 다양한 MoE 아키텍처와 모달리티로의 확장이다. 동적 전문가 격리라는 패러다임이 이 방향들에서 어디까지 갈 수 있을지가 후속 연구의 관전 포인트가 될 것이다.
References
- Wang et al., 2024. "Let the expert stick to his last: Expert-specialized fine-tuning for sparse architectural large language models." (ESFT)
- Dai et al., 2024. "DeepSeekMoE: Towards ultimate expert specialization in mixture-of-experts language models."
- DeepSeek-AI et al., 2024a. "DeepSeek-V2: A strong, economical, and efficient mixture-of-experts language model." (백본)
- Hu et al., 2022. "LoRA: Low-rank adaptation of large language models."
- Fedus et al., 2021. "Switch transformers: Scaling to trillion parameter models with simple and efficient sparsity."
- Li et al., 2025. "Decoding knowledge attribution in mixture-of-experts: A framework of basic-refinement collaboration and efficiency analysis."
- He et al., 2015. "Delving deep into rectifiers: Surpassing human-level performance on imagenet classification." (Kaiming 초기화)
- Yu et al., 2024. "MetaMath: Bootstrap your own mathematical questions for large language models."
- Zhang et al., 2020. "ChrEn: Cherokee-English machine translation for endangered language revitalization."