논문 리뷰
논문 리뷰: Beyond instruction-conditioning, MoTE: Mixture of Task Experts for Multi-task Embedding Models
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Beyond instruction-conditioning, MoTE: Mixture of Task Experts for Multi-task Embedding Models |
| 저자 | Miguel Romero Calvo, Shuoyang Ding, Corey D. Barrett, Georgiana Dinu, George Karypis (Amazon, University of Minnesota) |
| 학회 | Findings of the Association for Computational Linguistics: ACL 2025 |
| 논문 링크 | aclanthology.org/2025.findings-acl.1168 |
| 키워드 | 텍스트 임베딩, Mixture-of-Experts, 멀티태스크 학습, 대조 학습, 임베딩 특화 |
1. 들어가며
RAG, 검색, 추천, 분류 - 요즘 실무에서 쓰이는 머신러닝 파이프라인의 상당수가 텍스트를 밀집 벡터(dense embedding)로 바꾸는 임베딩 모델에 기대고 있다. 그런데 하나의 임베딩 모델이 이 모든 작업을 동시에 잘하기란 쉽지 않다. 문제의 뿌리는 작업마다 "가깝다"의 정의가 다르다는 데 있다.
논문이 드는 예시가 이 긴장을 잘 보여준다. "Who was Isaac Newton?"과 "Who was the father of Calculus?"라는 두 질문은 의미적 유사도(STS) 관점에서는 같은 사람을 가리키니 가까워야 한다. 그런데 검색(retrieval) 관점에서는 서로가 서로의 답이 될 수 없으므로 오히려 멀어야 한다. 같은 텍스트 쌍인데 작업에 따라 정반대의 거리를 요구하는 것이다. 단일 임베딩 공간을 여러 작업에 억지로 끼워 맞추면 어느 한쪽이 손해를 볼 수밖에 없다.
이 문제에 대한 업계의 표준 해법이 바로 **Instruction-Conditioning(IC)**이다. 입력 텍스트 앞에 "query:", "passage:" 같은 작업 설명 토큰을 붙여서 같은 모델이 상황에 맞는 임베딩을 뱉도록 유도하는 방식이다. E5, Instructor 같은 최신 모델들이 모두 이 계열이다. 특화 신호가 전적으로 인스트럭션 토큰에만 실려 있고, 이 토큰이 모델을 통과하며 최종 임베딩을 바꾼다는 게 핵심 전제다.
이 논문은 바로 이 전제에 의문을 던진다. 짧은 인스트럭션 토큰 몇 개로 임베딩을 정말 충분히 갈라놓을 수 있는가? 저자들의 답은 "특히 저용량(low-capacity) 모델에서는 그렇지 못하다"이다. 그리고 그 대안으로 작업 전용 파라미터를 모델 안에 심는 MoTE(Mixture of Task Experts) 블록과, 이 전문가들을 각자의 작업에 맞게 길들이는 TA-CL(Task-Aware Contrastive Learning) 학습 커리큘럼을 제안한다. 결과적으로 추론 지연, 활성 파라미터 수, 학습 데이터, 인스트럭션을 하나도 바꾸지 않으면서 retrieval에서 64%, 전체 데이터셋에서 43% 더 큰 성능 향상을 얻었다고 주장한다.
"입력을 바꾸는" 특화에서 "모델 내부 경로를 바꾸는" 특화로의 전환. 이 한 줄이 논문의 요지다.
2. 왜 Instruction-Conditioning만으로는 부족한가
IC의 한계를 논문은 이론과 실증 두 축으로 공격한다.
이론적 근거는 신경망의 **Lipschitz 연속성(Lipschitz continuity)**이다. Lipschitz 연속인 함수는 입력의 작은 변화가 출력의 작은 변화만 만든다. 인스트럭션 토큰을 몇 개 붙이는 건 입력 시퀀스 입장에서 보면 아주 작은 변화다. 그렇다면 출력 임베딩도 조금밖에 안 움직인다는 뜻이 되고, 이는 곧 작업별로 크게 벌어진(disentangled) 표현을 만들기 어렵다는 제약으로 이어진다. Tang et al.(2024)이 지적한 이 성질은 모델이 작을수록, 프롬프트가 짧을수록 더 심해진다. 저차원 임베딩은 정보 병목(information bottleneck, Tishby et al. 2000)에 걸려 의미 정보와 작업 정보를 동시에 담을 여유가 없기 때문이다.
여기에 멀티태스크 대조 학습의 고질적 문제까지 겹친다. 여러 작업을 한 모델로 동시에 학습하면 **그래디언트 간섭(gradient interference, Yu et al. 2020)**과 상충하는 목적함수(Ravi et al. 2020)가 모델의 용량을 잠식한다. 게다가 배치 구성 전략이나 대조 온도(contrastive temperature) 같은 하이퍼파라미터는 작업별로 최적값이 다른데, 단일 모델을 학습하면 이 값들을 하나로 타협해야 한다. 특화가 제대로 될 리 없다.
이 주장을 눈으로 보여주는 게 Figure 1이다.
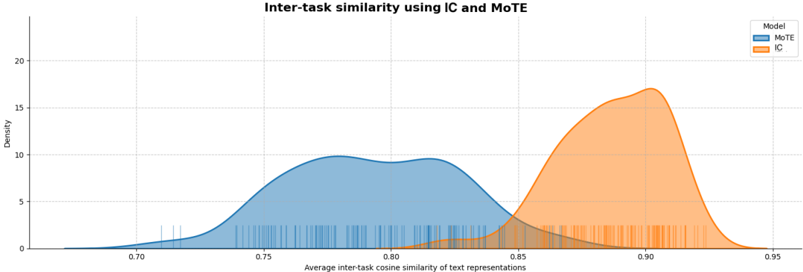
Figure 1 (원논문): 같은 시퀀스를 서로 다른 작업용으로 임베딩했을 때, 작업 간 평균 코사인 유사도의 분포. 파란색이 MoTE, 주황색이 IC.
가로축은 하나의 시퀀스를 여러 작업(분류, 클러스터링, 검색-질의, 검색-문서)용으로 각각 임베딩한 뒤 그 임베딩들 사이의 평균 코사인 유사도다. 값이 높다는 건 작업이 달라져도 임베딩이 거의 똑같다는 뜻, 즉 특화가 안 됐다는 신호다. IC(주황색)는 분포가 0.90 언저리에 몰려 있다. 작업 라벨만 바꿔 붙였을 뿐 나오는 벡터는 사실상 그대로라는 얘기다. 반면 MoTE(파란색)는 0.78~0.82 부근으로 확 내려앉아 있고 분포도 넓게 퍼진다. 같은 데이터, 같은 학습 과정을 거쳤는데도 MoTE가 작업별로 훨씬 다른 임베딩을 만들어낸다는 것이다. 특화의 여지가 IC에서는 구조적으로 막혀 있었다는 저자들의 가설을 뒷받침하는 그림이다.
3. 배경 지식
3.1 텍스트 임베딩 모델과 InfoNCE
임베딩 모델 는 시퀀스 공간 의 원소를 의 밀집 벡터로 보낸다. 보통 BERT나 RoBERTa 같은 인코더 전용 사전학습 체크포인트에서 출발해, 서로 가까워야 할 시퀀스 쌍 (검색의 질의-문단, 클러스터링의 문단-문단 등)로 대조 학습을 한다. 이때 가장 널리 쓰이는 손실이 InfoNCE(Oord et al. 2018)로, 형태는 다음과 같다.
여기서 는 시퀀스 를 임베딩한 벡터, 는 코사인 유사도 같은 유사도 함수, 는 같은 미니배치 안의 다른 포지티브(in-batch negative로 기능)들, 는 온도 파라미터다. 이 손실은 비슷한 시퀀스는 끌어당기고 다른 시퀀스는 밀어내며 를 최적화하는데, "비슷하다"의 정의가 작업마다 다르다는 게 앞서 말한 갈등의 원천이다.
3.2 Instruction-Conditioned 임베딩
IC는 입력 시퀀스에 작업을 설명하는 텍스트 문자열을 이어 붙여 하나의 모델로 특화 임베딩을 만드는 기법이다. 이 연결은 학습과 추론 양쪽에서 일어난다. 형식적으로 IC 모델은 인스트럭션 집합 와 시퀀스 집합 위에서
로 정의된다. 는 시퀀스 공간에서의 연결(concatenation) 연산이다. 인스트럭션의 상세도는 모델마다 다른데, 작은 모델(Wang et al. 2022)은 "query:", "passage:"처럼 작업 수준의 정형화된 인스트럭션을 쓰고, 큰 모델(Su et al. 2022)은 "Represent the Amazon comment for classifying the sentence as positive or negative:"처럼 데이터셋별 자유 형식 인스트럭션을 쓴다.
3.3 Mixture-of-Experts
MoE는 분할 정복 발상이다. 여러 전문가(expert) 모듈과 라우팅 메커니즘을 두고, 입력마다 가장 적합한 전문가를 골라 처리한다. 트랜스포머 MoE 블록(Lepikhin et al. 2020; Jiang et al. 2024)은 여러 MLP를 전문가로 두고, 토큰 단위로 학습된 라우터 가 각 토큰을 어느 전문가로 보낼지 결정한다. 선택된 전문가들이 토큰 표현을 독립적으로 처리한 뒤 풀링 레이어가 결과를 합친다. 학습 중에는 전문가들이 골고루 쓰이도록 보조적인 부하 균형(expert-balancing) 목적함수를 함께 최적화한다.
여기서 짚어둘 점 하나. 전통적 MoE의 라우팅은 토큰 단위이고, 무엇을 어느 전문가로 보낼지를 데이터로부터 학습한다. MoTE는 바로 이 지점을 뒤집는다.
4. 제안 방법: MoTE와 TA-CL
4.1 문제의 형식화
IC가 인스트럭션 하나에만 특화를 의존하면서 나머지 파라미터를 전부 공유하기 때문에 한계에 부딪힌다는 게 논문의 진단이다. 그렇다면 해법은 자연스럽다. 작업 전용 파라미터를 모델에 추가하되, 활성 파라미터 수는 그대로 유지하면 된다. 저자들은 함수 를 다음과 같이 정의한다.
는 모든 작업이 공유하는 파라미터(어텐션, 임베딩 층 등), 는 작업별 특화 파라미터의 집합, 는 인스트럭션 에 대해 선택된 특화 파라미터다. IC와 마찬가지로 입력은 튜플 로, 는 "query:", "passage:" 같은 작업 인스트럭션이고 는 실제 시퀀스다. 결정적 차이는 IC가 를 그냥 이어 붙여 공유 파라미터로 밀어 넣는 반면, 는 인스트럭션 를 보고 어떤 특화 파라미터 를 통과시킬지 동적으로 선택한다는 점이다. 입력 정보는 IC와 완전히 같지만, 그 입력이 지나가는 경로가 달라지는 것이다.
4.2 MoTE 아키텍처
이 를 실제로 구현한 것이 MoTE 트랜스포머 블록이다.
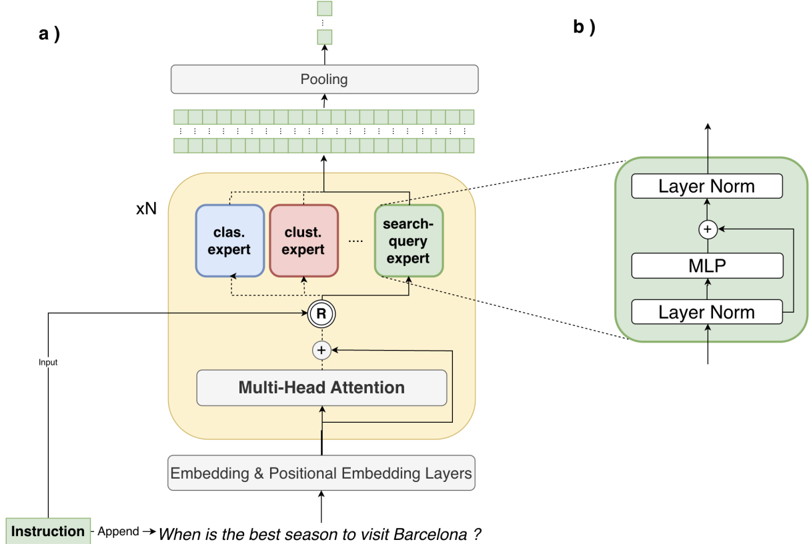
Figure 2 (원논문): (a) MoTE 블록 개요. 인스트럭션이 라우터(R)를 통해 작업별 전문가를 선택한다. (b) 전문가 하나의 내부 구조 - Layer Norm, MLP, Layer Norm으로 표준 트랜스포머 피드포워드 구성을 그대로 따르되 전문가마다 독립적으로 적용된다.
Figure 2(a)를 따라가 보면 동작이 한눈에 들어온다. 맨 아래에서 인스트럭션("When is the best season to visit Barcelona?" 같은 실제 입력 앞에 붙는 작업 태그)이 입력에 append되고, 임베딩·포지셔널 층과 Multi-Head Attention을 거친다. 그다음 라우터 이 등장하는데, 여기가 표준 MoE와 갈리는 지점이다. 라우터는 토큰 내용을 학습해서 판단하는 게 아니라 인스트럭션에 따라 결정론적으로 전문가를 고른다. 분류면 clas. expert, 클러스터링이면 clust. expert, 검색-질의면 search-query expert로 시퀀스 전체를 통째로 보낸다. 이 블록이 번 쌓이고, 마지막에 풀링으로 최종 임베딩을 만든다.
Figure 2(b)는 전문가 하나의 속을 보여준다. Layer Norm → MLP → Layer Norm(잔차 연결 포함) 구조로, 표준 트랜스포머의 피드포워드 블록과 형태가 같다. 다만 이 세트가 전문가마다 따로 존재한다는 게 포인트다. MLP는 작업별 변환을 담당하고, 두 정규화 층은 작업마다 서로 다른 중심값(centroid)과 분산을 학습하게 해준다(Ba, 2016). 작업별로 임베딩 공간의 위치와 퍼짐 정도를 따로 잡아줄 수 있으니 적응력이 올라간다.
이 설계가 주는 이점이 두 가지다. 첫째, 전통적 MoE와 달리 각 전문가가 오직 자기 작업의 예시로만 학습된다. 라우팅이 인스트럭션으로 고정되어 있으니, 분류 전문가에는 분류 데이터만, 검색 전문가에는 검색 데이터만 흘러 들어간다. 학습이 더 효율적이고 특화도 더 깨끗하다. 둘째, 토큰을 여러 전문가에 흩뿌리는 대신 시퀀스 하나를 단일 전문가로 통째로 보내기 때문에 추론 지연이 늘지 않는다. 어느 순간에도 활성화되는 파라미터는 IC와 동일하다.
메모리는 어떨까? 전문가가 여럿이니 파라미터 총량은 늘어난다. 하지만 저자들은 임베딩 모델이 현실에서는 한 번에 한 작업만 쓴다는 관찰(검색-인덱싱, 검색-질의, 분류 등)을 파고든다. 지금 안 쓰는 전문가는 CPU나 디스크로 내려보내면(offload) GPU 메모리 사용량을 IC 수준으로 유지할 수 있다는 것이다.
4.3 초기화: 사전학습 블록을 업사이클링
MoTE의 라우팅은 작업 태그가 붙은 입력을 전제한다. 그런데 작업 데이터셋은 대조 학습 단계에서만 존재하고, 일반 사전학습은 작업과 무관한 범용 시퀀스로 이뤄진다. 이 간극을 어떻게 메울까?
저자들은 사전학습된 밀집 블록을 대조 학습 전에 MoTE 블록으로 **업사이클링(up-cycling, Komatsuzaki et al. 2022)**한다. 세 단계다. (1) MoTE로 바꿀 밀집 트랜스포머 블록을 고른다. (2) 각 블록마다 원래 MLP와 동일한 구성으로 개의 전문가를 만든다. (3) 모든 전문가를 원본 MLP 가중치의 복사본으로 초기화한다. 처음엔 모든 전문가가 똑같은 상태에서 출발하지만, 대조 학습을 거치며 각자 자기 작업 쪽으로 분화된다. 사전학습 지식은 보존하면서 작업 특화의 유연성만 새로 얻는 셈이다.
4.4 TA-CL: 작업 인지 대조 학습
전문가를 만들어놨다고 끝이 아니다. 문제는 대조 학습이 같은 미니배치 안의 네거티브에 의존한다는 데 있다. 그런데 작업마다 최적의 배치 구성 전략과 대조 온도가 다르다(자세한 근거는 6절 부록 분석에서 다룬다). 한 배치에 여러 작업을 섞으면 어느 작업엔 안 맞는 설정을 강요하게 된다.
TA-CL은 이 문제를 이렇게 푼다. 학습 샘플을 작업 → 데이터셋의 계층 구조로 조직해두고, 미니배치를 만들 때 먼저 하나의 작업을 고른 다음 그 작업의 데이터셋에서 해당 작업의 배치 전략에 맞게 샘플을 뽑는다. 그리고 작업 메타데이터를 미니배치와 함께 학습 루프로 넘겨서 대조 목적함수를 그 작업에 맞게 조정한다. MoTE와 결합하면, 각 전문가가 자기 작업에 최적화된 설정(배치 구성 + 온도)으로만 학습되도록 보장된다. 구체적으로 검색 미니배치는 동질적(homogeneous) 배치와 온도 0.03, 분류 미니배치는 이질적(heterogeneous) 배치와 온도 0.03, 클러스터링 미니배치는 이질적 배치와 온도 0.06을 쓴다.
5. 실험 설정
평가는 **MTEB(Massive Text Embedding Benchmark, Muennighoff et al. 2022)**로 한다. 7개 작업, 56개 데이터셋을 아우르는 사실상의 표준 벤치마크다. 작업별 데이터셋 분포와 지표는 다음과 같다.
| Task | # Datasets | Metric |
|---|---|---|
| Retrieval | 15 | NDCG@10 |
| Class. | 12 | Accuracy |
| Clustering | 11 | V-Measure |
| Re-ranking | 4 | MAP |
| Pair Class. | 3 | AP |
| STS | 10 | Spearman corr. |
| Summ. | 1 | Spearman corr. |
Table 1 (원논문): MTEB 벤치마크의 작업별 데이터셋 분포와 평가 지표. 총 56개 데이터셋.
여기서 중요한 설계 하나. 학습에는 분류·클러스터링·검색 세 작업의 데이터만 쓴다. 나머지 네 작업(재랭킹, 페어 분류, STS, 요약)은 학습에서 본 적 없는 미학습(unseen) 작업으로, 일반화 성능을 재는 데 쓰인다. 즉 15+12+11=38개 데이터셋이 학습된(seen) 작업, 4+3+10+1=18개가 미학습 작업이다.
백본은 Nussbaum et al.(2024)의 nomic-bert-2048로, 100~250M 파라미터 구간에서 상위 10위 안에 드는 저용량 모델이다(2025년 2월 8일 기준). 저용량 모델을 고른 건 우연이 아니다. IC의 용량 병목이 가장 도드라지는 영역이 바로 여기이기 때문이다.
비교 대상은 네 가지다.
- EM (Embedding Model): 특화를 전혀 안 한 범용 모델. 모든 성능 향상의 기준선이다.
- SEM (Specialized Embedding Model): 각 작업(분류/클러스터링/검색)에 대해 따로따로 독립 학습한 단일 작업 전용 모델 세 개.
- IC (Instruction-Conditioning): 인스트럭션 기반 특화 모델. 논문 부록에서는 IEM(Instruction-conditioned EM)으로도 표기된다.
- MoTE: 제안 모델.
공정성을 위해 IC와 MoTE는 같은 체크포인트에서 출발하고, 같은 데이터로 InfoNCE + AdamW(학습률 , weight decay 0.1, 배치 크기 6,144)로 1 에폭만 학습한다. 둘 다 동일한 인스트럭션("classification:", "clustering:", "search query:", "search document:")을 쓴다. MoTE는 모든 트랜스포머 블록을 MoTE 블록으로 바꾸고 각 블록에 4개 전문가(위 네 인스트럭션에 대응)를 둔다.
6. 실험 결과
6.1 학습된 작업에서의 성능
먼저 학습에 쓴 세 작업(검색·분류·클러스터링)의 결과다. 표의 EM 열은 특화 없는 모델의 절대 성능이고, 나머지 열은 EM 대비 상대적 향상폭이다.
| Task | EM | SEM | IC | MoTE |
|---|---|---|---|---|
| Retrieval | 42.31 | -8.86 | +3.27 | +5.21 |
| Class. | 65.37 | -1.29 | +3.37 | +3.79 |
| Clustering | 42.95 | -3.84 | +0.14 | -0.06 |
| Average | 49.78 | -5.02 | +2.35 | +3.23 |
Table 2 (원논문): 학습된 작업에서 EM 대비 각 특화 방법의 성능 향상. Retrieval은 NDCG@10, Class.는 정확도, Clustering은 V-Measure, Average는 38개 데이터셋 평균.
검색에서 MoTE는 +5.21로 IC의 +3.27을 크게 앞선다. 향상폭 자체가 60% 가까이 커진 셈이다. 분류에서도 +3.79 대 +3.37로 MoTE가 우위다. 전체 평균으로 보면 +3.23 대 +2.35로, 지연·메모리를 그대로 유지하면서 얻은 격차라는 점에서 의미가 있다.
여기서 두 가지가 눈에 띈다. 첫째, 클러스터링만 예외다. MoTE가 -0.06으로 오히려 살짝 뒤처지고 IC도 +0.14에 그친다. 저자들은 이를 검색-문서(search-document)와 클러스터링의 임베딩 공간이 원래 서로 비슷하기 때문으로 본다. 두 작업을 억지로 갈라놓는 게 별 이득이 없다는 것인데, 이 가설은 6.2절에서 다시 검증된다. 둘째, 작업별로 따로 학습한 SEM이 전 작업에서 큰 폭의 마이너스(-5.02 평균)를 기록한다. 단일 작업에만 집중하면 오히려 성능이 떨어진다는, 다소 반직관적인 결과다. 멀티태스크 학습이 작업 간 시너지를 통해 표현력을 끌어올린다는 통념을 뒷받침하며, 동시에 MoTE의 접근(한 모델 안에서 작업별 특화)이 왜 SEM보다 나은지를 설명해준다. 전문가를 분리하되 공유 파라미터로 시너지는 유지하는 구조이기 때문이다.
6.2 작업 간 유사도 분석
Figure 1에서 봤던 "MoTE가 임베딩을 더 잘 분리한다"는 가설을 통계적으로 못 박는 실험이다. 논리는 이렇다. 만약 IC에 이미 충분한 용량이 있어서 임베딩을 잘 분리하고 있다면, 특화 용량을 키운 MoTE로 바꿔도 작업 간 유사도에 큰 차이가 없어야 한다. 반대로 IC가 용량 부족으로 분리를 못 하고 있었다면, 같은 데이터·같은 학습으로 용량만 키운 MoTE에서 유사도가 확 낮아질 것이다.
검증을 위해 위키피디아 문서 128개를 뽑아 각각 클러스터링·분류·검색-문서·검색-질의용으로 임베딩한 뒤, 작업 쌍마다 코사인 유사도를 잰다. 그리고 각 쌍에 대해 단측 Welch's t-검정으로 다음 가설을 검정한다.
은 방법 에서 작업 과 사이의 참 코사인 유사도다. 즉 "MoTE가 IC보다 작업 간 유사도가 낮다(더 잘 분리한다)"를 대립가설로 세운 것이다.
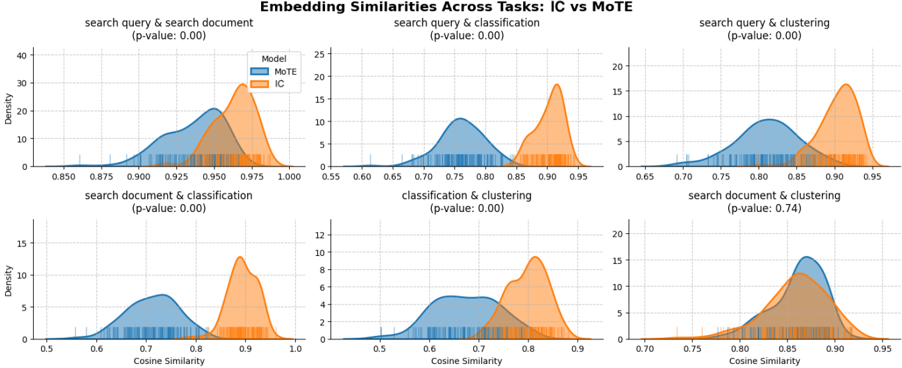
Figure 3 (원논문): 여섯 개 작업 쌍 각각에 대한 IC(주황)와 MoTE(파랑)의 작업 간 유사도 분포와 t-검정 p-value. 마지막 search document & clustering만 p=0.74로 유의하지 않다.
여섯 개 부분 그림 중 다섯 개(search query & search document, search query & classification, search query & clustering, search document & classification, classification & clustering)는 모두 p=0.00으로, MoTE(파랑)의 분포가 IC(주황)보다 확연히 왼쪽에 있다. 어떤 쌍에서는 코사인 유사도가 최대 0.3까지 낮아진다. MoTE가 작업별 임베딩을 훨씬 크게 벌려놓는다는 것이 통계적으로 확인된 것이다.
정작 흥미로운 건 마지막 그림, search document & clustering이다. 여기서만 p=0.74로 두 방법의 차이가 유의하지 않다. MoTE든 IC든 이 두 작업의 임베딩을 별로 다르게 만들지 못한다는 뜻이다. 이는 6.1절에서 클러스터링만 MoTE의 이득이 없었던 현상과 정확히 맞물린다. 검색-문서와 클러스터링은 표현 요구가 원래 거의 같아서, 굳이 전문가를 나눠봐야 실익이 없다는 것이다. 저자들이 결론에서 "관련 작업끼리는 전문가를 통합하는 게 나을 수 있다"며 하이브리드 방향을 제안하는 근거가 바로 이 관찰이다.
6.3 미학습 작업으로의 일반화
작업별 특화를 강하게 밀어붙이면 학습한 작업들에만 지나치게 맞춰져(over-specialized) 새 작업엔 취약해질 위험이 있다. MoTE는 작업별 파라미터까지 두니 이 위험이 더 크다. 그래서 학습에서 안 본 네 작업으로 검증한다. 재랭킹은 검색 작업에, 페어 분류·STS·요약은 분류 작업에 매핑해서 해당 전문가를 빌려 쓴다.
| Task | EM | SEM | IC | MoTE |
|---|---|---|---|---|
| Re-ranking | 55.38 | -7.35 | -2.01 | -0.45 |
| Pair Class. | 81.52 | -8.22 | -0.8 | +0.29 |
| STS | 77.91 | -2.82 | +2.11 | +2.15 |
| Summa. | 32.31 | -5.86 | +1.45 | +2.01 |
| Average | 70.97 | -4.90 | +0.67 | +1.25 |
Table 3 (원논문): 학습에 쓰이지 않은 작업에서의 성능. Re-ranking은 MAP, Pair Class.는 AP, STS·Summa.는 Spearman 상관, Average는 18개 데이터셋 평균.
MoTE가 대부분에서 IC를 앞선다. STS(+2.15)와 요약(+2.01)에서 가장 큰 이득을 얻어 미학습 작업에도 잘 적응한다는 걸 보여준다. 페어 분류에서는 MoTE가 +0.29로 소폭 개선한 반면 IC는 -0.8로 오히려 떨어진다. 전체 평균은 +1.25 대 +0.67로 MoTE가 두 배 가까이 앞선다.
유일하게 두 방법 모두 EM보다 못한 작업이 재랭킹(MoTE -0.45, IC -2.01)이다. 저자들은 검색 학습 데이터와 재랭킹 평가 데이터 사이의 분포 차이를 원인으로 든다. 재랭킹 데이터셋 중에는 비정상적으로 긴 질의나 질문 중복 판별 같은 특이한 형식이 섞여 있어 표준 검색 학습 시나리오와 어긋난다는 것이다. 이런 경우엔 특화된 임베딩 공간보다 범용 EM의 넓은 공간이 오히려 유리하다. 특화가 항상 정답은 아니라는, 정직한 관찰이다. 그래도 MoTE가 IC보다는 손실을 훨씬 덜 본다는 점(-0.45 대 -2.01)은 MoTE의 특화가 과적합이 아니라 견고한 방향임을 시사한다.
6.4 Ablation: TA-CL의 기여
TA-CL이 정말 효과가 있는지, 배치 전략과 온도를 작업 인지 방식으로 바꾼 것과 정적(static) 방식을 비교한다. 정적 학습은 모든 작업에 이질적 배치와 온도 0.03을 일괄 적용한다.
| Task | Static | TA-CL |
|---|---|---|
| Retrieval | 46.48 | 47.52 |
| Classification | 69.00 | 69.16 |
| Clustering | 42.82 | 42.89 |
| Re-ranking | 54.69 | 54.93 |
| Pair Classification | 81.93 | 81.81 |
| STS | 79.70 | 80.03 |
| Summarization | 34.06 | 34.32 |
| Avg. dataset performance | 58.78 | 59.19 |
Table 4 (원논문): MoTE를 정적 학습 대 TA-CL로 학습했을 때의 비교.
TA-CL이 거의 모든 작업에서 조금씩 이긴다. 가장 큰 이득은 검색에서 나온다(46.48 → 47.52). 정적 방식은 검색에 이질적 배치를 강요했지만, TA-CL은 검색에 맞는 동질적 배치를 써서 1점 넘게 끌어올렸다. 전체 평균으로는 56개 데이터셋에서 +0.41 향상. 단측 Welch's t-검정 결과 p-value가 로 0.05를 한참 밑돌아, 이 개선이 통계적으로 유의하다. 페어 분류에서만 아주 미세하게(81.93 → 81.81) 뒤처지는데, 워낙 작은 차이라 큰 의미를 두긴 어렵다. 정적 방식이 강제한 타협을 TA-CL이 작업별로 풀어준다는 게 핵심 메시지다.
7. Ablation: MoTE 라우팅 vs MoE 라우팅
MoTE의 정체성을 가르는 실험이다. 전통적 MoE는 학습된 **토큰 단위 라우팅(Token-Level Routing, TLR)**을 쓰지만, MoTE는 작업 정보를 직접 활용하는 **시퀀스 단위 라우팅(Sequence-Level Routing, SLR)**을 쓴다. 시퀀스 전체를 하나의 전문가로 보내니 IC 수준의 처리 효율을 유지하면서도 전문가를 작업 데이터로만 학습시킬 수 있다. 공정한 비교를 위해 TLR에도 동일한 작업 인스트럭션을 입력에 붙여줘서 라우팅에 작업 정보를 쓸 수 있게 했다.
| Task | TLR | SLR |
|---|---|---|
| Retrieval | 45.17 | 47.52 |
| Classification | 67.98 | 69.16 |
| Clustering | 42.69 | 42.89 |
| Reranking | 54.40 | 54.93 |
| Pair Classification | 80.84 | 81.81 |
| STS | 78.47 | 80.06 |
| Summarization | 32.67 | 34.32 |
| Average | 57.86 | 59.19 |
Table 5 (원논문): MoE의 토큰 단위 라우팅(TLR)과 MoTE의 시퀀스 단위 라우팅(SLR) 성능 비교. 56개 데이터셋 평균.
SLR이 전 작업에서 예외 없이 TLR을 이긴다. 격차가 큰 곳은 검색(+2.35), STS(+1.59), 요약(+1.65), 페어 분류(+0.97)다. 전체로는 56개 데이터셋 평균 +1.33 향상이고, 단측 Welch's t-검정 p-value가 로 0.05 아래라 유의하다. 이 결과가 중요한 이유는, MoTE의 이득이 단순히 "파라미터를 더 넣어서"가 아니라 라우팅 방식 자체에서 온다는 걸 보여주기 때문이다. 같은 수의 전문가를 두고도, 작업 정보를 시퀀스 수준에서 명시적으로 활용하는 편이 토큰 수준에서 학습으로 알아내는 것보다 낫다. 각 전문가가 자기 작업 데이터로만 깨끗하게 학습된다는 4.2절의 주장이 수치로 확인된 셈이다.
8. Ablation: MoTE 블록 배치 위치
MoE 블록을 트랜스포머에 넣는 방식은 크게 둘이다. **모든 블록(Every Block, EB)**에 넣거나(Fedus et al. 2022), 한 블록 걸러(Every Other Block, EOB) 넣는다(Lepikhin et al. 2020). 전자는 국소(local) 파라미터화, 후자는 전역(global) 파라미터화 쪽으로 균형이 기운다.
| Task | EB | EOB |
|---|---|---|
| Retrieval | 47.52 | 47.20 |
| Classification | 69.16 | 69.17 |
| Clustering | 42.89 | 42.81 |
| Re-ranking | 54.93 | 54.91 |
| Pair Classification | 81.81 | 81.83 |
| STS | 80.06 | 79.96 |
| Summarization | 34.32 | 33.97 |
| Average | 59.19 | 59.07 |
Table 6 (원논문): MoTE 블록을 모든 블록(EB)에 넣을 때와 한 블록 걸러(EOB) 넣을 때의 비교. 56개 데이터셋 평균.
결론부터 말하면 차이가 거의 없다(평균 59.19 대 59.07). EB가 검색·STS·요약에서 근소하게 앞서고, EOB는 페어 분류에서만 아주 살짝 낫다. 전체적으로 EB가 미세하게 우세해서 본 실험은 EB를 채택하지만, 이 차이는 실질적으로 무의미한 수준이다. 뒤집어 말하면, 모든 블록을 MoTE로 바꾸지 않고 절반만 바꿔도 성능은 거의 그대로라는 얘기다. 파라미터 예산이 빠듯하다면 EOB로 메모리를 아끼는 선택이 충분히 합리적이라는 실무적 함의가 있다.
9. Appendix: 보충 실험
9.1 하이퍼파라미터 민감도 분석 (Appendix A)
TA-CL이 작업별로 배치 전략과 온도를 왜 달리 가져가는지, 그 근거가 되는 통제 실험이다.
배치 전략(Batching Strategy). 대조 학습에서 in-batch 네거티브를 어떻게 고르느냐는 작업 성격에 달렸다. STS 같은 국소적 의미 구분이 중요한 작업은 미세한 의미 차이를 잡아내는 근접 네거티브가 필요하다. 논문이 든 예시가 "Vivendi shares closed 1.9 percent at 15.80 euros in Paris..."와 "in new york, vivendi shares were 1.4 percent down at $18.29" 같은 쌍인데, 이런 건 세밀한 문맥 구별을 요구한다. 반대로 분류·클러스터링처럼 전역적 표현이 중요한 작업은 더 다양한 네거티브가 유리하다. 이를 동질적(homogeneous, 한 데이터셋 안에서 샘플링) 대 이질적(heterogeneous, 여러 데이터셋에 걸쳐 샘플링) 배치로 나눠 실험했다.
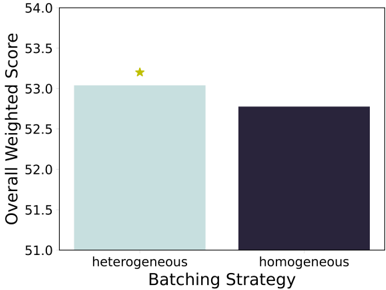
Figure 4 (원논문): 배치 전략별 전체 가중 점수. 이질적(heterogeneous) 배치가 최적(별표 표시).
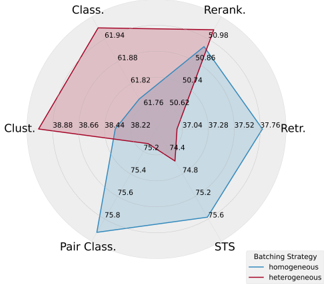
Figure 5 (원논문): 배치 전략별 작업 세부 성능. 파랑이 동질적, 빨강이 이질적 배치.
Figure 4를 보면 전체 가중 점수에서는 이질적 배치(약 53.05)가 동질적 배치(약 52.78)를 앞서 최고 점수를 낸다. 그런데 Figure 5의 레이더 차트로 작업별로 쪼개 보면 그림이 달라진다. 동질적 배치(파랑)는 STS·페어 분류·검색 같은 국소적 의미 작업에서 우세하고, 이질적 배치(빨강)는 분류·클러스터링·재랭킹 같은 전역적 작업에서 우세하다. 하나의 배치 전략으로 모든 작업을 동시에 최적화할 수 없다는 걸 명확히 보여준다. TA-CL이 검색엔 동질적, 분류·클러스터링엔 이질적 배치를 쓰는 게 이 그래프에서 나온 결정이다.
대조 온도(Contrastive Temperature). 낮은 온도는 앵커와 의미적으로 더 가까운 샘플에 상대적으로 큰 가중치를 실어 국소적 의미 차이를 잡아내고, 높은 온도는 다양한 네거티브에 가중치를 고르게 분산시킨다. 온도 0.03과 0.06을 비교했다.
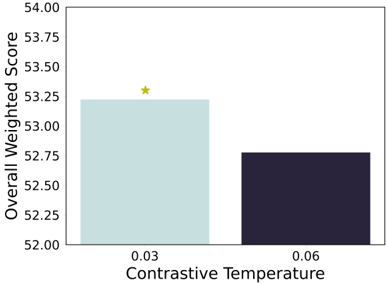
Figure 6 (원논문): 전체 최적 대조 온도. 0.03이 최적(별표 표시).
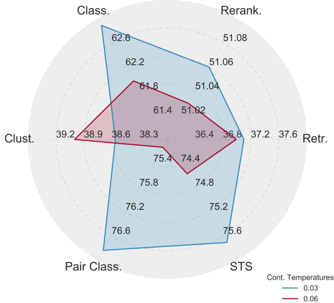
Figure 7 (원논문): 작업별 최적 대조 온도. 파랑이 0.03, 빨강이 0.06.
Figure 6에서 전체 최적은 온도 0.03(약 53.22)으로, 0.06(약 52.78)을 앞선다. 하지만 Figure 7의 작업별 분해를 보면 0.03이 전반적으로 좋아도 클러스터링만은 0.06이 낫다(약 39.2 대 38.6). 클러스터링은 전역적 의미 묶음을 다루는 작업이라 다양한 네거티브를 고르게 보는 높은 온도가 유리한 것이다. TA-CL이 클러스터링에만 온도 0.06을 쓰는 근거가 여기 있다. 배치 전략과 온도, 두 하이퍼파라미터 모두에서 "전체 최적 ≠ 작업별 최적"이라는 동일한 구조가 반복되고, 그 틈을 정확히 파고드는 게 TA-CL이다.
9.2 Expert Averaging: 메모리 절감 (Appendix B)
MoTE의 유일한 실질적 약점은 전문가가 여럿이라 메모리를 더 먹는다는 것이다. RAG 인덱싱이나 대량 분류처럼 벌크 추론이 필요한 실무에서는 처리량 저하로 이어질 수 있다. 이를 완화하려고 저자들은 추가 학습 비용 없이 전문가 블록들을 평균 내버리는(Expert Averaging, EA) 압축 기법을 제안한다.
| IEM | MoTE | EA | |
|---|---|---|---|
| Retrieval | 45.58 | 47.20 | 46.93 |
| Classification | 68.74 | 69.17 | 68.82 |
| Clustering | 43.09 | 42.81 | 42.70 |
| Reranking | 53.37 | 54.91 | 54.91 |
| Pair Classification | 80.72 | 81.83 | 81.59 |
| STS | 80.02 | 79.96 | 79.13 |
| Summarization | 33.76 | 33.97 | 33.38 |
| Average dataset performance | 58.43 | 59.07 | 58.60 |
Table 7 (원논문): EA를 IEM(인스트럭션 특화 모델), MoTE와 비교. 56개 데이터셋 평균.
EA는 여러 전문가를 하나로 평균 내므로 메모리는 IEM 수준으로 돌아가면서도, IEM 대비 평균 +0.17(58.43 → 58.60)의 성능을 유지한다. MoTE의 +0.64(59.07)에는 못 미치지만, 향상분의 상당 부분을 보존하는 셈이다. 이 유지분은 주로 검색(+1.35 NDCG@10)과 재랭킹(+1.54 MAP)에서 나온다. 반대로 STS나 요약에서는 EA가 IEM보다 오히려 떨어지는데, 전문가를 평균 내면서 국소적 특화가 희석되기 때문으로 보인다. 메모리와 성능 사이의 타협점을 제공하는 실용적 옵션이라고 볼 수 있다.
9.3 평가 지표 정의 (Appendix C)
논문 부록은 MTEB에서 쓰는 지표들을 수식으로 정리한다. 리뷰의 완결성을 위해 옮겨둔다.
NDCG@10 - 검색 순위 품질. 이상적 순위 대비 실제 순위의 상대 품질을 잰다.
는 번째 결과의 관련도 점수, IDCG@10은 완벽하게 정렬된 이상적 순위의 DCG@10이다. 값은 0~1이며 1이 완벽한 순위다.
Accuracy - 분류 정확도.
은 각각 참 양성, 참 음성, 거짓 양성, 거짓 음성이다.
V-Measure - 클러스터링 품질. 동질성(homogeneity)과 완전성(completeness)의 조화 평균이다.
(동질성)는 각 클러스터가 한 클래스만 담도록, (완전성)는 한 클래스가 한 클러스터에 모이도록 하는 정도다. 는 조건부 엔트로피, 는 둘의 가중치를 조절한다.
Average Precision (AP) - 양성 쌍을 음성 쌍보다 위에 올리는 능력.
는 양성 쌍의 총 개수, 는 번째 양성 쌍의 순위다.
Mean Average Precision (MAP) - 모든 질의에 대한 AP의 평균.
는 질의 개수, 는 질의 의 AP다.
Spearman 상관 - 예측 점수와 사람 주석 점수의 순위 상관. STS·요약에 쓰인다.
는 예측 순위와 정답 순위의 차이, 은 인스턴스 수다. 는 -1~1이며 1이 완벽한 양의 상관이다.
9.4 구현 세부사항 (Appendix D)
MoTE는 Nussbaum et al.(2024) 설계를 바탕으로 두 곳을 고쳤다. (1) 표준 FeedForward 블록을 전문가마다 하나씩 담은 nn.ModuleList로 교체하고, (2) 라우팅을 인스트럭션 기반으로 바꿨다. 학습은 전역 배치 크기 6,144로, DeepSpeed Stage 2를 써서 16노드(노드당 A100 40GB 8장) 클러스터에서 수행했다. in-batch 네거티브에 의존하는 대조 학습 특성상 그래디언트 캐싱은 쓰지 않았다. 배치 구성과 온도는 앞서 정리한 대로 작업별로 다르다(분류·검색 0.03, 클러스터링 0.06 / 검색은 동질적, 분류·클러스터링은 이질적 배치).
10. 비판적으로 읽기
강점부터. 이 논문의 미덕은 주장과 검증의 밀착도다. "IC가 임베딩을 잘 못 나눈다"는 가설(Figure 1)을 세우고, 통계 검정으로 못 박고(Figure 3), 그 예외까지 성능 표(Table 2의 클러스터링)와 일관되게 설명한다. Ablation도 촘촘해서, MoTE의 이득이 파라미터 증가가 아니라 라우팅 방식에서 온다는 걸 SLR vs TLR 비교(Table 5)로 분리해냈다. "추론 지연·활성 파라미터·학습 데이터·인스트럭션을 그대로 두고" 얻은 향상이라는 통제 조건도 설득력을 높인다. 무엇보다 저자들이 자기 방법의 한계(클러스터링, 재랭킹)를 숨기지 않고 오히려 분석의 소재로 삼는 태도가 좋다.
약점과 의문. 몇 가지 걸리는 지점이 있다. 첫째, 메모리 문제가 완전히 해결되진 않았다. "안 쓰는 전문가를 CPU/디스크로 내린다"는 건 한 번에 한 작업만 쓰는 상황을 전제하는데, 여러 작업을 섞어 서빙하는 실무에서는 스와핑 비용이 만만치 않을 수 있다. EA(Appendix B)가 대안이지만 향상분의 상당 부분을 반납한다. 둘째, 저용량 모델(nomic-bert, ~137M)에서만 검증됐다. Lipschitz 논리대로라면 큰 모델에서는 IC의 병목이 완화될 테니 MoTE의 이득도 줄어들 가능성이 있다. 저자들도 Limitations에서 대형 모델로의 확장을 미래 과제로 남겼는데, 이게 방법의 적용 범위를 실질적으로 제약한다. 셋째, 전문가 수 = 인스트럭션 수로 고정되어 있다. 작업이 수십 개로 늘면 전문가도 그만큼 늘어나 확장성 문제가 생기고, 라우팅이 인스트럭션에 결정론적으로 묶여 있어 학습 때 정의한 작업 밖으로 나가면 사람이 매핑을 정해줘야 한다(재랭킹→검색처럼). 넷째, retrieval 향상폭을 초록에서는 64%, 서론에서는 50%로 다르게 적고 있어 수치 서술의 일관성이 아쉽다. 표의 절대값(+3.27 → +5.21)이 명확하니 큰 문제는 아니지만.
저자들 스스로 결론에서 제시한 방향도 설득력이 있다. Figure 3에서 검색-문서와 클러스터링이 안 갈라진다는 관찰을 근거로, 모든 작업을 무조건 분리하기보다 관련 작업끼리는 전문가를 공유하는 하이브리드(MoTE + IC)가 더 나을 수 있다고 본다. 특화와 시너지 사이의 균형을 아키텍처로 잡자는 것인데, 이 논문이 특화 쪽 한 극단을 깔끔하게 증명해놓았으니 후속 연구가 파고들기 좋은 지점이다.
11. 마무리
MoTE의 발상은 단순하다. 임베딩 특화를 "입력에 태그를 붙이는" 문제에서 "모델 안에서 경로를 바꾸는" 문제로 옮긴 것이다. 이 전환 덕에 저용량 임베딩 모델이 겪던 용량 병목을, 활성 파라미터도 지연도 늘리지 않고 우회할 수 있게 됐다. 인스트럭션이 Lipschitz 연속성 탓에 임베딩을 조금밖에 못 흔든다면, 아예 작업마다 다른 파라미터 세트를 통과시켜 큰 차이를 만들자는 것이다.
전통적 MoE와의 결정적 차이는 라우팅에 있다. 토큰 단위로 학습해서 전문가를 고르는 대신, 작업 인스트럭션으로 시퀀스 전체를 결정론적으로 보낸다. 그 덕에 각 전문가는 자기 작업 데이터로만 깨끗하게 학습되고, 여기에 작업별 배치 전략·온도를 맞춰주는 TA-CL이 더해져 특화가 한층 날카로워진다. MTEB 56개 데이터셋에서 IC 대비 일관된 우위, 특히 검색에서의 큰 격차가 이 설계의 값어치를 뒷받침한다.
물론 만능은 아니다. 클러스터링처럼 검색-문서와 표현이 겹치는 작업에서는 이득이 없고, 재랭킹처럼 분포가 어긋나는 작업에서는 특화가 오히려 독이 된다. 메모리 부담과 대형 모델로의 확장성도 남은 숙제다. 그럼에도 "짧은 인스트럭션만으로 임베딩을 충분히 특화할 수 있는가"라는 질문에 이론·통계·성능을 두루 엮어 "아니다, 적어도 작은 모델에서는"이라고 답한 점에서, 이 논문은 임베딩 특화를 고민하는 사람이라면 한 번쯤 짚고 넘어갈 만한 레퍼런스다.