논문 리뷰
논문 리뷰: Training Sparse Mixture Of Experts Text Embedding Models
1. 들어가며
RAG 시스템을 실제로 운영해 본 사람이라면 임베딩 모델의 크기가 얼마나 골치 아픈 변수인지 안다. 검색 품질을 올리려면 파라미터를 키우는 게 가장 확실한 방법인데, 그 순간 두 가지 비용이 동시에 튄다. 하나는 코퍼스 전체를 색인할 때 드는 메모리와 스토리지, 다른 하나는 쿼리마다 발생하는 추론 지연(latency)이다. 특히 다국어 검색으로 넘어가면 상황이 더 나빠진다. 흔히 '다국어의 저주(curse of multilinguality)'라고 부르는 현상 때문에, 다국어 모델은 같은 영어 성능을 내려고 단일어 모델보다 3~5배 많은 파라미터를 써야 한다.
생성 모델(causal LM) 쪽은 이 딜레마를 Mixture of Experts(MoE) 구조로 상당 부분 풀어냈다. 전체 파라미터는 크게 늘리되 토큰마다 그중 일부 전문가(expert)만 활성화해서, 용량은 키우면서 연산량은 억제하는 방식이다. Mixtral, Switch Transformer, GShard 같은 모델들이 이 길을 닦았다. 그런데 이상하게도 텍스트 임베딩 쪽에서는 이 MoE가 제대로 적용된 적이 없었다.
Nomic AI의 Zach Nussbaum과 Brandon Duderstadt이 내놓은 이 논문은 바로 그 빈칸을 채운다. 제목 그대로 sparse MoE 구조를 텍스트 임베딩에 이식한 첫 범용(general-purpose) 모델, Nomic Embed v2를 제안한다. 305M의 활성 파라미터만으로 같은 체급 모델들을 앞서고, 두 배 크기(560~570M) 모델들과도 대등하게 겨룬다는 것이 핵심 주장이다. 게다가 학습 코드, 모델 가중치, 평가 데이터를 전부 공개해서 파이프라인 전체를 재현 가능하게 만들었다. 요즘 임베딩 모델 논문들이 학습 데이터를 비공개로 두는 경우가 많다는 점을 생각하면, 이 재현성은 그 자체로 이 논문의 무게를 더한다.
| 항목 | 내용 |
|---|---|
| 제목 | Training Sparse Mixture Of Experts Text Embedding Models |
| 저자 | Zach Nussbaum, Brandon Duderstadt (Nomic AI) |
| 발표 | arXiv Technical Report, 2025년 2월 |
| 논문 링크 | arXiv:2502.07972 |
| 코드 | github.com/nomic-ai/contrastors |
2. 기존 연구의 한계
임베딩 모델의 성능을 끌어올리는 지금까지의 정석은 두 가지였다. 첫째는 데이터 큐레이션, 둘째는 모델 크기 확장이다. 단일어(영어) 임베딩 모델들은 인터넷 규모의 데이터를 정제해서 학습하고, 필요하면 태스크별 instruction을 붙여 성능을 높였다. mE5, BGE-M3, mGTE, Jina V3 같은 다국어 모델들도 언어를 가로지르는 통합 임베딩 공간을 만들려 노력했지만, 결국 영어 벤치마크에서는 같은 크기의 단일어 모델에 밀린다.
그래서 다국어 모델이 택한 해법이 파라미터를 키우는 것이었다. 사전학습된 거대 다국어 LM을 검색용으로 파인튜닝하는 식이다. 문제는 이 방식이 앞서 말한 배포 비용을 그대로 떠안는다는 데 있다. 임베딩 벡터의 차원까지 커지면서(1024차원이 흔하다) dense 검색의 연산 비용과 경제적 비용이 함께 불어난다.
Arctic Embed 2.0 같은 최근 연구는 다국어 성능을 희생하지 않고도 강한 영어 성능을 낼 수 있음을 보였지만, 근본적인 효율 문제 - 큰 파라미터 수와 큰 임베딩 차원 - 는 그대로 남아 있었다. 저자들이 지적하는 핵심은 이것이다. 기존 접근은 전부 'dense 모델 용량을 키운다'는 한 방향에 의존했고, 그래서 성능과 효율이 정면으로 충돌했다. MoE는 이 충돌 자체를 우회할 수 있는 카드인데, 아무도 임베딩에 제대로 써보지 않았다.
MoE를 임베딩에 붙인 시도가 전혀 없었던 건 아니다. Hallee et al.(2024)은 도메인 특화 MoE 임베딩을, Li & Zhou(2024)는 MoE LM의 내부 상태를 임베딩으로 재활용하는 방법을 탐구했다. 동시기 연구인 GRITLM은 Mixtral 8x7B 같은 MoE 모델이 instruction tuning을 통해 임베딩과 생성을 동시에 처리할 수 있음을 보였다. 다만 이들은 도메인이 좁거나, 생성 모델을 임베딩에 겸용하는 방향이었다. 대규모 대조 학습(contrastive learning)으로 처음부터 임베딩 효율을 겨냥해 MoE를 설계한 것은 이 논문이 처음이라는 것이 저자들의 포지셔닝이다.
3. 핵심 아이디어
발상 자체는 한 문장으로 요약된다. "임베딩 모델을 dense하게 키우지 말고, sparse하게 키우자."
MoE의 매력은 '용량과 연산의 분리'에 있다. 전문가를 8개 두면 파라미터는 8배 가까이 늘지만, top-2 라우팅으로 토큰마다 2개만 활성화하면 실제 추론 연산은 그만큼 커지지 않는다. Nomic Embed v2는 총 475M 파라미터를 갖지만 추론 시에는 305M만 활성화된다. 305M이라는 활성 파라미터는 mGTE Base(305M), Arctic Embed v2 Base(305M)와 정확히 같은 체급이다. 즉 "같은 추론 비용으로 더 큰 용량을 쓴다"는 것이 이 모델의 존재 이유다.
두 번째 통찰은 처음부터 MoE를 학습하지 않고 업사이클링(upcycling) 한다는 점이다. Komatsuzaki et al.(2023)의 sparse upcycling을 따라, 이미 학습된 dense 체크포인트의 MLP 레이어를 복제해서 전문가로 초기화한다. 덕분에 MoE 학습의 고질병인 불안정성을 줄이고, dense 사전학습의 성과를 그대로 물려받는다. 여기서 한 가지 디테일이 중요한데, 모든 레이어를 MoE로 바꾸는 게 아니라 두 번째 레이어부터 하나 걸러 하나씩(every alternate) 만 MoE로 전환한다. 뒤에서 보겠지만 이 '선택적 업사이클링'이 전체 변환보다 실제로 더 낫다.
세 번째는 다국어 백본의 장문서 확장이다. XLM-Roberta Base는 절대 위치 인코딩(absolute positional encoding) 때문에 입력이 512토큰으로 묶여 있다. 이걸 RoPE(Rotary Positional Embeddings)로 바꿔 2048토큰까지 다루는 mNomic-BERT를 만들고, 그 위에 대조 학습을 얹는다. 결국 이 논문은 "장문서 다국어 백본 + sparse MoE + 대규모 대조 학습"이라는 세 부품을 조립한 결과물인 셈이다.
4. 배경지식
방법론이 여러 기존 기법을 조합하는 형태라, 각 부품의 원리를 먼저 정리해 둔다.
4.1 Masked Language Modeling과 다국어 백본
MLM은 BERT가 도입한 자기지도(self-supervised) 사전학습 목표로, 입력 시퀀스의 일부 토큰을 가리고 이를 복원하도록 학습한다. 다국어로 확장한 것이 mBERT였는데, Conneau et al.(2020)은 mBERT가 undertrained 상태임을 지적하고 CC100(CommonCrawl에서 뽑은 100개 언어 데이터)으로 다시 학습한 XLM-RoBERTa를 내놓았다. 단일어 모델에 견줄 만한 다국어 표현을 얻은 이 모델이 Nomic Embed v2의 출발점이다.
4.2 Mixture of Experts
dense 모델은 모든 입력에 대해 전체 파라미터를 활성화한다. sparse MoE는 다르다. 표준 MLP 레이어를 MoE 블록으로 교체하는데, 이 블록은 여러 개의 전문가 네트워크와 라우터(router)로 구성된다. 라우터는 각 토큰에 대해 모든 전문가의 로짓을 뽑고 softmax로 정규화한 뒤, 확률이 가장 높은 상위 k개 전문가에게만 토큰을 보낸다(Top-K 라우팅).
MoE 학습의 가장 큰 골칫거리는 전문가 붕괴(expert collapse) 다. 특정 전문가에게만 트래픽이 몰리고 나머지는 놀게 되는 현상이다. 이를 막기 위해 보조적인 load balancing loss를 추가한다.
여기서 는 전문가 로 라우팅된 토큰의 비율, 는 배치 전체에서 그 전문가에 대한 평균 라우팅 확률이다. 는 전문가 수, 는 이 균형 손실이 본 목표(대조 손실)에 비해 얼마나 강하게 작용할지를 조절하는 계수다. 직관적으로, 특정 전문가에 토큰도 많이 가고( 높음) 확률도 높게( 높음) 몰리면 이 손실이 커지므로, 트래픽을 고르게 퍼뜨리는 방향으로 학습이 유도된다. 논문은 이 를 1로 둔다.
4.3 Contrastive Learning
임베딩 모델은 보통 두 단계로 학습된다. 약지도(weakly-supervised) 대조 사전학습 다음에 대조 파인튜닝이다.
사전학습 단계는 InfoNCE 목표로 biencoder를 학습해서, 관련 있는 텍스트 쌍과 관련 없는 쌍을 구분하게 만든다. 배치 이 주어졌을 때 목표는 다음과 같다.
는 쿼리 와 문서 사이의 학습된 점수(보통 코사인 유사도), 는 온도(temperature)다. 분자는 정답 쌍 의 유사도이고, 분모는 정답 쌍에 더해 같은 배치의 다른 문서들(in-batch negative)까지 합친 값이다. 결국 정답 쌍은 가깝게, 배치 내 나머지 조합은 멀게 미는 손실이다.
파인튜닝 단계에서는 사람이 라벨링한 고품질 데이터와 하드 네거티브(hard negative)를 추가해 검색 성능을 끌어올린다. InfoNCE의 분모(정규화 항)를 하드 네거티브까지 포함하도록 확장한다.
새로 붙은 세 번째 항이 하드 네거티브 부분이다. 개의 하드 네거티브 을 분모에 넣어, in-batch negative만으로는 잡히지 않는 '헷갈리는' 오답까지 밀어낸다. 검색 모델의 분별력은 대부분 이 하드 네거티브에서 나온다.
여기에 저장 비용을 줄이기 위해 두 단계 모두에서 Matryoshka Representation Learning(MRL) 을 적용한다. 임베딩 차원이 커질수록 저장 비용도 비례해서 늘어나는데, MRL은 앞쪽 차원일수록 더 많은 정보를 담도록 순서를 매겨서, 필요하면 뒤쪽 차원을 잘라내 짧은 임베딩으로도 쓸 수 있게 한다. Nomic Embed v2는 768차원과 256차원 양쪽에서 잘 동작하도록 학습된다.
4.4 Consistency Filtering
약지도 데이터는 노이즈가 많다. Consistency filtering은 여기서 false positive(정답이라고 표시됐지만 실제로는 관련 없는 쌍)를 걸러내는 기법이다. 방식은 이렇다. 데이터를 1~3M 규모의 샤드로 나누고, 기존 임베딩 모델로 모든 쿼리와 문서를 임베딩한 뒤, 어떤 쿼리에 대해 그 정답 문서가 상위 top-k 유사 문서 안에 들어오지 않으면 그 쌍을 버린다. 원래 영어용으로 개발됐는데, Yu et al.(2024)이 multilingual-E5-small을 써서 샤드당 3M 샘플, top-20 임계값으로 다국어에 맞게 조정했다.
4.5 Hard Negative Mining
하드 네거티브는 보통 기존 retriever로 캐낸다. 전통적으로는 top-k 유사 문서를 그대로 하드 네거티브로 쓰는데, 이렇게 하면 실제로는 정답인데 오답으로 취급되는 false negative가 섞인다. Moreira et al.(2024)은 이를 막는 positive-aware hard negative mining을 제안했다.
정답 쌍의 유사도(pos_sim)에 마진 비율(보통 95%)을 곱해 임계값을 만들고, 이 임계값보다 유사도가 낮은 것만 네거티브로 받아들인다. 정답과 너무 비슷한 문서(즉 진짜 정답일 가능성이 높은 문서)를 네거티브에서 빼주는 셈이라 false negative가 줄어든다.
5. 제안 방법
전체 파이프라인은 (1) 백본 장문서 확장 → (2) consistency filtering → (3) 약지도 대조 사전학습 → (4) 하드 네거티브 마이닝 → (5) 대조 파인튜닝의 5단계로 이어진다.
5.1 XLM-Roberta의 장문서 확장: mNomic-BERT
XLM-Roberta Base의 절대 위치 인코딩을 RoPE로 교체하는 데서 시작한다. RoPE base 파라미터는 10,000으로 설정한다. 최근 연구들(Liu et al., 2024; Xiong et al., 2023)은 더 큰 RoPE base를 권하는데, 저자들의 실험에서는 오히려 GLUE와 XTREME-R 성능이 떨어졌다. 저자들은 이 차이를 학습 방식에서 찾는다. mGTE(Zhang et al., 2024)는 짧은 시퀀스(2048토큰)로 먼저 학습한 뒤 길이를 늘리는데, 이 논문은 처음부터 끝까지 시퀀스 길이를 일정하게 유지한다.
재구성한 CC100 데이터에서 2048토큰 세그먼트를 뽑아 학습하고, 언어 샘플링 온도는 원래 XLM-Roberta 프로토콜대로 0.3으로 둔다. 총 10,000 스텝만 학습한다. 이렇게 만든 모델이 mNomic-BERT다.
| Hyperparameter | Value |
|---|---|
| Batch Size | 4,096 |
| Peak Learning Rate | 4e-4 |
| Warmup Steps | 500 |
| Total Steps | 10,000 |
| Grad. Accumulation Steps | 8 |
| Learning Rate Schedule | Linear |
| Sequence Length | 2,048 |
| Rotary Base | 10,000 |
| MLM Probability | 0.3 |
| Language Sampling α | 0.3 |
| Max Grad Norm | 1.0 |
Table 2 (원논문): mNomic-BERT의 MLM 학습 하이퍼파라미터. 시퀀스 길이 2048과 rotary base 10,000이 장문서 확장의 핵심 설정이다.
10,000 스텝이라는 숫자가 눈에 띈다. 뒤의 GLUE 결과에서 저자들이 강조하듯, 이건 mGTE 사전학습 스텝의 3%에 불과하다. 무거운 재사전학습 없이 RoPE 교체와 가벼운 파인튜닝만으로 컨텍스트 길이를 늘렸다는 것이 이 단계의 메시지다.
5.2 Consistency Filtering
다국어 코퍼스는 mC4와 다국어 CC News에서 가져온다. 언어별로 데이터를 100만 건 세그먼트로 나누고, multilingual-E5-small로 쿼리-문서 유사도를 계산해서, 문서가 해당 쿼리의 상위 2개(top-2) 안에 드는 쌍만 남긴다. 영어 데이터는 Nomic Embed(Nussbaum et al., 2024)에서 이미 필터링한 것을 재사용한다. 이 과정을 거쳐 최종적으로 16억(1.6B) 쌍의 고품질 학습 데이터가 만들어진다. 언어별 분포는 Appendix A에 상세히 나온다.
top-20이 흔한 다국어 설정인데 여기서는 top-2로 훨씬 엄격하게 걸렀다는 점이 특징이다. 노이즈를 공격적으로 제거하는 쪽을 택한 것이다.
5.3 약지도 대조 사전학습
mNomic-BERT로 biencoder를 초기화하고, 필터링된 데이터로 1에폭 학습한다. 여기서 MoE 업사이클링이 일어난다. 두 번째 레이어부터 하나 걸러 MLP 레이어를 8개 전문가, top-2 라우팅의 MoE 레이어로 바꾼다. 그 결과 총 475M 파라미터 중 305M만 활성화되는 모델이 된다. load balancing 계수 는 1이다.
학습 세부 설정은 다음과 같다. InfoNCE 손실에 온도 , 배치당 하나의 데이터셋을 처리하는 방식으로 배치 크기 16,384, 랜덤 배치 샘플링. 연산 제약 때문에 쿼리는 최대 32토큰, 문서는 최대 256토큰으로 제한한다. 16개의 H100 GPU에서 분산 데이터 병렬(DDP)과 activation checkpointing으로 학습하고, peak learning rate 8e-5, warmup 1000스텝, cosine decay를 쓴다.
배치 16,384는 상당히 큰 값인데, 대조 학습에서 배치가 클수록 in-batch negative가 많아져 학습 신호가 풍부해진다. 뒤의 분석 섹션에서 배치 크기가 MoE의 이점을 얼마나 좌우하는지 정량적으로 드러난다.
5.4 하드 네거티브 마이닝
각 쿼리에 대해 Equation 5의 마진 기반 방식으로 하드 네거티브를 캔다. 영어와 다국어 데이터 모두 Chen et al.(2024)의 데이터와 BGE M3를 필터링에 사용한다.
5.5 대조 파인튜닝
사전학습된 biencoder를 마이닝한 하드 네거티브로 파인튜닝한다. 쿼리당 10개의 하드 네거티브를 넣고, 배치 256, peak learning rate 2e-5, warmup 400스텝, linear decay로 1에폭 학습한다. 사전학습과 달리 쿼리·문서 최대 길이를 모두 512토큰으로 늘린다. MRL을 적용해 768차원과 256차원 양쪽에서 효과적인 임베딩을 내도록 학습한다. 파인튜닝 데이터 분포는 Appendix C에 있다. 이렇게 완성된 최종 모델이 Nomic Embed v2다.
6. 실험 설정
평가는 세 갈래로 진행된다. 백본 mNomic-BERT의 언어 이해 능력(GLUE, XTREME-R)과, 최종 Nomic Embed v2의 검색 성능(BEIR, MIRACL)이다.
GLUE는 Nomic Embed의 평가 프로토콜을 따른다. 8개 태스크에서 3에폭, 5개 랜덤 시드, 배치(16, 32)와 학습률(1e-5, 2e-5, 3e-5)을 바꿔가며 학습한다. mGTE 평가는 논문에 맞춰 warmup 6%, max gradient norm 1로 조정한다. RTE, STSB, MRPC는 관행에 따라 MNLI 체크포인트에서 초기화한다.
| Hyperparameter | Value |
|---|---|
| Epochs | 3 |
| Sequence Length | 128 |
| Batch Size | 16, 32 |
| Learning Rate | 1, 2, 3e-5 |
| Learning Rate Schedule | Linear |
| Warmup Pct | 0 |
| Max Grad Norm | 0 |
Table 6 (원논문): GLUE 파인튜닝 하이퍼파라미터. mGTE만 예외적으로 warmup 6%, max grad norm 1을 적용한다.
XTREME-R은 10개 태스크로 구성된 다국어 자연어 이해 벤치마크다. 영어로만 학습하고 다국어·교차언어 태스크로 평가하는 zero-shot cross-lingual transfer 프로토콜을 따른다. 공정한 비교를 위해 Zhang et al.(2024)의 평가 파이프라인을 그대로 쓴다.
검색 벤치마크는 두 가지다. MTEB의 검색 서브셋인 BEIR(영어 전용)과, 다국어 검색을 평가하는 MIRACL이다. 모든 실험에서 쿼리와 문서에 각각 'search query', 'search document' 접두어를 붙이고, 입력을 512토큰으로 자르며, nDCG@10으로 측정한다. 재현성을 위해 FlagEmbedding 프레임워크로 평가하되 mE5 결과만 원논문에서 가져온다(mE5의 독일어 de, 요루바어 yo 결과는 원논문에 없어서 빠진다).
7. 결과
7.1 mNomic-BERT의 GLUE 성능
백본이 RoPE 교체와 가벼운 파인튜닝을 거친 뒤에도 언어 이해 능력을 유지하는지가 첫 번째 검증 대상이다.
| Model | Params | Pos. | Seq. | Avg. | CoLA | SST-2 | MRPC | STS-B | QQP | MNLI | QNLI | RTE |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| XLM-R-Base | 279M | Abs. | 512 | 82.35 | 46.95 | 92.54 | 87.37 | 89.32 | 90.69 | 84.34 | 90.35 | 77.26 |
| mNomic-BERT | 279M | RoPE | 2048 | 81.63 | 44.69 | 91.97 | 87.50 | 88.48 | 90.93 | 83.59 | 89.38 | 76.54 |
| mGTE-Base | 306M | RoPE | 8192 | 80.77 | 27.22 | 91.97 | 89.71 | 89.55 | 91.20 | 85.16 | 90.91 | 80.41 |
Table 3 (원논문): GLUE 벤치마크 파인튜닝 결과. mNomic-BERT는 512토큰 XLM-R-Base와 대등하면서 컨텍스트를 2048까지 확장했다.
mNomic-BERT의 평균 81.63은 원본 XLM-R-Base(82.35)에 거의 근접한다. 위치 인코딩을 절대 방식에서 RoPE로 바꾸고 컨텍스트를 512에서 2048로 늘렸는데도 언어 이해 능력이 크게 훼손되지 않았다는 뜻이다. 더 흥미로운 비교는 mGTE-Base와의 관계다. mNomic-BERT는 mGTE 사전학습 스텝의 3%만 쓰고도 mGTE(80.77)와 대등한 평균을 냈다. 무거운 재사전학습 대신 가벼운 확장으로 충분하다는 저자들의 주장을 뒷받침하는 결과다.
CoLA 열의 편차(mGTE 27.22, XLM-R 46.95)가 눈에 띈다. 저자들은 CoLA가 하이퍼파라미터에 유독 민감한 태스크임을 확인했고, mGTE의 보고 수치는 재현했지만 설정에 따라 분산이 커서 중앙값이 낮게 나왔다고 설명한다. 벤치마크 수치 하나로 모델을 재단하면 안 된다는 실무적 교훈이 담긴 각주인 셈이다.
7.2 XTREME-R 결과
교차언어 전이 능력은 어떨까.
| Model | Avg. | XNLI Acc. | XCOPA Acc. | UDPOS F1 | WikiANN F1 | XQuAD F1 | MLQA F1 | TyDiQA-GoldP F1 | Mewsli-X mAP@20 | LAReQA mAP@20 | Tatoeba Acc. |
|---|---|---|---|---|---|---|---|---|---|---|---|
| XLM-R-Base | 62.31 | 74.49 | 51.80 | 74.33 | 60.99 | 72.96 | 61.45 | 54.31 | 42.45 | 63.49 | 66.79 |
| mNomic-BERT | 62.70 | 73.57 | 61.71 | 74.92 | 60.96 | 71.13 | 59.61 | 43.46 | 43.27 | 67.49 | 70.82 |
| mGTE-Base | 64.63 | 73.58 | 63.62 | 73.52 | 60.72 | 74.71 | 63.88 | 49.68 | 44.58 | 71.90 | 70.07 |
Table 4 (원논문): XTREME-R zero-shot cross-lingual 결과. mNomic-BERT는 XLM-R-Base와 대등하고 mGTE-Base에는 소폭 뒤진다.
mNomic-BERT의 평균 62.70은 XLM-R-Base(62.31)를 약간 앞서고 mGTE-Base(64.63)에는 뒤진다. 태스크별로 뜯어보면 명암이 갈린다. XCOPA(51.80 → 61.71), Tatoeba(66.79 → 70.82), LAReQA(63.49 → 67.49)에서는 XLM-R-Base 대비 뚜렷하게 올랐지만, TyDiQA-GoldP(54.31 → 43.46)에서는 크게 떨어졌다. 특정 QA 태스크의 하락은 RoPE 확장 과정에서 생긴 부작용으로 보이는데, 전체적으로는 백본이 원본의 교차언어 능력을 대체로 유지하면서 컨텍스트만 늘렸다는 해석이 가능하다. 다만 mGTE와의 격차는 mGTE가 훨씬 긴 사전학습을 거쳤다는 점을 감안하면 납득할 만한 수준이다.
7.3 검색 벤치마크: BEIR와 MIRACL
이 논문의 본 무대다. 먼저 전체 모델 비교표를 보자.
| Model | Params (M) | Emb Dim | BEIR | MIRACL | Pretrain Data | Finetune Data | Code |
|---|---|---|---|---|---|---|---|
| mE5 Base | 278 | 768 | 48.88 | 62.3 | No | No | No |
| mGTE Base | 305 | 768 | 51.1 | 63.4 | No | No | No |
| Arctic Embed v2 Base | 305 | 768 | 55.4 | 59.9 | No | No | No |
| Nomic Embed v2 | 305 | 768 | 52.86 | 65.8 | Yes | Yes | Yes |
| BGE M3 | 568 | 1024 | 48.8 | 69.2 | No | Yes | No |
| Arctic Embed v2 Large | 568 | 1024 | 55.65 | 66.0 | No | No | No |
| mE5 Large | 560 | 1024 | 51.4 | 66.5 | No | No | No |
| mE5 Large Instruct | 560 | 1024 | 52.64 | 65.7 | No | No | No |
| Jina Embed v3 | 572 | 1024 | 53.88 | 61.2 | No | No | No |
Table 1 (원논문): 다국어 임베딩 모델 종합 비교. Nomic Embed v2만 사전학습·파인튜닝 데이터와 코드를 모두 공개한다.
표를 두 구역으로 나눠 읽어야 한다. 위쪽은 300M 안팎의 동급 모델, 아래쪽은 두 배 크기(560~570M)의 대형 모델이다.
동급에서 Nomic Embed v2는 MIRACL 65.8로 mE5 Base(62.3), mGTE Base(63.4), Arctic Embed v2 Base(59.9)를 모두 큰 폭으로 앞선다. BEIR에서는 52.86으로 mE5 Base, mGTE Base를 앞서지만 Arctic Embed v2 Base(55.4)에는 밀린다. 저자들이 곧바로 덧붙이는 반론이 인상적이다. Arctic Embed v2는 학습 데이터를 공개하지 않으며, 그 데이터의 상당 부분이 비공개 웹 검색 데이터로 채워져 있다는 것이다. 공개 데이터만으로 학습한 모델과 사설 검색 로그로 학습한 모델을 같은 선상에 놓기 어렵다는 얘기다.
대형 모델과의 비교가 이 표의 진짜 하이라이트다. 절반 크기인데도 Nomic Embed v2는 BEIR에서 Arctic Embed v2 Large를 제외한 모든 대형 다국어 모델을 앞선다. BGE M3(48.8), mE5 Large(51.4), mE5 Large Instruct(52.64), Jina Embed v3(53.88)와 견줘 보면 이 300M 모델의 BEIR 52.86이 얼마나 경쟁력 있는지 드러난다. MIRACL에서도 65.8로 대형 모델들과 대등하다(BGE M3의 69.2가 유일하게 확실히 앞선다). 활성 파라미터를 절반으로 줄이고도 검색 품질을 지켰다는 것, 이것이 MoE 채택의 실질적 보상이다.
MIRACL을 언어별로 쪼개 보면 이 모델의 성격이 더 선명해진다.
| Model | Avg (18) | Avg (16) | ar | bn | de | en | es | fa | fi | fr | hi | id | ja | ko | ru | sw | te | th | yo | zh |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Arctic M v2.0 | 60.6 | 59.9 | 69.7 | 67.7 | 56.7 | 55.7 | 55.4 | 52.6 | 68.4 | 54.0 | 53.7 | 48.3 | 58.3 | 59.7 | 58.8 | 52.3 | 81.7 | 74.3 | 75.6 | 48.3 |
| mGTE Base | 63.6 | 63.4 | 71.4 | 72.9 | 49.7 | 54.0 | 51.8 | 54.0 | 73.5 | 54.5 | 51.9 | 50.3 | 65.8 | 62.9 | 63.2 | 69.9 | 83.1 | 74.0 | 79.3 | 61.8 |
| mE5 Base | 62.2 | 62.3 | 71.6 | 70.2 | 51.9 | 51.2 | 51.5 | 57.4 | 74.4 | 49.7 | 58.4 | 51.1 | 64.7 | 62.2 | 61.5 | 71.1 | 75.2 | 75.2 | 70.7 | 51.5 |
| Nomic Embed v2 | 66.0 | 65.8 | 76.7 | 73.6 | 56.6 | 54.7 | 56.3 | 59.2 | 77.1 | 55.8 | 60.5 | 54.2 | 67.0 | 65.9 | 65.2 | 66.3 | 82.6 | 78.3 | 78.3 | 59.5 |
| Arctic L v2.0 | 66.3 | 66.0 | 76.1 | 74.4 | 58.6 | 53.7 | 55.6 | 60.3 | 77.1 | 56.7 | 58.4 | 52.3 | 66.5 | 66.3 | 67.1 | 70.8 | 83.5 | 77.5 | 78.3 | 59.9 |
| mE5 Large | 66.6 | 66.5 | 76.0 | 75.9 | 56.4 | 52.9 | 52.9 | 59.0 | 77.8 | 54.5 | 62.0 | 52.9 | 70.6 | 66.5 | 67.4 | 74.9 | 84.6 | 80.2 | 78.3 | 56.0 |
| E5 Large Instr. | 66.1 | 65.7 | 76.8 | 73.9 | 55.7 | 51.5 | 53.7 | 59.4 | 77.3 | 53.7 | 60.3 | 52.1 | 69.0 | 65.3 | 67.9 | 72.5 | 83.4 | 78.6 | 81.6 | 56.2 |
| BGE M3 | 69.2 | 69.2 | 78.5 | 79.9 | 56.8 | 56.9 | 56.1 | 60.9 | 78.6 | 58.2 | 59.5 | 56.0 | 72.8 | 69.6 | 70.1 | 78.6 | 86.2 | 82.6 | 81.8 | 62.6 |
Table 5 (원논문): 언어별 MIRACL nDCG@10. Avg(16)은 mE5가 보고하지 않은 de, yo를 제외한 평균이다.
Nomic Embed v2(Avg 66.0)는 동급 모델(mGTE 63.6, mE5 Base 62.2, Arctic M v2.0 60.6)을 전 언어에서 앞서고, 대형 모델인 Arctic L v2.0(66.3), mE5 Large(66.6), E5 Large Instruct(66.1)와 거의 붙는다. 특히 아랍어(ar 76.7)와 핀란드어(fi 77.1)에서는 대형 모델보다도 높다. 반대로 저자원 언어인 스와힐리어(sw 66.3)에서는 mE5 Large(74.9), BGE M3(78.6)에 크게 밀린다. 저자원 언어일수록 대형 모델의 파라미터 여유가 힘을 발휘하는 패턴인데, 뒤의 분석 섹션에서 이 현상이 다시 등장한다. BGE M3가 거의 모든 언어에서 최고인 건 사실이지만, 이 모델은 568M에 1024차원, 그리고 파인튜닝 데이터를 별도로 쓴다는 점을 함께 봐야 공정한 비교가 된다.
8. 분석
결과가 "된다"를 보였다면, 분석 섹션은 "왜 되는가"와 "어디까지 되는가"를 파고든다. 세 개의 통제된 실험이 이어진다.
8.1 임베딩에서 MoE는 정말 효과적인가 (단일어)
먼저 단일어 설정에서 MoE와 dense를 정면으로 붙인다. Nussbaum et al.(2024)의 235M 약지도 대조 쌍으로 사전학습하고, BEIR로 배치 크기를 바꿔가며 평가한다(최대 시퀀스 128토큰 고정). MoE 모델(Nomic BERT MoE)은 Nomic BERT의 레이어를 하나 걸러 업사이클링해서 만들되, 여기서는 token choice 라우팅에 top-1(k=1, Switch 라우팅), 8개 전문가를 쓴다. 비교 대상은 원본 Nomic BERT와 3배 큰 BERT Large다.
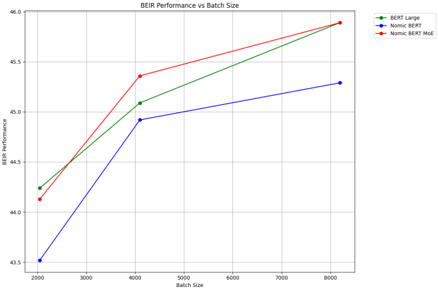
Figure 1 (원논문): 배치 크기와 모델 구조에 따른 BEIR nDCG@10. 배치가 커질수록 업사이클링 MoE(빨강)가 3배 큰 BERT Large(초록)에 수렴한다.
그래프의 메시지는 분명하다. 세 곡선 모두 배치 크기가 커질수록 성능이 오르지만(대조 학습에서 배치가 곧 negative 개수이므로 당연한 경향), 곡선 사이의 간격이 배치에 따라 달라진다. 작은 배치(2000)에서는 세 모델이 비슷하게 뭉쳐 있는데, 배치가 8000을 넘어가면 Nomic BERT MoE(빨강)가 원본 Nomic BERT(파랑)를 확실히 따돌리고 BERT Large(초록)와 거의 겹친다. 활성 파라미터는 Nomic BERT와 같은 수준인데도, 3배 큰 BERT Large의 성능에 수렴한다는 것이다. MoE의 추가 용량이 큰 배치의 풍부한 대조 신호와 만났을 때 비로소 제 값을 한다는 해석이 가능하다. 이것이 앞서 사전학습에서 배치 16,384라는 큰 값을 쓴 이유이기도 하다.
그렇다면 레이어를 몇 개나 MoE로 바꿔야 할까.
| MoE Layers | Batch Size | BEIR |
|---|---|---|
| 6 | 2048 | 44.13 |
| 6 | 4096 | 45.36 |
| 6 | 8192 | 45.89 |
| 12 | 2048 | 44.28 |
| 12 | 4096 | 44.89 |
| 12 | 8192 | 45.48 |
Table 7 (원논문): 업사이클링하는 레이어 수의 영향. 12개 전부 바꾸는 것보다 6개만 선택적으로 바꾸는 쪽이 큰 배치에서 더 낫다.
직관적으로는 MoE 레이어를 많이 둘수록 용량이 커져 좋을 것 같은데, 결과는 반대다. 12개 레이어를 전부 MoE로 바꾸면 6개만 바꿨을 때보다 성능이 떨어진다. 특히 배치 8192에서 6-layer는 45.89, 12-layer는 45.48로 격차가 벌어진다. 저자들은 이를 "용량과 최적화 안정성 사이의 균형"으로 해석한다. MoE 레이어가 많아질수록 라우팅해야 할 결정이 늘고 학습이 불안정해지는데, 하나 걸러 하나씩만 바꾸면 dense의 안정성과 MoE의 용량을 적절히 섞을 수 있다는 것이다. 본 모델이 '두 번째 레이어부터 alternate'로 업사이클링하는 설계가 이 실험에서 나온 셈이다.
8.2 다국어에서도 MoE가 통하는가
단일어에서 통한 이야기가 다국어에서도 그대로 성립할까. mC4와 다국어 CC News에서 65M 쌍을 추가하고, 여러 어족을 아우르는 6개 언어(영어, 중국어, 아랍어, 힌디어, 스페인어, 스와힐리어)로 통제된 실험을 한다. 스와힐리어가 저자원 대표다. XLM-RoBERTa Base, MoE 변형, XLM-RoBERTa Large 세 모델을 BEIR와 MIRACL에서 배치별로 비교한다.
| Model | Params | BEIR | MIRACL |
|---|---|---|---|
| Batch Size: 2048 | |||
| XLM-R Large | 561M | 45.86 | 38.49 |
| XLM-MoE (k=1) | 278M | 43.63 | 39.17 |
| XLM-B | 278M | 43.51 | 34.14 |
| Batch Size: 4096 | |||
| XLM-R Large | 561M | 46.26 | 38.99 |
| XLM-MoE (k=1) | 278M | 44.37 | 37.08 |
| XLM-B | 278M | 43.78 | 37.32 |
| Batch Size: 8192 | |||
| XLM-R Large | 561M | 46.91 | 42.71 |
| XLM-MoE (k=2) | 300M | 45.00 | 39.81 |
| XLM-MoE (k=1) | 278M | 44.11 | 39.17 |
| XLM-B | 278M | 43.96 | 37.92 |
Table 9 (원논문): 다국어 MoE vs dense. MoE는 동급 dense(XLM-B)를 앞서지만 대형(XLM-R Large)은 넘지 못한다. 배치 8192에서 k=2 전문가가 특히 강하다.
여기서 단일어와 다른 그림이 나온다. MoE 변형은 모든 배치에서 동급 dense인 XLM-B를 앞선다(예: 배치 8192에서 BEIR 44.11 vs 43.96, MIRACL 39.17 vs 37.92). 하지만 단일어에서와 달리 대형 모델 XLM-R Large는 넘지 못한다. BEIR에서 XLM-R Large는 45.86~46.91로 MoE보다 계속 위에 있다. 단일어에서는 MoE가 3배 큰 모델에 수렴했는데, 다국어에서는 그러지 못한 것이다.
저자들은 이 격차의 원인을 데이터 규모에서 찾는다. 초기 실험에서 100M 쌍만 썼을 때는 MoE가 동급 dense보다도 못했다고 밝힌다. 이는 Krajewski et al.(2024)의 관찰, 즉 학습 데이터가 제한된 상황에서는 MoE가 dense보다 뒤처진다는 발견과 맞아떨어진다. MoE는 용량이 큰 만큼 그 용량을 채울 데이터가 있어야 힘을 낸다. 다국어는 언어당 데이터가 쪼개지므로 사실상 '데이터 제한' 상황에 놓이기 쉽고, 그래서 단일어만큼 극적인 이득이 안 나온 것으로 보인다. 배치 8192에서 k=2 전문가(45.00)가 k=1(44.11)보다 확실히 나은 것도 이 맥락에서 읽힌다. 활성 전문가를 늘리면 더 많은 신호를 흡수할 수 있는데, 그러려면 큰 배치가 뒷받침돼야 한다.
이 실험은 논문 주장에 균형을 잡아준다. MoE가 만능이 아니라, '충분한 데이터와 큰 배치'라는 조건 아래서 이득을 낸다는 점을 저자 스스로 드러낸 것이다.
8.3 하드 네거티브 마이닝: 교사 모델과 마진
파인튜닝 품질을 좌우하는 하드 네거티브를 어떻게 캐야 하는지 따로 파고든다. E5-Large Unsupervised로 초기화하고, StackExchange 제목-본문 쌍, SQuAD, NQ에서 약 500k 예제로 학습해 NQ, FiQA, HotpotQA에서 평가한다. 교사(teacher) 모델로는 NVEmbed v1, Arctic Embed Large, Stella 1.5B v5를 비교한다.
| Teacher Model | Margin | Negatives | Avg | FiQA | HotpotQA | NQ |
|---|---|---|---|---|---|---|
| Arctic Embed Large | None | 4 | 52.87 | 42.68 | 59.47 | 56.45 |
| Arctic Embed Large | 0.95 | 4 | 55.20 | 44.98 | 62.75 | 57.88 |
| NVEmbed v1 | 0.95 | 4 | 54.94 | 45.00 | 58.29 | 61.56 |
| Stella 1.5B | 0.95 | 4 | 57.22 | 45.18 | 64.06 | 62.42 |
| Stella 1.5B | 0.98 | 4 | 57.20 | 45.67 | 63.65 | 62.29 |
| Stella 1.5B | 0.95 | 7 | 57.31 | 45.10 | 64.27 | 62.58 |
| Stella 1.5B | 0.95 | 10 | 57.45 | 45.17 | 64.48 | 62.69 |
Table 8 (원논문): 하드 네거티브 마이닝의 교사 모델·마진·네거티브 수 비교. positive-aware 마진(0.95)이 마진 없음보다 평균 2.33점 높다.
여러 트렌드가 한 표에 압축돼 있다. 첫째, positive-aware 마진의 효과가 뚜렷하다. Arctic Embed Large에서 마진 없음(52.87)과 마진 0.95(55.20)의 차이가 평균 2.33점이다. false negative를 걸러주는 이 마진이 확실히 값을 한다. 둘째, 교사 모델의 절대 크기가 전부가 아니다. Stella 1.5B(57.22)가 NVEmbed v1(54.94)을 앞서는데, Stella가 7배 작은 모델임을 생각하면 뜻밖의 결과다. 교사의 품질이 크기와 항상 비례하지는 않는다는 얘기다. 셋째, 네거티브 개수는 4→10으로 늘리면 조금씩 좋아지지만(57.22 → 57.45) 이득이 점점 줄어 정체 조짐을 보인다. 그럼에도 최종 모델이 10개를 택한 건 '작지만 일관된' 개선을 챙긴 선택이다. 넷째, 마진을 0.95에서 0.98로 바꿔도 성능은 거의 그대로다. 이 범위에서 마진에 크게 민감하지 않다는 뜻이라 하이퍼파라미터 튜닝 부담이 적다.
저자들은 여기에 덧붙여, 자신들이 캔 최고 데이터셋과 Chen et al.(2024)의 파인튜닝 데이터를 BGE M3로 Equation 5에 따라 필터링한 버전을 비교했더니 후자가 BEIR에서 nDCG@10 1점을 더 얻었다고 보고한다. 처음부터 캐는 것 말고, 이미 캔 데이터에서 나쁜 네거티브를 걸러내는 것도 유효한 선택지라는 것이다.
9. Appendix: 데이터 분포와 BEIR 상세
부록의 세 표는 본문 주장을 뒷받침하는 재료다.
9.1 사전학습 데이터 분포 (16억 쌍)
16억 쌍이 어떤 언어로 채워졌는지가 Table 10에 나온다. 지면상 상위 언어와 대표적 저자원 언어만 옮긴다(원표는 100개 언어 전체를 담는다).
| Code | Language | Pairs | Code | Language | Pairs |
|---|---|---|---|---|---|
| en | English | 234,553,344 | ko | Korean | 10,354,688 |
| es | Spanish | 210,010,112 | th | Thai | 7,602,176 |
| fr | French | 172,769,280 | fa | Persian | 5,177,344 |
| de | German | 169,426,944 | sw | Swahili | 327,680 |
| it | Italian | 104,251,392 | am | Amharic | 32,768 |
| pt | Portuguese | 87,982,080 | yo | Yoruba | 16,384 |
| ja | Japanese | 43,433,984 | xh | Xhosa | 16,384 |
| ru | Russian | 38,731,776 | st | Sotho | 16,384 |
| zh | Chinese | 18,661,376 | tl | Tagalog | 16,384 |
Table 10 (원논문 발췌): 사전학습 데이터의 언어별 분포. 영어 2.3억 쌍부터 요루바어 1.6만 쌍까지 4자릿수 규모의 격차가 있다.
분포의 불균형이 극단적이다. 영어가 2억 3천만 쌍인데 요루바어, 코사어, 소토어는 1만 6천 쌍에 불과하다. 무려 1만 4천 배 차이다. 앞서 MIRACL 언어별 결과(Table 5)에서 스와힐리어 성능이 대형 모델에 크게 밀린 이유가 이 표에 그대로 드러난다. 스와힐리어는 32만 쌍으로, 프랑스어(1.7억)의 500분의 1 수준이다. 데이터가 곧 성능인 임베딩 학습에서, 저자원 언어의 한계는 결국 이 데이터 절벽에서 비롯된다. MoE의 용량이 이 절벽을 메워주지는 못한다는 것이 8.2절 분석과 이어지는 지점이다.
9.2 파인튜닝 데이터 분포
| Dataset | Number of Samples |
|---|---|
| English Datasets | |
| MSMARCO | 485,120 |
| Stack | 249,856 |
| SQuAD | 87,552 |
| HotPot | 82,432 |
| NQ | 57,856 |
| FEVER | 28,672 |
| MIRACL Train Datasets | |
| Russian | 4,608 |
| Indonesian | 3,840 |
| Arabic | 3,328 |
| Japanese | 3,328 |
| Telugu | 3,328 |
| Finnish | 2,816 |
| Thai | 2,816 |
| English | 2,560 |
| Spanish | 2,048 |
| Persian | 2,048 |
| Swahili | 1,792 |
| Bengali | 1,536 |
| Chinese | 1,280 |
| French | 1,024 |
| Hindi | 1,024 |
| Korean | 768 |
| Total | 1,029,632 |
Table 11 (원논문): 파인튜닝 데이터 분포. 총 103만 쌍 중 영어 검색 데이터(MSMARCO 등)가 대부분을 차지한다.
파인튜닝 데이터는 총 103만 쌍으로 사전학습(16억)에 비하면 훨씬 작다. 그중에서도 영어 검색 데이터(MSMARCO 48.5만, Stack 25만 등)가 대부분이고, MIRACL 훈련셋의 다국어 데이터는 언어당 수천 건 수준이다. 파인튜닝이 주로 영어 검색 정합에 무게를 둔다는 뜻이다. 그런데도 MIRACL(다국어) 성능이 높게 나온 것은, 결국 사전학습 단계의 16억 다국어 쌍이 다국어 능력의 대부분을 만들었고 파인튜닝은 검색 정합을 다듬는 역할에 가깝다는 해석을 가능하게 한다.
9.3 BEIR 태스크별 상세와 256차원 성능
| Dataset | Nomic Embed v2 | Nomic Embed v2 256 |
|---|---|---|
| Average | 52.86 | 49.63 |
| ArguAna | 55.73 | 51.97 |
| ClimateFEVER | 33.38 | 29.58 |
| CQADupstack | 42.64 | 40.25 |
| DBPedia | 41.44 | 37.51 |
| FEVER | 87.17 | 84.64 |
| FiQA2018 | 38.74 | 35.71 |
| HotpotQA | 68.53 | 63.67 |
| MSMARCO | 40.89 | 38.90 |
| NFCorpus | 34.60 | 31.29 |
| NQ | 60.41 | 56.12 |
| QuoraRetrieval | 87.95 | 87.49 |
| SCIDOCS | 19.25 | 17.71 |
| SciFact | 72.89 | 66.31 |
| TRECCOVID | 78.78 | 74.22 |
| Touche2020 | 30.55 | 29.03 |
Table 12 (원논문): BEIR 태스크별 nDCG@10. 768차원과 256차원(Matryoshka) 비교.
이 표의 핵심은 두 열의 비교다. 임베딩 차원을 768에서 256으로 3분의 1로 줄였는데 평균은 52.86에서 49.63으로 3.23점(약 6%)만 떨어진다. 저장 비용은 3분의 1로 주는데 성능 손실은 6%에 그친다는 것이 MRL의 실질적 가치다. 태스크별로 보면 QuoraRetrieval(87.95 → 87.49)은 거의 손실이 없는 반면 SciFact(72.89 → 66.31)는 6점 넘게 빠진다. 정보 밀도가 높거나 전문 용어가 많은 과학 문헌 검색일수록 차원 축소에 민감하고, 짧고 정형화된 중복 질문 검색은 저차원으로도 충분하다는 실무적 감각을 준다. 스토리지가 빡빡한 환경이라면 256차원으로 내려도 대부분의 태스크에서 큰 손해 없이 쓸 수 있다는 메시지다.
10. 한계와 비판적 관점
저자들이 스스로 밝힌 한계는 이 연구가 MoE 임베딩의 '첫 탐색'에 불과하다는 점이다. 전문가 수와 활성 파라미터의 최적 스케일링, 대안적 라우팅 방식, 양방향(bidirectional) 특성을 활용한 loss-free 라우팅, 그리고 MoE를 다시 dense로 증류(distill)해서 배포를 더 쉽게 만드는 방향 등을 향후 과제로 남겼다. 데이터 크기·파라미터·임베딩 차원 사이의 근본적 스케일링 법칙을 이해하면, MoE의 이점이 더 큰 규모에서도 유지되는지 아니면 오히려 커지는지 알 수 있을 것이라는 전망도 덧붙인다.
리뷰어 관점에서 몇 가지를 더 짚고 싶다. 첫째, 다국어 MoE의 이득이 생각만큼 크지 않다는 점이 솔직하게 아쉽다. 8.2절에서 드러났듯 다국어에서 MoE는 대형 dense를 넘지 못했고, 저자원 언어(스와힐리어)에서는 격차가 꽤 컸다. 논문 제목이 'MoE 텍스트 임베딩'을 내세우지만, 정작 MoE의 마법이 가장 필요한 다국어·저자원 영역에서는 데이터 절벽에 막혀 힘을 덜 쓴다. MoE가 데이터 부족을 메워주는 도구가 아니라 데이터가 충분할 때 그 데이터를 더 잘 흡수하는 도구라는 점이 분명해진다.
둘째, 분석 섹션의 실험들(Figure 1, Table 7~9)이 최종 모델(Nomic Embed v2)이 아니라 축소된 프록시 모델(Nomic BERT MoE, XLM-R MoE, E5-Large 기반)에서 수행됐다. 설계 근거를 보이려는 통제 실험이라는 취지는 이해하지만, 최종 모델 자체의 ablation(예: 최종 모델에서 MoE를 뺐을 때 vs 넣었을 때)이 빠져 있어서 "16억 쌍으로 학습한 최종 모델에서 MoE가 정확히 몇 점을 벌어줬는가"는 표로 확인하기 어렵다.
셋째, 비교 대상인 Arctic Embed v2가 BEIR에서 더 높지만 비공개 데이터를 쓴다는 점을 저자들이 반복해서 강조하는데, 이는 양날의 검이다. 재현성이라는 강점을 부각하는 정당한 논거이지만, 동시에 "우리가 진 이유는 데이터가 공개라서"라는 방어 논리로도 읽힐 수 있다. 공개 데이터만으로 이 정도를 달성했다는 사실 자체가 충분히 강력한 만큼, 담백하게 두어도 좋았을 부분이다.
그럼에도 이 논문의 강점은 뚜렷하다. MoE를 범용 텍스트 임베딩에 처음으로 제대로 이식했고, '왜 되는가'(큰 배치 + 충분한 데이터)와 '어디까지 되는가'(다국어의 데이터 제약)를 통제 실험으로 정직하게 보였다. 무엇보다 코드·모델·데이터를 전부 공개해 후속 연구가 그대로 딛고 설 발판을 만들었다.
11. 마무리
Nomic Embed v2는 "임베딩 모델을 크게 만들되 무겁게 만들지는 말자"는 오래된 소망을 MoE로 구체화한 결과물이다. 305M 활성 파라미터로 560M급 모델과 겨루고, 공개 데이터만으로 그 성능을 냈다는 점에서 RAG를 실제로 운영하는 입장에서는 반가운 선택지다. 특히 256차원으로 줄여도 성능이 6%만 빠지는 MRL 특성은, 색인 스토리지가 곧 비용인 프로덕션 환경에서 곧바로 쓸모가 있다.
동시에 이 논문은 MoE가 만능이 아님을 스스로 보여준다. MoE의 용량은 그것을 채울 데이터와 그것을 학습시킬 큰 배치가 있을 때 빛나고, 데이터가 쪼개지는 다국어·저자원 환경에서는 dense 대형 모델을 넘어서지 못한다. sparse 스케일링이 dense 스케일링을 대체하는 게 아니라, 조건이 맞을 때 더 효율적인 경로를 제공한다는 것이 이 연구가 실증한 균형 잡힌 결론이다. 임베딩 모델의 스케일링을 고민한다면, 파라미터를 늘리기 전에 "우리 데이터와 배치가 MoE의 용량을 감당할 수 있는가"를 먼저 물어야 한다는 실무적 지침을 남긴 논문이다.