논문 리뷰
논문 리뷰: RouterRetriever: Routing over a Mixture of Expert Embedding Models
도메인마다 학습한 경량 LoRA 전문가를 여러 개 두고, 쿼리마다 가장 알맞은 전문가를 골라 임베딩을 뽑는 방식으로 단일 임베딩 모델의 한계를 넘어선 리트리버.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | RouterRetriever: Routing over a Mixture of Expert Embedding Models |
| 저자 | Hyunji Lee (KAIST AI), Luca Soldaini (Ai2), Arman Cohan (Ai2·Yale), Minjoon Seo (KAIST AI), Kyle Lo (Ai2) |
| 학회/저널 | AAAI 2025 |
| 논문 링크 | arXiv:2409.02685 |
| 코드/모델 | github.com/amy-hyunji/RouterRetriever · huggingface.co/amy-hyunji-lee/routerretriever |
1. 들어가며
검색(retrieval) 시스템을 만들 때 우리는 보통 MSMARCO 같은 대규모 범용 데이터셋에 임베딩 모델 하나를 학습시킨다. 이 방식은 전반적으로 무난한 성능을 내지만, 특정 도메인 안에서 평가하면 그 도메인 데이터로 직접 학습한 모델에 밀리는 경우가 많다. 생의학 논문 검색은 생의학 데이터로, 금융 질의응답은 금융 데이터로 학습한 모델이 더 잘한다는 건 이미 여러 연구에서 확인된 사실이다.
그렇다고 도메인마다 별도의 검색 시스템을 만들어 유지하는 건 비용이 만만치 않다. 대안으로 여러 도메인 데이터를 한꺼번에 넣어 학습하는 멀티태스크(multi-task) 방식이 있지만, 여기에도 함정이 있다. 새 도메인이 추가될 때마다 모델 전체를 다시 학습해야 하고, 도메인이 늘어날수록 모든 도메인에서 성능을 고르게 유지하기가 어려워진다.
흥미로운 지점은 여기다. 언어 모델(LLM) 생성 연구에서는 이미 "도메인별 전문가(expert)를 여러 개 두고 입력마다 적절한 전문가로 라우팅(routing)한다"는 Mixture-of-Experts 아이디어가 활발히 쓰이고 있다. 그런데 정작 검색용 임베딩 모델 쪽에서는 이 아이디어가 거의 시도되지 않았다. RouterRetriever는 바로 이 빈칸을 채운다. 도메인마다 경량 전문가를 학습해두고, 쿼리가 들어오면 임베딩 유사도를 기반으로 가장 알맞은 전문가를 골라 최종 임베딩을 생성한다. 저자들의 표현을 빌리면, 도메인 특화 전문가 임베딩 모델들의 혼합(mixture) 위에서 라우팅하는 것이 단일 범용 임베딩 모델의 실질적 대안이 될 수 있음을 보인 첫 연구다.
2. 기존 연구의 한계
2.1 도메인 특화 리트리버
도메인 특화 검색 성능을 끌어올리는 연구는 크게 두 갈래로 나뉜다. 하나는 데이터 증강(data augmentation)이다. 도메인 학습 데이터가 없거나 구축 비용이 클 때, 비지도(unsupervised) 방식으로 학습하거나(Contriever, Condenser, SimCSE 등) 도메인 문서로부터 가짜 쿼리(pseudo-query)를 생성해 파인튜닝하는(InPars, GPL 등) 접근이다.
다른 하나는 도메인 특화 임베딩 자체를 개선하는 방향이다. 여러 도메인 데이터를 멀티태스크로 학습하거나, 인스트럭션 기반 검색 모델(instruction-following retriever)로 도메인 지식을 입력에 실어 주는 방법(TART, INSTRUCTIR, Instructor 등), 또는 도메인 지식을 담은 소프트 토큰(soft token)을 학습하는 방법(Fang et al., 2024)이 있다.
이 방법들의 공통점은 도메인 지식을 입력(input)에 실어 단일 임베딩 모델로 처리한다는 데 있다. RouterRetriever는 여기서 갈라진다. 도메인 지식을 입력이 아니라 여러 모델의 파라미터(parametric representation)에 직접 새겨 넣고, 그중 적절한 것을 골라 쓴다.
2.2 라우팅 기법
전문가와 라우팅 메커니즘을 결합하는 아이디어는 생성 태스크에서 잘 발전해 왔다. 전문가와 라우터를 동시에 학습하는 방식(Branch-Train-MiX, PHATGOOSE)이 있고, 추가 학습 없이 라우팅하는 사후(post-hoc) 기법도 있다. 후자에는 모델 자체를 지식원으로 쓰거나(Knowledge Card), 토큰 공간에서 도메인 지식을 결합하거나(Belofsky, 2023), 각 도메인의 샘플 데이터에서 가장 관련 있는 소스를 고르는(Retrieval of Soft Prompt, Jang et al., 2023) 방식이 있다. RAG 품질 개선을 위해 외부 지식 사용 여부나 검색 방식을 라우팅으로 결정하는 연구(Mallen et al., 2022; Adaptive-RAG)도 있다.
정보 검색 쪽에서는 Lin et al.(2023a)이 길고 복잡한 쿼리를 하위 쿼리(sub-query)로 분해해 전문가 리트리버로 라우팅하는 방법을 제안했다. 다만 이들은 개별 전문가 모델을 통째로 따로 두고, 규칙 기반으로 하위 쿼리를 배정한다. RouterRetriever는 경량 컴포넌트를 전문가로 쓰고, 쿼리 전체를 그대로 처리하며 동적으로 라우팅한다는 점에서 다르다.
이 논문의 실험이 던지는 중요한 관찰 하나는, 생성 태스크에서 잘 통하던 라우팅 기법을 검색에 그대로 옮기면 최적 성능이 나오지 않는다는 것이다. 그래서 검색에 특화된 라우팅 기법이 따로 필요해진다.
3. 핵심 아이디어
RouterRetriever의 설계는 세 가지 판단 위에 서 있다.
첫째, 도메인 지식은 입력이 아니라 파라미터에 새기는 편이 낫다. 프롬프트나 소프트 토큰으로 도메인 신호를 주입하는 대신, 도메인마다 별도의 LoRA(Low-Rank Adaptation) 전문가를 학습해 지식을 파라미터에 직접 담는다. 각 전문가는 약 100만 개, 전체의 0.5% 수준의 파라미터만 갖는다.
둘째, 라우팅은 학습 없이 임베딩 유사도로 한다. 라우터를 따로 학습하면 새 도메인이 추가될 때마다 라우터도 다시 손봐야 한다. 대신 각 전문가를 대표하는 파일럿 임베딩(pilot embedding)을 미리 계산해두고, 쿼리 임베딩과의 평균 유사도가 가장 높은 전문가를 고른다. 라우팅이 학습-프리(training-free)이므로 전문가 추가·삭제가 자유롭다.
셋째, 전문가는 원래 학습된 도메인에만 매이지 않는다. 어떤 쿼리에 가장 좋은 전문가가 반드시 그 쿼리가 속한 데이터셋의 전문가일 필요는 없다. 생물학 관련 질문이 SciFact보다 NFCorpus 전문가에서 더 잘 검색된다면, 그 쿼리는 NFCorpus 전문가로 보내는 게 맞다. 파일럿 임베딩을 구성할 때 이 "실제 최고 성능 전문가"를 기준으로 삼는다는 점이 뒤에서 설명할 라우팅 정확도의 핵심이다.
기존 방법이 "좋은 단일 모델 하나를 만들자"였다면, RouterRetriever는 "잘 만든 전문가 여러 개를 두고 그때그때 맞는 걸 고르자"로 방향을 튼 셈이다.
4. 제안 방법
4.1 전체 구조
RouterRetriever는 고정된 베이스 검색 모델(base retrieval model) 하나와 여러 도메인 특화 전문가로 구성된다. 베이스 인코더로는 Contriever를 쓰고, 전문가는 각각 LoRA 모듈이다. 전체 동작은 두 단계로 나뉜다.
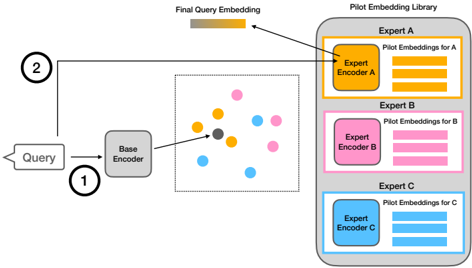
Figure 1: RouterRetriever의 전체 개요. ① 쿼리를 베이스 인코더로 임베딩(검은 점)한 뒤, 각 전문가의 파일럿 임베딩(Expert A는 주황, B는 빨강, C는 파랑)과 평균 유사도를 계산해 가장 높은 전문가(여기서는 Expert A)를 선택한다. ② 선택된 Expert A 인코더(베이스 인코더 + 해당 LoRA)로 쿼리를 다시 통과시켜 최종 쿼리 임베딩을 생성한다. (원논문)
그림을 따라가면 흐름이 명확하다. 왼쪽에서 쿼리가 들어오면 베이스 인코더가 먼저 임베딩(검은 점)을 만든다. 이 임베딩을 오른쪽의 파일럿 임베딩 라이브러리(Pilot Embedding Library)에 있는 전문가별 대표 임베딩들(색깔 점)과 비교해, 평균 유사도가 가장 높은 전문가를 고른다. 여기까지가 라우팅이다. 그다음 선택된 전문가 인코더로 쿼리를 다시 한번 통과시켜 최종 임베딩을 뽑는다. 쿼리 임베딩을 얻는 데 순전파(forward pass)가 두 번 필요하다는 점은 뒤의 효율성 논의에서 다시 짚는다. 이 전체 준비 과정(전문가 학습 + 파일럿 임베딩 구성)은 딱 한 번만 수행하면 된다.
4.2 전문가: 도메인별 LoRA 모듈
각 도메인 (, 는 전체 도메인 수)마다 해당 도메인 데이터로 LoRA 전문가 를 학습한다. 베이스 모델은 얼려두고(frozen) LoRA 파라미터만 학습하므로, 전문가 하나가 늘어나도 전체 파라미터 증가는 미미하다. 학습이 끝나면 개의 전문가 집합 를 얻고, 각 는 특정 도메인에 특화된다.
4.3 파일럿 임베딩 라이브러리
라우팅의 품질을 결정하는 게 이 파일럿 임베딩 라이브러리다. 구성 절차는 아래 알고리즘을 따른다.
Algorithm 1: 파일럿 임베딩 라이브러리 구성
입력: 도메인별 학습 데이터셋 D_1,...,D_T, 전문가 E = {e_1,...,e_T}
1: 빈 맵 P = {} 초기화 (파일럿 임베딩 라이브러리)
2: 각 데이터셋 D_i 에 대해:
3:   빈 리스트 L_i = [] 초기화
4:   각 인스턴스 x_j in D_i 에 대해:
5:     e_max = argmax_{e_i in E} Performance(e_i, x_j)   # 성능이 가장 좋은 전문가
6:     (x_j, e_max) 쌍을 L_i 에 추가
7:   각 전문가 e_m in E 에 대해:
8:     Group_m = { x_j | e_max = e_m }                  # 같은 전문가로 배정된 인스턴스
9:     Group_m 이 비어있지 않으면:
10:      c_m = Centroid( BaseEncoder(Group_m) )          # 중심 임베딩
11:      P[e_m].append(c_m)
12: 출력: 파일럿 임베딩 라이브러리 P
핵심 직관은 5번 줄에 있다. 데이터셋 의 각 인스턴스 에 대해, 그 인스턴스에서 실제로 가장 좋은 성능을 내는 전문가 를 찾는다. 여기서 가 반드시 가 속한 소스 도메인의 전문가일 필요는 없다는 점이 중요하다. 그다음 같은 로 배정된 인스턴스들을 묶어(Group), 그 그룹의 베이스 임베딩 평균, 즉 중심(centroid) 을 계산한다. 이 중심이 그 전문가에 대한 파일럿 임베딩이 된다.
하나의 데이터셋 에서 최대 개의 파일럿 임베딩(그룹이 비어 있으면 그보다 적게)이 나오고, 이를 개 데이터셋에 반복하면 최대 개의 파일럿 임베딩이 만들어진다. 논문은 그룹당 중심을 하나()만 두는 게 가장 좋다고 밝히는데(Appendix C.1), 중심이 여러 개가 되면 오히려 방해 요소(distractor)로 작용하기 때문이다.
4.4 라우팅 메커니즘
추론 시점에는 간단하다. 쿼리 임베딩을 베이스 인코더로 뽑은 뒤, 라이브러리의 개 파일럿 임베딩 각각과 유사도를 계산한다. 같은 전문가에 속한 개 파일럿 임베딩의 유사도를 평균 내어 전문가별 평균 유사도 점수를 만들고, 그중 가장 높은 전문가를 선택한다. 이 라우팅에는 어떤 학습도 필요 없으므로, 전문가를 넣고 빼는 데 라우터 재학습이 따르지 않는다. 유연성이 이 설계의 실질적 장점이다.
5. 실험 설정
5.1 데이터셋
평가는 BEIR 벤치마크로 한다. 저자들은 먼저 베이스 인코더(Contriever) 임베딩으로 BEIR 도메인들의 분포를 들여다본다.
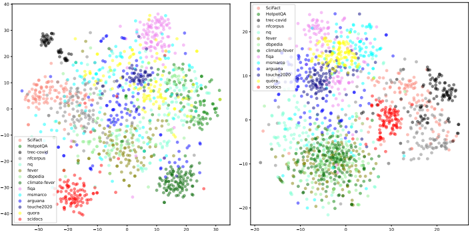
Figure 2: 각 데이터셋에서 100개씩 샘플링한 쿼리(좌)와 컨텍스트(우)의 Contriever 임베딩 TSNE 시각화. ArguAna·MSMARCO(파랑) 같은 범용 도메인은 넓게 퍼져 있고, HotpotQA(초록)·NFCorpus(회색)·SciFact(분홍)·FiQA(보라) 같은 도메인 특화 데이터셋은 촘촘히 뭉쳐 있다. Quora(노랑)는 쿼리는 흩어져 있지만 컨텍스트는 뭉쳐 있다. (원논문)
이 그림이 논문의 문제의식을 시각적으로 뒷받침한다. ArguAna와 MSMARCO처럼 넓게 퍼진 데이터셋은 '범용(general-domain)' 성격이 강하고, NFCorpus·SciFact·FiQA·HotpotQA처럼 한곳에 뭉친 데이터셋은 '도메인 특화(domain-specific)' 성격이 강하다. 뭉쳐 있다는 건 그 도메인이 고유한 표현 공간을 갖는다는 뜻이고, 그렇다면 그 도메인 전용 전문가를 두는 게 이득이라는 논리로 이어진다. Quora처럼 쿼리는 흩어졌지만 컨텍스트는 뭉친 경우도 있어, 데이터셋의 성격이 한 축으로만 결정되지 않는다는 것도 읽을 수 있다. 이후 데이터셋 약어는 ArguAna(AR), Quora(QU), MSMARCO(MS), HotpotQA(HO), SciFact(SF), NFCorpus(NF), FiQA(FI), SciDocs(SD), TREC-COVID(TR)로 쓴다.
실험에 쓰인 14개 BEIR 데이터셋의 통계는 아래와 같다.
| Domain | Name | Task | Train (k) | Gen Train (k) | Test | Corpus (k) |
|---|---|---|---|---|---|---|
| Misc. | ArguAna (AR) | Argument Retrieval | - | 23 | 1,406 | 8.7 |
| Misc. | Touche-2020 (TO) | Argument Retrieval | - | - | 49 | 382.5 |
| Misc. | MSMARCO (MS) | Passage Retrieval | 503 | - | 6,980 | 8,842 |
| Wikipedia | NaturalQuestions (NQ) | Question Answering | - | - | 3,452 | 2,681 |
| Wikipedia | HotpotQA (HO) | Question Answering | 85 | - | 7,405 | 5,233 |
| Wikipedia | DBpedia (DB) | Entity Retrieval | - | - | 400 | 4,636 |
| Wikipedia | FEVER (FE) | Fact Checking | 110 | - | 6,666 | 5,417 |
| Wikipedia | Climate-FEVER (CL) | Fact Checking | - | - | 1,535 | 5,417 |
| Bio-Medical | TREC-COVID (TR) | Bio-Medical Retrieval | - | 432 | 50 | 171 |
| Bio-Medical | NFCorpus (NF) | Bio-Medical Retrieval | 2.6 | 10.8 | 323 | 3.6 |
| Scientific | SCIDOCS (SD) | Citation Prediction | - | 67 | 1,000 | 25.7 |
| Scientific | SciFact (SF) | Fact Checking | 0.8 | 15.4 | 300 | 5.2 |
| Finance | FIQA-2018 (FI) | Question Answering | 5.5 | 162 | 648 | 57.6 |
| Quora | Quora (QU) | Duplicate-Question Retrieval | - | 200 | 10,000 | 523 |
Table 4 (원논문): BEIR 14개 데이터셋의 통계. Train/Gen Train/Corpus 단위는 천(k). 대부분 데이터셋은 학습셋이 제공되지 않고, 일부는 생성 학습셋 다운로드에 실패했다.
여기서 눈여겨볼 건 학습 데이터 규모의 불균형이다. MSMARCO는 50만 건이 넘는 반면 SciFact는 800건, NFCorpus는 2,600건에 그친다. 저자들은 초기 실험에서 학습 데이터가 너무 적은 도메인은 전문가가 MSMARCO보다도 못한 성능을 냈다고 밝힌다. 라우팅을 제대로 연구하려면 전문가부터 충분히 학습되어 있어야 하므로, BEIR가 제공하는 생성 쿼리(Gen Train)를 함께 써서 각 도메인 전문가를 어느 정도 수준으로 끌어올린 뒤 실험을 진행했다. 실험 결과 해석 시 이 전제를 기억해둘 필요가 있다.
5.2 베이스라인과 라우팅 기법
비교 대상은 크게 세 부류다. 먼저 단일 모델 베이스라인 두 가지다. 같은 데이터를 멀티태스크로 학습한 단일 모델(Multi-Task), 그리고 대규모 범용 데이터 MSMARCO만으로 학습한 단일 모델이다. 다음으로 두 가지 오라클(oracle) 설정이 있다. 데이터셋 전체를 그 데이터셋에서 평균 성능이 가장 좋은 전문가로 보내는 DatasetOracle(선행 연구의 Best Individual에 해당), 그리고 인스턴스마다 최고 전문가로 보내는 InstanceOracle(선행 연구의 Oracle에 해당)이다. InstanceOracle은 라우팅의 상한선(upper bound)을 보여준다.
마지막으로 생성 태스크에서 쓰이던 라우팅 기법 세 가지를 검색에 이식해 비교한다. ExpertClassifierRouter는 전문가마다 이진 분류기를 두고 선택 확률이 가장 높은 전문가를 고른다. ClassificationHeadRouter는 전문가 수만큼의 라벨을 갖는 분류 헤드 하나로 결정한다. DatasetRouter가 RouterRetriever와 가장 가까운데, 유사도로 인스턴스를 검색해 전문가를 고르는 점은 같지만 두 가지가 다르다. (1) RouterRetriever는 예측 라벨(predicted label, 즉 실제 최고 성능 전문가)을 쓰는 반면 DatasetRouter는 원본 데이터셋 라벨을 그대로 쓴다. (2) RouterRetriever는 클러스터링으로 인스턴스를 묶어 중심을 쓰지만, DatasetRouter는 데이터셋에서 100개를 무작위 샘플링한다.
5.3 하이퍼파라미터
베이스 인코더는 사전학습된 Contriever다. LoRA는 rank 8, alpha 32로 두어 전문가당 전체의 약 0.5%(약 100만 개) 파라미터만 학습한다. 학습률 1e-4, 배치 256(in-batch negative 사용), 최대 500 epoch에 early stopping을 건다. 메인 실험은 쿼리 인코더에만 전문가를 적용하고 컨텍스트 인코더는 얼려둔 설정을 기본으로 보고한다(컨텍스트 인코더까지 학습한 결과는 Appendix에 있다). 평가는 BEIR 공식 코드로 nDCG@10을 측정하며, 실험은 A6000 GPU 8장 이하에서 수행했고 모든 시드는 10으로 고정했다.
6. 실험 결과
6.1 메인 결과
7개 도메인 전문가를 쓴 RouterRetriever와 베이스라인들의 비교다.
| MSMARCO | Quora | ArguAna | HotpotQA | NFCorpus | SciFact | FiQA | Avg | |
|---|---|---|---|---|---|---|---|---|
| Single model on MSMARCO | 25.7 | 84.1 | 37.2 | 57.6 | 31.7 | 67.2 | 28.8 | 47.5 |
| Single model with Multi-Task | 22.4 | 82.0 | 36.9 | 52.1 | 32.9 | 69.4 | 28.9 | 46.4 |
| RouterRetriever (w/o MSMARCO expert) | 22.2 | 83.6 | 39.5 | 59.5 | 33.4 | 76.0 | 30.5 | 49.3 |
| ExpertClassifierRouter | 23.8 | 82.5 | 37.9 | 53.1 | 31.5 | 67.1 | 29.1 | 46.4 |
| ClassificationHeadRouter | 22.6 | 83.4 | 38.5 | 52.8 | 32.7 | 69.6 | 28.2 | 46.8 |
| DatasetRouter | 23.6 | 83.9 | 37.3 | 58.4 | 33.1 | 73.4 | 29.9 | 48.5 |
| RouterRetriever (w/ MSMARCO expert) | 23.0 | 83.8 | 38.6 | 59.9 | 33.4 | 77.6 | 30.8 | 49.6 |
| DatasetOracle | 25.7 | 84.5 | 40.2 | 59.9 | 34.4 | 79.8 | 32.2 | 50.9 |
| InstanceOracle | 34.5 | 89.9 | 48.5 | 66.6 | 39.0 | 85.4 | 39.6 | 57.6 |
Table 1 (원논문): BEIR nDCG@10. 같은 학습 데이터 규모에서 RouterRetriever는 단일 모델(MSMARCO, Multi-Task)과 언어모델 계열 라우팅 기법들을 모두 앞선다. 오라클과 비교하면 DatasetOracle에 근접하고, InstanceOracle까지는 여지가 남아 있다.
RouterRetriever는 MSMARCO 전문가가 없어도(49.3) 단일 MSMARCO 모델(47.5)과 멀티태스크 모델(46.4)을 모두 넘는다. MSMARCO 전문가를 추가하면 대부분 도메인에서 성능이 더 올라 49.6이 된다. 공정성을 위해 학습 인스턴스 총량을 MSMARCO와 맞췄는데도 이 격차가 난다는 점이 핵심이다. 도메인마다 별도 임베딩 모델을 두고 쿼리별로 동적으로 고르는 편이, 단일 모델로 모든 도메인을 감당하는 것보다 낫다는 주장을 직접적으로 뒷받침한다.
특히 도메인 특화 데이터셋에서 격차가 크다. SciFact는 단일 MSMARCO 모델의 67.2에서 RouterRetriever 77.6으로 10점 넘게 뛴다. 반대로 MSMARCO 컬럼에서는 RouterRetriever(23.0)가 단일 MSMARCO 모델(25.7)에 못 미치는데, 이건 뒤의 라우팅 에러 분석에서 설명되는 현상이다. 범용 도메인 쿼리는 여러 전문가로 흩어져 라우팅되기 쉬워, MSMARCO 전문가로 집중되지 못하기 때문이다.
6.2 라우팅 기법 비교
같은 Table 1에서 라우팅 기법들의 대비가 선명하다. ClassificationHeadRouter(46.8)와 ExpertClassifierRouter(46.4)는 놀랍게도 단일 MSMARCO 모델(47.5)보다도 낮다. 생성 태스크에서 잘 통하던 분류기 기반 라우팅이 검색에서는 오히려 독이 되는 셈이다. DatasetRouter(48.5)는 MSMARCO 단일 모델보다는 낫지만 RouterRetriever(49.6)에는 못 미친다. 평균적으로 RouterRetriever는 이들 표준 라우팅 기법보다 1.8점 앞선다.
저자들의 해석이 설득력 있다. 언어 모델에서는 라우팅이 토큰 단위로 이뤄져 유연하고, 한 번의 선택이 잘못돼도 그 영향이 분산된다. 반면 검색에서는 인스턴스당 대표 임베딩 하나가 필요하므로 전문가 선택이 인스턴스마다 딱 한 번뿐이다. 선택 하나하나가 결과를 좌우하니 라우팅이 훨씬 정교해야 한다. RouterRetriever는 인코더의 강점인 임베딩 유사도를 라우팅 신호로 삼아 이 요구에 맞춘다. 그럼에도 InstanceOracle(57.6)과의 큰 간극은 라우팅 개선의 여지가 여전히 넓다는 것을 보여준다.
6.3 미지 도메인으로의 제로샷 일반화
전문가가 학습된 도메인은 그렇다 치고, 전문가가 아예 없는 미지의 테스트셋에서는 어떨까? 학습셋이 없는 BEIR 7개 데이터셋(Touche2020, Climate-FEVER, DBPedia, NaturalQuestions, FEVER, TREC-COVID, SciDocs)으로 진짜 제로샷 일반화를 평가한다.
| w/ Experts | w/o Experts | |
|---|---|---|
| Single model on MSMARCO | 47.5 | 31.6 |
| Single model with Multi-Task | 46.4 | 31.2 |
| RouterRetriever (w/ MSMARCO expert) | 49.6 | 31.9 |
| DatasetOracle | 50.9 | 34.2 |
| InstanceOracle | 57.6 | 41.5 |
Table 2 (원논문): 전문가가 있는 도메인(w/ Experts, Table 1에서 가져옴)과 전문가가 없는 7개 BEIR 테스트셋 평균(w/o Experts)에서의 nDCG@10.
전문가가 없는 도메인에서도 RouterRetriever(31.9)가 단일 MSMARCO 모델(31.6)과 멀티태스크(31.2)를 근소하게 앞선다. 격차가 크진 않지만, 해당 도메인 전문가가 없는데도 뒤지지 않는다는 게 실용적으로 중요하다. 미지 쿼리라도 유사한 다른 도메인 전문가로 라우팅되면서 최소한 손해는 보지 않는다는 뜻이다. InstanceOracle이 여기서도 41.5로 크게 앞서는 건, 미지 도메인일수록 완벽한 라우팅의 이득이 더 크다는 신호다.
6.4 학습·추론 효율
RouterRetriever는 전문가당 0.5% 파라미터만 쓰는 LoRA 덕에 전문가를 추가해도 총 파라미터 증가가 무시할 만하다. 학습 데이터 총량도 멀티태스크와 같다. 결정적 차이는 유연성이다. 멀티태스크는 도메인을 추가·삭제·변경할 때 전체 모델을 재학습해야 하지만, RouterRetriever는 라우팅이 학습-프리라 그런 재학습이 없다. 다만 추론 시 쿼리 임베딩을 얻는 데 순전파가 두 번(라우팅용 한 번, 최종 임베딩용 한 번) 필요하다는 비용이 있고, 저자들도 이 라우팅 계산 효율 개선을 향후 과제로 남겨둔다. 구체적 효율 비교는 뒤의 부록에서 다룬다.
7. 분석
7.1 전문가 학습 시 데이터 크기의 영향
전문가를 학습할 때 데이터가 많을수록 좋을까? 답은 "도메인 안에서는 그렇지만, 도메인 밖에서는 아니다"이다.
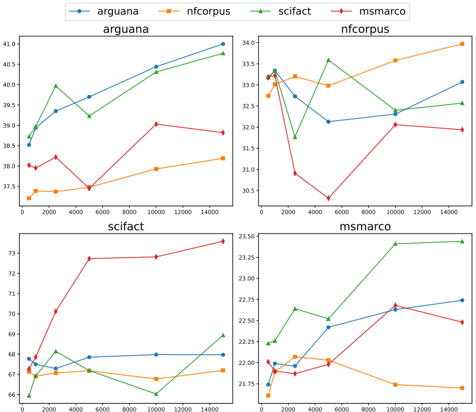
Figure 3: 단일 전문가 성능(nDCG@10, y축) 대 학습 인스턴스 수(x축). 선 색은 학습 데이터셋, 각 서브플롯은 BEIR 테스트 데이터셋을 나타낸다. 학습셋을 키우면 인-도메인 성능은 빠르게 오르지만, 아웃-오브-도메인으로는 잘 전이되지 않는다. (원논문)
네 개 서브플롯(arguana, nfcorpus, scifact, msmarco)에서 각 선은 서로 다른 데이터셋으로 학습한 전문가다. 대각 방향, 즉 학습 도메인과 평가 도메인이 일치할 때는 데이터가 늘수록 성능이 가파르게 오른다. 예컨대 arguana 평가에서 arguana로 학습한 전문가(파랑)가 데이터 증가와 함께 꾸준히 상승한다. 그런데 도메인이 어긋나면 데이터를 더 넣어도 성능이 나아지지 않는다.
흥미로운 부분은 아웃-오브-도메인에서는 범용 도메인(ArguAna, MSMARCO)으로 학습한 전문가가 도메인 특화(SciFact, NFCorpus) 전문가보다 대체로 낫다는 점이다. Figure 2에서 봤던 넓은 커버리지가 여기서 힘을 발휘한다. 학습셋 크기는 인-도메인 성능에, 데이터의 폭넓음과 다양성은 아웃-오브-도메인 성능에 더 크게 기여한다는 것이다. 이 관찰이 "왜 단일 모델을 키우기보다 전문가 여러 개를 두어야 하는가"에 대한 답이 된다. 데이터를 아무리 키워도 한 도메인 전문가가 다른 도메인까지 커버하지는 못하기 때문이다.
7.2 전문가 수의 영향
전문가를 몇 개까지 늘리는 게 이득일까?
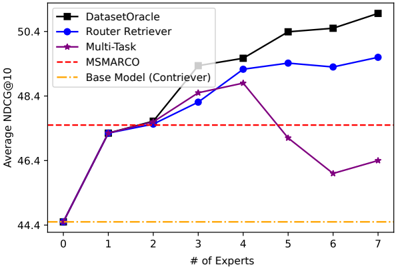
Figure 4: 전문가 수(x축)에 따른 평균 nDCG@10(y축). RouterRetriever는 전문가가 늘수록 성능이 오르며, 단 3개만으로도 MSMARCO 단일 모델을 넘는다. Multi-Task는 도메인이 늘수록 성능이 출렁인다. (원논문)
RouterRetriever(파랑)는 전문가가 3개만 돼도 MSMARCO 단일 모델(빨간 점선)을 넘어선다. MSMARCO만큼 크고 다양한 데이터가 없어도, 여러 임베딩 모델을 두고 그중 알맞은 걸 고르는 능력만으로 앞선다는 뜻이다. 반면 Multi-Task(보라)는 도메인이 늘수록 성능이 오르내린다. 도메인이 많아지면 학습 데이터 간 분산이 커져, 단일 모델이 모든 경우에 맞는 임베딩을 찾기 어려워지기 때문으로 저자들은 본다.
다만 RouterRetriever는 전문가가 늘수록 성능 향상 폭이 줄어드는 수확 체감(diminishing returns)을 보인다. 반면 DatasetOracle(검정)은 계속 오른다. 이 간극이 라우팅 개선의 여지를 가리키는데, 다음 그림이 이를 더 파고든다.
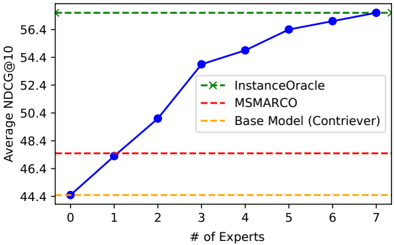
Figure 5: 사용 가능한 전문가 수(x축)에 따른 인스턴스 단위 오라클 라우팅 성능(nDCG@10, y축). 초기에는 전문가 추가 효과가 크고 이후 수확 체감이 나타난다. (원논문)
InstanceOracle도 전문가가 늘수록 빠르게 오르다가 수확 체감을 보인다. 즉 완벽하게 라우팅해도 전문가를 무한정 늘리는 이득은 한계가 있다. 하지만 InstanceOracle의 상승은 RouterRetriever보다 오래 지속되므로, RouterRetriever의 조기 정체는 상당 부분 라우팅이 전문가가 많아질수록 더 헷갈리기 때문이라고 해석할 수 있다. 전문가가 많아진 복잡한 상황을 감당할 더 정교한 라우팅이 필요하다는 것이다.
전문가를 하나씩 순차적으로 추가하며 관찰한 결과는 아래 표에 정리돼 있다.
| Start | Addition | AR | NF | SF | FI | HO | QU | MS | SD | TR |
|---|---|---|---|---|---|---|---|---|---|---|
| AR, NF, SF, FI | - | 40.1 | 32.3 | 76.7 | 30.7 | 55.3 | 83.2 | 22.1 | 15.1 | 43.1 |
| AR, NF, SF, FI | + HotpotQA | 38.5 | 33.0 | 72.2 | 27.9 | 59.2 | 82.7 | 22.3 | 15.9 | 43.6 |
| AR, NF, SF, FI, HO | + Quora | 39.5 | 33.4 | 76.0 | 30.5 | 59.5 | 83.6 | 22.2 | 15.1 | 44.3 |
| AR, NF, SF, FI, HO, QU | + MSMARCO | 38.6 | 33.4 | 77.6 | 30.8 | 59.9 | 83.8 | 23.0 | 14.8 | 44.9 |
| AR, NF, SF, FI, HO, QU, MS | + SciDocs | 38.8 | 32.7 | 76.9 | 30.3 | 59.8 | 84.1 | 22.9 | 16.3 | 44.7 |
| AR, NF, SF, FI, HO, QU, MS | + TREC-COVID | 38.4 | 32.7 | 77.3 | 31.4 | 59.9 | 83.9 | 22.7 | 14.6 | 56.2 |
Table 3 (원논문): RouterRetriever에 전문가를 순차적으로 추가할 때 BEIR 데이터셋별 성능(nDCG@10).
전문가가 적을 때는 새 전문가 하나가 전체 판을 흔든다. HotpotQA 전문가를 넣자 ArguAna가 40.1→38.5, SciFact가 76.7→72.2로 떨어지는 대신 HotpotQA는 55.3→59.2로 오른다. 라우팅이 아직 불안정해 기존에 잘 처리하던 쿼리들이 새 전문가로 잘못 흘러가는 것이다. 반면 전문가가 많아진 뒤에는 부작용이 잦아든다. 7개 전문가에 SciDocs를 추가하면 SciDocs만 14.8→16.3으로 오르고 나머지는 거의 그대로다. TREC-COVID를 넣으면 TREC-COVID가 44.9→56.2로 크게 뛰면서 다른 도메인은 안정적으로 유지된다. 전문가 풀이 어느 정도 갖춰진 뒤에는 관련 도메인 쿼리만 새 전문가로 라우팅되는 셈이다.
7.3 라우팅 에러 분석
RouterRetriever와 InstanceOracle의 성능 격차가 어디서 오는지, 어떤 인스턴스가 어떤 전문가로 라우팅되는지를 히트맵으로 들여다본다.
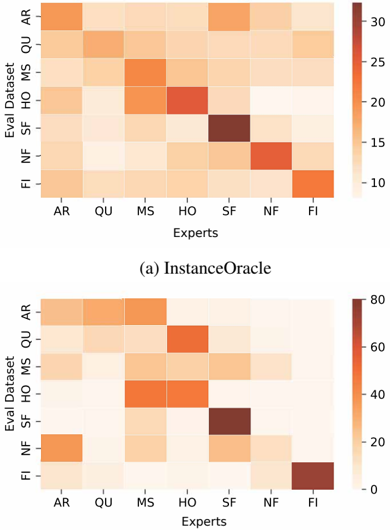
Figure 6: 평가 데이터셋(y축)별로 각 전문가(x축)가 얼마나 자주 선택되는가(진할수록 자주). 대각선은 인-도메인 선택. (a) InstanceOracle: AR·MS 같은 범용 전문가는 여러 데이터셋 쿼리를 두루 처리(진한 세로줄)하고, SF·NF는 반드시 인-도메인 전문가로 가야 한다(한 칸에 집중). (b) RouterRetriever: 실제 라우팅은 더 성기게, 대체로 소스 데이터셋 경계를 따라간다. (원논문)
(a) InstanceOracle 히트맵을 보면 ArguAna와 MSMARCO 컬럼이 여러 행에 걸쳐 진하다. 범용 전문가가 다양한 데이터셋 쿼리를 잘 처리한다는 뜻이다. 반대로 SciFact나 NFCorpus는 해당 전문가 칸만 진하다. 그 도메인 쿼리는 반드시 그 도메인 전문가로 보내야 최고 성능이 나온다. (b) RouterRetriever 히트맵은 훨씬 성기다. 실제 라우팅이 소스 데이터셋 경계를 따라, 즉 그 데이터셋의 전문가로 몰아주는 경향이 있다. 이 성긴 라우팅이 왜 RouterRetriever가 DatasetOracle과 비슷한 성능을 내는지(Table 1의 49.6 vs 50.9) 설명한다. 인스턴스 단위로 최적 전문가를 찾는 InstanceOracle의 세밀함까지는 못 따라가고, 대체로 데이터셋 단위 최적에 머문다는 것이다. 더 강력한 라우팅이 필요하다는 결론으로 이어진다.
8. 부록의 추가 실험
부록에는 본문 주장을 뒷받침하는 상세 결과가 풍부하다. 순서대로 정리한다.
8.1 컨텍스트 인코더까지 학습한 경우
메인 실험은 쿼리 인코더에만 전문가를 붙이고 컨텍스트 인코더는 얼려둔 설정이었다. 컨텍스트 인코더도 함께 학습하면 어떻게 될까?
| AR | MS | HO | NF | SF | QU | FI | Avg | |
|---|---|---|---|---|---|---|---|---|
| MSMARCO | 39.3 | 25.3 | 57.9 | 32.2 | 66.5 | 84.3 | 28.6 | 47.7 |
| Multi-Task | 38.2 | 21.9 | 49.8 | 32.4 | 65.1 | 83.3 | 26.1 | 45.3 |
| RouterRetriever | 40.5 | 21.0 | 61.3 | 32.7 | 68.2 | 82.5 | 30.0 | 48.0 |
| Best Individual (DatasetOracle) | 41.2 | 25.3 | 60.9 | 32.2 | 70.3 | 86.1 | 32.2 | 49.8 |
| Oracle (InstanceOracle) | 48.2 | 33.2 | 68.4 | 39.0 | 76.7 | 90.0 | 38.6 | 56.3 |
Table 6 (원논문): 컨텍스트 인코더를 학습 가능하게 둔 경우의 성능(nDCG@10).
전반적 경향은 동일하다. RouterRetriever(48.0)가 MSMARCO(47.7)와 Multi-Task(45.3)를 앞선다. 저자들은 컨텍스트 인코더를 열면 대체로 성능이 더 좋아진다고 언급하는데, 라우팅 효과 자체를 쿼리 인코더에 격리해 보이기 위해 본문에서는 얼린 설정을 택한 것이다. 방법의 이점이 특정 설정에 의존하지 않는다는 걸 보여주는 결과다.
8.2 전문가 조합별 상세 성능
전문가 수를 4개에서 7개까지 늘리며 전문가 도메인들과 MSMARCO에 대한 평균 성능을 정리한 표들이다(Table 7-10). 여기서 Avg는 각 전문가 도메인과 MSMARCO에 대한 평균이다.
| Gates | AR | MS | HO | NF | SF | QU | FI | Avg |
|---|---|---|---|---|---|---|---|---|
| 4 gates (AR,NF,SF,FI) | 40.1 | 22.1 | - | 32.3 | 76.7 | - | 30.7 | 40.4 |
| 5 gates (+HO) | 38.5 | 22.3 | 59.2 | 33.0 | 72.2 | - | 27.9 | 42.2 |
| 6 gates (+QU) | 39.5 | 22.2 | 59.5 | 33.4 | 76.0 | 83.6 | 30.5 | 49.3 |
| 7 gates (+MS) | 38.6 | 23.0 | 59.9 | 33.4 | 77.6 | 83.8 | 30.8 | 49.6 |
Table 7-10 (원논문): 게이트(전문가) 조합별 RouterRetriever 성능(nDCG@10). Avg는 각 전문가 도메인과 MSMARCO에 대한 평균이며, 조합에 없는 도메인은 -로 표시. Figure 4가 보였듯 3개 게이트만으로도 MSMARCO 모델을 넘는다.
각 조합에서 RouterRetriever는 대응하는 MSMARCO 모델과 멀티태스크 모델을 일관되게 앞선다. 전문가가 4개일 때 이미 40.4로 MSMARCO(38.1)를 넘고, 7개에서는 49.6에 이른다. 참고로 5개 게이트에서 SciFact가 76.7→72.2로 잠깐 떨어지는데, Table 3에서 봤듯 HotpotQA 전문가 추가로 인한 라우팅 불안정 때문이다.
8.3 미지 데이터셋을 포함한 전체 일반화
이번엔 전문가가 없는 도메인까지 포함해 14개 BEIR 데이터셋 전체 평균으로 본다(Table 11-16). 전문가 수를 4개부터 8개까지 늘려가며, 8개는 두 가지 조합(+SciDocs, +TREC-COVID)을 따로 본다.
| Config (Avg over all 14) | RouterRetriever | MSMARCO | Multi-Task | DatasetOracle | InstanceOracle |
|---|---|---|---|---|---|
| 4 gates (AR,NF,SF,FI), Table 11 | 39.9 | 39.5 | 36.7 | 40.5 | 46.2 |
| 5 gates (+HO), Table 12 | 40.2 | 39.5 | 39.0 | 41.8 | 48.1 |
| 6 gates (+QU), Table 15 | 40.4 | 39.5 | 38.2 | 42.2 | 48.9 |
| 7 gates (+MS), Table 16 | 40.7 | 38.5 | 38.8 | 42.6 | 49.6 |
| 8 gates (+SD), Table 13 | 40.4 | 39.5 | 39.0 | 42.6 | 48.9 |
| 8 gates (+TR), Table 14 | 41.7 | 39.5 | 39.1 | 46.9 | 49.9 |
Table 11-16 (원논문): 14개 BEIR 데이터셋 전체 평균 nDCG@10. 전문가 수와 조합에 따른 RouterRetriever와 베이스라인 비교.
모든 조합에서 RouterRetriever가 MSMARCO·Multi-Task를 앞서며, 전문가가 늘수록 전체 평균도 대체로 오른다. 6개 게이트 설정(Table 15)에서 학습 데이터 총량을 세 방법이 동일하게 맞췄을 때, 전문가 없는 도메인에서의 일반화 성능은 RouterRetriever와 MSMARCO가 둘 다 31.6으로 비슷하지만, 전문가가 있는 도메인에서는 RouterRetriever(49.3)가 MSMARCO(47.5)를 크게 앞선다. 즉 RouterRetriever의 이득은 "전문가가 있는 도메인에서 크게 앞서면서, 없는 도메인에서도 손해 보지 않는다"로 요약된다. TREC-COVID 전문가를 추가한 8게이트에서 전체 평균이 41.7로 특히 높은데, TREC-COVID 자체 성능(56.2)이 크게 올라 평균을 끌어올린 결과다.
8.4 효율성 상세 비교
라우팅 방법들을 학습·계산·저장 요구량으로 비교한 표다.
| Method | Training for Routing | Training Datasets for Routing/Experts | Offline Computation | Storage for Pilot Library |
|---|---|---|---|---|
| Single model on MSMARCO | No | - | - | - |
| Single model with Multi-task | No | 전체 D개 도메인 | - | - |
| ClassificationHeadRouter | Yes | 전체 D개 도메인 | - | - |
| ExpertClassifierRouter | Yes | 새 도메인만 | - | - |
| DatasetRouter | No | 새 도메인만 | T | D × T |
| RouterRetriever | No | 새 도메인만 | D × T | D × D |
Table 17 (원논문): 라우팅 방법별 학습·계산·저장 요구량. D는 도메인 수, T는 새 도메인의 데이터셋 크기.
RouterRetriever와 DatasetRouter는 둘 다 라우팅 학습이 필요 없고, 새 도메인 데이터만으로 전문가를 학습한다. 반면 멀티태스크와 ClassificationHeadRouter는 새 도메인이 추가될 때마다 이전 도메인까지 전부 포함해 처음부터 재학습해야 한다. DatasetRouter는 오프라인 계산량()이 RouterRetriever()보다 적지만, 저장 측면에서는 반대다. DatasetRouter는 저장이 필요한 반면 RouterRetriever는 면 된다. 보통 가 보다 훨씬 크기 때문에 저장 효율은 RouterRetriever가 앞선다. 예를 들어 3개 도메인 모델에 100개 인스턴스짜리 새 도메인을 추가하면(, ), DatasetRouter는 오프라인 계산 100회에 100개 임베딩 저장, RouterRetriever는 계산 400회에 4개 임베딩 저장이 된다. 계산을 조금 더 쓰는 대신 저장을 크게 아끼고, 무엇보다 최종 성능이 가장 높다는 게 저자들의 정리다.
8.5 파일럿 임베딩 개수의 영향
파일럿 임베딩을 그룹당 하나(중심 하나)만 쓴 이유를 뒷받침하는 실험이다.
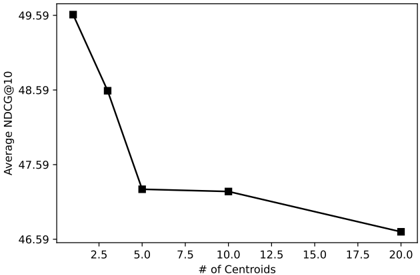
Figure 7: k-means 중심 임베딩 개수(x축) 증가에 따른 평균 nDCG@10(y축). 파일럿 임베딩이 많아질수록 성능이 떨어진다. (원논문)
중심이 1개일 때 49.59로 가장 높고, 5개, 10개, 20개로 늘릴수록 46점대까지 단조 감소한다. 파일럿 임베딩이 많아지면 라우팅을 오히려 헷갈리게 하는 방해 요소로 작용한다는 것이다. 그룹의 대표는 하나의 중심으로 압축하는 편이 라우팅 신호를 선명하게 유지한다는, 단순하지만 실용적인 설계 근거다.
8.6 게이트별 개별 성능
라우팅 없이 각 전문가(게이트)를 단독으로 전체 데이터셋에 평가한 결과다.
| 학습 데이터 | AR | TO | MS | CL | DB | NQ | FE | HO | NF | TR | SD | SF | QU | FI |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| AR | 40.2 | 17.0 | 22.4 | 15.7 | 31.0 | 26.2 | 68.9 | 54.2 | 32.8 | 40.3 | 15.5 | 67.8 | 83.7 | 29.6 |
| MS | 37.2 | 18.3 | 25.7 | 16.0 | 32.7 | 29.3 | 68.8 | 57.6 | 31.7 | 41.2 | 14.6 | 67.2 | 84.1 | 28.8 |
| HO | 38.5 | 19.7 | 22.4 | 17.7 | 36.1 | 28.8 | 67.8 | 59.9 | 32.2 | 39.1 | 16.2 | 66.0 | 82.8 | 27.7 |
| NF | 38.7 | 17.7 | 21.8 | 13.4 | 28.7 | 24.0 | 64.6 | 46.4 | 34.4 | 42.1 | 15.5 | 66.6 | 82.5 | 27.3 |
| TR | 37.0 | 17.3 | 22.8 | 16.2 | 31.6 | 26.4 | 68.1 | 56.6 | 33.1 | 67.3 | 15.7 | 68.3 | 83.1 | 29.1 |
| SD | 38.9 | 18.2 | 22.8 | 17.0 | 32.0 | 27.3 | 70.0 | 57.2 | 33.2 | 39.6 | 16.3 | 66.7 | 84.3 | 28.4 |
| SF | 37.9 | 16.5 | 21.8 | 16.0 | 29.4 | 25.5 | 68.1 | 50.2 | 32.3 | 28.8 | 15.1 | 79.8 | 83.6 | 25.1 |
| QU | 37.5 | 19.4 | 22.6 | 13.9 | 29.0 | 27.4 | 63.8 | 49.1 | 31.1 | 49.7 | 14.3 | 65.7 | 84.5 | 28.3 |
| FI | 35.1 | 18.5 | 22.1 | 15.4 | 29.5 | 25.2 | 64.6 | 46.9 | 32.3 | 42.7 | 15.0 | 64.5 | 83.4 | 32.2 |
Table 18 (원논문): 각 게이트를 라우팅 없이 단독 평가한 전체 성능(nDCG@10). 대각선(학습=평가 도메인)이 대체로 가장 높다.
학습 도메인과 평가 도메인이 일치하는 대각선 값이 대체로 가장 높다(SF 게이트의 SF=79.8, TR 게이트의 TR=67.3, FI 게이트의 FI=32.2). 특히 도메인 특화 데이터셋(NF, TR, SD, SF, QU, FI)은 일치할 때와 아닐 때의 격차가 크다. 반대로 범용 도메인(AR, MS, HO) 게이트는 여러 데이터셋에서 고르게 무난한 성능을 낸다. Figure 2와 Figure 3에서 관찰한 "범용은 넓게, 특화는 깊게"라는 성격이 개별 게이트 수준에서도 그대로 확인된다.
8.7 게이트 순서와 조합의 영향
전문가를 추가하는 순서를 바꿔도 결론이 유지되는지 확인한 실험이다.
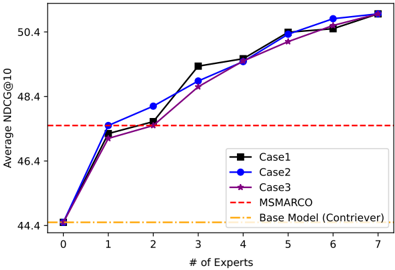
Figure 8: 게이트 추가 순서를 달리한 세 경우의 전문가 수(x축) 대 평균 nDCG@10(y축). Case1은 AR,FI,SF,NF,HO,QU,MS 순, Case2는 그 역순, Case3은 SF,NF,HO,QU,AR,MS,FI 순. (원논문)
세 순서 모두 (1) 전문가가 늘수록 성능이 오르고 (2) 초기 추가 효과가 크고 이후 수확 체감이 나타나는 패턴을 그대로 보인다. 즉 Figure 4·5의 결론이 특정 추가 순서에 기댄 우연이 아니라 조합·순서와 무관하게 재현된다. 방법의 강건성을 뒷받침하는 검증이다.
같은 도메인 안에서 전문가를 추가하는 경우도 따로 봤다.
| AR | MS | HO | NF | TR | SD | SF | QU | FI | Avg | |
|---|---|---|---|---|---|---|---|---|---|---|
| RouterRetriever | 39.5 | 22.2 | 59.5 | 33.4 | 44.3 | 15.1 | 76.0 | 83.6 | 30.5 | 44.9 |
| RouterRetriever (+ TR) | 38.4 | 22.7 | 59.9 | 33.3 | 56.2 | 14.6 | 77.3 | 83.9 | 31.4 | 46.4 |
| RouterRetriever (+ SD) | 38.8 | 22.9 | 59.8 | 32.7 | 44.7 | 16.1 | 76.9 | 84.1 | 30.3 | 45.1 |
Table 19 (원논문): 같은 도메인 내 전문가를 추가할 때의 성능(nDCG@10). 해당 데이터셋 성능은 오르고 나머지는 변화가 미미하다.
생의학 도메인에 TREC-COVID 전문가를 넣으면 TR이 44.3→56.2로 크게 오르고, 과학 도메인에 SciDocs 전문가를 넣으면 SD가 15.1→16.1로 오른다. 두 경우 모두 대상 데이터셋만 개선되고 나머지 도메인은 거의 그대로다. 전문가 추가가 관련 도메인에 집중된 이득을 주면서 다른 도메인을 해치지 않는다는, 앞선 Table 3의 안정적 추가 관찰과 일관된다.
8.8 라우팅 에러의 구체적 사례와 원인
라우팅이 "데이터셋 라벨이 아니라 실제 최고 성능 전문가"를 기준으로 삼는 이유를 보여주는 예시들이다.
| Question | Dataset | Max Gate |
|---|---|---|
| APOE4 expression in iPSC-derived neurons results in decreased tau phosphorylation. | SciFact | NFCorpus |
| which mir regulates the autophagy of cells | SciFact | NFCorpus |
| what kind of leader should i be as the chief executive | FiQA-2018 | ArguAna |
| what is casual dining dining | FiQA-2018 | HotpotQA |
| is it better to be a vegan or vegetarian? | ArguAna | SciFact |
| could we ban animal testing | ArguAna | SciFact |
| why do humans eat meat | ArguAna | Quora |
Table 5 (원논문): 데이터셋 라벨과 실제 최고 성능 게이트가 어긋나는 사례.
생물학 관련 질문은 SciFact 소속이라도 NFCorpus 게이트에서 더 잘 검색되고, 리더십 질문은 FiQA 소속이라도 ArguAna 게이트가 낫다. 데이터셋을 만들 때 서로 겹치지 않게 라벨링하지 않았기 때문에, 한 데이터셋 안의 인스턴스라도 실제로는 다른 도메인과 더 가까울 수 있다. RouterRetriever가 원본 라벨(DatasetRouter 방식) 대신 예측 라벨을 쓰는 이유가 여기 있다.
라우팅 에러 분석(Appendix C.4)은 Figure 6의 두 히트맵 차이를 데이터셋별로 뜯어본다. ArguAna는 최고 게이트 분포가 고르게 퍼져 있고 라우팅도 그 분포를 잘 따른다. 반면 NFCorpus는 NFCorpus 게이트를 골라야 하는데 라우팅이 ArguAna 게이트를 자주 택한다. 원인을 파고들어 보니, ArguAna의 대표 임베딩 중 상당수가 실제로는 NFCorpus에서 뽑혀 온 인스턴스(NFCorpus 소속이지만 ArguAna 게이트에서 최고 성능이라 ArguAna로 라벨링된 것)라 혼동이 생긴다. 저자들은 원본 데이터셋 정보를 완전히 지우기보다 두 정보 사이에 가중치(weighting factor)를 두면 개선될 수 있다고 제안한다.
9. 강점과 한계
강점
- 단일 모델 대비 일관된 우위: Table 1에서 같은 학습 데이터 규모로 MSMARCO 대비 +2.1, 멀티태스크 대비 +3.2 nDCG@10을 얻는다. 전문가 4개 조합부터 7개까지 모든 설정(Table 7-16)에서 이 우위가 흔들리지 않는다.
- 학습-프리 라우팅이 주는 유연성: 라우터를 학습하지 않으므로 전문가 추가·삭제에 재학습이 필요 없다. Table 17에서 보듯 멀티태스크가 전체 재학습을 요구하는 것과 대비된다. 실무에서 도메인이 계속 늘어나는 상황에 잘 맞는다.
- 경량성: 전문가당 0.5% 파라미터만 쓰는 LoRA라 전문가를 여럿 두어도 부담이 작다.
- 검색 특화 라우팅의 발견: 생성용 라우팅 기법이 검색에서 오히려 단일 모델보다 못하다는 것(ClassificationHeadRouter 46.8 < MSMARCO 47.5)을 실증하고, 임베딩 유사도 기반 라우팅으로 이를 넘어선다. "왜 검색은 라우팅이 달라야 하는가"에 대한 토큰 단위 vs 인스턴스 단위라는 설명도 설득력 있다.
- 철저한 분석: 데이터 크기, 전문가 수, 추가 순서, 파일럿 개수, 라우팅 에러까지 다각도로 뜯어봐, 성능이 어디서 오고 어디서 막히는지를 분명히 한다.
한계 및 아쉬운 점
- InstanceOracle과의 큰 간극: Table 1에서 RouterRetriever 49.6 대 InstanceOracle 57.6으로 8점이나 벌어진다. 라우팅이 사실상 DatasetOracle(50.9) 수준에 머물러, 인스턴스 단위의 세밀한 라우팅 잠재력을 못 살린다. 저자들도 인정하듯 라우팅 개선 여지가 방법의 가장 큰 병목이다.
- 추론 비용: 쿼리마다 순전파가 두 번 필요하다. 대규모 실시간 검색에서는 이 지연이 부담이 될 수 있는데, 논문은 개선을 향후 과제로만 남긴다.
- 베이스 인코더 의존: 실험이 Contriever 하나에 묶여 있다. 더 강력한 최신 임베딩 백본(E5, BGE, GTE 등)에서도 같은 이득이 나는지는 확인되지 않았다. 백본이 강해지면 도메인 전문가의 상대적 이점이 줄어들 가능성도 있다.
- 전문가 학습을 위한 데이터 보정: 학습셋이 작은 도메인은 생성 쿼리로 보강해야 전문가가 제대로 학습됐다(5.1절). 즉 방법이 "각 도메인 전문가가 어느 정도는 잘 학습됐다"는 전제 위에 서 있어, 데이터가 극도로 부족한 도메인에서의 실효성은 별도 검증이 필요하다.
- 파일럿 임베딩의 오라벨 혼동: 8.8절에서 드러난 NFCorpus→ArguAna 오라우팅처럼, 예측 라벨 방식이 도리어 라우팅을 흐리는 경우가 있다. 원본 라벨과 예측 라벨을 섞는 가중 방식은 아직 제안 수준에 머문다.
10. 마치며
RouterRetriever가 던지는 메시지는 명료하다. 검색에서 "잘 만든 단일 모델 하나"라는 오랜 기본값에, "경량 전문가 여럿 + 학습-프리 라우팅"이라는 실용적 대안을 제시한 것이다. 생성 모델에서 익숙한 Mixture-of-Experts 아이디어를 임베딩 검색으로 처음 옮겨오면서, 단순 이식이 아니라 검색의 특성(인스턴스당 단 한 번의 선택)에 맞춰 임베딩 유사도 기반 라우팅을 새로 설계한 점이 이 논문의 진짜 기여다.
동시에 이 논문은 자기 방법의 상한선을 정직하게 드러낸다. InstanceOracle과의 8점 격차는 곧 "라우팅만 더 정교해지면 여기까지 갈 수 있다"는 로드맵이기도 하다. 도메인이 끝없이 늘어나는 실무 검색 환경에서, 전체 재학습 없이 전문가를 붙였다 떼는 유연성은 그 자체로 매력적이다. 앞으로 더 강한 백본 위에서, 그리고 인스턴스 단위 라우팅에 근접하는 라우터와 결합됐을 때 이 접근이 어디까지 갈 수 있을지가 흥미로운 후속 질문으로 남는다.
References
- Lee, H., Soldaini, L., Cohan, A., Seo, M., Lo, K. (2025). RouterRetriever: Routing over a Mixture of Expert Embedding Models. AAAI 2025. arXiv:2409.02685
- Izacard, G. et al. (2021). Unsupervised Dense Information Retrieval with Contrastive Learning (Contriever). arXiv:2112.09118
- Hu, E. et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685
- Thakur, N. et al. (2021). BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval. arXiv:2104.08663
- Jang, J. et al. (2023). Exploring the Benefits of Training Expert Language Models over Instruction Tuning. ICML 2023
- Muqeeth, M. et al. (2024). Learning to Route among Specialized Experts for Zero-shot Generalization (PHATGOOSE). arXiv:2402.05859
- Ye, S. et al. (2022). Retrieval of Soft Prompt Enhances Zero-shot Task Generalization. arXiv:2210.03029
- Shen, S. et al. (2024). Learning to Decode Collaboratively with Multiple Language Models. arXiv:2403.03870
- Lee, H. et al. (2023). Back to Basics: A Simple Recipe for Improving Out-of-Domain Retrieval in Dense Encoders. arXiv:2311.09765