논문 리뷰
논문 리뷰: Mixture of Experts Approaches in Dense Retrieval Tasks
Dense Retrieval 모델의 마지막 Transformer 층 뒤에 단 하나의 MoE 블록(SB-MoE)만 붙여, 파라미터 증가를 최소화하면서 특히 경량 모델의 검색 성능을 끌어올린 연구.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Mixture of Experts Approaches in Dense Retrieval Tasks |
| 저자 | Effrosyni Sokli, Pranav Kasela, Georgios Peikos, Gabriella Pasi (University of Milano-Bicocca) |
| 게재 | arXiv 프리프린트, 2025년 10월 |
| 논문 링크 | arXiv:2510.15683 |
| 코드 | github.com/FaySokli/SB-MoE |
1. 들어가며
검색(retrieval) 파이프라인에서 Dense Retrieval Model(DRM)은 이제 기본 옵션에 가깝다. 쿼리와 문서를 같은 밀집 벡터 공간(dense vector space)에 투영해서 의미적 유사도로 순위를 매기는 방식은, BM25 같은 어휘 기반(lexical) 희소 검색이 놓치던 동의어나 문맥을 잡아낸다. 문제는 이 능력이 공짜가 아니라는 점이다. DRM은 대규모 라벨 데이터로 학습해야 하고, 그렇게 학습해도 자기가 본 태스크와 도메인을 벗어나면 성능이 뚝 떨어진다. 일반화(generalizability)와 태스크 특화 성능 사이의 트레이드오프가 이 계열의 고질적인 약점이다.
이 트레이드오프를 완화하는 도구로 꾸준히 거론된 것이 Mixture-of-Experts(MoE)다. 여러 개의 전문가(expert) 서브네트워크를 두고, 입력마다 적합한 전문가를 골라 쓰면 하나의 모델이 여러 종류의 데이터와 태스크를 유연하게 다룰 수 있다는 발상이다. IR 분야에서도 MoE를 DRM에 접목한 시도가 여럿 있었는데, 대부분 Transformer의 각 층(layer) 안에 있는 feed-forward 블록을 여러 전문가로 교체하는 방식을 택했다. 성능은 올랐지만 대가가 컸다. 층마다 전문가를 심으니 추가 파라미터가 눈덩이처럼 불어난 것이다.
이 논문이 던지는 질문은 단순하다. MoE의 이점을 누리면서 파라미터 폭증은 피할 수 없을까? 저자들의 답은 "층마다 넣지 말고, 마지막에 딱 한 번만 넣자"이다. DRM의 마지막 Transformer 층이 뱉어낸 임베딩 위에 MoE 블록 하나(Single-Block MoE, 이하 SB-MoE)만 얹는다. 층 내부는 그대로 두고 출력 임베딩만 정제하는 셈이라, 추가 파라미터가 적고 기존 DRM에 모듈처럼 붙였다 뗄 수 있다.
결과부터 말하면, SB-MoE는 TinyBERT나 BERT-Small처럼 파라미터가 적은 경량 백본에서 특히 잘 통한다. 반대로 BERT-Base나 Contriever처럼 이미 무거운 모델에서는 효과가 미미하거나 오히려 손해를 보기도 한다. 이 비대칭적인 결과가 논문의 가장 흥미로운 지점이고, "MoE가 언제 도움이 되는가"라는 질문에 대한 하나의 실증적 답이기도 하다.
2. 기존 연구의 한계
2.1 Dense Retrieval의 일반화 문제
DRM이 BM25 같은 어휘 기반 모델을 앞서는 이유는 명확하다. 쿼리와 문서를 공유된 밀집 벡터 공간에 투영해 의미적 문맥을 포착하고, 유사도 함수(예: 내적)로 관련성을 추정하기 때문이다. 그런데 이 강점은 학습 분포 안에서만 안정적이다. 도메인이나 태스크가 바뀌면 추가 fine-tuning 없이는 성능이 무너지는 경우가 많고, 심지어 오타 같은 사소한 교란에도 취약하다는 보고가 있다. 요컨대 DRM은 도메인/태스크 적응을 끊임없이 요구하는 모델이다.
2.2 MoE를 층마다 심는 접근의 대가
일반화 문제를 풀 도구로 MoE가 등장한다. MoE 자체는 1991년 Jacobs 등의 Adaptive Mixtures of Local Experts까지 거슬러 올라가는 오래된 아이디어지만, 분류, 다국어 기계번역 같은 다양한 시나리오에서 여전히 효과를 보인다. IR에서도 passage retrieval과 Q&A에 MoE가 쓰였는데, 대표적인 접근들([4], [5], [19])은 하나같이 Transformer 각 층의 feed-forward 블록을 여러 FFN 전문가로 교체하는 방식이다. 이 방식은 성능을 끌어올리지만 전체 파라미터 수를 크게 늘린다는 부담을 동반한다. 층이 12개면 전문가 세트도 12벌이 필요한 구조이니 당연한 결과다.
2.3 부분적으로만 MoE를 활용한 접근
또 다른 갈래로, DESIRE-ME([26])처럼 MoE 블록을 쿼리 임베딩에만 적용한 연구도 있다. 파라미터 부담은 줄지만, 문서 쪽 표현은 그대로 두기 때문에 MoE의 잠재력을 절반만 쓰는 셈이다. 검색은 결국 쿼리와 문서 양쪽의 표현이 얼마나 잘 정렬(align)되느냐의 문제인데, 한쪽만 정제하면 정렬의 이득이 제한된다.
이 세 갈래의 한계, 즉 (1) DRM의 낮은 일반화, (2) 층마다 MoE를 심을 때의 파라미터 폭증, (3) 쿼리에만 MoE를 거는 부분적 활용을 동시에 겨냥하는 것이 이 논문의 출발점이다. 저자들은 세 가지로 대응한다. 층마다가 아니라 단일 블록으로, 쿼리와 문서 양쪽에, 그리고 세 가지 IR 태스크(passage retrieval, open-domain Q&A, 도메인 특화 학술 검색)에서 검증한다.
3. 핵심 아이디어
SB-MoE의 발상은 MoE를 "어디에 넣느냐"의 문제로 재정의한 데 있다. 기존 연구가 Transformer 내부의 매 층에 MoE를 분산 배치했다면, 이 논문은 그 모든 개입을 마지막 한 지점, 즉 최종 층의 출력 임베딩으로 몰아넣는다. 백본 DRM은 손대지 않은 채, 그 위에 전문가 여러 쌍과 게이팅 함수, 풀링 모듈로 이루어진 얇은 블록 하나만 얹는 구조다.
이 선택이 왜 합리적인가. 검색에서 최종적으로 쓰이는 것은 결국 마지막 층이 내놓는 쿼리/문서 임베딩 하나다. 중간 층을 아무리 정교하게 다뤄도, 유사도 계산에 들어가는 것은 마지막 표현이다. 그렇다면 그 마지막 표현을 여러 전문가의 시각으로 정제하는 것이 가장 직접적이고 비용 효율적인 개입이라는 판단이다. 전문가마다 문서의 도메인이나 텍스트 복잡도 같은 서로 다른 특성을 포착하도록 학습되면, 이들의 출력을 종합한 최종 임베딩은 원본보다 풍부해진다.
게이팅 함수가 비지도(unsupervised) 방식으로 학습된다는 점도 중요하다. 어떤 입력에 어떤 전문가가 적합한지에 대한 정답 라벨은 없다. 게이팅 함수는 오로지 검색 손실을 최소화하는 방향으로 각 전문가에게 중요도 가중치를 배분하는 법을 스스로 익힌다. 뒤에서 보겠지만, 이 학습된 라우팅이 있느냐 없느냐가 성능을 가른다. 전문가를 그냥 여러 개 붙이는 것만으로는 아무것도 나아지지 않는다.
기존 층별 MoE가 "모델을 통째로 MoE화"하는 접근이라면, SB-MoE는 "기존 모델은 그대로 두고 출력만 후처리"하는 접근이다. 이 차이가 파라미터 효율과 모듈성을 동시에 가져다준다.
4. 제안 방법 (SB-MoE)
4.1 전체 구조
SB-MoE는 bi-encoder 형태의 DRM 위에 세워진다. bi-encoder는 쿼리와 문서를 독립적으로 인코딩하는 구조라, 문서 임베딩을 미리 계산해 두고 검색 시점에는 쿼리만 인코딩하면 되므로 효율적이다. 쿼리용과 문서용으로 인코더를 따로 두는 것도 가능하지만, 같은 백본을 공유하는 편이 성능 손실 없이 더 강건하다고 알려져 있어 이 논문도 공유 방식을 쓴다.
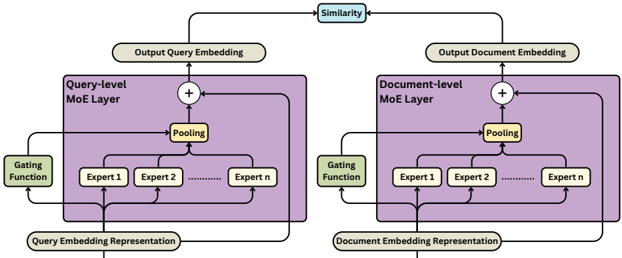
Figure 1 (원논문): SB-MoE의 세 구성요소. (i) 전문가(Experts), (ii) 게이팅 함수(Gating Function), (iii) 풀링 모듈(Pooling). 쿼리 임베딩과 문서 임베딩 각각에 대해 동일한 구조의 MoE 층이 병렬로 작동한다.
Figure 1은 SB-MoE가 실제로 어떻게 흐르는지를 보여준다. 왼쪽은 쿼리 경로(Query-level MoE Layer), 오른쪽은 문서 경로(Document-level MoE Layer)로, 두 경로가 완전히 대칭이다. 각 경로에서 백본 DRM이 내놓은 임베딩 표현(그림 맨 아래 'Query/Document Embedding Representation')이 입력으로 들어가면, 이 입력은 두 갈래로 분기한다. 하나는 Expert 1부터 Expert n까지의 전문가들로, 다른 하나는 게이팅 함수(Gating Function)로 들어간다. 전문가들은 각자 입력을 변환한 표현을 내놓고, 게이팅 함수는 어느 전문가가 이 입력에 중요한지를 나타내는 가중치를 계산한다. 풀링(Pooling) 모듈이 이 둘을 결합해 하나의 표현으로 합치고, 여기에 스킵 연결(그림의 '+')이 더해져 최종 출력 임베딩이 된다. 마지막으로 쿼리와 문서의 최종 임베딩이 만나 유사도(Similarity)가 계산된다.
여기서 눈여겨볼 부분은 그림 상단의 덧셈 노드다. 이것은 잔차 연결(residual connection)로, 전문가들이 정제한 표현을 원본 임베딩에 더하는 구조임을 시사한다. 즉 MoE 블록은 표현을 완전히 새로 쓰는 것이 아니라 원본 위에 보정을 얹는 방식으로 작동한다. 경량 모델에서 SB-MoE가 특히 잘 통하는 이유도 이 지점과 연결지어 해석할 수 있다.
정리하면 SB-MoE는 네 가지로 구성된다. (1) 쿼리/문서 임베딩을 만드는 백본 DRM(Figure 1에는 생략), (2) 최종 층 출력에 작용하는 전문가들, (3) 비지도로 학습되어 입력마다 최적 전문가를 고르는 게이팅 함수, (4) 전문가들의 표현을 종합해 최종 임베딩을 만드는 풀링 모듈이다.
4.2 전문가와 게이팅 함수
전문가는 백본 DRM에서 나온 쿼리 또는 문서 임베딩을 직접 입력으로 받는다. 전문가가 개라면 각 입력에 대해 개의 서로 다른, 그리고 강화된(enhanced) 표현이 만들어진다. 각 전문가의 내부 구조는 Houlsby 등이 제안한 어댑터(adapter) 구조를 따른다. 입력 차원을 절반으로 줄이는 down-projection FFN 층과, 다시 원래 차원으로 복원하는 up-projection FFN 출력 층으로 이루어진 한 쌍의 FFN이 하나의 전문가를 이룬다. 여기에 스킵 연결을 두어 잔차 학습(residual learning)을 가능하게 했다. 차원을 절반으로 압축했다 복원하는 병목(bottleneck) 구조라, 전문가 하나가 늘어나도 파라미터 증가가 크지 않다.
게이팅 함수는 같은 쿼리 또는 문서 임베딩을 입력으로 받아 차원 벡터를 출력한다. 이 벡터의 각 성분은 해당 전문가가 이 입력을 처리하기에 얼마나 적합한지를 나타내는 가능도(likelihood)다. 구조는 단순하다. 벡터 차원을 절반으로 줄이는 은닉층 하나와, 전문가 수와 같은 크기의 출력을 내는 FFN 출력층으로 이루어진다.
학습 시에는 Shazeer 등이 제안한 noisy Top-1 gating을 쓴다. 게이팅 출력에 노이즈를 섞어 특정 전문가로만 쏠리는 것을 막고, 모델이 모든 전문가를 골고루 탐색하도록 강제하는 기법이다. MoE 학습에서 흔히 나타나는 "몇몇 전문가만 계속 선택되고 나머지는 죽어버리는" 문제를 완화하기 위한 장치다.
4.3 두 가지 풀링 전략과 수식
추론 시점에는 전문가들의 출력을 종합하는 방식에 따라 두 가지 변형이 갈린다. 저자들은 이를 각각 SB-MoE과 SB-MoE로 부른다.
첫 번째 변형 SB-MoE은 게이팅 함수가 가장 높은 점수를 준 전문가 하나의 출력만 취한다. 입력 임베딩을 , 번째 전문가가 학습한 함수의 출력을 , 게이팅 함수가 번째 전문가에게 부여한 가중치를 라 하면, 선택되는 전문가 은 다음과 같다.
여기서 은 전체 전문가 수, 은 게이팅 함수가 지목한 가장 적합한 전문가의 인덱스다. 즉 가장 점수가 높은 전문가 하나만 통과시켜 최종 정제 표현 를 얻는다. 계산량이 적고, 각 입력이 특정 전문가에 특화되도록 유도하는 방식이다.
두 번째 변형 SB-MoE은 게이팅 출력 벡터를 softmax로 정규화해 확률 점수를 만들고, 이를 가중치로 삼아 모든 전문가의 출력을 가중합한다.
여기서 는 softmax로 정규화된 확률이고, 최종 표현 는 개 전문가 출력의 가중 평균인 셈이다. 모든 전문가의 특화된 시각을 동시에 반영하므로, 하나의 전문가로는 놓칠 수 있는 다면적 특성을 종합할 수 있다. 실험에서 보겠지만 경량 백본에서는 대체로 이 ALL 변형이 TOP-1보다 낫다. 여러 전문가의 표현을 섞는 것이 표현력이 부족한 작은 모델을 보완하는 효과가 있는 것으로 읽힌다.
학습과 추론의 비대칭에도 주목할 만하다. 학습 때는 항상 noisy Top-1으로 모든 전문가를 탐색시키지만, 추론 때는 TOP-1 또는 ALL 중 하나를 골라 쓴다. 즉 같은 학습 결과를 두 가지 방식으로 활용하는 구조다.
4.4 학습 설정
전문가 수는 기본적으로 6개로 고정하되, 별도의 하이퍼파라미터 실험에서 3, 6, 9, 12개로 변화시킨다. 6개라는 선택은 "전문가가 많다고 반드시 좋아지지는 않으며 대략 2~8개 범위가 적절하다"는 선행 연구들의 관찰을 따른 것이다.
학습률은 백본 DRM과 전문가에 서로 다르게 준다. 백본은 , 전문가는 로, 전문가 쪽을 100배 크게 잡았다. 이미 사전학습된 백본은 살살 건드리고, 새로 붙인 전문가는 빠르게 학습시키겠다는 의도다. 배치 크기는 64, 랜덤 시드는 42로 고정했다. 손실 함수는 contrastive loss를 쓰며 온도(temperature)는 1로 두었는데, Contriever만은 저자 권장값인 0.05를 사용한다. 학습 에폭은 TinyBERT가 30(작아서 빠름), 나머지는 20(단, CS 데이터셋은 학습 쿼리가 워낙 많아 10)이다. 학습셋의 5%를 검증에 쓰고 검증 손실이 가장 낮은 체크포인트만 남긴다.
5. 실험 설정
이 논문은 세 개의 연구 질문(RQ)을 세우고 각각에 맞는 베이스라인을 설계했다.
- RQ1: SB-MoE는 fine-tuning된 원본 DRM 대비 검색 성능이 얼마나 좋은가?
- RQ2: 성능 향상은 학습된 게이팅 함수와 전문가의 특성 포착 능력에서 오는가, 아니면 그냥 전문가를 붙인 효과인가?
- RQ3: SB-MoE는 추가 fine-tuning 없이 여러 도메인과 태스크에 일반화되는가?
베이스라인. RQ1을 위해서는 SB-MoE가 얹히는 원본 DRM을 동일한 데이터와 하이퍼파라미터로 fine-tuning한 FINE-TUNED를 둔다. RQ2를 위해서는 게이팅 함수를 학습하지 않고 전문가 가중치를 무작위로 주는 RANDOM-GATE를 둔다. 학습된 라우팅의 기여를 분리해 내기 위한 대조군이다. RQ3을 위해서는 MSMARCO로만 학습한 뒤 13개 BEIR 데이터셋에 zero-shot 평가하는 FT 설정을 둔다.
백본 DRM 4종. 파라미터 규모와 사전학습 전략이 다른 네 모델을 쓴다. Contriever(110M, contrastive 사전학습), BERT-Base(110M, MLM+NSP), BERT-Small(29M, 지식 증류), TinyBERT(14.5M, 더 작은 증류 모델)이다. 규모가 14.5M부터 110M까지 걸쳐 있어, MoE 블록의 효과가 백본 크기에 따라 어떻게 달라지는지 관찰하기 좋은 구성이다.
평가 지표. nDCG@10과 Recall@100 두 가지를 쓴다. 통계적 유의성은 Bonferroni 보정을 적용한 양측 대응 t-검정(유의수준 0.05)으로 검증하며, ASPIRE 툴킷으로 계산했다. 표에서 별표(*)는 FINE-TUNED(또는 zero-shot의 경우 FT) 대비 통계적으로 유의한 차이를 뜻한다.
데이터셋. 총 7개의 공개 데이터셋을 쓴다. 특성이 아래와 같이 다양하다.
| 데이터셋 | 태스크 | 코퍼스 규모 | 학습 쿼리 | 쿼리당 평균 관련 판정 | 테스트 쿼리 |
|---|---|---|---|---|---|
| MSMARCO v1 | Passage retrieval | 8.8M | 532k | 1.1 | 7k |
| TREC DL 19 | Passage retrieval | (MSMARCO 공유) | - | 215 | 43 |
| TREC DL 20 | Passage retrieval | (MSMARCO 공유) | - | 211 | 54 |
| NQ | Open-domain Q&A | 2.6M | 132k | 1.2 | 3.5k |
| HotpotQA | Multi-hop Q&A | 5.2M | 85k | 2 | 7.4k |
| PS (Political Science) | 도메인 특화 학술 검색 | 4.8M | 160k | 3.8 | 5.7k |
| CS (Computer Science) | 도메인 특화 학술 검색 | 4.8M | 550k | 3.25 | 6.5k |
Table (원논문 IV-C 본문 재구성): 실험에 사용한 7개 데이터셋의 특성. TREC DL 19/20은 MSMARCO와 코퍼스를 공유하되 쿼리당 관련 판정 수가 훨씬 조밀하다.
이 데이터셋들은 규모와 성격이 제각각이라는 점이 중요하다. MSMARCO는 쿼리당 관련 문서가 1.1개로 희소한 반면, TREC DL은 200개가 넘게 조밀하다. NQ와 HotpotQA는 Wikipedia 기반 Q&A인데 HotpotQA는 여러 문서를 거쳐야 하는 multi-hop이다. PS와 CS는 Bassani 등의 Multi-Domain Benchmark에서 가져온 도메인 특화 학술 검색으로, 학습 쿼리 규모가 각각 160k, 550k로 크게 다르다. 이렇게 학습 샘플 크기와 태스크가 다양해야 SB-MoE의 일관성을 제대로 검증할 수 있다. 여기에 더해 MSMARCO로 한 번 학습한 모델을 13개 BEIR 데이터셋에 zero-shot 평가하는 일반화 실험이 별도로 붙는다.
6. 실험 결과
6.1 RQ1: 경량 백본에서 뚜렷한 향상 (in-domain)
첫 번째 실험은 7개 데이터셋 각각에서 학습하고 그 테스트셋에서 평가한 in-domain 결과다. 원본 Table I은 4개 백본 × 4개 변형(FINE-TUNED, RANDOM-GATE, SB-MoE, SB-MoE) × 2개 지표로 이루어진 거대한 표라, 백본별로 나눠 옮긴다. 각 행에서 가장 좋은 값을 볼드로 표시했다(원논문 기준: 데이터셋별 최고값 볼드).
TinyBERT(14.5M)부터 보면 패턴이 선명하다.
| 데이터셋 | 지표 | FINE-TUNED | RANDOM-GATE | SB-MoE TOP-1 | SB-MoE ALL |
|---|---|---|---|---|---|
| MSMARCO | R@100 | .682 | .686* | .688* | .688* |
| nDCG@10 | .244 | .243* | .245* | .246* | |
| TREC DL 19 | R@100 | .421 | .408 | .421 | .422 |
| nDCG@10 | .439 | .434 | .440 | .438 | |
| TREC DL 20 | R@100 | .521 | .516 | .524 | .516 |
| nDCG@10 | .466 | .466 | .452 | .468 | |
| NQ | R@100 | .722 | .721 | .723 | .725* |
| nDCG@10 | .261 | .264* | .263* | .271* | |
| HotpotQA | R@100 | .465 | .458* | .464 | .477* |
| nDCG@10 | .243 | .235* | .236* | .252* | |
| PS | R@100 | .282 | .284* | .284* | .291* |
| nDCG@10 | .145 | .146 | .145 | .149* | |
| CS | R@100 | .327 | .328 | .328 | .332* |
| nDCG@10 | .172 | .171 | .172 | .175* |
*Table I 일부 (원논문): TinyBERT 백본 결과. 볼드는 데이터셋별 최고값, 는 FINE-TUNED 대비 유의한 차이.
TinyBERT에서는 7개 데이터셋 전부에서 SB-MoE(TOP-1 또는 ALL)가 두 지표 모두 FINE-TUNED를 넘거나 최소한 동률이다. 특히 ALL 변형이 거의 모든 최고값을 가져간다. NQ의 nDCG@10은 .261에서 .271로, HotpotQA는 .243에서 .252로 뛴다. 작은 모델일수록 원본 임베딩의 표현력이 부족하니, 여러 전문가의 시각을 종합하는 ALL 방식이 그 빈틈을 메워주는 것으로 해석할 수 있다.
BERT-Small(29M)도 같은 흐름이다.
| 데이터셋 | 지표 | FINE-TUNED | RANDOM-GATE | SB-MoE TOP-1 | SB-MoE ALL |
|---|---|---|---|---|---|
| MSMARCO | R@100 | .734 | .732 | .736* | .736* |
| nDCG@10 | .254 | .253* | .255* | .255* | |
| TREC DL 19 | R@100 | .464 | .455 | .464 | .466 |
| nDCG@10 | .430 | .436 | .437 | .440 | |
| TREC DL 20 | R@100 | .573 | .565 | .574 | .570 |
| nDCG@10 | .449 | .450 | .456 | .453 | |
| NQ | R@100 | .760 | .764* | .774* | .763* |
| nDCG@10 | .215 | .219* | .227* | .218* | |
| HotpotQA | R@100 | .587 | .583* | .588 | .595* |
| nDCG@10 | .310 | .309 | .310 | .317* | |
| PS | R@100 | .335 | .335 | .334 | .337* |
| nDCG@10 | .164 | .164 | .163 | .165 | |
| CS | R@100 | .324 | .326 | .328* | .330* |
| nDCG@10 | .166 | .166 | .168* | .169* |
Table I 일부 (원논문): BERT-Small 백본 결과.
BERT-Small에서 가장 눈에 띄는 건 NQ의 nDCG@10이다. FINE-TUNED .215에서 SB-MoE .227로 5.58% 향상됐는데, 논문이 대표 사례로 든 수치다. 여기서는 TOP-1이 ALL보다 나은 경우가 종종 보여(NQ, TREC DL 20), 경량 모델이라고 항상 ALL이 이기는 것은 아님을 알 수 있다.
반면 BERT-Base(110M)로 넘어가면 그림이 달라진다.
| 데이터셋 | 지표 | FINE-TUNED | RANDOM-GATE | SB-MoE TOP-1 | SB-MoE ALL |
|---|---|---|---|---|---|
| MSMARCO | R@100 | .790 | .788 | .790 | .791 |
| nDCG@10 | .293 | .286* | .289* | .290* | |
| TREC DL 19 | R@100 | .530 | .509* | .528 | .531 |
| nDCG@10 | .506 | .503 | .502 | .507 | |
| TREC DL 20 | R@100 | .614 | .615 | .617 | .620 |
| nDCG@10 | .516 | .508 | .513 | .516 | |
| NQ | R@100 | .881 | .879 | .880 | .883 |
| nDCG@10 | .350 | .351 | .352* | .356* | |
| HotpotQA | R@100 | .699 | .695* | .691* | .695* |
| nDCG@10 | .444 | .430* | .425* | .431* | |
| PS | R@100 | .396 | .395 | .394* | .396 |
| nDCG@10 | .201 | .200 | .200 | .201 | |
| CS | R@100 | .387 | .383* | .382* | .383* |
| nDCG@10 | .197 | .196 | .197 | .198* |
Table I 일부 (원논문): BERT-Base 백본 결과.
BERT-Base에서는 SB-MoE와 FINE-TUNED가 엎치락뒤치락한다. MSMARCO와 TREC DL 19/20에서는 SB-MoE의 이득이 소수점 셋째 자리에 그치고, HotpotQA에서는 오히려 FINE-TUNED가 두 지표 모두 최고값을 가져간다. 저자들의 해석은 "이미 파라미터가 많은 모델에서는 추가 전문가가 오히려 중복(redundancy)을 낳을 수 있다"는 것이다.
Contriever(110M)에서는 이 경향이 더 극단적이다.
| 데이터셋 | 지표 | FINE-TUNED | RANDOM-GATE | SB-MoE TOP-1 | SB-MoE ALL |
|---|---|---|---|---|---|
| MSMARCO | R@100 | .850 | .838* | .839* | .839* |
| nDCG@10 | .321 | .308* | .309* | .309* | |
| TREC DL 19 | R@100 | .605 | .583* | .582* | .584* |
| nDCG@10 | .540 | .533 | .545 | .539 | |
| TREC DL 20 | R@100 | .678 | .665 | .683 | .683 |
| nDCG@10 | .543 | .504* | .543 | .535 | |
| NQ | R@100 | .934 | .926* | .930* | .932 |
| nDCG@10 | .426 | .403* | .416* | .416* | |
| HotpotQA | R@100 | .862 | .855* | .853* | .861 |
| nDCG@10 | .672 | .653* | .653* | .667* | |
| PS | R@100 | .483 | .471* | .479* | .483 |
| nDCG@10 | .251 | .243* | .250 | .251 | |
| CS | R@100 | .437 | .435 | .435 | .438 |
| nDCG@10 | .224 | .224 | .222* | .223 |
Table I 일부 (원논문): Contriever 백본 결과.
Contriever에서는 MSMARCO, TREC DL 19, NQ, HotpotQA, PS의 여러 칸에서 FINE-TUNED가 최고값이고, SB-MoE 변형들은 오히려 유의하게 낮은(별표 붙은) 경우가 많다. Contriever는 애초에 contrastive 사전학습으로 임베딩 품질이 높은 모델이라, 그 위에 전문가를 얹어봐야 더 정제할 여지가 적다는 뜻으로 읽힌다. 결국 SB-MoE의 이득은 백본의 표현력에 반비례하는 셈이다. 표현력이 빈약한 경량 모델일수록 정제할 공간이 크고, 이미 잘 학습된 큰 모델일수록 그 공간이 좁다.
6.2 RQ2: 성능의 원천은 학습된 게이팅
RANDOM-GATE 열이 이 실험의 핵심이다. 전문가는 그대로 두되 게이팅만 무작위로 바꾼 설정인데, 위 네 표에서 확인되듯 RANDOM-GATE는 FINE-TUNED와 엇비슷하거나 오히려 떨어진다. 전문가를 붙였다는 사실 자체로는 아무 이득이 없다는 뜻이다. 심지어 Contriever에서는 RANDOM-GATE가 대부분 유의하게 하락한다. 반대로 학습된 게이팅을 쓰는 SB-MoE는 RANDOM-GATE를 일관되게 앞선다.
이 대비가 논문의 가장 깔끔한 논증이다. "전문가 + 학습된 게이팅"과 "전문가 + 무작위 게이팅"의 유일한 차이가 게이팅의 학습 여부이므로, 성능 향상이 학습된 라우팅에서 온다는 것을 인과적으로 분리해 낸다. 전문가라는 하드웨어가 아니라 그것을 지휘하는 게이팅이라는 소프트웨어가 핵심이라는 이야기다.
6.3 RQ3: MSMARCO 한 번 학습으로 13개 BEIR에 일반화
세 번째 실험은 MSMARCO로만 학습하고 13개 BEIR 데이터셋에 zero-shot 평가한 결과다. 원본 Table II 역시 방대해서 백본별로 나눠 옮긴다. 각 지표(R@100, nDCG@10)에서 세 변형(FT, TOP-1, ALL) 중 최고값을 볼드로 표시했다.
TinyBERT부터 보자.
| 데이터셋 | FT R@100 | FT nDCG | TOP-1 R@100 | TOP-1 nDCG | ALL R@100 | ALL nDCG |
|---|---|---|---|---|---|---|
| TREC-COVID | .058 | .338 | .061 | .348 | .061 | .356 |
| NFCorpus | .200 | .212 | .199 | .209 | .204 | .212 |
| NQ | .653 | .245 | .658* | .250* | .657* | .250* |
| HotpotQA | .467 | .320 | .469 | .320 | .470* | .326* |
| FiQA | .368 | .129 | .377* | .131 | .379* | .133* |
| ArguAna | .836 | .196 | .837 | .201* | .839 | .202* |
| Touché | .321 | .131 | .329 | .142* | .337 | .143* |
| Quora | .968 | .785 | .969 | .786 | .969 | .786 |
| DBPedia | .288 | .223 | .289 | .220 | .286 | .224 |
| SCIDOCS | .235 | .102 | .237 | .101 | .238 | .101 |
| FEVER | .780 | .447 | .775* | .442* | .777 | .452* |
| Climate-FEVER | .386 | .149 | .368* | .140* | .368* | .138 |
| SciFact | .706 | .365 | .725* | .377* | .725* | .378* |
*Table II 일부 (원논문): TinyBERT 백본의 zero-shot BEIR 결과. 는 FT 대비 유의한 차이.
TinyBERT는 13개 중 10개 데이터셋에서 FT를 앞선다. Recall@100 기준 향상 폭은 0.10%에서 5.17%, nDCG@10 기준으로는 0.13%에서 9.16%까지다. 다만 FEVER와 Climate-FEVER에서는 FT가 앞서는데, 학습셋(MSMARCO)과 성격이 크게 다른 사실 검증(fact verification) 태스크에서는 전문가 정제가 역효과를 낼 수 있음을 보여준다.
BERT-Small도 유사하게 9개 데이터셋에서 개선된다.
| 데이터셋 | FT R@100 | FT nDCG | TOP-1 R@100 | TOP-1 nDCG | ALL R@100 | ALL nDCG |
|---|---|---|---|---|---|---|
| TREC-COVID | .038 | .305 | .040 | .303 | .039 | .306 |
| NFCorpus | .213 | .228 | .213 | .227 | .216 | .229 |
| NQ | .706 | .210 | .707 | .213* | .706 | .210 |
| HotpotQA | .607 | .445 | .602* | .437* | .604 | .440* |
| FiQA | .370 | .141 | .386* | .146* | .387* | .147* |
| ArguAna | .967 | .371 | .968 | .363* | .967 | .363* |
| Touché | .230 | .049 | .240 | .050 | .238 | .047 |
| Quora | .976 | .794 | .976 | .788* | .977 | .795 |
| DBPedia | .340 | .221 | .342 | .222 | .342 | .219 |
| SCIDOCS | .282 | .119 | .276* | .116* | .278* | .116* |
| FEVER | .698 | .314 | .691* | .312* | .692* | .311* |
| Climate-FEVER | .318 | .100 | .322* | .104* | .322* | .104* |
| SciFact | .776 | .424 | .770 | .421 | .786 | .432 |
Table II 일부 (원논문): BERT-Small 백본의 zero-shot BEIR 결과.
BERT-Small의 향상 폭은 Recall@100에서 0.10~5.26%, nDCG@10에서 0.13~4.26%다. TinyBERT와 마찬가지로 HotpotQA, SCIDOCS, FEVER처럼 MSMARCO와 이질적인 태스크에서는 FT가 앞선다. 즉 경량 모델의 일반화 이득은 검색형(retrieval/Q&A) 태스크에 집중되고, 사실 검증이나 인용 예측처럼 다른 신호를 요구하는 태스크에서는 제한적이다.
BERT-Base와 Contriever의 zero-shot 결과는 대체로 FT가 우위다.
| 데이터셋 | FT R@100 | FT nDCG | TOP-1 R@100 | TOP-1 nDCG | ALL R@100 | ALL nDCG |
|---|---|---|---|---|---|---|
| TREC-COVID | .079 | .489 | .077 | .470 | .078 | .474 |
| NFCorpus | .238 | .270 | .238 | .265 | .237 | .266 |
| NQ | .829 | .330 | .820* | .322* | .820* | .323* |
| HotpotQA | .633 | .463 | .626* | .455* | .627* | .457* |
| FiQA | .544 | .221 | .535* | .218 | .539 | .218 |
| ArguAna | .947 | .273 | .954 | .281* | .954 | .283* |
| Touché | .398 | .146 | .378 | .143 | .368* | .144 |
| Quora | .984 | .824 | .984 | .825 | .985 | .825 |
| DBPedia | .407 | .290 | .400 | .279* | .399* | .277* |
| SCIDOCS | .308 | .127 | .309 | .128 | .308 | .127 |
| FEVER | .911 | .605 | .902* | .590* | .901* | .588* |
| Climate-FEVER | .489 | .191 | .486 | .188* | .484* | .186* |
| SciFact | .863 | .540 | .833* | .542 | .836* | .543 |
Table II 일부 (원논문): BERT-Base 백본의 zero-shot BEIR 결과.
| 데이터셋 | FT R@100 | FT nDCG | TOP-1 R@100 | TOP-1 nDCG | ALL R@100 | ALL nDCG |
|---|---|---|---|---|---|---|
| TREC-COVID | .052 | .427 | .024* | .266* | .024* | .265* |
| NFCorpus | .301 | .333 | .298 | .324* | .292* | .326* |
| NQ | .896 | .376 | .890* | .358* | .889* | .363* |
| HotpotQA | .799 | .650 | .789* | .634* | .792* | .638* |
| FiQA | .639 | .291 | .628* | .272* | .628* | .273* |
| ArguAna | .920 | .302 | .977* | .348* | .975* | .350* |
| Touché | .346 | .138 | .344 | .107* | .347 | .116* |
| Quora | .993 | .864 | .989 | .818* | .989 | .818* |
| DBPedia | .547 | .390 | .530* | .376* | .529* | .377* |
| SCIDOCS | .388 | .166 | .384 | .166 | .384 | .167 |
| FEVER | .936 | .681 | .936 | .614* | .935 | .619* |
| Climate-FEVER | .485 | .185 | .505* | .197* | .508* | .198* |
| SciFact | .959 | .679 | .942 | .665 | .944 | .668 |
Table II 일부 (원논문): Contriever 백본의 zero-shot BEIR 결과.
큰 백본에서는 SB-MoE가 BERT-Base에서 6개, Contriever에서 5개 데이터셋에서만 FT와 동률이거나 앞선다. 눈에 띄는 예외는 두 가지다. 첫째, Contriever의 ArguAna에서 SB-MoE이 Recall@100을 .920에서 .977로(+6.2%), nDCG@10을 .302에서 .350으로(+15.89%) 크게 끌어올린다. 논쟁 검색(argument retrieval)처럼 MSMARCO와 성격이 다른 태스크에서, 큰 모델에서도 전문가 정제가 통할 때가 있다는 사례다. 둘째, Contriever의 TREC-COVID에서는 SB-MoE가 Recall@100을 .052에서 .024로 반토막 내는데, 이는 zero-shot 상황에서 전문가 라우팅이 잘못 작동할 때 얼마나 크게 어긋날 수 있는지 보여주는 반례다.
전체적으로 RQ3은 RQ1의 결론을 재확인한다. SB-MoE는 경량 백본에서 일반화 이득이 크고, 큰 백본에서는 제한적이다. 다만 "MSMARCO로 한 번만 학습해서 13개 도메인에 붙일 수 있다"는 저비용 일반화 시나리오 자체는 저자원 환경에서 매력적인 그림이다.
7. 하이퍼파라미터 분석
SB-MoE가 경량 모델에서 특히 잘 통하니, 저자들은 TinyBERT를 대상으로 전문가 수의 영향을 파고든다. 이 절의 실험은 전부 SB-MoE로 수행됐다. TinyBERT에서 대체로 ALL이 TOP-1보다 낫기 때문이다.
7.1 전문가를 몇 개 둘 것인가
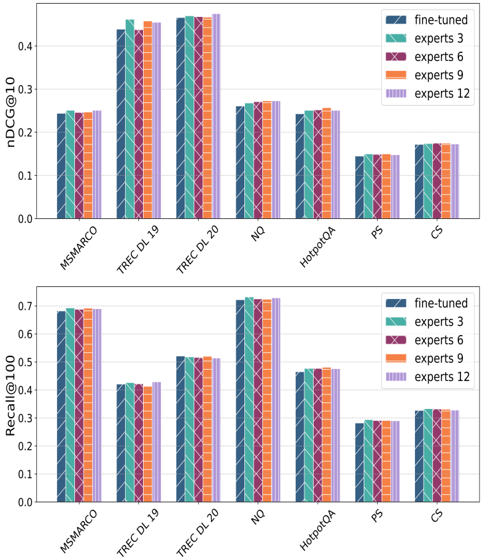
Figure 2 (원논문): SB-MoE을 TinyBERT에 얹고 전문가 수를 3, 6, 9, 12로 바꿨을 때의 nDCG@10(위)과 Recall@100(아래). fine-tuned 베이스라인과 7개 데이터셋에서 비교.
Figure 2는 데이터셋별로 fine-tuned 막대와 전문가 3/6/9/12개 막대를 나란히 놓은 그래프다. 위쪽이 nDCG@10, 아래쪽이 Recall@100이다. 몇 가지가 읽힌다.
첫째, 어느 데이터셋에서든 적어도 하나의 MoE 설정은 fine-tuned를 넘는다. 즉 전문가 수를 잘 고르면 SB-MoE는 언제나 베이스라인 이상이다. 둘째, 그러나 모든 지표와 데이터셋에서 일관되게 최적인 전문가 수는 없다. TREC DL 19를 보면 nDCG@10은 전문가 3개에서 최고인데 Recall@100은 12개에서 최고다. 같은 데이터셋 안에서도 어느 지표를 볼지에 따라 최적값이 갈린다. 셋째, 전문가를 늘린다고 성능이 오르지 않는다. MSMARCO, NQ, PS, CS의 Recall@100은 오히려 3개일 때 가장 좋다. NQ의 nDCG@10만 봐도 전문가 수에 따라 3.29~5.76%까지 출렁인다.
이 결과의 실용적 함의는 전문가 수가 태스크마다 튜닝해야 하는 하이퍼파라미터라는 것이다. 다행히 SB-MoE는 단일 블록이라 추가 파라미터가 적으니, 이 튜닝 자체가 저렴하다. 층별 MoE였다면 전문가 수를 바꿀 때마다 모든 층의 전문가를 다시 학습해야 하는 부담이 있었을 것이다.
7.2 실제로 활성화되는 전문가는 몇 개인가
학습 때는 noisy Top-1 gating으로 모든 전문가를 탐색시키지만, 추론 때 실제로 쓰이는 전문가는 몇 개일까. 저자들은 "코퍼스 문서 중 최소 100k개(가장 큰 코퍼스의 1% 이상)에 대해 게이팅 최고 점수를 받은" 전문가를 활성화(activated)된 것으로 정의하고 세어 봤다. TREC DL 19/20은 MSMARCO와 코퍼스를 공유하므로 제외해 5개 코퍼스가 대상이다.
| 코퍼스 (규모) | 임계값 | 전문가 수 | 활성화된 수 |
|---|---|---|---|
| MSMARCO (8.8M) | > 1.14% | 3 / 6 / 9 / 12 | 3 (100%) / 3 (50%) / 6 (66.67%) / 5 (41.67%) |
| NQ (2.6M) | > 3.85% | 3 / 6 / 9 / 12 | 3 (100%) / 2 (33.33%) / 5 (55.56%) / 4 (33.33%) |
| HotpotQA (5.2M) | > 1.92% | 3 / 6 / 9 / 12 | 3 (100%) / 4 (66.67%) / 7 (77.78%) / 5 (41.67%) |
| PS (4.8M) | > 2.08% | 3 / 6 / 9 / 12 | 3 (100%) / 5 (83.33%) / 5 (55.56%) / 5 (41.67%) |
| CS (4.8M) | > 2.08% | 3 / 6 / 9 / 12 | 3 (100%) / 4 (66.67%) / 4 (44.44%) / 7 (58.33%) |
Table III (원논문): TinyBERT에서 코퍼스별로 실제 활성화된 전문가 수 / 고용된 전문가 수. 임계값(Threshold)은 활성화로 인정하기 위한 최소 문서 비율.
Table III에서 가장 선명한 신호는 전문가 3개 설정에서는 5개 코퍼스 모두 100% 활성화된다는 점이다. 3개는 모두 실질적으로 쓰인다. 반면 전문가를 늘려도 활성화되는 수가 비례해서 늘지 않는다. HotpotQA에서 9개를 두면 7개(77.78%)가 활성화되지만, 12개로 늘리면 오히려 5개(41.67%)로 줄어든다. 전문가를 더 준다고 모델이 더 많이 쓰는 게 아니라, 상당수가 놀고 있다는 뜻이다. 활성화 수는 어느 코퍼스에서도 2~7개 범위에 머문다.
이 관찰은 두 가지를 말해준다. 하나는 앞서 Figure 2에서 본 "전문가를 늘려도 성능이 안 오른다"는 현상의 메커니즘이다. 늘린 전문가가 활성화되지 않으니 성능에 기여할 수 없다. 다른 하나는 효율성이다. 아무리 많아도 코퍼스당 7개를 넘게 쓰이지 않으니, 실제 추론 비용은 고용한 전문가 수보다 훨씬 낮게 유지된다. 전문가를 넉넉히 두더라도 계산 오버헤드가 그만큼 커지지는 않는 셈이다.
7.3 t-SNE로 본 벡터 공간의 변화
마지막으로 저자들은 전문가가 임베딩 공간을 실제로 어떻게 바꾸는지 t-SNE로 시각화한다. 전문가 3개 설정을 골랐는데, 이 설정에서 모든 코퍼스가 100% 활성화되기 때문이다. 각 그림은 쿼리 하나와 그 상위 1000개 검색 문서를 3차원으로 투영한 것으로, 왼쪽은 원본 DRM(TinyBERT), 오른쪽은 SB-MoE가 정제한 공간이다.
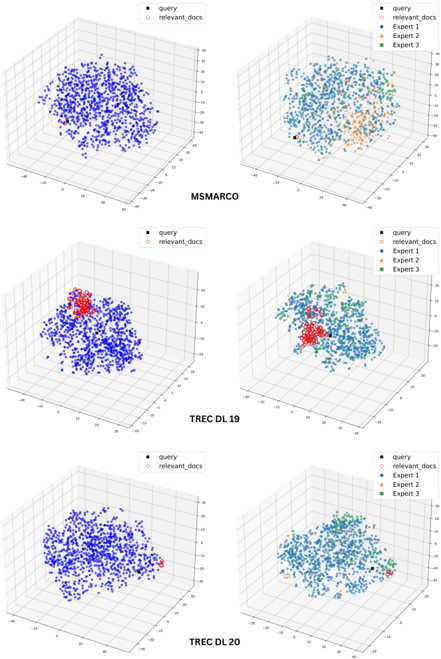
Figure 3 (원논문): 쿼리와 상위 1000개 검색 문서의 3D t-SNE. 왼쪽은 원본 DRM, 오른쪽은 SB-MoE 임베딩. 오른쪽 그림에서 색은 각 문서를 처리한 전문가(Expert 1/2/3)를 나타낸다.
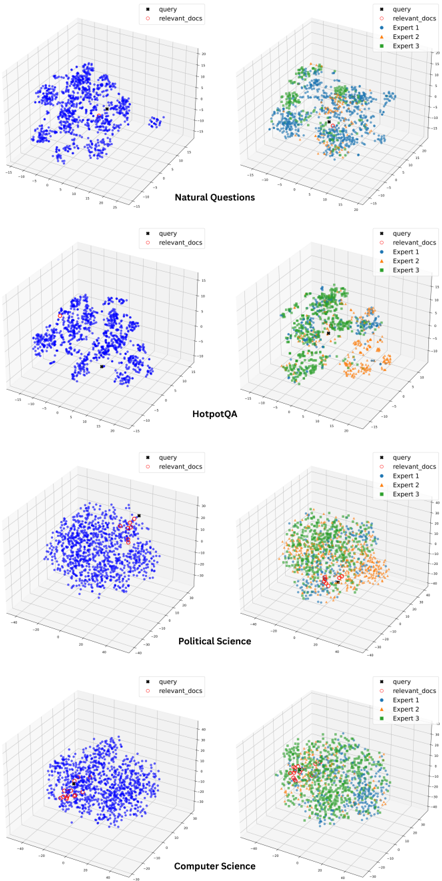
Figure 4 (원논문): Figure 3의 연속. NQ, HotpotQA, Political Science, Computer Science에서의 t-SNE 시각화.
Figure 3과 4를 함께 보면 세 가지가 눈에 들어온다. 첫째, 왼쪽(원본)에서는 대부분의 문서가 파란 점 하나의 색으로 뭉쳐 있고 쿼리(검은 사각형)와 관련 문서(빨간 원)의 위치가 애매하게 섞여 있다. 오른쪽(SB-MoE)으로 가면 쿼리와 관련 문서의 위치가 눈에 띄게 재배치된다. MoE 블록이 쿼리와 관련 문서를 벡터 공간에서 극적으로 이동시킨다는 것이다. 둘째, 오른쪽 그림에서 같은 전문가가 처리한 문서들(같은 색)이 뚜렷하게 군집(cluster)을 이룬다. 특히 HotpotQA(Figure 4)에서 초록/주황/파랑 색이 공간의 서로 다른 영역에 몰려 있는 것이 선명하다. 전문가들이 각자 특정한 텍스트 특성을 학습해 그것을 임베딩에 주입하고 있다는 방증이다. 셋째, 이런 재배치와 군집화가 실제 검색 성능 향상(Figure 2에서 전문가 3개일 때의 개선)과 맞물린다. 쿼리와 관련 문서가 유사도 계산에 더 잘 정렬되도록 공간이 재구성된 결과다.
솔직히 t-SNE 시각화는 차원 축소 과정에서 왜곡이 섞이기 때문에 해석에 주의가 필요하다. 다만 "전문가별로 문서가 색깔 군집을 이룬다"는 관찰은, 전문가가 무의미한 중복이 아니라 서로 다른 역할을 학습한다는 RQ2의 결론과 잘 들어맞는다. 정성적 증거로서 설득력이 있다.
8. 강점과 한계
강점
- 파라미터 효율과 모듈성. 층마다 MoE를 심는 대신 최종 층 뒤에 블록 하나만 얹어, 추가 파라미터를 최소화하면서 기존 DRM에 붙였다 뗄 수 있는 구조를 만들었다. 각 전문가가 차원을 절반으로 줄였다 복원하는 병목 구조라 전문가를 늘려도 비용 증가가 완만하다.
- 게이팅의 기여를 인과적으로 분리. RANDOM-GATE라는 대조군을 통해 "전문가를 붙인 효과"와 "학습된 라우팅의 효과"를 깔끔하게 갈라냈다. RANDOM-GATE가 FINE-TUNED와 엇비슷하다는 결과(Table I)는, 성능 향상의 원천이 게이팅 학습임을 분명히 보여준다.
- 경량 모델에서의 일관된 향상. TinyBERT와 BERT-Small에서 in-domain 7개 데이터셋 전반, zero-shot 13개 중 각각 10개/9개에서 개선을 보였다. 저자원 환경에서 작은 모델을 쓸 수밖에 없는 실무 상황에 직접적인 이점이 있다.
- 효율성의 실증. Table III에서 아무리 많은 전문가를 고용해도 코퍼스당 7개를 넘게 활성화되지 않음을 보여, 성능 이득이 계산 오버헤드 폭증 없이 얻어짐을 뒷받침했다.
한계 및 아쉬운 점
- 큰 백본에서의 효과 부재. BERT-Base와 Contriever에서는 이득이 미미하거나 오히려 손해를 본다(특히 Contriever zero-shot의 TREC-COVID는 Recall이 반토막 난다). 저자들도 인정하는 한계지만, "언제 SB-MoE를 쓰면 안 되는가"에 대한 더 깊은 진단(예: 백본 임베딩의 어떤 특성이 이득을 결정하는가)이 아쉽다.
- 파라미터 증가량의 정량화 부재. 논문의 핵심 주장이 "파라미터를 적게 늘린다"인데, 정작 SB-MoE가 각 백본에서 몇 개의 파라미터를 추가하는지, 기존 층별 MoE 대비 얼마나 절약되는지에 대한 구체적 수치 표가 없다. 효율성 주장이 정성적 서술에 머문 점이 아쉽다.
- 하이퍼파라미터 분석이 TinyBERT에 한정. 전문가 수 실험(Figure 2), 활성화 분석(Table III), t-SNE(Figure 3, 4)가 모두 TinyBERT에서만 수행됐다. 백본 크기에 따라 최적 전문가 수나 활성화 패턴이 달라질 텐데, 다른 백본에서의 검증이 비어 있다.
- 추론 지연/처리량 비교 없음. TOP-1과 ALL 변형의 실제 추론 속도 차이, 전문가 수에 따른 지연시간 변화 같은 실무적 측정이 없다. "효율적"이라는 주장의 마지막 근거가 될 수 있는 부분이다.
- 태스크별 실패 패턴에 대한 분석 부족. FEVER, Climate-FEVER 같은 사실 검증 태스크에서 SB-MoE가 자주 지는데, 이 실패가 왜 발생하는지(학습 태스크 MSMARCO와의 분포 차이 등)에 대한 정성적 에러 분석이 없다.
9. 마치며
이 논문의 기여는 화려한 신기록이 아니라 "MoE를 검색에 붙이는 가장 값싼 방법"을 제시하고, 그것이 언제 통하고 언제 통하지 않는지를 실증한 데 있다. Transformer 층마다 전문가를 심는 대신 최종 임베딩에 단일 블록만 얹는다는 발상은 단순하지만, 파라미터 효율과 모듈성이라는 실무적 가치를 확실히 챙긴다. 그리고 RANDOM-GATE 대조를 통해 "전문가가 아니라 게이팅이 핵심"이라는 점을 깔끔하게 논증한 것이 이 연구의 가장 단단한 부분이다.
무엇보다 인상적인 것은 결과의 방향성이다. SB-MoE의 이득은 백본이 작을수록 크고 클수록 작다. 표현력이 부족한 모델일수록 전문가의 정제가 채워줄 공간이 크다는, 어찌 보면 당연하지만 명확히 검증된 적은 없던 관계를 4개 백본 × 20개 데이터셋(7 in-domain + 13 zero-shot)의 전수 실험으로 보여줬다. 이는 "MoE는 항상 좋다"는 막연한 기대를 "MoE는 경량 모델에서 좋다"는 조건부 명제로 정교화한 셈이다.
실무 관점에서 이 논문이 유용한 지점은 분명하다. 저자원 환경에서 TinyBERT나 BERT-Small급 작은 DRM을 써야 하는데 성능이 아쉽다면, 마지막에 SB-MoE 블록 하나를 얹는 것이 저렴하고 효과적인 선택지가 될 수 있다. 반대로 이미 Contriever급 강한 백본을 쓰고 있다면 굳이 추가할 이유가 없다. 다음 연구가 큰 백본에서 이득이 사라지는 이유를 파고들고, 파라미터 절약량과 추론 비용을 정량화해 준다면, 이 조건부 명제가 더 실용적인 설계 지침으로 다듬어질 것이다.
References
- Jacobs et al., 1991. "Adaptive Mixtures of Local Experts." Neural Computation.
- Shazeer et al., 2017. "Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer." ICLR. (noisy Top-1 gating)
- Houlsby et al., 2019. "Parameter-Efficient Transfer Learning for NLP." ICML. (어댑터 구조)
- Reimers & Gurevych, 2019. "Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks." EMNLP. (bi-encoder)
- Izacard et al., 2022. "Unsupervised Dense Information Retrieval with Contrastive Learning." TMLR. (Contriever)
- Thakur et al., 2021. "BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models." NeurIPS Datasets and Benchmarks.
- Kasela et al., 2024. "DESIRE-ME: Domain-Enhanced Supervised Information Retrieval using Mixture-of-Experts." ECIR.
- Ma et al., 2023. "CoT-MoTE: Exploring Contextual Masked Auto-Encoder Pre-training with Mixture-of-Textual-Experts for Passage Retrieval." arXiv:2304.10195.
- Guo et al., 2024. "CAME: Competitively Learning a Mixture-of-Experts Model for First-stage Retrieval." ACM TOIS.
- Sokli et al., 2024. "Investigating Mixture of Experts in Dense Retrieval." arXiv:2412.11864.
- Bassani et al., 2022. "A Multi-Domain Benchmark for Personalized Search Evaluation." CIKM. (PS/CS)
- Peikos et al., 2024. "ASPIRE: Assistive System for Performance Evaluation in IR." arXiv:2412.15759.