논문 리뷰
논문 리뷰: LEAF - Knowledge Distillation of Text Embedding Models with Teacher-Aligned Representations
1. 들어가며
RAG와 시맨틱 검색이 실서비스에 들어오면서 텍스트 임베딩 모델은 조용히 인프라의 핵심이 됐다. 문제는 성능을 끌어올리려고 모델을 키우다 보니, 검색 파이프라인 전체의 비용과 지연시간이 임베딩 인코딩에서 결정되는 상황이 자주 생긴다는 점이다. 특히 정보 검색(IR, Information Retrieval)에서는 문서와 쿼리를 같은 모델로 인코딩하는 게 당연시되는데, 사실 이 두 작업의 요구사항은 전혀 대칭적이지 않다. 문서는 색인(index) 시점에 한 번만 인코딩하면 되고 지연시간 제약도 느슨하다. 반면 쿼리는 사용자가 검색을 날릴 때마다 실시간으로 인코딩해야 하므로, 큰 모델을 여기에 쓰면 운영 비용이 지속적으로 발생하고 사용자 체감 지연시간도 커진다.
여기서 자연스럽게 떠오르는 아이디어가 하나 있다. 문서는 크고 정확한 모델로, 쿼리는 작고 빠른 모델로 인코딩하면 되지 않을까? 그런데 이게 그동안 불가능했다. 서로 다른 임베딩 모델은 - 심지어 같은 모델 패밀리의 다른 사이즈끼리도 - 임베딩 공간이 호환되지 않기 때문이다. 큰 모델로 만든 문서 벡터와 작은 모델로 만든 쿼리 벡터를 같은 벡터 DB에 넣고 내적을 계산해봐야 의미 없는 값이 나온다. 그래서 임베딩 모델을 바꾸려면 지금까지 색인해둔 모든 데이터의 임베딩을 처음부터 다시 계산해야 하는 값비싼 재색인(recomputation)이 강제됐다.
MongoDB Research의 Robin Vujanic와 Thomas Rückstieß가 ACL 2026에 발표할 이 논문은 바로 이 호환성 문제를 정면으로 겨냥한다. LEAF(Lightweight Embedding Alignment Framework)는 지식 증류(knowledge distillation) 프레임워크인데, 여기서 만들어진 student 모델(leaf 모델)이 teacher 모델과 같은 임베딩 공간을 공유한다. 덕분에 앞에서 말한 비대칭(asymmetric) 아키텍처 - 문서는 teacher로, 쿼리는 leaf로 - 가 실제로 동작한다. 게다가 leaf 모델은 teacher가 가진 MRL(Matryoshka Representation Learning)과 양자화(quantization) 강건성 같은 속성까지 별도 학습 없이 그대로 물려받는다.
결과도 인상적이다. 23M 파라미터짜리 leaf-ir 모델이 BEIR 벤치마크에서 동급(≤100M) 모델 중 공개 리더보드 1위를 찍었고, 멀티태스크 모델 leaf-mt는 MTEB v2(English)에서 역시 동급 1위를 달성했다. 방법론 자체는 놀라울 만큼 단순하다. 손실 함수는 teacher 임베딩과 student 임베딩 사이의 거리 하나뿐이고, 대조 학습(contrastive learning)에서 필수인 라벨(judgment)이나 하드 네거티브(hard negative)도 필요 없으며, 배치 크기 32에 A100 한 장으로 학습된다. 단순함이 오히려 강점이 되는 흔치 않은 사례다.
2. 기존 연구의 한계
이 논문의 접근이 얼마나 단순한지를 생각하면, 오히려 왜 지금까지 아무도 이걸 제대로 파고들지 않았나 싶을 정도다. 저자들도 서두에서 "이 방향을 명시적으로 탐구한 문헌은 여전히 드물다"고 적고 있다. 관련 연구를 카테고리별로 짚어보면 각 접근이 어디서 멈췄는지가 드러난다.
2.1 비대칭 검색과 임베딩 변환
가장 가까운 선행 연구는 Campos et al.(2023)이다. 서로 다른 크기의 쿼리/문서 인코더로 비대칭 검색을 다룬다는 점에서 문제의식이 같다. 다만 이들은 teacher와 호환되도록 사전학습된 Transformer 백본을 레이어 프루닝(layer pruning)한 뒤 KL 발산(KL divergence) 손실로 정렬하는 방식이고, 목표도 경쟁력 있는 임베딩 모델을 만드는 것이 아니라 프루닝이 검색 성능에 미치는 영향을 분석하는 데 있었다. LEAF는 teacher 가중치에 접근한다고 가정하지 않고, 쿼리 인코더와 문서 인코더를 독립적으로 학습할 수 있게 한다는 점에서 더 유연하다.
Yoon & Arik(2025)는 모델 간 임베딩을 번역하는 MLP 변환기 네트워크를 학습시킨다. 흥미로운 지점은 이들이 "회귀(regression)만으로는 불충분하다"고 보고하며 추가 손실 항을 도입했다는 것이다. LEAF의 결론과 정반대인데, 저자들은 그 차이의 원인을 Yoon & Arik의 셋업에서 찾는다. 거기서는 두 Transformer가 모두 얼어붙어(frozen) 있고 오직 MLP만 학습되기 때문이라는 것이다. 반대로 LEAF는 백본 전체를 teacher 공간에 맞춰 재학습시키므로 회귀 손실 하나로 충분하다.
2.2 차원 축소 기반 증류
Hugging Face(2024)의 레시피는 teacher 임베딩을 PCA로 student 차원까지 축소한 뒤 MSE 손실로 정렬한다. 하지만 PCA는 MRL이나 양자화 강건성 같은 속성을 파괴한다. 더 근본적인 문제는, LEAF처럼 문서를 teacher로 인코딩하는 시나리오에서는 차원 축소가 student 배포 여부와 무관하게 문서 표현 자체를 손상시킨다는 점이다. LEAF는 애초에 student를 teacher의 임베딩 공간 안에서 직접 학습시키므로 이 문제를 겪지 않는다. Reimers & Gurevych(2020)도 MSE 손실로 단일 언어 모델을 다국어로 확장했지만, 이 경우 student가 오히려 teacher보다 큰 경우가 일반적이었다.
2.3 Transformer 내부를 활용하는 증류
TinyBERT(Jiao et al., 2020), DistilBERT(Sanh et al., 2020), MobileBERT(Sun et al., 2020) 같은 고전적 증류 기법들은 언어 모델링 헤드(language modeling head)를 타깃으로 하기 때문에 임베딩 모델에 직접 적용하기 어렵다. MiniLM(Wang et al., 2020)은 임베딩에 적용 가능하지만 모델 내부(attention의 key/query/value)에 접근할 수 있어야 하고, tokenizer가 같아야 하며, attention head 수까지 일치해야 한다. 이런 제약은 black-box 모델이나 이질적인 아키텍처 간 증류를 사실상 막는다.
2.4 유사도 점수 기반 증류
가장 흔한 임베딩 증류 방식은 유사도 점수를 활용하는 것이다. Hofstätter et al.(2020)의 Margin MSE 손실이 대표적이고 SPLADE v2(Formal et al., 2021)가 이를 채택했는데, 이 방식은 라벨과 하드 네거티브를 요구한다. Li et al.(2026)은 reranker teacher로부터 유사도 softmax에 KL 손실을 걸어 증류하고, Chen et al.(2024, M3-Embedding)은 dense/sparse 표현을 함께 쓸 수 있다는 성질을 이용한 자기 증류(self-distillation)를 수행한다.
이 모든 접근을 관통하는 한계는 명확하다. 대부분 라벨/하드 네거티브를 필요로 하거나, 모델 내부에 접근해야 하거나, tokenizer·head 수 일치를 요구하거나, 차원 축소로 유용한 속성을 잃는다. 그리고 어느 것도 student를 teacher와 호환되는 임베딩 공간에 정렬시키는 것을 목표로 삼지 않았다. LEAF는 이 빈틈을 정확히 파고든다.
3. 핵심 아이디어
LEAF의 발상은 지식 증류를 함수 근사(function approximation) 문제로 재정의하는 데서 출발한다. teacher 임베딩 모델은 결국 "문자열 → 임베딩 벡터"라는 하나의 함수다. 그렇다면 student가 할 일은 이 함수를 최대한 똑같이 흉내 내는 것이다. teacher가 어떤 텍스트에 대해 만들어내는 벡터 를, student도 같은 텍스트에 대해 최대한 가까운 벡터 로 내놓게 만들면 된다.
이렇게 정의하면 손실 함수가 자명해진다. 두 벡터 사이의 거리, 즉 근사 오차 를 줄이면 된다. 대조 학습처럼 "쿼리는 정답 문서와 가깝고 오답 문서와 멀어야 한다"는 상대적 순서를 가르칠 필요가 없다. teacher가 이미 잘 구조화해둔 임베딩 공간을 그대로 베끼면 되기 때문이다.
이 관점 전환이 가져오는 실질적 이득이 세 가지다. 첫째, teacher와 student가 같은 공간을 공유하므로 비대칭 아키텍처가 가능해진다. 둘째, 손실 계산에 teacher의 출력 벡터만 있으면 되므로 라벨도, 하드 네거티브도, 모델 내부 접근도 필요 없다. black-box 모델도 증류할 수 있다. 셋째, MRL이나 양자화 강건성처럼 teacher의 임베딩 공간에 이미 새겨진 속성들은 student가 그 공간을 근사하는 과정에서 자동으로 딸려온다. 이걸 위해 별도로 학습할 필요가 없다.
저자들이 제시하는 통찰 하나가 특히 곱씹어볼 만하다. 실험에서 leaf-ir(23M)은, 같은 절차·데이터로 처음부터 대조 학습된 arctic-embed-xs(역시 23M)를 큰 폭으로 앞선다. 저자들은 이를 두고 "큰 모델은 대조 학습 과정에서 임베딩 공간의 구조를 최적화하는 데 더 적합하고, 작은 모델은 그렇게 미리 최적화된 구조를 처음부터 스스로 구축하기보다 근사하는 편이 더 쉽다"고 해석한다. 즉 작은 모델에게는 "좋은 공간을 직접 설계하라"보다 "이미 좋은 공간을 베껴라"가 더 나은 학습 목표라는 것이다. 이건 단순히 LEAF가 잘 된다는 얘기를 넘어, 소형 임베딩 모델을 만드는 방법론 자체에 대한 주장이다.
4. 제안 방법 (Method)
4.1 비대칭 아키텍처가 푸는 문제
먼저 LEAF가 무엇을 가능하게 하는지부터 그림으로 보는 게 이해가 빠르다.
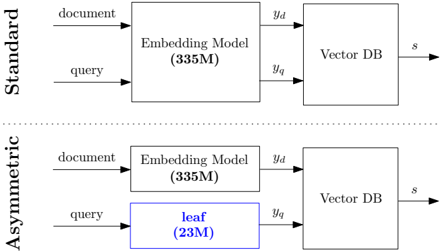
Figure 2: LEAF가 가능하게 하는 비대칭 아키텍처. 위(Standard)는 문서·쿼리를 모두 335M teacher로 인코딩하는 기존 방식, 아래(Asymmetric)는 문서는 teacher로, 쿼리는 23M leaf 모델로 인코딩한다. (원논문)
위쪽 Standard 구성에서는 문서 와 쿼리 가 모두 335M짜리 큰 임베딩 모델을 거친다. 벡터 DB는 이 둘의 유사도 를 계산해 검색 결과를 낸다. 아래쪽 Asymmetric 구성이 LEAF의 핵심 그림인데, 문서는 여전히 teacher(335M)로 인코딩하되 - 색인 시점에 한 번만 하면 되니까 - 쿼리만 작은 leaf(23M)로 인코딩한다. 두 벡터가 같은 공간에 있으므로 벡터 DB에서 정상적으로 유사도를 계산할 수 있다.
이 구성의 실익은 검색 서비스의 부하 특성과 정확히 맞물린다. 문서 인코딩은 오프라인 배치 작업이라 큰 모델을 써도 부담이 적지만, 쿼리 인코딩은 매 검색마다 온라인으로 일어나는 지연시간 크리티컬 경로다. 여기만 23M 모델로 갈아끼우면 쿼리 인코딩 비용과 지연시간이 극적으로 줄어드는데, 검색 품질은 문서 쪽을 teacher가 담당하는 덕에 거의 유지된다. 실제로 저자들은 비대칭 시스템의 성능이 "teacher와 student를 각각 standard로 돌렸을 때의 중간 어딘가"에 위치한다는 걸 실험으로 보인다.
4.2 leaf 모델 구조
leaf 모델 자체의 구조는 표준적인 임베딩 인코더에 층 하나가 더 붙은 형태다.
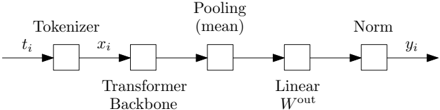
Figure 3: leaf 모델 아키텍처. Tokenizer → Transformer Backbone → mean pooling → Linear() → Norm 순으로 이어진다. (원논문)
입력 텍스트 는 tokenizer를 거쳐 토큰 시퀀스 가 되고, Transformer 백본을 통과한 뒤 mean pooling으로 하나의 벡터로 모인다. 여기서 백본의 출력 차원 은 보통 teacher의 출력 차원 보다 작기 때문에, 선형 층 를 쌓아 차원을 맞춘다. 마지막으로 teacher가 정규화된 벡터를 내놓는 모델이라면 Norm 층을 붙인다.
정리하면 입력 에 대한 leaf 임베딩 는 다음과 같이 계산된다.
여기서 mean pooling은 [PAD] 토큰이 아닌 실제 토큰 출력들에 대해서만 평균을 낸다. 흥미로운 설계 선택은 teacher가 어떤 pooling을 쓰든 상관없이 leaf는 항상 mean pooling을 쓴다는 점이다. [CLS], [EOS] 토큰 pooling이나 max pooling도 실험했지만 mean이 가장 좋았다(Appendix A.1). Norm 층은 teacher가 정규화된 벡터를 출력하는 경우에만 추가되며, 이때 정규화는 단순히 벡터를 자기 크기로 나누는 연산이다.
이라는 선형 층 하나가 이 구조의 숨은 주인공이다. 백본의 저차원 표현을 teacher의 고차원 공간으로 사영(projection)하는 역할을 하는데, 뒤에서 다룰 대안적 증류 손실들(MiniLM, TinyBERT 등)이 정작 이 층에 대한 학습 신호를 주지 못한다는 사실이 LEAF 손실의 필요성을 역설적으로 뒷받침한다.
4.3 손실 함수 - 근사 오차 하나
학습 목표는 앞서 말한 대로 극단적으로 단순하다. 학습 집합에 대한 인덱스를 라 하고, 각 학습 텍스트 와 teacher가 만든 정답 임베딩 의 쌍 가 주어진다. 그러면 각 샘플의 근사 오차는
이고, 이걸 그대로 평균 낸 것이 LEAF의 증류 손실이다.
이게 전부다. teacher 벡터 와 student 벡터 의 유클리드 거리를 최소화하는 것 외에 아무것도 없다. 이 손실의 함의를 하나씩 짚어보면 왜 저자들이 이걸 "lightweight"라 부르는지 알 수 있다.
우선 이 손실은 모델 내부(key, query, value 등)를 전혀 참조하지 않는다. teacher의 출력 벡터 만 얻을 수 있으면 되므로, 어떤 black-box 모델이든 증류 대상이 될 수 있다. 또 라벨이나 하드 네거티브가 등장하지 않는다. 대조 학습에서는 어떤 문서가 쿼리의 정답인지(judgment), 어떤 문서가 헷갈리는 오답인지(hard negative)를 데이터로 줘야 하는데, LEAF는 그냥 텍스트와 그 텍스트의 teacher 임베딩만 있으면 된다. 마지막으로 이 손실은 IR에 특화돼 있지 않다. teacher가 무슨 태스크를 위해 학습됐든, student는 그 출력 공간을 근사할 뿐이다. 그래서 뒤에서 IR용 leaf-ir뿐 아니라 멀티태스크 leaf-mt도 같은 레시피로 만들어낸다.
저자들은 왜 굳이 표현으로 손실을 제한하는지도 명시한다. 이렇게 해야 모델 내부를 모르는 상황에서도 적용 가능하고, 라벨·하드 네거티브도 불필요하며, 태스크 독립적이라는 이점들이 유지되기 때문이다. Appendix B에서 여기에 MiniLM·TinyBERT·DistilBERT의 손실을 얹어봤지만 더 나은 결과를 얻지 못했고, 위 장점들도 잃게 되어 추구하지 않았다고 밝힌다.
4.4 학습 데이터셋
데이터 구성에서 눈에 띄는 점은, teacher가 필요로 했던 라벨을 LEAF는 그냥 버린다는 것이다. 사용하는 데이터셋 중 일부는 judgment를 포함하고 있지만, Eq. (4)의 손실 계산에 필요 없으므로 쓰지 않는다. 대신 도메인을 넓게 커버하는 원시 텍스트를 문서 쪽과 쿼리 쪽으로 나눠 모은다.
문서 쪽은 FineWeb에서 300만, CC-News에서 90만(2016~2024년 각 연도별 랜덤 10만), BERT tokenizer의 개별 토큰 3만 개(baseline 정렬용), 그리고 새로 만든 Vocabulary 데이터셋 80만 개로 구성된다. 쿼리 쪽은 Amazon QA 97.9만, LoTTE 2.7만, MSMARCO/train 50.2만, PubMedQA 27.2만, TriviaQA 7.3만이다.
여기서 Vocabulary는 이 논문이 새로 만들어 공개하는 데이터셋이다. Kaggle의 영어 단어 47.9만 개 목록을 가져와 Claude 3.5 Sonnet에게 각 단어의 정의나 중요한 사실을 생성하게 한 것이다(프롬프트와 샘플은 Appendix C). BERT 토큰 3만 개를 문서로 넣은 것도 재밌는 디테일인데, tokenizer의 모든 개별 토큰에 대한 임베딩을 baseline으로 정렬해두려는 의도로 보인다.
데이터셋별 기여도는 아래 ablation에서 정량화된다.
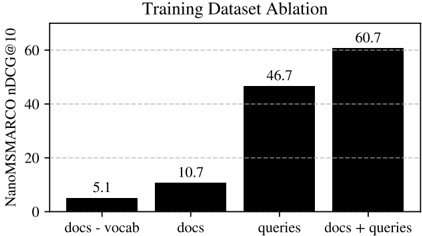
Figure 4: 학습 데이터 하위 세그먼트별로 1 에폭 학습했을 때 NanoMSMARCO nDCG@10 성능. (원논문)
막대 네 개가 각각 문서에서 vocab을 뺀 경우(5.1), 문서만(10.7), 쿼리만(46.7), 문서+쿼리 전체(60.7)를 보여준다. 여기서 드러나는 사실이 두 가지다. 첫째, 쿼리 데이터가 문서 데이터보다 압도적으로 중요하다. 쿼리만으로 학습해도 46.7이 나오는데 문서만으로는 10.7에 그친다. 검색에서 결국 쿼리를 잘 인코딩하는 게 성능을 좌우한다는 직관과 맞닿아 있다. 둘째, 그럼에도 SOTA에 도달하려면 둘 다 필요하다. 쿼리만(46.7)에서 문서까지 더하면 60.7로 14점이 더 오른다. 문서 데이터가 단독으로는 약해도 쿼리 데이터와 결합했을 때 임베딩 공간의 커버리지를 넓혀주는 보완재 역할을 하는 셈이다.
참고로 저자들은 벤치마크 오염(contamination)을 피하기 위해 각 데이터셋 출처를 검토했고, MSMARCO와 그 축소판 NanoMSMARCO는 학습/개발용으로만 쓰고 어떤 성능 벤치마크에도 포함하지 않았다.
4.5 학습 세부사항
백본은 MiniLM-L6-v2(23M)를 쓴다. 백본과 을 포함한 모델 전체를 학습한다. 옵티마이저는 AdamW(, , weight decay ), 초기 학습률 1e-4다. 학습률 스케줄이 조금 독특한데, 10 에폭에 걸쳐 1e-4에서 1e-5로 선형 감쇠(linear decay)하는 사이클을 3번 반복한다. 매 사이클이 끝나면 학습률을 다시 1e-4로 리셋한다. 총 30 에폭인 셈이다. 이 선형 감쇠가 다른 스케줄보다 나았다는 건 Appendix A.2에서 검증된다.
배치 크기는 32다. 이 부분이 특히 대조 학습 계열과 대비된다. Chen et al.(2020)이 보였듯 대조 학습은 배치가 클수록 유리한데(Muennighoff et al.는 2,048, Yu et al.는 32,768을 쓴다), LEAF는 32면 충분하다. 오히려 Appendix A.3의 분석은 작은 배치로 스텝 수를 늘리는 쪽이 유리하다고 말한다. 저자들의 해석이 설득력 있는데, 손실이 모든 임베딩 차원에 대해 조밀한(dense) 지도 신호를 주기 때문이라는 것이다. 대조 학습은 positive/negative 쌍 사이의 상대적 순서만 가르치지만, LEAF는 벡터의 모든 좌표를 정답에 맞추라고 직접 지시한다. 그래서 배치 안에서 많은 네거티브를 모아야 할 이유가 없다.
효율을 위해 모든 학습 샘플의 teacher 임베딩 를 미리 계산해 캐싱한다. 그러면 학습 중에는 student의 forward pass만 돌리면 되므로 시간이 크게 단축된다. teacher가 instruction 프롬프트를 지원하면 정답 임베딩을 만들 때 프롬프트를 넣고, leaf로 를 계산할 때도 동일하게 넣어 정렬을 유지한다. 전체적으로 약 20만 개의 학습 배치를 얻고 그중 128개를 검증셋으로 떼어낸다. 학습은 A100 40GB 한 장, 100시간 예산으로 이뤄진다. 이 정도면 대규모 임베딩 모델 학습으로는 매우 가벼운 축이다.
5. 실험 결과
5.1 정보 검색 모델 leaf-ir
leaf-ir은 arctic-embed-m-v1.5(109M)를 teacher로 삼아 23M으로 증류한 IR 특화 모델이다. 압축률 4.7배. 평가는 IR의 산업 표준인 BEIR로 한다. 비교 대상은 동급 SOTA인 arctic-embed-xs(23M), 그리고 더 큰 110M BERT를 쓰는 SPLADE++·ColBERT v2, 여기에 BM25 baseline과 teacher까지 포함한다.
| Model | Size | ArguAna | ClimateFEVER | CQADupStack | DBPedia | FEVER | FiQA2018 | HotpotQA | NFCorpus | NQ | Quora | SCIDOCS | SciFact | TREC-COVID | Touche2020 | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| leaf-ir (asym.) | 23M | 59.0 | 37.5 | 42.4 | 45.0 | 86.5 | 41.3 | 68.5 | 36.2 | 61.2 | 86.0 | 20.3 | 70.2 | 82.6 | 30.1 | 54.8 |
| leaf-ir | 23M | 58.4 | 34.6 | 42.3 | 44.6 | 86.6 | 38.4 | 68.1 | 35.8 | 58.9 | 86.3 | 19.7 | 70.0 | 80.3 | 30.2 | 53.9 |
| arctic-embed-xs | 23M | 52.1 | 29.9 | 40.1 | 40.2 | 83.4 | 34.5 | 65.3 | 30.9 | 54.8 | 86.6 | 18.4 | 64.5 | 79.4 | 32.8 | 50.9 |
| MiniLM-L6-v2 | 23M | 50.2 | 20.3 | 41.3 | 32.3 | 51.9 | 36.9 | 46.5 | 31.6 | 43.9 | 87.6 | 21.6 | 64.5 | 47.2 | 16.9 | 42.3 |
| BM25† | - | 40.8 | 16.2 | 28.2 | 31.9 | 63.8 | 23.8 | 62.9 | 31.8 | 30.5 | 78.7 | 15.0 | 67.6 | 58.9 | 44.2 | 42.5 |
| SPLADE++ | 110M | 52.0 | 23.0 | 33.4 | 43.7 | 78.8 | 34.7 | 68.7 | 34.7 | 53.8 | 83.4 | 15.9 | 70.4 | 72.7 | 24.7 | 49.3 |
| ColBERT v2 | 110M | 45.3 | 17.6 | 35.9 | 44.1 | 77.4 | 34.6 | 66.5 | 33.0 | 54.7 | 85.1 | 15.0 | 69.1 | 73.2 | 25.7 | 48.4 |
| arctic-embed-m-v1.5 (teacher) | 109M | 59.5 | 36.9 | 45.0 | 45.6 | 88.4 | 42.4 | 72.2 | 36.2 | 62.5 | 87.4 | 21.5 | 71.6 | 84.6 | 31.4 | 56.1 |
Table 1 (원논문): BEIR 벤치마크 nDCG@10 점수. †BM25는 , . SPLADE++·ColBERT v2 점수는 Schlatt et al.(2025)에서, 나머지는 공개 MTEB 리더보드에서 가져왔다.
leaf-ir을 standard 모드로 돌렸을 때 평균 nDCG@10이 53.9로, 14개 데이터셋 중 9개에서 새로운 SOTA를 세운다. 무엇보다 teacher(56.1) 대비 96.1%의 IR 성능을 파라미터 1/4.7로 유지한다는 점이 핵심이다. 같은 23M인 arctic-embed-xs(50.9)를 3점 앞서는데, 앞서 언급했듯 arctic-embed-xs는 teacher와 동일한 절차·데이터로 처음부터 대조 학습된 모델이다. 같은 크기·같은 데이터인데 학습 방식만 "직접 학습" 대신 "teacher 근사"로 바꿨더니 3점이 올랐다는 것이라, 저자들의 "작은 모델은 근사가 더 쉽다"는 주장을 정면으로 뒷받침한다.
비대칭 모드(asym.)로 가면 이야기가 더 재밌어진다. 문서를 teacher(109M)로 인코딩하고 쿼리만 leaf-ir(23M)로 인코딩하는 구성인데, standard 대비 14개 중 11개 데이터셋에서 성능이 오른다. 평균은 54.8로 **teacher 성능의 97.7%**까지 회복된다. 쿼리 인코딩에만 4.7배 작은 모델을 쓰면서도 teacher에 거의 근접하는 셈이다. 표에서 원논문은 이렇게 asym이 standard보다 나아진 셀을 파란색으로 표시하고, 비교 모델을 넘어선 곳을 볼드+밑줄로 표시한다.
세부적으로 보면 CQADupStack(42.4/42.3), FEVER(86.5/86.6), Quora(86.0/86.3)처럼 asym과 standard가 거의 붙어 있는 데이터셋도 있는 반면, ClimateFEVER(37.5 vs 34.6), NQ(61.2 vs 58.9), TREC-COVID(82.6 vs 80.3)처럼 asym이 눈에 띄게 앞서는 경우도 있다. 문서가 길고 복잡한 데이터셋일수록 문서 쪽을 큰 teacher로 인코딩하는 이득이 커지는 경향으로 읽힌다. 한편 Touche2020은 두 모드 모두 30점대로 낮고 BM25(44.2)에 크게 밀리는데, 이 데이터셋 특유의 논쟁적 질의 특성상 밀집 임베딩(dense embedding) 계열 전반이 약한 알려진 케이스다.
BEIR 리더보드 결과를 막대그래프로 보면 위상이 한눈에 들어온다.
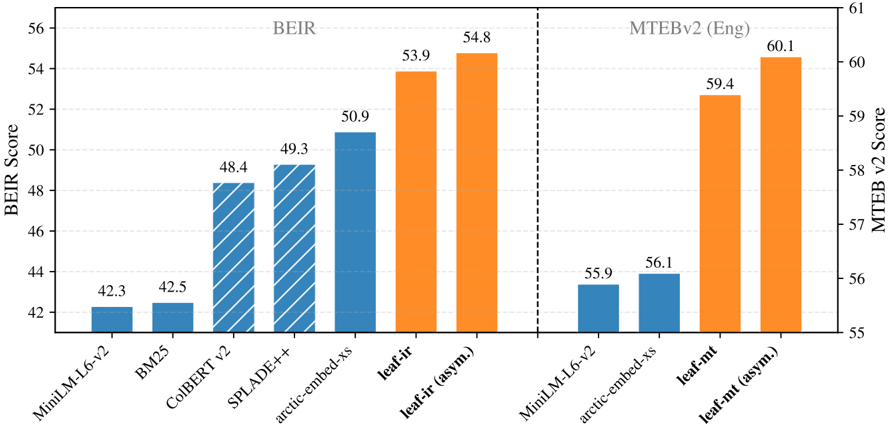
Figure 1: leaf-ir(23M)이 ≤100M 모델 대상 BEIR에서 SOTA를 세우고, 비대칭 모드에서 더 오른다. leaf-mt(23M)도 MTEB v2(English)에서 SOTA를 세운다. 빗금 친 막대는 더 큰 110M 모델을 활용하는 비교 대상. (원논문)
왼쪽 BEIR 패널에서 leaf-ir(53.9)과 leaf-ir asym(54.8)이 arctic-embed-xs(50.9)는 물론, 110M을 쓰는 ColBERT v2(48.4)·SPLADE++(49.3)까지 넘어선다. 23M 모델이 5배 가까이 큰 모델들을 제친다는 게 이 그림의 메시지다. 오른쪽 MTEB v2 패널은 뒤에서 다룰 leaf-mt 결과다.
5.2 MRL과 양자화 강건성 상속
LEAF의 가장 우아한 결과 중 하나가 여기 있다. leaf-ir은 MRL과 양자화 강건성을 명시적으로 학습하지 않았는데도 teacher로부터 물려받는다.
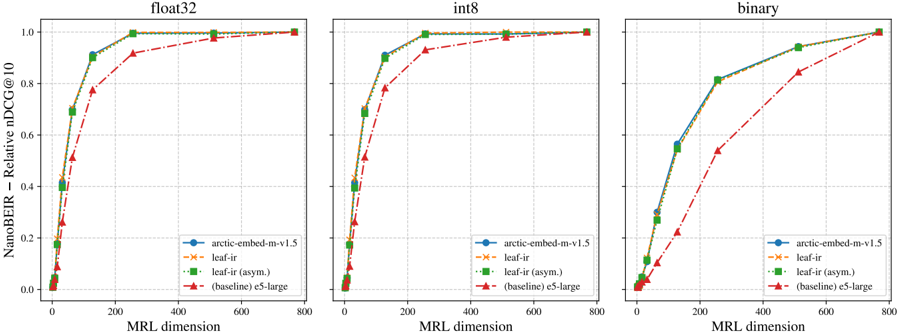
Figure 6: 다양한 MRL 절단(truncation)과 출력 양자화(float32/int8/binary) 조건에서의 성능 곡선. 값은 각 모델·양자화별 최대 nDCG@10에 대한 상대값(0~1). (원논문)
세 패널은 각각 float32, int8, binary 양자화에서 임베딩을 MRL로 절단했을 때(x축: MRL 차원) 상대 성능(y축)이 어떻게 변하는지 보여준다. 여기서 봐야 할 것은 파란 선(teacher, arctic-embed-m-v1.5)과 주황·초록 선(leaf-ir, leaf-ir asym)이 거의 완전히 겹친다는 사실이다. 즉 leaf-ir의 MRL 프로파일이 teacher와 사실상 동일하다. 반면 빨간 선(baseline e5-large, MRL로 학습되지 않은 모델)은 특히 낮은 차원에서 뚝 떨어지고 binary 양자화에서 격차가 더 벌어진다.
이 결과의 의미는 생각보다 크다. MRL 지원 모델을 만들려면 보통 다양한 차원에서의 손실을 함께 최적화하는 별도 학습이 필요하다. 그런데 LEAF는 그냥 teacher의 출력 공간을 근사했을 뿐인데, 그 공간에 MRL 구조가 이미 새겨져 있었기 때문에 student가 자동으로 그 성질을 얻었다. teacher 임베딩을 정확히 근사한다는 것은 곧 teacher가 가진 기하학적 구조 전체를 근사한다는 뜻이고, MRL·양자화 강건성은 그 구조의 일부였던 셈이다. leaf-ir의 절대 MRL 점수는 Appendix I에 있다.
5.3 임베딩 공간이 실제로 겹치는가
teacher와 leaf가 같은 공간을 공유한다는 주장을 시각적으로 확인해주는 게 Figure 5다.
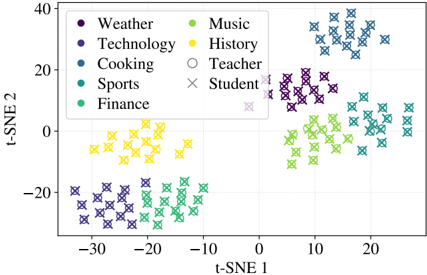
Figure 5: 7개 도메인(sports, technology, finance 등)에서 뽑은 샘플 텍스트에 대한 leaf-ir(Student, ×)과 teacher(○) 임베딩의 t-SNE 사영. (원논문)
7개 도메인(Weather, Technology, Cooking, Sports, Finance, Music, History)의 문장들을 teacher와 leaf-ir로 각각 인코딩한 뒤 t-SNE로 2차원에 사영한 그림이다. 같은 색은 같은 도메인, 원(○)은 teacher, 가위표(×)는 student를 나타낸다. 눈여겨볼 점은 각 텍스트에 대해 teacher 점과 student 점이 거의 포개져 있다는 것이다. 도메인별로 깔끔하게 군집이 형성되는 것은 임베딩 품질을 보여주고, teacher/student 점의 일치는 두 모델이 정말로 같은 공간에 벡터를 배치한다는 걸 보여준다. 비대칭 아키텍처가 왜 동작하는지에 대한 직관적 증거다.
이 그림에 쓰인 문장들은 Appendix D의 Table 5에 정리돼 있는데, 6개 도메인에서 각각 여러 문장을 뽑아 구성했다. 일부만 발췌하면 다음과 같다.
| 도메인 | 예시 문장 (발췌) |
|---|---|
| Weather | "The sun peeked through the clouds after a drizzly morning." / "Heavy rains caused flooding in several low-lying neighborhoods." |
| Technology | "The new smartphone features a foldable display and 5G connectivity." / "Quantum computing promises to solve problems beyond classical reach." |
| Cooking | "Preheat the oven to 375°F before you start mixing the batter." / "Marinate the chicken overnight in a blend of citrus and spices." |
| Sports | "He dribbled past two defenders and sank a three-pointer." / "The marathon runner kept a steady pace despite the sweltering heat." |
| Finance | "The stock market rallied after positive earnings reports." / "Inflation rates have reached a 40-year high, impacting consumers." |
| Music | "The symphony orchestra played a hauntingly beautiful melody." / "Jazz musicians often improvise solos based on the chord changes." |
| History | "The fall of the Berlin Wall in 1989 marked the end of an era." / "The signing of the Magna Carta in 1215 established principles of law." |
Table 5 (원논문): 임베딩 시각화(Figure 5)에 사용된 도메인별 샘플 문장. 각 도메인당 원논문에는 약 14개 문장이 있으며 여기서는 일부만 발췌.
각 도메인의 문장들이 주제적으로 뚜렷이 구분되면서도 도메인 내에서는 표현이 다양하다는 게 이 데이터셋의 설계 의도다. 서로 다른 표현이지만 같은 주제인 문장들이 임베딩 공간에서 한 군집으로 모이는지, 그리고 teacher와 student가 그 군집을 똑같이 그리는지를 검증하기 위한 통제된 예시인 셈이다.
5.4 멀티태스크 모델 leaf-mt
LEAF 레시피가 IR 전용이 아니라는 걸 보이기 위해, 저자들은 mxbai-l-v1(335M)을 23M으로 증류한 leaf-mt를 만든다. 압축률 14.6배로 leaf-ir보다 훨씬 공격적이다. 평가는 MTEB v2(English)로, 검색·리랭킹뿐 아니라 분류(classification), 군집화(clustering), 쌍 분류(pair classification), 의미 유사도(STS), 요약(summarization)까지 7개 태스크를 포함한다.
| # Datasets | Size | Class. (8) | Cluster. (8) | Pair Class. (3) | Rerank (2) | Retrieval (10) | STS (9) | Summ. (1) | Avg. | Avg. (Datasets) |
|---|---|---|---|---|---|---|---|---|---|---|
| leaf-mt (asym.) | 23M | 76.9† | 46.5† | 84.5† | 47.3 | 51.8 | 82.8† | 30.9† | 60.1 | 64.1 |
| leaf-mt | 23M | 76.9 | 46.5 | 84.5 | 46.9 | 47.3 | 82.8 | 30.9 | 59.4 | 63.0 |
| MiniLM-L6-v2 | 23M | 69.3 | 44.9 | 82.4 | 47.1 | 42.9 | 79.0 | 26.0 | 55.9 | 59.0 |
| arctic-embed-xs | 23M | 67.0 | 42.4 | 81.3 | 45.3 | 52.7 | 76.2 | 28.0 | 56.1 | 59.8 |
| mxbai-l-v1 (teacher) | 335M | 79.1 | 47.5 | 87.2 | 48.1 | 55.4 | 84.4 | 32.6 | 62.0 | 66.3 |
Table 2 (원논문): MTEB v2(English) 벤치마크 점수. †는 standard/asym 모드에서 값이 동일한 태스크. 괄호 안 숫자는 태스크를 구성하는 데이터셋 수.
leaf-mt는 standard 모드에서 평균 59.4로 7개 태스크 중 5개에서 SOTA를 세우고, **teacher(62.0) 성능의 95.8%**를 유지한다. 14.6배 압축이라는 걸 감안하면 상당한 회복률이다. 이전 동급 SOTA였던 MiniLM-L6-v2(55.9)와 arctic-embed-xs(56.1)를 모두 앞선다.
비대칭 모드에서 흥미로운 구조가 드러난다. 표에서 †가 붙은 태스크들(분류, 군집화, 쌍 분류, STS, 요약)은 standard와 asym 값이 완전히 같다. 이 태스크들은 문서 쪽만 있거나 쿼리/문서 구분이 없어서 비대칭이 개입할 여지가 없기 때문이다. 비대칭이 실제로 값을 바꾸는 건 리랭킹과 검색 두 태스크뿐인데, 여기서 확실히 이득이 난다. Retrieval이 47.3에서 51.8로 4.5점, Rerank가 46.9에서 47.3으로 오른다. 그 결과 asym 평균이 60.1로 올라 SOTA 태스크가 6개로 늘고, teacher 성능의 96.9%에 도달한다.
leaf-mt 역시 teacher로부터 MRL·양자화 강건성을 물려받는다(Figure 6과 유사한 프로파일, Appendix I 참조). 추론 속도는 뒤의 Appendix H에서 다루지만, 14.6배 압축이 문서 24.4배·쿼리 23.7배 처리량 증가로 이어진다.
5.5 강건성 마진 (Robustness Margins)
LEAF의 이론적 뼈대에 해당하는 분석이다. 저자들은 증류를 근사 스킴으로 보므로, 자연스럽게 "근사 오차를 얼마나 감당할 수 있는가"라는 질문이 따라온다.
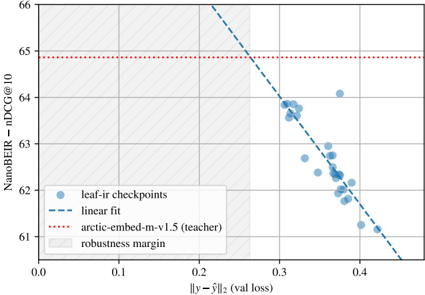
Figure 7: 학습 중 저장한 여러 leaf-ir 체크포인트의 NanoBEIR 성능(y축)과 검증셋 근사 오차 (x축). 점선은 선형 추세, 빨간 점선은 teacher 성능, 빗금 영역이 강건성 마진. (원논문)
각 파란 점은 학습 중 매 에폭 끝에 저장한 leaf-ir 체크포인트다(학습률이 높은 각 사이클 첫 에폭 체크포인트는 변동성이 커서 제외). x축은 검증셋 평균 근사 오차, y축은 NanoBEIR 성능이다. 정규화된 임베딩이므로 오차 범위는 인데, 최선의 체크포인트에서도 평균 오차가 약 0.3에 머문다. 즉 잔여 근사 오차는 결코 무시할 수 없을 만큼 크다.
그런데 여기서 반전이 있다. 파란 점들에 맞춘 선형 추세선(파란 점선)을 보면, 오차가 줄수록 성능이 teacher(빨간 점선)에 가까워지는 건 맞지만, 추세를 외삽하면 오차가 0이 되기 훨씬 전에 이미 teacher와 구별 불가능한 성능에 도달한다. 저자들은 이 성능 차이가 사라지는 것으로 추정되는 영역을 빗금으로 칠하고 이를 시스템의 강건성 마진이라 부른다. 다시 말해, 완벽한 근사가 아니어도 상당한 오차를 시스템이 흡수해준다는 것이다. 저자들은 LEAF의 성공이 바로 이 강건성 마진 덕분이라고 본다. 개인적으로는 이 부분이 논문에서 가장 통찰적인 관찰인데, "근사 오차가 크게 남아 있어도 다운스트림 성능은 멀쩡하다"는 사실이야말로 왜 이 단순한 방법이 통하는지를 설명해주기 때문이다. leaf-mt에 대한 동일 분석은 Appendix G에 있다.
6. 추가 실험 및 부록 (Appendix)
부록이 본문 못지않게 알차다. 학습 설정 근거부터 실패 사례 분석, 추론 속도까지 실무에 필요한 정보가 촘촘하다.
6.1 Pooling 층 비교 (Appendix A.1)
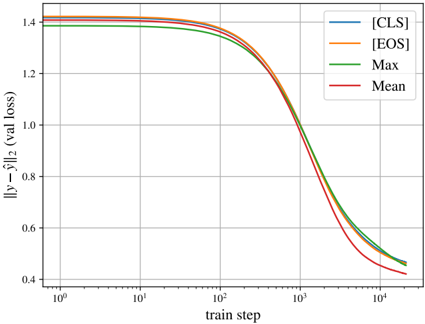
Figure 8: pooling 층별 검증 손실 비교. mean pooling이 가장 낮은(좋은) 최종 검증 손실을 낸다. (원논문)
전체 학습 데이터로 1 에폭을 돌려 [CLS], [EOS], Max, Mean pooling을 비교한 그림이다. 학습 초반(train step 10²까지)에는 네 방식이 비슷하다가, 후반부로 갈수록 mean(빨강)이 나머지보다 확실히 낮은 손실로 수렴한다. teacher가 어떤 pooling을 쓰든 leaf는 mean을 쓴다는 설계 선택의 근거다. 근사 대상이 teacher의 최종 출력 벡터이지 pooling 방식이 아니기 때문에, student는 자기에게 가장 잘 맞는 pooling을 자유롭게 고를 수 있다는 게 이 결과의 함의다.
6.2 학습률 스케줄 (Appendix A.2)
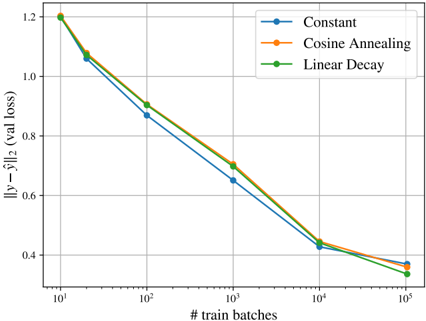
Figure 9: 학습률 감쇠 스케줄 비교. 학습 데이터가 가장 많을 때(에폭당 배치 수가 클 때) linear decay가 최저 검증 손실을 낸다. (원논문)
Constant, Cosine Annealing, Linear Decay 세 스케줄을 각각 10 에폭 돌려 최종 검증 손실을 비교했다. x축은 에폭당 배치 수(데이터 양의 대리 지표), y축은 최종 검증 손실이다. 데이터가 적은 영역에서는 Constant(파랑)가 가장 좋지만, 데이터가 많아져 에폭당 10만 배치에 이르면 - 실제 프로덕션 런에 가까운 조건 - Linear Decay(초록)가 가장 낮은 손실을 낸다. 그래서 본문의 프로덕션 학습에 linear decay를 채택한 것이다. 벤치마크 조건이 아니라 실제 운영 조건에서 무엇이 좋은지를 기준으로 선택했다는 점이 실용적이다.
6.3 배치 크기 선택 (Appendix A.3)
| Batch Size | Time | Val Loss () | # Batches |
|---|---|---|---|
| 16 | 4h 19min | 0.4194 | 400k |
| 32 | 3h 05min | 0.4214 | 200k |
| 64 | 2h 51min | 0.4301 | 100k |
| 128 | 2h 40min | 0.4390 | 50k |
| 256 | 2h 32min | 0.4593 | 25k |
Table 3 (원논문): 배치 크기별 학습 지표. 데이터 양은 고정이라 배치가 작을수록 배치 수가 많아진다. 배치 32가 완료 시간과 검증 손실 사이 최적 절충.
배치 16과 32의 최종 손실(0.4194 vs 0.4214)은 거의 붙어 있지만, 배치를 키울수록 손실이 점점 나빠진다(256에서 0.4593). 반면 학습 시간은 배치를 키워도 그만큼 줄지 않는다(16의 4h19m → 256의 2h32m). 32에서 시간과 손실의 균형이 가장 좋다. 이 표가 뒷받침하는 결론은 LEAF는 큰 배치보다 작은 배치로 많은 스텝을 밟는 걸 선호한다는 것이다. 저자들의 직관적 설명은, student가 teacher의 임베딩 공간에 맞춰 방향을 완전히 재정렬해야 하므로 세밀한 스텝이 유리하다는 것이다. 대조 학습이 큰 배치로 많은 네거티브를 모아야 하는 것과 정반대라, LEAF의 인프라 요구가 왜 가벼운지를 잘 보여준다.
6.4 대안적 증류 손실 (Appendix B)
이 부록이 저자들의 "단순함이 최선"이라는 주장에서 가장 도발적인 부분이다. MiniLM·TinyBERT·DistilBERT의 손실을 각각 LEAF 손실에 더해봤다. 이 손실들은 모두 언어 모델 증류용으로 설계돼 있고 에 대한 학습 신호를 주지 못하므로, LEAF의 손실과 반드시 결합해야 한다.
간단히 짚으면, MiniLM은 마지막 Transformer 층의 value 관계 행렬 과 attention 행렬 에 대해 teacher와 student 사이 KL 발산을 최소화한다. TinyBERT는 은닉 상태(hidden state) 정렬 손실 과 attention 정렬 손실을 쓰는데, 여기서 은 student 층을 teacher 층에 대응시키는 매핑이다. DistilBERT는 은닉 상태에 대한 코사인 유사도 손실을 쓴다. MiniLM과 TinyBERT는 attention head 수 일치를 요구하고, 세 방법 모두 tokenizer 일치를 요구한다 - LEAF의 손실에는 없는 제약들이다.
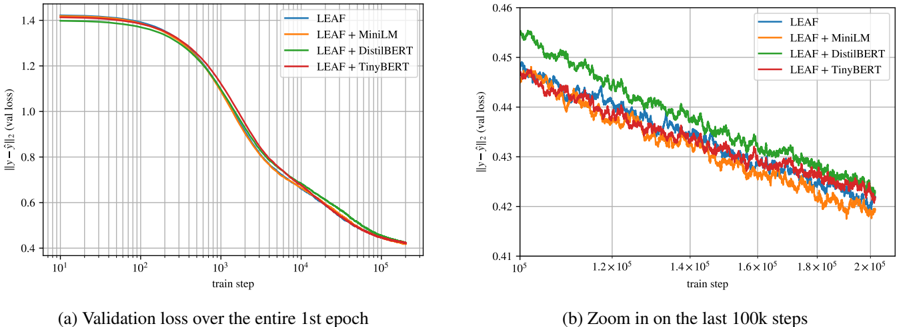
Figure 10: Appendix B의 여러 증류 방식에서 첫 에폭 동안 관찰된 검증 손실. (a) 전체 에폭, (b) 마지막 10만 스텝 확대. 첫 에폭 종료 시점의 검증 손실 차이는 미미하다. (원논문)
(a)를 보면 네 방식(LEAF, +MiniLM, +DistilBERT, +TinyBERT)의 검증 손실 곡선이 사실상 겹친다. (b)로 마지막 10만 스텝을 확대해도 차이가 아주 작다. 근사 오차 관점에서는 어느 손실을 얹든 비슷하게 수렴한다는 뜻이다. 그런데 다운스트림 성능은 얘기가 다르다.
| Loss | nDCG@10 |
|---|---|
| L LEAF | 60.7 |
| L LEAF + L MiniLM | 54.9 |
| L LEAF + L TinyBERT | 53.7 |
| L LEAF + L DistilBERT | 55.3 |
Table 4 (원논문): NanoMSMARCO에서 1 에폭 학습 후 측정한 증류 손실별 비교. Transformer 내부 표현을 활용하는 추가 신호가 더 나은 다운스트림 결과로 이어지지 않음을 보여준다.
순수 LEAF 손실(60.7)이 다른 손실을 더한 경우들(53.7~55.3)을 모두 큰 폭으로 앞선다. teacher의 내부 표현·attention 행렬이라는 더 많은 정보를 활용했는데도 오히려 성능이 떨어진 것이다. 저자들도 이걸 "반직관적(counterintuitive)"이라 부르며 한계 섹션에서 추가 연구가 필요하다고 인정한다. 개인적으로는 이 결과가 이 논문의 철학을 압축한다고 본다. 임베딩 증류에서 중요한 건 최종 출력 공간을 정확히 맞추는 것이지, 그 과정의 중간 표현까지 강제로 맞추는 게 아니라는 것이다. 오히려 중간 표현을 teacher에 억지로 정렬시키면 student가 자기 백본에 맞는 최적 경로를 찾을 자유를 뺏겨 성능이 나빠지는 것으로 해석할 수 있다.
6.5 Vocabulary 데이터셋 (Appendix C)
Kaggle의 47.9만 영어 단어 목록에 Claude 3.5 Sonnet을 붙여 각 단어의 정의·사실을 JSON으로 생성한 데이터셋이다. 프롬프트(Listing 1)는 다의어의 경우 정의마다 별도 문자열을 만들고, 각 정의가 단어를 포함해 독립적으로 읽히도록 요구한다. 예를 들어 "1080"에 대해 "1079 다음, 1081 이전의 자연수", "1920×1080 해상도(Full HD)", "살충제로 쓰이는 화합물 sodium fluoroacetate", "네 연속 소수의 합(263+269+271+277)" 같은 다양한 정의를 생성한다(Listing 2). 이렇게 단어 단위의 짧고 사실적인 텍스트를 문서 데이터에 넣음으로써, 어휘 수준의 표현까지 teacher 공간에 정렬시키려는 의도로 보인다.
6.6 검색 사례 분석 (Appendix E)
teacher와 leaf-ir이 실제 검색에서 얼마나 비슷하게 동작하는지를 정성적으로 보여준다. CC-News 2024년 문서 10만 개에서 "best marvel movie" 쿼리로 상위 10개를 뽑아 teacher, leaf-ir asym, leaf-ir standard를 비교했다.
| teacher | leaf-ir (asym.) | leaf-ir |
|---|---|---|
| 0.5904 - The MCU Movie With The Highest Rotten Tomatoes Score | 0.5905 - (동일 문서) | 0.5925 - (동일 문서) |
| 0.5187 - Kevin Feige: Marvel maestro... | 0.5079 - Kevin Feige... | 0.5312 - X-Men '97 Created A New Challenge... |
| 0.4752 - Netflix top 10 movies... | 0.4729 - X-Men '97... | 0.5238 - Kevin Feige... |
| 0.4721 - X-Men '97 Created A New Challenge... | 0.4621 - Netflix top 10... | 0.4908 - 'Indrani' is like a massified version... |
| 0.4642 - The Best Movies of 2024 So Far... | 0.4618 - Marvel's Apple Vision Pro story... | 0.4823 - Netflix top 10... |
Table 6 (원논문): 뉴스 10만 건에서 teacher와 leaf-ir(asym/standard)이 검색한 상위 10개 문서와 점수. 지면상 상위 5개만 발췌. (원논문 전체는 10개)
세 방법 모두 1위 문서가 동일하고, 그 점수(0.59대)가 나머지보다 확연히 높다. 겹침 정도를 보면 asym이 teacher와 8/10, standard가 9/10 문서를 공유한다. 점수 값 자체도 서로 매우 가깝다(예: 1위 문서 0.5904/0.5905/0.5925). 비대칭 모드에서 쿼리를 23M 모델로 인코딩해도 teacher와 사실상 같은 검색 결과가 나온다는 걸 구체적 사례로 보여주는 셈이다.
같은 부록에서 근사가 어디서 실패하는지도 분석한다. NanoBEIR의 쿼리·문서 중 근사 오차 가 가장 높은 것과 낮은 것을 뽑았다.
| 오차 높은 쿼리 (예시) | 오차 |
|---|---|
| Breaking the Barrier of Transactions: Mining Inter-Transaction Association Rules | 0.5247 |
| Collaborative video reindexing via matrix factorization | 0.5062 |
| Novel DC-DC Multilevel Boost Converter | 0.4835 |
| Fast Sparse Gaussian Markov Random Fields Learning... | 0.4673 |
| 오차 낮은 쿼리 (예시) | 오차 |
|---|---|
| benefits of oxygen pills | 0.2013 |
| where are the cones in the eye located | 0.2098 |
| how long can i keep cooked italian sausage in refrigerator | 0.2150 |
| Is obesity a disease? | 0.2198 |
Table 7 (원논문): 근사 오차가 가장 높은/낮은 쿼리·문서. 지면상 일부 발췌.
패턴이 뚜렷하다. 오차가 큰 쪽은 'matrix factorization', 'DC-DC multilevel boost converter', 'Markov random fields' 같은 전문 기술 용어나 다른 언어(프로그래밍 언어 포함)를 담은 텍스트다. 오차가 낮은 쪽은 건강·일상에 관한 평이한 자연어 질의다. 저자들은 이 격차의 원인을 학습 데이터에서 찾는다. 이런 전문·다국어 텍스트가 LEAF의 학습셋에 거의 없었기 때문이라는 것이다. 실패 원인을 데이터 커버리지 문제로 정직하게 귀속시키고, 이를 향후 개선 지점으로 지목한다는 점에서 분석이 깔끔하다.
6.7 MTEB v2 상세 결과 (Appendix F)
MTEB v2(English)를 구성하는 41개 개별 데이터셋 결과다. leaf-mt의 standard와 asym은 리랭킹·검색 태스크에서만 다르고(쿼리/문서 구분이 있는 유일한 태스크들), 나머지는 동일하다. 볼드는 leaf-mt가 teacher를 넘어선 경우다.
| Task Name | leaf-mt | leaf-mt (asym.) | mxbai-l-v1† | Metric | Task Type |
|---|---|---|---|---|---|
| AmazonCounterfactualClassification | 71.27 | * | 75.07 | Accuracy | Classification |
| Banking77Classification | 85.07 | * | 87.80 | Accuracy | Classification |
| ImdbClassification | 89.05 | * | 92.83 | Accuracy | Classification |
| MTOPDomainClassification | 92.73 | * | 93.95 | Accuracy | Classification |
| MassiveIntentClassification | 72.35 | * | 76.22 | Accuracy | Classification |
| MassiveScenarioClassification | 77.04 | * | 79.89 | Accuracy | Classification |
| ToxicConversationsClassification | 67.50 | * | 67.31 | Accuracy | Classification |
| TweetSentimentExtractionClassification | 60.23 | * | 59.70 | Accuracy | Classification |
| ArXivHierarchicalClusteringP2P | 59.50 | * | 60.11 | V Measure | Clustering |
| ArXivHierarchicalClusteringS2S | 52.91 | * | 58.99 | V Measure | Clustering |
| BiorxivClusteringP2P.v2 | 41.76 | * | 41.87 | V Measure | Clustering |
| MedrxivClusteringP2P.v2 | 37.58 | * | 37.27 | V Measure | Clustering |
| MedrxivClusteringS2S.v2 | 34.49 | * | 34.97 | V Measure | Clustering |
| StackExchangeClustering.v2 | 58.34 | * | 55.08 | V Measure | Clustering |
| StackExchangeClusteringP2P.v2 | 40.28 | * | 40.47 | V Measure | Clustering |
| TwentyNewsgroupsClustering.v2 | 47.29 | * | 51.10 | V Measure | Clustering |
| SprintDuplicateQuestions | 96.48 | * | 96.82 | AP | PairClassification |
| TwitterSemEval2015 | 71.25 | * | 78.55 | AP | PairClassification |
| TwitterURLCorpus | 85.64 | * | 86.23 | AP | PairClassification |
| AskUbuntuDupQuestions | 61.35 | 62.03 | 63.49 | MAP | Reranking |
| MindSmallReranking | 32.35 | 32.53 | 32.62 | MAP | Reranking |
| ArguAna | 61.64 | 64.44 | 65.47 | nDCG@10 | Retrieval |
| CQADupstackGamingRetrieval | 54.29 | 54.00 | 58.94 | nDCG@10 | Retrieval |
| CQADupstackUnixRetrieval | 36.58 | 37.25 | 41.77 | nDCG@10 | Retrieval |
| ClimateFEVERHardNegatives | 26.79 | 35.96 | 36.23 | nDCG@10 | Retrieval |
| FEVERHardNegatives | 72.49 | 81.13 | 86.54 | nDCG@10 | Retrieval |
| FiQA2018 | 36.27 | 42.22 | 45.27 | nDCG@10 | Retrieval |
| HotpotQAHardNegatives | 62.23 | 65.07 | 72.50 | nDCG@10 | Retrieval |
| SCIDOCS | 18.09 | 19.06 | 23.10 | nDCG@10 | Retrieval |
| TRECCOVID | 52.52 | 73.03 | 75.53 | nDCG@10 | Retrieval |
| Touche2020Retrieval.v3 | 51.58 | 45.72 | 48.60 | nDCG@10 | Retrieval |
| BIOSSES | 84.45 | * | 86.05 | Spearman | STS |
| SICK-R | 80.87 | * | 82.78 | Spearman | STS |
| STS12 | 77.96 | * | 79.07 | Spearman | STS |
| STS13 | 87.93 | * | 89.79 | Spearman | STS |
| STS14 | 82.40 | * | 85.22 | Spearman | STS |
| STS15 | 88.08 | * | 89.34 | Spearman | STS |
| STS17 | 87.12 | * | 89.21 | Spearman | STS |
| STS22.v2 | 69.12 | * | 69.04 | Spearman | STS |
| STSBenchmark | 87.19 | * | 89.29 | Spearman | STS |
| SummEvalSummarization.v2 | 30.86 | * | 32.63 | Spearman | Summarization |
*Table 8 (원논문): MTEB v2(English) 41개 데이터셋 상세. 는 standard/asym 동일. †mxbai-l-v1 값은 온라인 리더보드 기준. leaf-mt가 teacher를 넘는 경우를 볼드 처리.
대부분의 데이터셋에서 leaf-mt는 teacher(335M)에 근소하게 못 미친다. 14.6배 압축을 감안하면 자연스러운 결과다. 그런데 몇몇 데이터셋에서는 오히려 teacher를 넘어선다. 특히 Touche2020Retrieval.v3(51.58 vs 48.60)와 StackExchangeClustering.v2(58.34 vs 55.08)에서 격차가 크다. 저자들은 Touche2020 결과를 수동으로 확인해 정상임을 검증했다고 밝힌다. 이런 역전은 증류가 일종의 정규화(regularization) 효과를 내면서, 특정 데이터셋에서 teacher의 과적합 경향을 완화했을 가능성으로 읽힌다.
비대칭 모드의 효과가 검색 태스크에서 특히 극적으로 나타난다. TRECCOVID는 standard 52.52에서 asym 73.03으로 20점 넘게 뛰고, FEVERHardNegatives는 72.49에서 81.13으로, ClimateFEVERHardNegatives는 26.79에서 35.96으로 오른다. 문서가 길고 hard negative가 까다로운 데이터셋일수록 문서를 큰 teacher로 인코딩하는 이득이 크다는 걸 다시 확인시킨다. 다만 Touche2020Retrieval.v3만은 asym(45.72)이 standard(51.58)보다 낮은 역방향인데, 이 데이터셋의 특이성이 여기서도 나타난다.
6.8 leaf-mt 강건성 마진 (Appendix G)
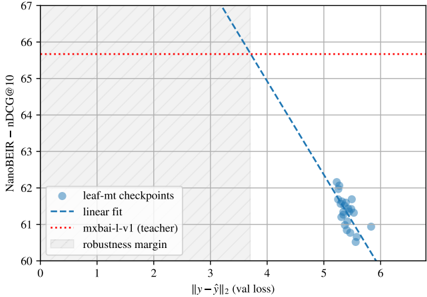
Figure 11: leaf-mt 학습 중 저장한 체크포인트들의 NanoBEIR 성능. leaf-ir과 마찬가지로 상당한 강건성 마진이 관찰된다. (원논문)
Figure 7의 leaf-mt 버전이다. 한 가지 차이는 teacher인 mxbai-l-v1이 정규화되지 않은 벡터를 출력하므로 근사 오차 에 2라는 상한이 없다는 점이다. 그래서 x축 오차가 5~6까지 분포한다. 그럼에도 패턴은 동일하다. 체크포인트들이 선형 추세를 따르고, 오차가 0에 도달하기 전에 teacher(빨간 점선) 성능과 만나는 강건성 마진(빗금 영역)이 존재한다. 정규화 여부와 무관하게 LEAF의 근사 스킴이 오차를 흡수한다는 걸 보여줘, 강건성 마진이 leaf-ir만의 우연이 아님을 뒷받침한다.
6.9 추론 속도 (Appendix H)
증류의 실질적 목표인 속도·비용을 정량화한다. AWS EC2 i3.large(2 vCPU, 15.25GB RAM, CPU 전용)에서 ONNX Runtime으로 측정했다. 검색·DB 워크로드에 흔히 쓰이는 저렴한 VM이다.
| model | docs/s | speedup | min latency | max N | queries/s | speedup | min latency | max N |
|---|---|---|---|---|---|---|---|---|
| arctic-embed-m-v1.5 | 3.2 ± 0.8 | 1× | 191 ± 52.6 ms | - | 16.7 ± 1.4 | 1× | 73.2 ± 5.8 ms | 1 |
| leaf-ir | 21.9 ± 5.5 | 6.5× | 28.2 ± 9.69 ms | 2 | 121.3 ± 14.0 | 7.3× | 11.4 ± 1.38 ms | 8 |
| mxbai-l-v1 | 0.9 ± 0.2 | 1× | 834 ± 298 ms | - | 4.9 ± 0.4 | 1× | 236 ± 18.5 ms | - |
| leaf-mt | 21.4 ± 5.8 | 24.4× | 39.2 ± 10.2 ms | 2 | 117.0 ± 15.9 | 23.7× | 11.5 ± 1.2 ms | 8 |
Table 9 (원논문): 모델별 성능 비교. max N은 100ms 이내에 처리 가능한 최대 배치 크기, '-'는 어떤 배치도 100ms 내 처리 불가.
leaf-ir의 4.7배 파라미터 감소가 문서 처리량 6.5배, 쿼리 처리량 7.3배로 이어진다. leaf-mt는 14.6배 감소가 문서 24.4배, 쿼리 23.7배 처리량 증가를 낳는다. 파라미터 압축률보다 처리량 향상이 더 큰 이유는, 작은 모델이 더 큰 배치를 메모리에 올릴 수 있고 CPU 캐시 효율도 좋기 때문으로 보인다.
max N 열이 실무적으로 특히 중요하다. Nielsen(1994)이 제시한 사용자 인지 반응 임계값 0.1초 안에 처리 가능한 최대 배치 크기인데, leaf 모델들만이 이 임계값 안에서 배치를 처리할 수 있다. teacher arctic-embed-m-v1.5는 쿼리 배치 1개(딱 한 건)만 겨우 되고 문서는 아예 불가('-')다. mxbai-l-v1은 쿼리·문서 모두 불가다. 반면 leaf 모델은 쿼리 배치 8개, 문서 배치 2개까지 0.1초 안에 처리한다.
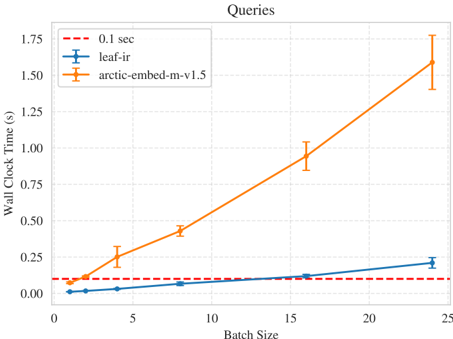
Figure 12: i3.large에서 배치 크기에 따른 leaf-ir과 teacher(arctic-embed-m-v1.5)의 쿼리 인코딩 벽시계 시간. 빨간 점선은 0.1초 임계값. (원논문)
추론 시간이 배치 크기에 거의 선형으로 증가하는데, teacher(주황)는 배치 4에서 이미 0.1초 선(빨간 점선)을 넘고 배치 24에서 1.5초를 넘어선다. 반면 leaf-ir(파랑)은 배치 8까지 0.1초 아래에 머문다. 사용자 체감 지연시간 관점에서 leaf 모델이 실서비스에 훨씬 적합하다는 걸 시각적으로 못 박는 그림이다.
6.10 절대 MRL 성능 (Appendix I)
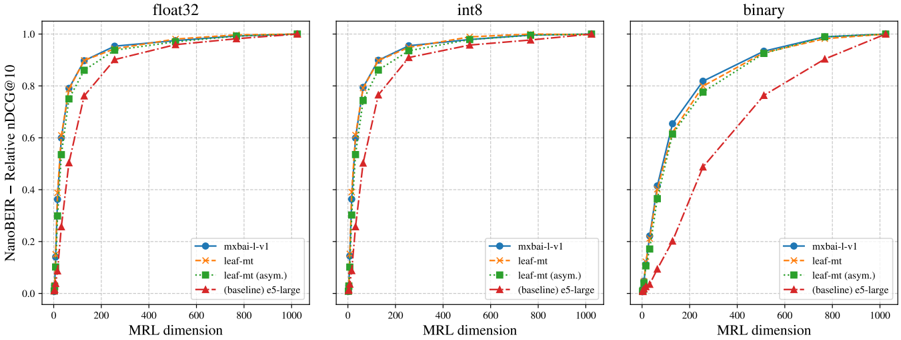
Figure 13: leaf-mt의 상대 MRL 성능. float32/int8/binary 양자화에서 mxbai-l-v1(teacher), leaf-mt, leaf-mt asym이 겹치고, baseline e5-large는 뒤처진다. (원논문)
Figure 6의 leaf-mt 버전이다. teacher(파랑), leaf-mt(주황), leaf-mt asym(초록)이 세 양자화 조건 모두에서 거의 겹치고, MRL로 학습되지 않은 e5-large(빨강)만 특히 저차원과 binary에서 크게 뒤처진다. leaf-mt도 leaf-ir처럼 teacher의 MRL·양자화 성질을 그대로 물려받았음을 보여준다.
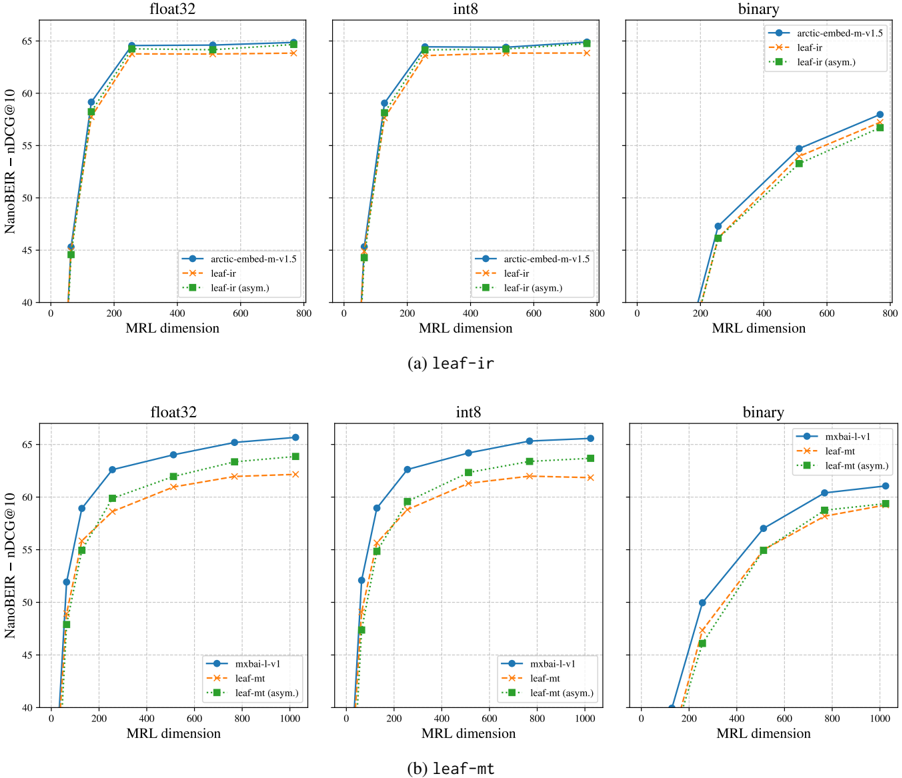
Figure 14: leaf-ir(위)과 leaf-mt(아래)의 절대 MRL 성능(NanoBEIR nDCG@10). float32/int8/binary별로 teacher, leaf, leaf asym을 비교. (원논문)
상대값이 아닌 절대 nDCG@10로 본 MRL 곡선이다. (a) leaf-ir을 보면 teacher(파랑)와 leaf-ir(주황), leaf-ir asym(초록)이 float32·int8에서 거의 붙어 있고, binary에서만 약간의 격차가 보인다. 흥미로운 건 leaf-ir asym(초록)이 저차원 구간에서 종종 standard보다 약간 높다는 점이다 - 문서를 teacher로 인코딩하는 이득이 저차원에서도 유지되는 것이다. (b) leaf-mt은 압축률이 커서 그런지 teacher(파랑)와의 격차가 leaf-ir보다 조금 더 벌어지지만, asym(초록)이 standard(주황)와 teacher 사이를 메우는 모습이 일관되게 나타난다. 비대칭 아키텍처가 MRL 절단 상황에서도 여전히 유효한 성능 보정 수단임을 보여준다.
7. 강점과 한계
강점
- 호환 가능한 증류라는 새로운 축: 기존 증류가 "작지만 독립적인 모델"을 만들었다면, LEAF는 "작으면서 teacher와 같은 공간을 쓰는 모델"을 만든다. 이게 비대칭 아키텍처를 처음으로 실용화한다. Figure 2의 구성으로 쿼리 인코딩 비용만 4.7~14.6배 줄이면서 검색 품질을 teacher의 97% 수준으로 유지할 수 있다(Table 1, 2).
- 극단적 단순함: 손실이 거리 하나다. 라벨·하드 네거티브·모델 내부 접근이 전부 불필요하고, black-box 모델도 증류 가능하며, 배치 32에 A100 한 장으로 학습된다. Table 4에서 보듯 더 복잡한 손실(MiniLM·TinyBERT 등)을 얹으면 오히려 성능이 떨어진다.
- 속성 자동 상속: Figure 6·13·14가 보여주듯 MRL과 양자화 강건성을 별도 학습 없이 물려받는다. teacher 공간을 근사하면 그 공간의 기하학적 성질까지 딸려온다는 걸 처음으로 명확히 보인 사례다.
- SOTA 달성과 공개: leaf-ir은 BEIR, leaf-mt는 MTEB v2에서 각각 동급 리더보드 1위다. 두 모델 모두 Apache 2.0으로 공개되고, 새로 만든 Vocabulary 데이터셋도 공개된다.
- 강건성 마진이라는 개념적 기여: Figure 7·11에서 근사 오차가 상당히 남아 있어도 다운스트림 성능은 teacher와 구별되지 않는다는 걸 보이고, 이를 강건성 마진으로 개념화했다. 왜 이 단순한 방법이 통하는지에 대한 설명을 제공한다.
한계 및 아쉬운 점
- 영어 전용: 저자들이 명시하듯 leaf-ir·leaf-mt는 영어로만 학습·평가됐다. 이런 소형 모델이 다국어(프로그래밍 언어 포함)를 수용할 수 있는지는 열린 질문이다. Table 7의 실패 사례가 다국어·전문 용어에 집중된 걸 보면, 다국어 확장 시 학습 데이터 커버리지가 관건이 될 것으로 보인다.
- 스케일링 미검증: 23M student만 다뤘다. 더 큰 student를 같은 방식으로 효과적으로 만들 수 있는지, 압축률을 더 낮추면(예: 100M teacher → 50M student) 어떤 트레이드오프가 생기는지에 대한 실험이 없다.
- 디코더·아키텍처 일반성: 최근 임베딩 모델은 인코더 대신 디코더를 많이 쓰는데, LEAF가 디코더 teacher/student에도 그대로 적용되는지는 미확인이다. black-box 적용 가능성을 강조하면서도 실제 실험은 인코더 teacher(arctic, mxbai) 두 개에 국한된다.
- 반직관적 결과의 미해명: Table 4에서 내부 표현을 활용하는 손실이 오히려 성능을 떨어뜨리는 현상을 저자 스스로 "counterintuitive"라 부르며 설명을 미뤘다. 왜 더 많은 정보가 해가 되는지에 대한 메커니즘 분석이 있었다면 논문의 통찰이 한층 깊어졌을 것이다.
- 강건성 마진의 정성적 성격: 강건성 마진은 매력적인 개념이지만, 그 경계(어느 오차까지가 마진인가)가 선형 추세 외삽과 빗금 영역으로 시각적·정성적으로만 제시된다. 이론적으로 마진의 폭을 예측하거나, teacher 공간의 어떤 성질이 마진을 넓히는지에 대한 정량적 분석은 없다.
- teacher 선택의 영향 미분석: leaf-ir/leaf-mt 각각 teacher가 하나씩 고정돼 있어, teacher 품질이나 구조가 최종 student 성능에 어떻게 영향을 주는지 통제된 비교가 없다. "좋은 teacher일수록 좋은 student"인지, 아니면 특정 teacher 성질이 증류 난이도를 좌우하는지가 궁금하지만 답이 없다.
8. 마치며
LEAF는 임베딩 증류를 "함수 근사" 문제로 다시 정의함으로써, 그동안 당연시돼온 두 가지 전제를 흔든다. 하나는 "작은 모델은 대조 학습으로 처음부터 잘 만들어야 한다"는 전제이고, 다른 하나는 "서로 다른 모델은 임베딩 공간이 호환되지 않는다"는 전제다. teacher 공간을 로 근사하기만 하면 작은 모델이 오히려 더 잘 만들어지고, 그렇게 만든 모델은 teacher와 공간을 공유해 비대칭 검색을 가능하게 한다.
실무 관점에서 가장 매력적인 건 비대칭 아키텍처다. 이미 큰 임베딩 모델로 문서를 색인해둔 시스템이라면, 재색인 없이 쿼리 인코더만 leaf로 교체해 실시간 비용과 지연시간을 극적으로 줄일 수 있다. Table 9의 max N 결과 - leaf만이 0.1초 임계값 안에서 배치를 처리한다 - 는 이게 단순한 벤치마크 숫자가 아니라 사용자 체감으로 이어지는 차이임을 보여준다. Apache 2.0 공개라 도입 장벽도 낮다.
방법론적으로는 "덜어내는 것이 더하는 것"이라는 메시지가 오래 남는다. 라벨·하드 네거티브·모델 내부·복잡한 손실 항을 전부 걷어냈더니 SOTA가 나왔고, 오히려 정보를 더한 손실들은 성능을 떨어뜨렸다(Table 4). MRL·양자화 강건성처럼 애써 학습해야 할 것 같던 속성들이 공간을 근사하는 과정에서 공짜로 딸려왔다. 강건성 마진이라는 개념은 이 모든 게 왜 작동하는지에 대한 설득력 있는 설명을 제공한다.
물론 영어 전용, 스케일링 미검증, 디코더 미적용 같은 한계가 남아 있고, 반직관적 결과의 메커니즘도 아직 열려 있다. 그럼에도 "호환 가능한 증류"라는 방향 자체가 임베딩 모델 배포의 경제학을 다시 생각하게 만든다는 점에서, 후속 연구와 실무 양쪽에 참고할 지점이 많은 논문이다.
References
- Vujanic & Rückstieß, 2026. "LEAF: Knowledge Distillation of Text Embedding Models with Teacher-Aligned Representations." (본 논문, ACL 2026, arXiv:2509.12539)
- Campos et al., 2023. "Quick dense retrievers consume kale: Post training KL alignment of embeddings for asymmetrical dual encoders."
- Yoon & Arik, 2025. (임베딩 변환 MLP 네트워크)
- Reimers & Gurevych, 2020. "Making monolingual sentence embeddings multilingual using knowledge distillation."
- Wang et al., 2020. "MiniLM: Deep self-attention distillation for task-agnostic compression of pre-trained transformers."
- Jiao et al., 2020. "TinyBERT: Distilling BERT for natural language understanding."
- Sanh et al., 2020. "DistilBERT, a distilled version of BERT."
- Hofstätter et al., 2020. "Improving efficient neural ranking models with cross-architecture knowledge distillation." (Margin MSE)
- Formal et al., 2021. "SPLADE: Sparse Lexical and Expansion Model for First Stage Ranking."
- Santhanam et al., 2022. "ColBERTv2: Effective and efficient retrieval via lightweight late interaction."
- Merrick et al., 2024. "Arctic-Embed." (teacher: arctic-embed-m-v1.5, arctic-embed-xs)
- Kusupati et al., 2022. "Matryoshka Representation Learning." (MRL)
- Thakur et al., 2021. "BEIR: A heterogeneous benchmark for zero-shot evaluation of information retrieval models."
- Enevoldsen et al., 2025. "MMTEB: Massive Multilingual Text Embedding Benchmark." (MTEB v2)
- Chen et al., 2024. "M3-Embedding: Multi-linguality, multi-functionality, multi-granularity text embeddings through self-knowledge distillation."