논문 리뷰
논문 리뷰: Beyond Single Representations: Multi-Model Embedding Fusion for Stable Text Classification
여러 LLM에서 뽑은 임베딩을 어느 층에서, 어떻게 합칠 것인가를 6개 데이터셋에 걸쳐 실증적으로 파헤치고, 다중 모델 융합이 층·풀링 선택의 민감도를 줄여 특히 저자원 환경에서 안정적인 텍스트 분류를 만든다는 것을 보인 연구.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Beyond Single Representations: Multi-Model Embedding Fusion for Stable Text Classification |
| 저자 | Jiho Gwak, Yuchul Jung (교신저자) - Kumoh National Institute of Technology, South Korea |
| 학회/저널 | ACL 2026 (Long Paper) |
| 논문 링크 | aclanthology.org/2026.acl-long.1786 |
1. 들어가며
LLM을 임베딩 추출기로 쓰는 흐름은 이제 낯설지 않다. 생성 모델이든 임베딩 전용 모델이든, 마지막 층(final layer)의 hidden state를 뽑아 문장 벡터로 삼고 그 위에 분류기를 얹는 방식이 광범위하게 쓰인다. 그런데 여기에는 두 가지 관행적 가정이 깔려 있다. 하나는 "마지막 층이 가장 좋은 표현을 준다"는 것이고, 다른 하나는 "모델 하나면 충분하다"는 것이다.
두 가정 모두 그렇게 견고하지 않다. 디코더 기반 LLM은 근본적으로 다음 토큰 예측(next-token prediction)을 위해 학습되기 때문에, 층이 깊어질수록 표현이 "생성"에 특화되어 간다. 분류에 필요한 판별적(discriminative) 정보는 오히려 중간 층에 더 풍부하게 남아 있을 수 있다는 관찰이 인코더 계열(BERT)에서 먼저 보고되었고, 최근에는 디코더 LLM에서도 비슷한 정황이 제기되어 왔다. 그렇다면 어느 층을 골라야 하는가? 풀링(pooling)은 어떻게 해야 하는가? 서로 다른 모델의 임베딩을 합치면 정말 이득이 있는가? 이런 질문들이 산발적으로만 다뤄져 왔을 뿐, 하나의 통일된 실험 설정 아래 체계적으로 비교된 적은 드물었다.
이 논문은 바로 그 빈틈을 겨냥한다. 새로운 융합 기법을 제안하는 방법론 논문이라기보다는, "층 선택 × 풀링 전략 × 다중 모델 융합"이라는 세 축을 하나의 프레임 안에서 철저히 실증 분석하는 성격이 강하다. 생성 모델 4종(Llama3.2, Phi-4, Qwen3, Gemma3)과 임베딩 전용 모델 3종(e5-large-v2, NV-Embed-v2, Qwen3-Embedding), 그리고 감성·주제·법률에 걸친 6개 데이터셋을 교차시켜, 개별 층의 효용이 실제로 얼마나 되는지, 그리고 여러 모델을 합쳤을 때 무엇이 달라지는지를 수치로 보여준다.
결론부터 말하면 이 논문의 메시지는 두 문장으로 압축된다. 첫째, 최적 층이 어디인가는 모델 구조보다 데이터셋 특성에 더 크게 좌우된다. 둘째, 단일 층·단일 모델의 성능은 들쭉날쭉하지만, 여러 모델을 융합하면 그 변동성이 눌리면서 특히 학습 데이터가 부족한 상황에서 큰 이득을 본다. 화려한 SOTA 경신은 아니지만, 실무자가 "임베딩을 어떻게 뽑고 합쳐야 안정적인가"라는 질문에 답을 찾을 때 참고할 만한 실증 지도를 그려준 셈이다.
2. 기존 연구의 한계
2.1 텍스트 분류와 사전학습 언어 모델
텍스트 분류는 TF-IDF, n-gram 같은 통계적 표현에 SVM(Pang et al., 2002)이나 로지스틱 회귀(Zhang et al., 2003)를 얹는 방식에서 출발했다. 판을 바꾼 것은 사전학습 언어 모델이다. BERT(Devlin et al., 2019)와 RoBERTa(Liu et al., 2019)가 양방향 구조와 대규모 사전학습으로 풍부한 문맥 정보를 담아내면서, 다운스트림 태스크에 파인튜닝했을 때 전통적 방법을 일관되게 앞섰다. 이 시기의 표준은 "인코더 모델을 파인튜닝한다"였다.
2.2 LLM의 확장된 활용
디코더 기반 LLM이 등장하면서 제로샷(Kojima et al., 2023)·퓨샷(Zhang et al., 2022) 분류가 가능해졌고, chain-of-thought(Wei et al., 2023)나 CARP(Sun et al., 2023) 같은 프롬프트 기반 접근이 쏟아졌다. GPT-3, LLaMA 계열의 분류 성능을 다룬 실증 연구도 많다. 다만 이 계열은 프롬프트 설계에 따라 성능 변동이 크다는 약점이 반복적으로 지적되어 왔다(Cao et al., 2024; He et al., 2024). 같은 태스크라도 프롬프트를 조금 바꾸면 결과가 출렁이는 것이다.
그래서 최근에는 LLM을 "생성기"가 아니라 "고품질 임베딩 제공자"로 쓰려는 관심이 커졌다(Tao et al., 2025). 7B 이하의 비교적 가벼운 LLM도 효율적인 자원으로 강력한 임베딩 품질을 낼 수 있다는 보고가 이어졌고(Wang et al., 2024; Lee et al., 2025), 특히 모델 내부의 서로 다른 층이 태스크마다 최적의 표현을 낸다는 점, 즉 층 선택(layer selection)의 중요성이 부각되었다(Zhang et al., 2024; Skean et al., 2024). 트랜스포머의 중간 표현이 생각보다 중요하다는 시각이다.
2.3 임베딩 융합
여러 모델에서 뽑은 임베딩을 결합하려는 시도도 꾸준했다(Shinnou et al., 2018; Blandfort et al., 2019). 대표적으로 LLMEmbed(Liu et al., 2024)는 LLaMA2의 임베딩을 BERT·RoBERTa의 임베딩과 결합해 각 모델의 고유한 표현 특성을 효과적으로 활용할 수 있음을 보였다. NLP 바깥에서도 QUARC(Kumar et al., 2020)처럼 쿼터니언(quaternion) 연산을 쓰는 융합이 제안되었다.
문제는 여기서부터다. 어떤 융합 방식을 쓰느냐에 따라 성능 차이가 크게 벌어지고, 모든 조합이 일관된 개선으로 이어지지도 않는다(Ko et al., 2024). 게다가 각 임베딩 층이 서로 다른 표현 능력을 지니므로, 층별 특성을 이해하는 것이 효과적인 융합의 전제 조건이라는 지적도 나왔다(Kaushik et al., 2024). 다시 말해 "층을 어떻게 고르느냐"와 "모델을 어떻게 합치느냐"가 얽혀 있는데, 이 둘을 함께 통제하며 비교한 연구가 부족했다. 이 논문이 파고드는 지점이 바로 여기다.
3. 핵심 아이디어
이 논문의 출발점은 단순한 관찰이다. 단일 층에서 뽑은 하나의 임베딩은 성능이 안정적이지 않다. 어떤 데이터셋에서는 14번째 층이 최고인데 다른 데이터셋에서는 마지막 층이 최고이고, 같은 모델이라도 태스크가 바뀌면 최적 층이 널뛴다. 그런데 실무에서 데이터셋마다 최적 층을 일일이 찾아 고정하는 건 현실적으로 어렵다. 최적 층은 사전에 알 수 없기 때문이다.
저자들의 통찰은 이 불확실성을 개별 층을 더 잘 고르는 방향이 아니라 여러 모델을 섞는 방향으로 흡수하자는 데 있다. 서로 다른 표현 공간(representational space)을 가진 모델들을 융합하면, 특정 층이나 특정 모델의 약점이 다른 모델에 의해 상쇄된다. 융합에 참여하는 모델 수가 늘어날수록 어느 한 모델의 영향력은 희석되고, 결과적으로 성능의 하한(lower bound)이 끌어올려진다. 최고 성능을 극적으로 높이는 게 아니라 최악의 경우를 방어하는 전략인 셈이다.
이 안정화 효과가 가장 극적으로 드러나는 곳이 저자원(low-resource) 환경이다. 학습 데이터가 200개뿐인 LegalBench 같은 데이터셋에서는 단일 모델의 F1이 심하게 요동치는데, 다중 모델 융합이 이 변동을 크게 눌러준다. 기존 임베딩 융합 연구가 주로 "성능이 오르더라"에 초점을 맞췄다면, 이 논문은 "왜, 어디서, 얼마나 안정적으로 오르는가"를 층·풀링·모델 수라는 세 변수를 통제하며 정량화한 것이 차별점이다.
4. 제안 방법 (Method)
4.1 전체 구조
이 연구는 임베딩 기반 텍스트 분류를 세 가지 상보적 관점에서 조사한다. 첫째는 층별 표현 분석이다. LLM의 층마다 표현이 다르다는 기존 보고가 텍스트 분류에서도, 그리고 임베딩 전용 모델에서도 똑같이 관찰되는지 검증한다. 둘째는 안정성 분석이다. 층에 따라 성능이 얼마나 불안정한지 확인하고, 이 한계를 다중 모델 융합으로 완화할 수 있음을 보인다. 셋째는 저자원 환경에서의 효용이다. 라벨 데이터가 부족할 때 융합된 표현이 유의미한 성능 향상을 주는지 분석한다. 실험에는 최대 14B 규모의 생성 LLM과 임베딩 전용 모델이 함께 쓰인다.
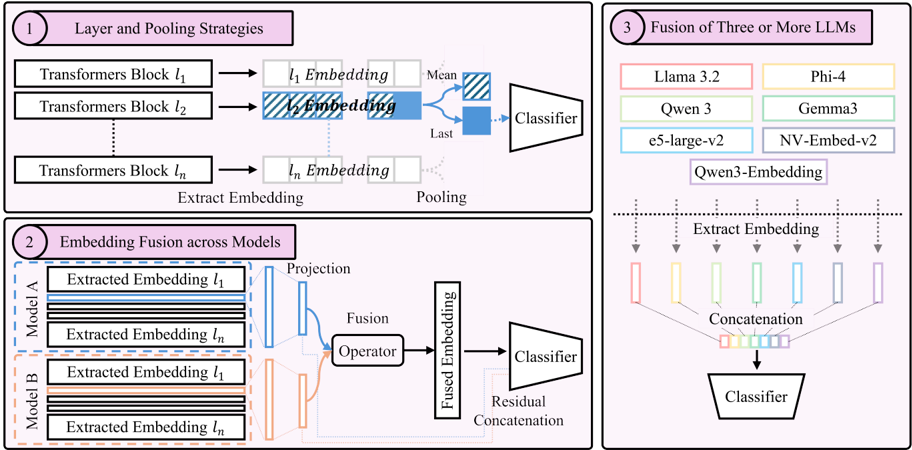
Figure 1: 임베딩 융합 평가를 위한 실험 설계 개요. l_n은 각 모델의 n번째 트랜스포머 블록 층을 뜻하며, n은 마지막 층을 가리킨다. (원논문)
Figure 1이 전체 파이프라인을 세 블록으로 나눠 보여준다. (1) Layer and Pooling Strategies(좌상단)는 하나의 모델 안에서 모든 트랜스포머 블록()의 임베딩을 각각 뽑은 뒤, mean 풀링과 last 풀링을 적용해 분류기로 평가하는 과정이다. 층별·풀링별 민감도를 측정하는 단계다. (2) Embedding Fusion across Models(좌하단)는 서로 다른 두 모델(Model A, Model B)의 임베딩을 공통 차원 공간으로 선형 사영(projection)한 뒤, 사전에 정의한 연산자(concatenation, sum, convolution 등)로 융합해 단일 표현을 만든다. 잔차 연결(residual concatenation)도 옵션으로 들어간다. (3) Fusion of Three or More LLMs(우측)는 7개 모델(Llama 3.2, Phi-4, Qwen 3, Gemma3, e5-large-v2, NV-Embed-v2, Qwen3-Embedding)의 임베딩을 모두 뽑아 concatenation으로 이어붙이고 분류기에 넣는 구성이다.
세 블록의 순서가 곧 논문의 논증 흐름이다. 먼저 단일 모델에서 층·풀링이 얼마나 불안정한지 드러내고(블록 1), 그 불안정을 두 모델 융합으로 완화한 뒤(블록 2), 세 개 이상으로 확장했을 때의 안정성-비용 트레이드오프(블록 3)까지 밀고 나간다.
실험에 쓰인 데이터셋과 모델 사양은 아래와 같다.
| Dataset | Classes | Train | Test |
|---|---|---|---|
| SST-2 | 2 | 67,349 | 872 |
| R8 | 8 | 5,485 | 2,189 |
| MR | 2 | 40,000 | 10,000 |
| R52 | 52 | 6,532 | 2,568 |
| LegalBench | 3 | 200 | 50 |
| Rotten Tomatoes | 2 | 8,530 | 1,066 |
Table 1-상단 (원논문): 데이터셋 통계. SST-2·MR·Rotten Tomatoes는 감성 분류, R8·R52는 주제 분류, LegalBench는 법률 도메인. LegalBench는 공식 가이드라인에 따라 8:2로 분할했고 나머지는 원래 분할을 사용.
| Model Type | Model | Dim | Layers | Params |
|---|---|---|---|---|
| Generation | llama3.2 | 4096 | 28 | 3B |
| qwen3 | 4096 | 36 | 8B | |
| gemma3 | 2304 | 48 | 12B | |
| phi4 | 3584 | 40 | 14.7B | |
| Embedding | e5-large-v2 | 1024 | 24 | 0.335B |
| nv-embed-v2 | 4096 | 32 | 7.1B | |
| qwen3-embedding | 4096 | 24 | 8B |
Table 1-하단 (원논문): 생성 모델과 임베딩 모델의 사양. 임베딩 차원(Dim), 층 수(Layers), 파라미터 규모(Params).
데이터셋 구성이 이 논문을 읽는 열쇠다. SST-2(67,349개)나 MR(40,000개)처럼 학습 데이터가 넉넉한 것부터 LegalBench(200개)처럼 극단적으로 적은 것까지 스펙트럼이 넓다. R52는 클래스가 52개나 되어 클래스 불균형과 저빈도 클래스 문제가 심하다. 이 다양성이 뒤에서 "융합이 저자원·다클래스에서 특히 강하다"는 주장을 뒷받침하는 토대가 된다. 모델 쪽도 3B(llama3.2)부터 14.7B(phi4)까지, 그리고 0.335B(e5-large-v2)라는 경량 임베딩 모델까지 규모가 다양해서 "성능이 단순히 모델 크기로 결정되지 않는다"는 관찰을 가능하게 한다.
분류기는 융합된 임베딩 벡터를 입력으로 받는 MLP(multilayer perceptron)이며, 학습은 batch size=1024, learning rate=1e-4, Adam 옵티마이저, 120 epoch로 수행되었다. 실험 환경은 NVIDIA RTX 4090(24GB) 2장이다. 백본 모델 자체는 파인튜닝하지 않고 임베딩만 뽑아 쓴다는 점이 중요하다 - 이 논문이 측정하는 것은 어디까지나 표현(representation)의 품질과 융합의 효과이지, 모델 재학습의 효과가 아니다.
4.2 층과 풀링 전략 (Layer and Pooling Strategies)
층별 표현(Layer-wise Representation). 디코더 기반 LLM은 층마다 담아내는 의미·문맥 정보가 다르다는 것이 선행 연구의 관찰이다. 저자들은 이 현상이 (a) 서로 다른 아키텍처의 생성 LLM에서, 그리고 (b) 표현 학습에 명시적으로 최적화된 임베딩 모델에서도 똑같이 나타나는지 확인하려 한다. 이를 위해 각 텍스트 데이터셋에 대해 모든 층에서 뽑은 임베딩을 체계적으로 평가한다. 즉 llama3.2라면 0층부터 28층까지, gemma3라면 48층까지 전부 훑어 층별 판별력을 정량화하는 것이다.
풀링(Pooling). 다음으로 풀링 전략이 층 선택과 어떻게 상호작용하는지 본다. 임베딩 전용 모델은 풀링 방식이 명시되어 있지만(Tang and Yang, 2024), 생성 모델은 임베딩을 뽑을 때 풀링을 따로 고려하지 않으므로 적절한 풀링 선택이 중요해진다. 여기서 비교하는 두 방식은 다음과 같다.
- last 풀링: 시퀀스의 마지막 토큰 위치의 표현을 그대로 사용
- mean 풀링: 시퀀스 전체의 hidden state를 평균
주의할 점은 여기서 말하는 "last"가 마지막 층이 아니라 마지막 토큰 위치라는 것이다. 저자들은 각 모델·데이터셋에 대해 풀링의 영향이 같은 모델 안에서 데이터셋을 넘나들며 일관적인지, 성능 차이가 얼마나 벌어지는지를 분석한다.
4.3 모델 간 임베딩 융합 (Embedding Fusion across Models)
차원 사영(Dimension Projection). 서로 다른 모델의 임베딩은 차원이 제각각이다(예: e5-large-v2는 1024, nv-embed-v2는 4096). 그래서 융합 전에 선형 사영으로 차원을 통일한다. 임베딩 을 목표 차원 로 사영할 때 학습 가능한 가중치 행렬 와 바이어스 를 쓴다.
의 선택에는 트레이드오프가 있다. 큰 차원은 정보를 더 보존하지만 연산 비용이 늘고, 작은 차원은 비용을 줄이는 대신 정보 손실 위험이 있다. 이 논문은 효율을 위해 더 작은 차원으로 사영하는 쪽을 택했다.
융합 방법(Fusion Methods). 융합은 서로 다른 LLM에서 뽑은 임베딩을 결합해 표현력을 높이는 과정이다. 층별 분석은 앞 절에서 다뤘으므로, 여기서는 모델 간 일관성을 확보하고 융합 전략 자체의 효과만 분리하기 위해 임베딩을 마지막 층으로 고정한다. 융합을 하나의 사상(mapping)으로 정의하면 다음과 같다.
여기서 는 서로 다른 모델에서 뽑은 임베딩이고 는 융합 결과다. 의 구체적 형태로 다음을 탐색한다.
Concatenation - 임베딩 벡터를 차원 방향으로 그대로 이어붙여 하나의 벡터를 만든다. 정보를 손실 없이 모두 보존하는 가장 단순한 방식이다.
Sum - 차원을 맞춘 뒤 원소별 덧셈으로 새 임베딩을 만든다.
Multiplication - 임베딩을 크기의 2차원 배열로 reshape한 뒤(따라서 는 완전제곱수여야 한다) 행렬 곱으로 결합한다.
Hadamard (원소별 곱) - 같은 위치의 원소끼리 곱해 결합한다.
Quaternion Fusion (Kumar et al., 2020) - 임베딩을 쿼터니언 값 벡터로 취급하고 쿼터니언 연산으로 융합해 모델 간 다차원 관계를 보존한다.
Residually Enhanced Fusion (Gardias et al., 2020) - 새로 만든 임베딩을 잔차 연결로 원본과 다시 결합해, 원래 표현력을 유지하면서 추가 정보를 얹는다. Figure 3에서 각 융합 기법 뒤에 붙는 (R) 표기가 이 잔차 버전을 뜻한다.
정리하면 Concatenation·Sum·Multiplication·Hadamard·Quaternion 다섯 계열에, 각각의 잔차 버전을 더해 Figure 3에서 C, S, S_R, Q, Q_R, M, M_R, H, H_R의 아홉 가지 조합이 만들어진다.
층 인식 융합(Layer-Aware Fusion). 마지막으로, 데이터셋별 최적 층에서 뽑은 임베딩을 융합하면 성능이 더 오르는지를 조사한다. 각 데이터셋에 대해 4.2절의 방법으로 가장 효과적인 층을 먼저 찾고, 그 층의 임베딩으로 단일/다중 모델 융합을 수행한 뒤, 기본 층이나 마지막 층을 쓴 베이스라인과 비교한다. 백본을 파인튜닝하지 않고도 데이터셋에 맞춰 층을 고르는 것만으로 정확도와 안정성을 끌어올릴 수 있는지를 보는 분석이다.
4.4 세 개 이상 모델의 융합 (Fusion of Three or More LLMs)
앞 절들이 두 모델 결합에 집중했다면, 이 절은 세 개 이상으로 확장한다. 성능·안정성뿐 아니라 융합 집합이 커질 때 늘어나는 비용, 주로 임베딩 추출 시간(embedding extraction time)까지 함께 따진다. 모델을 더 넣는 이득이 비용을 정당화하는지 보려는 것이다.
여러 모델을 합치는 동기는 상보적 강점(complementary strengths)을 활용하기 위함이다. 특히 세 개 이상을 합쳤을 때 성능이 오르고 분산이 줄어 더 안정적인 결과로 이어지는지를 검증한다. 이 실험의 융합 방법은 주로 concatenation이며, 가능한 모든 조합을 테스트한다. 외부 변동 요인을 줄이기 위해 임베딩은 마지막 층으로 고정하고 mean 풀링을 모든 모델에 일관되게 적용한다.
5. 실험 결과
5.1 층 전략에 따른 결과 (Results by Layer Strategies)
층별 표현. 중간 층의 임베딩이 마지막 층보다 강한 표현력을 보이는 경우가 많다는 것이 선행 연구의 주장이었다. 생성 모델이 마지막 층으로 갈수록 텍스트 생성에 특화된다는 관찰을 근거로, 저자들은 이 패턴이 여러 층·모델에 걸쳐 일관되게 유지되는지 정밀 평가했다.
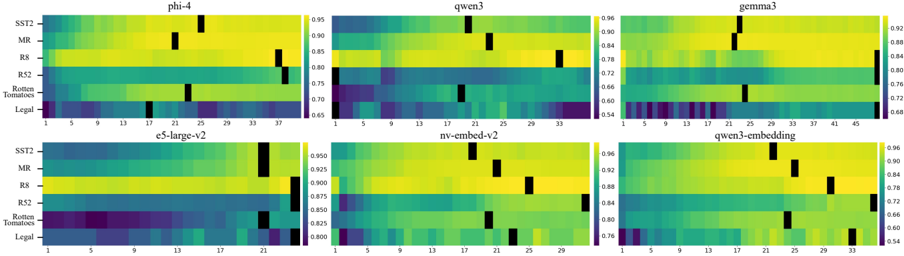
Figure 2: LLM들의 단일 층 임베딩 분류 성능 비교. 각 히트맵에서 세로축은 데이터셋(SST2, MR, R8, R52, Rotten Tomatoes, Legal), 가로축은 층 인덱스, 색은 성능(밝을수록 높음)이며 검은 셀이 최고 성능 층을 표시한다. (원논문)
Figure 2는 6개 모델(phi-4, qwen3, gemma3 / e5-large-v2, nv-embed-v2, qwen3-embedding)에 대해 층×데이터셋 성능을 히트맵으로 펼쳐 보인다. 여기서 읽히는 그림은 "최적 층은 한 군데로 수렴하지 않는다"는 것이다. 어떤 경우엔 중간 층이 최고지만, 그 위치가 데이터셋마다 검은 셀의 자리를 옮겨 다닌다. 예컨대 Gemma3는 생성 모델임에도 세 개 데이터셋에서 마지막 층이 최고였고, 반대로 Qwen3는 무려 0번째 층이 두 데이터셋에서 최고 정확도를 냈다. 표현 학습에 특화된 임베딩 모델조차 마지막 층이 항상 우월하지는 않았다. 층별 우열이 "모델의 성질"보다 "데이터셋의 성질"에 더 끌려간다는 논문의 첫 주장이 이 히트맵에서 시각적으로 확인된다.
정확한 수치는 Table 2에 담겨 있다. 각 모델에 대해 마지막 층(5회 평균)과 최고 층(5회 중 최고)의 정확도·F1을 데이터셋별로 비교한 것이다. 표가 담는 정보량이 많아 정확도와 F1을 나눠 정리한다. 셀은 마지막 층 → 최고 층 (최고 층 인덱스) 형식이다.
| Model | SST2 | MR | R8 | R52 | Rotten Tomatoes | LegalBench |
|---|---|---|---|---|---|---|
| llama3.2 | 0.911 → 0.950 (14) | 0.957 → 0.965 (14) | 0.975 → 0.979 (24) | 0.902 → 0.924 (26) | 0.895 → 0.910 (13) | 0.836 → 0.920 (0) |
| phi4 | 0.944 → 0.954 (25) | 0.960 → 0.966 (21) | 0.978 → 0.980 (39) | 0.908 → 0.933 (30) | 0.909 → 0.923 (21) | 0.860 → 0.960 (19) |
| qwen3 | 0.943 → 0.951 (24) | 0.958 → 0.965 (22) | 0.967 → 0.975 (32) | 0.858 → 0.896 (0) | 0.911 → 0.919 (25) | 0.780 → 0.920 (0) |
| gemma3 | 0.953 → 0.964 (23) | 0.959 → 0.967 (21) | 0.976 → 0.978 (48) | 0.920 → 0.922 (48) | 0.923 → 0.926 (26) | 0.888 → 0.900 (48) |
| e5-large-v2 | 0.945 → 0.953 (21) | 0.953 → 0.956 (21) | 0.973 → 0.974 (24) | 0.895 → 0.896 (24) | 0.891 → 0.894 (21) | 0.916 → 0.920 (24) |
| nv-embed-v2 | 0.955 → 0.969 (17) | 0.967 → 0.972 (20) | 0.983 → 0.984 (25) | 0.951 → 0.953 (31) | 0.922 → 0.935 (19) | 0.940 → 0.960 (22) |
| qwen3-embedding | 0.949 → 0.964 (22) | 0.964 → 0.972 (25) | 0.982 → 0.983 (30) | 0.950 → 0.952 (36) | 0.906 → 0.922 (24) | 0.920 → 0.960 (33) |
Table 2-(a) (원논문): 정확도(Accuracy) - 마지막 층 → 최고 층 (괄호는 최고 층 인덱스).
| Model | SST2 | MR | R8 | R52 | Rotten Tomatoes | LegalBench |
|---|---|---|---|---|---|---|
| llama3.2 | 0.911 → 0.950 (14) | 0.957 → 0.965 (14) | 0.925 → 0.941 (24) | 0.366 → 0.485 (26) | 0.895 → 0.910 (13) | 0.575 → 0.833 (15) |
| phi4 | 0.944 → 0.954 (25) | 0.960 → 0.966 (21) | 0.938 → 0.943 (13) | 0.406 → 0.583 (30) | 0.909 → 0.923 (21) | 0.592 → 0.912 (19) |
| qwen3 | 0.943 → 0.951 (24) | 0.958 → 0.965 (22) | 0.867 → 0.916 (30) | 0.196 → 0.389 (0) | 0.911 → 0.919 (25) | 0.535 → 0.634 (24) |
| gemma3 | 0.953 → 0.964 (23) | 0.959 → 0.967 (21) | 0.927 → 0.931 (48) | 0.480 → 0.492 (48) | 0.923 → 0.926 (26) | 0.764 → 0.778 (48) |
| e5-large-v2 | 0.945 → 0.953 (21) | 0.953 → 0.956 (21) | 0.922 → 0.931 (24) | 0.357 → 0.365 (24) | 0.891 → 0.894 (21) | 0.629 → 0.632 (24) |
| nv-embed-v2 | 0.955 → 0.969 (17) | 0.967 → 0.972 (20) | 0.954 → 0.958 (22) | 0.667 → 0.681 (31) | 0.922 → 0.925 (19) | 0.896 → 0.912 (22) |
| qwen3-embedding | 0.949 → 0.964 (22) | 0.964 → 0.972 (25) | 0.946 → 0.952 (31) | 0.664 → 0.699 (36) | 0.906 → 0.922 (24) | 0.884 → 0.911 (33) |
Table 2-(b) (원논문): F1-score - 마지막 층 → 최고 층 (괄호는 최고 층 인덱스). 마지막 층 결과는 5회 평균, 최고 층 결과는 5회 중 최고값.
이 두 표가 말하는 핵심은 논문의 표현대로 "최적 층을 고르는 것만으로 정확도가 최대 4%, F1이 최대 20%까지 올랐다"는 것이다. 그런데 그 개선의 분포가 흥미롭다. 정확도가 이미 포화된 SST2·MR 같은 데이터셋에서는 최고 층으로 바꿔봐야 1%p 안팎의 미미한 차이다. 반면 클래스가 많고 불균형이 심한 R52, 데이터가 극히 적은 LegalBench에서는 F1의 도약이 크다. qwen3의 R52 F1은 0.196에서 0.389로 두 배 가까이 뛰고, phi4의 LegalBench F1은 0.592에서 0.912로 무려 32%p 벌어진다. 정확도(다수 클래스에 유리)는 크게 안 변하는데 F1(소수 클래스 반영)이 폭등한다는 건, 마지막 층이 저빈도 클래스를 특히 못 잡고 있었다는 뜻이다. 층 선택이 클래스 불균형 상황에서 더 결정적으로 작동한다.
한편 이 결과는 양날의 검이기도 하다. "최고 층"은 어디까지나 사후적으로 5회 실행 중 가장 좋았던 값을 고른 것이라, 실전에서 그 층을 미리 알 수 없다는 한계가 그대로 남는다. 최적 층 인덱스가 llama3.2 LegalBench의 0번부터 gemma3 R8의 48번까지 사방으로 흩어져 있다는 사실 자체가, 단일 층 선택 전략의 실용성을 스스로 반박한다. 바로 이 딜레마가 다중 모델 융합으로 넘어가는 동기가 된다.
풀링. 풀링 전략의 결과는 Figure 4에 정리되어 있다.
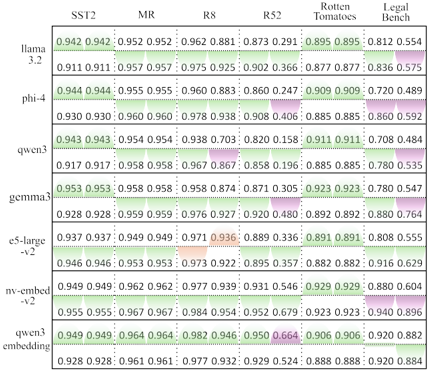
Figure 4: 모델·데이터셋별 풀링 전략에 따른 성능 차이. 각 셀은 2×2 블록으로 위쪽이 last 풀링(acc, F1), 아래쪽이 mean 풀링(acc, F1)이다. 초록색은 더 높은 성능을 낸 풀링, 보라색은 두 풀링 간 성능 격차가 6%를 넘는 경우, 주황색은 F1과 정확도의 추세가 엇갈리는 특이 사례를 표시한다. (원논문)
여기서 last는 마지막 층이 아니라 시퀀스의 마지막 토큰 위치를 뜻한다는 점을 다시 짚어둔다. 공정한 비교를 위해 모든 실험은 마지막 층 표현을 쓰고 풀링만 바꿨다. 평균적으로 두 풀링 사이에 1% 이상의 성능 차이가 났고, LegalBench에서는 그 격차가 20%를 넘겼다. 가장 눈에 띄는 발견은 생성 모델의 분포적 특성이다. 네 개 생성 모델은 아키텍처가 다름에도 모델별로 일관된 풀링 선호를 보이지 않았다. 대신 풀링의 효과가 모델을 가로지르기보다 데이터셋을 가로질러 일반화되는 경향을 보였다. 즉 "이 모델은 mean이 좋다"가 아니라 "이 데이터셋은 mean이 좋다"에 가깝다. 반면 임베딩 전용 모델은 모델 유형에 걸쳐 일관된 거동을 보였다. 풀링이 명시적으로 설계된 모델답게 예측 가능하게 움직인 것이다. 이 대비는 앞선 층 분석의 결론("최적 층은 모델보다 데이터셋에 좌우된다")과 정확히 같은 방향을 가리킨다 - 생성 LLM에서 표현을 뽑는 선택(층이든 풀링이든)은 데이터셋 의존적이며, 그래서 사전에 최적을 고정하기 어렵다.
5.2 융합 전략 실험 (Fusion Strategy Experiments)
이제 두 모델의 임베딩을 다양한 방식으로 융합한 결과다. 각 융합 임베딩의 성능 증감은 두 개별 모델의 단일 층 임베딩 중 더 높은 F1과 비교해 측정했다. 즉 "더 나은 쪽 모델보다 융합이 나은가"라는 엄격한 기준이다.
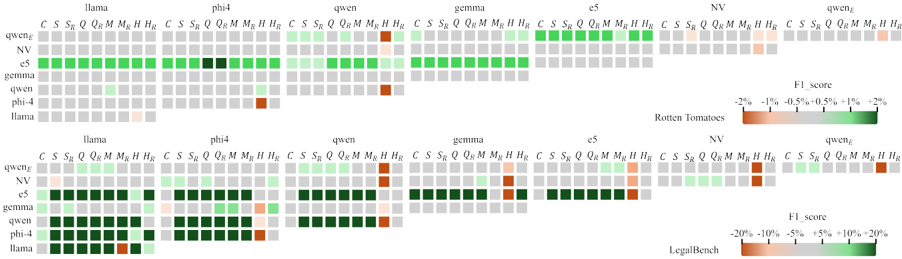
Figure 3: 두 모델을 결합할 때 층 조합에 따른 F1 변화. 위쪽은 Rotten Tomatoes(스케일 −2%~+2%), 아래쪽은 LegalBench(스케일 −20%~+20%)다. 모델 약어는 llama(LLaMA-3.2), phi4(Phi-4), qwen(Qwen3), gemma(Gemma-12B-it), e5(e5-large-v2), NV(NV-Embed-v2), qwenE(Qwen3-Embedding). 융합 방법은 C(Concatenation), S(Sum), S_R(Sum Residual), Q(Quaternion), Q_R(Quaternion Residual), M(Multiplication), M_R(Multiplication Residual), H(Hadamard), H_R(Hadamard Residual). 초록은 성능 향상, 주황/빨강은 하락. (원논문)
Figure 3은 두 데이터셋을 대비시켜 보여준다. 하나는 정확도가 아직 포화되지 않은 Rotten Tomatoes, 다른 하나는 데이터가 부족해 정확도·F1 모두 불안정한 LegalBench다. 우선 예상대로 동일 모델끼리의 단순 concatenation은 두 데이터셋 모두에서 아무런 개선을 주지 못했다 - 같은 표현 공간을 두 번 이어붙여봐야 새로운 정보가 없기 때문이다. Rotten Tomatoes에서는 e5 모델과의 융합이 NV 임베딩이 낀 조합을 빼면 모든 경우 0.5% 이상의 향상을 냈다. 다른 조합들도 소폭 개선을 보였으나 대부분 향상 폭이 크지는 않았다.
두 히트맵의 색 스케일 차이(±2% vs ±20%)가 이 절의 핵심 메시지를 시각적으로 웅변한다. Rotten Tomatoes에서는 융합의 효과가 잔잔한 초록빛인 반면, LegalBench에서는 진한 초록이 화면을 채운다. 데이터가 충분한 곳에서는 융합이 미세 조정 수준이지만, 데이터가 부족한 곳에서는 대부분의 융합 조합이 20%가 넘는 F1 향상을 냈다. 이 대비가 논문의 두 번째 주장을 뒷받침한다 - 분류 성능의 향상은 어느 한 모델의 본질적 강함에서 오는 게 아니라, 서로 다른 표현 공간을 지닌 모델들의 통합에서 나온다. 그리고 그 통합 효과는 데이터가 제한적일 때 훨씬 두드러진다.
5.3 최적 층 융합 분석 (Optimal-Layer Fusion Analysis)
앞선 실험들은 두 가지를 확인해줬다. 적절한 층을 고르는 것만으로 성능이 오르고, 서로 다른 모델을 합치면 더 오른다는 것. 문제는 최적 층이 데이터셋 특성과 모델 아키텍처에 따라 달라지기 때문에, 실전에서 이를 보편적으로 결정해 융합하는 건 사실상 불가능하다는 데 있다. 그래서 이 절은 "각 모델의 최적 층을 이미 안다고 가정"하고, 그런 이상적 조건에서 임베딩 융합이 달성할 수 있는 성능 향상의 이론적 상한(upper bound)을 분석한다.
| Dataset | Models | Layer | Fusion | ACC | F1 | Δ(%) |
|---|---|---|---|---|---|---|
| SST2 | NV-Embed-v2 | - | - | 0.955 | 0.955 | |
| SST2 | NV-Embed-v2, e5-large-v2 | 17, 21 | Hadamard(R) | 0.9748 | 0.9748 | +1.98% |
| MR | Qwen3-Embedding | - | - | 0.964 | 0.964 | |
| MR | NV-Embed-v2, e5-large-v2 | 20, 21 | Hadamard | 0.9738 | 0.9738 | +0.98% |
| R8 | NV-Embed-v2 | - | - | 0.983 | 0.954 | |
| R8 | NV-Embed-v2, Qwen3-Embedding | 25, 30 | concatenation | 0.9863 | 0.9607 | +0.33%, +0.67% |
| R52 | NV-Embed-v2 | - | - | 0.951 | 0.667 | |
| R52 | NV-Embed-v2, Qwen3-Embedding | 31, 36 | Hadamard(R) | 0.9599 | 0.7702 | +0.82%, +10.32% |
| Rotten Tomatoes | NV-Embed-v2 | - | - | 0.922 | 0.922 | |
| Rotten Tomatoes | NV-Embed-v2, gemma3-12b-it | 19, 26 | Sum(R) | 0.9371 | 0.9371 | +1.51% |
| LegalBench | Qwen3-Embedding | - | - | 0.94 | 0.896 | |
| LegalBench | NV-Embed-v2, e5-large-v2 | 22, 24 | Multiplication(R) | 0.98 | 0.927 | +4.0%, +3.1% |
Table 3 (원논문): 단일 모델 베이스라인과 두 모델 융합의 성능 비교. l은 각 데이터셋의 최적 층 인덱스. 융합 결과를 볼드 처리.
Table 3에서 먼저 눈에 들어오는 건 최적 융합 조합의 구성이다. 6개 데이터셋 중 5개에서 NV-Embed-v2가 최고 조합에 들어간다. NV-Embed-v2는 단일 모델 성능에서도 이미 가장 강한 축이라(Table 2에서 R52 F1 0.667, LegalBench F1 0.896로 최고), 강한 앵커 모델에 보완적 모델을 하나 더 붙이는 구도가 반복된다. 흥미로운 건 그 짝이 대부분 경량 임베딩 모델 e5-large-v2(0.335B)라는 점이다 - 가장 무거운 생성 모델이 아니라 가장 가벼운 임베딩 모델이 보완재로 자주 선택된다.
향상 폭 자체는 대체로 소박하다(marginal). SST2 +1.98%, MR +0.98%, R8 +0.33%처럼 포화된 데이터셋에서는 이론적 상한조차 크지 않다. 그러나 저자원·다클래스에서는 이야기가 다르다. R52의 F1이 0.667에서 0.7702로 +10.32%, LegalBench의 정확도가 0.94에서 0.98로 +4.0% 오른다. 융합 기법도 데이터셋마다 갈린다 - 포화된 SST2/MR/Legal은 Hadamard·Multiplication 계열(원소별 상호작용을 강조), R8/R52는 concatenation·Hadamard가 최고였다. 저자들의 결론은 신중하다. 관찰된 향상이 미미하긴 해도, 층 인식 임베딩 융합이 단일 임베딩 모델에 내재한 성능 정체(plateau)를 넘어설 잠재력을 시사한다는 것이다. "최적 층을 안다면"이라는 가정 위에 세워진 상한값이라는 점을 저자 스스로 명확히 해둔 것이 정직하다.
5.4 세 개 이상 모델의 융합: 안정성과 비용 트레이드오프
분석을 세 개 이상 모델로 확장해, 통합하는 표현의 수가 늘 때 성능이 어떻게 변하는지 본다. 각 구성에 대해 정확도·F1의 최솟값과 최댓값을 보고하고, 성능과 비용의 트레이드오프를 분석한다.
| Models | SST2 | MR | R8 | R52 | Rotten Tomatoes | LegalBench |
|---|---|---|---|---|---|---|
| Acc / F1 | Acc / F1 | Acc / F1 | Acc / F1 | Acc / F1 | Acc / F1 | |
| Single | 0.911-0.955 | 0.953-0.967 | 0.967-0.983 / 0.916-0.954 | 0.858-0.951 / 0.196-0.667 | 0.891-0.922 | 0.780-0.940 / 0.535-0.896 |
| 3(35) | 0.930-0.961 | 0.961-0.971 | 0.978-0.984 / 0.932-0.956 | 0.921-0.956 / 0.461-0.721 | 0.891-0.925 | 0.860-0.980 / 0.592-0.927 |
| 4(35) | 0.934-0.963 | 0.961-0.971 | 0.978-0.985 / 0.932-0.958 | 0.934-0.957 / 0.545-0.720 | 0.894-0.925 | 0.880-0.980 / 0.620-0.927 |
| 5(21) | 0.941-0.962 | 0.962-0.971 | 0.980-0.984 / 0.942-0.955 | 0.939-0.956 / 0.589-0.722 | 0.899-0.925 | 0.920-0.980 / 0.884-0.927 |
| 6(7) | 0.956-0.963 | 0.965-0.971 | 0.982-0.984 / 0.945-0.953 | 0.946-0.956 / 0.639-0.724 | 0.906-0.925 | 0.940-0.980 / 0.898-0.927 |
| 7(1) | 0.958 | 0.971 | 0.982-0.983 / 0.949-0.951 | 0.956 / 0.697 | 0.924-0.925 | 0.940-0.980 / 0.898-0.927 |
Table 4 (원논문): 3개 이상 모델 융합의 정확도·F1. 괄호 안 숫자 N(C)는 7개 모델에서 n개를 순서·중복 없이 뽑는 조합의 수(예: 3(35)는 C(7,3)=35). SST2·MR·Rotten Tomatoes는 이진 분류라 Acc와 F1이 같아 하나로 표기. 모든 모델은 마지막 층 + mean 풀링. 7(1)은 7개 모델을 모두 합친 유일한 조합.
Table 4가 이 논문의 논지가 가장 선명하게 드러나는 표다. 여기서 봐야 할 건 최댓값이 아니라 최솟값의 이동이다. 융합 모델 수가 늘어도 최댓값은 크게 변하지 않는다(SST2는 이미 0.96대에서 천장을 친다). 하지만 최솟값이 확연히 위로 올라간다. R52의 F1 최솟값은 단일 모델의 0.196에서 3개 융합 0.461, 5개 0.589, 6개 0.639로 계단식으로 상승한다. LegalBench의 F1 최솟값은 0.535에서 5개 융합 시 0.884로 뛴다. 이것이 논문이 말하는 "안정성(stability)"의 정체다 - 운 나쁘게 약한 조합을 골라도 바닥이 높아져 있어 크게 실패하지 않는다. 이질적 임베딩을 통합할수록 어느 한 모델의 영향력이 희석되고, 결과의 하한이 끌어올려지는 것이다.
주의할 지점도 있다. 7개를 다 합친 7(1) 조합이 항상 최고는 아니다. R52 F1이 7개 융합에서 0.697인데, 6개 융합의 최댓값 0.724보다 낮다. 모델을 무작정 다 넣는다고 최고 성능이 나오는 게 아니라, 오히려 안정성(최솟값 방어)을 사는 대신 최댓값에서는 손해를 볼 수 있다는 뜻이다. 여기서 비용 분석이 필요해진다.
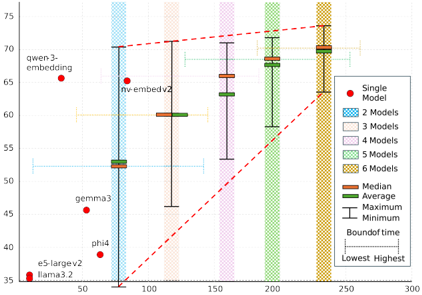
Figure 5: 임베딩 추출 시간(가로축)과 성능 안정성(세로축, R52 F1)의 트레이드오프. 빨간 점은 단일 모델, 색이 다른 상자들은 각각 2~6개 모델 융합의 성능 범위(중앙값·평균·최댓값·최솟값)를 나타낸다. (원논문)
Figure 5는 R52 데이터셋에서 임베딩 추출 시간과 F1의 관계를 그린다. 단일 모델들(빨간 점)은 성능이 35~66 사이로 넓게 흩어져 있다 - 무엇을 고르느냐에 따라 결과가 크게 달라지는 불안정한 영역이다. 반면 융합 상자들은 위로 올라가면서 세로 폭(최솟값-최댓값 범위)이 좁아진다. 저자들의 결론은 세 모델 융합이 성능 향상과 비용 사이에서 가장 유리한 균형점이라는 것이다. 3개 융합은 최솟값과 최댓값 모두에서 가장 큰 개선을 가져오는 반면, 4개 융합부터는 성능을 더 안정화하긴 해도 최댓값 향상은 미미해져 수확 체감(diminishing returns)이 나타난다. 모델을 하나 더 넣을 때마다 임베딩 추출 시간은 선형적으로 늘어나는데, 세 개를 넘어서면 그 비용을 정당화할 만큼의 성능 이득이 따라오지 않는 것이다. 실무적으로 "세 개까지만 합쳐라"라는 구체적 처방을 데이터로 제시한 셈이다.
6. 강점과 한계
강점
- 통일된 실험 설정 아래의 체계적 비교: 층 선택·풀링·다중 모델 융합이라는, 그동안 따로따로 다뤄지던 세 변수를 하나의 프레임에서 교차시켰다. 7개 모델 × 6개 데이터셋 × 9개 융합 기법을 훑는 실험 규모가 이 논문의 실질적 기여다. Figure 2·3·4의 히트맵들이 "최적 표현은 모델보다 데이터셋에 좌우된다"는 주장을 여러 각도에서 반복 검증한다.
- 저자원 환경에서의 명확한 효용: Figure 3의 ±2% vs ±20% 스케일 대비, Table 4의 최솟값 상승(R52 F1 0.196→0.639, LegalBench 0.535→0.898)이 데이터가 부족할 때 융합이 특히 강하다는 것을 정량적으로 못 박았다. 실무에서 라벨 데이터를 모으기 어려운 도메인(법률 등)에 직접적 시사점을 준다.
- 비용까지 고려한 실용적 처방: Figure 5의 트레이드오프 분석으로 "세 모델 융합이 성능-안정성-비용의 최적 균형"이라는 구체적 가이드라인을 제시했다. 단순히 "많이 합칠수록 좋다"에서 멈추지 않고 수확 체감 지점을 짚어준 것이 실용적이다.
- 파인튜닝 없는 접근: 백본을 재학습하지 않고 임베딩 추출과 경량 MLP 분류기만으로 실험을 구성해, 순수하게 표현 품질과 융합의 효과를 분리해 측정했다. 재현과 응용이 상대적으로 쉽다.
- 정직한 서술: 최적 층 융합(Table 3)이 "최적 층을 안다는 가정 위의 상한값"임을 명시하고, 향상이 미미한 경우도 그대로 보고했다. 결과를 부풀리지 않은 태도가 신뢰를 준다.
한계 및 아쉬운 점
- 최적 층의 실전 미지성: Table 2의 "최고 층"은 5회 실행 중 사후적으로 최고였던 값을 고른 것이라, 실제로는 그 층을 미리 알 수 없다. 저자들도 이 점을 인정하지만, 그렇다면 층 선택 분석의 실용적 가치는 "그런 상한이 존재한다"를 보이는 데 그친다. 최적 층을 예측하는 방법이 함께 제시됐다면 훨씬 강한 논문이 됐을 것이다.
- 정적·태스크 무관 융합에 국한: 저자 스스로 밝힌 한계로, 각 모델·층의 기여도를 동적으로 조절하는 학습 가능한 가중치(adaptive/learnable weighting) 메커니즘을 다루지 않았다. concatenation 위주의 고정 융합이라 융합 자체의 잠재력을 다 끌어내지 못했을 수 있다.
- 텍스트 분류에만 한정: 검색(retrieval)·클러스터링·생성 같은 다른 다운스트림 태스크로 확장되지 않았다. 융합의 효과가 태스크 유형에 따라 어떻게 달라지는지는 열린 질문으로 남는다.
- 7개 융합의 성능 역전에 대한 분석 부족: Table 4에서 7개를 다 합친 조합이 6개보다 R52 F1에서 낮아지는 현상(0.697 < 0.724)이 관찰되는데, 왜 특정 모델이 노이즈로 작용하는지에 대한 심층 분석이 없다. 어떤 모델을 넣지 말아야 하는지를 짚었다면 실용성이 더 높았을 것이다.
- 비용 분석의 좁은 범위: Figure 5의 트레이드오프는 R52 한 데이터셋, 임베딩 추출 시간이라는 단일 지표에 국한된다. 메모리 사용량이나 다른 데이터셋에서도 "세 개가 최적"이 유지되는지는 확인되지 않았다.
- 노이즈·도메인 이동 미검증: 저자들도 향후 과제로 언급했듯, 저자원 효용이 노이즈가 섞이거나 도메인이 바뀐 데이터에서도 유지되는지는 더 검증이 필요하다.
7. 마치며
이 논문은 새로운 모델이나 융합 기법을 내놓는 대신, "임베딩을 어느 층에서 뽑고 어떻게 합쳐야 안정적인가"라는 실무적 질문에 실증적 지도를 그려준다. 그 지도가 가리키는 방향은 분명하다. 단일 층·단일 모델에 최적을 걸면 데이터셋이 바뀔 때마다 성능이 출렁이지만, 서로 다른 표현 공간을 가진 모델 두세 개를 융합하면 그 변동이 눌리면서 특히 데이터가 부족한 상황에서 든든한 방어선이 생긴다. 최댓값을 높이는 전략이 아니라 최솟값을 끌어올리는 전략이라는 점이 이 논문의 성격을 잘 요약한다.
세 가지가 기억에 남는다. 첫째, 생성 LLM에서 최적 층과 풀링은 모델의 성질보다 데이터셋의 성질에 더 끌려간다는 관찰이다. 이는 "마지막 층을 쓰면 된다"는 관행에 대한 실증적 반박이다. 둘째, 융합의 이득은 데이터가 부족할수록 커진다는 점으로, 저자원 도메인에서 임베딩 융합이 데이터 효율적인 대안이 될 수 있음을 보였다. 셋째, 무작정 많이 합치는 게 능사가 아니라 세 개 정도에서 성능-안정성-비용의 균형이 맞는다는 실용적 처방이다.
물론 최적 층을 실전에서 예측하는 방법, 학습 가능한 동적 융합, 분류 너머의 태스크로의 확장 등 남은 과제가 적지 않다. 그럼에도 여러 LLM을 임베딩 제공자로 함께 쓰는 시대에, "무엇을 어떻게 합칠 것인가"를 통제된 실험으로 정리해준 이 논문은 RAG나 분류 파이프라인을 설계하는 실무자에게 실질적인 참고점이 된다. 화려하진 않지만 성실한, 그리고 정직한 실증 연구다.
References
- Devlin et al., 2019. "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding."
- Liu et al., 2024. "LLMEmbed: Rethinking Lightweight LLM's Genuine Function in Text Classification."
- Kumar et al., 2020. "QUARC: Quaternion Multi-Modal Fusion Architecture for Hate Speech Classification."
- Gardias et al., 2020. "Enhanced Residual Networks for Context-based Image Outpainting."
- Skean et al., 2024. "Does Representation Matter? Exploring Intermediate Layers in Large Language Models."
- Zhang et al., 2024. "Investigating Layer Importance in Large Language Models."
- Tang and Yang, 2024. "Pooling and Attention: What Are Effective Designs for LLM-based Embedding Models?"
- Lee et al., 2025. "NV-Embed: Improved Techniques for Training LLMs as Generalist Embedding Models."
- Wang et al., 2024. "Text Embeddings by Weakly-Supervised Contrastive Pre-training." (e5)
- Zhang et al., 2025. "Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models."
- Kaushik et al., 2024. "Enhancing Authorship Attribution through Embedding Fusion."
- Ko et al., 2024. "Benchmarking Text-integrated Protein Language Model Embeddings and Embedding Fusion on Diverse Downstream Tasks."