논문 리뷰
논문 리뷰: When Does Mixing Help? Analyzing Query Embedding Interpolation in Multilingual Dense Retrieval
두 언어로 번역된 쿼리 임베딩을 비율을 바꿔가며 선형 보간하면 어떤 일이 벌어지는지를 105개 조건에서 통제 실험으로 파헤친 논문. 답은 "섞으면 대체로 이득이지만, 문서 색인에 영어가 끼어 있으면 이야기가 완전히 달라진다"이다.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | When Does Mixing Help? Analyzing Query Embedding Interpolation in Multilingual Dense Retrieval |
| 저자 | Tongyao Zhu*, Chao-Ming Huang*, Min-Yen Kan† (National University of Singapore) |
| 학회/저널 | arXiv Preprint, 2026 |
| 논문 링크 | arXiv:2606.13537 |
| 코드 | github.com/tongyao-zhu/query-embedding-mix |
(* 공동 1저자, † 교신저자)
1. 들어가며
싱가포르 사람에게 검색창을 쥐여주면 어떤 쿼리가 나올까? "how to 报税 in Singapore" 같은 문장이 자연스럽게 튀어나온다. 두 개 이상의 언어를 쓰는 커뮤니티에서 한 문장 안에 여러 언어를 섞어 쓰는 것, 이른바 코드 믹싱(code-mixing) 혹은 코드 스위칭(code-switching)은 검색과 대화 시스템에서 흔한 현상이다. 그런데 정작 다국어 검색기(multilingual retriever)를 만들고 평가할 때는 "쿼리는 하나의 언어로 되어 있다"는 가정이 거의 항상 깔려 있다. 단일 언어 검색(monolingual retrieval)이거나, 아니면 쿼리를 통째로 다른 언어로 번역하는 교차 언어 검색(cross-lingual retrieval)만 다룰 뿐, 쿼리 자체가 언어를 섞고 있는 상황은 표준 벤치마크에서 사실상 테스트되지 않는다.
이 공백에서 자연스러운 질문 하나가 떠오른다. 언어를 섞으면 검색이 정말 나아지는가? 두 언어의 혼합 비율을 조금씩 바꿔갈 때, 검색 성능은 언제나 "더 잘하는 쪽 단일 언어" 아래로 묶여 있을까, 아니면 중간 어딘가의 혼합이 양쪽 끝(순수 단일 언어 쿼리)을 모두 넘어설 수 있을까? 이 질문에 제대로 답하려면 세 가지가 필요하다. 혼합 비율을 정밀하게 조절할 수 있어야 하고, 의미가 동일한 병렬 쿼리(parallel query)가 있어야 하며, 문서 색인의 언어 구성을 여러 가지로 바꿔가며 평가할 수 있어야 한다.
문제는 고품질 코드 믹싱 쿼리를 만드는 일 자체가 비싸다는 데 있다. 저자들도 예비 실험에서 LLM에게 단어 수준 코드 스위칭(특정 단어를 다른 언어로 치환)을 시켜봤지만, 생성이 늘 성공하는 것도 아니고 원하는 혼합 비율을 맞추려면 비율마다 별도의 LLM 호출이 필요했다. 그래서 이 논문은 발상을 바꾼다. 텍스트를 섞는 대신, 임베딩을 섞는다. 두 언어의 단일 언어 쿼리 임베딩을 구한 다음, 이 둘을 여러 목표 비율로 볼록 결합(convex combination)해서 만든 보간(interpolation) 벡터를 "언어 혼합 쿼리 표현"으로 쓰는 것이다. LLM을 여러 번 부를 필요 없이 비율을 정밀하게 조절할 수 있고, LLM이 잘 모르는 언어쌍에서도 통제된 비교가 가능해진다.
이 단순한 도구 하나로 저자들은 BGE-M3(Chen et al., 2024)라는 강력한 다국어 검색기를 대상으로 35개 언어쌍 × 3개 문서 언어 설정, 총 105개 조건을 훑는다. 그리고 다섯 가지 결론에 도달한다. 섞으면 대체로 이득이고(88/105), 영어가 색인에 있느냐 없느냐가 판을 뒤집으며, 영어는 어떤 비영어 언어에게도 가장 강력한 혼합 파트너이고, 영어 지배 효과를 걷어내면 유형론적 거리(typological distance)가 멀수록 이득이 줄고, 이 패턴들은 모델 계열과 크기를 바꿔도 유지된다. 결과가 구조적이고 예측 가능하다는 것, 그래서 다국어 RAG 파이프라인에 바로 써먹을 배포 지침을 준다는 것이 이 논문의 실질적 가치다.
2. 기존 연구의 한계
2.1 다국어 밀집 검색과 그 평가
밀집 검색기(dense retriever)는 쿼리와 지문(passage)을 공유 벡터 공간에 인코딩하고 유사도로 관련성을 매긴다. 대개 바이인코더(bi-encoder) 구조를 쓴다(Karpukhin et al., 2020). Contriever(Izacard et al., 2022)나 BGE-M3(Chen et al., 2024) 같은 최신 다국어 검색기는 보통 MS MARCO(Bajaj et al., 2018)와 그 다국어 버전인 mMARCO(Bonifacio et al., 2022)에서 벤치마크된다. 문제는 이 벤치마크들이 쿼리를 단일 언어이거나 완전히 번역된 것으로 가정한다는 점이다. 최근 연구는 LLM이 여러 NLP 태스크에서 강력한 다국어 능력을 보인다고 해서 코드 믹싱까지 잘하는 것은 아니라고 지적한다(Zhang et al., 2023a). 검색기가 코드 믹싱 상황에서 얼마나 강건한지는 아직 열린 문제인 것이다.
2.2 IR에서의 혼합 언어 쿼리
FIRE의 mixed-script/mixed-language 세팅은 스크립트 변이, 음차(transliteration), 토크나이제이션 부정확성이 검색에 어떻게 영향을 주는지를 보여줬다(Banerjee et al., 2016; Chakma and Das, 2016). 최근의 이중언어 웹 검색 벤치마크는 다국어 검색기가 단일 언어 쿼리와 혼합 쿼리에서 일관되지 않게 행동한다는 점, 그리고 코드 스위칭 학습이 강건성을 높인다는 점을 보고했다(Kim et al., 2025). 그러나 기존 자원들은 '혼합됨(mixedness)'을 이진 속성으로 다루거나 고정된 혼합 쿼리 집합만 제공하는 경우가 많아서, 혼합 비율에 따라 성능이 어떻게 변하는지를 분리해내기 어렵다. 이 논문이 비율 통제 설계(ratio-controlled design)를 채택하고, 음차/토크나이제이션 노이즈를 피하기 위해 임베딩 수준에서 섞는 이유가 여기 있다.
2.3 코드 믹싱 NLP 벤치마크와 진단
IR 바깥으로 눈을 돌리면 LinCE(Aguilar et al., 2020)나 GLUECoS(Khanuja et al., 2020) 같은 코드 믹싱 벤치마크 스위트가 있다. 이들은 언어쌍에 따라 성능 변동이 크다는 점, 그리고 언어 식별(Language Identification, LID)과 세그먼테이션 오류가 성능 저하의 주요 원인이라는 점을 강조한다. 이 논문의 통제된 IR 평가는 이런 진단을 IR 관점에서 보완하며, 언어쌍과 비율에 따른 효과를 정량화한다.
이 세 갈래의 한계를 관통하는 공통점은 "혼합 비율을 연속적으로 통제하면서, 문서 언어 구성까지 바꿔가며, 노이즈 없이 순수하게 언어 조합 효과만 측정한 연구가 없다"는 것이다. 이 논문의 방법론은 바로 그 빈틈을 정확히 겨냥한다.
3. 핵심 아이디어
발상은 의외로 단순하다. 코드 믹싱 쿼리를 텍스트로 만드는 대신, 두 언어 임베딩의 중간 지점을 취하자는 것이다.
왜 이게 통할까? 단어 수준 혼합은 근본적으로 세 가지 문제를 안고 있다. 첫째, 비용이다. 원하는 혼합 비율의 쿼리를 얻으려면 비율마다 LLM을 새로 호출해야 한다. 둘째, 품질이다. LLM은 종종 불완전한 문장을 만들거나 지정한 비율을 지키지 못한다. 셋째, 통제 불가능성이다. 생성 노이즈, 토크나이제이션·LID 부정확성이 섞여 들어와 "언어 조합의 순수 효과"를 오염시킨다.
임베딩 보간은 이 셋을 모두 우회한다. 두 단일 언어 쿼리를 한 번씩만 인코딩해두면, 그 뒤로는 인코더를 다시 부르지 않고도 를 바꿔가며 임의의 혼합 벡터를 즉석에서 만들 수 있다. LLM이 낯설어하는 언어쌍(예: 힌디-인도네시아어)에서도 문제없이 동작하고, 비율은 실수 하나로 정밀하게 조절된다.
물론 "임베딩을 섞은 것이 실제로 언어를 섞은 것과 같은가?"라는 의심이 든다. 저자들은 이 의심을 정면으로 다룬다. EN-ZH 쌍에서 단어 수준 혼합과 임베딩 수준 혼합의 비율-성능 곡선이 같은 추세를 그리는지 비교하고(4.1절), 나아가 단어 수준으로 섞은 쿼리의 임베딩이 실제로 두 단일 언어 임베딩을 잇는 보간 궤적 근처에 놓인다는 것을 기하학적으로 확인한다. 즉 임베딩 보간은 단어 수준 혼합의 저비용 프록시(proxy)로 정당화된다.
기존 연구가 "코드 믹싱을 어떻게 잘 만들까" 혹은 "코드 믹싱으로 어떻게 학습시킬까"에 집중했다면, 이 논문은 한 발 물러서서 "이미 배포된 검색기가 언어 혼합에 어떻게 반응하는가"를 값싸고 정밀하게 진단하는 도구를 제안한 셈이다.
4. 제안 방법 (Method)
4.1 전체 구조: 무엇을 어떻게 재는가
목표는 명확하다. 의미가 동일한 두 언어 쿼리 사이의 혼합 비율을 바꿀 때 다국어 밀집 검색 성능이 어떻게 변하는지를, 여러 문서 언어 색인 설정 아래서 측정하는 것이다.
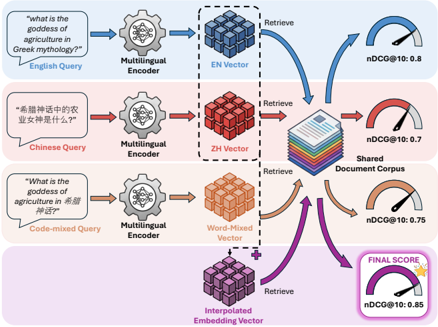
Figure 1: 연구 프로토콜 개요. 영어 쿼리, 중국어 쿼리, 그리고 코드 믹싱 쿼리를 다국어 인코더에 넣어 각각의 벡터를 얻고, 공유 문서 코퍼스에서 검색한다. 맨 아래의 보간 임베딩 벡터(Interpolated Embedding Vector)가 이 논문의 주인공으로, 단일 언어 벡터들보다 더 높은 nDCG@10(0.85)을 낸다. (원논문)
Figure 1은 논문 전체의 문제의식을 한 장으로 압축한다. 위쪽 세 줄은 영어 쿼리(nDCG 0.8), 중국어 쿼리(0.7), 그리고 실제 텍스트로 코드 믹싱한 쿼리(0.75)를 보여주고, 맨 아래 줄이 두 단일 언어 임베딩을 보간해서 만든 벡터(0.85)를 보여준다. 눈여겨볼 지점은 보간 벡터가 세 가지 실제 쿼리 모두를 앞선다는 것이다. 이 그림은 "임베딩을 섞으면 순수 단일 언어보다, 심지어 실제 코드 믹싱 텍스트보다도 잘할 수 있다"는 논문의 중심 주장을 시각적으로 예고한다.
태스크와 데이터. mMARCO에서 지문 랭킹(passage ranking)을 수행한다. mMARCO는 다국어 지문 컬렉션과 쿼리의 여러 번역본을 공유 쿼리 ID로 정렬해 제공하고 관련성 판정(relevance judgment)도 함께 준다. 표준 바이인코더 파이프라인을 따라 각 지문을 한 번 인코딩해 FAISS flat 색인(Douze et al., 2024)에 넣고, 모든 쿼리·지문 임베딩을 L2 정규화한 뒤 내적 스코어링(정규화 후에는 코사인 유사도와 동치)을 쓴다. 검색 시 상위 지문을 뽑아 nDCG@10 같은 랭킹 지표를 계산한다.
세팅. mMARCO에서 제공하는 14개 언어(ar, de, en, es, fr, hi, id, it, ja, nl, pt, ru, vi, zh)를 쓰고, 가설을 뒷받침할 35개 대표 언어쌍을 고른다. 코드 믹싱 프로토콜 간 평가 풀을 일관되게 유지하기 위해, 충분히 긴 1,484개 쿼리로 이루어진 필터링된 부분집합을 사용한다. 이렇게 하면 단어 수준 코드 믹싱이 의미를 갖고, 짧고 노이즈 많은 쿼리를 피할 수 있다.
주 실험은 8.8백만 지문 전체 mMARCO 코퍼스를 쓴다. Ablation과 단어 혼합 실험에는 계산량을 줄이기 위해 문서 언어 설정마다 10만 지문 부분집합을 쓴다(부록 §B). 각 언어쌍 에 대해 세 가지 문서 언어 설정을 평가한다. (i) 단일 문서, (ii) 단일 문서, (iii) 이중언어 문서(각 문서를 두 언어로). 모든 설정에서 유일하게 바뀌는 것은 쿼리 표현(단일 언어 vs. 혼합)뿐이고, 문서와 검색 절차는 고정된다. 이 통제가 이 논문의 신뢰성을 떠받치는 축이다.
4.2 단어 수준 혼합 (Word-Level Mixing)
먼저 비교 기준이 될 단어 수준 혼합을 짚어두자. LLM에게 을 다시 쓰되 대략 원하는 수만큼 내용 토큰을 끼워 넣도록 지시한다. 생성 후에는 LID 태그로 실현된 비율을 추정하고 퇴화된 출력(전부 이거나 전부 )을 버린다. 미세한 비율 불일치에 대한 민감도를 줄이려고 받아들인 쿼리를 다섯 개 퍼센트 밴드 로 분류한다. LLM 생성은 비싸고 추가 변동성(생성 노이즈, 토크나이제이션/LID 부정확성)을 끌고 오기 때문에, 단어 혼합은 오직 임베딩 수준 혼합을 검증하는 용도로만 쓴다. 구체적인 생성 절차와 실패 사례는 뒤의 부록(6장)에서 자세히 다룬다.
4.3 임베딩 수준 혼합 (Embedding-Level Mixing)
이 논문의 도구가 여기 있다. 과 를 두 단일 언어 번역 에 대한 쿼리 인코더 출력이라 하자. 혼합 가중치 (의 퍼센트로 해석)에 대해, 혼합 쿼리 임베딩을 두 단일 언어 임베딩의 보간으로 정의한다.
여기서 이면 순수 쿼리, 이면 순수 쿼리, 그 사이는 두 언어가 섞인 표현이다. 마지막의 L2 정규화가 중요한데, 검색 스코어링이 코사인 유사도이므로 방향만 의미가 있고 크기는 정규화로 통일된다. 실험에서는 을 훑는다. 이 중 가 내부(interior) 비율이고 이 양 끝점(endpoint)이다.
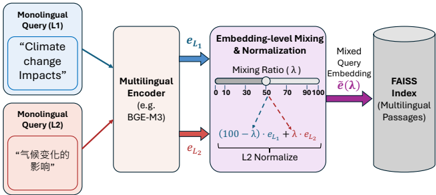
Figure 2: 임베딩 수준 쿼리 혼합의 흐름. 두 단일 언어 쿼리 번역을 인코딩하고, 비율 로 임베딩을 보간한 뒤 L2 정규화하고, 색인에서 검색한다. (원논문)
Figure 2가 보여주는 핵심은 오른쪽 화살표다. 혼합 임베딩 로 벡터 색인을 직접 질의하며, 인코더를 다시 부르지 않는다. 바로 이 점 덕분에 혼합 비율이 검색에 미치는 효과를 아주 값싸게 연구할 수 있고, LLM 생성 품질이나 LID 문제도 원천적으로 피할 수 있다. 그림 가운데의 슬라이더(0부터 100까지)는 이 방법이 "연속적인 다이얼"처럼 비율을 조절한다는 점을 직관적으로 전달한다.
4.4 언어쌍 메타데이터
언어쌍이 성능에 어떤 영향을 주는지 분석하려고, 각 쌍에 네 가지 요인을 주석으로 붙인다. **스크립트 일치(Script match)**는 과 의 주요 문자 체계가 같은지를 나타낸다. **족 거리(family distance)**와 **유형론적 거리(typological distance)**는 DistaL(Goot et al., 2025)에서 얻으며, 별도 언급이 없으면 연속 거리(족은 glot_tree, 유형론은 lang2vec_knn)를 쓴다. **자원 수준(resource level)**은 Microsoft 언어 다양성 분류(Joshi et al., 2020)를 따라 0~5 밴드로 나뉜다. mMARCO에는 밴드 0~2 언어가 없으므로 밴드 5를 고자원(H), 밴드 3~4를 저자원(L)으로 보고 쌍 유형(H-H, H-L, L-L)을 파생한다.
4.5 평가와 혼합 이득의 정의
주 지표는 nDCG@10이고, 보조로 MRR@10과 Recall@10을 개발 스플릿에서 공식 관련성 판정으로 계산한다. 지표는 Kim et al.(2025)을 따라 %로 보고한다.
혼합의 이득을 요약하기 위해, 각 (언어쌍, 문서 언어) 설정에서 최선의 내부 비율( 중)과 최선의 끝점( 중)을 비교한다.
따라서 은 어떤 내부 혼합이 같은 문서 언어 설정에서 최선의 단일 언어 쿼리를 능가한다는 뜻이다. 이 한 줄짜리 정의가 논문 전체의 통화(currency)다. 이후 거의 모든 결과가 "이 조건에서 가 얼마였는가"로 이야기된다. 주의할 점은 가 "최선 vs. 최선"의 비교라는 것이다. 내부 혼합의 최댓값을 끝점의 최댓값과 겨루므로, 이 나오려면 중간 어딘가의 봉우리가 두 순수 언어 모두를 넘어서야 한다.
5. 실험 결과
별다른 언급이 없으면 이 장의 모든 결과는 전체 mMARCO에서의 임베딩 수준 혼합에 기반한다.
5.1 단어 혼합 vs. 임베딩 혼합: 프록시는 정당한가
가장 먼저 확인할 것은 임베딩 혼합이 단어 수준 코드 믹싱과 같은 비율 추세를 그리느냐다. 저자들은 EN-ZH 쌍을 고른다. 둘 다 고자원 언어라 LLM이 단어 혼합을 잘 해낼 만하고, 스크립트가 크게 다르고 공유 어휘가 없어서 대비가 선명하기 때문이다.
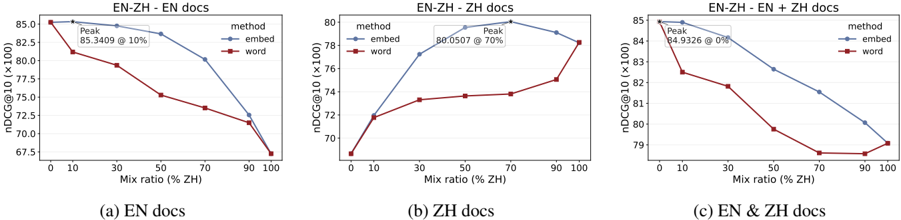
Figure 3: EN-ZH 쌍에서 세 문서 언어 설정별 단어 혼합 vs. 임베딩 혼합의 nDCG@10. 파란 선이 임베딩(embed), 빨간 선이 단어(word). (a) EN 문서, (b) ZH 문서, (c) EN+ZH 문서. (원논문)
세 패널 모두에서 임베딩 혼합(embed-mix)이 단어 혼합(word-mix)과 같은 큰 추세를 따른다. (a) EN 문서에서는 ZH 비율이 커질수록 성능이 떨어지고, (b) ZH 문서에서는 ZH 비율이 커질수록 오르며(70%에서 봉우리 80.05), (c) EN+ZH 문서에서는 새로운 내부 봉우리 없이 양 끝점 사이를 매끄럽게 보간한다. 세 곡선의 형태가 두 방법에서 일치한다는 것이 프록시 정당화의 첫 번째 증거다. 동시에 눈에 띄는 건 파란 선(embed)이 거의 항상 빨간 선(word) 위에 있다는 점이다. 저자들은 이 절대적 격차를 단어 혼합 특유의 노이즈(생성 변동, 토크나이제이션/LID 오류) 탓으로 돌린다. 임베딩 혼합은 구조상 이 노이즈를 애초에 겪지 않는다.
추세가 왜 일치하는지를 더 파고들기 위해, 단어 혼합 쿼리 임베딩의 기하를 분석한다. 각 정렬된 EN-ZH 쿼리에서 , 를 단일 언어 임베딩, 을 단어 혼합 쿼리 임베딩이라 하자. EN→ZH 축 위의 정규화된 위치 (이 EN, 이 ZH)과 그 축에 대한 정규화된 직교 거리 를 다음처럼 정의한다.
은 혼합 임베딩이 두 끝점을 잇는 선분 위 어디쯤에 있는지를, 는 그 선분에서 얼마나 벗어나 있는지를 잰다. (논문은 이 두 진단량을 텍스트로 정의하고 있고, 위 식은 그 정의를 표준 사영으로 옮긴 것이다.)
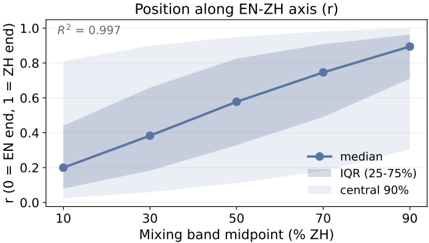
Figure 4a: EN-ZH 축 위 위치 대 혼합 밴드 중점(% ZH). 중앙값(median)이 거의 선형으로 증가한다. . (원논문)
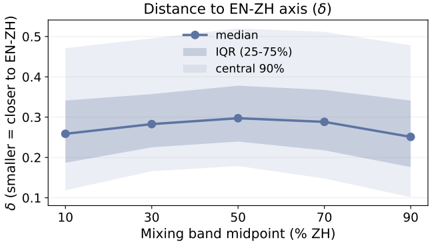
Figure 4b: EN-ZH 축에 대한 직교 거리 대 혼합 밴드 중점(% ZH). 의 중앙값이 모든 밴드에서 작게 유지된다. (원논문)
Figure 4의 두 패널이 함께 말하는 바는 이렇다. 의도한 ZH 비율이 커질수록 의 중앙값이 거의 선형으로 증가하고(), 는 밴드 전체에서 0.25~0.30 근처로 작게 머문다. 즉 단어 혼합 쿼리는 두 단일 언어 끝점을 잇는 보간 궤적 가까이에 놓인다. 이것이 "임베딩을 보간하면 단어 수준 혼합과 비슷한 효과가 나는" 이유를 부분적으로 설명한다. 단어를 실제로 섞어도, 그 결과 임베딩은 결국 두 순수 임베딩 사이의 선분 위를 이동하기 때문이다. 부록 C.1에서 EN-VI, ZH-VI, HI-ID 세 쌍으로 이 검증이 확장되며 같은 결론이 확인된다. 이 근거를 바탕으로 나머지 실험은 통제 가능하고 확장 가능하며 여러 언어쌍에서 더 강건한 임베딩 보간을 주 방법으로 채택한다.
5.2 큰 그림: 임베딩 보간은 대체로 단일 언어보다 낫다
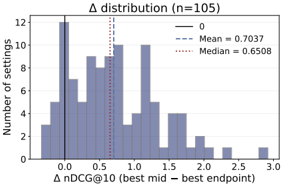
Figure 5a: 105개 설정에 대한 의 분포. 평균 0.7037, 중앙값 0.6508. 대부분의 질량이 0의 오른쪽에 있다. (원논문)
105개 그룹(35 언어쌍 × 3 문서 언어 설정)에 대해 최적 비율에서의 분포를 보면, 88/105(83.8%)가 이고 17/105(16.2%)가 이다. 평균 , 중앙값 , 관측 범위는 에서 까지다. 95% 부트스트랩 구간으로 보면 66/105는 신뢰성 있게 양수(구간이 0보다 엄격히 위), 38/105는 0과 구분 불가(구간이 0을 가로지름), 1/105만 신뢰성 있게 음수다. 가장 큰 이득은 AR 문서에서의 EN-AR(, )에서 나오고, 가장 음의 경우는 EN+ZH 문서에서의 EN-ZH(, )다.
이 분포가 전하는 메시지는 명확하다. 언어를 섞는 것은 대체로 도움이 되고, 손해를 볼 때조차 그 폭이 작다(최악이 ). 저자들은 이를 단일 언어 임베딩들이 상보적(complementary) 의미 신호를 담고 있어서, 이들을 결합하면 더 강건한 표현이 나온다는 가설로 설명한다. 하지만 이 큰 그림 밑에는 훨씬 흥미로운 구조가 숨어 있다.
5.3 영어의 강력한 효과
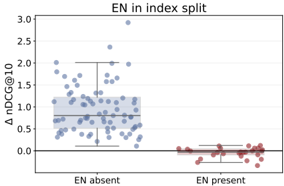
Figure 5b: 색인의 영어 유무로 나눈 . 영어가 없을 때(EN absent) 모든 그룹이 이고, 영어가 있을 때(EN present)는 모두 0 근처에 몰려 있다. (원논문)
전체적으로 가 양수인 경우가 많았지만, 패턴을 급격히 바꾸는 결정적 요인이 있다. 바로 영어 문서의 존재다. 105개 그룹을 문서 언어 설정에 영어가 포함되는지로 나누면 그림이 완전히 갈라진다. 문서에 영어가 없을 때(비영어 단일 설정과 비영어+비영어 이중언어 설정) 모든 그룹이 이고 평균은 다. 순수 단일 언어 검색보다 나은 혼합 비율이 반드시 존재한다는 뜻이다. 반면 색인에 영어가 있으면(EN 단일 또는 EN+X 이중언어) 모든 가 0 근처에 뭉쳐 평균 가 된다. 섞어봐야 소용이 없는 것이다.
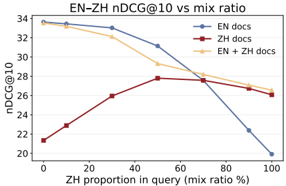
Figure 5c: EN-ZH 예시. ZH 문서, EN 문서, EN+ZH 문서 각각에 대한 nDCG@10 대 (L2 %) 곡선. (원논문)
혼합의 효과에는 비대칭성이 있다. 기존 웹 검색 연구(Kim et al., 2025)는 이중언어 사용자가 영어 문서를 검색할 때 의도적으로 영어를 섞는 것이 효과적이라고 보고하며, 그 이득을 쿼리-문서 유사도 증가로 설명했다. 그런데 이 논문은 영어의 효과가 쿼리-문서 유사도를 압도한다는 것을 발견한다. Figure 5c에서 보듯, ZH 쿼리에 EN을 더하면 단일 언어 ZH 문서에서조차 검색이 개선되지만(, ), 그 반대는 성립하지 않는다. EN 쿼리에 ZH를 더하면 영어 문서 검색은 일관되게 나빠진다. 즉 효과가 비대칭이다. 비영어 쿼리에 영어를 섞으면 비영어 문서 검색이 좋아지지만, 다른 언어에 영어를 섞어도 영어 문서 검색에는 도움이 안 된다.
여기서 한 걸음 더 나아가, 영어를 쿼리의 '혼합 파트너' 언어로 볼 때 어떤가를 본다.
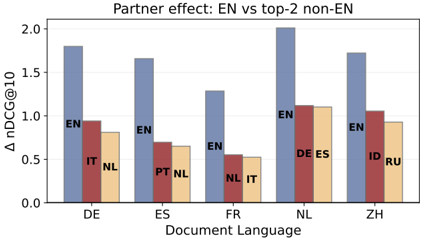
Figure 6: 여러 문서 언어 에 대해, 단일 문서 설정에서 영어가 시험된 파트너 중 가장 큰 를 준다. DE, ES, FR, NL, ZH 문서에서 파란 막대(EN)가 상위 2개 비영어 파트너를 압도한다. (원논문)
문서 언어를 고정하고 파트너 언어를 바꿔가며 재보면, 각 비영어 문서 언어 에 대해 영어가 단일 문서에서 가장 큰 를 낸다. 저자들은 이것이 연구 대상 13개 언어 전부에서 일관됨을 확인한다(상세는 부록 Table 12). Figure 6에서 영어(파란 막대)는 2위 파트너를 큰 격차로 앞선다. 예컨대 NL 문서에서 EN은 인 반면 2위 DE는 이다.
부록에서 저자들은 이 결론이 자원 밴드 0~2의 극저자원 언어까지 일반화됨을(C.2), 그리고 영어 차용어(loanword)가 전혀 없는 순수 단일 언어 쿼리에서도 혼합이 성능을 높임을(C.3) 보인다. 즉 영어 혼합의 이점은 DNA, NBA 같은 개체명·약어의 교차 언어 보존이라는 표면적 어휘 매칭을 훨씬 넘어선다. 저자들의 가설은 이렇다. 웹 코퍼스의 절대다수가 영어이기 때문에(Kudugunta et al., 2023) 영어가 가장 포괄적인 지식 기반을 인코딩하고, 그 결과 현재의 주류 모델들은 영어 서브스페이스 안에 가장 강건하고 조밀하게 구조화된 의미 표현을 갖게 된다. 영어가 혼합 쿼리를 벡터 공간의 더 좋은 영역으로 끌어당기는 보편적 앵커(universal anchor) 역할을 한다는 것이다. 개인적으로는 이 해석이 이 논문에서 가장 곱씹을 만한 부분이다. "영어를 섞으면 좋아진다"가 단순한 어휘 겹침이 아니라 사전학습 데이터 불균형이 벡터 공간에 남긴 구조적 흔적이라는 주장은, 다국어 모델을 다루는 사람이라면 한 번쯤 마주쳤을 직관을 정면으로 언어화한다.
5.4 문서-쿼리 언어 일치
단일 언어 문서 설정에서 성능은 쿼리 임베딩 중 얼마나 많은 부분이 색인된 문서 언어에서 오는지와 밀접하게 연관된다. 를 혼합 쿼리 임베딩 중 색인된 문서 언어가 기여하는 비율이라 하자(예: 문서만 있는 설정에서 ).
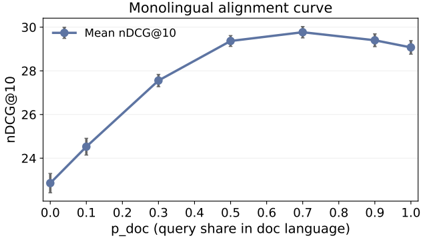
Figure 7: 단일 언어 문서 설정에서의 문서-언어 정렬. 색인된 문서 언어에서 오는 쿼리 임베딩 비율 에 대한 평균 nDCG@10. 성능은 가 커질수록 빠르게 오르다가 대략 에서 봉우리를 친다. (원논문)
70개 단일 언어 문서 설정 전부에서, 문서 언어와 일치하는 단일 언어 끝점이 반대 언어 끝점을 능가한다. 이는 교차 언어 검색이 단일 언어 기준선보다 어렵다는, 널리 관찰된 교차 언어 정렬 갭(cross-lingual alignment gap)과 일치한다(Zhang et al., 2023b; Conneau et al., 2020). 하지만 Figure 7이 드러내는 진짜 이야기는 곡선의 비선형성에 있다. 쿼리가 문서 언어에서 멀어질수록(가 100에서 0으로) 성능이 전반적으로 떨어지지만, 그 하락이 선형이 아니다. 쿼리 임베딩의 50%만 목표 문서 언어에 두어도 100% 단일 언어 쿼리와 거의 맞먹는다. 이 관점은 두 효과를 분리해준다. 문서 언어를 맞추는 것은 여전히 중요하지만, 완전한 단일 언어 쿼리가 항상 최적은 아니라는 것. 내부 혼합은 충분한 문서 언어 신호를 보존하면서 다른 언어에서 오는 상보적 정보를 더할 수 있고, 그래서 최적 비율은 언어 정렬과 교차 언어 의미 강화 사이의 트레이드오프를 반영한다.
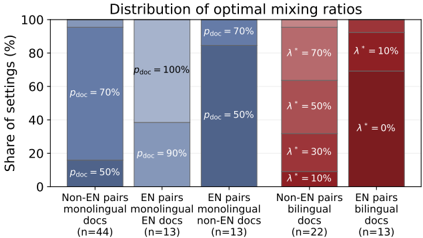
Figure 8: 최적 쿼리 혼합 비율의 분포. 단일 언어 설정은 로, 이중언어 설정은 (%)로 봉우리 위치를 표시한 누적 막대. 다섯 개 부분집합별로 봉우리가 어디에 몰리는지를 보여준다. (원논문)
최적 비율은 어디일까? Figure 8이 답한다. 문서 언어 일치 끝점이 끝점들 중에서는 최선이지만, 최선의 내부 혼합은 종종 끝점에서 살짝 떨어진 곳에 있다. 비영어 쌍의 단일 언어 문서 설정에서는 봉우리가 대개 근처다(44개 중 35개). 즉 쿼리에 문서 언어를 70% 담을 때 가장 좋다. 영어 쌍의 경우 봉우리가 이봉형(bimodal)이다. 영어 문서만 있는 설정에서는 대개 섞지 않는 게 최선이고(, 13개 중 8개), 비영어 문서 설정에서는 균형 혼합 근처가 최선인 경우가 많다(, 13개 중 11개). 마지막으로 영어가 없고 문서가 이중언어일 때는 대칭성(과 를 바꿔도 됨) 때문에 최적 비율이 정규분포처럼 퍼지고, 영어가 쌍에 있고 문서가 EN+일 때는 섞지 않는 것()이 봉우리다. 모두 앞서의 영어 지배 발견과 일관된다.
5.5 그 밖의 발견들
혼합은 최상위 순위보다 재현율에 더 영향을 준다. 혼합 효과가 nDCG를 넘어선다는 것을 보이려고, 같은 정의를 지표만 바꿔 다시 계산한다.
| Metric | Mean | #() | #() |
|---|---|---|---|
| nDCG@10 | 0.7037 | 88 | 17 |
| MRR@10 | 0.5844 | 88 | 17 |
| R@10 | 1.2021 | 98 | 7 |
Table 1 (원논문): 지표별 혼합 효과. 같은 (쌍, 문서 언어)에 대해 끝점 vs. 내부 비교를 수행하되 지표만 바꿨다.
세 지표가 어떤 설정이 혼합으로 이득을 보는지에 대해 대체로 합의한다. 다만 Recall@10의 평균 개선폭(1.2021)이 가장 크고 양의 경우도 98/105로 가장 많다. 특히 11개 설정에서 이면서 인데(모두 EN 쌍의 EN 단일 또는 EN+ 문서), 이는 혼합이 더 많은 관련 지문을 상위 10위 안으로 끌어오면서도 최상위 순서를 약간 흐트러뜨릴 수 있음을 뜻한다. 실무적으로는 리랭커(reranker)를 뒤에 붙이는 파이프라인이라면 재현율 향상이 곧 이득으로 이어진다는 점에서 의미가 있다.
영어를 제거하면 언어 요인들의 이차 효과는 약하다. 영어-문서 효과를 배제한 쌍 고유의 효과를 보려고 비영어 언어쌍의 단일 언어 문서로 제한하면 44개 설정(22쌍 × 2 문서 언어)이 남는다.
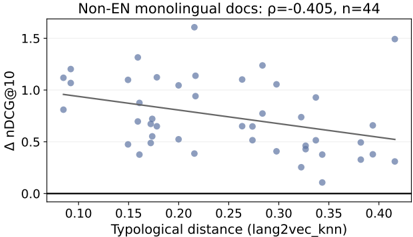
Figure 10: 언어쌍의 유형론적 거리 대 혼합 이득 (비영어 단일 문서, ). Spearman 의 음의 추세가 존재하지만 완만하다. (원논문)
Figure 10에서 유형론적 거리는 이 부분집합의 혼합 이득과 중간 정도의 음의 상관(, 95% CI )을 보인다. 언어가 유형론적으로 멀수록 혼합 이득이 줄어든다는 것인데, 두 언어의 표현이 근본적으로 이질적이면 보간이 만들어내는 상보성이 약해지기 때문으로 읽힌다. 나머지 세 요인(스크립트, 족, 자원)은 아래처럼 정리된다.
| Factor | 비영어 부분집합에서의 증거 |
|---|---|
| Script | 스크립트가 일치하는 쌍이 불일치 쌍보다 혼합 이득이 큼( vs. ); 평균 차이 , 95% CI |
| Family | 족 거리는 약한 음의 연관(, 95% CI ); 이진 족 분할은 뚜렷이 갈리지 않음 |
| Resource | 단조 추세는 없으나 저자원 쌍이 더 큰 평균 이득( for L-L vs. for H-H) |
Table 2 (원논문): 스크립트·족·자원 수준이 혼합 이득에 미치는 효과. 95% CI는 언어쌍에 대한 클러스터 부트스트랩. 약한 이차 효과만 보인다.
이 세 요인은 영어-문서 효과(5.3절)나 문서-언어 정렬(5.4절)에 비하면 이차적이다. 제한된 언어 집합에서 효과가 작고 깔끔하게 단조롭지도 않아서, 저자들은 이를 예측적(predictive)이라기보다 시사적(suggestive)이라고 조심스럽게 규정한다. 이런 절제된 태도가 오히려 논문의 신뢰도를 높인다.
혼합 이득은 최선의 단일 언어 끝점이 이미 얼마나 강한지에도 달렸다.
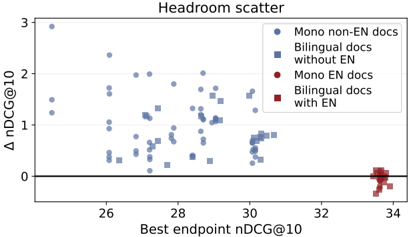
Figure 9: 대 더 강한 끝점의 nDCG@10(headroom scatter). 음의 추세는 주로 영어 문서 설정(오른쪽 하단 붉은 점 군집)이 이끈다. (원논문)
Figure 9는 가 더 나은 끝점 점수와 음의 상관()을 가짐을 보여준다. 단일 언어 끝점이 이미 강하면 보간이 개선할 여지(headroom)가 별로 없다는, 어찌 보면 당연한 이야기다. 흥미로운 건 이 추세가 영어 문서 설정(EN 쌍: )에 의해 주도되고, 문서에서 영어를 빼면 상관이 약해진다는() 점이다. 그림에서도 붉은 점(영어 문서)들이 오른쪽 하단(높은 끝점, 0 근처 )에 몰려 있고, 파란 점(비영어 문서)들은 왼쪽 위로 넓게 퍼진다. 결국 "영어 문서에서는 끝점이 이미 강해서 섞을 이유가 없다"는 5.3절의 결론과 자연스럽게 맞물린다.
이중언어 문서는 주로 영어가 없을 때 도움이 된다.
| Pair type | Mean Gain | #(Gains > 0) | #(Gains > 0.1) |
|---|---|---|---|
| Non-EN | 0.4475 | 21/22 | 19/22 |
| EN | 0.0101 | 8/13 | 3/13 |
Table 3 (원논문): 이중언어 문서의 이득. 두 단일 언어 문서 설정 중 나은 쪽 대비 이중언어 문서의 개선폭으로 측정. 비영어 쌍에서는 흔하지만 영어 쌍에서는 대체로 무시할 만하다.
같은 쿼리 집합을 고정한 채, 이중언어 문서 설정()에서의 점수를 두 단일 언어 문서 설정 중 나은 쪽과 비교한 것이다. 비영어 쌍은 평균 이득 0.4475에 22개 중 21개가 양수로, 문서를 두 언어로 채우는 것이 대체로 도움이 된다. 반면 영어를 포함한 쌍은 평균 0.0101로 사실상 효과가 없다. 여기서도 영어의 그림자가 어른거린다. 영어가 관여하면 검색기가 이미 영어 신호에 강하게 정렬되어 있어서, 문서 쪽을 이중언어로 만드는 추가 이득이 흡수되어 버리는 것이다.
6. Ablation: 모델 계열과 크기
발견들이 특정 모델의 특이성이 아니라 일반적 성질인지 확인하려고, 다른 다국어 임베딩 모델과 여러 크기의 Qwen3로 실험한다. Ablation은 10만 지문 부분집합(부록 §B)에서 평가한다. 대상은 multilingual-e5-large-instruct(Wang et al., 2024), gte-multilingual-base(Zhang et al., 2024), jina-embeddings-v3(Sturua et al., 2024), 그리고 Qwen3-Embedding-0.6B/4B/8B(Zhang et al., 2025)다.
| Setting | Index | E5 | GTE | Jina | Qwen3 (0.6B) | Qwen3 (4B) | Qwen3 (8B) |
|---|---|---|---|---|---|---|---|
| 영어 문서 ⇒ 끝점에 묶임 | |||||||
| EN-ZH | EN docs | −0.018 (10) | −0.054 (10) | −0.147 (10) | −0.188 (10) | +0.006 (30) | +0.053 (10) |
| EN-AR | EN docs | −0.042 (10) | −0.217 (10) | +0.010 (10) | −0.446 (10) | +0.002 (10) | +0.069 (10) |
| EN-DE | EN docs | +0.076 (10) | −0.037 (10) | +0.103 (10) | −0.019 (10) | +0.157 (10) | +0.053 (10) |
| 비영어 문서 ⇒ 내부 이득 | |||||||
| EN-ZH | ZH docs | +2.167 (70) | +2.528 (50) | +2.603 (50) | +2.619 (50) | +1.002 (30) | +0.843 (50) |
| EN-AR | AR docs | +5.684 (50) | +6.088 (30) | +4.331 (50) | +7.384 (50) | +1.789 (30) | +1.190 (30) |
| EN-DE | DE docs | +2.211 (50) | +2.434 (30) | +1.967 (30) | +2.753 (50) | +1.037 (30) | +0.235 (30) |
| EN이 최강 파트너 (ZH 문서 고정) | |||||||
| AR-ZH | ZH docs | +0.468 (90) | +0.116 (90) | +0.608 (70) | +0.454 (90) | +0.528 (70) | +0.702 (70) |
| EN-ZH | ZH docs | +2.167 (70) | +2.528 (50) | +2.603 (50) | +2.619 (50) | +1.002 (30) | +0.843 (50) |
| ID-ZH | ZH docs | +1.147 (70) | +1.022 (70) | +1.169 (70) | +0.912 (70) | +0.451 (70) | +0.572 (70) |
| ZH-RU | ZH docs | +0.988 (30) | +0.458 (30) | +1.366 (30) | +0.730 (30) | +0.441 (30) | +0.860 (30) |
Table 4 (원논문): 모델 계열과 Qwen3 크기 Ablation. 각 셀은 nDCG@10이고 괄호 안은 (%). (원논문에서는 셀이 의 부호·크기로 음영 처리됨: 파랑=양, 빨강=음.)
모델 계열. 5.3절의 영어-색인 효과가 네 계열 전부에서 일관된다. 영어가 색인되면(EN docs) 가 0 근처이고, 비영어 문서(ZH/AR/DE docs)에서는 혼합이 뚜렷한 이득을 낸다. 예컨대 EN-AR on AR docs에서 E5는 +5.684, GTE는 +6.088, Jina는 +4.331로 모두 크게 양수인 반면, EN-AR on EN docs에서는 −0.042, −0.217, +0.010으로 0 언저리다. 또한 ZH 문서를 고정하고 파트너를 바꾸는 검사에서 영어가 네 계열 모두에서 가장 강한 파트너임이 재확인된다(EN-ZH가 AR-ZH, ID-ZH, ZH-RU를 압도). 최선의 내부 혼합 위치도 모델을 바꿔도 안정적이다. 비영어 문서에서는 대개 균형() 근처, 영어 문서에서는 영어 끝() 근처다.
크기. Qwen3를 세 크기로 평가한 결과(표의 오른쪽 세 열), 영어 요인은 스케일링 아래서도 지속된다. 영어가 색인되면 가 0에 가깝고 비영어 문서에서는 양의 이득이 난다. 영어 문서 설정에서 이따금 양의 값(예: Qwen3-8B의 EN-ZH +0.053)이 나오지만, 비영어 문서 검색 이득에 비하면 훨씬 작아서 "혼합이 영어 검색을 개선하지 않는다"는 결론을 뒤집지 않는다. 눈여겨볼 점은 스케일이 커질수록 단일 언어 끝점 점수가 좋아지고, 그 결과 의 크기가 자연히 줄어든다는 것이다. EN-AR on AR docs에서 0.6B는 +7.384였지만 4B는 +1.789, 8B는 +1.190으로 줄어든다. 큰 모델일수록 애초에 잘하니 보간이 채울 여지가 작아진다는, Figure 9의 headroom 논리와 정확히 같은 이야기다. 그럼에도 패턴 자체(영어 경계, 균형 근처 최적, 영어 최강 파트너)는 바뀌지 않는다. 이로써 발견들이 단일 모델 크기나 계열을 넘어 일반적으로 성립한다고 결론짓는다.
7. 추가 실험 및 부록 (Appendix)
부록은 이 논문에서 결코 곁가지가 아니다. 프록시 정당화, 극저자원 확장, 번역 순도 문제, 그리고 실전 배포용 라우터까지, 본문의 주장을 떠받치거나 실용성으로 옮기는 핵심 근거가 여기 모여 있다.
7.1 단어 혼합 생성의 세부와 실패 사례 (Appendix A)
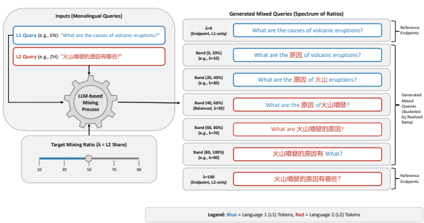
Figure 11: LLM을 통한 단어 수준 쿼리 혼합의 예시. 두 단일 언어 쿼리(EN, ZH)를 입력받아 목표 혼합 비율( = L2 share)에 따라 여러 밴드의 코드 믹싱 쿼리를 생성한다. 파랑=L1 토큰, 빨강=L2 토큰. (원논문)
Figure 11은 §3.2에서 쓴 단어 혼합 검증용 데이터를 어떻게 만드는지 보여준다. "What are the causes of volcanic eruptions?"와 그 중국어 번역을 입력으로, 0-20부터 80-100까지 다섯 밴드의 코드 믹싱 쿼리를 생성한다. 밴드가 올라갈수록 빨간(중국어) 토큰의 비율이 커지는 스펙트럼이 한눈에 들어온다.
생성 파이프라인은 꼼꼼하다. 먼저 Stanza(Qi et al., 2020) 토크나이저로 양쪽 언어 모두 6토큰 이상인 EN-ZH 병렬 쿼리만 남겨 2,883쌍을 얻는다(A.1). gpt-5-mini로 각 병렬 쌍에서 밴드별로 하나의 유창한 단문 코드 믹싱 쿼리를 생성하되, 주어진 EN·ZH 쿼리에서만 파생할 것, 단순 연결이 아닐 것, 같은 의미의 중복이 없을 것, 단어 대 단어 교대보다 유창성을 우선할 것 등의 제약을 건다(A.2, A.8). 실현된 ZH 비율은 다음처럼 측정한다(A.4).
여기서 , 은 Stanza가 각각 중국어·영어로 식별한 토큰 수(숫자만 있는 토큰은 제외)다. 밴드 목표는 중점에서 시작해 유지할 영어 토큰 수로 변환하고, 유계 피드백 루프로 목표 밴드에 맞을 때까지 재시도한다(A.5). 다섯 밴드 모두에서 수용된 쿼리 ID의 교집합을 취하면 1,484개 공통 쿼리가 남고, 이 고정 집합이 연구 전체의 평가 기준이 된다(A.6, A.7).
A.9의 실패 사례들이 특히 읽을 만하다. 의미 표류(semantic drift): 如果 you 有 gout?는 원 쿼리 "what foods are good if you have gout?"에서 핵심 의도("어떤 음식이 좋은가")가 통째로 빠진다. 약어 처리: k 在 silverado 中代表什么처럼 단일 문자 기호 k가 번역되지 않고 남아 짧은 쿼리에서 실현 비율을 흔든다. 중복(duplication): how does your 如 何 ... dna fit inside your cells처럼 의문사가 영어와 중국어로 이중 표기되어 부자연스러워진다. 이런 실패가 밴드마다 하나만 나도 해당 쿼리를 전 밴드에서 버려야 하므로, 모든 혼합 비율에서 품질을 보장하려면 과정이 극도로 자원 집약적이 된다. 임베딩 혼합이 왜 매력적인 대안인지를 역설적으로 증명하는 셈이다.
7.2 10만 mMARCO 부분집합 구성 (Appendix B)
색인 비용을 줄이되 언어 간 문서 정체성을 정렬해 유지하려고, 문서 ID로만 정의되는 고정 10만 문서 부분집합을 만든다. (1) BeIR/msmarco-qrels(validation split)에서 관련으로 판정된 모든 고유 문서 ID를 먼저 포함하고, (2) 컬렉션을 훑어 관련 집합에 없는 문서를 10만이 될 때까지 결정론적으로 채우며(샘플링 없음), (3) mMARCO의 언어 간 일관된 문서 식별자를 이용해 이 고정 집합을 모든 언어 색인에 그대로 반영한다. 결과적으로 언어별 색인은 서로 다른 텍스트를 담지만 동일한 10만 문서 집합에 대응한다.
7.3 더 많은 쌍에서의 단어 vs. 임베딩 혼합 (Appendix C.1)
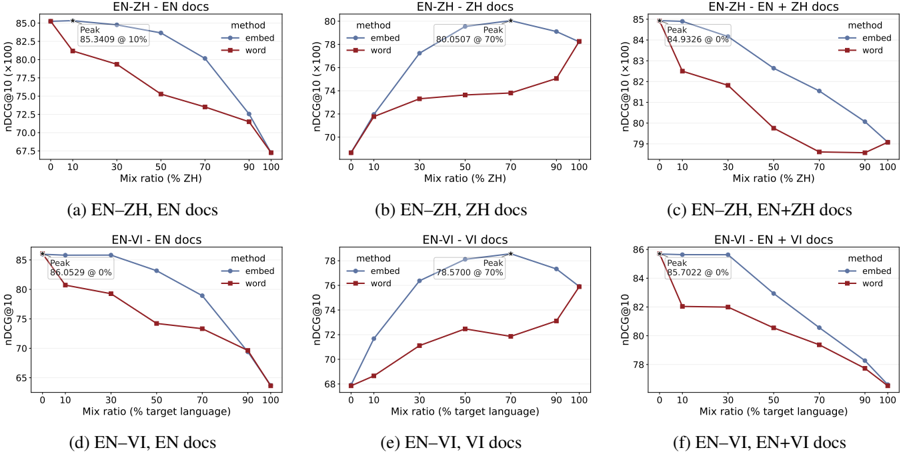
Figure 12: EN-ZH와 EN-VI 쌍의 단어 vs. 임베딩 혼합 비율 곡선. 각 쌍마다 세 문서 언어 설정(L1, L2, L1+L2)을 보인다. (원논문)
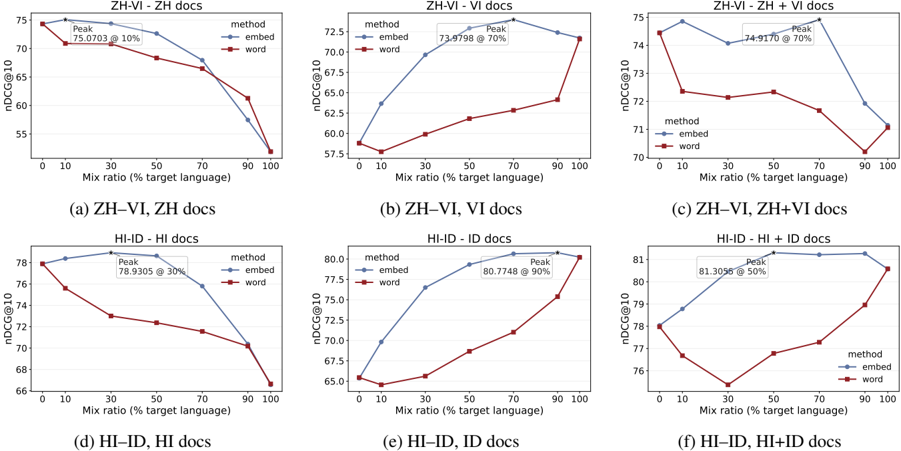
Figure 13: ZH-VI와 HI-ID 쌍의 단어 vs. 임베딩 혼합 비율 곡선. (원논문)
§4.1의 프록시 검증을 EN-ZH, EN-VI, ZH-VI, HI-ID 네 쌍으로 확장한다. 같은 10만 세팅, 같은 검색기(BGE-M3), 같은 비율 집합을 쓴다. Figure 12와 13이 보여주는 패턴이 일관된다. 최선의 단어 혼합 검색은 항상 순수 단일 언어 쿼리(0/100)에서 나오지만, 임베딩 혼합은 대개 내부 비율(10~90)에서 최선이다. 그리고 매칭되는 비율들(10, 30, 50, 70)에서 임베딩 혼합이 12개 설정 전부에서 단어 혼합을 앞서며, 평균 이득이 각각 +3.43, +5.36, +6.09, +5.25 nDCG@10이다.
이 두 그림은 두 가지를 못 박는다. 첫째, 임베딩 혼합은 한 쌍을 넘어 비율 추세의 유효한 프록시다. 둘째, 이득이 단순한 표면 단어 혼합으로 설명되지 않는다. 단어 혼합의 내부 지점들은 이 설정들에서 최선이 아니기 때문이다. 즉 임베딩 보간의 이득은 "쿼리에 목표 언어 단어를 끼워 넣는" 것 이상의 무언가에서 온다.
7.4 극저자원 언어로의 확장 (Appendix C.2)
원 mMARCO에는 밴드 0~2 언어가 없으므로, 영어와 다섯 저자원 언어를 짝지어 확장한다. 싱할라어(SI, 밴드 0), 네팔어(NE)·크메르어(KM, 밴드 1), 암하라어(AM)·스와힐리어(SW, 밴드 2)다. 문서는 NLLB-3.3B(NLLB Team et al., 2022)로, 쿼리는 gpt-5-mini로 번역했다.
| Pair | on EN docs | on docs | on docs | 95% CI on docs | on EN+ docs |
|---|---|---|---|---|---|
| EN-AM | 0.21 | 7.04 | 50 | [5.78, 7.90] | 0.13 |
| EN-KM | 0.13 | 2.82 | 50 | [2.09, 3.83] | −0.18 |
| EN-NE | 0.15 | 2.86 | 50 | [2.05, 3.75] | 0.13 |
| EN-SI | 0.03 | 4.60 | 50 | [3.47, 5.67] | −0.03 |
| EN-SW | 0.13 | 4.32 | 30 | [3.55, 5.12] | 0.06 |
Table 5 (원논문): 다섯 저자원 언어를 영어와 짝지은 확장. 각 행은 같은 10만 세팅·비율 집합에서의 (혼합 이득).
다섯 저자원 설정 모두 문서에서 가 양수이고 95% 신뢰구간이 엄격히 0 위에 있으며, 평균 이다. 최적 비율은 다섯 중 넷이 균형()이고 스와힐리어만 영어 쪽에 약간 가까운 이다. 반면 영어 포함 설정에서는 뚜렷한 이득이 없다. EN 단일 문서 평균 +0.13, EN+ 문서 평균 +0.02이고 열 개 신뢰구간이 모두 0을 가로지른다. 자원이 극도로 희박한 언어에서 혼합 이득이 오히려 큰 것(EN-AM +7.04)은, 저자원 언어의 단일 언어 표현이 약해서 영어라는 앵커가 채울 여지가 크다는 headroom 논리와 완벽히 들어맞는다. 본문의 관찰이 mMARCO가 다루는 자원 범위를 넘어서도 유지되는 셈이다.
7.5 순수 단일 언어 문서·쿼리에서의 검증 (Appendix C.3)
임베딩 혼합 이득이 혹시 번역의 불순물, 즉 문서나 쿼리에 여전히 남아 있는 영어 단어 때문은 아닐까? 이를 걸러내기 위해 비라틴 언어(AR, HI, JA, RU, ZH)만 골라, 라틴 문자열이 조금이라도 있으면 불순(impure)으로 분류하고 순수한 것만 남겨 실험을 재수행한다.
| Language | Pure docs | Pure share (%) |
|---|---|---|
| AR | 4,810,036 | 54.4 |
| HI | 6,805,767 | 77.0 |
| JA | 4,573,928 | 51.7 |
| RU | 4,964,775 | 56.2 |
| ZH | 4,180,503 | 47.3 |
Table 6 (원논문): 문서 순도 검사. 원 데이터셋은 8.8백만 문서. 'Pure'는 라틴 문자가 없는 엄격한 단일 언어 문서.
| Document setup | Avg. No. Queries Kept | % |
|---|---|---|
| L1-only docs | 892.4 | 60.1 |
| L2-only docs | 822.3 | 55.4 |
| L1+L2 docs | 724.1 | 48.8 |
| All settings | 812.9 | 54.8 |
Table 7 (원논문): 순도 기반 쿼리 필터링의 효과. 기준선은 필터링 전 설정당 1,484 쿼리.
Table 6에서 보듯 순수 문서 비율이 언어에 따라 47~77%로, 번역 코퍼스에 라틴 잔여물이 상당하다. 중국어는 절반 이하(47.3%)만 순수하다. 쿼리도 필터링하면 설정당 평균 812.9개(54.8%)만 남는다.
| Statistic | Value |
|---|---|
| nDCG@10 > 0 | 37/45 (mean = +0.3347) |
| MRR@10 > 0 | 35/45 |
| Recall@10 > 0 | 36/45 |
| EN in index (mean ) | −0.0221 (6/10 negative) |
| EN not in index (mean ) | +0.4367 (2/35 negative) |
| Largest gain | EN-HI on HI docs (+1.7161) |
Table 8 (원논문): 순도 필터링 결과의 주요 지표.
Table 8이 핵심 반박을 제공한다. 순도 필터링 후에도 결론은 유지된다. 영어가 색인에 없을 때 혼합이 가장 도움이 되고(평균 +0.4367), 있을 때는 훨씬 덜하다(평균 −0.0221). 다만 필터링 후 평균 이득은 +0.3347로, 필터링 전(+0.7037)보다 작다. 이는 문서 속 영어 단어가 비필터링 코퍼스에서 이득의 일부를 만든다는 것을 뜻한다. 하지만 절반 넘게 줄어든 게 아니라 여전히 상당한 이득이 남으므로, 혼합의 이점이 단순 어휘 매칭을 넘어선다는 주장은 살아남는다.
무엇이 불순물인지를 이해하려고, 이미 불순으로 표시된 판정 관련 ZH 문서를 감사한다(ChatGPT 5.4로 분류 지원).
| Impurity label present in document | Docs | Share (%) |
|---|---|---|
| English named strings | 418 | 56.4 |
| Acronyms / abbreviations | 352 | 47.5 |
| Structured codes / measures | 128 | 17.3 |
| Common English lexical items | 92 | 12.4 |
| Encoding garble | 73 | 9.9 |
| Source or template residue | 30 | 4.1 |
| Romanized non-English or Latin scientific terms | 12 | 1.6 |
Table 9 (원논문): 741개 감사된 불순 판정 관련 ZH 문서에 나타난 불순물 라벨. 한 문서가 여러 행에 기여할 수 있다.
가장 흔한 불순물은 영어 개체명(56.4%; 인명·지명·브랜드·제목)과 약어(47.5%; 기관명·의학 용어 등)다. 38.2%의 문서가 둘 이상의 라벨을 갖고, 가장 흔한 조합은 영어 개체명 + 약어(전체의 15.1%)다. 요컨대 불순물은 대부분 영어로 두는 게 자연스러운 개체·약어·코드에서 온다. 이는 원 데이터셋의 번역 품질이 적절하며, 혼합의 이득이 단순 어휘 매칭을 넘어선다는 점을 다시 뒷받침한다.
7.6 최적 혼합 비율을 위한 경량 라우터 (Appendix C.4)
5.4절에서 관찰한 비율 패턴을 실전 규칙으로 옮길 수 있을까? 저자들은 언어쌍과 문서 언어 설정 만으로 최적 혼합 비율을 예측하는 경량 정책 라우터를 시험한다. 결정적으로, 이 라우터는 추론 시 어떤 쿼리·문서 텍스트 특징도 계산하지 않는다. 학습 셋에서 각 설정별로 비율마다 평균 nDCG@10을 구해, 가장 높은 점수를 내는 비율을 저장하는 단순 룩업 테이블(lookup table)일 뿐이다. 런타임에는 저장된 최적 비율을 즉시 적용하는 제로 비용 조회만 한다.
| Held-Out Evaluation Metric | Value |
|---|---|
| Settings matching oracle optimal ratio | 200 / 273 |
| Mean nDCG@10 (Router Policy) | 29.3483 |
| Mean nDCG@10 (Oracle Upper Bound) | 29.3981 |
| Mean nDCG@10 (Global 50% Baseline) | 28.8432 |
| Mean gain over best monolingual endpoint | +0.7190 |
| Upper-bound theoretical mean gain | +0.7634 |
| Wins / Ties / Losses vs. best monolingual | 251 / 14 / 8 |
Table 10 (원논문): 경량 라우터의 held-out 결과. 'best monolingual endpoint'는 쿼리 언어를 문서 언어에 맞추는 표준 관행을 뜻한다.
이 저비용 라우터가 273개 설정 중 200개에서 정확히 최적 비율을 고른다. 전체 성능(29.3483)은 이론적 오라클 상한(29.3981)에 놀라울 만큼 가깝다. 잠재 이득의 거의 전부를 회수한다는 뜻이다. 단일 언어 끝점 대비 평균 +0.7190 이득(상한 +0.7634), 승/무/패는 251/14/8이다. 고정 50% 혼합을 전역 적용하는 나이브 기준선(28.8432)도 넘는다. 결론은 실용적으로 묵직하다. 테스트 시 쿼리 혼합에 복잡한 동적 특징 추출이 반드시 필요한 것은 아니며, 약간의 튜닝 데이터만 있으면 제로 연산 정책 테이블로 다국어 검색을 신뢰성 있게 끌어올릴 수 있다.
7.7 추가 발견 (Appendix D)
영어가 최강의 혼합 파트너 - 전체 결과. Figure 6을 뒷받침하는 13개 언어 전수 결과다.
| Doc language () | # partners | Partner languages ranked by on -only documents |
|---|---|---|
| AR | 3 | EN (+2.92) > ZH (+1.49) > HI (+1.24) |
| DE | 5 | EN (+1.80) > IT (+0.94) > NL (+0.81) > ES (+0.74) > FR (+0.67) |
| ES | 6 | EN (+1.66) > PT (+0.70) > NL (+0.65) > FR (+0.65) > IT (+0.47) > DE (+0.25) |
| FR | 6 | EN (+1.29) > NL (+0.55) > IT (+0.52) > ES (+0.52) > DE (+0.49) > PT (+0.38) |
| HI | 4 | EN (+1.97) > AR (+0.77) > JA (+0.49) > ZH (+0.43) |
| ID | 3 | EN (+1.32) > ZH (+0.41) > VI (+0.39) |
| IT | 6 | EN (+1.72) > DE (+1.14) > NL (+1.12) > ES (+1.10) > PT (+1.07) > FR (+1.05) |
| JA | 4 | EN (+1.13) > RU (+0.38) > HI (+0.33) > ZH (+0.11) |
| NL | 5 | EN (+2.01) > DE (+1.12) > ES (+1.10) > FR (+0.72) > IT (+0.65) |
| PT | 4 | EN (+1.69) > ES (+1.32) > IT (+1.20) > FR (+0.88) |
| RU | 3 | EN (+1.99) > JA (+0.66) > ZH (+0.51) |
| VI | 2 | EN (+2.36) > ID (+1.61) |
| ZH | 6 | EN (+1.72) > ID (+1.06) > RU (+0.93) > HI (+0.46) > JA (+0.38) > AR (+0.31) |
Table 12 (원논문): 단일 언어 색인에서 영어가 가장 강한 혼합 파트너. 각 비영어 문서 언어 에 대해 단일 색인으로 고정하고 파트너 언어를 로 정렬. 13개 언어 전부에서 영어가 최대 .
Table 12의 위력은 예외가 없다는 데 있다. 13개 언어 전부에서 영어가 1위이고, 대개 2위와의 격차가 크다. AR 문서에서 EN(+2.92)은 ZH(+1.49)의 거의 두 배이고, VI 문서에서 EN(+2.36)은 유일한 대안 ID(+1.61)를 여유 있게 앞선다. 유일하게 접전인 곳은 ES 문서(EN +1.66 vs PT +0.70)나 FR 문서(EN +1.29 vs NL +0.55)처럼 유럽어 이웃이 많은 경우인데, 그마저도 영어가 이긴다. 이 표 하나만으로도 "영어는 특별하다"는 논문의 주장이 통계적 우연이 아님을 납득하게 된다.
최적 쿼리 비율 - 전체 결과. Figure 8을 보완하는 전수 표다.
| Pair | Document Index | # | Peak Location | Count |
|---|---|---|---|---|
| Non-EN | Monolingual; L1/L2-only | 44 | =0.7 / 0.5 / 0.9 | 35 / 7 / 2 |
| with EN | Monolingual; EN-only | 13 | =1.0 / 0.9 | 8 / 5 |
| with EN | Monolingual; non-EN-only | 13 | =0.5 / 0.7 | 11 / 2 |
| Non-EN | Bilingual; L1+L2 | 22 | =10 / 30 / 50 / 70 / 90 | 2 / 5 / 7 / 7 / 1 |
| with EN | Bilingual; EN+L2 | 13 | =0 / 10 / 30 | 9 / 3 / 1 |
Table 11 (원논문): 최적 쿼리 혼합 비율. 단일 언어 문서 설정은 로, 이중언어 설정은 (%)로 봉우리 위치를 보고.
Table 11은 5.4절의 관찰을 숫자로 확정한다. 비영어 단일 문서에서 봉우리는 압도적으로 (44개 중 35개)이고, 영어 단일 문서에서는 섞지 않는 쪽(, 13개 중 8개)이며, 영어 쌍이지만 비영어 문서일 때는 균형(, 13개 중 11개)이다. 이중언어 문서에서도 영어 유무가 결정적이다. 영어가 없으면 가 50 주변에 대칭으로 퍼지지만(50과 70이 각 7개), 영어가 있으면 (섞지 않음)이 13개 중 9개로 몰린다.
모델 계열 Ablation - 전체 결과. Table 4의 확장판으로, 네 계열(E5, GTE, Jina, Qwen 0.6B)에 대해 DE·AR·RU 문서 파트너 검사를 추가한다.
| Setting | Index | E5 | GTE | Jina | Qwen (0.6B) |
|---|---|---|---|---|---|
| 영어 색인 ⇒ 끝점에 묶임 | |||||
| EN-ZH | EN docs | −0.0175 (10) | −0.0544 (10) | −0.1473 (10) | −0.1878 (10) |
| EN-AR | EN docs | −0.0422 (10) | −0.2170 (10) | +0.0103 (10) | −0.4459 (10) |
| EN-DE | EN docs | +0.0755 (10) | −0.0371 (10) | +0.1034 (10) | −0.0194 (10) |
| 비영어 색인 ⇒ 내부 이득 | |||||
| EN-ZH | ZH docs | +2.1673 (70) | +2.5284 (50) | +2.6031 (50) | +2.6185 (50) |
| EN-AR | AR docs | +5.6839 (50) | +6.0879 (30) | +4.3305 (50) | +7.3837 (50) |
| EN-DE | DE docs | +2.2110 (50) | +2.4341 (30) | +1.9674 (30) | +2.7530 (50) |
| ZH 문서: EN이 최강 파트너 | |||||
| AR-ZH | ZH docs | +0.4680 (90) | +0.1159 (90) | +0.6077 (70) | +0.4542 (90) |
| EN-ZH | ZH docs | +2.1673 (70) | +2.5284 (50) | +2.6031 (50) | +2.6185 (50) |
| ID-ZH | ZH docs | +1.1465 (70) | +1.0216 (70) | +1.1687 (70) | +0.9120 (70) |
| ZH-RU | ZH docs | +0.9883 (30) | +0.4582 (30) | +1.3659 (30) | +0.7300 (30) |
| DE 문서: EN > NL | |||||
| DE-NL | DE docs | +0.6357 (30) | +1.9691 (50) | +1.0221 (30) | +1.1582 (30) |
| EN-DE | DE docs | +2.2110 (50) | +2.4341 (30) | +1.9674 (30) | +2.7530 (50) |
| AR 문서: EN > ZH | |||||
| AR-ZH | AR docs | +3.0493 (50) | +4.4727 (50) | +1.8877 (30) | +5.7645 (50) |
| EN-AR | AR docs | +5.6839 (50) | +6.0879 (30) | +4.3305 (50) | +7.3837 (50) |
| RU 문서: EN > ZH | |||||
| ZH-RU | RU docs | +0.7890 (70) | +1.6164 (70) | +0.9810 (70) | +2.1950 (50) |
| EN-RU | RU docs | +2.2780 (50) | +2.7728 (50) | +3.3136 (50) | +3.9388 (50) |
Table 13 (원논문): 모델 계열 Ablation(10만 부분집합 색인). 각 셀은 nDCG@10(퍼센트 포인트), 괄호는 (%). 계열을 가로질러 영어-색인 경계(5.3절)가 지속되고, 문서 언어 고정 파트너 검사가 영어=최강 파트너를 강화한다.
Table 13은 파트너 검사를 DE, AR, RU 문서로 넓혀 영어 우위를 못 박는다. 어떤 비영어 문서 언어를 고정하든, 그리고 어떤 모델 계열을 쓰든, 영어를 파트너로 넣은 쌍이 같은 문서에서 다른 파트너 쌍을 이긴다. 예컨대 AR 문서에서 EN-AR(+5.68~+7.38)이 AR-ZH(+1.89~+5.76)를, RU 문서에서 EN-RU(+2.28~+3.94)가 ZH-RU(+0.79~+2.20)를 모든 계열에서 앞선다. 저자들의 해석은 간명하다. 임베딩 모델은 대개 웹 코퍼스에서 비지도로 학습되므로 언어 표현이 서로 비슷하고, 그 안에서 영어가 지배적이라는 것. 방법이 아니라 데이터가 만든 편향이기에 계열을 넘어 재현된다.
8. 강점과 한계
강점
- 값싸고 정밀한 진단 도구. 임베딩 보간이라는 아이디어 자체가 이 논문의 가장 큰 기여다. 인코더를 한 번만 부르고 나머지는 벡터 산술로 처리하므로, 105개 조건 × 7개 비율이라는 방대한 격자를 LLM 생성 없이 훑을 수 있다. Figure 3~4와 Figure 12~13이 이 프록시가 단어 수준 혼합의 추세를 충실히 따른다는 것을 반복 검증해, 도구의 정당성이 탄탄하다.
- 하나의 강력하고 실행 가능한 발견. "영어가 색인에 있으면 순수 영어 쿼리를, 없으면 섞어라"는 결론은 다국어 RAG를 운영하는 사람에게 즉시 쓸 수 있는 규칙이다. Table 10의 라우터는 이 규칙이 제로 연산으로 오라클의 99.8%(29.3483 / 29.3981)를 회수함을 보여준다.
- 철저한 강건성 검증. 모델 계열 4종(Table 4, 13), Qwen3 크기 3종, 극저자원 5개 언어(Table 5), 순도 필터링(Table 6~9)까지, 발견이 무너질 만한 지점을 저자들이 먼저 찾아가 막아둔다. 특히 C.3의 순도 실험은 "이득이 번역 잔여 영어 단어 탓 아니냐"는 가장 날카로운 반론을 정면으로 반박한다.
- 절제된 주장. 스크립트·족·자원 요인을 "예측적이 아니라 시사적"이라고 명시하고(Table 2), 부트스트랩 구간으로 88/105 중 66개만 신뢰성 있게 양수임을 투명하게 밝힌다. 과장 없이 데이터가 말하는 만큼만 말한다.
한계 및 아쉬운 점
- 번역된 병렬 쿼리라는 인공적 설정. 저자들도 한계에서 인정하듯, 이 연구는 의미가 고정된 병렬 번역을 섞을 뿐 자연스럽게 타이핑된 코드 믹싱 쿼리(철자 변이, 음차, 불규칙한 전환점, LID 오류)를 다루지 않는다. EN-ZH 단어 혼합과 세 추가 쌍(C.1)으로 간극을 줄였지만, 여전히 통제된 생성 테스트일 뿐 실제 사용자 쿼리의 전 범위를 담지는 못한다.
- mMARCO에 묶인 언어·번역. 정렬된 쿼리와 비교 가능한 문서 컬렉션이 필요해 mMARCO가 제공하는 언어와 번역에 의존한다. 새 번역을 만들면 품질 관리가 별개 프로젝트가 되어버리기 때문인데, 그 결과 커버되는 언어쌍이 제한적이고 쌍의 수도 조합적으로 폭증하는 문제를 회피하는 선에서 멈춘다.
- 왜 λ≈70인가에 대한 기계론적 설명 부재.* 비영어 단일 문서에서 봉우리가 에 몰린다는 관찰(Table 11)은 흥미롭지만, 왜 하필 70인지에 대한 이론적 근거는 제시되지 않는다. "언어 정렬과 의미 강화의 트레이드오프"라는 설명은 방향은 맞지만 정량적이지 않아서, 다른 데이터셋·모델에서 이 70이 옮겨갈지는 미지수다.
- 영어 앵커 가설의 간접성. 영어가 "보편적 앵커"라는 해석은 매력적이지만, 사전학습 데이터 불균형이라는 원인은 직접 측정된 게 아니라 정황(웹 코퍼스의 영어 비중)에서 추론된다. 벡터 공간의 밀도나 등방성(isotropy) 같은 내재적 지표로 이 가설을 직접 검증했다면 훨씬 강한 주장이 됐을 것이다.
- 라우터의 일반화 범위. Table 10의 라우터는 룩업 테이블이라 학습 셋에 등장한 조합에만 답할 수 있다. 새로운 언어쌍이나 문서 구성에 대한 콜드 스타트(cold start) 전략은 비어 있다. 유형론적 거리 같은 메타데이터로 비율을 예측하는 회귀 라우터가 후속으로 자연스러워 보인다.
9. 마치며
이 논문의 미덕은 화려한 새 모델이 아니라, 잘 벼려진 질문과 그 질문에 답하는 값싼 도구에 있다. "언어를 섞으면 검색이 나아지는가?"라는 소박한 물음을 임베딩 보간이라는 렌즈로 105개 조건에 걸쳐 통제 실험한 결과, 답은 단순한 예/아니오가 아니라 구조를 가진 지도(map)로 나왔다. 섞으면 대체로 이득이고, 손해는 작으며, 무엇보다 영어가 색인에 있느냐가 모든 것을 가른다.
가장 오래 남는 통찰은 영어의 비대칭적 지배다. 비영어 쿼리에 영어를 더하면 비영어 문서 검색이 좋아지지만 그 역은 성립하지 않고, 영어는 13개 언어 전부에게 최강의 혼합 파트너다. 이것을 저자들은 사전학습 데이터 불균형이 벡터 공간에 새긴 흔적, 즉 영어가 다른 언어들을 더 좋은 표현 영역으로 끌어당기는 앵커라는 가설로 풀어낸다. 현재의 다국어 임베딩 모델이 얼마나 영어 중심적으로 조직되어 있는지를, 성능표가 아니라 기하로 드러낸 셈이다.
실무적으로는 두 가지를 가져갈 만하다. 첫째, 다국어 RAG에서 영어를 포함하는 색인을 검색할 때는 굳이 섞지 말고 순수 영어 쿼리를 기본으로 두는 게 안전하다. 둘째, 비영어 색인에서는 임베딩 혼합이 추가 학습 없는 테스트 타임 증강(test-time augmentation)으로 재현율을 끌어올린다. 그리고 이 판단을 자동화하는 데 복잡한 특징 추출이 필요 없다는 것, 언어쌍과 문서 언어만 보는 제로 연산 룩업 테이블로 잠재 이득의 거의 전부를 회수할 수 있다는 것이 마지막 선물이다.
후속 방향으로 저자들이 제시하는 것은 자연스럽게 발생한 코드 믹싱 쿼리로의 확장과, 두 개를 넘어 여러 언어를 동시에 보간하는 것이다. 특히 후자는 저자원·고다양성 환경에서 테스트 타임 스케일링의 새로운 축이 될 수 있다는 점에서 눈여겨볼 만하다. 값싼 진단 도구 하나가 열어젖힌 문이 생각보다 넓다.
References
- Chen et al., 2024. "BGE M3-Embedding: Multi-lingual, multi-functionality, multi-granularity text embeddings through self-knowledge distillation." (BGE-M3)
- Bonifacio et al., 2022. "mMARCO: A multilingual version of the MS MARCO passage ranking dataset."
- Bajaj et al., 2018. "MS MARCO: A human generated machine reading comprehension dataset."
- Kim et al., 2025. "MiLQ: Benchmarking IR models for bilingual web search with mixed language queries."
- Karpukhin et al., 2020. "Dense passage retrieval for open-domain question answering." (DPR)
- Izacard et al., 2022. "Unsupervised dense information retrieval with contrastive learning." (Contriever)
- Zhang et al., 2023a. "Multilingual large language models are not (yet) code-switchers."
- Aguilar et al., 2020. "LinCE: A centralized benchmark for linguistic code-switching evaluation."
- Khanuja et al., 2020. "GLUECoS: An evaluation benchmark for code-switched NLP."
- Goot et al., 2025. "DistaL: A comprehensive collection of language distance measures."
- Joshi et al., 2020. "The state and fate of linguistic diversity and inclusion in the NLP world."
- Kudugunta et al., 2023. "MADLAD-400: A multilingual and document-level large audited dataset."
- Wang et al., 2024. "Multilingual E5 text embeddings: A technical report."
- Zhang et al., 2024. "mGTE: Generalized long-context text representation and reranking models for multilingual text retrieval."
- Sturua et al., 2024. "jina-embeddings-v3: Multilingual embeddings with task LoRA."
- Zhang et al., 2025. "Qwen3 embedding: Advancing text embedding and reranking through foundation models."
- NLLB Team et al., 2022. "No language left behind: Scaling human-centered machine translation."
- Douze et al., 2024. "The Faiss library."
- Qi et al., 2020. "Stanza: A Python natural language processing toolkit for many human languages."