논문 리뷰
논문 리뷰: Linear-Time and Constant-Memory Text Embeddings Based on Recurrent Language Models
Mamba2·RWKV·xLSTM 같은 순환(recurrent) 언어 모델을 텍스트 임베더로 파인튜닝하고, 레이어 방향으로 시퀀스를 잘라 처리하는 "수직 청킹(vertical chunking)" 추론 전략을 도입해 입력 길이와 무관하게 메모리가 상수로 수렴하는 임베딩 모델을 만든 연구.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Linear-Time and Constant-Memory Text Embeddings Based on Recurrent Language Models |
| 저자 | Tobias Grantner (Dynatrace Research), Emanuel Sallinger (TU Wien & University of Oxford), Martin Flechl (Dynatrace Research) |
| 게재 | arXiv preprint, 2026 |
| 논문 링크 | arXiv:2604.18199 |
| 키워드 | 텍스트 임베딩, 순환 언어 모델, Mamba2, 선형 시간, 상수 메모리 |
1. 들어가며
RAG나 시맨틱 검색이 실무의 기본기가 되면서 텍스트 임베딩 모델의 성능 경쟁은 치열해졌지만, 정작 "긴 문서를 어떻게 값싸게 임베딩할 것인가"라는 질문은 상대적으로 덜 다뤄졌다. 지금 SOTA를 찍고 있는 임베딩 모델은 대부분 디코더 기반 트랜스포머(E5-mistral-7b 계열)인데, 트랜스포머는 태생적으로 시퀀스 길이에 대해 계산량이 제곱(quadratic), 메모리가 선형(linear)으로 늘어난다. 32K 토큰짜리 문서 하나를 임베딩하려고 80GB H100의 메모리를 꽉 채우는 상황이 실제로 벌어진다.
이 문제를 정면으로 겨냥한 것이 이 논문이다. 아이디어 자체는 단순하다. 트랜스포머 대신 선형 시간·상수 메모리로 동작하는 순환 아키텍처(Mamba2, RWKV, xLSTM)를 임베더로 쓰면 되지 않겠느냐는 것이다. 순환 모델은 텍스트 생성(autoregressive generation) 맥락에서는 이미 효율성이 잘 정리되어 있지만, 임베딩 생성처럼 "입력 전체를 한 번에 인코딩"하는 상황에서의 동작은 놀랄 만큼 덜 연구되어 있었다. 기존 연구도 작은 태스크 특화 모델 수준에 머물러 있었다.
저자들이 던지는 질문은 두 갈래다. 첫째, 순환 모델을 범용(general-purpose) 임베더로 파인튜닝하면 트랜스포머와 견줄 만한 품질이 나오는가? 둘째, 순환 모델의 "입력 인코딩" 단계를 어떻게 스케줄링해야 계산 병렬성과 메모리 효율을 동시에 챙길 수 있는가? 이 논문은 첫 질문에 대해 MTEB·Multilingual MTEB·LongEmbed 세 벤치마크로, 둘째 질문에 대해 Mamba2의 이중성(duality)을 활용한 수직 청킹 추론 전략으로 답한다. 그리고 그 전략이 Mamba2뿐 아니라 RWKV·xLSTM에도 그대로 통한다는 걸 실험으로 확인한다.
2. 기존 연구의 한계
2.1 임베딩 모델 학습의 흐름
트랜스포머는 사실상 텍스트 임베딩의 표준 아키텍처다. 초기에는 BERT 같은 마스크 언어 모델(masked language model)을 다단계 약지도(weak supervision)로 적응시키는 방식이 주류였다. 판을 바꾼 건 E5-mistral-7b(Wang et al., 2024)다. 이 모델은 디코더 전용(decoder-only) 자기회귀 언어 모델을 다양한 합성·주석 데이터로 파인튜닝하는 패러다임을 정립했다. 이후 합성 데이터 생성 기법이 좋아지고, 더 강한 파운데이션 모델이 등장하고, 학습 절차가 길어지면서 성능이 개선됐지만, E5-mistral-7b는 여전히 오픈웨이트 범용 임베딩 모델 중에서 경쟁력을 유지하고 있다. 이 논문이 학습 레시피의 기준점으로 E5-mistral-7b를 그대로 채택한 이유이기도 하다.
2.2 효율적인 임베딩 추론
트랜스포머의 추론 효율은 대개 어텐션 최적화나 양자화(quantization)로 챙긴다. FlashAttention은 타일링(tiling)으로 제곱 크기의 어텐션 행렬을 메모리에 물리적으로 만들지 않으면서, 어텐션 계산의 메모리 사용량을 시퀀스 길이에 대해 제곱에서 선형으로 줄인다. 슬라이딩 윈도우 어텐션(sliding-window attention)은 문맥을 고정 크기 지역 윈도우로 제한해 계산 복잡도를 선형으로 낮추지만, 그만큼 표현력을 희생한다. 양자화는 가중치와 활성값을 저정밀도로 표현해 메모리를 아낀다. 극단적으로 정적 임베딩(static embedding) 모델은 상수 메모리에 최고 효율을 내지만, 품질이 트랜스포머에 크게 못 미친다.
여기서 핵심은, 이 모든 최적화가 어텐션 계산 자체의 근본적 복잡도를 바꾸지는 못한다는 점이다. FlashAttention이 메모리를 선형으로 줄여도 계산량은 여전히 제곱이고, 슬라이딩 윈도우는 표현력을 깎아 선형을 얻는다. 근본적으로 다른 스케일링을 원한다면 아키텍처를 바꿔야 한다.
2.3 순환 언어 모델
순환 신경망(RNN)은 상수 크기의 잠재 상태(latent state)를 유지하면서 입력 길이에 선형으로 스케일한다. 전통적 RNN은 대규모 학습에 필요한 병렬화가 안 된다는 게 치명적 약점이었는데, Mamba2·RWKV·xLSTM 같은 현대적 변종들은 상태 업데이트를 병렬로 계산할 수 있는 구조화된 순환(structured recurrence) 메커니즘을 도입해 이 문제를 풀었다. 이들의 텍스트 생성 능력은 폭넓게 연구됐지만, 범용 임베더로서의 잠재력은 상대적으로 방치되어 있었다. 바로 이 공백이 이 논문의 출발점이다.
3. 핵심 아이디어
이 논문의 기여는 두 층위로 나뉜다.
첫째는 아키텍처 이식이다. E5-mistral-7b의 대조 학습(contrastive learning) 레시피를 순환 모델(Mamba2)에 거의 그대로 적용해, 순환 모델도 트랜스포머와 견줄 만한 범용 임베더가 될 수 있음을 보인다. 새로운 손실 함수나 학습 트릭을 발명한 게 아니라, "같은 레시피, 다른 백본"이라는 통제된 비교를 통해 아키텍처의 순수 효과를 드러낸다는 점이 실험 설계의 미덕이다.
둘째는 추론 스케줄링이다. 여기가 진짜 기술적 알맹이다. Mamba2는 같은 출력을 두 가지 시선으로 계산할 수 있는 이중성(duality)을 갖는다. 하나는 메모리 효율적이지만 순차적인 순환 뷰(recurrent view)이고, 다른 하나는 완전 병렬화되지만 제곱 메모리를 먹는 행렬 뷰(matrix view)다. 저자들은 이 둘을 시퀀스 방향으로 섞는 **청크 추론(chunked inference)**을 정리하고, 여기서 한 발 더 나아가 시퀀스를 레이어 방향으로도 잘라 처리하는 **수직 청킹(vertical chunking)**을 제안한다.
수직 청킹의 통찰은 이렇다. 표준적인 "수평(horizontal)" 추론은 전체 시퀀스를 한 레이어씩 통과시키는데, 이러면 현재 레이어의 전체 시퀀스 활성값을 메모리에 들고 있어야 해서 메모리가 시퀀스 길이 에 선형으로 는다. 반대로 시퀀스를 고정 크기 블록 로 잘라 한 블록을 모든 레이어에 먼저 통과시킨 뒤 다음 블록으로 넘어가면, 메모리에 들고 있어야 할 건 현재 블록의 활성값과 레이어당 하나씩의 순환 상태뿐이다. 이면 메모리가 시퀀스 길이와 무관해진다. 병렬화는 블록 크기 만큼만 되지만, 현대 하드웨어는 생각보다 작은 시퀀스 길이에서 이미 연산 한계(compute-bound)에 도달하므로 손해가 거의 없다. 결국 "수평 추론의 속도를 유지하면서 순환의 확장성을 얻는" 절충이 성립한다.
그리고 이 전략은 Mamba2에만 갇혀 있지 않다. (i) 입력 시퀀스에 대한 선형 시간 순환 구조와 (ii) 그 순환과 짝을 이루는 병렬화 가능한 이중 형식(dual formulation), 이 두 성질만 있으면 적용된다. RWKV와 xLSTM이 정확히 이 조건을 만족한다.
4. 제안 방법 (Method)
4.1 학습: E5-mistral-7b 레시피의 이식
학습 절차는 E5-mistral-7b의 대조 학습 레시피를 따른다. 사전학습된 모델 이 주어지면, 언어 모델링 헤드(language modeling head)를 떼어내 을 만든다. 입력 시퀀스 의 끝에 모델의 EOS(end-of-sequence) 토큰 를 붙이고, 마지막 레이어에서 이 EOS 위치의 출력 를 앞선 문맥 전체의 요약으로 본다. 이것이 곧 입력 텍스트의 표현이다.
이렇게 얻은 는 가변 길이 텍스트를 고정 크기 차원 벡터로 사상한다. 파인튜닝은 InfoNCE 손실로 이뤄진다. 관련 있는 양성 쌍(positive pair)을 여러 음성 예제(negative)로부터 구별하도록 모델을 압박하는 대조 손실이다.
여기서 와 는 각각 쿼리와 양성 샘플의 임베딩, 은 코사인 유사도, 는 온도(temperature) 하이퍼파라미터다. 개의 인배치 음성(in-batch negative) 는 쿼리에 딸려온 하드 네거티브(hard negative)와, 같은 배치 안 다른 쿼리들의 양성·하드 네거티브를 모두 포함한다. 배치 안의 다른 예제들을 공짜 음성으로 재활용하는 표준적 대조 학습 방식이다.
인스트럭션 튜닝(instruction tuning)도 그대로 가져온다. 태스크별 학습 없이 다양한 다운스트림 태스크에 적응하도록, 모든 쿼리에 다음 템플릿을 씌운다.
Instruct: {prompt}\nQuery: {query}
{prompt}는 태스크별 지시문으로 대체된다. 눈여겨볼 설계는 이 인스트럭션을 쿼리에만 붙이고 문서에는 붙이지 않는다는 점이다. 대규모 검색에서 문서 코퍼스는 태스크 지시문과 무관하게 한 번만 임베딩해두면 되므로, 시스템이 효율적으로 유지된다. 인스트럭션이 문서 쪽에 붙으면 태스크가 바뀔 때마다 코퍼스 전체를 다시 임베딩해야 하는데, 그 비용을 원천 차단한 것이다.
4.2 순환 임베딩 추론: 문제 설정
순환 언어 모델의 자기회귀 생성 효율은 잘 정리되어 있지만, 입력 토큰을 처음 인코딩하는 단계 - 임베딩 생성에서는 이게 추론 전부다 - 의 동작은 덜 연구되어 있다. 저자들은 Mamba2를 대표 아키텍처로 삼아 이 문제를 파고든다. Mamba2를 고른 이유는 그 이중적 성질 때문이다. 선형 순환으로도, 구조화된 행렬 변환으로도 표현할 수 있어서 병렬화 수준과 메모리 스케줄링을 자유롭게 조율할 수 있다.
스케줄링 전략이 요구하는 성질은 딱 두 가지다. (i) 입력 시퀀스에 대한 선형 시간 순환 구조, (ii) 순환 모드에 더해 청크 내부(intra-chunk) 처리를 지원하는 병렬화 가능한 이중 형식. 이 두 성질은 Mamba2뿐 아니라 RWKV·xLSTM을 포함한 넓은 계열의 순환/SSM 아키텍처가 공유한다(Appendix B). 그래서 이 전략은 폭넓게 적용된다. 아래 유도는 명료함을 위해 이산화(discretization)를 생략하고 단일 차원 입출력을 가정한다. 다차원으로의 확장은 각 차원에 독립적으로 일반화된다.
4.3 Mamba2의 이중성 (Duality)
Mamba2는 구조화 상태공간 모델(structured state space model, SSM)이다. 입력 시퀀스 를 길이 의 출력 로 사상한다. 각 시점 의 출력 는 현재 입력 와 상태 확장 인자(state expansion factor) 을 갖는 잠재 상태 에 의존한다. 상태는 반복적으로 갱신되고 출력이 생성된다.
시간 가변 행렬 , , 은 입력의 함수로, 보통 학습된 투영(projection)과 비선형 변환의 조합으로 계산된다. 이 순환 형식은 시퀀스 길이에 대해 계산 , 메모리 로 추론한다. 그러나 상태 갱신을 순차적으로 계산하기 때문에 현대 가속기의 병렬성을 온전히 못 쓴다.
이 간극을 메우려고 구조화 SSM은 전이 행렬 에 제약을 건다. Mamba2에서는 로, 는 스칼라이고 는 항등 행렬이다. 이 구조 덕에 순환을 펼칠(unroll) 수 있다. 초기 상태 을 가정하면, 임의 시점 의 상태(그리고 출력 )를 선행 입력 전체의 직접적 함수로 쓸 수 있다.
여기서 는 단계 에서 까지의 누적 전이(cumulative transition)로, 구조를 활용한 것이다. 전체 시퀀스 변환은 결국 하나의 선형 연산자 으로 볼 수 있다.
순환의 인과성(causality) 때문에 은 하방 삼각 행렬(lower-triangular matrix)이다. 계산을 더 벡터화하기 위해 인과 커널 행렬(causal kernel matrix) 을 정의한다.
그러면 처럼, 누적 감쇠(decay)를 담은 과 입력 의존 커널의 아다마르 곱으로 이 표현된다. 이 행렬 형식이 Mamba2 학습 효율의 열쇠다. 병렬화된 하드웨어 가속 행렬 곱을 그대로 쓰기 때문이다. 다만 전체 행렬 을 물리적으로 만들면 계산·메모리 모두 가 든다.
이중성의 정체가 여기 있다. 완전 병렬화되는 제곱 메모리의 행렬 뷰와, 메모리 효율적인 선형 순환 뷰 - 이 둘은 같은 출력을 만든다. 어느 쪽을 언제 쓸지 고르는 자유가 곧 스케줄링의 여지다.
4.4 청크 추론 (Chunked Inference)
Mamba2의 이중성은 "순환의 메모리 효율"과 "행렬 곱의 병렬성"을 결합할 길을 연다. 방법은 이렇다. 입력 시퀀스를 크기 의 청크 개로 쪼갠다(가 를 나눈다고 가정). 청크 내부의 지역 결과는 행렬 형식으로 병렬 계산하고, 전역 잠재 상태는 청크 사이를 순차적으로 오가며 갱신한다.
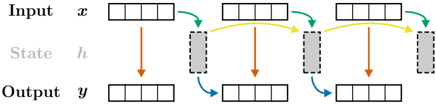
Figure 1 (원논문): 청크 단위 추론. 청크 내부는 병렬로 계산하고(초록·노랑 화살표), 청크 경계의 상태(회색 점선 박스)는 청크 사이를 순환적으로 전파한다.
Figure 1은 이 아이디어의 골격을 보여준다. 위쪽 입력 가 청크(3~4 토큰 묶음)로 나뉘고, 각 청크의 출력 는 청크 내부 계산으로 병렬 산출된다(주황 화살표). 청크 경계에 놓인 상태 (회색 점선 박스)는 초록 화살표로 다음 청크로 넘어가며, 파란 화살표로 그 상태가 다음 청크의 출력에 반영된다. 즉 한 청크 안은 병렬, 청크 사이는 순환이라는 하이브리드다. 이 전략에서 지배적 비용은 청크 크기 에 대해 제곱인 청크 내부 계산이라, 전체 비용은 가 된다. 시퀀스 길이 에 대해 선형인 셈이다.
의 준분리(semi-separable) 구조 - 오프대각(off-diagonal) 블록이 공유 전이 행렬 를 통해 저계수(low-rank) 분해된다는 성질 - 를 활용하면, 청크 사이의 계산 대부분까지 블록 분해 행렬 곱으로 병렬화할 수 있다. 계산은 세 단계로 나뉜다.
1단계 - 청크 내부 계산 (병렬). 먼저 들어오는 경계 상태를 0으로 가정하고(), 각 청크의 출력과 경계 잠재 상태에 대한 청크 내부 기여분을 독립적으로 계산한다. 청크 국소 행렬 변환이다.
2단계 - 청크 사이 상태 전파 (순차). 전역 문맥을 유지하려면 이전 청크가 남긴 상태를 반영해야 한다. 이전 청크의 최종 경계 상태와 현재 청크 내부 기여분을 결합해 경계 상태 를 순환적으로 계산한다().
여기서 는 청크 전체를 가로지르는 누적 전이다.
3단계 - 최종 출력 보정 (병렬). 마지막으로, 이전 청크의 갱신된 최종 상태를 바탕으로 각 청크 출력에 필요한 보정분을 계산하고, 이를 청크 내부 결과에 더해 최종 출력을 조립한다. 첫 청크는 선행 문맥이 없으므로 이다. 에 대해 보정분 은 이전 경계 상태 에 좌측 인자를 적용해 얻고, 최종 출력은 다음처럼 합쳐진다.
상태 전파(2단계)의 순차 계산은 개의 경계 상태에 대해서만 도는 행렬-벡터 곱이라 부담이 작다. 나머지 대부분은 병렬로 처리된다. 결과적으로 계산 비용은 , 활성 메모리도 같은 스케일을 따른다. 유도의 세부는 6.1절(Appendix A)에서 다시 다룬다.
4.5 교차 레이어 추론 전략: 수평 vs 수직
여기가 이 논문의 진짜 새로움이다. 현대 임베딩 모델은 개의 레이어를 순차 적층한 구조라, 레이어 의 출력이 레이어 의 입력이 된다. 표준 실행 패턴은 **수평 추론(horizontal inference)**이다. 길이 의 전체 시퀀스를 한 레이어씩 통과시킨다. 각 Mamba2 레이어는 내부적으로 4.4절의 청크 병렬화를 쓸 수 있다. 문제는, 현재 처리 중인 레이어의 전체 시퀀스 중간 활성값을 전부 들고 있어야 한다는 점이다. 그래서 메모리가 로 시퀀스 길이 에 선형으로 는다.
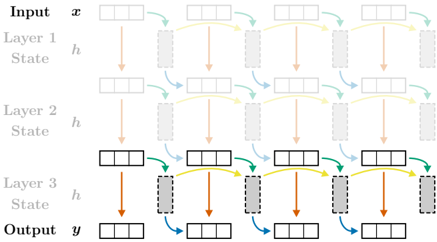
Figure 2a (원논문): 완전 수평 추론. 병렬화가 전체 시퀀스 길이에 걸쳐 이뤄지지만, 현재 처리 레이어의 모든 중간 활성값(검은 박스)을 메모리에 유지해야 한다.
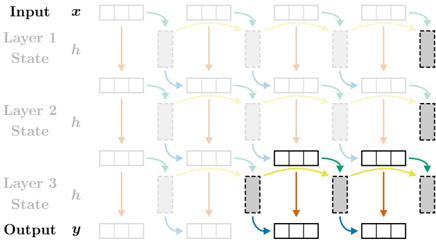
Figure 2b (원논문): 완전 수직 추론. 병렬화는 고정된 수직 청크 크기로 제한되지만, 현재 청크의 활성값과 레이어당 하나의 순환 상태(맨 오른쪽 검은 열)만 저장하면 된다.
Figure 2는 마지막(최상위) 레이어를 통과하는 최종 순전파를 두 전략으로 대비한다. 강조된(검은) 영역이 메모리에 유지되는 활성값이다. 왼쪽 수평 추론(2a)에서는 최상위 레이어의 출력 전체가 검게 칠해져 있다. 전 시퀀스 활성값을 다 들고 있어야 한다는 뜻이다. 반면 오른쪽 수직 추론(2b)에서는 맨 오른쪽 한 청크의 활성값과 레이어당 하나씩의 상태(회색 점선 박스)만 검게 표시된다. 이 그림 한 장이 두 전략의 메모리 발자국 차이를 압축한다.
저자들이 제안하는 **수직 청킹 추론(chunked vertical inference)**은 시퀀스 수준 병렬화를 깊이 방향 순환(depth-wise recurrence)과 맞바꾼다. 구체적으로 입력을 크기 의 수직 청크 개로 나눈다. 이때 는 청크 내부 크기 의 배수이므로 다. 하나의 수직 청크를 모든 개 레이어에 먼저 통과시킨 뒤 다음 청크로 넘어간다(Figure 2b). 각 레이어의 순환 상태는 수직 청크를 가로질러 보존된다. 4.4절에서 시점을 가로질러 상태를 이어가던 레이어 내부 순환과 똑같은 원리가, 이번엔 레이어 사이(cross-layer)에 걸쳐 수직 청크 단위로 작동하는 것이다.
이제 메모리는 총 시퀀스 길이 와 분리된다(일 때). 현재 수직 청크 길이 의 활성값과 레이어당 하나씩의 순환 상태 개만 저장하면 되기 때문이다. 짧은 입력()에는 표준 수평 추론으로 폴백(fallback)해서, 레이어 사이 상태 저장을 아예 없앤다 - 짧은 시퀀스에서 수직 청킹의 오버헤드가 0이 되게 한 셈이다. 최종 메모리 소비는 다음과 같다.
첫 항 은 레이어당 순환 상태, 둘째 항 는 현재 수직 청크의 활성값을 담당한다. 이면 이 값은 에 대해 상수다. 동시에 처리하는 토큰 수를 에서 로 줄이면 이론상 병렬화가 제한되지만, 현대 하드웨어는 비교적 작은 시퀀스 길이에서 이미 연산 한계에 닿는다. 그러니 하드웨어 처리량을 포화시킬 만큼 크되 메모리 제약에 맞을 만큼 작은 를 고르면, 수평 추론의 속도에 순환의 확장성을 얹을 수 있다. 실증은 5.4절에서, 실무 파라미터 선택 가이드는 6.5절(Appendix E.1)에서 다룬다.
5. 실험 결과
5.1 실험 설정
- 벤치마크: 영어 MTEB(eng, v1)과 갱신판 MTEB(eng, v2), 다국어 MTEB(Multilingual, v2), 그리고 장문 검색 벤치마크 LongEmbed. MTEB(eng, v2)는 분류·클러스터링·쌍분류·리랭킹·검색·STS·요약을 아우르는 41개 영어 데이터셋을 담고, Multilingual은 250개 이상 언어로 확장하며, LongEmbed는 이 논문 설정에서 최대 32,768 토큰까지의 장문 검색을 평가한다.
- 비교 대상(백본): 트랜스포머 쪽은 Mistral 7B v0.1(E5-mistral-7b의 기반)과 Qwen2 1.5B. 순환 쪽은 Mamba2 1.3B(Dao & Gu, 2024)와 코드 생성 모델 Codestral Mamba2 7B. 가능한 한 동일한 절차·데이터·하이퍼파라미터로 파인튜닝해 아키텍처의 순수 효과를 본다.
- 학습 데이터: E5-mistral-7b가 쓴 공개 데이터셋 조합과, Springer et al.(2025)이 Llama 3.1 70B로 재현·공개한 합성 데이터. 1 에폭 학습.
- 하드웨어: 추론 평가는 80GB 메모리의 NVIDIA H100 1장에서 수행. 시스템 부하 변동을 감안해 3회 반복 후 평균 보고.
5.2 학습 절차 검증 (Table 2)
본격 비교에 앞서, 저자들은 자기네 학습 파이프라인이 원 논문 수준을 재현하는지부터 확인한다. E5-mistral-7b(Wang et al., 2024)와 그 재현판(Springer et al., 2025)의 결과를, 같은 기반 체크포인트를 파인튜닝해 맞춰본다.
| 모델 | Task Mean | Type Mean |
|---|---|---|
| E5-mistral-7b (v0.1) - Wang et al. (2024) | 66.5 | 64.2 |
| Qwen2 1.5B - Springer et al. (2025) | 63.3 | 61.3 |
| Mistral 7B v0.1 - Springer et al. (2025) | 65.5 | 63.2 |
| Qwen2 1.5B (ours) | 63.6 | 61.8 |
| Mistral 7B v0.1 (ours) | 65.7 | 63.5 |
Table 2 (원논문): MTEB(eng, v1)에서 파인튜닝한 트랜스포머 모델을, Wang et al.(2024)·Springer et al.(2025)이 보고한 점수와 비교. 태스크 평균과 태스크 유형 평균으로 집계.
재현된 Qwen2 1.5B는 Springer et al.의 태스크 평균을 0.3%p, Mistral 7B v0.1은 0.2%p 앞선다. 원 E5-mistral-7b(66.5)와의 격차도 줄였다. 큰 차이는 아니지만 방향이 일관되게 위쪽이라는 점이 중요하다. 파이프라인이 재현판을 살짝 웃도는 수준으로 정확히 동작한다는 뜻이고, 이 위에서 이뤄지는 순환-트랜스포머 비교의 신뢰도를 담보한다. 통제 실험에서 이런 "기준선 검증"을 먼저 깔아두는 건 좋은 습관이다.
5.3 순환 모델은 트랜스포머와 겨룰 수 있는가 (Table 1)
이 논문의 첫 질문에 대한 답이 Table 1에 있다. 동일한 파인튜닝 조건에서 순환 모델과 트랜스포머를 세 벤치마크로 맞붙인다.
| 모델 | Mult. v2 (Task) | Mult. v2 (Type) | eng v2 (Task) | eng v2 (Type) | LongEmbed (Task) |
|---|---|---|---|---|---|
| Qwen2 1.5B | 56.2 | 48.7 | 65.7 | 62.3 | 41.0 |
| Mamba2 1.3B | 55.2 | 47.9 | 64.3 | 60.9 | 40.8 |
| Mistral 7B v0.1 | 58.6 | 50.5 | 67.3 | 63.3 | 44.7 |
| Codestral Mamba2 7B | 59.4 | 51.9 | 65.2 | 61.8 | 44.5 |
Table 1 (원논문): 파인튜닝한 트랜스포머·순환 임베딩 모델을 MTEB(Multilingual, v2)·MTEB(eng, v2)·LongEmbed에서 평가. 볼드는 순환(제안) 모델.
벤치마크마다 승부가 갈리는 게 흥미롭다. 다국어(Multilingual, v2)에서는 순환 모델이 앞선다. Codestral Mamba2 7B가 태스크 평균 59.4로 우리가 파인튜닝한 모든 모델 중 최고를 찍으며 Mistral 7B v0.1(58.6)을 넘어선다. 반대로 1.3B급에서는 Mamba2 1.3B(55.2)가 Qwen2 1.5B(56.2)에 비슷한 폭으로 밀린다.
영어(eng, v2)에서는 트랜스포머가 근소하게 앞선다. Codestral Mamba2 7B(65.2)가 Mistral 7B v0.1(67.3)에 태스크 평균 기준 약 2%p 뒤진다. 태스크 유형 평균으로 보면 61.8 대 63.3으로 격차가 1.5%p 수준이다. 뒤에서 보겠지만 이 격차의 대부분은 영어 검색(retrieval) 한 항목에서 나온다.
LongEmbed에서는 사실상 동률이다. 비슷한 크기 모델끼리 0.2%p 이내로 붙는다(v0.1 44.7 vs Codestral 44.5, Qwen2 41.0 vs Mamba2 40.8). 장문 검색에서 순환 모델이 트랜스포머에 뒤지지 않는다는 건, 상수 메모리라는 효율 이점을 생각하면 실무적으로 특히 값진 결과다.
저자들은 영어에서 남은 격차를 아키텍처 열위가 아니라 사전학습 규모·구성의 차이로 해석한다. Mamba2 1.3B는 훨씬 적은 데이터로 사전학습됐고(뒤에 나오듯 700B 토큰 대 Qwen2의 7T 토큰), Codestral Mamba2 7B는 애초에 코드 생성 특화 모델이다. 더 충실히 사전학습된 순환 백본이라면 이 격차는 좁혀질 여지가 크다는 게 저자들의 전망이다. 개인적으로는 이 해석이 설득력 있다고 본다. 같은 레시피·데이터로 맞춰도 백본의 사전학습 이력이 다른 이상, 순수 아키텍처 비교라고 못 박기는 어렵기 때문이다.
5.4 추론 효율 평가
두 번째 질문 - 추론을 어떻게 스케줄링할 것인가 - 에 대한 실증이다. H100 1장에서 입력 길이와 배치 크기를 바꿔가며 런타임과 메모리를 측정한다.
청크 내부 크기 는 얼마가 좋은가.
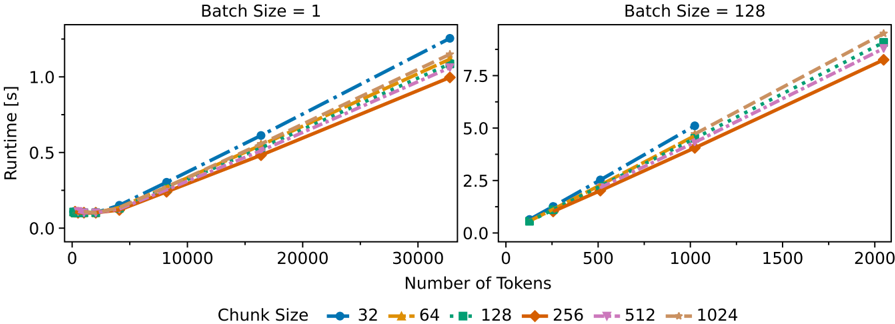
Figure 3 (원논문): Codestral Mamba2 7B의 완전 수평 청크 추론 런타임. 청크 크기(32~1024)와 배치 크기(1, 128)를 바꿔가며 측정.
Figure 3은 청크 크기가 런타임에 미치는 영향을 단일 시퀀스(배치 1)와 128 배치로 보여준다. 두 설정 모두에서 (주황 실선)이 전 구간에서 가장 빠르다. 더 작은 청크(예: 32, 파란 점선)는 병렬화 잠재력을 깎아 위쪽으로 벌어지고, 더 큰 청크는 제곱인 청크 내부 계산의 오버헤드를 키운다. 병렬성과 제곱 비용 사이의 최적점이 256 부근이라는 것이고, 이후 실험은 이 값을 고정으로 쓴다.
수직 청크 크기 는 어디서 포화되는가.
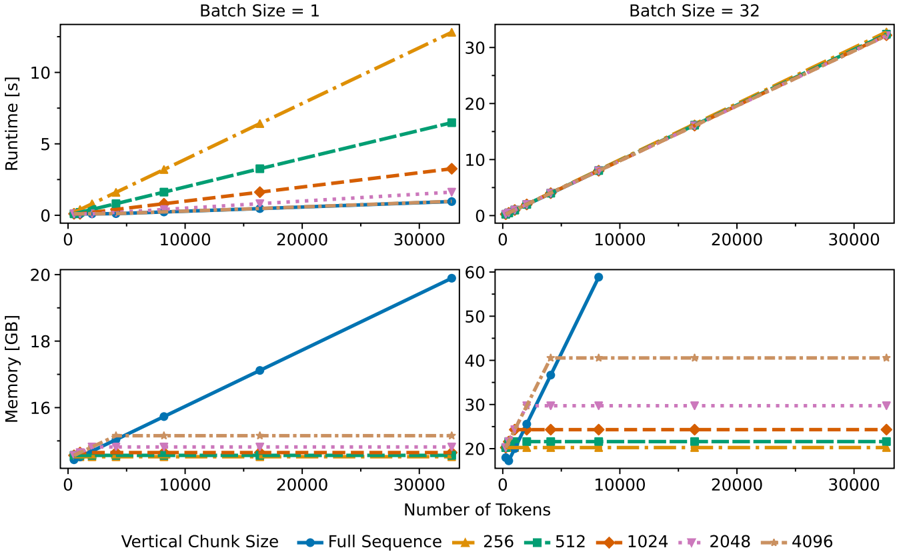
Figure 4 (원논문): 청크 내부 크기를 256으로 고정하고 수직 청크 크기를 바꿔가며 측정한 Codestral Mamba2 7B의 런타임(위)과 메모리(아래). 배치 1과 32.
를 256으로 고정한 채 수직 청크 크기 를 키우면(Figure 4), 단일 시퀀스 런타임은 완전 수평 추론(파란 실선, "Full Sequence")에 점점 수렴해 에서 완전히 만난다. 즉 이 설정에서 병렬화는 4096 토큰이면 포화되고, 그 이상은 레이어 사이 순환의 성능 영향이 무시할 만하다는 뜻이다. 배치 32에서는 더 극적이다. 모든 수직 청크 크기에서 런타임이 완전 수평과 거의 붙어 있고, 일 때만 미세하게 오른다. 배치를 태우면 훨씬 작은 에서 병렬화가 포화된다.
아래쪽 메모리 그래프가 이 방법의 핵심 주장을 시각적으로 증명한다. 파란 "Full Sequence" 곡선은 토큰 수에 따라 메모리가 선형으로 계속 오르는 반면, 유한한 를 쓰는 곡선들은 토큰까지만 오르고 이후 평평해진다(상수 수렴). 배치 32의 오른쪽 아래 그래프에서 (주황)은 ~20GB, (갈색)은 ~40GB 근처에서 각각 수평선을 그린다. 가 곧 메모리 상한을 정하는 다이얼이 되는 것이다.
트랜스포머와 정면 비교.
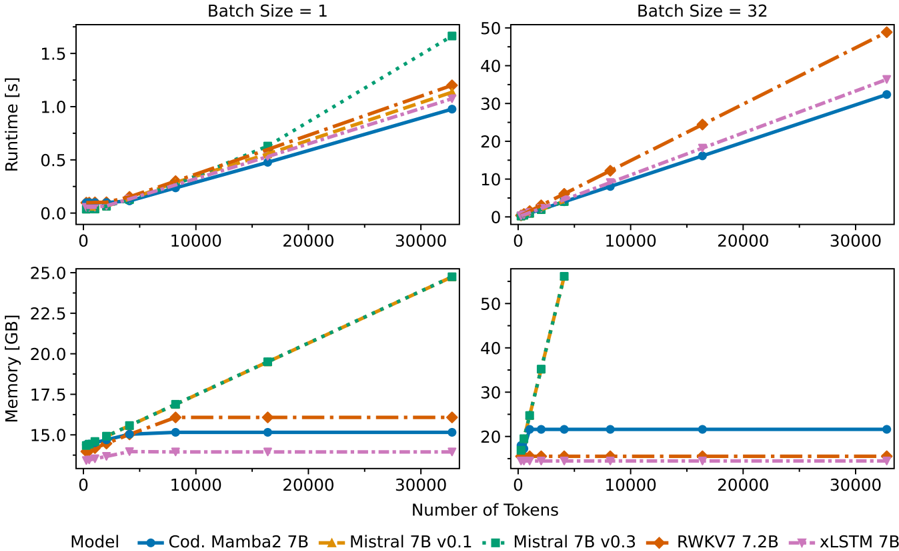
Figure 5 (원논문): Codestral Mamba2 7B·RWKV7 7.2B·xLSTM 7B를 Mistral 7B v0.1·v0.3과 비교한 런타임(위)과 메모리(아래). 순환 모델은 수직 청킹(내부 256, 수직 4096@배치1 / 512@배치32) 사용, 트랜스포머는 FlashAttention-2 사용.
Figure 5는 세 순환 아키텍처(Mamba2·RWKV7·xLSTM)와 두 Mistral을 맞붙인 결정적 그림이다. 단일 시퀀스 생성에서 Codestral Mamba2 7B(파란 실선)는 입력 길이 4096 토큰을 넘어서면 두 트랜스포머 모두를 런타임·메모리에서 앞선다. Mistral 7B v0.3(초록 점선)에 대한 우위는 시퀀스가 길어질수록 벌어지는데, 완전 어텐션(full attention)의 제곱 복잡도 때문이다. 반면 Mistral 7B v0.1(주황)은 4096 슬라이딩 윈도우를 써서 제곱 성장을 보이지 않는다. 배치 32에서는 셋의 런타임이 얼추 비슷하지만, 두 Mistral은 메모리 초과로 4096 토큰까지밖에 못 돌린다.
메모리 그래프가 압권이다. 세 순환 아키텍처 모두 수직 청크 크기까지는 선형으로 오르다가 이후 사실상 상수로 눕는 동일한 패턴을 공유한다. 트랜스포머의 선형 성장(초록/노랑 대각선, 배치 32에서는 8000 토큰 근처에서 화면 밖으로 치솟음)과 극명하게 대비된다. RWKV7과 xLSTM은 심지어 Mamba2보다 낮은 메모리 바닥을 찍는다. 이 그림이 논문의 세 번째 주장 - 수직 청킹이 특정 아키텍처의 요행이 아니라 순환/SSM 계열 전반에 통하는 성질 - 을 뒷받침한다.
6. 부록 (Appendix)
부록의 분량이 본문에 맞먹는다. 유도, 아키텍처 일반화, 단계별 시각화, 태스크 유형별 상세 결과, 하드웨어 이식성, 학습 세부까지 촘촘하다. 하나씩 짚는다.
6.1 청크 추론 유도 (Appendix A)
4.4절의 세 단계 방정식이 어디서 오는지를 Dao & Gu(2024)의 블록 분해(block decomposition, Section 6)에 근거해 유도한다. 요지는 전체 SSM 행렬 을 블록으로 쪼갤 때 나타나는 구조다.
- 대각 블록 = 청크 내부 출력. 는 의 대각 블록을 청크 내부 상호작용으로 제한한 것에 대응한다(식 8).
- 오프대각의 우측() 인자 = 청크 내부 상태. 는 선행 청크 상태를 무시하고 청크 내부 입력만으로 끝 상태를 계산하며, 저계수 오프대각 블록의 우측 인자에 대응한다. 입력 기여를 행 벡터 로 가중한다(식 9).
- 중심() 인자 = 상태 순환. 최종 청크 상태 는 청크 상태에 대한 순환으로, 중심 인자가 이전 청크의 전역 상태 을 전이 행렬로 앞으로 전파한다(식 10).
- 좌측() 인자 = 출력 보정. 오프대각 블록은 좌측()·중심()·우측() 인자로 분해되는데, 우측 인자와 입력을 누적 전역 상태 로 접어버리면 좌측 인자만 남아 가 된다(식 11).
- 가법 분해. 최종적으로 는 청크 내부 기여(대각)와 청크 사이 보정(오프대각)의 합으로 깔끔히 분리된다(식 12).
수식 이미지가 논문에 렌더링되어 있어 세부 인덱스까지 옮기지는 못했지만, 골자는 "의 준분리 구조 덕에 오프대각을 저계수로 접을 수 있고, 그 접힘이 곧 상태 순환"이라는 것이다. Mamba2의 SSD(state space duality) 알고리즘을 임베딩 인코딩 맥락에서 재정리한 셈이다.
6.2 Mamba2 너머의 순환 아키텍처 (Appendix B)
수직 청킹이 왜 RWKV·xLSTM에도 통하는지를 설명한다. 구조화 SSM 말고도 여러 순환 아키텍처가 병렬·순환 두 모드를 갖는 이중 형식을 지닌다. RWKV는 자기어텐션을 시간 감쇠 가중 키-값(time-decayed WKV) 연산자로 대체하는데, 이 연산자는 전 시점에 대한 병렬 스캔으로도, 시점별 경량 순환으로도 계산된다. xLSTM은 지수 게이팅(exponential gating)과 구조화 메모리 갱신을 갖는 확장 LSTM 블록을 도입하며, 시간에 대해 결합적(associative)이도록 설계되어 병렬 프리픽스(prefix) 연산으로도 표준 순환으로도 구현된다. "병렬 청크 내부 + 순환 청크 사이"라는 골격이 이들 모두에서 성립하므로, 4.4절의 청크 추론이 그대로 이식된다. Figure 5의 실험이 이 논증의 경험적 뒷받침이다.
6.3 교차 레이어 추론 단계별 시각화 (Appendix C)
본문 Figure 2는 최상위 레이어의 최종 순전파만 보여줬는데, Appendix C는 전 레이어를 통과하는 과정을 단계별로 펼친다.
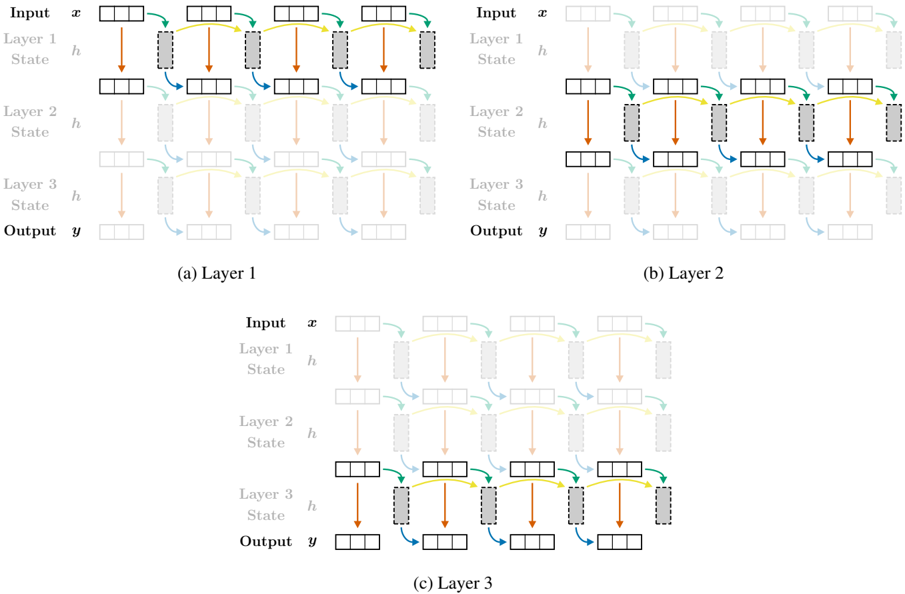
Figure 6 (원논문): 완전 수평 추론의 단계별 시각화. 각 그림은 한 레이어를 처리한 뒤의 상태로, 레이어마다 모든 청크를 병렬로 계산한 다음 다음 레이어로 넘어가며, 전 시퀀스에 걸쳐 활성값이 누적된다.
Figure 6에서 (a)→(b)→(c)로 갈수록 아래 레이어(Layer 1→3)가 차례로 채워지고, 각 레이어에서 전체 시퀀스가 한꺼번에 처리된다(검은 박스가 가로로 쭉 늘어남). 레이어를 넘어갈 때마다 전 시퀀스 활성값이 메모리에 쌓이는 구조가 눈에 들어온다. 수평 추론이 왜 메모리를 쓰는지 그림으로 납득된다.
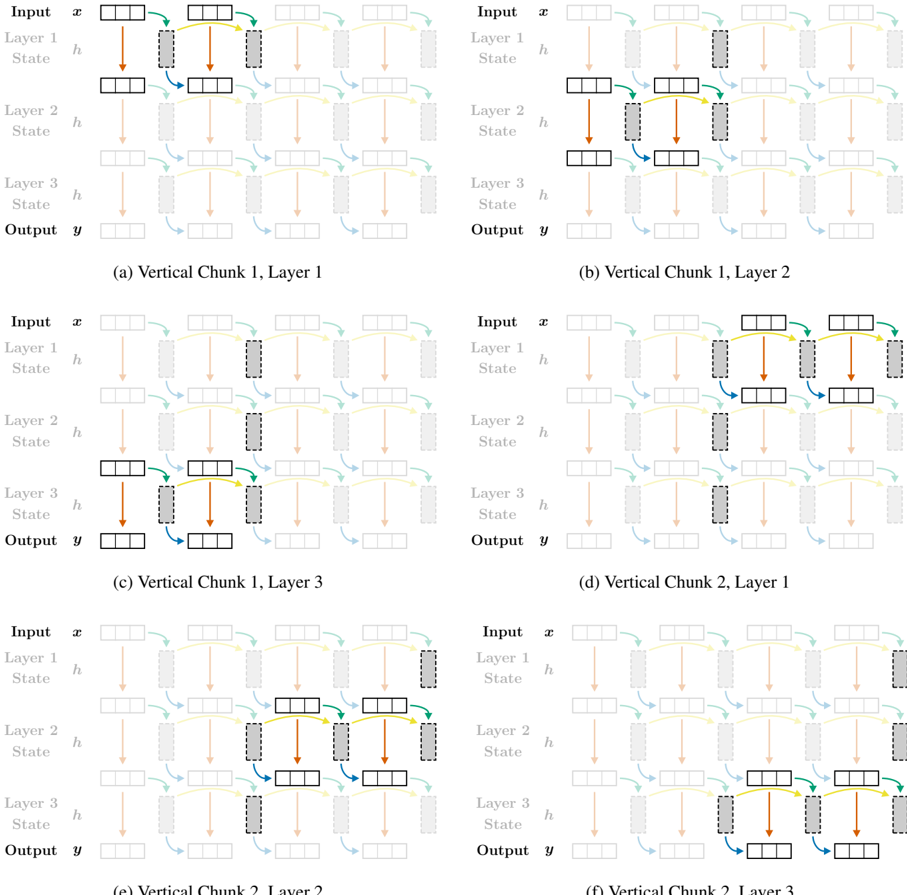
Figure 7 (원논문): 수직 청킹 추론의 단계별 시각화. 첫 수직 청크를 모든 레이어에 통과시킨 뒤 둘째 청크로 넘어간다. 현재 수직 청크의 활성값과 레이어당 하나의 상태만 유지한다.
Figure 7은 정반대 순서다. (a)~(c)는 "수직 청크 1"이 Layer 1→3을 통과하는 과정이고, (d)~(f)는 "수직 청크 2"가 같은 여정을 밟는다. 왼쪽 절반(첫 청크)이 모든 레이어를 다 지난 뒤에야 오른쪽 절반(둘째 청크)이 시작된다. 검게 유지되는 영역이 항상 "현재 청크 한 덩이 + 레이어당 상태 하나"로 국한된다. 두 그림을 나란히 보면 수평과 수직이 처리 순서를 전치(transpose)한 관계라는 게 직관적으로 잡힌다. 수평은 "레이어를 바깥 루프, 시퀀스를 안쪽"으로 돌고, 수직은 "청크를 바깥 루프, 레이어를 안쪽"으로 돈다.
6.4 태스크 유형별 상세 결과 (Appendix D)
MTEB의 태스크 유형 약어부터 정리한다.
| Task Type | 약어 |
|---|---|
| Bitext Mining | Bit.M. |
| Classification | Cls. |
| Clustering | Clust. |
| Instruction Reranking | I.Rera. |
| Multilabel Classification | M.Cls. |
| Pair Classification | P.Cls. |
| Reranking | Rera. |
| Retrieval | Retr. |
| STS | STS |
| Summarization | Sum. |
Table 3 (원논문): MTEB 태스크 유형 약어.
Codestral Mamba2 7B와 Mistral 7B v0.1의 유형별 성적이 영어와 다국어에서 정반대로 갈린다는 게 이 절이 짚어내는 지점이다.
다국어(Multilingual, v2) - Table 4. 순환 모델이 여러 유형에서 앞선다. Codestral Mamba2 7B가 비텍스트 마이닝(bitext mining)에서 +2.0, 리랭킹에서 +4.8, 검색에서 +1.9점으로 트랜스포머 기준선을 넘거나 바짝 붙는다.
| 모델 | Bit.M. | Cls. | Clust. | I.Rera. | M.Cls. | P.Cls. | Rera. | Retr. | STS | Task Mean | Type Mean |
|---|---|---|---|---|---|---|---|---|---|---|---|
| E5-mistral-7b (v0.1) - Wang | 70.6 | 60.3 | 50.6 | −0.6 | 22.2 | 81.1 | 63.8 | 55.8 | 74.0 | 60.2 | 53.1 |
| Qwen2 1.5B (ours) | 61.8 | 57.6 | 46.9 | −2.2 | 20.0 | 78.2 | 53.7 | 50.7 | 71.4 | 56.2 | 48.7 |
| Mistral 7B v0.1 (ours) | 68.6 | 60.2 | 46.9 | −4.7 | 21.2 | 79.9 | 55.3 | 54.4 | 72.4 | 58.6 | 50.5 |
| Mistral 7B v0.3 (ours) | 68.7 | 60.2 | 48.0 | −4.4 | 21.7 | 80.1 | 55.5 | 55.1 | 72.7 | 58.9 | 50.8 |
| Mamba2 1.3B (ours) | 61.1 | 55.7 | 45.2 | −5.6 | 19.5 | 77.6 | 55.4 | 50.9 | 70.9 | 55.2 | 47.9 |
| Codestral Mamba2 7B (ours) | 70.6 | 60.0 | 47.0 | −3.2 | 21.8 | 81.0 | 60.1 | 56.3 | 73.3 | 59.4 | 51.9 |
Table 4 (원논문): MTEB(Multilingual, v2) 상세 결과. 볼드는 순환 모델. 인스트럭션 리랭킹(I.Rera.)의 음수는 해당 메트릭 특성상 정상 범위다.
Codestral Mamba2 7B의 검색 56.3은 Mistral v0.1의 54.4를 앞서고, 리랭킹 60.1도 55.3을 크게 웃돈다. 심지어 원 E5-mistral-7b(비텍스트 70.6, 검색 55.8)와도 어깨를 나란히 한다. 다국어에서 순환 모델이 강한 이유를 논문이 단정하진 않지만, Codestral의 코드 사전학습이 다국어·구조적 텍스트에 의외로 유리하게 작용했을 가능성을 생각해볼 수 있다.
영어(eng, v2) - Table 5. 패턴이 뒤집힌다. Codestral Mamba2 7B가 가장 크게 뒤지는 항목은 검색으로 −6.5점이며, 이 한 항목이 전체 점수 차의 대부분을 설명한다. 나머지 유형(분류·쌍분류·클러스터링·STS)의 격차는 대략 1~2점 안이다.
| 모델 | Cls. | Clust. | P.Cls. | Rera. | Retr. | STS | Sum. | Task Mean | Type Mean |
|---|---|---|---|---|---|---|---|---|---|
| E5-mistral-7b (v0.1) - Wang | 79.9 | 51.4 | 88.4 | 49.8 | 57.6 | 84.3 | 36.6 | 68.0 | 64.0 |
| Qwen2 1.5B (ours) | 78.1 | 49.7 | 85.2 | 48.4 | 54.1 | 82.2 | 38.3 | 65.7 | 62.3 |
| Mistral 7B v0.1 (ours) | 80.7 | 50.9 | 87.2 | 49.3 | 56.8 | 82.5 | 35.8 | 67.3 | 63.3 |
| Mistral 7B v0.3 (ours) | 79.9 | 52.0 | 87.1 | 49.3 | 56.4 | 82.4 | 37.1 | 67.3 | 63.5 |
| Mamba2 1.3B (ours) | 76.8 | 48.6 | 85.0 | 48.3 | 50.7 | 81.9 | 35.0 | 64.3 | 60.9 |
| Codestral Mamba2 7B (ours) | 79.5 | 50.5 | 86.2 | 49.3 | 50.3 | 81.7 | 35.2 | 65.2 | 61.8 |
Table 5 (원논문): MTEB(eng, v2) 상세 결과. 볼드는 순환 모델.
Codestral의 영어 검색 50.3은 Mistral v0.1의 56.8과 6.5점 벌어진다. 반면 분류(79.5 vs 80.7), 쌍분류(86.2 vs 87.2), STS(81.7 vs 82.5)는 1~2점 안쪽이다. 영어 검색이라는 단일 병목이 순환 모델의 영어 열위를 거의 다 만든다는 뜻인데, 이건 시사하는 바가 크다. 순환 모델의 문제가 전방위적 표현력 부족이 아니라 특정 태스크(정밀한 문서 검색)에 국한된다면, 검색 특화 학습이나 더 나은 사전학습으로 좁힐 여지가 있다.
LongEmbed - Table 6. 장문 검색에서는 승부가 반반이다. Codestral Mamba2 7B가 절반의 태스크에서, Mistral 7B v0.1이 나머지 절반에서 앞선다.
| 모델 | NQA | Needle | Passkey | QMSum | SSFD | WikimQA | Mean |
|---|---|---|---|---|---|---|---|
| E5-mistral-7b (v0.1) - Wang | 37.2 | 31.5 | 30.8 | 28.6 | 75.1 | 58.7 | 43.7 |
| Qwen2 1.5B (ours) | 27.4 | 30.5 | 34.0 | 30.8 | 75.4 | 48.2 | 41.0 |
| Mistral 7B v0.1 (ours) | 40.8 | 28.5 | 37.8 | 31.9 | 79.8 | 49.6 | 44.7 |
| Mistral 7B v0.3 (ours) | 43.2 | 27.8 | 36.5 | 32.0 | 79.8 | 49.7 | 44.8 |
| Mamba2 1.3B (ours) | 24.2 | 32.2 | 37.8 | 29.9 | 72.9 | 47.9 | 40.8 |
| Codestral Mamba2 7B (ours) | 35.7 | 31.0 | 38.8 | 30.2 | 75.0 | 56.5 | 44.5 |
Table 6 (원논문): LongEmbed 상세 결과. 볼드는 순환 모델.
흥미로운 지점은 Passkey다. Codestral Mamba2 7B가 38.8로 두 Mistral(37.8, 36.5)을 앞선다. Passkey는 긴 문맥 어딘가에 숨은 정보를 찾는 "needle in a haystack" 성격의 태스크인데, 상수 크기 상태로 긴 문맥을 압축하는 순환 모델이 여기서 밀리지 않는다는 건 다소 반직관적이면서도 고무적이다. 반면 NQA(자연스러운 질문 응답 성격)에서는 Codestral 35.7이 Mistral 40.8에 뒤지는데, 이는 앞서 본 영어 검색 열위의 연장선으로 읽힌다.
정리하면, 순환 모델은 다국어에서 트랜스포머를 앞서거나 맞먹고, 영어 검색만이 유일하게 눈에 띄는 격차 지점이다. 세 벤치마크 전체에서 나머지 유형은 거의 동률이다.
MTEB(eng, v1) - Table 7. 검증에 쓴 v1 벤치마크의 상세 결과로, 여기엔 순환 모델과 Mistral v0.2까지 추가로 담긴다.
| 모델 | Cls. | Clust. | P.Cls. | Rera. | Retr. | STS | Sum. | Task Mean | Type Mean |
|---|---|---|---|---|---|---|---|---|---|
| E5-mistral-7b (v0.1) - Wang | 77.4 | 50.3 | 88.4 | 60.2 | 57.1 | 84.7 | 31.5 | 66.5 | 64.2 |
| Qwen2 1.5B - Springer | 76.5 | 47.2 | 86.9 | 55.0 | 54.4 | 79.3 | 29.7 | 63.3 | 61.3 |
| Mistral 7B v0.1 - Springer | 77.9 | 49.1 | 87.4 | 57.6 | 57.1 | 82.9 | 30.1 | 65.5 | 63.2 |
| Mistral 7B v0.2 - Springer | 78.3 | 50.5 | 88.2 | 60.0 | 58.2 | 85.7 | 31.3 | 66.9 | 64.6 |
| Qwen2 1.5B (ours) | 75.5 | 46.9 | 85.2 | 58.2 | 52.8 | 82.7 | 31.5 | 63.6 | 61.8 |
| Mistral 7B v0.1 (ours) | 77.6 | 49.5 | 87.2 | 59.9 | 56.3 | 82.9 | 31.0 | 65.7 | 63.5 |
| Mistral 7B v0.3 (ours) | 76.9 | 49.4 | 87.1 | 60.0 | 55.8 | 83.0 | 30.9 | 65.5 | 63.3 |
| Mamba2 1.3B (ours) | 73.8 | 46.2 | 85.0 | 58.0 | 49.0 | 82.4 | 30.6 | 61.9 | 60.7 |
| Codestral Mamba2 7B (ours) | 76.9 | 47.3 | 86.2 | 60.0 | 49.5 | 82.2 | 29.8 | 63.2 | 61.7 |
Table 7 (원논문): MTEB(eng, v1) 상세 결과. 볼드는 순환 모델.
v1에서도 그림이 똑같다. Codestral Mamba2 7B의 리랭킹(60.0)은 Mistral v0.1(59.9)과 동률이고 STS(82.2)도 붙지만, 검색은 49.5로 Mistral의 56.3에 6.8점 밀린다. 영어 검색이라는 단일 약점이 v1·v2 양쪽에서 재현된다는 건, 이게 우연한 노이즈가 아니라 순환 임베더의 체계적 특성임을 굳혀준다.
6.5 파라미터 강건성과 이식성 (Appendix E)
추론 실험 결과가 특정 GPU의 특성 때문은 아닌지 검증하기 위해, 저자들은 L40S·A100·H100 세 가속기에서 주요 실험을 재현한다.
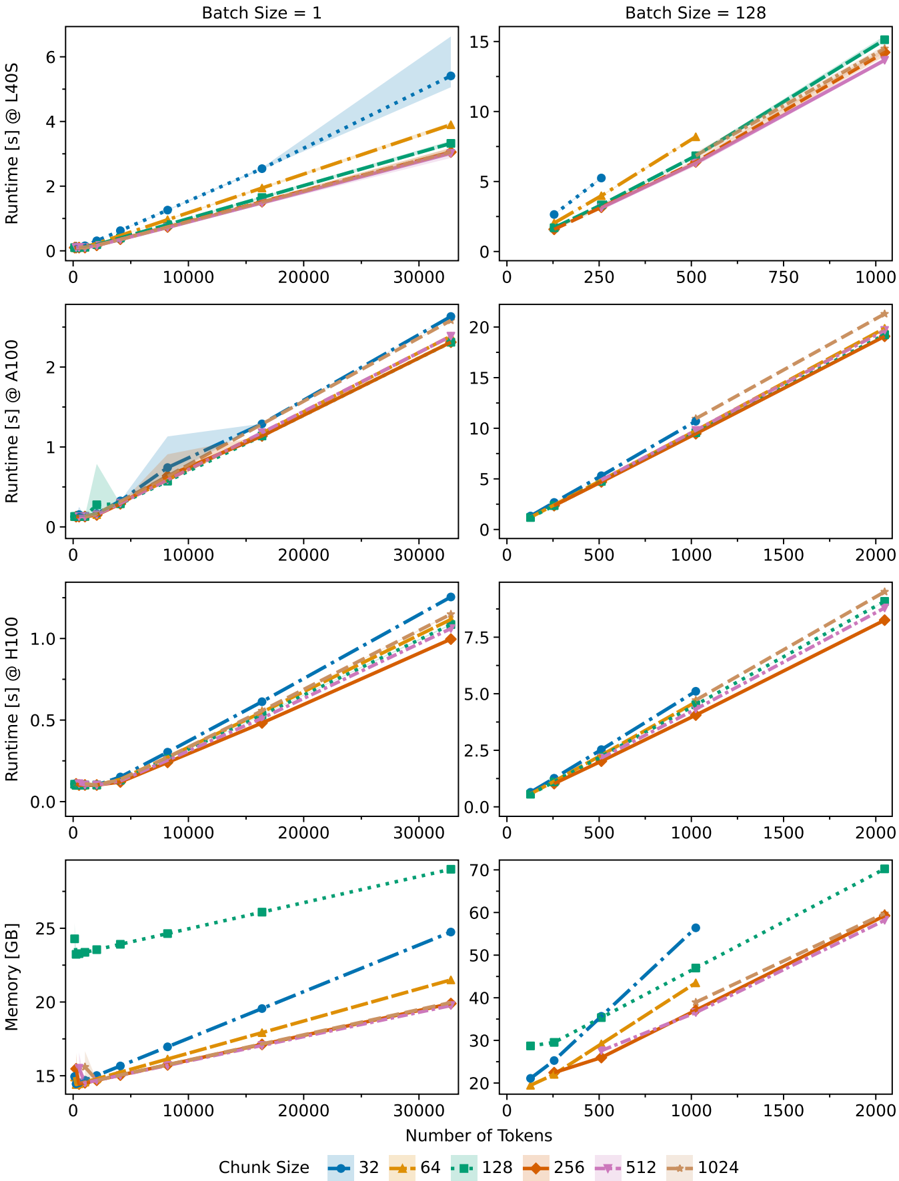
Figure 8 (원논문): 청크 크기별 완전 수평 청크 추론 런타임을 L40S·A100·H100에서 측정. 메모리는 기기 간 동일해 한 번만 표시. 3회 실행의 평균·최소·최대.
Figure 8은 Figure 3(청크 크기 스윕)을 세 하드웨어로 확장한다. 세 행(L40S/A100/H100) 모두에서 (주황) 근방이 최적으로 유지된다. 작은 청크(파란)가 위로 벌어지는 경향도 동일하다. 음영(band)은 3회 실행의 최소~최대 범위로, 대체로 좁아 측정이 안정적임을 보여준다.
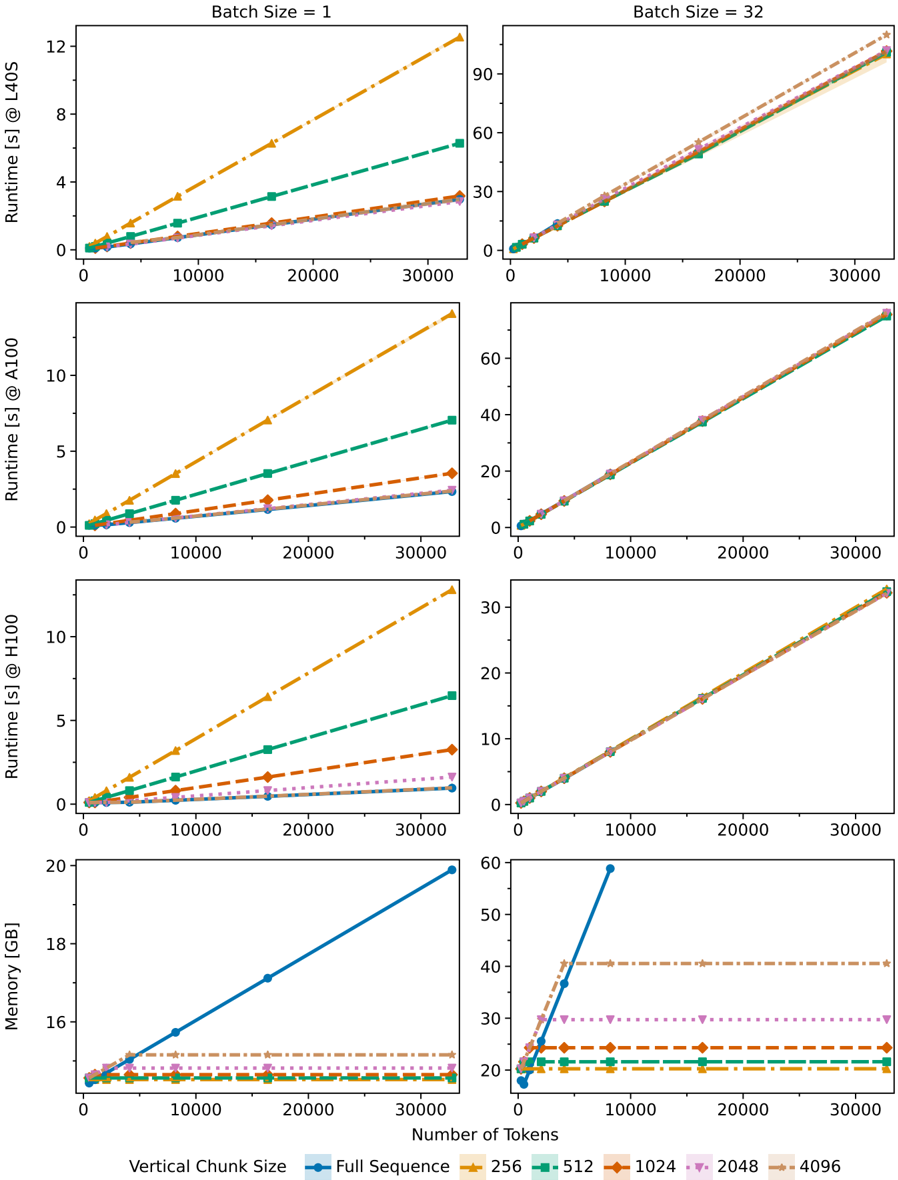
Figure 9 (원논문): 수직 청크 크기별 런타임·메모리를 L40S·A100·H100에서 측정. 내부 청크 256 고정. 메모리는 기기 간 동일해 한 번만 표시.
Figure 9는 Figure 4의 하드웨어 확장판이다. 단일 시퀀스에서 병렬화가 에서 포화되는 패턴, 배치에서 더 작은 로 포화되는 패턴이 세 기기에서 일관된다. 맨 아래 메모리 곡선이 까지 오르다 눕는 상수 수렴도 그대로다.
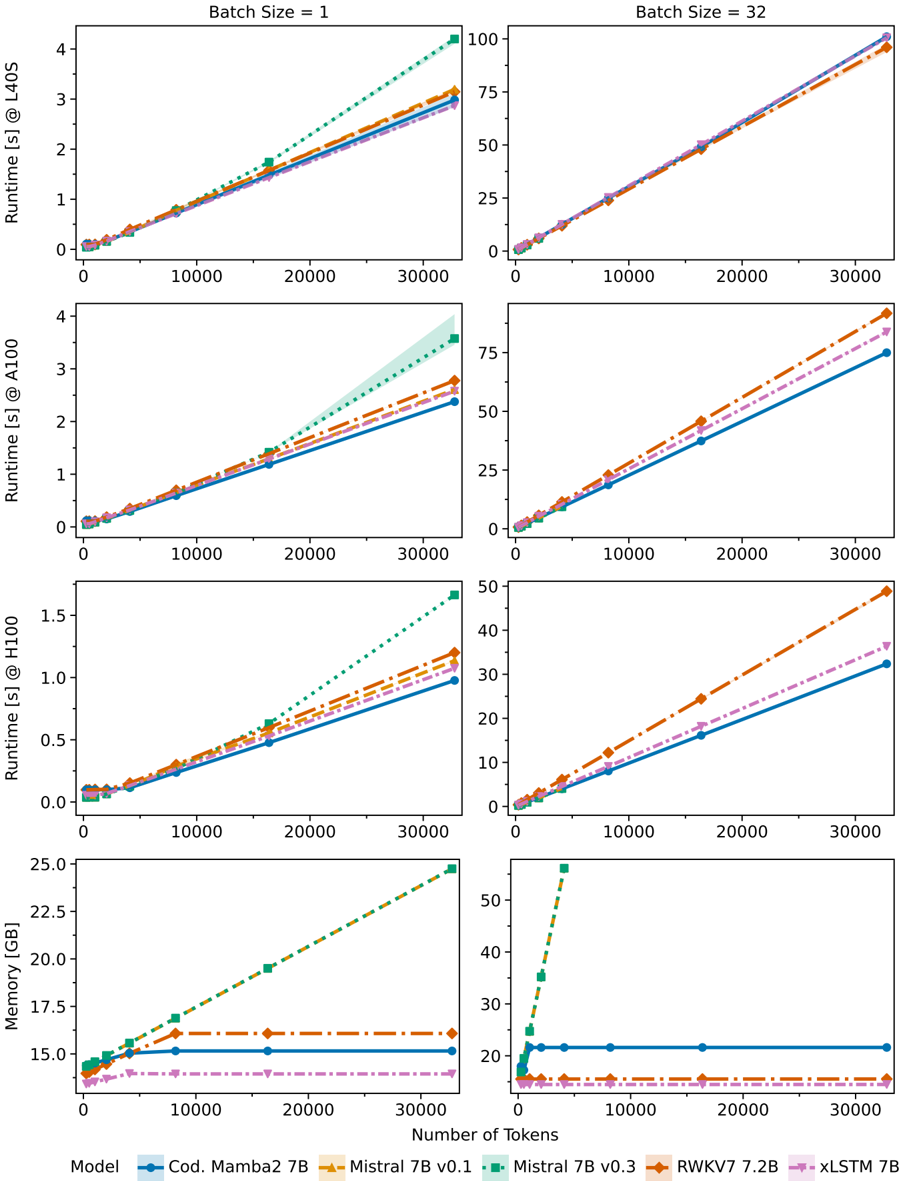
Figure 10 (원논문): Codestral Mamba2 7B·RWKV7 7.2B·xLSTM 7B를 Mistral 7B v0.1·v0.3과 비교. L40S·A100·H100에서 측정. 트랜스포머는 FlashAttention-2 사용.
Figure 10은 Figure 5의 확장판으로, 순환 모델의 런타임·메모리 우위가 하드웨어와 무관하게 보존됨을 보인다. 세 기기 모두에서 순환 모델의 메모리는 수직 청크 이후 상수로 눕고(맨 아래 행), 트랜스포머의 초록/노랑 대각선은 계속 오른다. 저자들이 이 절에서 뽑아낸 결론은 세 가지다. (i) 기본 청크 크기 이 세 기기에서 최적으로 유지된다. (ii) 병렬화 포화점은 단일 시퀀스에서 최대 , 큰 배치에서 다. (iii) 긴 시퀀스에서 순환 모델의 런타임·메모리 이점은 하드웨어와 무관하게 보존된다.
**실무 파라미터 선택 가이드(Appendix E.1)**도 값지다. 요약하면 이렇다.
- 청크 내부 크기 는 모델의 기본값을 그대로 쓰면 된다(별도 튜닝 불필요).
- 배치 추론이면 로 완전 포화, 메모리가 빠듯하면 (거의 포화). 둘 다 토큰 이후 상수 메모리를 유지한다.
- 단일 시퀀스 추론은 이 필요하며, 정확한 포화점은 하드웨어에 달렸다. 메모리에 맞는 한 가장 큰 를 쓰는 게 최선이다.
이 가이드의 함의가 좋다. 저자들의 표현대로, **수직 청크 크기는 세심히 튜닝할 하이퍼파라미터라기보다 "메모리 제약 아래서 거의 완전 병렬 속도를 유지하게 해주는 다이얼"**로 쓰면 된다. 실무자가 고민할 일이 하나 줄어든다는 뜻이다.
6.6 학습 세부사항 (Appendix F)
학습 데이터 정제(Table 8). 재현된 합성 데이터에서 쿼리·양성·음성 중 하나가 빈 문자열인 삼중항(triple)이 약 15,726개(전체 1,739,369개의 0.90%) 발견되어 걸러냈다. 공개 데이터셋은 빈 항목이 0이다.
| Dataset | Total | Empty (Count) | Empty (%) |
|---|---|---|---|
| Short Short | 19,932 | 1,995 | 10.01% |
| STS | 99,791 | 3,819 | 3.83% |
| Bitext | 89,611 | 3,047 | 3.40% |
| Short Long | 153,934 | 4,635 | 3.01% |
| Long Short | 108,487 | 2,111 | 1.95% |
| Long Long | 19,236 | 119 | 0.62% |
| Public Datasets (11) | 1,248,378 | 0 | 0.00% |
| 합계 | 1,739,369 | 15,726 | 0.90% |
Table 8 (원논문): 쿼리·양성·음성 중 빈 텍스트가 하나 이상인 삼중항의 분포.
Short-Short 데이터셋의 빈 항목 비율이 10%로 유독 높은 게 눈에 띈다. 짧은 텍스트 쌍을 합성하다 보니 빈 생성이 잦았던 것으로 보이는데, 이런 데이터 위생(hygiene) 문제를 명시적으로 짚고 필터링한 건 재현 가능성 측면에서 신뢰가 간다.
학습 설정. 모든 모델을 배치 크기 2048, 1 에폭, 100스텝 워밍업 후 선형 감쇠(linear decay), 가중치 감쇠 0.1, 손실 온도 로 학습했다. 최대 시퀀스 길이는 512로 제한(Wang·Springer 설정 따름). 메모리 절약을 위해 QLoRA(4비트 양자화, bfloat16 활성값)와 LoRA 어댑터(, , 모든 선형 레이어에 적용)를 썼다. 학습률은 Mamba2 1.3B를 제외한 전 모델에서 를 사용했다.
Mistral 버전 차이도 정리해둔다. v0.1은 컨텍스트 8,192에 4,096 슬라이딩 윈도우 어텐션. v0.2가 컨텍스트를 32,768로 늘리고 위치 인코딩 파라미터를 조정하며 슬라이딩 윈도우를 완전 어텐션으로 교체. v0.3은 이를 물려받고 어휘(vocabulary)를 확장했다. 추론 평가(Figure 5)에서 v0.1과 v0.3을 함께 쓴 이유가 여기 있다. 슬라이딩 윈도우(v0.1) 대 완전 어텐션(v0.3)의 스케일링 차이를 드러내기 위함이다.
Mamba2 1.3B의 학습률 튜닝(Table 9). Mamba2 1.3B만 유독 높은 학습률이 필요했다. 전체 데이터의 1/16로 배치도 128로 줄여(그래디언트 업데이트 수는 동일하게 유지) 여러 학습률을 스윕한 결과, 에서 성능이 정점을 찍었다.
| Learning Rate | Mean (Task) |
|---|---|
| 62.89 | |
| 63.19 | |
| 63.33 | |
| 62.77 | |
| 62.53 |
Table 9 (원논문): Mamba2 1.3B의 학습률 튜닝. 전체 데이터 부분집합으로 1 에폭 학습 후 MTEB(eng, v2)로 평가.
트랜스포머 기본값()보다 6배가량 큰 학습률이 필요했다는 건 순환 모델의 최적화 지형(optimization landscape)이 다르다는 신호다. 순환 모델을 파인튜닝하려는 후속 연구자가 반드시 참고할 실용적 디테일이다. 기본값을 그대로 쓰면 성능이 안 나올 수 있다는 경고이기도 하다.
6.7 인스트럭션 (Appendix G)
학습 인스트럭션(Table 10, 11). 여러 인스트럭션을 가진 데이터셋의 통계와, 하나·둘의 고정 인스트럭션을 쓰는 데이터셋의 인스트럭션 목록이다.
| Dataset | Samples | Unique Instructions |
|---|---|---|
| Short-Short | 19,932 | 12,165 |
| Short-Long | 153,934 | 96,872 |
| Long-Short | 108,487 | 67,217 |
| Long-Long | 19,236 | 11,724 |
Table 10 (원논문): 파인튜닝에 쓰인, 여러 개의 서로 다른 인스트럭션을 담은 데이터셋의 샘플 수와 고유 인스트럭션 수.
합성 데이터셋들이 샘플 수에 육박하는 고유 인스트럭션을 갖는다는 게 인상적이다(Short-Long은 15만 샘플에 9.7만 고유 인스트럭션). 인스트럭션 다양성이 매우 높다는 뜻으로, 태스크 일반화를 노린 설계다.
| Datasets | Instruction (요지) |
|---|---|
| ELI5 | Reddit ELI5 포럼에서 가장 많이 추천된 답변 검색 |
| HotpotQA | 멀티홉 질문에 답이 되는 문서 검색 |
| MIRACL / NQ / SQuAD | 질문에 답하는 위키피디아 구절 검색 |
| MS MARCO | 웹 검색 쿼리에 관련된 구절/문서 검색 |
| NLI | 전제로부터 함의되는 가설 검색 |
| Quora Duplicates | 의미가 같은 질문 검색 |
| Synthetic Bitext | 병렬 문장(parallel sentences) 검색 |
| Synthetic STS | 의미적으로 유사한 텍스트 검색 |
| T2Ranking | 중국어 검색 쿼리에 답하는 웹 구절 검색 |
Table 11 (원논문): 하나 또는 두 개의 서로 다른 인스트럭션을 쓰는 데이터셋의 파인튜닝 인스트럭션.
평가 인스트럭션(Table 12, 13). 평가에는 태스크 유형별 인스트럭션과 태스크별 인스트럭션을 함께 쓴다. 검색·리랭킹 태스크는 인스트럭션을 쿼리에만 붙이고, 나머지는 모든 시퀀스에 붙인다.
| Task Type | Instruction |
|---|---|
| STS | Retrieve semantically similar text. |
| Summarization | Given a news summary, retrieve other semantically similar summaries |
| Bitext Mining | Retrieve parallel sentences. |
Table 12 (원논문): MTEB 평가에 쓰인 태스크 유형별 인스트럭션.
태스크별 인스트럭션을 담은 Table 13은 MTEB(eng)의 개별 태스크마다 지시문을 명세한다(AmazonCounterfactualClassification, ArguAna, ClimateFEVER, FiQA2018, HotpotQA, SciFact, TRECCOVID 등 40여 개). 대표 몇 개만 옮기면 다음과 같다.
| Task | Instruction |
|---|---|
| AmazonPolarityClassification | Classify Amazon reviews into positive or negative sentiment |
| ArguAna | Given a claim, find documents that refute the claim |
| Banking77Classification | Given an online banking query, find the corresponding intents |
| ClimateFEVER (HardNegatives) | Given a claim about climate change, retrieve documents that support or refute the claim |
| FiQA2018 | Given a financial question, retrieve user replies that best answer the question |
| HotpotQA (HardNegatives) | Given a multi-hop question, retrieve documents that can help answer the question |
| SCIDOCS | Given a scientific paper title, retrieve paper abstracts that are cited by the given paper |
| SciFact | Given a scientific claim, retrieve documents that support or refute the claim |
| TRECCOVID | Given a query on COVID-19, retrieve documents that answer the query |
Table 13 (원논문): MTEB 평가에 쓰인 태스크별 인스트럭션(일부 발췌). 원논문은 MTEB(eng)의 전체 태스크에 대한 지시문을 명세한다.
인스트럭션이 대부분 "Given X, retrieve Y" 형태의 검색 지향 문장이라는 게 눈에 띈다. 임베딩 모델을 검색 중심으로 정렬하는 E5-mistral-7b 계열의 관행을 그대로 따른 것이다.
7. 강점과 한계
강점
- 통제된 비교 설계. 순환과 트랜스포머를 동일한 레시피·데이터·하이퍼파라미터로 파인튜닝하고, 그 전에 파이프라인이 기존 재현판을 웃도는지(Table 2)부터 검증했다. 덕분에 Table 1의 품질 비교가 "아키텍처의 순수 효과"에 최대한 근접한다. 임베딩 논문에서 이 정도의 통제는 드물다.
- 메모리 상수화라는 실질적 이득. Figure 4·5의 메모리 곡선이 보여주듯, 수직 청킹은 입력 길이가 수직 청크를 넘으면 메모리를 상수로 눕힌다. 32K 토큰 문서를 트랜스포머가 메모리 초과로 배치 처리조차 못 할 때(Figure 5의 배치 32), 순환 모델은 여유롭게 돈다. 장문·대량 배치라는 실무 시나리오에서 직접적 가치다.
- 아키텍처 일반성. 수직 청킹이 Mamba2에 국한되지 않고 RWKV7·xLSTM에도 동일하게 통한다는 걸 실험(Figure 5·10)으로 확인했다. 특정 모델의 트릭이 아니라 "선형 순환 + 병렬 이중 형식"을 갖는 계열 전반의 스케줄링 원리라는 주장에 힘이 실린다.
- 재현성에 대한 성의. 빈 삼중항 필터링(Table 8), Mamba2의 학습률 튜닝(Table 9), 하드웨어 3종 재현(Appendix E), 실무 파라미터 가이드(E.1)까지 - 후속 연구자가 바로 따라 할 수 있게 디테일을 촘촘히 공개했다. 모델 체크포인트와 추론 구현도 공개한다.
한계 및 아쉬운 점
- 품질 평가가 Mamba2에 집중. 추론 효율은 RWKV·xLSTM까지 확장했지만, 임베딩 품질(MTEB 점수) 평가는 Mamba2만 대상으로 했다. RWKV·xLSTM을 임베더로 파인튜닝하면 품질이 어떤지는 미제로 남았다. 효율 일반성은 보였으나 품질 일반성은 아직 공백이다.
- 백본 사전학습의 불공정성. 저자들도 인정하듯, Mamba2 1.3B는 700B 토큰으로 사전학습됐는데 이는 Qwen2 1.5B(7T 토큰)의 1/10 규모다. Codestral Mamba2 7B는 코드 특화 모델이라 사전학습 구성 자체가 다르다. 그래서 영어 검색의 격차가 "아키텍처 한계"인지 "사전학습 열위"인지 딱 잘라 말하기 어렵다. 동등한 조건에서 사전학습된 순환 백본으로 재검증이 필요하다.
- 입력 길이 분포를 통제하지 않음. 벤치마크의 실제 입력 길이 분포를 고려하지 않았고, 입력 길이를 체계적으로 바꿔가며 품질을 측정하지도 않았다. 순환 모델의 강점이 장문에 있는데, 정작 품질-길이 관계를 세밀히 파고들지 않은 건 아쉽다. Figure는 런타임·메모리의 길이 의존성만 보여줄 뿐, 품질의 길이 의존성은 다루지 않는다.
- 영어 검색이라는 구조적 약점. v1·v2 양쪽에서 순환 모델의 영어 검색이 6점 이상 뒤진다(Table 5·7). 저자들은 사전학습 탓으로 돌리지만, 상수 크기 상태로 긴 문맥의 정밀 검색을 하는 순환 모델의 근본적 정보 병목(information bottleneck)일 가능성도 배제하기 어렵다. 이 부분은 더 파고들 만한 여지가 있다.
- 수식의 가독성. 논문 본문의 핵심 방정식(청크 추론 세 단계)이 표기가 촘촘해 처음 읽을 때 따라가기 벅차다. Appendix A의 유도가 있긴 하지만, Dao & Gu(2024)의 블록 분해에 대한 사전 지식이 없으면 진입 장벽이 높다.
8. 마치며
이 논문의 성취를 한 문장으로 줄이면, **"순환 언어 모델을 트랜스포머급 임베더로 파인튜닝할 수 있고, 수직 청킹으로 그 추론을 입력 길이와 무관한 상수 메모리로 돌릴 수 있다"**는 것이다. 두 주장 모두 세 벤치마크와 세 아키텍처, 세 하드웨어에 걸친 실험으로 뒷받침된다.
품질 면에서 순환 모델은 다국어에서 트랜스포머를 앞서고, 장문 검색에서 맞먹으며, 영어 검색에서만 눈에 띄게 뒤진다. 이 격차마저 저자들은 아키텍처가 아닌 사전학습 규모·구성의 차이로 본다. 통제 실험의 설득력과 남은 변수(백본 사전학습)의 존재가 공존하는 지점이다.
진짜 기여는 수직 청킹이라는 스케줄링 아이디어다. 시퀀스를 레이어 방향으로 잘라 "한 블록을 전 레이어에 먼저 통과"시키는 단순한 전치(transpose)가, 전 시퀀스 활성값 저장을 없애고 메모리를 모델 깊이의 함수로 바꾼다. 게다가 병렬화 손실이 작은 청크 크기에서 이미 포화되므로 속도 손해도 거의 없다. "메모리 제약 아래 거의 완전 병렬 속도"라는 실용적 스위트 스팟을, 튜닝 부담 없는 다이얼() 하나로 제공한다.
가져갈 것은 분명하다. 장문 문서나 대량 배치를 임베딩해야 하는데 트랜스포머의 메모리 벽에 막혔다면, 순환 임베더 + 수직 청킹은 지금 당장 검토할 만한 대안이다. 그리고 더 충실히 사전학습된 순환 백본이 나온다면 - 저자들의 전망대로 - 영어 검색의 격차마저 좁아지면서, 장문·자원 제약 환경을 위한 새로운 임베딩 모델 계열의 문이 열릴 수 있다. 순환 모델의 임베딩 활용이 아직 초기라는 점을 생각하면, 이 논문은 그 방향의 탄탄한 이정표다.
References
- Grantner, Sallinger, Flechl. Linear-Time and Constant-Memory Text Embeddings Based on Recurrent Language Models. arXiv:2604.18199.
- Dao & Gu (2024). Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality (Mamba2).
- Wang et al. (2024). Improving Text Embeddings with Large Language Models (E5-mistral-7b).
- Springer et al. (2025). E5-mistral-7b 재현 및 합성 데이터 공개.
- Peng et al. (2023, 2025). RWKV: Reinventing RNNs for the Transformer Era.
- Beck et al. (2024). xLSTM: Extended Long Short-Term Memory.
- Muennighoff et al. (2023). MTEB: Massive Text Embedding Benchmark.
- Enevoldsen et al. (2025). MMTEB: Massive Multilingual Text Embedding Benchmark.
- Zhu et al. (2024). LongEmbed: Extending Embedding Models for Long Context Retrieval.
- Dao et al. (2022), Dao (2024). FlashAttention / FlashAttention-2.
- van den Oord et al. (2019). Representation Learning with Contrastive Predictive Coding (InfoNCE).
- Dettmers et al. (2023). QLoRA. / Hu et al. (2022). LoRA.