논문 리뷰
논문 리뷰: SemCSE-Multi - Multifaceted and Decodable Embeddings for Aspect-Specific and Interpretable Scientific Domain Mapping
하나의 논문을 "가설", "종", "생태계", "방법론" 같은 여러 관점(aspect)별로 따로따로 임베딩하고, 그 임베딩을 다시 자연어로 되돌려 읽을 수 있게 만든 완전 비지도 프레임워크.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | SemCSE-Multi: Multifaceted and Decodable Embeddings for Aspect-Specific and Interpretable Scientific Domain Mapping |
| 저자 | Marc Brinner, Sina Zarrieß (Bielefeld University, Computational Linguistics) |
| 학회/저널 | arXiv Preprint, 2026 (v2) |
| 논문 링크 | arXiv:2510.11599 |
| 코드 | github.com/inasargumentation/SemCSE-Multi |
1. 들어가며
과학 논문은 매년 기하급수적으로 쏟아진다. 특정 분야에 처음 발을 들인 연구자가 "이 분야에 어떤 흐름이 있고, 내 연구와 가까운 논문은 무엇인가"를 파악하는 일은 갈수록 어려워지고 있다. 이 문제에 대한 표준적인 처방은 임베딩(embedding)이다. 논문 초록을 밀집 벡터(dense vector)로 사상하면 유사도 계산, 대규모 검색, 의미 기반 클러스터링과 시각화가 한꺼번에 가능해진다. SPECTER, SciNCL, SPECTER2 같은 모델들이 바로 이 목적으로 만들어졌다.
그런데 이렇게 만들어진 임베딩 공간에는 두 가지 근본적인 문제가 있다. 첫째는 해석 불가능성(interpretability)이다. t-SNE로 논문 지도를 그려놓고 보면 점들이 이리저리 뭉쳐 있는데, "이 영역은 무슨 의미인가", "왜 이 논문이 여기에 찍혔는가"를 설명할 방법이 없다. 좌표는 있지만 좌표의 뜻이 없는 셈이다.
둘째가 더 본질적이다. 기존 임베딩은 단일하고 고정된, 그것도 암묵적인 유사도 개념에 의존한다. 그런데 유사도라는 것 자체가, 어떤 관점에서 보느냐를 명시하지 않으면 정의될 수 없는 개념이다. 이건 새로운 통찰이 아니라 이미 Goodman(1972)이 "Seven strictures on similarity"에서 지적했고 Bär et al.(2011)이 재확인한 오래된 문제다. 그럼에도 기존 모델들은 논문이 가진 수많은 관점을 하나의 벡터로 뭉개버린다. SPECTER는 서로 인용하면 가깝게 놓고, SciRepEval 계열은 저자를 공유하면 가깝게 놓고, SemCSE는 "대략의 의미적 관련성"으로 가깝게 놓는다. 결과적으로 (1) 두 논문이 왜 비슷한지 그 요인을 알 수 없고, (2) 특정 관점만 떼어내서 유사도를 보는 것이 불가능하다.
이 논문이 주 무대로 삼는 분야는 **침입생물학(invasion biology)**이다. 외래종이 새로운 생태계에 유입되어 일으키는 생태·경제·사회적 영향을 다루는 분야인데, 이 영역에는 "생태계의 어떤 특성이 침입 가능성에 영향을 주는가" 같은 일반적 인과 가설이 중심 역할을 한다. 어떤 연구자는 다루는 종이나 생태계가 전혀 달라도 같은 가설을 검증하면 관련 연구로 본다. 반면 다른 연구자는 가설과 무관하게 특정 종이나 생태계에만 관심이 있어서, 완전히 다른 가설을 다루는 연구를 서로 관련 있다고 여긴다. 여기에 더해 연구 질문, 방법론, 정책 제언 같은 보조 관점들도 유사도 판단의 축이 될 수 있다.
정리하면, 사용자마다 "비슷하다"의 기준이 다르다. 그렇다면 임베딩 공간도 하나의 고정된 유사도가 아니라, 사용자가 지정한 관점에 맞춰 조절 가능한(aspect-specific, user-adaptable) 유사도를 지원해야 한다. SemCSE-Multi는 바로 이 요구를 정면으로 겨냥한다. 각 관점을 서로 분리된 임베딩으로 인코딩하고, 그 임베딩을 다시 자연어 설명으로 복원(decode)해서 해석 가능성까지 확보한다. 게다가 이 모든 과정을 지도 데이터 없이(unsupervised) 해낸다는 점이 핵심이다.
2. 기존 연구의 한계
2.1 인용 기반 시각화와 임베딩
과학 도메인을 시각화하는 고전적 방법은 인용 네트워크다. VOSviewer(van Eck and Waltman, 2010)나 CitNetExplorer처럼 서로 인용하는 논문을 관련 있다고 보고 군집화하는 방식이다. 여기서 한 단계 발전한 것이 인용 정보로 학습한 임베딩 모델들이다. SPECTER(Cohan et al., 2020), SciNCL(Ostendorff et al., 2022b), SPECTER2(Singh et al., 2023)는 서로 인용하는 논문을 임베딩 공간에서 가깝게 배치하도록 학습되어, 인용 네트워크에 직접 접근하지 않고도 유사도를 계산할 수 있다.
문제는 인용을 유사도의 대리 지표(proxy)로 쓴다는 데 있다. 두 논문이 인용 관계로 묶였을 때, 그것이 어떤 관점에서 관련된 것인지에 대한 정보도 통제권도 전혀 없다. 같은 가설을 다뤄서 인용했을 수도, 방법론이 비슷해서 인용했을 수도, 단순히 같은 저자라서 인용했을 수도 있는데 이 모든 것이 하나의 벡터로 뭉개진다.
2.2 다면적 임베딩(Multifaceted Embeddings)
단순한 유사도 정의를 넘어서려는 시도가 다면적 임베딩이다. 접근법의 스펙트럼은 넓다. 다운스트림 성능 최적화를 위해 모델이 스스로 관련 관점을 찾게 하거나(Zhang et al., 2022; Mysore et al., 2022), 인용이 논문 내 어디에 위치하는지로 참조된 관점을 추론하거나(Chakraborty et al., 2016; Ostendorff et al., 2020), 논문의 섹션별로 별도 임베딩을 만들거나(Singh and Singh, 2022), 특정 관점·태스크에 특화된 임베딩을 지도 데이터로 학습하는(Jain et al., 2018; Risch et al., 2022; Ostendorff et al., 2022a; Singh et al., 2023) 방식들이 있다.
일반 임베딩과 다면적 임베딩 모두에 공통된 한계가 있다. 사용자가 어떤 관점의 유사도를 볼지 직접 지정할 수 없다는 점이다. 이런 사용자 통제는 오직 대규모 지도 데이터셋에 의존하는 방법에서만 가능한데, 그런 데이터셋을 구축하는 것 자체가 대부분의 도메인에서 비현실적이다. 이 논문은 사용자에게 가장 관련 있는 관점을 명시적으로 인코딩하는 완전 비지도 방식의 다면적 임베딩을 제안해 이 한계를 정면으로 돌파한다.
2.3 임베딩 디코딩(Decoding Embeddings)
임베딩을 다시 자연어로 되돌리는 연구는 지금까지 주로 프라이버시 위협의 맥락에서 다뤄졌다. 임베딩 역전(embedding inversion) 공격, 즉 임베딩만 보고 원문을 복원해 정보 유출을 일으킬 수 있다는 위험성 연구(Li et al., 2023; Morris et al., 2023; Huang et al., 2024)가 대표적이다. 흥미로운 지점은, 이 기술이 해석 가능성 향상에 쓰일 수 있다는 가능성은 거의 탐구되지 않았다는 것이다. SemCSE-Multi는 바로 이 미개척 방향을 파고든다. 공격 도구였던 디코딩을 해석 도구로 뒤집는 셈이다.
3. 핵심 아이디어
이 프레임워크의 발상은 세 문장으로 요약된다. 첫째, 각 관점을 따로 학습한 임베딩 모델로 서로 분리된 임베딩 공간을 만든다. 둘째, 이 여러 모델을 **하나의 통합 모델로 증류(distill)**해서 초록 하나만 넣으면 모든 관점 임베딩이 한 번의 forward pass로 나오게 한다. 셋째, 임베딩을 다시 자연어로 복원하는 디코더를 붙여서 공간 전체를 읽을 수 있게 만든다.
여기서 지도 데이터가 필요 없다는 점이 결정적이다. 관점별 유사도를 사람이 라벨링한 데이터셋 대신, LLM을 시켜 **관점별 요약 문장(aspect-specific summarizing sentence)**을 생성한다. 예를 들어 "종(species)" 관점이라면, 초록에서 종의 분류학적 수준·먹이 습성·번식 전략 같은 기능적 특성만 뽑아 문장으로 만들되 실제 종 이름은 절대 쓰지 않도록 프롬프트로 강제한다. 이렇게 하면 모델이 "같은 이름이니까 같다"는 얄팍한 학습을 못 하고, 대신 종의 생태적 역할이라는 일반화 가능한 의미를 학습하게 된다.
한 초록에 대해 같은 관점의 요약을 여러 번(4회) 생성하면, 표현은 조금씩 다르지만 의미는 정렬된 문장 쌍들이 생긴다. 이 쌍들을 가깝게 놓도록 대조 학습(contrastive learning)을 하면, 그 관점에 특화된 의미 공간이 만들어진다. SemCSE(Brinner and Zarriess, 2025)에서 검증된 "LLM 요약 기반 임베딩" 아이디어를 관점별로 확장한 것이 첫 단계의 뼈대다.
기존 방법과의 근본적 차이는 이렇다. 인용 기반 모델이 "왜 비슷한지 모르는 하나의 유사도"를 준다면, SemCSE-Multi는 "가설로는 이만큼, 종으로는 저만큼 비슷하다"를 분리해서, 그리고 사용자가 가중치로 조합할 수 있게 준다. 게다가 임의의 좌표를 찍으면 "여기는 이런 의미의 영역"이라고 문장으로 답해준다.
4. 제안 방법 (Method)
4.1 전체 구조
프레임워크는 세 개의 핵심 요소로 구성된다. 순서대로 (1) 관점별 임베딩 모델 학습(Section 3), (2) 통합 모델 SemCSE-Multi로의 증류(Section 4), (3) 임베딩 디코딩(Section 5)이며, 여기에 (4) 저차원 시각화와의 인터랙션(Section 6)이 얹힌다. 데이터의 출발점은 Brinner et al.(2025)이 구축한 침입생물학 논문 초록 37,786편의 코퍼스다. 침입생물학 도메인 전문가의 자문을 받아 여섯 개 관점을 선정했는데, 가설(hypothesis), 생태계(ecosystem), 연구 질문(research question), 종(species), 방법론(methodology), 제언(recommendation)이다. 관점 선정 기준은 두 가지였다. 전문가가 시각화·문헌 검색에서 실제로 유용하다고 보는가, 그리고 그 관점이 초록에 충분히 자주 등장하는가. 두 번째 기준이 중요한 이유는, 전문(full-text)에만 있고 초록에는 없는 정보는 학습 파이프라인에서도 다운스트림 검색에서도 쓸 수 없기 때문이다.
4.2 관점별 임베딩 모델 학습
각 관점마다 독립된 임베딩 모델을 하나씩 학습한다. 먼저 학습 데이터를 만들어야 하는데, 초록 하나·관점 하나에 대해 요약 문장 여러 개가 필요하다. Mistral Small 3.1(24B)에게 초록당 4번 프롬프트를 넣어 해당 관점을 요약하게 하고, 그 관점이 적용되지 않는 연구라면 정확히 'Not applicable.'이라고 답하게 한다. 자기회귀 생성의 확률성 덕분에 4개의 요약은 표현이 조금씩 다르지만, 같은 생성 맥락을 공유하므로 의미적으로는 강하게 정렬된다.
이 요약 생성 프롬프트가 데이터 품질을 좌우한다. 아래는 가설(general) 관점용 프롬프트다.
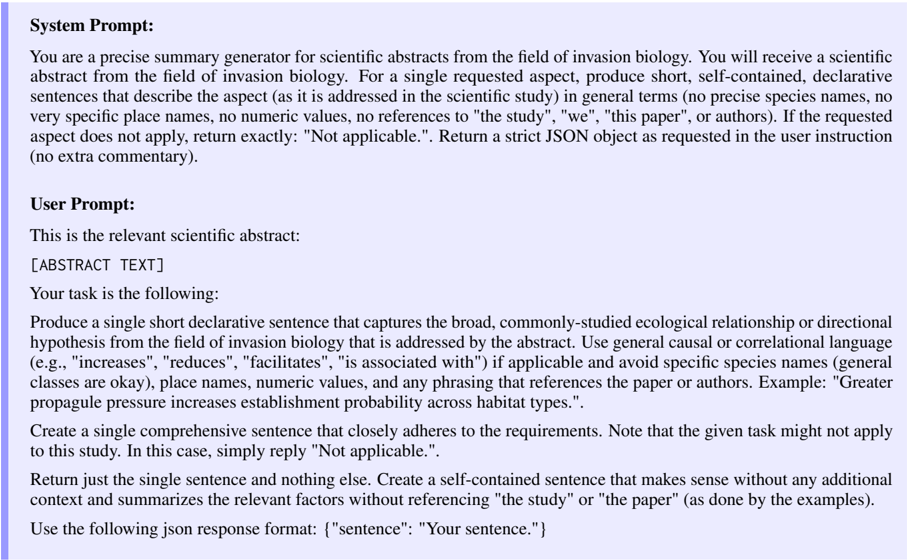
Figure 2 (원논문): 침입생물학 도메인에서 가설(general) 관점의 요약 문장을 생성하기 위해 Mistral Small 3.1(24B)에 제공한 프롬프트.
프롬프트를 뜯어보면 설계 의도가 선명하게 드러난다. 시스템 프롬프트는 "정확한 요약 생성기"라는 역할을 부여하면서, 구체적 종 이름·지명·수치·'this paper'/'we' 같은 자기지칭을 쓰지 말고 일반적 용어로만 서술하라고 못박는다. 유저 프롬프트에서는 "increases", "reduces", "facilitates", "is associated with" 같은 인과·상관 언어를 쓰라는 예시("Greater propagule pressure increases establishment probability across habitat types.")까지 제시한다. 이렇게 구체적 정보를 의도적으로 제거하는 이유는, 다음 단계의 매칭 태스크를 자명하지 않게(non-trivial) 만들기 위해서다. 종 이름이 그대로 남아 있으면 모델이 "이름이 같으니 같은 종"이라는 지름길을 학습해버리고, 서로 다른 이름의 종은 무조건 무관하게 취급한다. 이름을 지우고 기능적 특성만 남기면, 비로소 이름은 다르지만 생태적 역할이 비슷한 종들을 가깝게 놓는 일반화된 의미 공간이 만들어진다.
임베딩 모델 자체는 SemCSE 방식(Brinner and Zarriess, 2025)을 따른다. 같은 초록에서 나온 두 요약을 가깝게, 관련 없는 요약(같은 관점이지만 다른 초록)은 멀게 배치하는 대조 손실을 쓴다. 배치 에 대한 손실은 다음과 같은 InfoNCE 형태다.
여기서 는 같은 초록·같은 관점에서 나온 관련 요약 쌍의 임베딩이고, 은 코사인 유사도, 는 온도(temperature) 파라미터다. 분자는 관련 쌍을 가깝게, 분모는 배치 내 나머지 요약들을 밀어내는 역할을 한다. 직관적으로는 "같은 논문의 같은 관점 요약들끼리는 서로를 알아보게, 남의 논문 요약과는 헷갈리지 않게" 만드는 것이다.
베이스 인코더는 SciDeBERTa(Kim et al., 2023, 183M 파라미터)를 쓴다. SemCSE 원 논문이 채택했고 강한 성능을 보인 모델이라 동일 조건을 유지해 비교 변수를 줄이려는 선택이다. 768차원 CLS 토큰 임베딩을 선형 projection head로 150차원까지 낮춰 관점별 공간을 만든다. AdamW(lr 1e-5, weight decay 1e-4, 배치 32)로 최적화하며, 1,000 스텝마다 검증 검색 성능으로 체크포인트를 고른다.
4.3 통합 모델 SemCSE-Multi로의 증류
관점별 모델은 요약 문장 위에서만 동작한다. 그런데 실제 응용에서는 초록을 입력하면 곧바로 임베딩이 나와야 하고, 매번 LLM으로 요약을 생성하는 건 비싸고 일관성도 떨어진다. 그래서 관점별 모델들의 능력을 하나의 통합 모델로 증류한다. 이것이 SemCSE-Multi다.
증류 타깃을 만드는 방식이 깔끔하다. 각 초록·관점에 대해, 해당 관점 모델로 임베딩한 개별 요약들의 임베딩을 평균내서 단일 타깃 임베딩을 얻는다. 그리고 SemCSE-Multi는 이 타깃 임베딩을 전체 초록으로부터 직접 예측하도록 학습된다. 구조는 SciDeBERTa 인코더 하나에 관점 수만큼의 선형 head를 붙인 형태로, 각 head가 768차원 CLS 임베딩을 150차원 관점 임베딩으로 사상한다. 손실은 예측 임베딩과 타깃 임베딩 사이의 L2 손실이다.
여기서 는 초록, 는 그 초록에 적용 가능한(유효 요약이 하나 이상 있는) 관점들의 집합, 는 관점 의 head가 내놓는 예측 임베딩, 는 관점별 모델이 만든 요약 임베딩들의 평균 타깃이다. L2를 쓰는 이유는 알려진 타깃을 정밀하게 재구성하는 데 자연스러운 선택이기 때문이다. AdamW(lr 1e-4, weight decay 1e-4, 배치 16)로 학습하고 250 스텝마다 검증한다.
이 2단계 설계(관점별 격리 학습 → 통합 증류)가 왜 중요한지는 뒤의 5.6절 ablation에서 정량적으로 드러난다. 미리 요점만 말하면, 처음부터 통합 모델을 한 번에 학습하면 관점들 사이로 정보가 새어나가(leak) 분리(disentanglement)가 무너진다.
4.4 임베딩 디코딩
임베딩 공간은 본질적으로 추상적이다. 공간에서 조금 이동하는 것이 무슨 의미인지, 왜 특정 텍스트가 특정 위치에 놓이는지 알기 어렵다. 그런데 이 프레임워크에는 남들에게 없는 자산이 있다. 모든 관점 임베딩에 대해, 그 임베딩을 설명하는 요약 문장이 학습 데이터로 이미 존재한다는 점이다. 즉 (임베딩, 자연어 설명) 쌍이 대량으로 확보되어 있으니, 이걸 지도 데이터 삼아 디코더를 학습할 수 있다.
디코딩 파이프라인은 LLM의 자기회귀 생성 능력에 올라탄다. 먼저 관점 임베딩을 LLM의 입력 임베딩 공간으로 사상한다. 은닉층 하나(차원 768, sigmoid 활성화)짜리 dense feed-forward 네트워크가 입력 임베딩을 5개의 시퀀스 토큰으로 투사한다. 여기에 입력과 무관하게 학습되는 5개의 task descriptor 토큰을 앞에 덧붙여 "지금 무슨 작업을 하라"는 일반적 지시를 준다. 순수 자기회귀 모델을 쓸 때는 생성 텍스트와의 구분을 위한 delimiter 토큰 하나를 더 붙인다. 학습 시 LLM 본체는 **완전히 동결(frozen)**하고, 이 mapping 네트워크와 학습 토큰들만 표준 언어모델링 cross-entropy 손실로 최적화한다.
여기서 는 관점 임베딩, 는 mapping 네트워크가 만든 입력 토큰들, 는 복원 대상 요약 문장의 번째 토큰이다. 요약 문장을 임베딩 조건 하에서 재생성하도록 학습하는 것이다.
백본으로 성격이 다른 두 LLM을 비교한다. 하나는 순수 자기회귀 모델인 Llama 3 8B, 다른 하나는 더 큰(24B) 챗 모델인 Mistral Small 3.1이다. 후자는 애초에 요약을 생성한 바로 그 모델이라는 점에서, 전자는 SemCSE 원 논문에서도 쓰인 대표적 소형 자기회귀 LLM이라는 점에서 골랐다. hidden 차원 차이 때문에 mapping 네트워크는 Llama용 약 16M, Mistral용 약 24M 파라미터가 된다.
4.5 인터랙티브 임베딩과 디코딩
임베딩 공간은 고차원이어야 다양한 의미 요인을 담을 수 있지만, 사람이 보려면 2~3차원으로 투사해야 한다. 이 논문은 t-SNE(van der Maaten and Hinton, 2008)를 쓰되, t-SNE가 미분 가능하고 최적화 기반이라는 성질을 적극 활용해 세 가지 인터랙션을 가능하게 만든다.
t-SNE는 고차원에서 쌍별 거리 행렬 를 계산해 대칭 유사도 확률 로 바꾼 뒤, 저차원 좌표 의 유사도 확률 가 를 최대한 닮도록 KL 발산을 최소화한다. 거리는 코사인 거리 를 쓴다. 자세한 수식은 6.3절(부록 A.9)에서 다룬다.
첫째, 관점 가중치 조절. 관점별 거리 를 가중합해 결합 거리를 정의한다.
값을 조절하면 어떤 관점을 우선할지가 바로 시각화에 반영된다. 가설을 100%로 놓으면 가설 중심의 지도가, 종을 100%로 놓으면 종 중심의 지도가 나온다. 사용자가 슬라이더를 움직이듯 지도를 바꿀 수 있는 것이다.
둘째, 새 샘플 추가. 사용자가 제공한 새 논문을 기존 시각화에 얹으려면, 거리 행렬 를 새 샘플의 거리로 확장하고 새 좌표 에 대해서만 KL 목적함수를 최적화하면 된다. 기존 점들은 고정한 채로. 수렴을 빠르게 하려고 을 고차원 공간의 최근접 이웃 5개에 대응하는 저차원 좌표의 평균으로 초기화한다.
셋째, 임의 좌표의 고차원 임베딩 복원. 이게 가장 독창적인 부분이다. 사용자가 시각화의 빈 위치 을 찍으면, 기존 고차원 임베딩들을 모두 고정한 채 새 고차원 임베딩 을 최적화 변수로 도입해서, 그 점이 저차원에서 에 사상되도록 KL 목적함수를 최소화한다. 와 계산이 미분 가능하므로 이게 가능하다. 다만 안정성을 위해 을 원 공간의 상위 20개 주성분(PCA)으로 제약한다(, , ). 이렇게 복원한 고차원 임베딩을 다시 디코딩 파이프라인에 통과시키면, 비어 있던 좌표가 "이 영역은 이런 의미"라는 자연어 설명으로 채워진다. 지도의 빈 공간을 클릭하면 그곳의 의미를 읽어주는 인터페이스가 원리적으로 가능해지는 셈이다.
5. 실험 결과
5.1 실험 설정
주 평가 도메인은 침입생물학이다. 학습에는 37,786편 초록을, 평가에는 별도의 테스트셋 954편(Brinner et al., 2022)을 쓴다. 이 테스트셋은 도메인 전문가가 "10대 주요 가설 중 어느 것을 다루는가"를 라벨링해두었기 때문에, 가설 관점에 한해서는 사람 기준의 정답(ground truth)이 존재한다.
나머지 관점들은 대규모 전문가 라벨을 얻기 어렵다. 그래서 250개 샘플의 모든 쌍에 대해 LLM(Qwen3-30B-A3B-Instruct-2507)이 관점별 유사도 점수를 매기게 하고 이를 정답으로 삼는다. 평가지표는 두 종류다. 관점별 임베딩 모델은 요약 검색 태스크에서 **MRR(Mean Reciprocal Rank)**로, 통합 모델은 임베딩 유사도 순위와 정답 유사도 순위 사이의 Spearman 상관으로 평가한다.
는 쿼리 수, 는 번째 쿼리에서 정답 후보가 검색된 순위다. 순위가 1이면 1점, 2이면 0.5점 식으로, 정답이 위쪽에 검색될수록 높다.
비교 대상은 널리 쓰이는 과학 임베딩 모델들이다. SPECTER, SPECTER2 Proximity, SciNCL, SemCSE, 그리고 침입생물학 특화 모델 InvDef-DeBERTa(Brinner et al., 2025). 저자들은 다른 다면적 모델은 비교에서 뺐는데, 지도 데이터셋 없이 타깃 관점을 자유롭게 고를 수 있는 모델이 (저자들이 아는 한) 없기 때문이다.
5.2 관점별 임베딩 모델의 검색 성능
먼저 중간 산출물인 관점별 모델들이 제대로 학습됐는지 검색으로 확인한다. 각 관점마다 초록당 요약 2개를 뽑아 하나는 쿼리, 하나는 후보로 두고, 최대 954개 후보 풀에서 정답을 찾는 태스크다.
| Hypotheses | Ecosystem | Res. Question | Species | Methodology | Recommendation | |
|---|---|---|---|---|---|---|
| Samples | 954 | 951 | 954 | 954 | 954 | 63 |
| MRR Main model | 0.673 | 0.620 | 0.879 | 0.589 | 0.547 | 0.982 |
| MRR Other models | 0.556 | 0.404 | 0.757 | 0.374 | 0.352 | 0.903 |
| MRR SemCSE | 0.539 | 0.377 | 0.780 | 0.349 | 0.281 | 0.838 |
| MRR SciDeBERTa | 0.228 | 0.104 | 0.169 | 0.106 | 0.075 | 0.426 |
Table 1 (원논문): 관점별 요약 임베딩 모델의 검색 성능(MRR). Main = 해당 관점으로 학습된 모델, Others = 나머지 관점 모델들의 평균, SemCSE·SciDeBERTa = 베이스라인. 제안 모델(Main)은 볼드 처리.
전반적으로 Main 모델의 MRR이 대부분 0.5를 넘는다. 정답이 보통 상위 2개 안에 검색된다는 뜻이다. 여기서 진짜 중요한 건 Main과 Other의 격차다. 어떤 관점의 검색을, 그 관점으로 학습한 모델이 아니라 다른 관점 모델들로 수행하면 성능이 뚜렷하게 떨어진다. 예를 들어 종(Species)에서 Main 0.589 대 Others 0.374, 방법론(Methodology)에서 0.547 대 0.352다. 이 하락 자체가 "각 모델이 자기 관점에 특화된 정보를 학습했다"는 직접 증거다. 만약 모든 모델이 그냥 일반적 의미 유사도만 배웠다면 Main과 Others가 비슷해야 하는데, 그렇지 않다.
베이스라인 SemCSE는 일반 과학 텍스트로 학습된 모델이라 관점 특화 모델을 따라가지 못하고, 학습 전 SciDeBERTa 디코더는 예상대로 최하위다. 한 가지 눈에 띄는 예외는 연구 질문(Res. Question)인데, 여기서는 Others(0.757)와 SemCSE(0.780)도 상당히 높다. 연구 질문 요약이 다른 관점 정보와 자연스럽게 겹치는 부분이 많아서, 관점 특화의 이점이 상대적으로 작게 나타나는 것으로 보인다. 제언(Recommendation)은 유효 샘플이 63개뿐이라 수치 해석에 주의가 필요하지만, Main 0.982로 매우 높긴 하다.
다만 저자들도 명확히 선을 긋는다. 이 단계 모델들은 요약 문장 위에서만 동작하므로 실제 다운스트림 응용을 반영하지 못한다. 이들의 진짜 역할은 도메인·관점 관련 특성을 인코딩하는 의미 공간의 뼈대를 만드는 것이고, 그 위에서 통합 모델이 진짜 평가를 받는다.
5.3 통합 모델의 관점 분리 능력
핵심 평가는 Table 2다. SemCSE-Multi가 각 관점 임베딩으로 계산한 유사도가, 그 관점의 정답 유사도와 얼마나 상관되는지를 상관 행렬로 보여준다. 행은 임베딩 출처(관점별 임베딩과 베이스라인들), 열은 정답 유사도(사람이 라벨링한 가설 라벨 "Hypo-Labels", 그리고 나머지는 모두 LLM 생성)다. 모든 값은 Spearman 상관 ×100이다.
| 임베딩 출처 | Hypo-Labels | Hypothesis | Ecosystem | Res. Q | Species | Method. | Recom. |
|---|---|---|---|---|---|---|---|
| (예측자) Hypo-Labels | 100 | 35.1 | 8.7 | 37.8 | 9.8 | 19.4 | 5.8 |
| SemCSE-Multi: Hypothesis | 42.0 | 44.0 | 21.3 | 45.5 | 31.2 | 26.6 | 8.2 |
| SemCSE-Multi: Ecosystem | 13.5 | 15.7 | 37.3 | 14.6 | 23.2 | 16.1 | 4.1 |
| SemCSE-Multi: Research Question | 34.9 | 38.2 | 25.5 | 40.0 | 28.6 | 24.0 | 8.3 |
| SemCSE-Multi: Species | 15.0 | 16.9 | 30.8 | 16.5 | 44.8 | 20.7 | 4.3 |
| SemCSE-Multi: Methodology | 18.6 | 21.8 | 11.4 | 27.1 | 13.8 | 46.7 | 9.0 |
| SemCSE-Multi: Recommendation | 32.7 | 36.2 | 26.1 | 37.0 | 30.4 | 27.5 | 7.8 |
| SemCSE-Multi: Combined | 42.0 | 44.0 | 37.3 | 40.0 | 44.8 | 46.7 | 7.8 |
| Baseline: SPECTER | 18.9 | 26.1 | 31.5 | 28.9 | 34.5 | 24.0 | 5.1 |
| Baseline: SPECTER2 | 22.1 | 27.4 | 26.3 | 30.1 | 30.4 | 19.5 | 8.3 |
| Baseline: SciNCL | 20.7 | 28.6 | 30.4 | 30.2 | 37.5 | 23.6 | 6.3 |
| Baseline: SemCSE | 22.9 | 35.0 | 26.2 | 37.1 | 29.3 | 31.9 | 4.5 |
| Baseline: InvDef-DeBERTa | 21.0 | 32.2 | 26.8 | 37.8 | 29.7 | 30.9 | 9.4 |
Table 2 (원논문): 임베딩 유사도와 정답 유사도(사람 라벨 Hypo-Labels 또는 LLM 생성) 사이의 Spearman 상관(×100). SemCSE-Multi의 대각 성분(해당 관점 임베딩 vs 해당 관점 정답)은 볼드 처리.
읽는 순서가 있다. 먼저 맨 윗줄, 사람이 라벨링한 가설 라벨(Hypo-Labels)을 예측자로 넣어봤을 때 LLM 생성 가설 유사도와 35.1의 상관을 보인다. 사람 라벨과 LLM 라벨이 꽤 정렬된다는 뜻이고, 이는 LLM 기반 정답 생성이 합리적이라는 사전 검증이 된다. 이게 성립해야 나머지 LLM 정답을 믿고 쓸 수 있다.
핵심 관찰은 대각선이 일관되게 가장 높다는 것이다. 생태계 임베딩은 생태계 정답과 37.3으로 가장 잘 맞고, 종 임베딩은 종 정답과 44.8로, 방법론 임베딩은 방법론 정답과 46.7로 가장 잘 맞는다. 각 관점 임베딩이 자기 관점의 유사도와 가장 강하게 정렬된다는 것이 곧 관점이 제대로 분리(disentangle)되어 있다는 증거다. 나머지 비대각 셀들의 상관이 훨씬 낮다는 것은, 한 관점 임베딩이 다른 관점 정보를 거의 섞지 않았다는 뜻이다.
대각선을 벗어난 예외 몇 개는 오히려 이 그림을 강화한다. (1) 가설 임베딩이 사람 가설 라벨과 42.0으로 강하게 맞는다 - 가설 요인이 임베딩에 잘 담겼다는 확인이다. (2) 가설 임베딩과 연구 질문 정답 사이의 상관(45.5)이 연구 질문 자신의 대각값(40.0)보다도 높다. 이건 오류가 아니라 두 관점의 자연스러운 상호의존성이다. 대부분의 연구에서 검증하는 가설은 연구 질문과 직결되어 있으니, 두 관점이 겹치는 게 정상이다. 부록 A.6의 유의성 검정에서도 이 셀만은 무작위화 없이도 대각값을 넘어서는 예외로 명시된다.
베이스라인들과의 대비가 결정적이다. 침입생물학 특화 모델 InvDef-DeBERTa를 포함한 어떤 베이스라인도, 제언을 제외한 모든 관점에서 SemCSE-Multi의 대각 성분에 근접하지 못한다. 예컨대 방법론 정답에 대해 SemCSE-Multi는 46.7인데 최고 베이스라인(SemCSE)이 31.9다. 더 중요한 건, 베이스라인은 단일 임베딩이라 애초에 관점을 분리할 수 없다는 점이다. SciNCL 한 줄을 보면 가설 28.6, 생태계 30.4, 연구 질문 30.2, 종 37.5, 방법론 23.6으로, 모든 관점에 어중간하게 걸쳐 있고 어느 하나에도 특화되지 못한다. 사용자가 "종 관점만 보고 싶다"고 해도 떼어낼 방법이 없다.
Combined 행은 특히 인상적이다. 모든 관점 거리를 가중합한 단일 결합 거리인데, 각 열에서 그 관점의 대각값과 정확히 같은 값(가설 44.0, 생태계 37.3, 종 44.8, 방법론 46.7 …)을 달성한다. 즉 관점을 조합해도 각 관점의 특화 성능을 그대로 유지한다. 하나의 조율 가능한 유사도로 여러 관점의 최고 성능을 동시에 낸다는 뜻이다.
이 분리 능력을 눈으로 확인하는 것이 Figure 1이다.
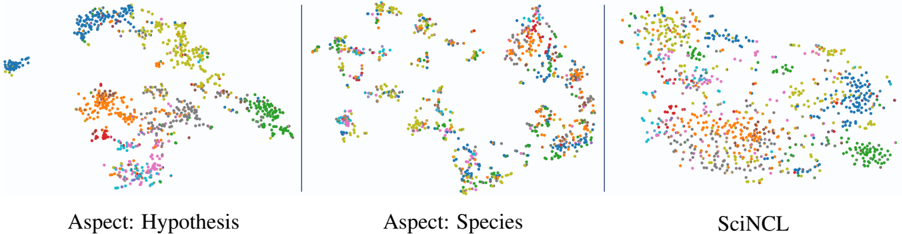
Figure 1 (원논문): 통합 임베딩 모델의 가설(좌)·종(중) 관점 임베딩 공간과 SciNCL(우) 모델의 t-SNE 시각화. 각 점은 테스트셋의 논문 한 편이며, 색은 사람이 라벨링한 가설 라벨을 나타낸다.
세 그림 모두 색은 동일하게 가설 라벨로 칠해져 있다. 그래서 가설 관점(좌)에서는 같은 색끼리 명확한 군집을 이룬다 - 가설로 임베딩했으니 당연하다. 종 관점(중)을 보면 같은 색이 여기저기 흩어진다. 같은 가설을 다루더라도 종이 다르면 종 공간에서는 멀어지기 때문인데, 이게 바로 "관점에 따라 유사도가 완전히 달라진다"는 프레임워크의 주장을 시각적으로 증명한다. 두 그림의 구조가 확연히 다르다는 것 자체가 관점 분리의 증거다. 오른쪽 SciNCL은 인용 기반 단일 임베딩인데, 색 군집이 훨씬 흐릿하고 구조가 덜 뚜렷하다. 특정 관점에 정렬되어 있지 않으니 가설 라벨로 칠해도 깔끔하게 나뉘지 않는 것이다.
제언(Recommendation) 관점만은 약하다(대각값 7.8). 저자들은 두 가지 이유를 든다. 초록에 명시적 제언이 드물어 학습 샘플이 적고(유효 5,414편에 불과), 제언이 없거나 암시만 된 경우 LLM이 없는 내용을 지어내(hallucinate) 요약 품질이 떨어진다는 것이다. 관점 자체의 결함이 아니라 데이터 희소성의 문제라는 진단이다.
5.4 임베딩 디코딩 성능
디코더가 임베딩을 정말로 의미 있게 되돌리는지, 아니면 그럴듯한 관점 관련 문장을 아무거나 만드는지를 가려야 한다. 그래서 세 가지 조건을 비교한다. Matching(맞는 임베딩으로 정답 요약 복원), Shuffled(한 샘플의 임베딩에 다른 샘플의 요약을 정답으로 매칭), Unconditioned(임베딩 정보 없이, 순수 자기회귀 Llama에만 해당). 지표는 정답 요약의 perplexity(낮을수록 좋음)와 생성 문장의 BERTScore(SciBERT 기반, 높을수록 좋음)다.
| Aspect | Llama Matching | Llama Reconst. | Llama Shuffled | Llama Uncond. | Mistral Matching | Mistral Reconst. | Mistral Shuffled |
|---|---|---|---|---|---|---|---|
| Perplexity | |||||||
| Hypotheses general | 5.86 | 8.16 | 22.52 | 53.88 | 5.43 | 8.07 | 25.21 |
| Hypotheses specific | 5.01 | 6.32 | 14.53 | 24.44 | 4.52 | 5.96 | 14.97 |
| Ecosystem | 5.39 | 7.12 | 16.50 | 46.97 | 5.38 | 7.13 | 17.05 |
| Res. Question | 5.76 | 8.67 | 21.80 | 27.18 | 5.93 | 8.43 | 20.62 |
| Species | 5.00 | 5.94 | 13.94 | 37.87 | 5.24 | 6.23 | 14.92 |
| Methodology | 5.37 | 6.67 | 16.37 | 94.08 | 5.58 | 6.64 | 16.94 |
| Recommendation | 13.14 | 17.82 | 27.14 | 65.50 | 12.15 | 16.72 | 27.05 |
| BERTScore | |||||||
| Hypotheses general | 77.5 | 76.1 | 71.9 | - | 79.2 | 77.6 | 72.9 |
| Hypotheses specific | 76.5 | 75.5 | 71.6 | - | 78.0 | 76.5 | 71.2 |
| Ecosystem | 77.2 | 76.1 | 73.0 | - | 78.6 | 77.4 | 73.7 |
| Res. Question | 74.5 | 72.3 | 69.0 | - | 75.9 | 74.1 | 70.4 |
| Species | 75.5 | 74.5 | 68.8 | - | 76.8 | 75.5 | 69.7 |
| Methodology | 78.7 | 77.8 | 72.5 | - | 79.9 | 78.9 | 72.9 |
| Recommendation | 70.1 | 69.4 | 67.8 | - | 70.6 | 69.0 | 68.5 |
Table 3 (원논문): Llama·Mistral 디코더의 perplexity와 BERTScore. Reconstructed는 저차원 시각화 위치에서 복원한 임베딩을 디코딩한 경우(6.4절). Matching 조건을 볼드 처리.
Matching perplexity가 대부분 5~6 수준으로 매우 낮다. 맞는 임베딩을 주면 디코더가 정답 요약을 높은 확률로 복원한다는 뜻이다. 반면 Shuffled는 14~27, Unconditioned는 24~94로 크게 뛴다. 특히 Unconditioned는 임베딩 없이 관점만 알고 문장을 짜내는 조건인데, 방법론(Methodology)에서 94.08까지 치솟는다. 임베딩이 없으면 그 논문이 어떤 방법론을 썼는지 알 길이 없으니 당연히 헤맨다. 이 대비가 곧 "디코더가 정말 임베딩의 내용을 읽고 있다"는 증거다.
BERTScore도 같은 이야기를 한다. Matching이 Shuffled보다 일관되게 5~6점 높다. 이건 단순히 정답의 likelihood만 오른 게 아니라, 실제 생성된 문장이 정답과 잘 맞는다는 뜻이라 더 강한 증거다. Llama(8B)와 Mistral(24B)의 차이는 크지 않은데, 오히려 Mistral이 perplexity에서 근소하게 낫다. 요약을 생성한 바로 그 모델이라 분포가 익숙한 덕으로 보인다. 이는 8B급 소형 모델로도 디코딩이 충분히 작동한다는 실용적 함의를 준다. 제언 관점만은 perplexity가 12~13으로 높은데, 앞서 본 학습 데이터 희소성이 여기서도 그대로 이어진다.
디코딩이 실제로 어떤 문장을 뱉는지는 Figure 3에서 확인할 수 있다. Russell et al.(2014)의 "기능적으로 동등한 침입종에 의한 재침입" 논문을 예시로, 관점별 원본 LLM 요약과 SemCSE-Multi 임베딩을 디코딩해 복원한 문장을 나란히 놓은 것이다.
| 관점 | LLM 요약 (원본) | 임베딩 복원 (Reconstruction) |
|---|---|---|
| Hypothesis-General | 여러 침입종이 서로 경쟁적으로 대체하며 침입 성공과 생물다양성 영향을 바꾼다. | 기존에 정착한 침입종의 존재는 두 번째 침입종의 성공적 침입 가능성을 낮춘다. |
| Hypothesis-Specific | 침입종은 경쟁적 상호작용으로 다른 침입종에 의해 대체될 수 있다. | 침입종은 우월한 경쟁 능력으로 기존 침입종을 밀어낼 수 있다. |
| Ecosystem | 교란 정도가 높고 침입이 잦은 섬 생태계를 다룬다. | 토착 설치류가 있고 인위적 교란이 잦은 섬 생태계. |
| Research Question | 상대적 우위와 번식체 압력에 매개된 정착·식민 침입종 간 경쟁이 기능적으로 유사한 침입자의 대체와 공존에 어떻게 영향을 주는가? | 타감작용 유무가 다른 두 침입종의 경쟁 동역학이 환경 조건에 따라 정착과 확산에 어떻게 영향을 주는가? |
| Species | 온대·열대 지역의 잡식성, 높은 번식력을 지닌 소형 설치류 여럿. | 온대 지역의 작고 일반적이며 잡식성인 침입 설치류로, 높은 번식력과 넓은 서식지 내성을 지님. |
| Methodology | 다양한 경쟁 시나리오 하의 개체군 동역학을 탐구한 이론적 모델링 프레임워크. | 다양한 생활사 형질과 경쟁 능력을 지닌 종 간 상호작용과 결과를 탐구한 예측 시뮬레이션 모델링 접근. |
| Recommendation | 보전 관리는 기존 침입종 제거가 또 다른 침입을 촉진할 수 있음을 고려해야 한다. | 관리자는 박멸과 공존 관리 전략을 고를 때 종 간 상대 적합도와 잡종화 가능성을 고려해야 한다. |
Figure 3 (원논문): SemCSE-Multi 관점 임베딩의 원본 요약과 복원 문장 비교. 예시 초록은 Russell et al.(2014), 테스트셋 포함.
복원 문장을 원본과 비교해보면 표현은 다르되 의미는 상당히 보존된다. 종 관점에서 "온대·잡식성·높은 번식력"이라는 기능적 특성이 그대로 살아나고, 생태계 관점에서 "교란이 잦은 섬 생태계"가 재현된다. 눈여겨볼 점은 이름이 전혀 등장하지 않는다는 것이다. 원본 요약이 애초에 종 이름·지명을 배제하도록 생성됐으니, 복원도 기능적 서술로만 이뤄진다. 반면 완벽하진 않다. 제언 관점의 복원은 "잡종화 가능성" 같은 원본에 없던 내용을 끌어오는데, 이는 제언 임베딩이 부실하다는 앞선 관찰과 일치한다. 연구 질문의 복원도 "타감작용(allelopathy)"이라는 원본에 없는 구체 개념을 넣는 등 다소 벗어난다.
5.5 빈 영역 디코딩: 시각화의 빈 공간 읽기
가장 새로운 실험이 이것이다. 저차원 시각화에서 아무 샘플도 없는 위치를 디코딩할 수 있는가? 절차는 이렇다. 한 관점만으로() t-SNE 시각화를 만들고, 추가 샘플을 임베딩 로 지도에 얹어 좌표 을 얻는다. 그다음 그 샘플을 다시 제거해서 을 빈 위치로 만들고, 그 빈 위치에 대해 새 고차원 임베딩 을 복원한 뒤 디코딩한다. 이때 정답은 원래 그 자리에 있던 샘플의 요약이다. 요컨대 "빈 자리를 디코딩하면, 원래 거기 있었을 샘플과 일관된 설명이 나오는가"를 검증한다.
결과는 Table 3의 Reconstructed 열에 있다. 예상대로 원본 고차원 임베딩을 직접 디코딩한 Matching보다는 약간 뒤진다(예: 가설 general에서 Llama 5.86 → 8.16). 2차원 투사는 단사(injective)가 아니라 여러 고차원 점이 같은 저차원 위치에 사상될 수 있으니 정보 손실이 불가피하다. 그럼에도 Reconstructed는 Matching에 상당히 근접하고, Shuffled(22.52)와는 확연히 차이 난다. 빈 위치에서 복원한 임베딩도 여전히 의미 있는 자연어 설명을 만들어낸다는 뜻이다. 지도의 빈 공간을 클릭해 "여기는 이런 연구가 있을 법한 영역"이라는 설명을 받는 인터랙션이 실제로 작동함을 보인 것이다.
5.6 두 단계 학습이 왜 중요한가 (Ablation)
4.3절에서 예고한 2단계 설계의 정당성을 부록 A.7이 검증한다. 비교 대상은 SemCSE-Multi와 동일한 구조(공유 인코더 + 관점별 head)를 쓰되, 한 번에 모든 관점을 통합 학습하는 baseline이다. 관점별로 배치를 나눠 대조 손실을 적용하고, 이번엔 요약뿐 아니라 전체 초록도 목적함수에 포함한다.
대각 성분(매칭 관점, 부진한 제언 제외 5개)의 평균은 두 방식이 거의 같다 - SemCSE-Multi 42.6, baseline 42.8. 즉 자기 관점을 맞히는 능력은 대등하다. 그런데 비대각 성분(가설-연구질문 셀 제외 18개)에서 갈린다. SemCSE-Multi가 21.43인 반면 baseline은 28.3이다. baseline은 관점 간 상관이 훨씬 높다. 다른 관점 정보가 새어 들어갔다는 뜻이고, 곧 분리가 나빠졌다는 뜻이다.
이유는 구조에 있다. baseline에서는 모든 관점 임베딩이 같은 고차원 인코더 출력에 선형 사상만 달리해서 나온다. 그래서 한 관점을 위한 업데이트가 공유 임베딩을 바꾸면 다른 관점 임베딩도 영향을 받는데, 그 변화가 다른 관점의 매칭 성능을 해치지 않는 한 되돌려지지 않는다. 결과적으로 관점 간 정보가 공유되어버린다. 반면 관점별 모델을 격리해서 학습하면 그 관점에 유용한 정보만 들어가고, 이렇게 잘 분리된 타깃을 통합 모델이 예측하도록 증류하는 것이다. 분리를 확보하려면 격리 학습이 필수라는 결론이다.
6. 부록: 상세 설정과 의료 도메인 실험
6.1 여섯 관점과 데이터셋
부록 A.1은 여섯 관점을 상세히 정의한다. 가설은 외래종의 정착·확산·영향을 설명하는 생태적 관계로, 일반형과 구체형 두 세분화를 실험했으나 프롬프트 개정 과정에서 둘이 비슷해져 요약 차이는 미미했다. 생태계는 기후대·서식지 구조·교란 같은 수용 생태계 특성, 연구 질문은 실험적·관찰적 대비와 관심 변수, 종은 (이름이 아닌) 분류학적 수준·먹이 습성·번식 전략 등 기능적 특성, 방법론은 현장 조사·조작 실험·모델링 등 접근법, 제언은 조기 탐지·서식지 복원 같은 관리·정책 제언이다.
부록 A.2는 요약 생성 프롬프트의 네 가지 설계 원칙을 밝힌다. (1) 관점 격리 - 종 이름·지명을 쓰지 말고 다른 관점 정보를 배제, (2) 비자명 매칭 강제 - 지나치게 구체적인 정보를 피하고 넓은 개념에 집중, (3) 유사도 관련 특성 포함 - 종 관점이라면 분류학적 수준·성장형·먹이 역할·기후 친화성·분산/번식 방식·침입 관련 형질까지 명시적으로 요구, (4) 비적용 처리 - 관점이 없으면 'Not applicable.' 출력. 데이터셋 규모는 다음과 같다.
| Aspect | Samples | Summaries |
|---|---|---|
| Hypothesis | 37,709 | 300,889 |
| Ecosystem | 35,684 | 140,480 |
| Research question | 37,718 | 150,778 |
| Species | 36,695 | 145,919 |
| Methodology | 37,389 | 148,795 |
| Recommendation | 5,414 | 19,522 |
Table 4 (원논문): 침입생물학 도메인의 관점별 데이터셋 규모.
가설만 요약이 30만 개로 압도적으로 많은데, 이는 일반형·구체형 요약을 병합해 학습했기 때문이다(일반화된 가설과 연구 특화 가설을 정렬하도록). 유효 샘플이 2개 이상인 초록만 포함되므로, 관점별로 초록 수가 조금씩 다르다. 제언은 5,414편으로 다른 관점의 1/7 수준에 그친다. 이 수치가 앞서 본 제언 관점의 모든 부진(Table 1의 63개 테스트 샘플, Table 2의 낮은 대각값, Table 3의 높은 perplexity)의 뿌리다.
6.2 LLM 유사도 평가와 통계적 유의성
부록 A.5는 Qwen3-30B-A3B로 쌍별 유사도 정답을 만드는 방법을 설명한다. 250개 샘플의 모든 쌍에 대해 관점별로 1~5 또는 1~6의 정수 점수를 매기게 하는데, 세 가지가 품질에 결정적이었다고 한다. (1) 고려할 요인과 무시할 요인(종 이름·지명 등)을 명시, (2) 각 점수의 요건을 담은 정밀한 채점 루브릭 제공, (3) 명시적 추론 강제 - 점수만 바로 뽑게 하면 품질이 낮아, 두 초록의 관련 요인을 먼저 요약한 뒤 점수를 매기게 했다. 이는 chain-of-thought의 축약판인데, Qwen3의 명시적 추론과 정확도는 비슷하면서 계산 효율이 훨씬 좋아 대량 쌍 처리가 가능했다. 이 평가 프롬프트가 Figure 4다.
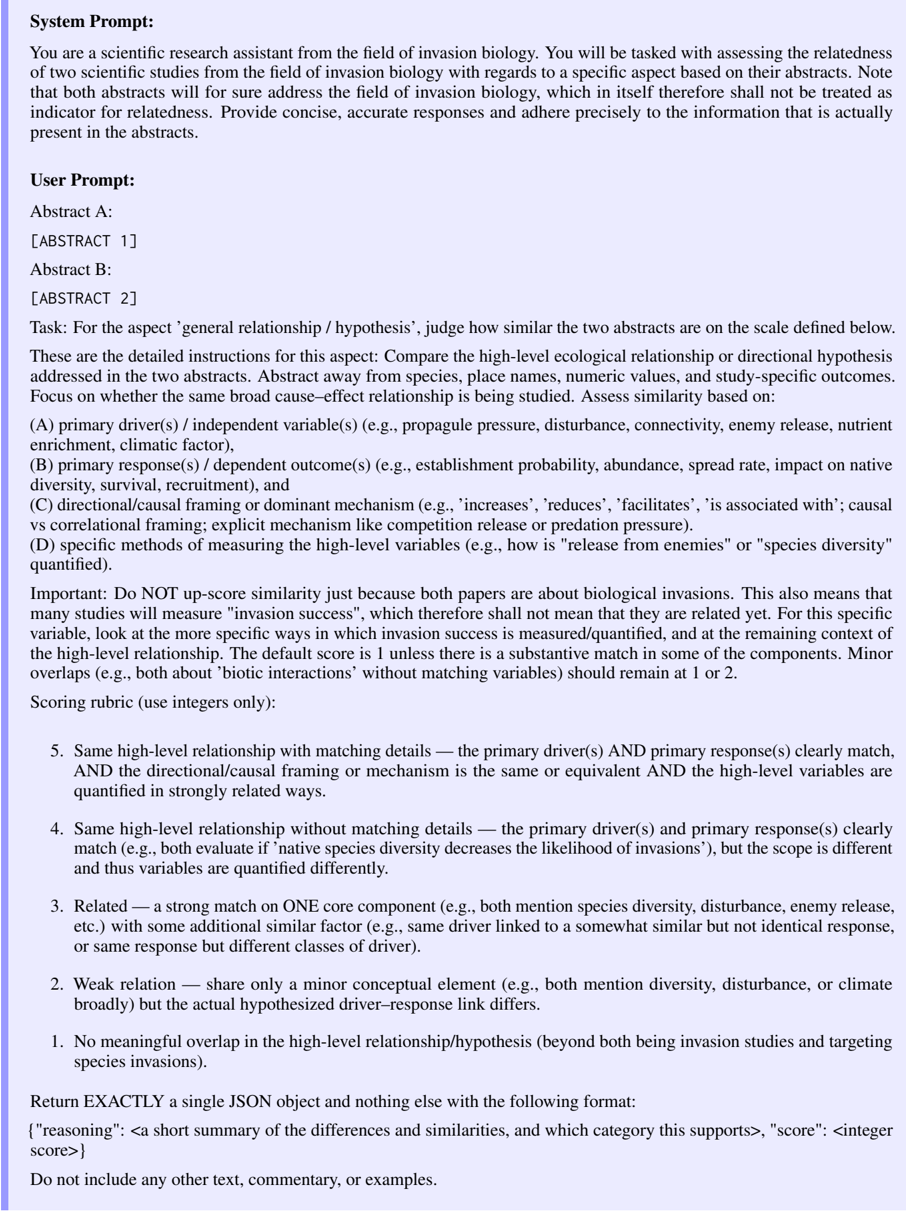
Figure 4 (원논문): 가설 관점에서 두 초록의 쌍별 유사도를 평가하기 위해 Qwen3-30B-A3B-Instruct-2507에 제공한 프롬프트.
프롬프트를 보면 채점 루브릭이 매우 구체적이다. 5점은 "주요 동인과 반응이 명확히 일치하고 방향성·메커니즘까지 같음", 1점은 "고수준 관계에 의미 있는 겹침 없음"으로, 각 점수의 경계를 예시와 함께 못박는다. 특히 "두 논문 다 생물학적 침입을 다룬다는 이유만으로 점수를 올리지 말라"는 지시가 눈에 띈다. 도메인이 같다는 사실 자체를 유사도로 착각하지 않게 막는 장치인데, 이런 세심한 통제가 정답 품질을 담보한다. 출력은 reasoning과 score를 담은 JSON으로 강제한다.
부록 A.6은 대각 우위가 우연이 아님을 순열 검정(permutation test)으로 증명한다. 관점 와 의 유사도 행렬 , 에서 각 셀을 무작위로 섞은 를 1만 번 만들어, 가 정답 와 만큼 높은 상관을 보이는 비율을 잰다. 모든 관점 쌍에서 1만 번 중 단 한 번도 매칭 설정만큼 높은 상관이 나오지 않았다. 즉 대각 우위는 통계적으로 유의하다. 예외는 (원래 부진한) 제언 관점과, 앞서 말한 가설 임베딩 vs 연구 질문 정답 셀뿐이다.
6.3 t-SNE와 인터랙션의 수식적 상세
부록 A.9는 t-SNE 수식을 정리한다. 고차원에서 조건부 확률은
로 정의되고, 이를 대칭화한다.
저차원에서는 자유도 1의 두꺼운 꼬리 Student-t 분포로 유사도를 모델링한다.
그리고 두 분포의 KL 발산을 최소화한다.
는 고차원 점, 는 저차원 좌표, 는 점별 대역폭(perplexity로 결정), 은 샘플 수다. 두꺼운 꼬리 분포가 무관한 점들이 한데 뭉치는 것을 막아준다. 부록 A.10은 새 점 삽입과 임베딩 복원의 최적화 세부를 다루는데, 앞서 4.5절에서 본 대로 새 좌표만 최적화하거나(삽입) 고차원 임베딩만 최적화하되(복원) 상위 20개 주성분으로 제약하는 방식이다. 부록 A.11은 빈 영역 디코딩 평가 절차로, leave-one-out 방식으로 매 샘플을 한 번씩 빼고 그 자리를 복원·디코딩해 perplexity를 평균낸다.
6.4 의료 도메인으로의 일반화
침입생물학에만 통하는 트릭이 아님을 보이려고, 부록 B는 의료 도메인 실험을 추가한다. 규모는 작게 잡아 PubMed 초록 15,000편(테스트 500, 검증 150), 관점 3개(질병 disease, 방법론 methodology, 환자군 patient group), 쌍별 평가 200 샘플로 한정했다. 침입생물학과 달리 도메인 전문가 자문 없이, 챗 LLM의 도움으로 관점을 골랐다. 선정 기준이 재밌는데, 도메인에 관련되면서도 기존 임베딩 모델이 잘 못 잡을 법한 관점을 일부러 택했다. 인용 기반 모델은 같은 질병을 다루는 논문끼리 잘 묶겠지만(그런 논문끼리 서로 인용하니), 방법론이나 환자군은 약할 것이라는 가설을 세운 것이다.
관점별 모델의 검색 성능부터 보자.
| Disease | Methodology | Patient Group | |
|---|---|---|---|
| Samples | 282 | 396 | 330 |
| MRR Main model | 0.859 | 0.741 | 0.694 |
| MRR Other models | 0.778 | 0.541 | 0.546 |
| MRR SemCSE | 0.811 | 0.548 | 0.510 |
Table 5 (원논문): 의료 도메인 관점별 모델의 검색 성능(MRR). Main 모델을 볼드 처리.
침입생물학과 같은 패턴이다. Main이 Others와 SemCSE를 앞선다. 다만 절대 수치가 전반적으로 더 높은데(질병 0.859), 저자들은 이를 데이터셋이 작아 후보 풀이 작기 때문이라고 명확히 짚는다. 성능 자체보다 Main > Others 구조가 재현된다는 점이 핵심이다.
통합 모델 평가는 두 지표로 나뉜다. 왼쪽은 전역 Spearman 상관, 오른쪽은 상위 10개 검색 정밀도다.
| 임베딩 출처 | Disease | Methodology | Patient Group |
|---|---|---|---|
| SemCSE-Multi: Disease | 20.29 | 7.57 | 7.81 |
| SemCSE-Multi: Methodology | 10.97 | 38.40 | 18.66 |
| SemCSE-Multi: Patient Group | 12.18 | 28.45 | 41.62 |
| SemCSE-Multi: Combined | 20.29 | 38.40 | 41.62 |
| SPECTER | 31.16 | 25.28 | 20.36 |
| SPECTER2 | 30.24 | 18.70 | 17.50 |
| SciNCL | 32.75 | 27.75 | 18.25 |
| SemCSE | 29.14 | 33.30 | 28.33 |
| MedEmbed-base | 30.98 | 31.78 | 18.56 |
| Clinical-ModernBERT | 14.81 | 39.94 | 25.03 |
Table 6 (원논문): 의료 도메인의 Spearman 상관(×100). 대각 성분 볼드.
방법론(38.40)과 환자군(41.62)에서는 어떤 일반 도메인 베이스라인도 SemCSE-Multi를 이기지 못한다. 의료 특화 모델을 둘(MedEmbed-base, Clinical-ModernBERT) 추가했는데도 그렇다. Clinical-ModernBERT만 방법론에서 39.94로 근소하게 앞설 뿐, 나머지 두 관점에서는 크게 뒤진다. 저자들이 세운 가설 - 기존 모델은 방법론·환자군에 약하다 - 이 정확히 맞아떨어진 것이다.
그런데 질병(Disease) 관점에서는 반전이 있다. SemCSE-Multi가 20.29로, SciNCL(32.75)·SPECTER(31.16) 등 여러 베이스라인에 뒤진다. 저자들은 이를 프롬프트 설계 미흡 탓으로 돌린다. 요약 생성 프롬프트가 "서로 다른 질병 사이의 의미 있는 유사도(공유 병리기전, 침범 장기계 등)"를 뽑도록 충분히 지시하지 못해서, 모델이 밀접한 질병만 잘 묶고 덜 관련된 질병들 사이의 미묘한 유사도는 못 잡는 공간을 학습했다는 것이다. 이 진단을 검증하려고 상위 10개 검색 정밀도를 따로 본다.
| 임베딩 출처 | Disease | Methodology | Patient Group |
|---|---|---|---|
| SemCSE-Multi: Disease | 50.35 | 21.90 | 41.15 |
| SemCSE-Multi: Methodology | 19.40 | 54.05 | 45.95 |
| SemCSE-Multi: Patient Group | 23.70 | 34.25 | 62.65 |
| SemCSE-Multi: Combined | 50.35 | 54.05 | 62.65 |
| SPECTER | 41.10 | 32.35 | 46.00 |
| SPECTER2 | 38.45 | 27.70 | 40.90 |
| SciNCL | 43.50 | 31.05 | 45.75 |
| SemCSE | 40.00 | 37.20 | 46.75 |
| MedEmbed-base | 42.30 | 31.60 | 46.95 |
| Clinical-ModernBERT | 25.00 | 41.85 | 47.50 |
Table 7 (원논문): 의료 도메인 상위 10개 검색 정밀도(%). 임베딩 기준 상위 10개 중 LLM 기준 상위 10개에도 드는 비율. 대각 성분 볼드.
전역 상관에서 뒤졌던 질병 관점이, 상위 10개 정밀도에서는 50.35로 모든 베이스라인을 크게 앞선다(SciNCL 43.5, MedEmbed 42.3). 즉 SemCSE-Multi의 질병 임베딩은 정말로 밀접한 질병을 찾는 데는 최고인데, 덜 관련된 질병들의 순서를 매기는 능력이 떨어졌던 것이다. 전역 상관 저조는 임베딩의 결함이 아니라 "먼 관계의 정렬" 문제였다는 저자 가설이 데이터로 확인된 셈이다. 이 두 표의 대비는 그 자체로 하나의 교훈이다. 하나의 지표만 보면 결론을 잘못 내릴 수 있고, 프롬프트 설계가 결과를 좌우한다는 것이다.
이 상관 행렬들은 논문에서 히트맵으로도 제시된다.
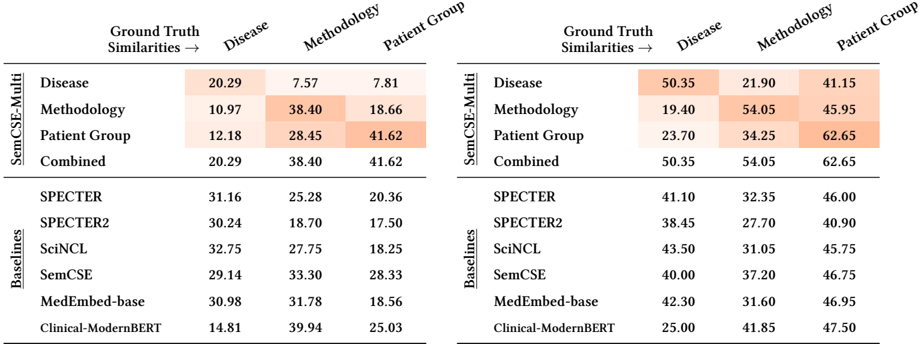
의료 도메인 Table 6(좌: Spearman 상관)과 Table 7(우: 상위 10개 검색 정밀도)의 히트맵. 진한 색일수록 높은 값이며, 대각선이 진하게 나타나는 SemCSE-Multi의 관점 분리가 시각적으로 드러난다. (원논문)
마지막으로 의료 도메인 디코딩 결과다.
| Aspect | Llama Matching | Llama Reconst. | Llama Shuffled | Llama Uncond. | Mistral Matching | Mistral Reconst. | Mistral Shuffled |
|---|---|---|---|---|---|---|---|
| Disease | 6.28 | 11.76 | 25.20 | 30.08 | 6.44 | 12.75 | 26.78 |
| Methodology | 6.71 | 10.63 | 26.73 | 167.37 | 6.91 | 10.90 | 30.14 |
| Patient Group | 7.39 | 11.02 | 39.44 | 111.86 | 7.49 | 11.46 | 48.73 |
Table 8 (원논문): 의료 도메인 디코더의 perplexity. Matching 조건 볼드. 낮을수록 좋음.
침입생물학과 일관된 그림이다. Matching perplexity(6~7)가 Shuffled(25~48), Unconditioned(30~167)보다 압도적으로 낮다. 특히 방법론 Unconditioned가 167.37로 폭발하는데, 임베딩 없이 그 논문의 연구 설계를 맞히는 게 불가능에 가깝다는 뜻이다. 빈 위치 복원(Reconstructed)도 Matching보다 약간 높을 뿐 Shuffled보다 훨씬 낮아, 시각화 위치 기반 디코딩이 다른 도메인에서도 작동함을 확인한다.
7. 강점과 한계
강점
- 완전 비지도 다면적 임베딩. 관점별 유사도를 사람이 라벨링한 데이터셋 없이, LLM 요약 생성만으로 여러 관점을 분리 학습한다. Table 2에서 다섯 관점 모두 대각값이 최고를 기록하고, 부록 A.6의 순열 검정으로 통계적 유의성까지 확보했다. 지도 데이터가 필요했던 기존 사용자 통제형 다면적 임베딩의 진입 장벽을 없앤 점이 실질적 기여다.
- 분리와 조합의 동시 달성. Table 2의 Combined 행이 보여주듯, 관점을 가중합한 단일 거리로도 각 관점의 특화 성능을 그대로 유지한다. 사용자가 슬라이더로 관점 비중을 바꿔가며 지도를 조율할 수 있다는 응용 시나리오가 원리적으로 뒷받침된다.
- 임베딩을 읽을 수 있게 만든 디코딩. Table 3에서 Matching perplexity(5~6)와 Shuffled/Unconditioned(14~94)의 큰 격차로, 디코더가 임베딩 내용을 실제로 복원함을 입증했다. 프라이버시 공격 기술이던 임베딩 역전을 해석 도구로 전환한 발상이 신선하다.
- 빈 공간까지 해석. 5.5절과 Table 3의 Reconstructed 열은, 시각화의 아무것도 없는 위치도 디코딩해 의미를 부여할 수 있음을 보인다. 사용자 중심 인터랙티브 탐색이라는 목표에 직접 닿는 결과다.
- 도메인 이식성 검증. 부록 B의 의료 도메인 실험으로 침입생물학에 국한된 결과가 아님을 보였고, 특히 "기존 모델이 약한 관점을 일부러 골랐더니 정말 우위를 보였다"는 검증(Table 6·7)이 프레임워크의 차별점을 잘 드러낸다.
한계 및 아쉬운 점
- LLM 요약에 대한 의존. 프레임워크 전체가 LLM 생성 요약 위에 서 있다. 저자들도 한계로 인정하듯, LLM의 편향이 정보의 표현·정렬에 미묘하게 스며들 수 있고 이를 정량화하기 어렵다. 요약 생성 모델(Mistral), 정답 평가 모델(Qwen3), 디코더(Llama/Mistral)가 모두 LLM이라 평가의 상당 부분이 LLM 대 LLM 구도라는 점도 짚어둘 만하다. 유일한 사람 기준 정답은 가설 관점 하나뿐이다.
- 희소 관점의 붕괴. 제언 관점은 유효 초록 5,414편(Table 4)에 그쳐, 검색·상관·디코딩 모든 지표에서 부진하다(Table 1·2·3). 초록에 드물게 등장하는 관점은 샘플 부족과 LLM 환각이 겹쳐 품질이 무너진다. 관점을 자유롭게 고를 수 있다는 장점이, 그 관점이 텍스트에 충분히 자주 나올 때만 성립한다는 조건부 강점인 셈이다.
- 프롬프트 설계에 대한 민감성. 의료 질병 관점의 전역 상관 저조(Table 6)가 순전히 프롬프트 미흡 탓이었다는 사실(Table 7에서 회복)은, 성능이 프롬프트 품질에 크게 좌우됨을 보여준다. 저자들 스스로 "고품질 프롬프트는 도메인 전문가의 세심한 감수를 요한다"고 결론짓는데, 이는 "완전 비지도"라는 강점의 실질적 비용이 프롬프트 엔지니어링과 전문가 자문으로 옮겨갔다는 뜻이기도 하다.
- 평가 규모와 지표의 제약. 통합 모델의 상관 평가가 250쌍(의료는 200쌍) 수준으로 크지 않고, 대부분 LLM 정답에 의존한다. 또 관점별 임베딩을 150차원으로 고정했는데 차원 선택의 민감도 분석은 없다. t-SNE 인터랙션도 정성적 시연(Figure 1)과 perplexity 대리 평가에 그쳐, 실제 사용자 연구(user study)로 유용성을 검증하지는 않았다.
- 효율·확장성 정보 부재. 요약을 초록당·관점당 4회 생성하고(관점 6개면 초록당 24회 LLM 호출) 250쌍을 모두 평가하는 비용, 디코딩 최적화(PCA 제약 하 반복 최적화)의 실시간 응답성 등 실무 배포에 필요한 수치가 빠져 있다. 인터랙티브 시각화를 표방하는 만큼 지연시간 정보가 있었으면 좋았다.
8. 마치며
SemCSE-Multi의 기여를 한 줄로 압축하면, "유사도는 관점을 명시해야 정의된다"는 오래된 통찰을 **비지도 학습으로 실제 구현하고, 거기에 읽을 수 있는 임베딩까지 얹었다"**는 것이다. 관점별 모델을 격리 학습한 뒤 하나로 증류하는 2단계 설계가 분리(disentanglement)의 열쇠였고(5.6절), 그 위에 디코딩을 붙여 임베딩 공간과 시각화의 빈 공간까지 자연어로 설명 가능하게 만들었다.
이 프레임워크가 매력적인 지점은 실용적 인터페이스로 곧장 이어진다는 데 있다. 연구자가 문헌 지도를 띄워놓고 "가설 70%, 방법론 30%로 보여줘"라고 비중을 조절하고, 지도의 빈 곳을 클릭해 "여기는 어떤 연구가 있을 영역인지" 설명을 받는 도구. 기존 임베딩이 좌표는 주되 뜻은 못 주던 한계를 정면으로 메운다.
동시에 이 논문은 LLM 기반 파이프라인의 명암을 압축적으로 보여준다. 지도 데이터를 안 써도 되는 대신 프롬프트 품질이 성능을 좌우하고(의료 질병 관점), 텍스트에 드문 관점은 무너지며(제언), 평가의 상당 부분이 LLM에 기댄다. "데이터 수집에서 데이터 제조로"의 전환이 가진 힘과 취약성이 한 논문 안에 모두 담긴 셈이다.
저자들이 결론에서 밝히듯, 이 프레임워크의 원리는 과학 텍스트에 국한되지 않는다. 관점을 명시하고 요약을 생성하고 임베딩을 분리·디코딩하는 절차는 비과학 도메인이나 이미지 같은 비텍스트 양식으로도 확장될 여지가 있다. 임베딩을 "계산 대상"에서 "읽고 조작하는 대상"으로 바꾸려는 시도로서, 후속 연구가 참고할 만한 설계 패턴을 여럿 남겼다.
References
- Brinner and Zarrieß, 2025. "SemCSE: Semantic Contrastive Sentence Embeddings using LLM-generated Summaries for Scientific Abstracts." arXiv:2507.13105.
- Brinner et al., 2025. "Enhancing Domain-Specific Encoder Models with LLM-Generated Data." arXiv:2503.22006. (InvDef-DeBERTa)
- Brinner et al., 2022. "Linking a Hypothesis Network from the Domain of Invasion Biology to a Corpus of Scientific Abstracts: The INAS Dataset." (테스트셋)
- Cohan et al., 2020. "SPECTER: Document-level Representation Learning using Citation-informed Transformers." ACL.
- Ostendorff et al., 2022b. "Neighborhood Contrastive Learning for Scientific Document Representations with Citation Embeddings." (SciNCL) arXiv:2202.06671.
- Singh et al., 2023. "SciRepEval: A Multi-Format Benchmark for Scientific Document Representations." (SPECTER2) arXiv:2211.13308.
- Kim et al., 2023. "MediBioDeBERTa: Biomedical Language Model with Continuous Learning and Intermediate Fine-tuning." IEEE Access. (SciDeBERTa)
- van der Maaten and Hinton, 2008. "Visualizing Data using t-SNE." JMLR.
- Morris et al., 2023. "Text Embeddings Reveal (Almost) as Much as Text." EMNLP. (임베딩 역전)
- Zhang et al., 2020. "BERTScore: Evaluating Text Generation with BERT." ICLR.
- Yang et al., 2025. "Qwen3 Technical Report." arXiv:2505.09388.
- Grattafiori et al., 2024. "The Llama 3 Herd of Models." arXiv:2407.21783.
- Mistral AI, 2025. "Mistral Small 3.1."
- Goodman, 1972. "Seven Strictures on Similarity." / Bär et al., 2011. "A Reflective View on Text Similarity." RANLP.