논문 리뷰
논문 리뷰: TALAS - Teacher-Anchored Layer Alignment with Adaptive Sharpness-Aware Minimization for Embedding Distillation
캐싱해둔 교사 임베딩만으로 LLM 임베딩 모델을 BERT급 소형 인코더로 증류하되, 상위 레이어만 교사에 앵커링하고 나머지는 위→아래로 자기 증류하며, ASAM으로 평평한 최소점을 찾아 일반화를 끌어올린 프레임워크.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | TALAS: Teacher-Anchored Layer Alignment with Adaptive Sharpness-Aware Minimization for Embedding Distillation |
| 저자 | Quoc Phong Dao*, Hoang Son Nguyen*, Pham Khanh Chi*, Linh Ngo Van† (Hanoi University of Science and Technology), Diep Thi-Ngoc Nguyen (VNU-UET), Thien Huu Nguyen (University of Oregon), Trung Le (Monash University) |
| 학회/저널 | arXiv preprint, 2026년 6월 (cs.CL) |
| 논문 링크 | arXiv:2606.21851 |
( 공동 1저자, † 교신저자)*
1. 들어가며
RAG 파이프라인이 실무의 기본기가 되면서, 검색 품질을 좌우하는 텍스트 임베딩 모델의 중요성은 두말할 필요가 없어졌다. 문제는 요즘 성능 상위권을 휩쓰는 임베딩 모델들이 하나같이 파라미터가 크고 임베딩 차원도 높다는 데 있다. MTEB 리더보드 상단을 보면 수십억 파라미터짜리 LLM 기반 임베딩 모델이 즐비한데, 이런 모델을 실제 서비스에 그대로 얹으면 지연시간과 서빙 비용이 감당하기 어려운 수준으로 뛴다. 그래서 "성능은 최대한 가져오되 크기는 줄이자"는 지식 증류(Knowledge Distillation, KD)가 자연스럽게 후보로 떠오른다.
그런데 KD 연구의 무게중심은 그동안 생성형 LLM 쪽에 쏠려 있었고, 정작 다운스트림 곳곳에서 쓰이는 임베딩 모델의 증류는 상대적으로 덜 파고들어졌다. 임베딩 증류에는 고유한 골칫거리가 있기 때문이다. 하나는 효율성과 효과성의 트레이드오프다. 교사의 hidden state나 attention 패턴 같은 내부 신호를 끌어다 쓰면 학생이 배울 감독 신호가 풍부해지지만, 교사가 수십억 파라미터짜리 LLM이면 그 내부 신호를 학습 중에 계속 뽑아내는 비용이 어마어마하다. 반대로 교사의 최종 출력 임베딩 하나만 쓰면 파이프라인은 가벼워지지만, 그 한 벡터에 눌러 담긴 의미를 학생이 온전히 복원하기가 쉽지 않다.
또 하나는 용량 격차(capacity gap) 문제다. 교사가 지나치게 강하면 오히려 증류가 잘 안 되는 역설이 잘 알려져 있다(Cho and Hariharan, 2019). 특히 임베딩 모델에서 학생의 얕은 레이어까지 교사의 고도로 추상화된 표현에 억지로 맞추려 하면, 저수준 언어 특징을 뽑아야 할 초기 레이어의 역할이 망가지면서 최적화가 오히려 불안정해진다.
TALAS는 이 두 문제를 정면으로 겨냥한다. 교사 임베딩을 학습 전에 한 번만 뽑아 캐싱해두고(학습 루프에서 교사 추론은 아예 없다), 그 임베딩을 학생의 상위 레이어에만 앵커로 걸며, 나머지 레이어는 학생 자신의 상위 레이어를 길잡이 삼아 위에서 아래로 구조를 전파한다. 마지막으로 Adaptive Sharpness-Aware Minimization(ASAM)으로 손실 지형의 평평한 최소점을 찾아 일반화를 안정화한다. 세 축이 맞물리면서, 4B짜리 Qwen3 임베딩 모델을 109M BERT-base로, 혹은 0.6B 모델을 22M MiniLM으로 증류하면서도 강력한 베이스라인을 일관되게 앞서는 결과를 낸다.
2. 기존 연구의 한계
논문의 Related Work(본문 2절과 Appendix A)는 증류 방식을 세 갈래로 정리한 뒤, 임베딩 특화 증류를 별도로 다룬다.
2.1 출력 증류 (Output Distillation)
가장 널리 쓰이는 형태로, 학생이 교사의 출력 분포나 출력 표현을 그대로 흉내 내도록 학습한다(Hinton et al., 2015; Sanh et al., 2020). 교사 내부 상태에 접근할 필요가 없어 오프라인·블랙박스 증류에 자연스럽게 들어맞고, 구현이 단순하며 효율적이라는 게 장점이다. 문제는 용량 격차가 클 때다. 출력 하나만 보고 배우면 학생이 교사 특유의 아티팩트에 과적합하거나, 교사 분포의 지배적이고 쉬운 부분만 골라 배우면서 미묘한 뉘앙스를 놓치기 쉽다(Cho and Hariharan, 2019; Gu et al., 2024).
2.2 관계 증류 (Relational Distillation)
출력 하나로는 부족하니, 개별 표현을 맞추는 대신 샘플 사이의 구조적 관계를 전달하자는 흐름이다. Relational Knowledge Distillation(RKD, Park et al., 2019)이 대표적으로, 임베딩 공간에서 쌍별 거리나 각도 관계를 보존한다. 표현 하나하나를 맞추는 것보다 의미 기하(semantic geometry)를 보존하는 편이 더 강건하다는 게 여러 연구에서 확인됐다(Jiao et al., 2020; Truong et al., 2025). 다만 쌍별 비교나 중간 상태 감독이 들어가면 메모리·연산 부담이 커지고, 특히 학습 중 교사 추론을 온라인으로 돌려야 하면 확장성이 크게 떨어진다.
2.3 교사 보조자 증류 (Teacher Assistant Distillation)
용량 격차 자체를 완화하려고 교사와 학생 사이에 중간 용량의 보조 모델을 끼워 넣는 접근이다(Mirzadeh et al., 2019). 표현 차이를 단계적으로 줄여주니 교사가 학생보다 훨씬 클 때 직접 증류보다 일관되게 낫다. 대신 보조 모델을 따로 학습·유지해야 하므로 학습 복잡도와 비용이 늘어난다는 게 근본적 제약이다.
2.4 임베딩 특화 증류
임베딩 교사는 대개 학생과 아키텍처·토크나이저·어휘가 다른 대형 LLM이라, 토큰 단위 정렬 자체가 비싸거나 불가능한 경우가 많다. 그래서 임베딩 전용 증류 연구는 상대적으로 드물다. DistillCSE(Xu et al., 2023)는 대조 학습으로 문장 표현을 전달해 토큰 단위 감독을 피했고, Jasper & Stella(Zhang et al., 2025a)는 다단계 증류 파이프라인으로 SOTA 임베딩 모델을 압축했으며, EMO(Truong et al., 2025)는 최적 수송(optimal transport)으로 샘플 간 관계를 정렬한다.
이들 대부분이 여전히 토큰 단위 감독, 중간 상태 매칭, 반복적인 온라인 교사 추론 중 하나에 의존한다는 게 공통된 한계다. TALAS의 출발점이 바로 여기다. "교사의 캐싱된 문장 임베딩만 쓰면서, 얕은 레이어를 억지로 교사에 맞추지 않고도 용량 격차를 넘을 수 있을까?"
3. 핵심 아이디어
TALAS의 통찰은 "교사를 어디에, 어떻게 걸 것인가"를 다시 설계한 데 있다. 세 가지 결정이 맞물린다.
첫째, 교사는 상위 레이어에만 건다. 저수준 언어 특징을 담당하는 얕은 레이어까지 교사의 추상적 임베딩에 맞추려 하면 오히려 학습이 망가진다. 그래서 학생이 교사의 임베딩 공간을 근사할 만한 용량을 이미 갖춘 상위 레이어에만 교사 앵커링을 제한한다.
둘째, 나머지는 학생 스스로 위→아래로 전파한다. 상위 레이어를 교사에 앵커링했으니, 그 바로 아래 레이어는 교사가 아니라 자기 위층()을 "길잡이"로 삼아 정렬한다. 이 사슬형 전파가 얕은 레이어를 교사에 직접 노출시키지 않으면서도, 얕은 층부터 깊은 층까지 표현 기하가 매끄럽게 이어지도록 다리를 놓는다. 여기서 점 단위가 아니라 **샘플 간 관계 구조(RKD)**를 인접 레이어끼리 맞춘다는 점이 중요하다. 절댓값 표현이 아니라 "배치 안에서 어떤 샘플이 어떤 샘플과 가깝다"는 위상만 전달하니, 얕은 레이어의 고유한 특징 추출을 파괴하지 않는다.
셋째, 평평한 최소점을 노린다. 코사인 기반 임베딩 증류는 인스턴스 단위의 강한 제약이라, 표준 SGD로 밀어붙이면 학생이 교사 출력에 과적합하면서 데이터의 밑바탕 구조를 못 배우는 위험이 있다(Stanton et al., 2021). ASAM으로 손실 지형의 sharpness를 억제하면, 학생은 교사의 넓은 의미 구조를 붙잡되 특정 임베딩 타깃에 과하게 매몰되지 않는다.
여기에 실무적으로 결정적인 한 가지가 더 붙는다. 교사 임베딩을 학습 전에 딱 한 번 뽑아 캐싱해두므로, 학습 루프 안에서 교사 추론이 완전히 사라진다. 이게 왜 큰가는 4절에서 저장 비용 계산과 함께 다시 짚는다.
기존 임베딩 증류가 "무엇을 얼마나 풍부하게 흉내 낼까"에 집중했다면, TALAS는 "어느 깊이에, 어떤 형태의 신호를, 어떤 최적화로" 전달할지를 분리해서 설계한 것이 근본적 차이다.
4. 제안 방법 (Method)
4.1 전체 구조
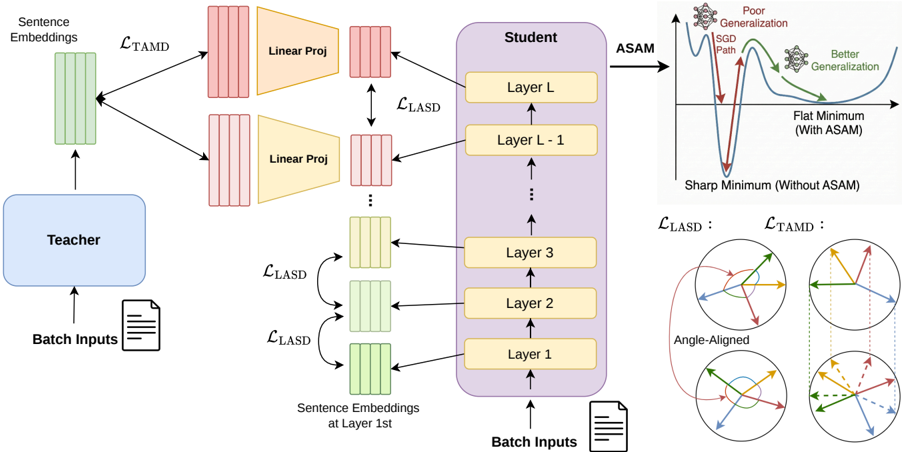
Figure 1: TALAS 프레임워크 개요. 교사(왼쪽)는 배치 입력에서 문장 임베딩을 만들고, 이 임베딩이 학습 가능한 Linear Projection을 거쳐 학생의 상위 레이어(Layer L, L-1)에 로 앵커링된다. 학생 내부의 인접 레이어끼리는 로 기하 구조 일관성을 강제한다. 전체 학습은 ASAM으로 최적화되어 평평한 최소점(오른쪽 위)을 향한다. 오른쪽 아래는 (각도 정렬, 관계 보존)와 (투영 후 점 단위 정렬)의 개념도. (원논문)
이 그림 한 장에 TALAS의 설계가 압축돼 있다. 왼쪽 파란 블록이 교사인데, 화살표가 배치 입력에서 문장 임베딩으로 한 번만 흐른다는 게 핵심이다 - 학습 중 교사는 다시 호출되지 않는다. 교사 임베딩은 두 개의 서로 다른 Linear Projection(노란 사다리꼴)을 거쳐 학생의 최상위 두 레이어(Layer L, Layer L-1)에 각각 로 연결된다. 같은 교사 임베딩을 여러 상위 레이어가 공유 앵커로 삼는 구조다.
학생 내부(보라색 스택)를 보면, 인접 레이어 사이마다 화살표가 걸려 있다. Layer 1↔2, Layer 2↔3처럼 위층이 아래층을 끌어주는 사슬이다. 맨 아래 "Sentence Embeddings at Layer 1st"까지 이 사슬로 교사의 구조가 전파된다.
오른쪽 위의 손실 지형 그림이 ASAM의 직관을 보여준다. 붉은 SGD 경로는 좁고 깊은 sharp minimum(일반화 나쁨)으로 빨려 들어가는 반면, 초록 ASAM 경로는 넓고 평평한 flat minimum(일반화 좋음)으로 향한다. 오른쪽 아래 두 개의 구(球) 그림은 두 손실의 성격 차이를 대비한다 - 는 벡터들의 상대적 각도 배치(관계)를 맞추고, 는 투영을 통해 개별 벡터를 교사 방향으로 끌어당긴다.
문제 설정을 정리하면 이렇다. 교사 와 학생 가 있고, 각각의 문장 임베딩을 , 로 쓴다. 학생의 레이어 에서 풀링한 임베딩은 이다. 풀링은 백본에 따라 [CLS](Devlin et al., 2019), [EOS](Zhang et al., 2025b), mean pooling(Lee et al., 2024) 등을 쓴다. 일반적인 KD 손실은 다음처럼 교사·학생 출력의 불일치를 재는 형태다.
여기서 는 cross-entropy, MSE, 유사도 기반 거리 등의 불일치 척도다. TALAS는 이 뼈대 위에 세 개의 손실(, , )을 얹고 ASAM으로 최적화한다.
4.2 Teacher-Anchored Multi-Layer Distillation ()
EOFD나 FDD 같은 선행 연구가 attention map, hidden state 같은 복잡한 내부 신호에 기대는 것과 달리, TALAS는 문장 임베딩 증류에만 집중해 연산 부담을 크게 줄인다. 감독 신호가 줄어든 만큼 의미 전달을 극대화하려고, "핵심 의미를 하위 레이어에 압축해 넣자"는 ESE(Li et al., 2025)의 표현 압축 원리에서 아이디어를 빌린다. 그래서 중간·최종 레이어를 모두 교사에 맞추고 싶지만, 용량 격차 탓에 전 레이어를 억지로 맞추는 건 역효과다. 결론적으로 앵커링은 상위 레이어에만 건다.
핵심은 교사의 최종 임베딩을 고정된 앵커로 두고, 학생의 여러 상위 레이어를 그 앵커에 정렬하는 것이다. 레이어 에 대한 손실과 전체 손실은 다음과 같다.
각 항의 의미는 이렇다. 은 학생의 전체 레이어 수, 은 배치 크기, 는 코사인 거리다. 는 레이어 마다 따로 두는 학습 가능한 투영 행렬로, 학생의 차원 를 교사 차원 로 매핑한다(그림의 Linear Proj가 바로 이것). 두 번째 식은 최상위부터 개 레이어()의 손실을 평균한다. 즉 가 앵커링하는 상위 레이어의 깊이를 정한다.
같은 교사 임베딩 가 여러 상위 레이어의 공유 앵커로 작동하는 게 이 설계의 묘미다. 최종 레이어에서만 감독을 주는 대신 여러 상위 레이어를 같은 목표에 걸면, 고수준 의미가 forward pass 도중에 일찍 주입되어 중간 레이어가 미리 의미를 획득한다. 단일 레이어 증류보다 학습이 안정되고 레이어 간 표현 drift가 줄어드는 이유다.
4.3 Layer-Aligned Self-Distillation ()
상위 레이어를 교사에 걸었으니 하위 레이어로 감독을 어떻게 이을지가 남는다. 그냥 하위 레이어까지 교사에 직접 맞추면 앞서 말한 대로 얕은 층의 특징 추출이 망가진다(Sun et al., 2019). 그렇다고 하위 레이어를 완전히 방치하면 감독받는 상위 레이어와 방치된 하위 레이어 사이에 표현의 단절이 생겨, 의미 구조가 네트워크를 타고 매끄럽게 흐르지 못한다.
TALAS의 답은 위에서 아래로 순차 전파하는 자기 증류다. 하위 레이어를 교사에 직접 매핑하지 않고, 학생 자신의 위층()을 아래층()의 동적 길잡이로 쓴다. 이 사슬형 접근 덕에 깊은 층은 고수준 추상을 유지하면서 얕은 층이 자기 구조를 잃지 않고 점진적으로 목표 공간에 다가간다.
이걸 인접 레이어 간의 기하 구조 일관성 문제로 정식화하는데, 여기서 RKD가 등장한다. 점 단위가 아니라 배치 안 샘플들의 구조적 관계를 보존하는 방식이다. 레이어 의 배치 임베딩을 라 하고, L2 정규화한 로부터 관계 행렬을 만든다.
의 각 원소 는 번째와 번째 샘플의 코사인 유사도, 즉 다. 이 행렬이 레이어 임베딩 공간의 기하 위상(topology)을 담는다. 목표는 인접 레이어의 구조적 발산을 최소화하는 것이고, 관계 행렬 차이의 Frobenius norm으로 손실을 정의한다.
는 제곱 Frobenius norm으로, 행렬 수준의 MSE 대용이다. 직관적으로 보면, 위층에서 "샘플 A와 B가 가깝고 C는 멀다"는 관계 지도가 아래층에서도 최대한 유지되도록 강제하는 것이다. 절댓값 임베딩을 복사하는 게 아니라 관계 지도만 물려주므로, 각 레이어는 자기 표현의 절대적 스케일과 저수준 특징을 지키면서도 위상만 정렬한다. 이 사슬을 통해 최상단에 걸린 교사 지식이 입력 레이어까지 구조적으로 흘러내리며 용량 격차를 메운다.
4.4 학습 목표와 대조 정규화 ()
와 는 모두 학생을 교사의 의미 공간에 맞추는 데 초점이 있다. 그런데 직접 감독에만 전적으로 기대면 위험이 있다. 교사 표현이 해당 학습 도메인에서 붕괴(collapse)하거나 이방성(anisotropy)이 심하면, 학생이 그 나쁜 기하 성질까지 물려받아 표현 공간이 쪼그라들 수 있다(Ethayarajh, 2019). 대조 학습은 uniformity를 최적화해 이 붕괴를 막는데, 서로 다른 샘플을 초구면 위에 고르게 흩뿌려 표현이 이방성 클러스터로 퇴화하는 걸 막는다(Wang and Isola, 2020).
그래서 SimCSE(Gao et al., 2022) 기반 비지도 대조 손실을 정규화 항으로 넣는다. 배치 문장을 서로 다른 dropout 마스크 로 두 번 통과시켜 두 뷰 , 를 얻고 다음을 최소화한다.
은 배치 크기, 는 온도, 은 코사인 유사도다. 이 항이 교사의 의미 안내를 받으면서도 넓고 균일한 표현 공간을 유지하도록 균형을 잡아준다.
최종 목표는 세 손실의 가중합이다.
는 세 항의 기여를 조절하는 하이퍼파라미터로, 실험에서는 , , 을 썼다(Appendix E). 대조 항의 가중치가 유독 작은 게 눈에 띄는데, 이 항은 어디까지나 표현 붕괴를 막는 안전장치 역할이고 실제 의미 전달은 두 증류 항이 주도한다는 설계 의도가 숫자에 드러난다.
4.5 ASAM 최적화
목표 함수가 학생을 교사에 잘 정렬시켜도, 표준 SGD로 증류 손실을 밀면 위험하다. 코사인 기반 임베딩 증류는 인스턴스 단위의 강한 제약이라 학생이 데이터 구조를 못 배운 채 교사 출력에만 과적합할 수 있고, 이는 교사에 대한 충실도는 높지만 일반화는 나쁜 결과로 이어진다(Stanton et al., 2021).
그래서 을 ASAM(Kwon et al., 2021)으로 최적화한다. 경험적 손실 를 직접 줄이는 대신 국소 min-max 문제를 푼다.
는 모델 파라미터, 은 적대적 섭동(perturbation), 는 이웃 크기를 조절하는 반경, 는 파라미터 크기에 따라 섭동을 정규화하는 파라미터 의존 스케일 행렬이다. 바로 이 가 SAM과 ASAM을 가르는 지점이다. 표준 SAM이 유클리드 이웃에서 섭동을 재는 반면, ASAM은 파라미터 스케일을 반영해 섭동을 정규화하므로 더 안정적이고 적응적이다. 강한 감독 신호나 큰 용량 격차가 있는 증류에서 특히 유용한 성질이다.
실제 최적화는 2단계 상승-하강 절차로 이뤄진다. Algorithm 1을 풀어 쓰면 이렇다.
- 사전 단계: 학습 시작 전, 교사 임베딩을 전 학습 데이터에 대해 한 번만 뽑아 캐시 에 저장한다.
- 각 스텝마다:
- 미니배치 를 뽑고, 캐시에서 대응하는 교사 타깃 를 꺼낸다.
- 상승(Ascent): 현재 가중치 에서 의 그래디언트로 섭동된 가중치 를 만든다().
- 하강(Descent): 섭동 위치 에서 그래디언트 를 다시 계산해 원래 파라미터 를 업데이트한다.
요약하면, "지금 위치가 조금만 흔들어도 손실이 확 튀는 뾰족한 골짜기인가?"를 매 스텝 점검하고, 그런 곳을 피해 넓은 분지로 학생을 인도하는 것이다. 대신 스텝마다 forward-backward를 두 번 돌아야 해서 학습 시간이 사실상 두 배가 되는데, 이 비용 얘기는 한계에서 다시 짚는다.
4.6 오프라인 교사 추론과 캐싱된 타깃 (Appendix C)
TALAS의 실무적 무기는 교사를 학습 루프에서 완전히 빼는 데 있다. 교사는 전처리 단계에서 딱 한 번 실행되어 전 학습 샘플의 문장 임베딩(마지막 CLS 임베딩)을 뽑아 저장하고, 학습 중에는 미니배치에 해당하는 사전 계산 임베딩만 lazy loading으로 불러온다.
왜 이게 큰 차이를 만드는지는 저장 비용 계산이 잘 보여준다. BERT 계열 교사가 샘플 하나당 모양의 hidden state를 낸다고 하면 개 원소, float32로 샘플당 약 768KB다. 10만 샘플이면 76GB를 넘어 대부분의 학습 환경에서 비현실적이다. 중간 레이어 hidden state까지 캐싱하는 방식이라면 이 비용이 더 폭증한다. 반면 문장 임베딩만 캐싱하면 샘플당 벡터 하나, float32로 약 3KB다. 10만 샘플이면 약 300MB로 줄어 오프라인 증류가 실용적이고 확장 가능해진다. 이 250배 차이가 TALAS가 문장 임베딩만 쓰기로 한 이유를 정량적으로 정당화한다.
5. 실험 결과
5.1 실험 설정
태스크와 데이터셋. 세 부류를 평가한다. Classification은 BANKING77, EMOTION, TWEETEVAL-SENTIMENT에서 F1, Pair Classification은 MRPC, SCITAIL, WIC에서 Average Precision(AP), STS는 SICK, STS12, STS-BENCHMARK에서 Spearman 상관을 잰다. 총 9개 데이터셋이다. EMO(Truong et al., 2025)의 태스크 선정 프로토콜을 따르되, EMO가 지도 학습(SFT)을 쓴 것과 달리 TALAS는 라벨 없이 SimCSE 스타일 비지도 목표로 학습한다.
학습 코퍼스. 세 in-domain 데이터셋(EMOTION, WIC, STS-BENCHMARK)에서 각 5,000문장씩 균등 샘플링해 하나의 라벨 없는 코퍼스로 합친다. 나머지 데이터셋은 out-of-domain으로 취급한다. 즉 학습은 딱 세 데이터셋의 텍스트만 보고, 평가는 9개 전부에서 이뤄지므로 도메인 이동(domain shift)에 대한 강건성을 정직하게 측정하는 구조다. (Appendix D를 보면 실제 코퍼스는 classification 5,000문장 + STS 2,500쌍 + pair classification 2,500쌍을 개별 문장으로 펼쳐 총 15,000문장으로 구성한다.)
모델. 학생은 BERT-base, MINILMV2 H384, MINILMV2 H768. 교사는 BGE-M3, QWEN3-EMBEDDING-0.6B, QWEN3-EMBEDDING-4B. 세 가지 교사→학생 조합을 체계적으로 평가한다: Qwen3-0.6B→MiniLMv2 H384(22M), BGE-M3→MiniLMv2 H768(66M), Qwen3-4B→BERT-base(109M).
베이스라인. 토큰 단위 KD로 DSKD, CDM, EMO를, 문장 단위 KD로 JASPER & STELLA, DISTILLCSE를 비교한다. 여기에 증류 없이 SimCSE만 돌린 SimCSE-unsup과, 학습 전 학생(Student base)도 참조점으로 둔다.
5.2 주요 결과 (Main Results)
Table 1은 세 교사-학생 조합 각각에서 9개 데이터셋 성능과 in/out-of-domain 평균을 보여준다. in-domain은 ⋆로 표시(Emotion, WiC, STSB)했다.
Qwen3-Embedding 0.6B → MiniLMv2 H384 (22M)
| Method | Banking77 | Tweet | Emotion⋆ | MRPC | SciTail | WiC⋆ | SICK | STS12 | STSB⋆ | Avg-In | Avg-Out | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Teacher | 93.21 | 71.33 | 66.53 | 83.37 | 90.00 | 66.85 | 80.64 | 77.11 | 84.60 | 72.66 | 82.61 | 79.29 |
| Student base | 68.29 | 41.07 | 69.90 | 78.39 | 64.56 | 59.58 | 47.60 | 21.95 | 22.08 | 40.91 | 58.45 | 52.60 |
| SimCSE-unsup | 86.67 | 69.56 | 54.00 | 82.29 | 73.76 | 65.71 | 66.04 | 59.11 | 62.08 | 60.60 | 72.91 | 68.80 |
| CDM | 86.07 | 70.32 | 53.04 | 81.97 | 72.97 | 68.34 | 65.97 | 61.12 | 65.75 | 62.38 | 73.07 | 69.51 |
| DSKD | 85.66 | 69.86 | 52.25 | 82.17 | 73.52 | 68.58 | 66.54 | 62.52 | 66.70 | 62.51 | 73.38 | 69.76 |
| Jasper & Stella | 85.94 | 71.25 | 57.99 | 83.36 | 76.17 | 68.25 | 70.57 | 63.81 | 70.11 | 65.45 | 75.18 | 71.94 |
| DistillCSE | 88.03 | 69.87 | 54.24 | 83.20 | 77.66 | 67.88 | 70.09 | 68.19 | 71.53 | 64.55 | 76.17 | 72.30 |
| EMO | 87.03 | 71.67 | 59.63 | 83.45 | 78.17 | 68.89 | 70.81 | 65.78 | 71.42 | 66.65 | 76.15 | 72.98 |
| TALAS | 86.69 | 72.77 | 60.94 | 85.10 | 81.42 | 66.65 | 72.51 | 70.77 | 76.22 | 67.94 | 78.21 | 74.79 |
BGE-M3 → MiniLMv2 H768 (66M)
| Method | Banking77 | Tweet | Emotion⋆ | MRPC | SciTail | WiC⋆ | SICK | STS12 | STSB⋆ | Avg-In | Avg-Out | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Teacher | 93.52 | 73.85 | 68.56 | 85.81 | 91.87 | 61.47 | 79.18 | 78.73 | 84.87 | 71.63 | 83.83 | 79.76 |
| Student base | 81.84 | 47.70 | 71.67 | 79.67 | 65.06 | 60.89 | 49.46 | 26.76 | 24.12 | 44.24 | 62.41 | 56.35 |
| SimCSE-unsup | 87.89 | 71.45 | 55.65 | 83.87 | 76.32 | 67.96 | 66.93 | 59.66 | 63.97 | 62.53 | 74.35 | 70.41 |
| CDM | 89.15 | 70.48 | 58.71 | 84.16 | 75.91 | 70.00 | 68.14 | 62.74 | 67.78 | 65.50 | 75.10 | 71.90 |
| DSKD | 89.51 | 70.53 | 57.27 | 84.39 | 75.36 | 69.96 | 68.81 | 66.78 | 70.05 | 65.76 | 75.90 | 72.52 |
| Jasper & Stella | 88.38 | 74.13 | 62.81 | 85.98 | 80.33 | 68.38 | 74.35 | 66.80 | 74.55 | 68.58 | 78.33 | 75.08 |
| DistillCSE | 90.50 | 72.70 | 59.88 | 84.39 | 78.48 | 69.49 | 73.97 | 70.00 | 73.73 | 67.70 | 78.34 | 74.79 |
| EMO | 90.19 | 74.26 | 61.48 | 85.31 | 80.82 | 68.30 | 75.41 | 67.06 | 76.35 | 68.71 | 78.84 | 75.46 |
| TALAS | 90.62 | 74.81 | 63.30 | 87.05 | 81.94 | 66.28 | 76.86 | 69.04 | 79.01 | 69.53 | 80.05 | 76.55 |
Qwen3-Embedding 4B → BERT-base (109M)
| Method | Banking77 | Tweet | Emotion⋆ | MRPC | SciTail | WiC⋆ | SICK | STS12 | STSB⋆ | Avg-In | Avg-Out | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Teacher | 93.63 | 72.22 | 68.94 | 84.79 | 91.77 | 66.80 | 83.43 | 82.55 | 86.87 | 74.20 | 84.73 | 81.22 |
| Student base | 84.86 | 47.79 | 68.02 | 77.36 | 67.74 | 59.22 | 42.43 | 21.54 | 20.30 | 42.44 | 60.33 | 54.36 |
| SimCSE-unsup | 89.21 | 69.13 | 53.55 | 82.86 | 76.59 | 71.64 | 68.19 | 61.68 | 70.36 | 65.18 | 74.61 | 71.47 |
| CDM | 89.75 | 70.58 | 53.11 | 84.83 | 75.19 | 71.06 | 69.37 | 68.48 | 73.92 | 66.03 | 76.37 | 72.92 |
| DSKD | 89.66 | 69.93 | 54.51 | 83.13 | 77.95 | 71.53 | 68.65 | 63.37 | 71.42 | 65.82 | 75.45 | 72.24 |
| Jasper & Stella | 89.71 | 73.83 | 65.98 | 85.33 | 80.99 | 70.50 | 73.96 | 67.90 | 75.65 | 70.71 | 78.62 | 75.98 |
| DistillCSE | 90.94 | 70.90 | 60.80 | 82.86 | 78.98 | 68.63 | 75.12 | 72.61 | 77.08 | 68.84 | 78.57 | 75.32 |
| EMO | 90.78 | 73.54 | 67.48 | 84.46 | 81.57 | 69.76 | 75.66 | 68.83 | 77.17 | 71.47 | 79.14 | 76.58 |
| TALAS | 91.43 | 74.30 | 70.71 | 86.47 | 82.66 | 69.24 | 78.38 | 75.40 | 80.88 | 73.61 | 81.44 | 78.83 |
Table 1 (원논문): 9개 데이터셋 실험 결과. ⋆는 in-domain, 나머지는 out-of-domain. Avg.는 전체 평균이며 TALAS를 볼드 처리.
세 조합 모두에서 TALAS가 전체 평균(Avg.) 1위를 가져간다. 22M 조합에서 74.79로 2위 EMO(72.98)를 1.81점, 66M에서 76.55로 EMO(75.46)를 1.09점, 109M에서 78.83으로 EMO(76.58)를 2.25점 앞선다. 강한 베이스라인인 EMO가 SFT(지도 학습)를 쓰는 반면 TALAS는 라벨 없는 비지도 학습이라는 점을 감안하면, 이 격차의 의미가 더 커진다.
특히 눈에 띄는 건 out-of-domain(Avg-Out) 성능이다. 109M 조합에서 TALAS의 Avg-Out은 81.44로, 교사(84.73)에 3.3점 차까지 따라붙는다. STS12를 보면 TALAS(75.40)가 EMO(68.83)를 6.6점, Tweet에서도 대부분 베이스라인을 앞선다. 학습 코퍼스가 세 in-domain 데이터셋뿐인데 out-of-domain에서 이만큼 벌린다는 건, 교사 출력을 그대로 복사하는 게 아니라 표현의 기하 구조를 배우는 와 평평한 최소점을 찾는 ASAM이 실제로 일반화에 기여하고 있다는 방증이다.
한 가지 흥미로운 예외는 WiC⋆다. 세 조합 모두에서 TALAS의 WiC 점수가 여러 베이스라인보다 오히려 낮다(22M에서 66.65 vs DSKD 68.58). WiC는 문맥에 따라 같은 단어의 의미가 바뀌는지를 판단하는 태스크라, 문장 전체 임베딩의 의미 유사도만으로는 잡기 어려운 세밀한 어휘 중의성 문제다. 문장 임베딩만 증류하는 TALAS의 설계가 이 지점에서는 상대적으로 불리하게 작용하는 것으로 보인다. 그래도 나머지 8개 데이터셋에서의 우위가 이를 상쇄하고도 남는다.
5.3 Ablation Study - 손실 조합의 기여
Table 2는 네 요소(, , , ASAM)를 켜고 끄며 각각의 기여를 분해한다.
Qwen3-Embedding 0.6B → MiniLMv2 H384 (22M)
| ASAM | Avg-In | Avg-Out | Avg-All | |||
|---|---|---|---|---|---|---|
| ✓ | 44.24 | 62.41 | 56.35 | |||
| ✓ | ✓ | 65.50 | 75.24 | 71.99 | ||
| ✓ | ✓ | ✓ | 67.03 | 75.77 | 72.85 | |
| ✓ | ✓ | 67.65 | 77.10 | 73.95 | ||
| ✓ | ✓ | ✓ | 67.27 | 77.78 | 74.28 | |
| ✓ | ✓ | ✓ | 68.04 | 76.93 | 73.97 | |
| ✓ | ✓ | ✓ | ✓ | 67.94 | 78.21 | 74.79 |
BGE-M3 → MiniLMv2 H768 (66M)
| ASAM | Avg-In | Avg-Out | Avg-All | |||
|---|---|---|---|---|---|---|
| ✓ | 40.91 | 58.45 | 52.60 | |||
| ✓ | ✓ | 70.08 | 79.21 | 76.17 | ||
| ✓ | ✓ | ✓ | 69.37 | 79.63 | 76.21 | |
| ✓ | ✓ | 69.46 | 79.12 | 75.90 | ||
| ✓ | ✓ | ✓ | 68.67 | 79.06 | 75.59 | |
| ✓ | ✓ | ✓ | 69.83 | 79.27 | 76.13 | |
| ✓ | ✓ | ✓ | ✓ | 69.53 | 80.09 | 76.57 |
Qwen3-Embedding 4B → BERT-base (109M)
| ASAM | Avg-In | Avg-Out | Avg-All | |||
|---|---|---|---|---|---|---|
| ✓ | 65.18 | 74.61 | 71.47 | |||
| ✓ | ✓ | 69.58 | 77.53 | 74.88 | ||
| ✓ | ✓ | ✓ | 71.28 | 77.99 | 75.75 | |
| ✓ | ✓ | 73.05 | 80.29 | 77.88 | ||
| ✓ | ✓ | ✓ | 72.32 | 80.97 | 78.09 | |
| ✓ | ✓ | ✓ | 73.32 | 80.44 | 78.06 | |
| ✓ | ✓ | ✓ | ✓ | 73.61 | 81.44 | 78.83 |
Table 2 (원논문): 손실 조합별 ablation. in-domain, out-of-domain, 전체 평균으로 보고. 마지막 행이 전체 TALAS.
이 표가 각 요소의 역할을 또렷이 드러낸다. 먼저 가 절대적 뼈대다. 첫 행(SimCSE만)은 사실상 증류 없는 상태로, 22M에서 56.35에 그친다. 를 켜는 순간 71.99로 15점 이상 뛴다. 논문 표현대로 가 빠진 구성은 "파국적 성능 하락"을 겪으며, 다른 목표들이 그 위에서 작동하는 기반임을 확인시킨다.
ASAM의 기여는 조합마다 다르다. BGE-M3→MiniLMv2 H768(66M)에서는 이득이 미미하지만(예: 4행 vs 6행 비교), Qwen3-4B→BERT-base와 Qwen3-0.6B→MiniLMv2 H384에서는 확실히 크다. 109M 조합에서 만 쓴 74.88이 ASAM을 더하니(6행) 78.06까지 오른다. 저자의 해석이 설득력 있다 - 학생이 극단적으로 작거나(22M) 교사가 압도적으로 강할 때(4B) 최적화 지형이 험난해지고, 바로 그때 평평한 최소점을 찾는 ASAM의 능력이 결정적이 된다. ASAM은 용량 격차가 클수록 빛을 발하는 장치인 셈이다.
보조 목표 두 개는 역할이 상보적이다. 는 in-domain(Avg-In)의 국소 클러스터링을 강화하지만 학습 분포로 편향되는 조짐이 있고, 대신 를 넣으면 out-of-domain(Avg-Out)이 일관되게 오른다. 109M 조합에서 5행(ASAM, SimCSE 없음)의 Avg-Out은 80.97로, SimCSE를 넣은 6행(80.44)보다 오히려 높다. 레이어 간 기하 관계를 보존하는 게 강건한 전이 학습에 더 효과적이라는 뜻이다. 네 요소를 모두 켠 마지막 행이 세 조합 모두에서 최고 Avg-All을 찍으며, 각 요소가 독립적으로 의미 있는 기여를 한다는 점을 마무리한다.
5.4 계산 효율 분석
Table 3은 Qwen3-4B→BERT-base 조합을 NVIDIA T4 GPU, 배치 32에서 측정한 자원 소비다.
| Method | Time (ms/step) | Mean Mem (MB) | Peak Mem (MB) | Std Mem (MB) |
|---|---|---|---|---|
| SimCSE-unsup | 151 | 2662 | 3690 | 235 |
| DistillCSE | 182 | 3373 | 3674 | 124 |
| Jasper & Stella | 204 | 2932 | 3884 | 71 |
| EMO | 1223 | 11203 | 13831 | 492 |
| DSKD | 1002 | 10991 | 12393 | 336 |
| CDM | 1078 | 10814 | 12156 | 314 |
| TALAS (w/o ASAM) | 195 | 2864 | 3982 | 261 |
| TALAS (with ASAM) | 375 | 3317 | 4499 | 277 |
Table 3 (원논문): Qwen3-Embedding-4B → BERT-base 학습 시 런타임과 GPU 메모리 비교.
수치가 극적이다. 토큰 단위 베이스라인(EMO, DSKD, CDM)은 학습 중 교사를 병렬로 추론하고 dense state를 캐싱하기 어려운 탓에 스텝당 1,000ms를 넘고 peak 메모리가 12GB를 웃돈다. 반면 TALAS(w/o ASAM)는 스텝당 195ms에 peak 3.98GB로, 토큰 단위 방법 대비 시간은 5배 이상, 메모리는 3배 이상 가볍다. DistillCSE(182ms)에 근소하게 뒤지고 Jasper(204ms)보다는 빠른 수준이면서, Jasper처럼 번거로운 2단계 파이프라인도 필요 없다.
ASAM을 켜면 forward-backward가 두 번이라 375ms로 늘고 peak 4.5GB가 되지만, 그래도 토큰 단위 방법과는 비교 자체가 안 될 만큼 자원 친화적이다. 4.6절의 캐싱 전략(76GB→300MB)이 이 효율의 근본 원천이다. 소비자용 GPU 한 장으로도 4B 교사에서 증류를 돌릴 수 있다는 게 실무적으로 가장 크게 와닿는 지점이다.
5.5 Sharpness-Aware 변형 비교
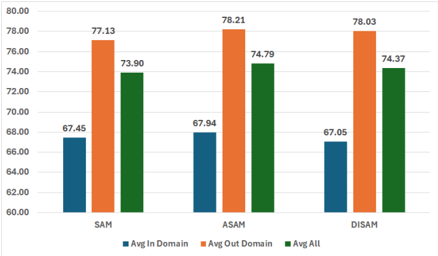
Figure 2: Qwen3-Embedding 0.6B → MiniLMv2 H384에서 SAM 변형 비교. 파랑=Avg In-Domain, 주황=Avg Out-of-Domain, 초록=Avg All. (원논문)
세 sharpness-aware 최적화(SAM, ASAM, DISAM)를 22M 조합에서 비교한 막대그래프다. ASAM이 전체 평균 74.79로 가장 높고, DISAM(74.37), SAM(73.90)이 뒤를 잇는다. ASAM은 out-of-domain 78.21과 in-domain 67.94를 동시에 최고로 찍어, 일반화와 표현 충실도 사이의 균형이 가장 좋다. DISAM은 도메인별 통계를 섭동 추정에 넣는 더 정교한 변형인데도 ASAM에 근소하게 밀리는데, 이 태스크 구성에서는 파라미터 스케일 정규화(ASAM)만으로도 도메인 간 균형을 충분히 잡는다는 뜻으로 읽힌다. 결국 TALAS는 ASAM을 기본 최적화로 채택한다.
5.6 경험적 Sharpness 분석
sharpness가 실제로 억제되는지를 직접 확인하려고, 학습 중 손실의 곡률을 헤시안 최대 고윳값 로 측정했다. 값이 클수록 뾰족한 최소점, 작을수록 평평한 최소점을 뜻하는 널리 쓰이는 프록시다.
| Epoch | ASAM | AdamW |
|---|---|---|
| 1 | 14.89 | 30.24 |
| 3 | 12.94 | 21.48 |
| 5 | 11.59 | 19.66 |
| 10 | 10.85 | 18.66 |
| 30 | 9.93 | 17.41 |
Table 4 (원논문): 학습 에폭별 헤시안 최대 고윳값 . 값이 낮을수록 평평한 최소점.
전 구간에서 ASAM의 가 AdamW보다 뚜렷하게 작고, 그 격차가 학습 내내 유지된다(에폭 1에서 14.89 vs 30.24, 에폭 30에서도 9.93 vs 17.41). 단순히 비슷한 해에 도달하되 분산만 줄인 게 아니라, ASAM이 최적화를 체계적으로 평평한 영역으로 몰아간다는 직접 증거다. sharpness-aware 방법이 파라미터 섭동에 대한 민감도를 명시적으로 벌한다는 이론적 동기와 정확히 들어맞는 결과다. Figure 1 오른쪽 위의 손실 지형 그림이 말로 그린 직관을 이 표가 숫자로 뒷받침하는 셈이다.
5.7 증류 레이어 깊이의 효과
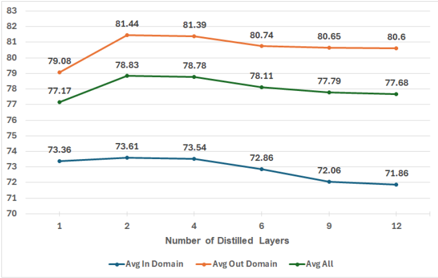
Figure 3: Qwen3-Embedding 4B → BERT에서 교사 앵커링 레이어 수()에 따른 성능. 파랑=Avg In-Domain, 주황=Avg Out-of-Domain, 초록=Avg All. (원논문)
로 교사에 앵커링하는 상위 레이어 수 를 바꿔가며 본 결과다. 성능이 선형으로 오르지 않고 에서 정점을 찍는다(Avg All 78.83, Avg-Out 81.44). 그 뒤로는 완만하게 떨어지고 에서 out-of-domain이 특히 지속적으로 하락한다. 저자의 해석은 명료하다 - 교사-학생 용량 격차가 큰 상황에서 너무 많은 내부 레이어에 제약을 걸면 과잉 정규화(over-regularization)가 일어나 학생 고유의 특징 조직을 옥죈다는 것이다. 상위 두 레이어만 앵커링하는 게 고수준 의미 전달과 학생의 표현 유연성 사이 최적점이라는 결론으로, 3.1절에서 앵커링을 "상위 레이어에만" 제한한 설계 결정을 실험으로 정당화한다.
6. 추가 실험 및 부록 (Appendix)
6.1 학습 설정 (Appendix E, Table 5)
세 교사-학생 쌍에 통일된 학습 프로토콜을 적용했다. 손실 가중치는 , , 이다.
| Settings | DSKD | CDM | EMO | Stella & Jasper | DistillCSE | TALAS |
|---|---|---|---|---|---|---|
| Epoch | 5 | 5 | 5 | 2+5 (2단계) | 5 | 5 |
| LR | 2×10⁻⁵ | 2×10⁻⁵ | 2×10⁻⁵ | 2×10⁻⁵ | 2×10⁻⁵ | 2×10⁻⁵ |
| Batch Size | 32 | 32 | 32 | 32 | 32 | 32 |
| LR Scheduler | Cosine | Cosine | Cosine | Cosine | Cosine | Cosine |
Table 5 (원논문): 증류·문장 임베딩 방법별 학습 설정.
모든 방법이 동일한 5 에폭, LR 2×10⁻⁵, 배치 32, Cosine 스케줄러로 맞춰져 공정 비교가 담보된다. 유독 Stella & Jasper만 "2+5"의 2단계 파이프라인을 요구하는데, 5.4절에서 지적한 이 방법의 번거로움이 여기에도 드러난다. 평가는 classification에 F1, pair classification에 AP, STS에 Spearman 상관을 쓴다. classification은 임베딩을 얼려 로지스틱 회귀를 얹고, pair classification은 코사인 유사도에 최적 임계값을 적용하는 표준 프로토콜(Conneau and Kiela, 2018)을 따른다.
6.2 사전학습 모델과의 비교 (Appendix F, Table 6)
TALAS가 고작 15K 문장으로 학습했다는 점을, 약 100만 규모로 학습한 기성 모델들과 나란히 놓고 본다.
| Model | Training Data | Banking77 | Tweet | MRPC | SciTail | SICK | STS12 | Avg-Out |
|---|---|---|---|---|---|---|---|---|
| Unsup-SimCSE | ~1M sentences | 90.74 | 69.85 | 84.85 | 83.04 | 72.23 | 68.40 | 78.19 |
| Sup-SimCSE | ~1M pairs (NLI) | 90.77 | 74.10 | 86.76 | 85.40 | 79.52 | 77.76 | 82.39 |
| SBERT-NLI (mean) | ~1M pairs (NLI) | 88.84 | 74.00 | 86.97 | 76.67 | 69.71 | 70.15 | 77.72 |
| SBERT-NLI+STS (mean) | ~1M pairs + 8.6k (STS-B) | 89.84 | 74.11 | 89.28 | 83.76 | 77.15 | 79.38 | 82.25 |
| SBERT-NLI (CLS) | ~1M pairs (NLI) | 89.11 | 75.90 | 87.80 | 77.63 | 72.21 | 69.41 | 78.68 |
| TALAS | ~15K sentences | 91.43 | 74.30 | 86.47 | 82.66 | 78.38 | 75.40 | 81.44 |
Table 6 (원논문): 기성 fine-tuned BERT-base 모델과의 out-of-domain 성능 비교. 최고=볼드, 차선=이탤릭.
핵심은 데이터 효율이다. 경쟁 모델 대부분이 약 100만 규모의 감독 데이터로 학습했는데, TALAS는 15K 문장(약 60~70배 적은 규모)만으로 Avg-Out 81.44를 찍어 Sup-SimCSE(82.39), SBERT-NLI+STS(82.25) 같은 지도 학습 SOTA에 근접한다. Banking77에서는 91.43으로 오히려 모두를 앞서고, SICK에서도 78.38로 최상위권이다. STS 태스크에서 강한 걸 보면, 제한된 데이터에서도 효과적인 의미 정렬을 배웠다는 뜻이다. 교사 감독을 효율적으로 활용해 대규모 주석 코퍼스 없이도 고품질 문장 표현을 얻는다는 게 이 표의 메시지다.
6.3 깊이 상세 Ablation (Table 7)
Figure 3을 데이터셋 단위로 펼친 표다.
| Num Layers | Banking77 | Tweet | Emotion⋆ | MRPC | SciTail | WiC⋆ | SICK | STS12 | STSB⋆ | Avg-In | Avg-Out | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3-0.6B → MiniLMv2 H384 | ||||||||||||
| 1 | 86.28 | 72.33 | 60.46 | 84.33 | 80.73 | 66.57 | 72.15 | 68.14 | 75.43 | 67.49 | 77.33 | 74.05 |
| 2 | 86.69 | 72.77 | 60.94 | 85.10 | 81.42 | 66.65 | 72.51 | 70.77 | 76.22 | 67.94 | 78.21 | 74.79 |
| 3 | 86.03 | 72.35 | 61.01 | 85.10 | 80.55 | 66.86 | 73.01 | 68.60 | 75.76 | 67.88 | 77.61 | 74.36 |
| 6 | 85.95 | 71.72 | 60.88 | 85.33 | 79.47 | 67.12 | 71.85 | 67.33 | 74.13 | 67.38 | 76.94 | 73.75 |
| Qwen3-4B → BERT-base | ||||||||||||
| 1 | 91.10 | 72.88 | 70.73 | 85.36 | 82.30 | 71.27 | 77.40 | 65.41 | 78.09 | 73.36 | 79.08 | 77.17 |
| 2 | 91.43 | 74.30 | 70.71 | 86.47 | 82.66 | 69.24 | 78.38 | 75.40 | 80.88 | 73.61 | 81.44 | 78.83 |
| 4 | 91.35 | 73.99 | 70.94 | 86.55 | 82.80 | 69.11 | 77.80 | 75.86 | 80.58 | 73.54 | 81.39 | 78.78 |
| 6 | 91.24 | 74.09 | 69.59 | 86.45 | 82.48 | 69.26 | 77.25 | 72.91 | 79.72 | 72.86 | 80.74 | 78.11 |
| 9 | 90.05 | 74.84 | 69.10 | 86.73 | 82.35 | 67.99 | 76.76 | 73.17 | 79.09 | 72.06 | 80.65 | 77.79 |
| 12 | 90.28 | 74.68 | 68.47 | 86.74 | 82.99 | 68.15 | 76.45 | 72.43 | 78.96 | 71.86 | 80.60 | 77.68 |
Table 7 (원논문): 의 앵커링 레이어 수에 대한 ablation.
두 조합 모두 에서 Avg.가 정점이다(74.79, 78.83). 109M 조합은 2~4 레이어(81.44, 81.39)까지 out-of-domain이 최고 수준이지만 6~12로 깊어질수록 79.72→78.96으로 계속 내려간다. in-domain은 상대적으로 안정적인데 out-of-domain이 먼저 무너진다는 게 중요한 관찰이다. 교사 감독을 학생 깊숙이 밀어 넣으면 학습 도메인에는 잘 맞춰도 일반화 능력이 먼저 희생된다는 뜻으로, 앵커링을 소수 상위 레이어로 제한해야 한다는 설계 원칙을 재확인한다.
6.4 깊이 상세 Ablation (Table 8)
자기 증류를 적용하는 레이어 수를 바꾼 결과인데, 와 정반대 경향을 보인다.
| Num Layers | Banking77 | Tweet | Emotion⋆ | MRPC | SciTail | WiC⋆ | SICK | STS12 | STSB⋆ | Avg-In | Avg-Out | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3-0.6B → MiniLMv2 H384 | ||||||||||||
| 2 | 87.93 | 72.30 | 61.49 | 83.39 | 80.27 | 68.76 | 72.39 | 64.90 | 73.35 | 67.87 | 76.86 | 73.86 |
| 3 | 87.34 | 72.57 | 60.66 | 85.23 | 81.30 | 67.43 | 71.77 | 69.61 | 75.66 | 67.92 | 77.97 | 74.62 |
| 6 | 86.69 | 72.77 | 60.94 | 85.10 | 81.42 | 66.65 | 72.51 | 70.77 | 76.22 | 67.94 | 78.21 | 74.79 |
| Qwen3-4B → BERT-base | ||||||||||||
| 2 | 91.36 | 73.56 | 68.21 | 84.97 | 81.29 | 70.06 | 77.33 | 70.60 | 78.28 | 72.18 | 79.85 | 77.30 |
| 4 | 91.59 | 74.50 | 70.96 | 86.30 | 81.42 | 69.63 | 77.76 | 74.04 | 79.40 | 73.33 | 80.94 | 78.40 |
| 6 | 91.66 | 74.56 | 70.92 | 86.26 | 82.41 | 70.01 | 78.08 | 74.81 | 80.35 | 73.76 | 81.30 | 78.78 |
| 9 | 90.63 | 74.69 | 69.41 | 86.52 | 82.40 | 68.48 | 78.27 | 74.89 | 80.79 | 72.89 | 81.23 | 78.45 |
| 12 | 91.43 | 74.30 | 70.71 | 86.47 | 82.66 | 69.24 | 78.38 | 75.40 | 80.88 | 73.61 | 81.44 | 78.83 |
Table 8 (원논문): 의 자기 증류 레이어 수에 대한 ablation.
여기서는 레이어를 깊게 쓸수록 성능이 오른다. 22M 조합은 6 레이어에서 최고 Avg-Out(78.21), 109M 조합은 2→12로 갈수록 단조 증가해 12 레이어에서 최고(Avg-Out 81.44, Avg. 78.83)를 찍는다. 가 소수 레이어에서 정점을 찍고 꺾이는 것과 대조적이다.
두 표를 나란히 놓으면 TALAS 설계의 논리가 선명해진다. 교사 앵커링()은 얕게, 자기 증류()는 깊게. 교사의 추상적 임베딩을 억지로 깊이 밀어 넣으면 학생이 옥죄이지만, 학생 자신의 위층으로 아래층을 끌어주는 관계 정렬은 네트워크 전체에 깊이 깔아도 표현 강건성을 계속 높인다. 큰 학생일수록 깊은 자기 증류의 이득이 더 크다는 점도 확인된다.
6.5 SAM 변형 데이터셋 상세 (Table 9)
Figure 2를 두 조합·전 데이터셋으로 펼친 표다.
| Method | Banking77 | Tweet | Emotion⋆ | MRPC | SciTail | WiC⋆ | SICK | STS12 | STSB⋆ | Avg-In | Avg-Out | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3-0.6B → MiniLMv2 H384 | ||||||||||||
| SAM | 87.57 | 72.77 | 60.64 | 83.54 | 80.49 | 68.04 | 72.30 | 66.08 | 73.67 | 67.45 | 77.13 | 73.90 |
| ASAM | 86.69 | 72.77 | 60.94 | 85.10 | 81.42 | 66.65 | 72.51 | 70.77 | 76.22 | 67.94 | 78.21 | 74.79 |
| DISAM | 86.84 | 73.11 | 60.52 | 84.99 | 81.11 | 65.20 | 72.30 | 69.80 | 75.43 | 67.05 | 78.03 | 74.37 |
| Qwen3-4B → BERT-base | ||||||||||||
| SAM | 91.16 | 73.97 | 68.39 | 85.10 | 80.84 | 70.38 | 77.48 | 78.77 | 75.65 | 71.47 | 81.22 | 77.97 |
| ASAM | 91.43 | 74.30 | 70.71 | 86.47 | 82.66 | 69.24 | 78.38 | 75.40 | 80.88 | 73.61 | 81.44 | 78.83 |
| DISAM | 91.27 | 74.60 | 71.14 | 86.51 | 81.92 | 68.53 | 78.57 | 76.00 | 80.53 | 73.40 | 81.48 | 78.79 |
Table 9 (원논문): SAM 변형(SAM, DISAM, ASAM) 데이터셋별 비교.
ASAM이 두 조합 모두 최고 Avg.(74.79, 78.83)를 유지한다. DISAM이 Tweet 감성 분석 같은 특정 태스크에서는 근소하게 앞서기도 하고, 109M 조합의 Avg-Out에서는 DISAM(81.48)이 ASAM(81.44)을 0.04점 앞서는 접전이지만, 전체 스펙트럼에서의 강건성과 안정성은 ASAM이 우위다. 특정 태스크의 미세한 우열보다 평균적 안정성을 택해 ASAM을 기본 최적화로 삼은 판단이 이 표에 근거를 둔다.
6.6 확장된 관련 연구와 SAM 계열 배경 (Appendix A, B)
Appendix A는 출력·관계·교사 보조자 증류를 2절보다 상세히 정리하며, 임베딩 특화 증류에서 TALAS가 "캐싱된 문장 임베딩만으로 교사 추론 없이 학습한다"는 위치를 재확인한다. Appendix B는 SAM 계열을 정리한다. 표준 SAM(Foret et al., 2020)은 반경 의 유클리드 이웃에서 최악 손실을 최소화하고(), 1차 테일러 근사로 최적 섭동을 로 구한다. DISAM(Zhang et al., 2024b)은 SAM의 i.i.d. 가정이 다중 도메인에서 깨진다는 문제의식에서, 도메인 손실 간 분산을 최소화하는 제약을 섭동 추정에 더한다. 잘 수렴한 도메인에는 섭동을 키우고 덜 수렴한 도메인에는 억눌러 도메인 간 수렴 속도를 동기화하는 것이다. TALAS는 이 계열 중 파라미터 스케일을 반영하는 ASAM을 임베딩 증류 파이프라인에 직접 통합해, 강한 감독과 큰 용량 격차 상황에서 강건성과 out-of-domain 일반화를 함께 끌어올린다.
6.7 베이스라인 구현 세부 (Appendix E)
생성형 증류 방법을 판별적 문장 임베딩 설정에 맞게 어떻게 이식했는지도 밝힌다. CDM은 원래 교사의 예측 엔트로피로 DTW 정렬 비용을 조절하는데, 문장 인코더는 토큰 단위 어휘 분포를 내지 않으므로 비용 함수를 토큰 편집 거리(Levenshtein)로 바꿔 DTW로 최적 정렬 경로를 찾고 교사 hidden state를 학생 길이에 맞춰 평균 집계한 뒤 MSE를 건다. DSKD는 양방향·대칭 과정으로 확장해 문장 수준(CLS를 학습 가능한 투영으로 정렬)과 토큰 수준(Cross-Layer Attention으로 어휘·길이 불일치를 우회) 두 granularity에서 정렬한다. 베이스라인을 그냥 가져다 쓴 게 아니라 임베딩 설정에 맞게 성실히 적응시켰다는 점에서, 비교의 공정성을 높이려는 노력이 읽힌다.
7. 강점과 한계
강점
- 효율과 성능의 동시 달성: Table 3에서 보듯 TALAS는 토큰 단위 방법 대비 학습 시간 5배, 메모리 3배 이상 이득을 보면서도 Table 1에서 전 조합 평균 1위를 가져간다. 교사를 학습 루프에서 빼는 캐싱 전략(76GB→300MB)이 이 효율의 뿌리다.
- 일반화에 강함: 라벨 없는 15K 문장, 그것도 세 in-domain 데이터셋만으로 학습하고도 out-of-domain에서 격차를 벌린다. Table 6에서 100만 규모 감독 데이터로 학습한 Sup-SimCSE(82.39)에 15K 문장으로 81.44까지 따라붙는 데이터 효율은 특히 인상적이다.
- 설계와 실험의 정합성: "는 얕게, 는 깊게"라는 원칙이 Table 7·8의 상반된 깊이 경향으로 깔끔하게 검증된다. ASAM이 sharpness를 실제로 억제한다는 것도 Table 4의 측정으로 직접 확인했다. 주장마다 대응하는 증거가 있다.
- 재현성 있는 통제 비교: Table 5처럼 모든 방법을 동일 에폭·LR·배치로 맞추고, 생성형 베이스라인도 임베딩 설정에 성실히 이식했다(Appendix E).
한계 및 아쉬운 점
- 저자가 밝힌 제약: 계산 예산 탓에 대형 모델이나 대규모 코퍼스로의 확장성은 검증하지 못했고, 평가가 영어 중심이라 다국어·저자원 언어에서의 적응성은 미지수다. 또 ASAM이 스텝당 forward-backward를 두 번 요구해 학습 시간이 사실상 두 배가 된다(Table 3에서 195ms→375ms). 수렴 안정성과 학습 속도의 트레이드오프인데, 빠른 반복이 필요한 상황에서는 부담이 될 수 있다.
- WiC의 일관된 약세: Table 1의 세 조합 모두에서 TALAS의 WiC 점수가 여러 베이스라인에 뒤진다. 문장 임베딩만 증류하는 설계가 어휘 수준 중의성 판단에는 불리하다는 구조적 한계로 보이는데, 논문이 이 지점을 명시적으로 분석하지는 않는다.
- 평가 태스크의 폭: classification/pair classification/STS 9개에 그치고, 정작 임베딩 모델의 주 무대인 대규모 검색(retrieval) 벤치마크(MTEB 등)가 빠져 있다. 저자도 결론에서 MTEB 확장을 향후 과제로 남겼는데, RAG 실무 관점에서는 검색 성능이 가장 궁금한 지표라 이 공백이 아쉽다.
- Table 1과 Table 2의 미세한 불일치: ablation(Table 2)의 "만" 행 값이 Table 1의 Student base 값과 두 조합에서 서로 뒤바뀐 것처럼 보이는 지점이 있다. 최종 TALAS 행은 두 표가 일치하므로 결론에는 영향이 없지만, 편집 단계의 사소한 표기 혼선으로 읽힌다.
- 민감도 부재: 처럼 극단적으로 작은 대조 가중치를 썼는데, 이 값들에 대한 민감도 분석이 없어 하이퍼파라미터의 강건성을 판단하기 어렵다.
8. 마치며
TALAS의 기여를 한 문장으로 압축하면, "교사를 어느 깊이에 어떤 형태로 걸 것인가"를 재설계해 임베딩 증류의 효율-성능 트레이드오프를 넘어선 것이다. 상위 레이어에만 교사를 앵커링하고(), 나머지는 학생 자신의 위층으로 관계 구조를 위→아래로 전파하며(), ASAM으로 평평한 최소점을 찾는다는 세 결정이 용량 격차라는 고질적 병목을 정면으로 겨냥한다. 여기에 교사 임베딩을 미리 캐싱해 학습 루프에서 교사 추론을 완전히 제거한 실무적 선택이 더해져, 소비자용 GPU 한 장으로 4B 교사를 증류하는 그림이 현실이 됐다.
특히 라벨 없이 15K 문장만으로 100만 규모 지도 학습 모델에 근접하는 데이터 효율은, 주석 비용이 부담스러운 도메인이나 저자원 환경에서 매력적인 대안이 된다. 교사 출력을 복사하는 대신 표현의 기하 구조를 배우게 하고, sharpness를 억눌러 일반화를 확보한다는 두 축은 임베딩 증류를 넘어 다른 표현 학습 증류에도 옮겨볼 만한 아이디어다.
남은 숙제도 분명하다. 검색 벤치마크에서의 검증, 다국어로의 확장, ASAM의 두 배 학습 시간 완화, WiC 같은 어휘 수준 태스크의 약점 보완이 그것이다. 저자가 예고한 MTEB 확장이 이뤄지면 TALAS의 실용적 가치가 훨씬 또렷해질 것이다. 그래도 "무엇을 흉내 낼까"가 아니라 "어디에, 어떻게, 어떤 최적화로"를 분리해 사고한 이 논문의 관점은, 앞으로의 임베딩 증류 연구에 하나의 유용한 좌표를 남긴다.
References
- Kwon et al., 2021. "ASAM: Adaptive Sharpness-Aware Minimization for Scale-Invariant Learning of Deep Neural Networks."
- Foret et al., 2020. "Sharpness-Aware Minimization for Efficiently Improving Generalization." (SAM)
- Zhang et al., 2024b. "Domain-Inspired Sharpness-Aware Minimization." (DISAM)
- Park et al., 2019. "Relational Knowledge Distillation." (RKD)
- Hinton et al., 2015. "Distilling the Knowledge in a Neural Network."
- Gao et al., 2022. "SimCSE: Simple Contrastive Learning of Sentence Embeddings."
- Xu et al., 2023. "DistillCSE: Distilled Contrastive Learning for Sentence Embeddings."
- Zhang et al., 2025a. "Jasper and Stella: Distillation of SOTA Embedding Models."
- Truong et al., 2025. "EMO: Embedding Distillation via Optimal Transport."
- Cho and Hariharan, 2019. "On the Efficacy of Knowledge Distillation."
- Mirzadeh et al., 2019. "Improved Knowledge Distillation via Teacher Assistant."
- Stanton et al., 2021. "Does Knowledge Distillation Really Work?"
- Wang and Isola, 2020. "Understanding Contrastive Representation Learning through Alignment and Uniformity on the Hypersphere."
- Chen et al., 2024. "BGE-M3: Multi-Linguality, Multi-Functionality, Multi-Granularity Text Embeddings."
- Zhang et al., 2025b. "Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models."
- Li et al., 2025. "ESE: Espresso Sentence Embeddings."