논문 리뷰
논문 리뷰: ViLL-E: Video LLM Embeddings for Retrieval
하나의 VideoLLM이 텍스트 생성(캡셔닝·QA)과 임베딩 기반 검색(비디오 검색·모먼트 검색)을 동시에 해내도록, 생성-대조 결합 학습과 "복잡한 비디오엔 더 오래 생각하는" 적응형 임베딩 헤드를 붙인 통합 모델.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | ViLL-E: Video LLM Embeddings for Retrieval |
| 저자 | Rohit Gupta, Jayakrishnan Unnikrishnan, Fan Fei, Sheng Liu, Son Tran (Amazon), Mubarak Shah (UCF) |
| 학회/저널 | arXiv preprint, 2026년 4월 |
| 논문 링크 | arXiv:2604.12148 |
1. 들어가며
비디오를 다루는 모델 생태계는 오랫동안 두 갈래로 갈라져 있었다. 한쪽에는 비디오를 보고 텍스트를 내놓는 VideoLLM이 있다. Video-ChatGPT, VideoChat, Qwen2.5-VL 같은 모델들은 비디오 질의응답(Video QA)이나 캡셔닝처럼 "출력이 텍스트인" 태스크에서 강력하다. 다른 한쪽에는 비디오와 텍스트를 같은 벡터 공간에 정렬시키는 임베딩 기반 전문가 모델이 있다. CLIP 계열을 비디오로 확장한 VidLA, SigLIP, 그리고 모먼트 검색(moment retrieval)에 특화된 QD-DETR 같은 검출기들이 여기 속한다. 이들은 텍스트-비디오 검색(Text-to-Video Retrieval)이나 시간적 위치추정(temporal localization)에서 성능을 주도한다.
문제는 이 두 세계가 서로 넘어오지 못한다는 데 있다. VideoLLM은 임베딩을 만들지 못하니 검색을 못 하고, 검색 전문가는 텍스트를 생성하지 못하니 QA를 못 한다. 심지어 시간적 추론을 흉내 내도록 특화된 VideoLLM(예: LLaVA-ST)조차 ActivityNet이나 Charades-STA 같은 위치추정 벤치마크에서 QD-DETR 같은 전문 검출기에 두 자릿수 격차로 뒤처진다. 실무에서는 결국 서로 다른 두 개의 스택을 따로 유지하고, 데이터셋마다 개별적으로 파인튜닝해야 한다.
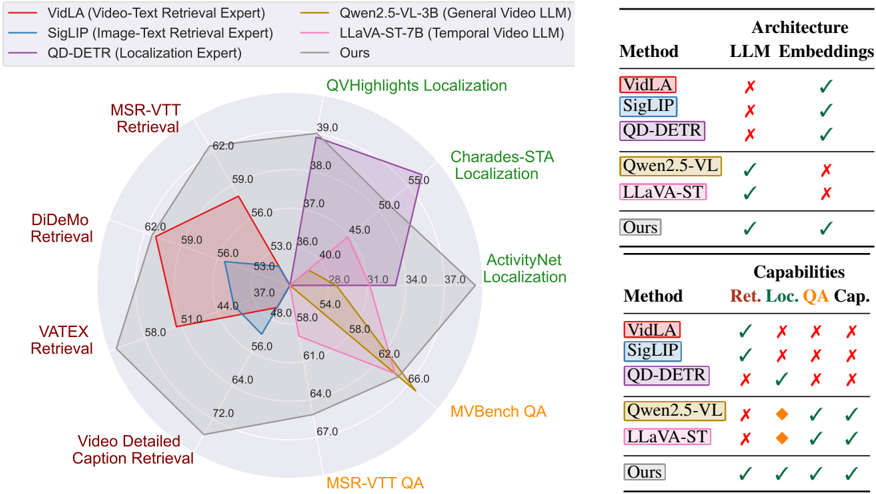
Figure 1: 왼쪽·오른쪽 아래는 레이더 차트로, VideoLLM(주황·분홍)이 시간적 위치추정(초록 축)에서 전문가 모델(회색이 ViLL-E)에 뒤지고, 텍스트-비디오 검색(빨강 축)은 아예 수행하지 못함을 보여준다. 오른쪽 위 표는 각 모델의 아키텍처(LLM 여부, 임베딩 생성 여부)와 4대 능력(Ret. 검색, Loc. 위치추정, QA, Cap. 캡셔닝)을 정리한 것이다. (원논문)
Figure 1이 이 구도를 압축해서 보여준다. 오른쪽 위 표를 보면 VidLA·SigLIP·QD-DETR은 임베딩은 만들지만 LLM이 아니고, Qwen2.5-VL·LLaVA-ST는 LLM이지만 임베딩을 못 만든다. 능력 표에서 기존 모델은 하나같이 한두 칸만 채워져 있는데, ViLL-E(Ours)만 검색·위치추정·QA·캡셔닝 네 칸을 모두 ✓로 채운다. 레이더 차트에서 회색(ViLL-E) 다각형이 초록 축(QVHighlights, Charades-STA, ActivityNet 위치추정)과 빨강 축(MSR-VTT, DiDeMo, VATEX 검색)을 두루 넓게 덮는 반면, 특정 색 모델은 자기 전문 축에서만 튀어나온다. 저자들이 하고 싶은 말은 명확하다. 임베딩을 만들 수 있느냐 없느냐가 이 격차의 핵심이라는 것이다.
여기서 저자들은 NLP 쪽의 흐름 하나를 끌어온다. GRIT나 E5처럼, 생성형 LLM을 놀랄 만큼 적은 데이터로 대조 파인튜닝(contrastive finetuning)하면 강력한 검색 임베딩을 뽑아낼 수 있다는 결과다. 그렇다면 비디오에서도 같은 질문을 던질 수 있다. 두 개의 스택을 유지하는 대신, 하나의 모델이 생성 태스크도 풀고 판별력 있는 비디오/텍스트 임베딩도 뽑아낼 수는 없을까? ViLL-E(VideoLLM-Embed, 발음은 "윌리")는 이 질문에 대한 답이다. PaliGemma라는 표준 멀티모달 LLM 위에 학습 가능한 어텐션 풀링 임베딩 헤드를 얹고, 이 헤드가 추론 시 비디오 복잡도에 맞춰 "어려운 비디오는 더 오래 생각하고 쉬운 비디오는 빨리 끝내도록" 설계했다.
2. 기존 연구의 한계
2.1 검색·위치추정을 위한 비디오 전문가 모델
텍스트-비디오 검색의 표준 레시피는 CLIP이나 BLIP 같은 듀얼 인코더(dual-encoder) 이미지-텍스트 모델을 비디오로 확장하는 것이다. 여러 프레임에서 CLIP 비전 인코더 출력을 뽑아 시간 관계를 모델링하도록 구조를 손보고, 임베딩 공간에서 밀집 벡터 검색(dense vector search)을 수행한다. 일부는 크로스-모달 융합 레이어를 추가한 리랭킹 단계를 붙이기도 한다.
시간적 위치추정 쪽은 Moment-DETR, QD-DETR, TR-DETR, UnLoc처럼 검색 아이디어에서 출발한 검출기들이 주도한다. 텍스트와 비디오 세그먼트의 적합도를 점수화하는 Video-Text Fusion을 쓰거나, QD-DETR의 시간 구간 예측 모듈, Moment-DETR의 학습 가능한 모먼트 쿼리 같은 고유 장치를 더한다. Vid2Seq처럼 검색 대신 dense captioning으로 위치추정을 하는 접근도 있다. 이들의 공통점은 각자의 태스크에서는 최전선에 가깝지만, 한 태스크에 특화되어 있고 데이터셋마다 개별 파인튜닝을 요구한다는 것이다.
2.2 Video LLMs
LLaVA를 비디오로 확장한 Video-LLaVA는 이미지·비디오를 함께 학습한 LanguageBind 인코더를 CLIP 대신 쓴다. BLIP2 스타일로 Q-Former를 붙인 VideoChat, Video-LLaMA도 있다. VideoChatGPT는 ActivityNet dense caption과 GPT-3.5를 이용한 반자동 IFT 데이터를, VideoChat2는 30개 이상 데이터셋을 통합한 IFT 데이터를 만들었다. 이들은 비디오 QA와 텍스트 생성에는 강하지만 시간적 위치추정에 약하고, 무엇보다 임베딩을 생성하지 못해 검색을 할 수 없다.
2.3 위치추정 IFT를 갖춘 Video LLMs
최근에는 VideoLLM에 시간 인식과 위치추정 능력을 심으려는 연구가 이어졌다. 이들은 대체로 Q-Former로 토큰을 줄이느냐(BLIP2 계열)에 따라 갈린다. TimeChat은 슬라이딩 윈도우 Q-Former를, VTimeLLM은 MLP를, HawkEye는 단순 Q-Former를, Momentor는 병렬 시간 인식 모듈을 프로젝션 레이어에 넣는다. LLaVA-ST는 시공간 특수 토큰을 언어 스트림에 삽입하고 언어 정렬 위치 임베딩으로 비전 특징과 정렬시킨다. 이들은 dense captioning, 타임스탬프 생성 같은 특화 태스크로 학습해 일반 VideoLLM보다는 위치추정을 잘하지만, LLM을 쓰지 않는 전문가 모델을 끝내 넘지 못한다.
2.4 임베딩 생성을 위한 LLMs
NLP 쪽에서는 생성형 LLM을 상대적으로 적은 데이터로 파인튜닝해 다양한 다운스트림에 쓸 강한 임베딩을 뽑을 수 있음이 확인되었다. GRIT는 사전학습된 LLM을 생성형 인스트럭션 수행과 임베딩 생성에 동시에 파인튜닝해 두 태스크 모두에서 강한 성능을 유지했다. VLM2Vec, GME, MM-Embed 같은 최근 연구들이 LLM을 멀티모달 임베딩에 쓰려 했지만 이미지에 국한되어 있었다. ViLL-E는 이 흐름을 비디오로 끌고 와, 생성 능력과 임베딩 생성 능력을 하나의 VideoLLM에 통합한다.
3. 핵심 아이디어
ViLL-E의 발상은 두 축으로 요약된다.
첫째, 생성과 임베딩을 하나의 백본에서 동시에 학습한다. LLM 트랜스포머 레이어는 두 태스크가 공유하고, 그 위에 캡션·답변을 뱉는 LM 헤드와 임베딩을 뽑는 임베딩 헤드가 나란히 달린다. 학습할 때 다음 단어 예측 손실(생성)과 CLIP식 대조 손실(임베딩)을 함께 걸어, 한 번의 학습으로 표현력 있는 문장도 만들고 판별력 있는 임베딩도 얻는다.
둘째, 그리고 더 독창적인 부분인데, 비디오 임베딩을 EOS 토큰이 나올 때까지 자기회귀적으로 생성한다. 기존 LLM 기반 임베딩은 GRIT처럼 고정된 개수의 토큰을 뽑아 풀링한다. ViLL-E는 그렇게 하지 않는다. 모델이 비디오를 보고 토큰을 하나씩 생성하다가 EOS를 내면, 그때까지 생성된 토큰 전체를 임베딩 헤드로 넘긴다. 쉬운 비디오는 몇 토큰 만에 EOS를 내고 끝나고, 복잡한 비디오는 더 많은 토큰을 뱉는다. 말하자면 임베딩 생성에 **적응형 계산(adaptive computation)**을 도입한 것이다. "어려운 문제엔 더 오래 생각한다"는 최근 추론 모델의 직관을 임베딩 생성에 옮겨 온 셈이다.
기존 방법이 "좋은 임베딩 모델과 좋은 생성 모델을 각각 따로 만들자"였다면, ViLL-E는 "하나의 모델이 둘 다 하되, 임베딩의 계산량마저 입력에 맞춰 유연하게 조절하자"로 판을 다시 짠다. 이 두 아이디어가 어떻게 구체화되는지 방법론에서 하나씩 뜯어본다.
4. 제안 방법 (Method)
4.1 전체 구조
ViLL-E는 PaliGemma-3B를 초기 가중치로 삼는다. PaliGemma는 Gemma-2B 언어모델과 SigLIP-SO-400M ViT 비전 인코더로 구성된 멀티모달 LLM으로, Apache 2.0 라이선스로 공개돼 있다. 생성 태스크와 임베딩 태스크가 하나의 LLM 백본을 공유하고, 비디오 입력을 처리하는 비전 인코더 모듈이 앞에 붙는다. PaliGemma의 방식을 그대로 따라, 시각 토큰과 입력 프롬프트는 양방향 어텐션(bidirectional attention)으로 처리하고, 자기회귀적으로 생성되는 접미부(suffix)에는 인과 어텐션(causal attention)을 적용한다. 비디오 QA 같은 텍스트 생성 태스크에서는 PaliGemma와 동일하게 동작한다.
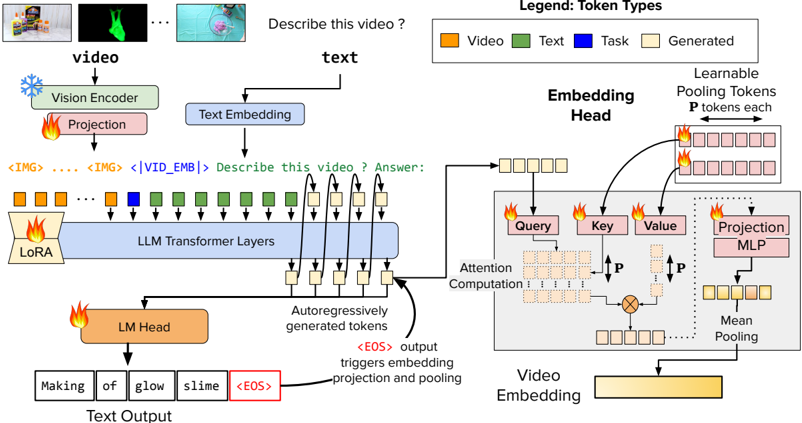
Figure 2: ViLL-E의 아키텍처. 비디오 프레임을 비전 인코더로 인코딩하고 프로젝션으로 임베딩 벡터화한 뒤, 텍스트 프롬프트 임베딩과 결합해 사전학습된 멀티모달 LLM으로 자기회귀 처리한다. EOS 토큰이 생성되면 그때까지 생성된 토큰 전체를 임베딩 헤드로 넘긴다. 임베딩 헤드는 어텐션 기반 학습 풀링으로 토큰을 집약하고, MLP 프로젝션 후 평균 풀링해 비디오 임베딩을 낸다. (원논문)
Figure 2를 왼쪽에서 오른쪽으로 따라가 보자. 비디오 프레임이 비전 인코더(눈송이 아이콘 = 동결)를 거쳐 프로젝션(불꽃 아이콘 = 학습)으로 임베딩 벡터가 되고, <IMG> ... <IMG> <|VID_EMB|> Describe this video ? Answer: 형태로 텍스트 프롬프트와 하나의 시퀀스로 묶인다. LLM 트랜스포머 레이어(LoRA로 경량 파인튜닝)가 이걸 자기회귀 처리해 "Making of glow slime <EOS>" 같은 텍스트를 LM 헤드로 뱉는다. 여기까지는 평범한 VideoLLM이다. 핵심은 그 다음이다. <EOS> 출력이 임베딩 프로젝션과 풀링을 트리거한다. 그때까지 자기회귀적으로 생성된 토큰들이 모두 오른쪽의 임베딩 헤드로 흘러 들어가, 어텐션 풀링과 MLP 프로젝션, 평균 풀링을 거쳐 하나의 비디오 임베딩으로 압축된다.
4.2 임베딩 헤드 설계: KV-Former
임베딩 헤드를 어떻게 만들 것인가는 이 논문에서 가장 공들인 설계 결정이다. 저자들이 내건 네 가지 목표는 (1) 생성 태스크와 분리된 전용 모델링 용량, (2) 표현력을 지나치게 죽이지 않으면서 밀집 임베딩을 만드는 병목(bottleneck), (3) 비디오 복잡도에 따라 가변 토큰 길이에 대응하는 적응성, (4) 파라미터 효율성이다. 이 기준으로 다섯 가지 후보를 저울질한다.
- Attention-Free 풀링: LLM 끝에서 두 번째 레이어 토큰을 고정 크기로 풀링. 가볍지만 휴리스틱 풀링에 의존한다(Sentence-BERT식).
- Self-Attention: 트랜스포머 레이어를 하나 더 추가. 태스크 특화 용량은 생기지만 앞선 LLM 레이어와 중복되고 병목이 없다.
- Q-Former: 학습된 쿼리가 LLM 출력에 크로스-어텐션해 고정 길이 임베딩을 만든다(BLIP-2). 효과적이지만 출력 크기가 항상 학습 쿼리 개수와 같아 가변 길이 콘텐츠에 유연하지 못하다.
- K-Former: 키(key)만 학습해 가변 길이 출력을 가능하게 한다.
- KV-Former (제안): LLM 토큰을 쿼리로 쓰고, 개의 학습 가능한 키·값 "풀링 토큰"을 둔다. 가변 길이 출력이 가능하면서 동시에 사전 학습(dictionary learning)에 가까운 병목 역할을 한다.
정리하면 KV-Former는 Q-Former와 K-Former의 장점을 합친 형태다. 트랜스포머 기반 셀프 어텐션 레이어가 LLM 토큰을 쿼리로, 개의 학습 키·값을 두어 토큰을 적응적으로 가중한다. 어텐션 후 가중 표현을 MLP로 임베딩 공간에 사영하고 평균 풀링한다. LLM 토큰의 개수가 가변이어도 대응할 수 있다는 점이 핵심인데, 바로 이것이 다음의 적응형 임베딩 메커니즘을 가능하게 하는 전제다.
4.3 EOS 트리거 적응형 임베딩 생성
비디오 임베딩 생성에서 ViLL-E는 EOS로 촉발되는 메커니즘을 쓴다. 모델이 토큰을 자기회귀적으로 생성하다가 EOS를 내는 시점까지 걸린 스텝 수가 곧 그 비디오에 투입된 추론량이 된다. 복잡한 비디오는 더 깊은 분석이 필요하니 더 많은 스텝을, 단순한 비디오는 더 적은 스텝을 쓴다. 이 적응형 계산이 고정 스텝 LLM 기반 임베딩 방법 대비 성능을 크게 끌어올린다는 것이 저자들의 주장이며, 뒤의 Table 9와 Table 11이 이를 뒷받침한다.
반면 텍스트 임베딩은 단일 스텝으로 생성한다. GRIT 같은 선행 연구처럼 텍스트 전체를 한 번에 임베딩하는 표준 추론을 쓴다. 텍스트는 이미 이산적이고 짧아 굳이 가변 계산이 필요 없기 때문이다. 이 비대칭(비디오는 가변, 텍스트는 고정)이 설계의 실용적 균형점이다.
4.4 네 가지 학습 태스크
ViLL-E는 학습 전 과정에 걸쳐 네 가지 태스크를 사용한다. Figure 3이 각 태스크의 데이터 흐름과 손실을 한눈에 보여준다.
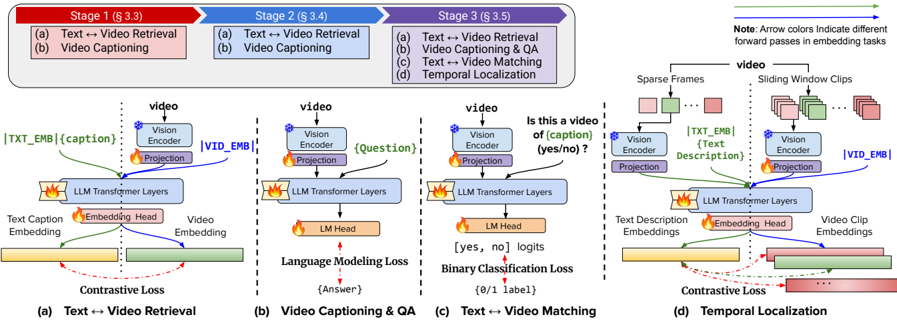
Figure 3: 세 단계 학습과 네 태스크. (a) Text↔Video Retrieval은 대조 손실, (b) Video Captioning & QA는 언어모델링 손실, (c) Text↔Video Matching은 이진 분류 손실, (d) Temporal Localization은 슬라이딩 윈도우 클립에 대한 대조 손실을 쓴다. Stage 1·2는 (a),(b)만, Stage 3는 네 태스크를 모두 쓴다. (원논문)
(a) Text-Video Retrieval. 비디오와 텍스트 임베딩을 CLIP식 대조 손실로 정렬해, 짝지어진 예제가 배치 내 다른 예제(in-batch negative)를 앞서도록 한다.
(b) Video Captioning & QA. 캡셔닝은 이전 토큰과 비디오가 주어졌을 때 캡션의 각 토큰을 예측하도록 학습한다. QA는 질문을 프롬프트의 일부로 넣어 모델의 어텐션을 정답 방향으로 유도한다. 둘 다 다음 토큰 예측 손실을 쓴다.
(c) Text-Video Matching. 검색을 보완하는 태스크로, 주어진 비디오-캡션이 실제로 짝인지를 이진 판단한다. 라벨로 지도한다. 이 태스크가 뒤에 나올 2단계 리랭킹의 근거가 된다.
(d) Temporal Localization. 특정 비디오 세그먼트를 텍스트 주석에 맞추되, 비슷하지만 틀린 세그먼트와 구분하게 한다. 슬라이딩 윈도우 하드 네거티브 마이닝으로 시간적 겹침이 적은(IoU < 0.2) 도전적인 비매칭 세그먼트를 공급한다. 포지티브 하나에 하드 네거티브 둘을 쓰는 표준 대조 구성이다.
각 태스크의 손실 수식은 부록 B에 정리돼 있는데, 표기부터 짚어두면 이렇다. 비디오 전체는 대문자 , 거기서 잘라낸 시간 세그먼트는 소문자 로 쓴다. 위치추정용 하드 네거티브 세그먼트는 (번 샘플의 번째 네거티브)이다. 캡션·질문·답변 등 자연어 시퀀스는 로 표기한다. 모델 은 원입력과 모드 토큰 (예: |VID_EMB|)을 받아 임베딩 , , 를 낸다. 모든 대조 목적함수는 코사인 유사도 을 온도 로 스케일해 쓴다.
검색 손실은 표준 InfoNCE다.
여기서 는 번 비디오 임베딩, 는 그 짝 텍스트 임베딩이며, 분모의 가 배치 내 네거티브 텍스트다. 코사인 유사도가 정렬된 쌍에서 높아지도록 민다.
캡셔닝과 QA 손실은 다음 토큰 예측이다.
는 캡션의 번째 토큰, 은 캡션 길이다. QA는 질문 를 조건에 추가한다.
매칭 손실은 이진 교차엔트로피다.
이 매칭 라벨이고, 는 "Yes(매칭)" 토큰의 확률이다. 즉 비디오-캡션 쌍을 넣고 "Yes/No" 다음 토큰 확률로 매칭 여부를 판단하는 구조다.
위치추정 손실은 세그먼트 단위 대조다.
여기서 는 포지티브 세그먼트 유사도, 는 번째 하드 네거티브 세그먼트 유사도이며 는 IoU < 0.2인 네거티브 집합이다. 정답 시간 구간과는 가깝게, 겹치지 않는 구간과는 멀게 임베딩을 학습시킨다.
4.5 세 단계 학습 전략
학습은 세 단계로 진행된다. 파라미터 효율을 위해 파인튜닝에는 LoRA를 쓰되, 비전 프로젝션 모듈과 임베딩 헤드는 완전히 학습해 표현 학습을 극대화한다.
Stage 1: 생성-대조 사전학습. 대규모 비디오-캡션 데이터로 생성과 대조를 동시에 학습한다. 한 스텝에 두 번의 순전파가 필요하다.
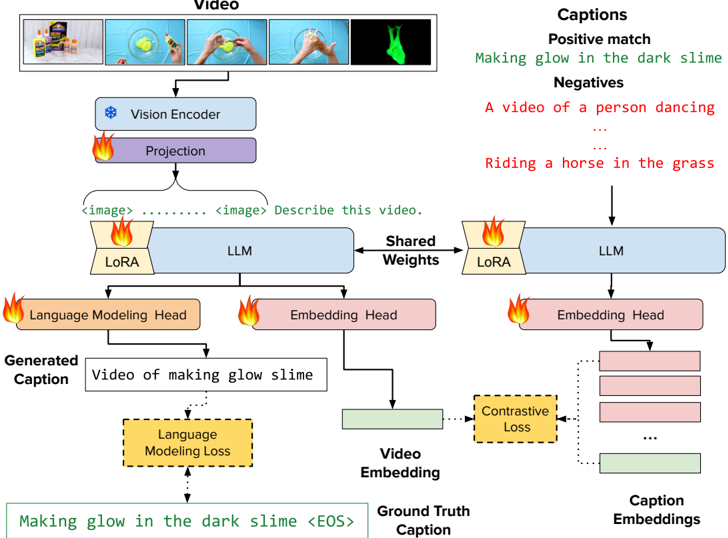
Figure 9: Stage 1 학습. 첫 순전파에서 비디오와 프롬프트를 넣어 캡션과 비디오 임베딩을 동시에 생성하고, 둘째 순전파에서 캡션만 넣어 캡션 임베딩을 만든다. 해당 비디오의 정답 캡션이 포지티브, 배치 내 다른 비디오의 캡션이 네거티브가 되어 대조 손실이 걸린다. (원논문)
Figure 9를 보면 왼쪽 순전파에서 비디오 프레임이 동결된 비전 인코더와 프로젝션(불꽃)을 거쳐 <image> ... <image> Describe this video. 프롬프트와 함께 LLM으로 들어간다. 여기서 LM 헤드는 "Making glow in the dark slime <EOS>" 같은 캡션을 자기회귀 생성하고(언어모델링 손실), 임베딩 헤드는 비디오 임베딩을 낸다. 오른쪽 순전파에서는 캡션 문자열만 같은 LLM+LoRA 스택을 통과시켜(가중치 공유) 캡션 임베딩을 얻는다. 정답 캡션이 비디오 임베딩의 포지티브 파트너가 되고 배치 내 나머지 캡션이 네거티브가 되어 InfoNCE 대조가 걸린다. 두 손실을 더하므로, 모델은 유창한 비디오 설명을 생성하는 동시에 의미가 맞는/안 맞는 비디오-텍스트 쌍을 구분하는 표현을 함께 배운다.
Stage 2: 지속 사전학습. Stage 1 데이터는 다양하지만 캡션이 짧은 요약에 그쳐 비디오의 세부를 놓치는 경우가 많다. 비디오의 중요한 디테일을 특징 공간에 보존하는 것이 다운스트림에 유리하므로, 고품질 서술 캡션으로 재캡셔닝한 소규모 데이터로 중간 사전학습을 한 번 더 끼워 넣는다. 태스크 구성(검색 + 캡셔닝)은 Stage 1과 같다.
Stage 3: 멀티태스크 파인튜닝. 마지막으로 캡셔닝/QA, 검색, 매칭, 위치추정 네 태스크를 결합한 고품질 데이터로 파인튜닝한다. 이 단계에서 위치추정 태스크가 처음 들어온다.
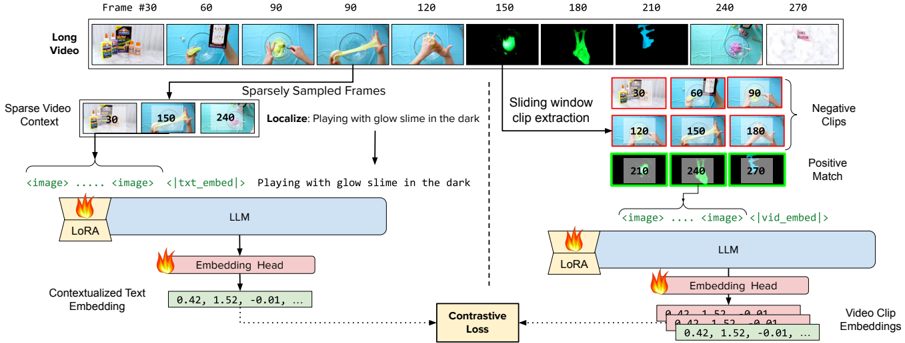
Figure 10: Stage 3의 시간적 위치추정 학습. (왼쪽) 긴 비디오에서 성긴 프레임을 뽑아 프롬프트에 넣어 문맥을 주고, "Playing with glow slime in the dark" 같은 텍스트로 문맥화된 텍스트 임베딩을 만든다. (오른쪽) 긴 비디오를 슬라이딩 윈도우로 클립 분할해 각 클립 임베딩을 얻고, 주석에 따라 포지티브/하드 네거티브를 정해 대조 손실을 건다. (원논문)
Figure 10의 학습 절차가 흥미롭다. 왼쪽 절반에서 긴 비디오 전체에서 성기게(sparsely) 샘플링한 프레임 몇 장을 캡션 프롬프트 앞에 붙여 거친 시각 문맥을 제공한 뒤, LoRA-적응 LLM과 임베딩 헤드를 거쳐 문맥화된 텍스트 임베딩을 만든다. 오른쪽 절반에서는 같은 긴 비디오를 고정 스트라이드 슬라이딩 윈도우로 잘라 각 클립을 동일한 스택(비전 인코더 → 프로젝션 → LLM → 임베딩 헤드)에 통과시켜 클립 임베딩을 얻는다. 정답 주석과 시간 경계가 일치하는 클립이 포지티브, 배치 내 나머지 윈도우 세그먼트가 하드 네거티브가 되어 InfoNCE가 걸린다. 프레임 단위 명시적 지도 없이도 공유 임베딩 공간에 세밀한 시간 감각을 심는 방식이다. 텍스트 임베딩에 성긴 프레임 문맥을 주입한다는 점이 특히 영리한데, 같은 텍스트라도 어떤 비디오 안에서 위치를 찾느냐에 따라 다른 임베딩이 나오게 만들어 위치추정의 모호성을 줄인다.
배치 구성도 실용적이다(부록 C). Table 2를 따라 각 비디오에는 지원 태스크를 표시하는 4개의 불리언 플래그가 붙는다. 배치를 샘플링할 때 플래그도 함께 샘플링해 태스크별 부분 미니배치를 만들고, 태스크마다 하나씩 미니배치를 돌린 뒤 모든 태스크의 그래디언트를 누적해 한 번에 가중치를 업데이트한다.
5. 학습 데이터
5.1 Stage 1: 대규모 사전학습 데이터
사전학습에는 라이선스가 있는 Shutterstock 스톡 비디오 데이터셋을 쓴다. 1000만 개의 고유 캡션을 담고 있고, 캡션당 무작위 클립 하나를 남겨 1000만 비디오-캡션 쌍을 만든다. 학계에서 쓰이던 WebVid-10M과 동등한 규모다.
5.2 Stage 2: 고품질 중간 데이터
Shutterstock의 부분집합을 재캡셔닝해 쓴다. Shutterstock에 풍부하게 달린 키워드를 이용해 균형을 맞추는데, 30회 미만 등장 키워드는 제외하고, 빈도 높은 키워드부터 시작해 키워드당 최대 500개 비디오를 후보 풀에 추가한다. 예산 한계 안에서 20만 개 비디오에 대해 캡션을 생성한다. LLaVA, Meta-CLIP, Cambrian의 통찰(흔한 개념을 언더샘플링해야 희소 개념에 대한 일반화가 좋아진다)을 따른 것이다.
재캡셔닝에는 Claude-3-Sonnet을 쓴다. 비디오에서 480픽셀 높이로 리사이즈한 20프레임과 함께 "비디오의 전체 테마, 시각 요소, 등장인물, 행동, 장면, 핵심 순간을 포괄하는 상세 서술 캡션을 제공하라"는 프롬프트를 넣는다.
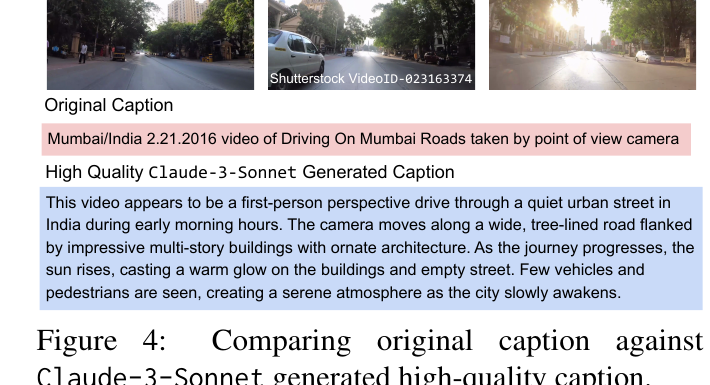
Figure 4: 원본 캡션과 Claude-3-Sonnet 생성 고품질 캡션 비교. 원본은 "Mumbai/India 2.21.2016 video of Driving On Mumbai Roads..."라는 메타데이터성 한 줄인 반면, 생성 캡션은 이른 아침 인도의 조용한 도시 거리를 1인칭 시점으로 달리는 장면을 세밀하게 서술한다. (원논문)
Figure 4의 대비가 재캡셔닝의 필요성을 잘 보여준다. 원본 캡션(분홍 박스)은 촬영 메타데이터에 가까운 한 줄인데, 생성 캡션(파랑 박스)은 "가로수 길, 다층 건물의 정교한 건축, 해가 뜨며 건물에 번지는 따뜻한 빛, 드문 차량과 보행자가 만드는 고요한 분위기"까지 담는다. 이렇게 디테일이 풍부해진 캡션이 비디오의 세부를 모델 특징 공간에 보존하도록 돕는다.
5.3 Stage 3: 멀티태스크 파인튜닝 데이터
파인튜닝 데이터는 LLM의 인스트럭션 파인튜닝(IFT)에 대응한다. 소수의 비디오-텍스트 데이터셋에서 10만 샘플을 골라 태스크별 지도를 얻는다.
| Dataset | # | Cap | QA | Loc |
|---|---|---|---|---|
| MSR-VTT | 10K | ✓ | ✓ | ✗ |
| ActivityNet | 30K | ✓ | ✓ | ✓ |
| DiDeMo | 10K | ✓ | ✗ | ✓ |
| Shutterstock | 50K | ✓ | ✗ | ✗ |
Table 2 (원논문): 멀티태스크 데이터셋 구성. Cap(캡셔닝), QA, Loc(위치추정) 지도 여부를 표시.
Table 2에서 눈에 띄는 건 데이터셋마다 지원하는 지도가 다르다는 점이다. MSR-VTT는 짧은 캡션과 QA를, ActivityNet과 DiDeMo는 비디오 청크마다 구분되는 시간 국소화 가능한 캡션을 제공하므로 위치추정 지도를 준다. ActivityNet은 QA 주석도 이미 달려 있다. 모든 데이터셋이 캡셔닝·검색·매칭 지도에 기여하고, 여기에 Shutterstock 원본 캡션 5만 개를 섞어 롱테일 다양성을 유지한다. 30만 개로 보이는 합이 실제로는 10만 샘플로 정리되는데, 표의 수치는 각 소스에서 끌어온 규모를 나타낸다.
6. 실험 결과
6.1 실험 설정
8개 벤치마크로 모델의 통합 능력을 먼저 보이고, 이어 단일 모델로는 이전에 풀기 어려웠던 새로운 태스크들을 다룬 뒤, 마지막에 각 구성요소의 기여를 ablation으로 검증한다. 검색·모먼트 검색/위치추정 평가에는 선행 연구(TimeChat, VidLA, Video-LLaVA)의 표준 프로토콜을 따른다.
- 비디오 검색: MSR-VTT, DiDeMo, VATEX. 비디오는
{video} <|vid_embed|>, 텍스트는<|txt_embed|> {text}로 임베딩을 뽑아 최근접 이웃 검색. - 모먼트 검색/위치추정: ActivityNet-Captions, Charades-STA, QVHighlights. 성긴 프레임과 텍스트를
{sparse frames} <|txt_embed|> {text}로 넣어 문맥화 텍스트 임베딩을, 슬라이딩 윈도우 클립을{clip frames} <|vid_embed|>로 넣어 클립 임베딩을 만든 뒤 후처리로 매칭 구간을 얻는다. - QA: MSR-VTT-QA, VideoChatGPT 벤치, MSVD-QA, MVBench, VideoMME.
구현 세부(부록 C)를 보면 임베딩 헤드는 단일 레이어로 Gemma-2B 레이어와 같은 차원(hidden_dim 2048, mlp_dim 16384, n_heads 8)이다. 모든 프레임은 224×224로 리사이즈한다. LoRA는 랭크 128로 LLM의 모든 선형 레이어(비전 인코더·임베딩 레이어·출력 헤드 제외)에 적용한다. PaliGemma의 <unused0>, <unused1> 토큰을 <txt_embed>, <video_embed> 초기화에 재활용한다. 학습은 수정한 HuggingFace Trainer에 FSDP를 얹어 진행한다.
6.2 검색·모먼트 검색 주 결과
먼저 검색과 위치추정의 메인 테이블이다. 모델은 ViLL-E-2.5B(PaliGemma 백본이 사실상 2.5B 규모)로 표기된다.
| Method | ActivityNet R@1,IoU=0.5 | Charades R@1,IoU=0.5 | QVHighlights mAP | MSR-VTT R@1 | DiDeMo R@1 | VATEX R@1 |
|---|---|---|---|---|---|---|
| Expert Models | ||||||
| M-DETR | - | 53.6ᶠᵗ | 35.7ᶠᵗ | ✗ | ✗ | ✗ |
| QD-DETR | 33.2ᶠᵗ | 57.3ᶠᵗ | 38.9ᶠᵗ | ✗ | ✗ | ✗ |
| TR-DETR | - | 57.6ᶠᵗ | 39.9ᶠᵗ | ✗ | ✗ | ✗ |
| SigLIP | ✗ | ✗ | ✗ | 51.7ᶠᵗ | 55.4ᶠᵗ | 40.8 |
| VidLA | ✗ | ✗ | ✗ | 58.0ᶠᵗ | 61.1ᶠᵗ | - |
| InternVideo2-CLIP-1B | ✗ | ✗ | ✗ | 50.0 | 47.7 | 63.2 |
| Video LLMs | ||||||
| Momentor-7B | 23.0 | 27.5 | 7.6 | ✗ | ✗ | ✗ |
| VTimeLLM-7B | 27.8 | 27.5 | - | ✗ | ✗ | ✗ |
| TimeChat-7B | 16.3 | 32.2 | 21.7 | ✗ | ✗ | ✗ |
| Qwen2.5-VL-3B | 28.6 | 38.1 | - | ✗ | ✗ | ✗ |
| LLaVA-ST-7B | 31.2 | 44.8 | - | ✗ | ✗ | ✗ |
| ViLL-E-2.5B (Ours) | 39.4 (↑8.2) | 51.5 (↑6.7) | 39.0 | 62.5 (↑4.5) | 61.4 | 63.5 |
Table 1 (원논문): 검색 태스크 결과. ᶠᵗ는 해당 train split에 파인튜닝한 모델, ✗는 태스크 수행 불가. 제안 방법은 볼드.
Table 1은 이 논문의 중심 근거다. 세 가지를 눈여겨볼 만하다.
첫째, 모먼트 검색에서 VideoLLM들을 압도한다. ActivityNet 39.4는 가장 강한 VideoLLM 경쟁자 LLaVA-ST-7B(31.2)를 8.2p 앞서고, Charades 51.5는 44.8을 6.7p 앞선다. 더 놀라운 건 ViLL-E가 2.5B로 7B 모델들을 이겼다는 점이다. QVHighlights mAP 39.0은 VideoLLM 중 최고인 TimeChat(21.7)을 17p 이상 벌린다.
둘째, 데이터셋별 파인튜닝 전문 검출기에 근접하거나 넘어선다. ActivityNet에서 39.4는 QD-DETR의 파인튜닝 성능 33.2를 오히려 앞선다. Charades 51.5는 M-DETR(53.6ᶠᵗ)·QD-DETR(57.3ᶠᵗ)에 아직 못 미치지만, 이들이 각 데이터셋에 개별 파인튜닝된 전문가라는 점을 감안하면 하나의 통합 모델로서는 상당히 좁힌 격차다. QVHighlights 39.0도 TR-DETR(39.9ᶠᵗ)에 거의 붙었다.
셋째, 텍스트-비디오 검색에서 전문 검색 모델과 대등하다. MSR-VTT 62.5는 파인튜닝된 VidLA(58.0ᶠᵗ)를 4.5p 앞서고, DiDeMo 61.4는 VidLA(61.1ᶠᵗ)와 사실상 동률, VATEX 63.5는 InternVideo2-CLIP-1B(63.2)를 근소하게 넘는다. VideoLLM이 텍스트-비디오 검색을 아예 못 하던(✗) 것을 생각하면, 이 열들이 채워졌다는 사실 자체가 이 논문의 존재 이유다.
한 가지 짚자면 초록·본문에서 개선폭을 "평균 7%", "8% 이상", "거의 10%" 등 조금씩 다르게 표현하는데, 어떤 베이스라인 집합을 기준으로 잡느냐에 따른 차이다. 표의 화살표 수치(+8.2, +6.7)가 가장 구체적인 근거다.
6.3 QA 결과
생성 태스크에서 얼마나 경쟁력을 지키는지가 통합 모델의 관건이다.
| Method | MSR-VTT-QA | VCG | MSVD | MVBench | VideoMME |
|---|---|---|---|---|---|
| General Video LLMs | |||||
| Qwen-2.5VL | - | - | - | 67.0 | 61.5 |
| LLaVA-Video | - | 3.5 | - | 58.6 | 63.3 |
| Temporally-Specialized Video LLMs | |||||
| ST-LLM | 63.2 | 3.15 | 74.6 | 54.9 | 37.9 |
| LLaVA-ST | 59.0 | 3.3 | 75.9 | 64.2 | - |
| Momentor | 55.6 | 3.0 | 68.9 | - | - |
| VTimeLLM | 50.2 | 2.9 | - | - | - |
| TimeChat | 45.0 | 2.3 | - | 38.5 | 34.7 |
| ViLL-E | 65.2 | 3.7 | 75.2 | 64.7 | 45.0 |
Table 3 (원논문): QA 태스크. MSR-VTT-QA·MSVD-QA는 정확도, VCG(VideoChatGPT 벤치)는 5점 척도, MVBench·VideoMME는 종합 벤치. 시간 특화 VideoLLM 중 최고치는 볼드.
Table 3에서 ViLL-E는 시간 특화 VideoLLM 그룹 안에서 MSR-VTT-QA(65.2), VCG(3.7), MVBench(64.7)에서 최고를 찍는다. MSVD-QA에서만 LLaVA-ST(75.9)에 근소하게(75.2) 밀린다. 종합 벤치인 MVBench·VideoMME에서 일반 VideoLLM인 Qwen-2.5VL·LLaVA-Video가 ViLL-E를 앞서지만, 이들은 검색·위치추정을 전혀 못 하는 순수 생성 모델임을 기억해야 한다. 검색·위치추정 능력을 새로 얻으면서도 QA 경쟁력을 시간 특화 모델 수준으로 유지했다는 것이 요점이다. 통합의 대가로 생성 성능이 무너지지 않았다는 증거다.
6.4 새로운 태스크들
통합 능력이 열어주는 새 태스크들이 이 논문의 진짜 재미다. 하나의 모델이 임베딩도 만들고 매칭도 판단할 수 있으니, 기존에 단일 모델로는 어렵던 파이프라인이 가능해진다.
2단계 검색 (Retrieve-and-Rerank). 1단계에서 생성 임베딩으로 캡션에 맞는 Top-K 비디오를 검색하고, 2단계에서 각 후보 비디오-캡션 쌍을 VideoLLM에 넣어 매칭 손실로 재랭킹한다.
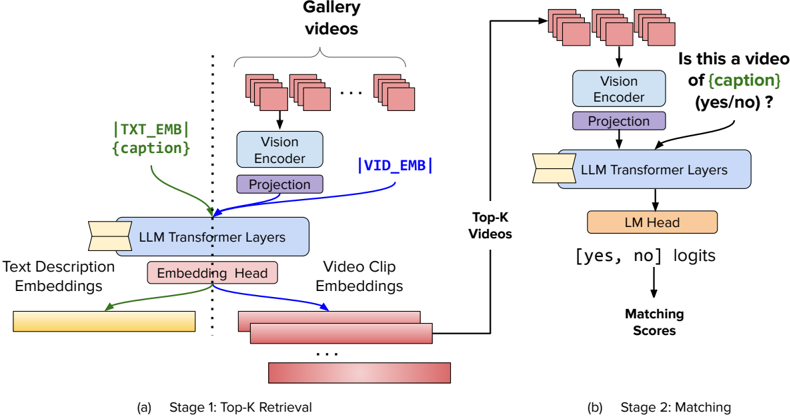
Figure 5: 2단계 검색 추론. (a) Stage 1은 텍스트/비디오 임베딩으로 Top-K를 검색하고, (b) Stage 2는 각 후보에 "Is this a video of {caption} (yes/no)?" 프롬프트를 넣어 yes/no 로짓으로 매칭 점수를 계산해 재랭킹한다. (원논문)
| MSR-VTT | T→V R@1 | T→V R@5 | V→T R@1 | V→T R@5 |
|---|---|---|---|---|
| VidLA | 58.0 | 81.1 | 56.1 | 80.5 |
| Ours (1 Stage) | 62.5 | 78.1 | 55.3 | 74.8 |
| Ours (2 Stage) | 62.8 | 80.1 | 57.3 | 83.5 |
Table 4 (원논문): 2단계 검색 + 매칭 (K=25). 볼드는 최고치.
Table 4에서 2단계 매칭은 R@1을 약 2%p 끌어올린다(T→V 62.5→62.8, V→T 55.3→57.3). R@5에서 개선이 더 크다(V→T 74.8→83.5). 1단계 임베딩 검색이 후보를 좁히고, 2단계에서 LLM의 추론력이 모호한 케이스를 해소해 순위를 정교화하는 구조다. Figure 5의 (b)에서 보듯 후보마다 "Is this a video of {caption} (yes/no)?"를 물어 yes/no 로짓 차이로 점수를 낸다. 검색 임베딩과 매칭 판단을 같은 모델이 수행하므로 별도 리랭커를 붙일 필요가 없다.
Composed Video Retrieval (CoVR). 쿼리 비디오와 수정 텍스트가 주어지면, 원본 비디오를 지시대로 변형한 가상의 비디오를 검색하는 태스크다. 비교적 새로운 태스크이자 도전적인 제로샷 벤치마크다.
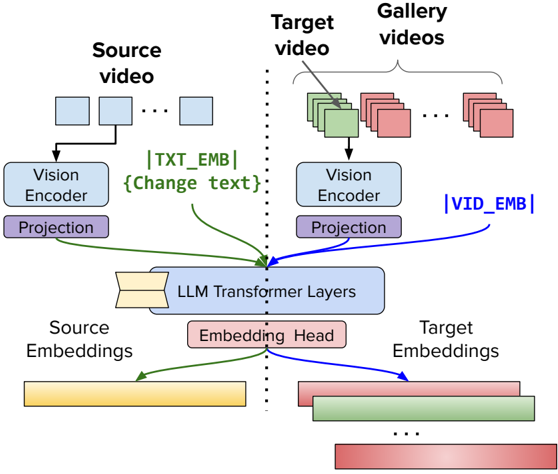
Figure 6: Composed Video Retrieval 추론. 소스 비디오 프레임과 변형 텍스트를 {source frames} <|txt_emb|> {change text}로 넣어 멀티모달 쿼리 임베딩을 만들고, 갤러리 비디오들의 타깃 임베딩과 코사인 유사도로 매칭한다. (원논문)
| Method | R@1 | R@5 | R@10 |
|---|---|---|---|
| COVR-BLIP | 45.46 | 70.46 | 79.54 |
| Thawakar et al. | 47.52 | 72.18 | 82.37 |
| Ours | 53.13 | 74.80 | 85.95 |
Table 5 (원논문): 제로샷 Composed Video Retrieval. 볼드는 최고치.
Table 5에서 ViLL-E는 제로샷임에도 R@1 53.13으로 최근 베이스라인(Thawakar et al. 47.52)을 5.6%p 넘는다. 소스 비디오 프레임과 변형 텍스트를 하나의 시퀀스에 넣어(Figure 6) 조기 융합(early fusion)된 쿼리 임베딩을 만들 수 있기 때문인데, 이건 별도 학습 없이 통합 아키텍처가 그냥 제공하는 능력이다. 임베딩과 멀티모달 문맥을 자연스럽게 합칠 수 있다는 통합 모델의 이점이 잘 드러나는 결과다.
긴 캡션 검색 (Detailed Video Caption Retrieval). CLIP 같은 듀얼 인코더는 77토큰 같은 짧은 문맥 창에 갇혀 있다. LLM 접근인 ViLL-E는 수천 토큰까지 지원한다. 도메인 특화(YouCook2)나 학습 데이터 중복 문제가 없는 AuroraCap-VideoDetailCaption(1,027 비디오, 짧은 캡션과 긴 캡션 모두 포함)으로 평가한다.
| Method | Short T→V R@1 | Short T→V R@5 | Short V→T R@1 | Short V→T R@5 | Long T→V R@1 | Long T→V R@5 | Long V→T R@1 | Long V→T R@5 |
|---|---|---|---|---|---|---|---|---|
| SigLIP | 62.5 | 83.2 | 65.4 | 85.1 | 51.7 | 72.7 | 60.4 | 81.0 |
| VidLA | 61.2 | 85.7 | 65.9 | 85.0 | 45.3 | 65.2 | 55.9 | 72.7 |
| LongCLIP | 63.0 | 85.4 | 61.5 | 83.6 | 73.5 | 91.7 | 74.5 | 92.8 |
| ViLL-E | 64.3 | 85.7 | 65.5 | 85.4 | 75.7 | 92.4 | 75.1 | 93.3 |
Table 6 (원논문): 제로샷 상세 비디오 캡션 검색. 짧은 캡션 평균 27단어, 긴 캡션 평균 500단어. 볼드는 최고치.
Table 6의 대비가 이 태스크의 핵심을 드러낸다. SigLIP과 VidLA는 짧은 캡션(27단어)에서는 준수하지만 긴 캡션(500단어)으로 가면 오히려 성능이 떨어진다. VidLA의 긴 캡션 T→V R@1은 45.3으로 짧은 캡션 61.2보다 낮다. 짧은 텍스트 인코더 문맥(64토큰)에 긴 캡션이 잘려버리기 때문이다. 248토큰까지 지원하는 LongCLIP은 긴 캡션에서 개선을 보이지만(73.5) 여전히 ViLL-E(75.7)에 못 미친다. ViLL-E는 캡션이 길어질수록 오히려 성능이 오르는데, 저자들의 표현으로 R@1이 텍스트-투-비디오 11.4%p(64.3→75.7), 비디오-투-텍스트 9.6%p(65.5→75.1) 향상된다. 긴 문맥을 그대로 삼킬 수 있는 LLM 백본의 구조적 이점이 검색 성능으로 직결된 사례다.
6.5 Ablation Study
각 구성요소의 기여를 세 갈래로 뜯어본다. 계산 효율을 위해 일부 실험은 사전학습 없이 수행한다. 벤치마크 열은 왼쪽부터 QA(MSR-VTT-QA, VideoChatGPT), 검색(MSR-VTT, DiDeMo, VATEX), 위치추정(ActivityNet, QVHighlights, Charades-STA)이다.
(a) 지도 유형 (파인튜닝 중). G=Generative, C=Contrastive, M=Matching.
| G | C | M | MSR(QA) | VCG | MSR(Ret) | DDM | VTX | ANet | QVH | Ch. |
|---|---|---|---|---|---|---|---|---|---|---|
| ✓ | ✓ | ✓ | 65.1 | 3.7 | 62.8 | 61.5 | 63.7 | 39.4 | 38.9 | 51.7 |
| ✓ | ✓ | ✗ | 63.9 | 3.7 | 60.3 | 60.2 | 62.2 | 39.1 | 38.5 | 51.5 |
| ✓ | ✗ | ✗ | 61.3 | 3.0 | 25.1 | 23.5 | 11.9 | 28.7 | 23.8 | 42.1 |
| ✗ | ✓ | ✗ | 45.5 | 2.1 | 54.7 | 53.1 | 55.2 | 29.3 | 30.3 | 48.8 |
Table 7a (원논문): 지도 유형 ablation. 볼드는 최고치.
Table 7a가 통합 학습의 정당성을 보여준다. 세 손실을 모두 쓴 전체 모델이 거의 모든 열에서 최고다. 매칭 손실을 빼면(✓✓✗) 성능이 소폭 하락하고, 대조 손실을 빼면(✓✗✗) 검색·위치추정이 붕괴한다. VATEX 검색이 63.7→11.9로 무너지는 게 극적이다. 임베딩을 제대로 학습하려면 대조 신호가 필수라는 뜻이다. 반대로 생성 손실을 빼면(✗✓✗) QA(65.1→45.5)와 캡셔닝(VCG 3.7→2.1)이 크게 떨어진다. 생성과 대조가 서로를 보완해, 둘을 함께 쓰면 생성·임베딩 양쪽이 다 좋아진다는 것이 결론이다.
(b) 임베딩 헤드 설계.
| Head | MSR(QA) | VCG | MSR(Ret) | DDM | VTX | ANet | QVH | Ch. |
|---|---|---|---|---|---|---|---|---|
| Ours (KV-Former) | 55.9 | 3.1 | 49.3 | 45.5 | 45.3 | 32.3 | 32.6 | 49.3 |
| ✗ (없음) | 40.8 | 2.8 | 30.7 | 29.1 | 32.1 | 19.8 | 20.4 | 30.7 |
| Linear | 42.9 | 2.8 | 32.4 | 29.3 | 33.2 | 23.6 | 25.4 | 42.7 |
| MLP | 51.7 | 3.0 | 43.5 | 39.8 | 39.5 | 30.2 | 29.7 | 47.1 |
| Self-Att | 52.5 | 3.2 | 43.8 | 40.9 | 40.9 | 28.2 | - | 45.7 |
| Q-Former | 52.1 | 3.0 | 47.5 | 43.2 | 42.8 | 27.9 | - | 44.2 |
| K-Former | 52.7 | 3.1 | 49.0 | 44.1 | 44.7 | 32.8 | - | 47.4 |
Table 7b (원논문): 임베딩 헤드 설계 ablation. 볼드는 최고치. 일부 QVH 셀은 원논문에 값이 비어 있어 -로 표시.
Table 7b는 4.2절의 다섯 후보 논의를 수치로 검증한다. 임베딩 헤드를 아예 빼거나(✗) 단순 Linear로 대체하면 성능이 크게 떨어진다. MLP → Self-Att → Q-Former → K-Former로 갈수록 좋아지는데, 특히 가변 길이 출력이 가능한 K-Former가 고정 길이 Q-Former를 대부분 열에서 앞선다(MSR 검색 49.0 vs 47.5, VATEX 44.7 vs 42.8). 그리고 키·값을 모두 학습하는 KV-Former(Ours)가 최종적으로 최고다. 가변 길이 대응과 병목 역할을 동시에 갖춘 설계가 실제로 이득임을 보여주는 근거다. QA(MSR 55.9)에서도 KV-Former가 가장 높아, 임베딩 헤드가 생성 태스크에도 도움을 준다는 점이 흥미롭다.
(c) 사전학습의 영향. Pre.=10M 규모 Stage 1, HQ=고품질 20만 Stage 2.
| Pre | HQ | MSR(QA) | VCG | MSR(Ret) | DDM | VTX | ANet | QVH | Ch. |
|---|---|---|---|---|---|---|---|---|---|
| ✓ | ✓ | 65.1 | 3.7 | 62.8 | 61.5 | 63.7 | 39.4 | 38.9 | 51.7 |
| ✓ | ✗ | 63.2 | 3.3 | 58.6 | 59.6 | 60.5 | 36.8 | 38.8 | 51.9 |
| ✗ | ✗ | 55.9 | 3.1 | 49.3 | 45.5 | 45.3 | 32.3 | 32.6 | 49.3 |
Table 7c (원논문): 사전학습 영향 ablation. 볼드는 최고치.
Table 7c는 두 사전학습 단계의 역할을 분리해 보여준다. Stage 1(대규모)이 검색 태스크에 결정적이다. 둘 다 없을 때(✗✗) MSR 검색이 49.3에 그치던 것이 Stage 1만 넣어도 58.6으로 뛴다. 반면 Stage 2(고품질 재캡셔닝)는 긴 비디오 데이터셋과 생성 태스크에서 특히 이득이다. QA 63.2→65.1, VATEX 60.5→63.7처럼 두 번째 단계가 더 세밀한 표현을 더한다. 정리하면 대규모 사전학습이 임베딩의 뼈대를 세우고, 고품질 재캡셔닝이 디테일을 채우는 역할 분담이다.
7. 부록 실험 및 추가 분석
부록에는 적응형 임베딩 메커니즘을 뒷받침하는 세부 실험과 데이터 구성 분석이 담겨 있다.
7.1 풀링 토큰 개수 (Table 8)
임베딩 헤드의 학습 가능한 풀링 토큰 개수 를 바꿔본 실험이다.
| # | Pre. | VCG | MSR | VTX | QVH |
|---|---|---|---|---|---|
| Ours (256) | ✗ | 3.1 | 49.3 | 45.3 | 32.6 |
| 32 | ✗ | 2.7 | 34.8 | 35.5 | 25.7 |
| 64 | ✗ | 3.0 | 42.5 | 39.2 | 29.5 |
| 128 | ✗ | 3.1 | 48.6 | 44.9 | 32.0 |
| 512 | ✗ | 3.1 | 49.5 | 45.0 | 32.4 |
Table 8 (원논문): 풀링 토큰 개수. Ours는 256 사용.
Table 8에서 저자들은 256을 택한다. Q-Former가 보통 32개 쿼리를 쓰는 것과 대비되는 큰 값이다. 32개에서는 성능이 뚜렷이 낮고(MSR 34.8), 128부터 거의 포화되며, 512로 늘려도 이득이 미미하다(MSR 49.5 vs 256의 49.3). 병목의 용량을 충분히 크게 잡아야 표현력을 확보한다는 뜻인데, 사전 학습에 비유한 "딕셔너리"의 크기를 넉넉히 준 셈이다.
7.2 임베딩 토큰 개수 (Table 9)
ViLL-E의 비디오 임베딩 생성은 EOS까지 가변 개수의 토큰을 뽑는다. GRIT 같은 인코더 접근은 고정 개수를 쓴다. 이 가변 방식의 이득을 재기 위해, 모델이 고정된 1개 또는 5개 토큰만 쓰도록 학습시켜 비교한다.
| # | Pre. | MSR(QA) | VCG | MSR(Ret) | DDM | VTX | ANet | QVH | Ch. |
|---|---|---|---|---|---|---|---|---|---|
| Ours (가변) | ✗ | 55.9 | 3.1 | 49.3 | 45.5 | 45.3 | 32.3 | 32.6 | 49.3 |
| 1 (고정) | ✗ | 50.2 | 2.6 | 45.8 | 37.6 | 38.9 | 23.7 | 24.1 | 36.8 |
| 5 (고정) | ✗ | 54.1 | 2.8 | 47.9 | 40.3 | 41.2 | 27.3 | 27.8 | 42.3 |
Table 9 (원논문): 임베딩 토큰 개수. Ours는 EOS까지 가변 생성.
Table 9가 적응형 메커니즘의 핵심 근거다. 고정 1토큰은 모든 열에서 크게 뒤처지고(Charades 36.8), 고정 5토큰으로 늘려도 여전히 가변 방식에 못 미친다(Charades 42.3 vs 49.3). 특히 위치추정 계열(ANet, QVH, Ch)에서 격차가 크다. 비디오마다 필요한 만큼 토큰을 뽑는 것이 고정 개수보다 확실히 낫다는 것을 보여준다.
7.3 추론 지연시간 (Table 10)과 지속시간별 정확도 (Table 11)
가변 생성이 느리지 않느냐는 자연스러운 의문이 든다. AWS g6e.8xlarge(NVIDIA L40S GPU)에서 12프레임·배치 16으로 측정한 결과다.
| Tokens | Latency (ms) |
|---|---|
| Fixed - 1 | 238 |
| Fixed - 5 | 257 |
| Fixed - 10 | 326 |
| Adaptive (Ours) | 262 |
Table 10 (원논문): 임베딩 토큰 개수별 추론 지연시간.
Table 10을 보면 적응형(262ms)은 고정 5토큰(257ms)과 거의 같고 고정 10토큰(326ms)보다 훨씬 빠르다. 정확도는 크게 올리면서 지연시간 오버헤드는 미미하다는 뜻이다. 가변 생성이라 느릴 것이라는 직관과 달리, 쉬운 비디오는 빨리 끝나므로 평균 비용이 낮게 유지된다.
이 "쉬운 건 빨리, 어려운 건 오래"가 정말 작동하는지를 지속시간별로 쪼갠 것이 Table 11이다. ActivityNet Captions를 5분까지 거의 균일하게 분포한 지속시간 구간으로 나눠 텍스트-투-비디오 R@1을 측정한다.
| Method | 0-60s | 60-120s | 120-180s | 180s+ | Overall |
|---|---|---|---|---|---|
| VidLA Baseline | 65.7 | 66.5 | 65.0 | 63.5 | 65.2 |
| Fixed Token = 1 | 66.2 | 64.7 | 63.5 | 62.2 | 64.1 |
| Fixed Tokens = 5 | 66.6 | 67.4 | 66.4 | 65.4 | 66.5 |
| Adaptive (Ours) | 67.9 | 68.5 | 67.8 | 67.1 | 67.9 |
Table 11 (원논문): ActivityNet Captions 텍스트-투-비디오 검색(R@1)을 비디오 지속시간별로 분해.
Table 11에서 적응형은 모든 지속시간 구간에서 최고이고, 특히 긴 비디오(180s+)에서 격차가 벌어진다. 고정 토큰 방식은 비디오가 길어질수록 성능이 떨어지는데(고정 1토큰 66.2→62.2), 적응형은 67.9→67.1로 거의 유지된다. 저자들은 여기서 결정적 증거를 하나 더 제시한다. 적응형이 실제로 뽑는 평균 토큰 수를 재보니 0-60s에서 8.6개, 60-120s에서 10.1개, 120-180s에서 11.5개, 180s+에서 14.8개였다. 긴 비디오일수록 모델이 자발적으로 더 많은 토큰을 뽑는다 - "복잡한 비디오엔 더 오래 생각한다"는 설계 의도가 실제 행동으로 확인된 셈이다. 개인적으로는 이 테이블이 논문에서 가장 설득력 있는 부분이라고 본다. 메커니즘의 존재 이유를 정확히 겨냥한 측정이기 때문이다.
7.4 학습 하이퍼파라미터 (Table 12)
| Hyperparameter | Stage 1/2 | Stage 3 |
|---|---|---|
| Number of GPUs | 32 | 8 |
| Batch Size (per GPU) | 12 | 8 |
| Gradient Accumulation | 2 | 4 |
| Optimizer | Lion | AdamW |
| Base Learning Rate | 1e-5 | 5e-6 |
| Warmup Steps | 2000 | 1000 |
| Weight Decay* | 0.00001 | - |
| LoRA Rank | 128 | 32 |
| Training Steps | 25,000 | 4,000 |
| Max Token Length | 2304/4096 | 4096 |
*Table 12 (원논문): 단계별 학습 하이퍼파라미터. 는 새 임베딩 헤드에만 적용.
Table 12에서 눈에 띄는 건 단계별 설계의 차이다. 대규모 Stage 1/2는 GPU 32장·Lion 옵티마이저·LoRA 랭크 128로 효율에 무게를 두고, 소규모 Stage 3는 GPU 8장·AdamW·낮은 학습률(5e-6)·랭크 32로 안정적 파인튜닝을 노린다. 학습률은 MSR-VTT에서의 소규모 실험으로 정했다고 한다. 대규모 사전학습(25,000 스텝)이 파인튜닝(4,000 스텝)보다 훨씬 길다는 점도 Table 7c의 "Stage 1이 뼈대"라는 결론과 맞아떨어진다.
7.5 위치추정 추론 프로토콜 (Table 13)
부록 G는 위치추정 추론의 후처리를 설명한다. 비디오를 겹치지 않는 윈도우로 나눠 각 세그먼트의 텍스트-비디오 유사도를 계산하고, 최고 점수 윈도우(점수 )를 시드로 삼아 좌우로 인접 윈도우를 병합한다. 병합 조건은 인접 윈도우 점수 가 병합 임계값 를 넘거나 시드 점수의 일정 비율 이상()일 때다. 양쪽 다 실패하는 첫 이웃에서 확장을 멈추고, 승인된 윈도우들의 합집합이 최종 예측이 된다.
| Window | Stride | IoU | R@1, IoU=0.5 |
|---|---|---|---|
| 5s | 5s | 0.3 | 39.0 |
| 5s | 5s | 0.4 | 39.4 |
| 5s | 5s | 0.5 | 35.7 |
| 10s | 10s | 0.4 | 39.2 |
| 10s | 5s | 0.4 | 41.7 |
| 15s | 10s | 0.4 | 39.9 |
Table 13 (원논문): ActivityNet에서의 위치추정 추론 프로토콜 ablation.
Table 13은 윈도우·스트라이드·IoU 임계값의 조합을 탐색한다. 윈도우 10s에 스트라이드 5s(즉 50% 겹침) 조합이 41.7로 가장 좋다. 겹치는 윈도우가 경계 근처 이벤트를 더 잘 포착하기 때문으로 보인다. IoU 임계값은 0.4 부근이 최적이고 0.5로 높이면 오히려 떨어진다(39.4→35.7). 참고로 Table 1의 ActivityNet 수치 39.4는 5s/5s/0.4 설정에 해당하는데, 후처리를 10s/5s로 바꾸면 41.7까지 오른다는 점도 눈여겨볼 만하다.
7.6 데이터 구성 분석 (Figure 7, 8)
Stage 2 데이터 균형화의 효과를 두 그래프가 보여준다.
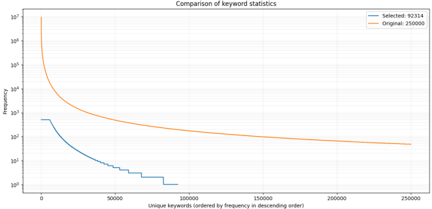
Figure 7: 흔한 개념을 언더샘플링해 데이터셋 개념 균형을 맞춘 결과. y축은 로그 스케일. 주황(원본 25만)과 파랑(선별 9.2만)의 빈도 분포. (원논문)
Figure 7에서 원본 키워드 빈도 분포(주황)는 소수 흔한 키워드가 극단적으로 많은 롱테일이다. 선별 후(파랑)는 키워드당 최대 500개 상한을 걸어 이 롱테일을 평탄화한다. 흔한 개념의 과대표집을 억제해 희소 개념 일반화를 노린 것이다.
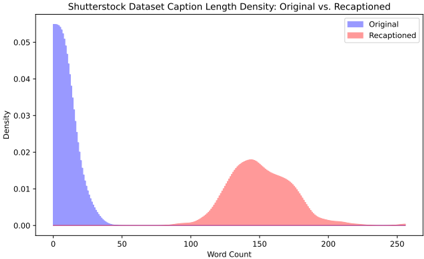
Figure 8: 재캡셔닝이 캡션의 상세도를 크게 높인다. 파랑은 원본 캡션, 빨강은 생성 캡션의 단어 수 밀도. (원논문)
Figure 8은 재캡셔닝 전후 캡션 길이 분포다. 원본(파랑)은 10단어 미만에 몰려 있는데, 재캡셔닝(빨강)은 평균 130단어 이상으로 이동한다. Figure 4에서 본 질적 차이가 분포 전체에서 일관되게 나타남을 보여주는 그래프다. 캡션당 평균 10단어 미만에서 130단어 이상으로의 이동이 Stage 2가 더하는 "디테일"의 정체다.
7.7 정성적 캡셔닝 결과 (Figure 11)
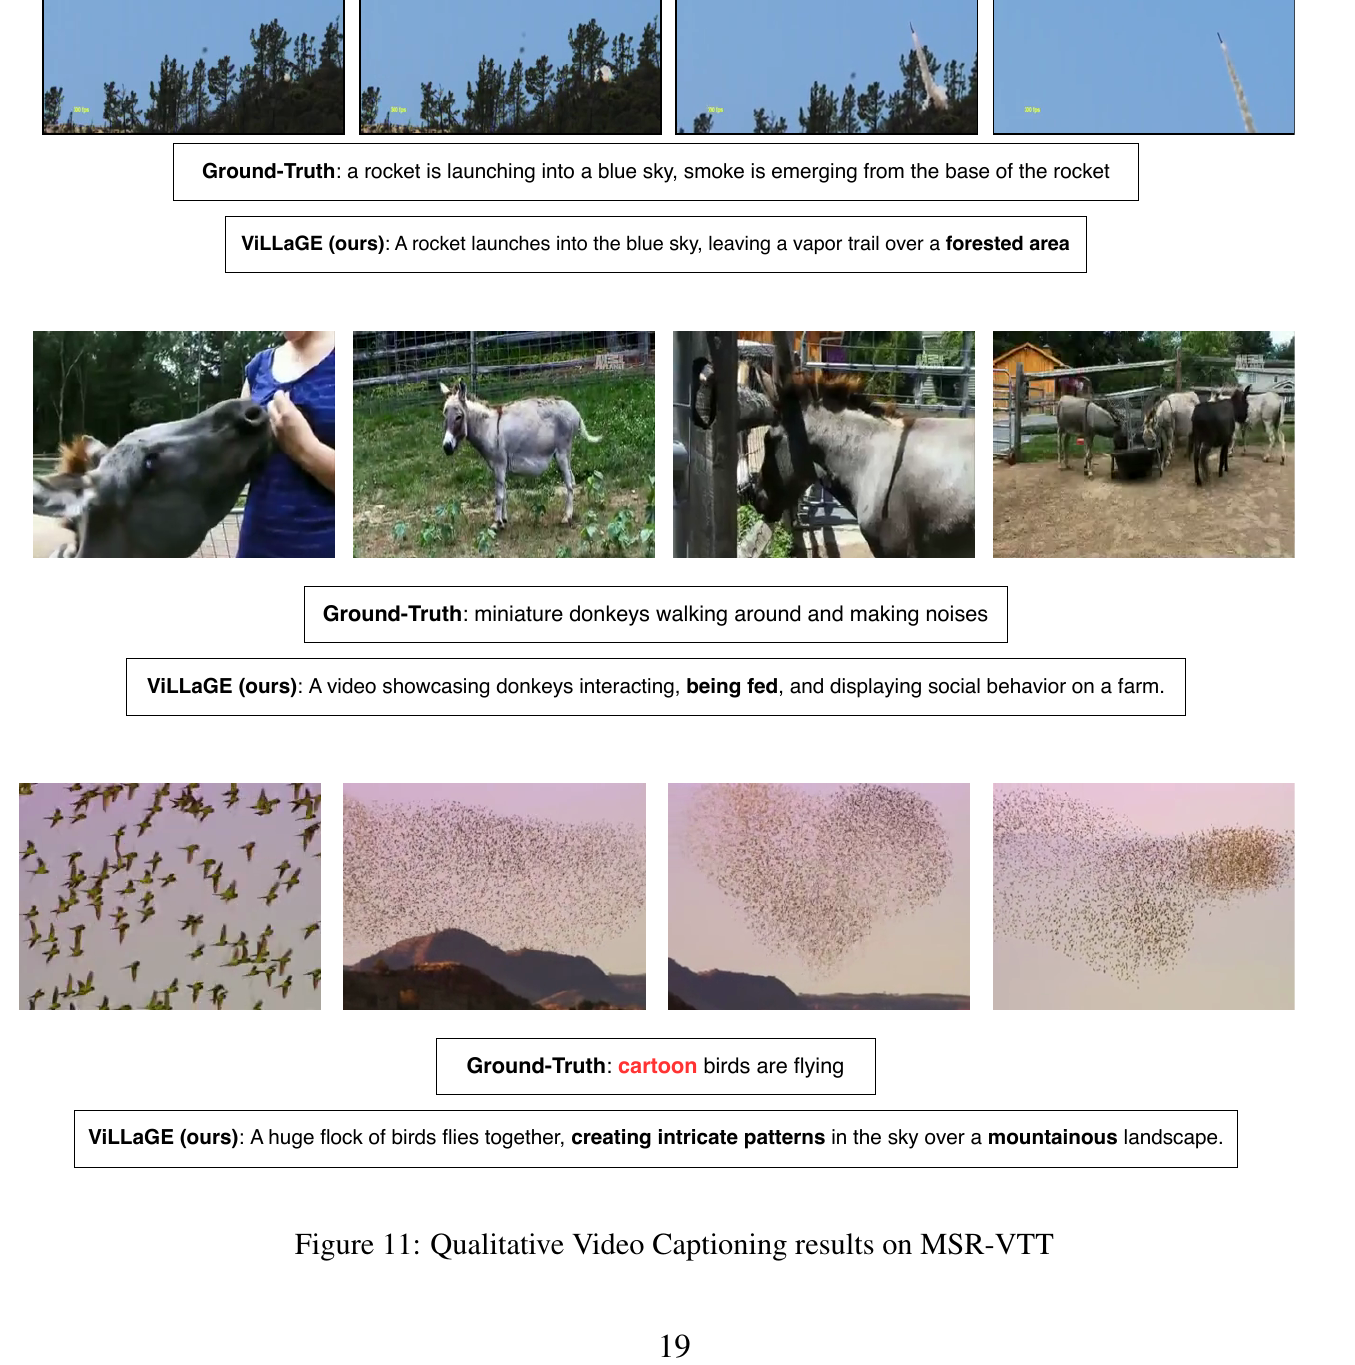
Figure 11: MSR-VTT에서의 정성적 캡셔닝 결과. 로켓 발사, 미니어처 당나귀, 새 떼 세 사례에서 정답 캡션과 ViLL-E 생성 캡션을 비교한다. (원논문)
Figure 11은 ViLL-E의 캡션이 때로 데이터셋 정답보다 풍부함을 보여준다. 로켓 발사 영상에서 정답은 "연기가 나며 상승"에 그치는데, ViLL-E는 "숲이 우거진 지역 위로 수증기 궤적을 남기며"까지 묘사한다. 미니어처 당나귀 영상에서 정답은 "걸어 다니며 소리를 낸다"인데, ViLL-E는 "상호작용하고, 먹이를 먹고, 농장에서 사회적 행동을 보인다"고 확장한다. 새 떼 영상에서는 정답이 "만화 새들이 난다"인 반면(사실 만화가 아니라 실제 새 떼다) ViLL-E는 "거대한 새 떼가 산악 풍경 위로 정교한 패턴을 만든다"고 정확히 서술한다. 생성-대조 결합 학습이 임베딩만 좋게 하는 게 아니라 캡션의 표현력도 끌어올렸다는 정성적 증거다. 참고로 이 그림들에서 모델이 "ViLLaGE (ours)"로 표기돼 있는데, 본문 명칭 ViLL-E와 다른 걸 보면 집필 중 이름을 바꾼 흔적으로 보인다.
7.8 임베딩 시각화 (Figure 12)
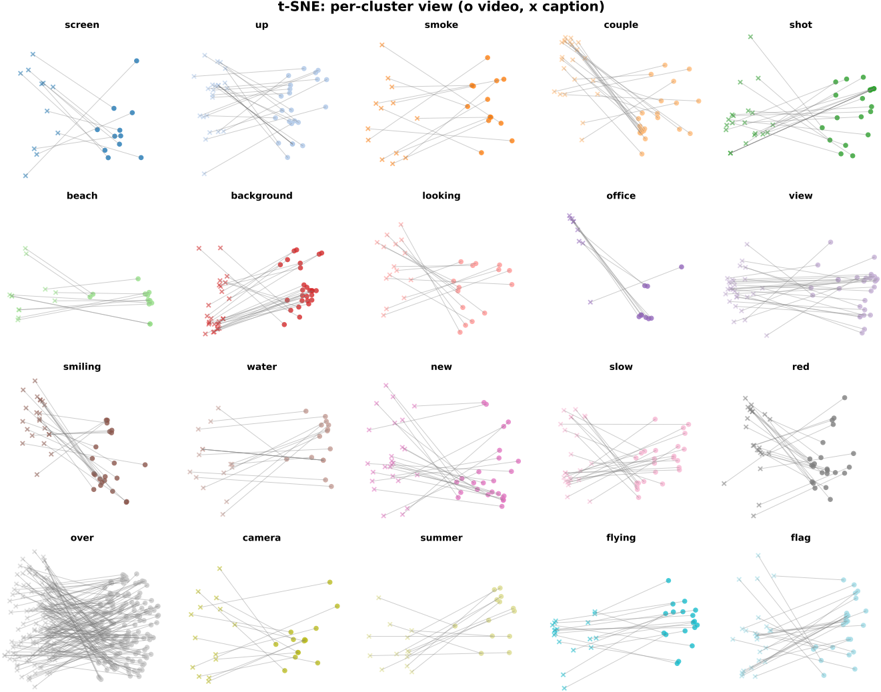
Figure 12: 보류 검증셋 비디오의 텍스트·비디오 임베딩을 Barnes-Hut t-SNE로 2차원 축소한 뒤 K-means(k=20)로 군집화한 4×5 그리드. 각 패널은 하나의 군집으로, 채워진 원은 비디오, ×는 캡션이며 회색 선이 짝을 잇는다. (원논문)
Figure 12는 임베딩의 정렬 품질을 군집별로 시각화한다. 각 패널에서 비디오(원)와 짝 캡션(×)을 잇는 회색 선이 짧고 교차가 적을수록 정렬이 좋은 것이다. 저자들에 따르면 "couple", "flying", "summer" 같은 개념 군집에서 특히 강한 정렬을 보인다. "office"나 "smoke" 군집처럼 선이 한 점으로 수렴하는 패널은 밀집된 정렬을, 선이 넓게 교차하는 패널은 상대적으로 어려운 도메인을 시사한다. 임베딩 공간이 도메인별로 어디서 잘 작동하고 어디서 덜한지를 한눈에 진단하는 도구다.
7.9 광범위한 영향과 라이선스
부록 D-F는 실무적 고려를 담는다. 생성 모델과 임베딩 모델을 하나로 통합하면 두 개의 추론 파이프라인을 유지할 때보다 에너지 사용과 환경 영향을 줄일 수 있다는 것이 저자들이 강조하는 긍정적 함의다. 부정적으로는 범용 모델이 지닌 오용 가능성을 공유한다. 프라이버시 보호를 위해 모든 비디오는 deface 파이썬 패키지로 사람 얼굴을 블러 처리해 저장·사용한다. 데이터·모델 라이선스도 상세히 밝히는데, WebVid-10M(Shutterstock)은 비상업 연구용, PaliGemma-3B는 Gemma Open Model License, SigLIP-SO-400M은 Apache 2.0, Claude-3-Sonnet은 Anthropic 이용약관을 따른다. 데이터셋별로도 ActivityNet(MIT), DiDeMo(BSD 2-Clause), VATEX(CC BY 4.0), QVHighlights(CC BY-NC-SA 4.0) 등 조건이 제각각이라, 재현이나 상업적 활용 시 주의가 필요하다.
8. 강점과 한계
강점
- 통합의 실증. Figure 1의 능력 표에서 보듯, 검색·위치추정·QA·캡셔닝 네 능력을 한 모델에 담은 첫 VideoLLM이다. Table 1과 Table 3이 이 통합이 성능 희생 없이 이뤄졌음을 뒷받침한다. 검색을 새로 얻으면서도 QA를 시간 특화 모델 수준으로 유지했다.
- 적응형 임베딩의 설득력 있는 검증. Table 9(가변 vs 고정), Table 10(지연시간), Table 11(지속시간별 + 토큰 수)이 "복잡한 비디오엔 더 오래 생각한다"는 주장을 정확히 겨냥해 측정한다. 특히 긴 비디오에서 자발적으로 토큰을 더 뽑는다는 관찰(8.6→14.8개)이 메커니즘의 실재를 증명한다.
- 파라미터 효율. 2.5B 모델로 7B VideoLLM들을 모먼트 검색에서 압도한다(Table 1). LoRA 파인튜닝과 학습 가능한 임베딩 헤드만으로 이룬 결과다.
- 통합이 여는 새 태스크. 2단계 리랭킹(Table 4), 제로샷 CoVR(Table 5, +5.6p), 긴 캡션 검색(Table 6)은 별도 학습 없이 통합 아키텍처가 그냥 제공하는 능력이다. 특히 긴 캡션에서 듀얼 인코더가 무너지는(VidLA 61.2→45.3) 것과 대비되는 견고함이 인상적이다.
한계 및 아쉬운 점
- 다중 턴 대화 부재. 저자들이 밝히듯 베이스 PaliGemma의 한계를 물려받아 일반적인 다중 턴 대화를 못 한다. 실용 모델이 되려면 이 부분을 별도로 다뤄야 한다.
- 영어 편중. 학습 데이터가 주로 영어여서 PaliGemma의 다국어 능력을 일부 잃을 것으로 저자들도 예상한다. 다국어 검색이 중요한 실무에선 제약이다.
- 개념 증명 수준의 위치. 저자 스스로 이 작업을 "생성-임베딩 통합의 개념 증명(proof of concept)"으로 규정한다. Charades 51.5가 QD-DETR 57.3ᶠᵗ에 여전히 못 미치듯, 데이터셋별 전문가를 완전히 대체하진 못한다.
- 후처리 의존성. 위치추정 성능이 Table 13처럼 윈도우·스트라이드·IoU 임계값 같은 추론 후처리에 상당히 민감하다(39.0~41.7). 임베딩 자체의 품질과 후처리 튜닝의 기여가 뒤섞여 있어, 순수 표현력을 분리해 보기 어렵다.
- 명명·표기의 불일치. Figure 10·11에 "ViLLaGE"라는 옛 이름이 남아 있고, Table 7b의 일부 셀이 비어 있는 등 마무리의 세부가 다소 거칠다. 결과 해석에 지장은 없지만 재현을 시도하는 독자에겐 사소한 마찰이 된다.
9. 마치며
ViLL-E가 던지는 메시지는 단순하다. 비디오를 다루는 생성 모델과 임베딩 모델을 굳이 따로 둘 이유가 없다는 것이다. 하나의 LLM 백본에 생성 헤드와 임베딩 헤드를 나란히 얹고 생성-대조를 함께 학습하면, 두 세계의 능력이 서로를 갉아먹기는커녕 보완한다는 것을 Table 7a가 수치로 보여줬다. 여기에 EOS 트리거 적응형 임베딩이라는 한 수를 더해, 비디오 복잡도에 따라 계산량을 스스로 조절하는 메커니즘까지 붙였다. Table 11에서 긴 비디오일수록 모델이 자발적으로 더 많은 토큰을 뽑는다는 관찰은, 이 설계가 단순한 장식이 아니라 실제로 작동하는 원리임을 확인시킨다.
물론 아직 완성형은 아니다. 다중 턴 대화도, 다국어도, 데이터셋별 전문가를 완전히 뛰어넘는 위치추정 정확도도 남은 과제다. 그러나 방향성만큼은 분명하다. NLP에서 GRIT가 생성과 임베딩의 통합을 보였듯, 비디오에서도 두 스택을 하나로 합치는 흐름이 시작된 것이다. 실무 관점에서 두 개의 추론 파이프라인을 하나로 줄일 수 있다는 효율성의 함의도 무시하기 어렵다.
가장 오래 기억에 남는 건 "쉬운 비디오는 빨리, 어려운 비디오는 오래 생각한다"는 적응형 임베딩의 발상이다. 추론 모델이 어려운 문제에 더 오래 사고하는 흐름을, 임베딩 생성이라는 전혀 다른 문제로 옮겨 온 이 아이디어는 앞으로 다른 모달리티의 임베딩에도 응용될 여지가 커 보인다.
References
- Gupta et al. (2026). ViLL-E: Video LLM Embeddings for Retrieval. arXiv:2604.12148.
- Beyer et al. (2024). PaliGemma: A versatile 3B VLM for transfer. arXiv:2407.07726.
- Muennighoff et al. (2024). Generative Representational Instruction Tuning (GRIT). arXiv:2402.09906.
- Rizve et al. (2024). VidLA: Video-Language Alignment at Scale. CVPR 2024.
- Moon et al. (2023). Query-Dependent Video Representation for Moment Retrieval and Highlight Detection (QD-DETR). CVPR 2023.
- Li et al. (2025). LLaVA-ST: A Multimodal LLM for Fine-grained Spatial-Temporal Understanding. arXiv:2501.08282.
- Zhai et al. (2023). Sigmoid Loss for Language Image Pre-training (SigLIP). ICCV 2023.
- Radford et al. (2021). Learning Transferable Visual Models from Natural Language Supervision (CLIP). ICML 2021.