논문 리뷰
논문 리뷰: Why Mean Pooling Works: Quantifying Second-Order Collapse in Text Embeddings
토큰 임베딩을 그냥 평균 내는 mean pooling이 어째서 잘 작동하는지를, "2차 통계량 붕괴"라는 개념과 이를 측정하는 SOCM 지표로 정량화한 논문.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Why Mean Pooling Works: Quantifying Second-Order Collapse in Text Embeddings |
| 저자 | Tomomasa Hara, Hiroto Kurita, Masaaki Imaizumi, Kentaro Inui, Sho Yokoi (Kyoto University, Tohoku University, The University of Tokyo, RIKEN, MBZUAI, NINJAL) |
| 학회/저널 | arXiv Preprint, 2026 |
| 논문 링크 | arXiv:2604.27398 |
1. 들어가며
문장이나 문단, 문서를 하나의 벡터로 압축하는 텍스트 임베딩(text embedding)은 이제 NLP의 기본 부품이다. 정보 검색(information retrieval), 자동 평가, 그리고 무엇보다 RAG(retrieval-augmented generation)의 검색 단계가 모두 이 벡터 하나에 기대고 있다. 그런데 이 임베딩을 만드는 마지막 연산은 의외로 허술하다. 토큰마다 나오는 임베딩들을 그냥 산술 평균 내는 것, 즉 mean pooling이 사실상 표준이기 때문이다.
곰곰이 생각해보면 이상한 일이다. 문장 하나에는 수십 개의 토큰 임베딩이 있고, 이들은 임베딩 공간에서 나름의 모양(spread)을 이루며 흩어져 있다. 그런데 평균을 내는 순간 이 모양에 대한 정보는 전부 버려지고 무게중심 하나만 남는다. 통계학의 언어로 말하면, mean pooling은 토큰 임베딩 분포의 1차 통계량(first-order statistic) 만 취하고 공분산 같은 2차 이상의 통계량(higher-order statistics) 은 통째로 날려버린다. 극단적으로는, 서로 완전히 다른 두 문장의 토큰 분포가 우연히 비슷한 평균을 가진다면 두 문장의 임베딩이 사실상 구별 불가능해질 수도 있다.
실제로 이 걱정에서 출발해, 토큰 임베딩 리스트를 평균 내지 않고 통째로 다루려는 연구들(최적 수송, ColBERT, BERTScore 등)이 꾸준히 있어 왔다. 그럼에도 현실의 최신 인코더들은 여전히 mean pooling을 쓰면서 이런 무겁고 정교한 방법들과 대등하거나 더 나은 성능을 낸다. 그렇다면 질문은 뒤집힌다. 이론적으로는 정보를 버리는 게 분명한 mean pooling이, 왜 실제로는 별 문제 없이 잘 작동하는가?
이 논문은 그 질문에 정면으로 답한다. 먼저 "2차 통계량이 붕괴하는(collapse)" 현상을 정의하고, 그것이 얼마나 심각하게 일어나는지를 재는 지표 SOCM(degree of Second-Order Collapse by Mean pooling)을 제안한다. 그리고 이 자를 실제 모델과 실제 텍스트에 들이대서, 현대의 대조 학습(contrastive learning) 기반 인코더들이 이 붕괴에 놀랄 만큼 강건하다는 것을 보여준다. 더 나아가 그 강건함이 어디서 오는지를 트랜스포머 레이어 수준에서 이론적·경험적으로 파고든다.
2. 기존 연구의 한계
이 논문의 위치를 이해하려면, 텍스트 임베딩을 만드는 두 갈래의 흐름을 먼저 정리할 필요가 있다.
2.1 Mean pooling 계열: 표준이 된 단순함
토큰 임베딩을 평균 내는 방식은 고전적인 정적 임베딩(static embedding) 시절부터 있었고(Wieting et al., 2016; Shen et al., 2018), 트랜스포머 인코더 시대에 와서는 Sentence-BERT(Reimers and Gurevych, 2019) 이후 사실상 기본값이 됐다. SimCSE(Gao et al., 2021), E5(Wang et al., 2024), GTE(Li et al., 2023), Nomic Embed(Nussbaum et al., 2025) 등 지금 널리 쓰이는 인코더 상당수가 mean pooling을 쓴다.
이 방식이 살아남은 이유는 대체로 공학적이다. 대조 학습과 궁합이 좋고, 메모리를 적게 쓰며, 근사 최근접 이웃 탐색(approximate nearest neighbor search)과도 잘 맞는다. 요컨대 "싸고 빠르고 무난하다"는 것이지, "정보를 잘 보존한다"는 근거로 정당화된 적은 없다. 이 논문이 채우려는 공백이 바로 여기다. 공학적 이점 너머에서, 정보 이론적으로 왜 괜찮은지를 설명하려는 것이다.
2.2 고차 통계량을 보존하는 계열: 무겁지만 원리적
정반대 진영에는 mean pooling의 정보 손실을 아예 피하려는 방법들이 있다. 토큰 임베딩 리스트를 평균 내지 않고 리스트 그대로 다루는 접근이 대표적이다. 두 리스트 사이의 거리를 최적 수송(optimal transport)으로 재는 Word Mover's Distance(Kusner et al., 2015), MoverScore(Zhao et al., 2019), Word Rotator's Distance(Yokoi et al., 2020) 계열이 있고, 각 쿼리 토큰을 가장 비슷한 문서 토큰에 매칭하는 ColBERT(Khattab and Zaharia, 2020), 토큰 단위 유사도를 F-score처럼 집계하는 BERTScore(Zhang et al., 2020)도 여기에 속한다. 텍스트를 하나의 확률 분포로 보는 Sen2Pro(Shen et al., 2023)나, 1차·2차 통계량을 직접 예측해서 텍스트를 가우시안 분포로 표현하는 GaussCSE(Yoda et al., 2024)도 같은 문제의식에서 나왔다.
이들은 원리적으로는 더 많은 정보를 담지만, 계산이 무겁고 저장·검색 파이프라인에 얹기 번거롭다. 그리고 결정적으로, 이렇게 공을 들여도 mean pooling 기반 최신 인코더를 확실히 이기지 못한다(Lee et al., 2022). 이 애매한 무승부가 이 논문의 출발점이다. 고차 통계량을 열심히 보존하는 방법이 단순 평균을 못 이긴다면, 혹시 최신 인코더에서는 애초에 보존할 고차 통계량이 별로 없는 게 아닐까?
3. 핵심 아이디어
이 논문의 통찰은 제목만 보면 "mean pooling이 잘 작동한다"는 옹호처럼 읽히지만, 실제 논증은 훨씬 미묘하다. 저자들의 주장은 이렇게 요약된다. mean pooling이 2차 통계량을 버리는 건 맞다. 다만 잘 학습된 최신 인코더에서는 버릴 2차 통계량 자체가 거의 남아 있지 않기 때문에, 손실이 사실상 발생하지 않는다.
즉 mean pooling이 정보를 잘 보존해서 잘 작동하는 게 아니라, 대조 학습이 토큰 임베딩들을 문장별로 한 점 근처에 뭉치게(concentrate) 만들어서, 분포의 모양(2차 통계량)을 무의미하게 만들어 버린 것이다. 모양이 없으면 모양을 버려도 잃을 게 없다. 이것이 "seemingly coarse"한 mean pooling이 멀쩡히 작동하는 이유에 대한 이 논문의 대답이다.
이 통찰을 검증 가능한 형태로 만들려면 두 가지가 필요하다. 하나는 "2차 통계량 붕괴가 얼마나 심한가"를 숫자로 재는 자(SOCM), 다른 하나는 "왜 토큰이 뭉치는가"에 대한 메커니즘 설명(트랜스포머 레이어 분석)이다. 논문은 이 둘을 각각 4·5장과 6장에서 제공하고, 7장에서 이 붕괴 강건성이 다운스트림 성능과 상관된다는 것까지 보여주며 이야기를 닫는다.
아래 그림이 논문 전체의 얼개다.
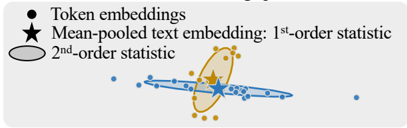
Figure 1 (원논문, 상단): 검은 점은 토큰 임베딩, 별은 mean pooling으로 얻은 1차 통계량(텍스트 임베딩), 타원은 2차 통계량을 나타낸다. 파란 분포와 노란 분포는 퍼진 모양(2차 통계량)이 서로 다른데도 평균(별)의 위치가 겹쳐, mean pooling 후에는 구별되지 않는다.
윗 그림의 범례는 이 논문의 표기법 전체를 압축한다. 토큰 임베딩(점)들이 만드는 분포를 별(평균)과 타원(공분산)으로 요약할 때, mean pooling은 오직 별만 남긴다. 파란색과 노란색 두 분포가 명백히 다른 방향으로 퍼져 있는데도 별이 겹쳐 있다면, 이 둘은 mean pooling 후 사실상 같은 벡터가 된다. 이것이 저자들이 말하는 "붕괴(collapse)"의 시각적 정의다.
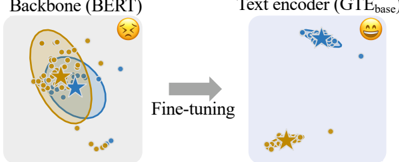
Figure 1 (원논문, 하단): 왼쪽 백본(BERT)에서는 두 텍스트(파랑·노랑)의 토큰 분포가 넓게 퍼져 서로 겹치며 붕괴가 일어난다(찡그린 표정). 대조 학습으로 파인튜닝한 텍스트 인코더(GTE_base)에서는 각 텍스트의 토큰이 한 점으로 뭉치고 두 분포의 평균이 멀찍이 분리되어 붕괴가 사라진다(웃는 표정).
아랫 그림이 논문의 결론을 미리 보여준다. 백본 모델(BERT)에서는 두 문장의 토큰 임베딩이 넓게 퍼져 겹치는 반면, 대조 학습으로 파인튜닝한 GTE_base에서는 각 문장의 토큰이 좁게 뭉치고 두 뭉치가 공간상에서 멀리 떨어진다. 붕괴가 일어나려면 "퍼짐이 크면서 평균이 겹쳐야" 하는데, 파인튜닝된 모델은 정확히 그 반대의 상태로 간다. 실제로 이 예시는 뒤에 나올 SOCM 지표로 발굴한 사례다.
4. 제안 방법: 2차 통계량 붕괴와 SOCM
4.1 준비 - 토큰 임베딩의 1차·2차 통계량
두 텍스트 에 대해 모델 는 각각 토큰 임베딩 리스트를 출력한다.
여기서 는 텍스트 의 번째 토큰 임베딩, 는 임베딩 차원, 는 토큰 개수다. mean pooling은 이 리스트를 평균 내어 텍스트 임베딩 를 만든다.
이 가 토큰 임베딩을 하나의 경험적 분포(empirical distribution)로 볼 때의 1차 통계량이다. 반면 분포의 공간적 구조는 2차 통계량, 즉 공분산 행렬 에 담긴다.
mean pooling은 만 취하고 는 버린다. 논문은 mean pooling이 놓치는 통계량 중 가장 낮은 차수인 2차 통계량에 초점을 맞춘다. 3차 이상은 다루지 않는데, 이건 뒤의 한계 절에서 저자들도 명시적으로 인정하는 지점이다.
4.2 붕괴는 언제 일어나는가
붕괴가 발생하는 조건은 두 분포의 1차 통계량이 얼마나 비슷한지, 2차 통계량이 얼마나 다른지의 조합으로 갈린다.
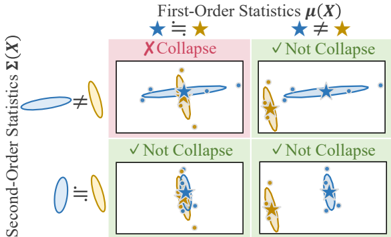
Figure 2 (원논문): 2차원 임베딩 공간에서의 개념적 분포. 가로축은 1차 통계량의 유사도(왼쪽 열은 평균이 비슷, 오른쪽 열은 평균이 다름), 세로축은 2차 통계량의 유사도(위 행은 공분산이 다름, 아래 행은 공분산이 비슷). 왼쪽 위 한 칸(빨강)만 붕괴가 일어나고, 나머지 세 칸(초록)은 붕괴가 일어나지 않는다.
Figure 2는 이 조합을 2×2 격자로 깔끔하게 정리한다. 붕괴가 일어나는 유일한 경우는 왼쪽 위, 즉 평균은 비슷한데() 공분산이 다른() 상황이다. 이 경우 2차 통계량까지 봐야 구별되는 두 분포가 mean pooling 후 같은 표현으로 뭉개진다. 나머지 세 경우는 안전하다. 평균이 다르면() 어차피 평균만으로 구별되고(단, 분산이 지나치게 크지 않은 한), 평균도 공분산도 비슷하면 두 분포는 실제로 비슷한 것이므로 같게 표현되는 게 옳다.
이 격자가 중요한 이유는, SOCM이라는 지표가 정확히 이 직관을 함수 형태로 옮긴 것이기 때문이다. "평균이 가까울수록, 그리고 공분산이 멀수록 위험하다"는 문장을 그대로 수식으로 만들면 SOCM이 된다.
4.3 SOCM의 정의
두 토큰 임베딩 리스트 에 대해 SOCM은 다음과 같이 정의된다.
여기서 는 1차 통계량 사이의 거리, 는 2차 통계량 사이의 거리다. 형태를 보면 직관이 그대로 담겨 있다. 붕괴는 평균이 가까울 때(가 작아 가 클 때) 그리고 공분산이 멀 때(가 클 때) 심해지므로, 둘의 곱 가 붕괴의 심각도를 잘 반영한다.
1차 거리 는 스케일 조정된 제곱 유클리드 거리다.
텍스트 임베딩은 관례적으로 단위 노름으로 정규화()해서 쓰기 때문에, 이 가정 아래 는 범위를 가지고, 를 곱하면 이 된다. 이 거리는 사실상 텍스트 임베딩에서 흔히 쓰는 코사인 기반 거리와 대응된다.
2차 거리 는 스케일 조정된 Bures-Wasserstein 거리(Dowson and Landau, 1982)다.
와 같은 범위로 맞추기 위해 를 가정한다. 이 가정은 4.2절에서 말한 "토큰 임베딩의 분산이 지나치게 커지지 않는" 시나리오에 해당하며, 이 조건 아래 이 되어 와 같은 스케일이 된다. 두 거리가 모두 이므로 자연히 이고, 값이 클수록 붕괴가 심하다는 뜻이다.
4.4 왜 Wasserstein 거리를 분해했는가
와 를 임의로 정한 게 아니라는 점이 이 설계의 설득력을 만든다. 이 둘은 토큰 임베딩 분포 사이의 -Wasserstein 거리 를 1차·2차 성분으로 분해한 것이다(Dowson and Landau, 1982).
각 토큰 임베딩 리스트 를 가우시안 로 특성화(characterize)했다는 점이 핵심이다. 이렇게 하면 3차 이상 모멘트는 명시적으로 구분되지 않지만, 대신 계산이 안정적이고 다룰 수 있게 된다. Wasserstein 거리는 1차뿐 아니라 고차 통계량까지 고려하는 대표적 분포 거리이고, 2.2절에서 소개한 최적 수송 기반 방법들이 바로 이 거리에 근거하고 있다. 그러니 그 방법들이 재는 "분포 간 거리"를 1차·2차로 쪼갠 로 SOCM을 만드는 건 자연스러운 선택이다. 가우시안 근사의 정당성은 부록 A에서 별도로 다룬다(6.1절에서 후술).
4.5 SOCM이 만족하는 다섯 가지 성질
라는 형태가 임의적이지 않다는 것을 보이기 위해, 저자들은 붕괴 심각도를 재는 지표가 갖춰야 할 다섯 가지 성질을 정의하고 SOCM이 이를 모두 만족함을 증명한다(증명은 부록 B).
- (a) 붕괴 극대 조건: . 평균이 완전히 같고 공분산이 최대로 다를 때만 붕괴가 최댓값 1이 된다.
- (b) 붕괴 부재 조건: . 평균이 최대로 다르거나 공분산이 완전히 같으면 붕괴는 0이다.
- (c) 에 대한 단조성: . 평균이 멀어질수록 붕괴는 약해진다.
- (d) 에 대한 단조성: . 공분산이 멀어질수록 붕괴는 심해진다.
- (e) 와 의 상호작용: . 평균이 이미 멀리 떨어져 있으면(큰 ) 공분산 차이가 붕괴에 미치는 영향이 줄어든다.
(e)가 특히 음미할 만하다. 평균만으로 이미 두 분포가 잘 구별되는 상황이라면, 공분산이 얼마나 다르든 사실 별로 중요하지 않다는 것이다. 에서 에 곱해지는 계수 가 이 상호작용을 자연스럽게 만들어낸다. 부록 B.6에서는 더 일반적으로 형태() 역시 (a)-(e)를 모두 만족하며, 채택한 형태는 인 가장 단순한 경우임을 밝힌다.
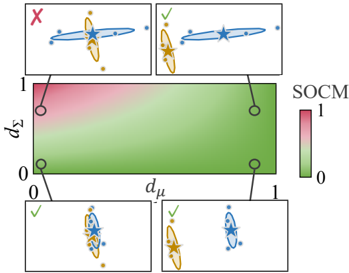
Figure 3 (원논문): 가로축 , 세로축 에 대한 SOCM 값. 왼쪽 위(평균 유사·공분산 상이)에서 SOCM이 높고(붉은색), 나머지 세 모서리에서는 낮다(초록색). 네 모서리는 Figure 2의 네 시나리오에 대응한다.
Figure 3의 히트맵은 이 성질들을 한눈에 확인시켜준다. SOCM 값이 붉게 치솟는 곳은 오직 왼쪽 위(, ) 구석뿐이고, 나머지는 완만하게 초록으로 내려앉는다. 왼쪽 아래에서 오른쪽 위로 갈수록 붉은 영역이 점점 좁아지는데, 이게 바로 성질 (e)의 시각적 표현이다. 가 커지면(오른쪽으로 갈수록) 아무리 가 커도 SOCM이 크게 오르지 않는다. Figure 2의 개념도와 Figure 3의 함수 값이 정확히 대응한다는 점에서, SOCM은 직관을 임의성 없이 수식화한 지표라 할 만하다.
5. 실험: 붕괴는 실제로 얼마나 일어나는가
SOCM이라는 자를 손에 쥐었으니, 이제 실제 모델과 텍스트에 들이대 본다. 결론부터 말하면, 대조 학습으로 파인튜닝된 인코더는 백본보다 붕괴에 확연히 강건하다.
5.1 실험 설정
절차는 단순하다. 텍스트 쌍 데이터셋 와 모델 를 준비하고, 각 텍스트에서 토큰 임베딩 리스트를 뽑은 뒤 모든 쌍에 대해 SOCM을 계산해 평균 낸다.
토큰 임베딩 리스트 정규화가 한 가지 짚어둘 디테일이다. SOCM은 을 가정하므로, 각 리스트를 평균의 노름으로 나눠 정규화한다.
이렇게 하면 가 성립해(증명은 부록 C) 정규화된 텍스트 임베딩이 단위 노름을 갖게 된다. 텍스트 임베딩을 단위 정규화해서 쓰는 실무 관행과도 일치한다.
데이터셋은 Wikipedia에서 무작위로 1,000개 텍스트를 뽑아 쌍마다 비교하여 만든 499,500개 쌍이다. MS MARCO에서 한 추가 실험도 같은 결론을 냈다(부록 E, 6.2절 참고).
모델은 mean pooling을 쓰는 대표적 인코더들을, 각각의 백본과 함께 짝지어 비교했다. BERT를 백본으로 하는 Unsupervised SimCSE(mean)·E5_base·GTE_base, MiniLM 계열의 all-MiniLM-L12-v2·E5_small·GTE_small, MPNet 계열의 all-mpnet-base-v2, 그리고 nomic-bert-2048과 nomic-embed-text-v1.5가 대상이다. 백본 모델 자체에도 SOCM을 측정해 파인튜닝 전후를 대조했다.
5.2 정량 결과
각 모델의 평균 SOCM은 다음과 같다. 백본에서 파생된 인코더는 괄호 안에 변화량을 표기했고, 값이 감소한(즉 붕괴에 더 강건해진) 경우를 볼드로 표시한다.
| Model | Avg. SOCM ↓ |
|---|---|
| BERT | 0.396 |
| → Unsup-SimCSE-mean | 0.193 (−0.203) |
| → E5_base | 0.029 (−0.367) |
| → GTE_base | 0.018 (−0.378) |
| MiniLM | 0.242 |
| → all-MiniLM-L12-v2 | 0.313 (+0.071) |
| → E5_small | 0.099 (−0.143) |
| → GTE_small | 0.055 (−0.187) |
| MPNet | 0.117 |
| → all-mpnet-base-v2 | 0.100 (−0.017) |
| nomic-bert-2048 | 0.139 |
| → nomic-embed-text-v1.5 | 0.122 (−0.017) |
Table 1 (원논문): Wikipedia 텍스트 쌍에 대한 모델별 평균 SOCM. 괄호는 백본 대비 변화량이며, 볼드는 감소를 나타낸다.
여기서 눈에 띄는 건 백본과 파인튜닝 모델의 격차다. BERT는 SOCM 0.396으로 상당히 높은데, 같은 백본에서 나온 GTE_base는 0.018까지 떨어진다. 22배가 넘는 차이다. E5_base(0.029)도 마찬가지로 거의 붕괴가 없는 수준이다. 즉 검색·임베딩용으로 대조 학습한 최신 인코더일수록 붕괴가 극적으로 줄어든다. 이것이 3장에서 예고한 핵심 발견의 정량적 증거다. 최신 인코더에는 붕괴할 2차 통계량이 애초에 남아 있지 않다.
흥미로운 예외가 all-MiniLM-L12-v2(+0.071)다. 유일하게 백본(MiniLM, 0.242)보다 SOCM이 오른 경우다. 저자들은 이를 특별히 해석하진 않지만, all-MiniLM-L12-v2가 여러 데이터셋을 섞어 distillation과 대조 학습을 결합한 특수한 학습 레시피를 쓴다는 점을 떠올리면, 모든 파인튜닝이 자동으로 토큰을 뭉치게 만드는 건 아니라는 신호로 읽을 수 있다. 반면 E5·GTE 같은 검색 특화 대조 학습은 예외 없이 SOCM을 크게 낮췄다. 붕괴 강건성이 "대조 학습"이라는 라벨보다 그 구체적 방식에 달려 있음을 시사하는 대목이다.
또 하나, 백본 중에서도 MPNet(0.117)과 nomic-bert-2048(0.139)은 처음부터 SOCM이 낮다. 모든 백본이 BERT처럼 심하게 붕괴하는 건 아니라는 뜻으로, 붕괴 강건성은 사전학습 방식에도 어느 정도 좌우된다.
5.3 정성 분석
정량 결과를 실제 임베딩 공간에서 눈으로 확인한 것이 앞서 본 Figure 1의 아래 그림이다. 저자들은 의미적으로 무관한 두 문장을 골랐다. 하나는 "Virginia Woolf set many scenes of her novel 'Night and Day' (1919) in Russell Square.", 다른 하나는 "Ghiz was born in Charlottetown, Prince Edward Island, to Atallah Joseph Ghiz, a Lebanese corner store owner, and Marguerite F. Ghiz (née McKarris)."이다. 이 쌍에 대해 BERT는 SOCM = 0.618로 매우 높고, GTE_base는 SOCM = 0.024로 매우 낮다(둘 다 축소 전 원래 768차원 공간에서 계산한 값이다).
PCA 투영(centering 없이)으로 보면 원인이 분명하다. BERT에서는 두 문장의 토큰 분포가 퍼진 정도는 다르지만 평균이 비슷하게 겹쳐 있어 붕괴가 일어난다. 반대로 GTE_base에서는 두 분포의 평균이 확실히 분리되어 있어 붕괴가 없다. 무관한 두 문장이라면 임베딩도 멀리 떨어져야 마땅한데, BERT는 그걸 못 하고 GTE_base는 해내는 것이다. 이 사례가 SOCM으로 발굴됐다는 점에서, 이 지표가 단순 통계량을 넘어 실제 문제 사례를 짚어내는 진단 도구로 쓰일 수 있음을 보여준다.
6. 파인튜닝된 인코더는 어떻게 붕괴를 피하는가
붕괴가 줄어든다는 사실을 확인했으니, 다음 질문은 자연스럽게 "어떻게?"로 넘어간다. 저자들의 답은 토큰 임베딩이 문장별로 한 점 근처에 뭉친다(concentration) 는 것이다. 이 뭉침이 트랜스포머 레이어의 어떤 구조에서 나오는지를 6장에서 이론과 실험 양쪽으로 파고든다.
6.1 이론 분석
단순화한 트랜스포머 를 상정한다. 단일 헤드 self-attention 블록을 세 부품으로 추상화한다. 입력 토큰 임베딩을 이라 할 때, 어텐션·투영 성분이 만드는 출력 는
이다. 여기서 는 softmax를 거친 어텐션 가중치 행렬, 와 는 각각 value·output 투영 행렬이다. 여기에 잔차 연결(residual connection)이 입력을 더해 를 만들고,
마지막으로 LayerNorm·FFN 등 어텐션 이후 연산을 추상화한 토큰별 변환 가 각 에 적용되어 최종 토큰 임베딩 이 된다. 분석을 위해 ()로 두고 는 고정으로 취급한다. 뭉침의 정도는 임의의 행렬 의 퍼짐(spread) 으로 잰다.
이제 토큰 뭉침이 일어나려면 세 부품이 각각 협조해야 한다. (i) 어텐션·투영이 의 퍼짐을 줄이고, (ii) 잔차 연결이 이 뭉침을 에서 보존하며, (iii) 토큰별 변환 가 퍼짐을 과도하게 키우지 않아야 한다. 각각을 세 상수로 형식화한다.
- Definition 1 (): 중심화 행렬 을 이용해, 어텐션·투영 성분()이 입력 의 퍼짐을 에서 얼마나 확대/축소하는지를 재는 상수(연산자 노름 과 Frobenius 노름 로 구성). 가 작을수록 가 더 뭉친다.
- Definition 2 (): 입력 의 퍼짐이 잔차 출력 의 스케일에 미치는 영향의 비율. 이 작을수록 에서 입력 퍼짐의 영향이 작다.
- Definition 3 (): 토큰별 변환 를 거치며 의 상대적 퍼짐이 얼마나 커지는지를 재는 최소 상수. 가 작을수록 가 퍼짐을 덜 키운다.
이 셋을 묶으면 첫 번째 정리가 나온다.
Theorem 1 (토큰 임베딩은 문장 내에서 뭉칠 수 있다). 이면 최종 토큰 임베딩의 정규화된 퍼짐은 를 만족한다(숨은 상수는 에 의존).
직관은 이렇다. 어텐션·투영을 지나며 가 뭉치고(가 포착), 잔차 출력 에서 입력 퍼짐의 영향이 작아지고(이 포착), 가 이를 흩뜨리지 않으면(가 포착), 결국 는 뭉친 상태로 남는다. 즉 인 데다 과 까지 작으면 토큰 임베딩이 문장별로 한 점에 모인다.
그리고 이 뭉침이 SOCM을 낮춘다는 것을 두 번째 정리가 잇는다.
Theorem 2 (토큰 임베딩 뭉침은 낮은 SOCM으로 이어진다). 모델 가 텍스트 에 대해 를 출력하고, 에 대해 이라 하자. 그러면 정규화된 쌍 의 SOCM은 을 만족한다.
증명의 핵심은 간단하다. 가 뭉치면 문장 안의 토큰들이 거의 동일해지므로 공분산이 작아지고, 따라서 가 작아져 SOCM도 작아진다. 두 정리를 이으면 논리 사슬이 완성된다. 특정 조건(, ·가 작음)에서 토큰이 뭉치고(Theorem 1), 토큰이 뭉치면 붕괴가 사라진다(Theorem 2). 상세 증명은 부록 F, G에 있다.
솔직히 이 이론 부분은 다소 순환적으로 읽히는 면이 있다. "토큰이 한 점으로 모이면 공분산이 0에 가까워지니 당연히 2차 통계량 붕괴가 없다"는 건 거의 정의에 가깝기 때문이다. 다만 이 논문이 기여하는 부분은 그 "당연한" 결론을 트랜스포머의 구체적 부품()과 연결해, 실제 모델에서 측정 가능한 양으로 환원했다는 점이다.
6.2 경험 분석
이론이 실제 모델에서도 성립하는지를 BERT와 GTE_base로 확인한다(다른 모델은 부록 H). 단순화된 이론과 달리, 실제 모델에서는 각 레이어의 입력 은닉 상태를 , 실제 어텐션·투영을 거친 잔차 출력을 , 출력 은닉 상태를 로 두고 대응하는 양들을 직접 계산했다.
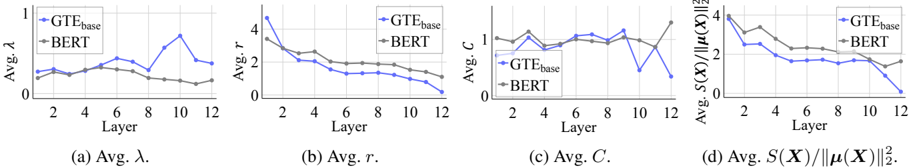
Figure 4 (원논문): (a) 평균 : 작을수록 가 입력 대비 더 뭉침. (b) 평균 : 작을수록 잔차 출력 에서 퍼짐의 영향이 작음. (c) 평균 : 작을수록 가 의 상대적 퍼짐을 덜 키움. (d) 평균 : 작을수록 문장 내 토큰 임베딩이 더 뭉침.
네 개의 패널이 이론의 각 부품을 하나씩 검증한다. (a) 는 BERT와 GTE_base 모두 전 레이어에서 1보다 작다. Theorem 1의 전제 조건 이 실제로 성립하는 것이다. 흥미롭게도 어텐션·투영 성분은 두 모델 모두에서 토큰을 뭉치게 만드는 경향이 있어, 이건 파인튜닝의 효과라기보다 트랜스포머 구조 자체의 성질로 보인다.
차이가 극명하게 갈리는 곳은 (b) 이다. GTE_base는 후반부 레이어에서 이 BERT보다 낮고, 특히 마지막 레이어에서 0에 가깝게 떨어진다. 이 작다는 건 잔차 연결에서 입력 퍼짐의 영향이 작다는 뜻이므로, 파인튜닝이 잔차 경로를 통해 뭉침을 보존하도록 모델을 바꿨다고 읽을 수 있다. (c) 는 두 모델이 대체로 비슷하지만 GTE_base가 일부 후반 레이어에서 조금 더 작다.
그 결과가 (d) , 즉 실제 뭉침의 정도다. GTE_base가 BERT보다 낮고, 특히 후반부 레이어에서 격차가 벌어진다. 이건 Theorem 1이 예측한 그대로다(이고 , 가 작으니 뭉침이 강해진다). 그리고 마지막 레이어의 강한 뭉침이 GTE_base의 낮은 SOCM으로 이어진다는 것이 Theorem 2와 부합한다. 정리하면, 어텐션·투영은 파인튜닝 전후 모두 토큰을 뭉치게 하지만, 잔차 연결에서 입력 퍼짐의 영향()이 파인튜닝 후에 더 작아지면서 최종 출력이 더 강하게 뭉치게 된다.
왜 파인튜닝 인코더에서 뭉침이 일어나는가. 저자들의 설명은 대조 학습이 mean-pooled 임베딩을 감독(supervise)한다는 데서 출발한다. 대조 학습은 개별 토큰 임베딩을 직접 감독하지 않고 오직 평균 임베딩만 감독하는데, 이 임베딩이 판별적(discriminative)으로 유지되도록 압박한다(Wang and Isola, 2020). 판별적 성질이 평균에 안정적으로 반영되는 가장 쉬운 방법 중 하나가, 토큰들이 평균 근처로 모이는 것이다. 이런 관점에서 보면 어텐션이 다른 토큰의 정보를 끌어모아 뭉침을 촉진하고, 잔차 연결이 그 뭉침을 보존하는 셈이다.
선행 연구와의 연결. 이 결과는 대조 학습이 후반부 레이어에서 문장 내 토큰 임베딩을 비등방적(anisotropic)으로 만든다는 Xiao et al.(2023)의 관찰과 일치한다. 그들의 발견에 "mean pooling 붕괴에 대한 강건성"이라는 새로운 의미를 부여한 것이 이 논문의 기여다.
7. 다운스트림 성능과의 상관
지금까지 SOCM이 낮으면 붕괴가 적다는 걸 봤다. 그런데 이게 실제로 좋은 임베딩과 관련이 있을까? MTEB(eng, v2) - 41개 태스크로 구성된 표준 텍스트 임베딩 벤치마크 - 점수와 SOCM을 비교해 이 질문에 답한다.
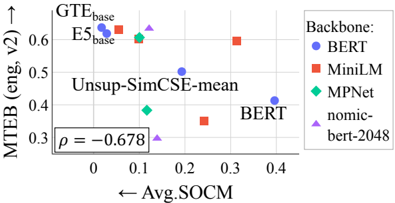
Figure 5 (원논문): 각 점이 하나의 모델. 마커 모양은 백본 종류를 나타내고, BERT 백본 모델은 이름을 표기했다. 가로축은 왼쪽으로 갈수록 SOCM이 커지는 방향( Avg. SOCM), Spearman .
Figure 5는 오른쪽 위(낮은 SOCM, 높은 MTEB)에서 왼쪽 아래(높은 SOCM, 낮은 MTEB)로 내려오는 뚜렷한 음의 추세를 보여준다. GTE_base와 E5_base가 오른쪽 위 구석에, BERT가 반대편에 놓인다. Spearman 상관은 ()로, SOCM이 낮은 모델일수록 다운스트림 성능이 높은 경향이 통계적으로 유의하게 나타난다. 붕괴에 대한 강건성이 최신 인코더가 실제 태스크에서 성공하는 한 요인일 수 있다는 것이다.
여기서 저자들은 6장에서 나온 뭉침 지표 와 SOCM 중 어느 쪽이 성능을 더 잘 설명하는지도 비교한다.
| SOCM | −0.678 |
| −0.622 |
Table 2 (원논문): MTEB(eng, v2) 점수와 SOCM, 각각의 Spearman .
SOCM()이 단순 뭉침 지표()보다 성능과 더 강하게 음의 상관을 보인다. 저자들의 해석이 설득력 있다. 는 각 문장 내부의 뭉침만 볼 뿐, 서로 다른 문장 사이의 분리(inter-text separation)는 담지 못한다. 그래서 의미적으로 다른 두 문장이 비슷한 평균을 갖더라도 이 지표는 작게 나올 수 있다. 반면 SOCM은 가 커질수록(평균이 분리될수록) 값이 작아지므로 문장 간 분리까지 반영한다. 대조 학습이 네거티브 쌍을 밀어내며 만드는 분리(Wang and Isola, 2020)를 SOCM이 포착하기 때문에, 파인튜닝이 가져오는 성능 향상을 더 잘 설명한다는 것이다. 다만 표본이 12개 모델에 불과해 이 상관을 강하게 일반화하긴 조심스럽다.
8. 부록: 추가 실험과 상세 결과
8.1 가우시안 특성화의 정당성 (부록 A)
토큰 임베딩 리스트를 가우시안으로 근사한 것은 단순한 편의가 아니라 의도된 설계다. 일반적인 비(非)가우시안 분포에서 Wasserstein 거리를 계산하려면 차원에 대해 계산량이 폭발하는 선형계획 기반 알고리즘이 필요해 고차원에서는 사실상 불가능하다(Cuturi, 2013). 가우시안 근사는 이 벽을 넘게 해준다. 게다가 1·2차 통계량만으로 계산한 -Wasserstein 거리는 임의의 분포 사이의 진짜 -Wasserstein 거리에 대한 보편적 하한(universal lower bound)을 제공한다(Cuesta-Albertos et al., 1996). 즉 가우시안 근사는 정보를 무작정 버리는 게 아니라 Wasserstein 관점에서 이론적으로 보장된 정보를 회수한다. 생성 모델 평가의 표준인 FID(Fréchet Inception Distance) 역시 같은 가우시안 근사에 기대고 있다는 점(Heusel et al., 2017)이 실용적 선례가 된다.
8.2 MS MARCO에서의 추가 결과 (부록 E)
Wikipedia 결과의 일반성을 확인하기 위해 MS MARCO에서도 같은 실험을 반복했다. MS MARCO passages에서 1,000개 텍스트를 뽑아 499,500개 쌍을 만들고, 추가로 MS MARCO hard negatives에서 50,000개 쿼리-네거티브 패시지 쌍에 대해서도 SOCM을 계산했다.
| Model | Avg. SOCM ↓ |
|---|---|
| BERT | 0.491 |
| → Unsup-SimCSE-mean | 0.269 (−0.222) |
| → E5_base | 0.043 (−0.448) |
| → GTE_base | 0.025 (−0.466) |
| MiniLM | 0.289 |
| → all-MiniLM-L12-v2 | 0.348 (+0.059) |
| → E5_small | 0.085 (−0.204) |
| → GTE_small | 0.055 (−0.234) |
| MPNet | 0.106 |
| → all-mpnet-base-v2 | 0.094 (−0.012) |
| nomic-bert-2048 | 0.110 |
| → nomic-embed-text-v1.5 | 0.133 (+0.023) |
Table 5 (원논문): MS MARCO passages 텍스트 쌍에 대한 모델별 평균 SOCM. 괄호는 백본 대비 변화량, 볼드는 감소.
| Model | Avg. SOCM ↓ |
|---|---|
| BERT | 0.480 |
| → Unsup-SimCSE-mean | 0.257 (−0.224) |
| → E5_base | 0.036 (−0.445) |
| → GTE_base | 0.017 (−0.464) |
| MiniLM | 0.340 |
| → all-MiniLM-L12-v2 | 0.330 (−0.010) |
| → E5_small | 0.087 (−0.253) |
| → GTE_small | 0.048 (−0.292) |
| MPNet | 0.129 |
| → all-mpnet-base-v2 | 0.093 (−0.036) |
| nomic-bert-2048 | 0.131 |
| → nomic-embed-text-v1.5 | 0.104 (−0.027) |
Table 6 (원논문): MS MARCO hard negatives의 쿼리-네거티브 패시지 쌍에 대한 모델별 평균 SOCM. 괄호는 백본 대비 변화량, 볼드는 감소.
전체 경향은 Wikipedia와 판박이다. E5·GTE 계열이 백본 대비 SOCM을 극적으로 낮추고(BERT → GTE_base가 passages에서 −0.466, hard negatives에서 −0.464), all-MiniLM-L12-v2만 여전히 예외적이다. 특히 눈여겨볼 점은 데이터셋에 따라 all-MiniLM-L12-v2와 nomic-embed-text-v1.5의 변화 부호가 갈린다는 것이다. all-MiniLM-L12-v2는 세 데이터셋 모두에서 백본 근처를 맴돌지만 hard negatives에서는 소폭 감소(−0.010)로 돌아서고, nomic-embed-text-v1.5는 Wikipedia·hard negatives에서는 감소하나 passages에서는 증가(+0.023)한다. 붕괴 강건성이 모델뿐 아니라 텍스트 분포에도 다소 의존한다는 뜻으로, 절대값보다 "검색 특화 대조 학습은 강하게 붕괴를 줄인다"는 방향성이 더 견고한 결론이다. 한편 hard negatives는 애초에 의미적으로 무관한(따라서 평균이 분리되기 쉬운) 쌍이라 가 커지고 SOCM이 낮게 나오는 경향이 있는데, 그럼에도 파인튜닝 효과가 일관되게 관찰된다는 점이 강건성 주장을 뒷받침한다.
8.3 구현 세부와 모델 정보 (부록 D)
전처리에서 모델·데이터셋 간 공정한 비교를 위해 query:, passage: 같은 태스크별 프리픽스를 일부러 쓰지 않았다. E5나 GTE처럼 이런 프리픽스를 활용하도록 설계된 모델에는 불리할 수 있는 선택인데, 통일된 비교를 위한 결정이다. 실험에 쓴 데이터셋의 출처는 다음과 같다.
| Dataset | URL |
|---|---|
| Wikipedia | huggingface.co/datasets/princeton-nlp/datasets-for-simcse (wiki1m_for_simcse.txt) |
| MS MARCO | huggingface.co/datasets/mteb/msmarco |
| MS MARCO Hard Negatives | huggingface.co/datasets/sentence-transformers/msmarco-co-condenser-margin-mse-sym-mnrl-mean-v1 |
| MTEB (eng, v2) | github.com/embeddings-benchmark/mteb |
Table 3 (원논문): 실험에 사용한 데이터셋의 URL.
모델은 대부분 공개 체크포인트를 그대로 썼고, Unsupervised SimCSE만 공개 체크포인트가 없어 원저자 코드로 직접 학습했다(bert-base-uncased 백본, 영어 Wikipedia, 기본 하이퍼파라미터).
| Model | model_name | Params (M) |
|---|---|---|
| BERT | bert-base-uncased | 110 |
| Unsup-SimCSE-mean | h-tomo/unsup-simcse-bert-base-uncased-mean | 110 |
| E5_base | intfloat/e5-base-v2 | 110 |
| GTE_base | thenlper/gte-base | 110 |
| MiniLM | microsoft/MiniLM-L12-H384-uncased | 30 |
| all-MiniLM-L12-v2 | sentence-transformers/all-MiniLM-L12-v2 | 30 |
| E5_small | intfloat/e5-small-v2 | 30 |
| GTE_small | thenlper/gte-small | 30 |
| MPNet | microsoft/mpnet-base | 109 |
| all-mpnet-base-v2 | sentence-transformers/all-mpnet-base-v2 | 109 |
| nomic-bert-2048 | nomic-ai/nomic-bert-2048 | 137 |
| nomic-embed-text-v1.5 | nomic-ai/nomic-embed-text-v1.5 | 137 |
Table 4 (원논문): 실험에 사용한 Hugging Face 모델과 파라미터 수(백본 기준, 단위 M).
파라미터 표에서 알 수 있듯 백본과 파인튜닝 모델은 크기가 동일하다(BERT 계열 110M, MiniLM 계열 30M). 붕괴 강건성의 차이가 모델 크기가 아니라 학습 방식에서 온다는 점을 뒷받침하는 통제다.
8.4 다른 모델들에 대한 레이어별 분석 (부록 H.1)
6.2절의 BERT-GTE_base 분석을 나머지 모델 쌍으로 확장한 결과다. 네 패널(, , , )의 해석은 Figure 4와 동일하다.
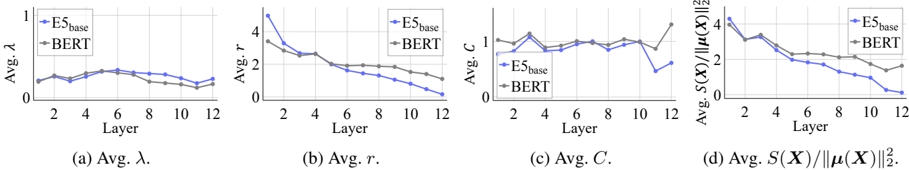
Figure 6 (원논문): BERT와 E5_base의 레이어별 , , , .
E5_base는 GTE_base와 마찬가지로 후반부에서 이 낮아지고 최종 레이어의 뭉침()이 BERT보다 강하다. Table 1에서 E5_base의 SOCM(0.029)이 매우 낮았던 것과 정확히 맞아떨어진다.
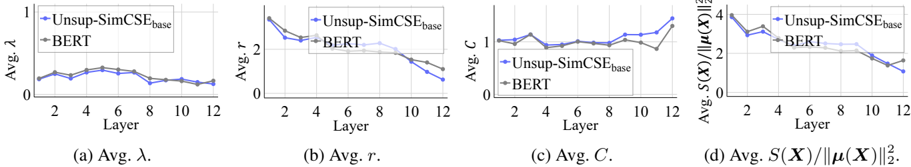
Figure 7 (원논문): BERT와 Unsupervised SimCSE의 레이어별 , , , .
Unsupervised SimCSE도 후반부 과 최종 뭉침에서 BERT보다 개선을 보이지만, 그 폭은 E5·GTE만큼 크지 않다. SimCSE의 SOCM(0.193)이 E5·GTE보다 높았던 것과 일관된다. 비지도 대조 학습이 지도 검색 학습보다 뭉침을 덜 유도한다는 신호다.
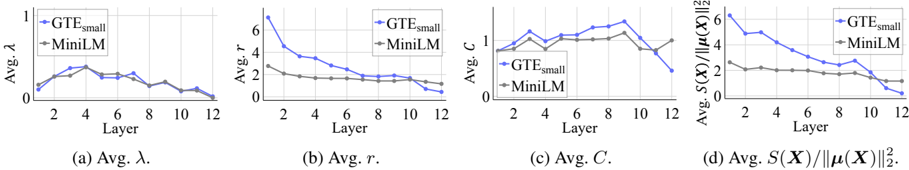
Figure 8 (원논문): MiniLM과 GTE_small의 레이어별 , , , .
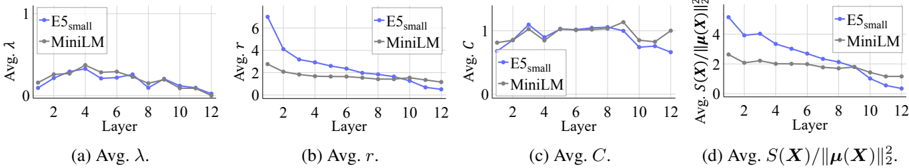
Figure 9 (원논문): MiniLM과 E5_small의 레이어별 , , , .
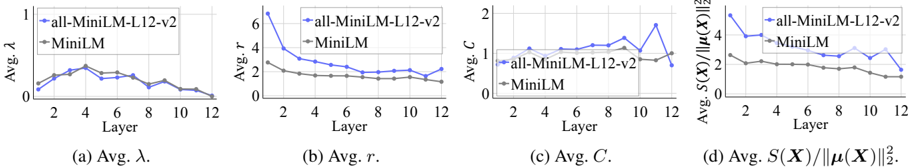
Figure 10 (원논문): MiniLM과 all-MiniLM-L12-v2의 레이어별 , , , .
MiniLM 계열에서도 GTE_small·E5_small은 후반부 뭉침이 백본보다 강해지는 반면(Figure 8, 9), all-MiniLM-L12-v2는 이 경향이 약하다(Figure 10). 이는 all-MiniLM-L12-v2가 유일하게 SOCM이 오히려 증가했던 Table 1의 예외와 정확히 대응한다. 레이어별 뭉침 분석이 SOCM의 모델 간 차이를 일관되게 설명해준다는 점에서, 6장의 이론적 메커니즘이 여러 모델에 걸쳐 재현된다고 볼 수 있다.
8.5 문장 내 토큰 임베딩의 코사인 유사도 (부록 H.2)
6장의 뭉침을, Xiao et al.(2023)이 쓴 비등방성 측정 방식과 맞추어 문장 내 토큰 임베딩 쌍의 평균 코사인 유사도 로 다시 확인한다. 값이 클수록 토큰들이 한 방향으로 뭉쳐 있다는 뜻이다.
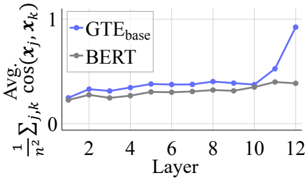
Figure 11 (원논문): BERT와 GTE_base의 레이어별 문장 내 평균 코사인 유사도(Wikipedia).
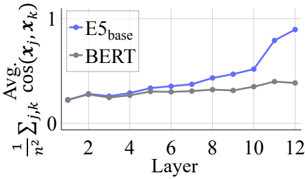
Figure 12 (원논문): BERT와 E5_base의 레이어별 문장 내 평균 코사인 유사도(Wikipedia).
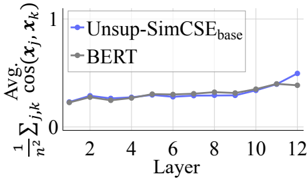
Figure 13 (원논문): BERT와 Unsupervised SimCSE의 레이어별 문장 내 평균 코사인 유사도(Wikipedia).
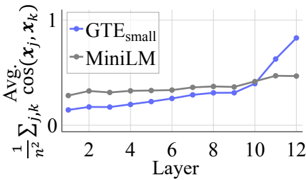
Figure 14 (원논문): MiniLM과 GTE_small의 레이어별 문장 내 평균 코사인 유사도(Wikipedia).
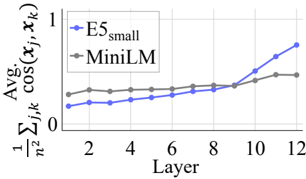
Figure 15 (원논문): MiniLM과 E5_small의 레이어별 문장 내 평균 코사인 유사도(Wikipedia).
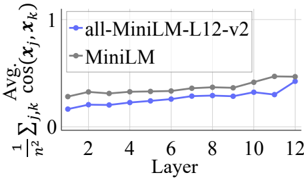
Figure 16 (원논문): MiniLM과 all-MiniLM-L12-v2의 레이어별 문장 내 평균 코사인 유사도(Wikipedia).
여섯 그림에서 공통된 패턴이 보인다. GTE·E5 같은 검색 특화 인코더(Figure 11, 12, 14, 15)는 후반부 레이어에서 코사인 유사도가 급격히 치솟아, 마지막 레이어에서 백본을 크게 앞지른다. GTE_base(Figure 11)는 최종 레이어에서 거의 0.9 이상까지 오른다. 반면 백본은 대체로 0.5 근처에서 완만하게 유지된다. Unsupervised SimCSE(Figure 13)는 상승 폭이 작고, all-MiniLM-L12-v2(Figure 16)는 오히려 백본보다 낮은 구간도 있다. 이 순서(GTE·E5 > SimCSE > all-MiniLM)는 SOCM 감소 폭의 순서와 그대로 겹친다. 문장 내 토큰 뭉침이 클수록 SOCM이 낮다는 6장의 주장을, 독립적인 측정 방식으로 다시 확인해주는 셈이다.
8.6 와 의 분해 분석 (부록 I)
SOCM이 모델마다 다른 이유를 이해하기 위해, 구성 요소인 와 를 따로 뜯어본다.
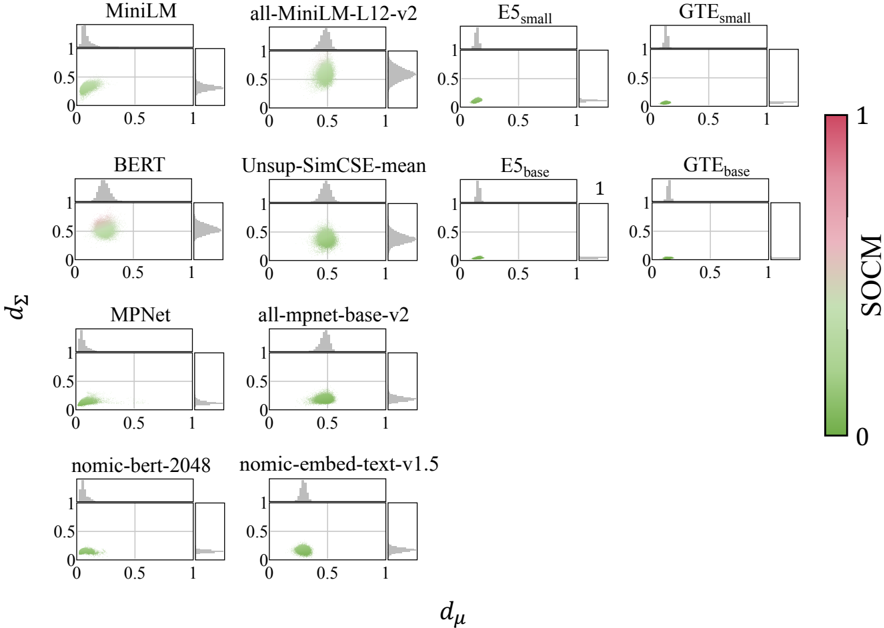
Figure 17 (원논문): Wikipedia에서 각 모델의 텍스트 쌍에 대한 (가로)와 (세로) 산점도. 각 점은 텍스트 쌍이고 색은 SOCM(초록=낮음, 빨강=높음). 위·오른쪽 히스토그램은 각 축의 분포.
12개 모델의 산점도를 나란히 놓으면 파인튜닝의 효과가 한눈에 들어온다. E5_base, GTE_base, E5_small, GTE_small 같은 검색 특화 인코더는 점 구름이 세로축() 아래쪽에 바짝 붙어 있다. 공분산 거리가 거의 0이라는 뜻이다. 반면 BERT나 MiniLM은 가 0.5 근처까지 넓게 퍼져 있어, 색도 붉은 쪽(높은 SOCM)으로 물든 점이 많다. 저자들의 분석대로, 토큰이 뭉치면 각 문장의 공분산 자체가 작아지고, 라는 부등식에 의해 두 공분산이 서로 아무리 달라도 가 작게 눌린다. 즉 SOCM 감소의 주된 동력은 의 증가(평균 분리)보다 의 소멸(공분산 축소)이며, 이것이 6장의 뭉침 메커니즘과 정확히 맞물린다.
8.7 정규화 아래에서의 트레이스 상한 (부록 J)
SOCM 정의에서 가정한 가 실제로 언제 성립하는지를 증명하는 부분이다. 두 가정을 둔다. Assumption 1은 LayerNorm 파라미터가 모든 차원에서 공유된다는 것(, )으로, 트랜스포머의 전형적 초기화()를 반영한다. Assumption 2는 문장 내 토큰 임베딩이 충분히 비슷하다는 것으로, 구체적으로 문장 내 평균 코사인 유사도가 을 만족한다는 조건이다. 이 가정은 문맥화된 임베딩이 비등방적이라는 경험적 관찰(Ethayarajh, 2019)에 근거한다. 이 두 가정 아래, 정규화된 트레이스 표현이 에 대해 단조 감소하며 에서 2로 수렴함을 보여 가 성립한다. SOCM의 스케일 가정이 근거 없는 편의가 아니라 실제 아키텍처 조건에서 유도된다는 점을 짚어둔 대목이다.
8.8 계산 자원 (부록 K)
모든 실험은 NVIDIA RTX 6000 Ada 한 장으로 수행했다. 5장의 SOCM 계산은 모델당 약 2시간, 7장의 MTEB(eng, v2) 분석은 모델당 약 6시간이 걸렸다. 그리고 논문 준비에 Claude·ChatGPT를 코드 디버깅, 문장 다듬기, 시각화 생성 등 기술적 보조로만 활용했고 연구 아이디어와 해석은 전적으로 저자들의 것이라고 부록 L에서 밝힌다.
9. 강점과 한계
강점
- 문제 설정의 참신함: "mean pooling이 잘 작동한다"를 옹호가 아니라 "붕괴할 2차 통계량이 남아 있지 않아서"라는 반전된 논리로 설명한 점이 신선하다. 널리 쓰이지만 원리적으로 정당화된 적 없던 관행에 정보 이론적 렌즈를 댔다.
- 원리적으로 설계된 지표: SOCM이 Wasserstein 거리 분해에서 유도되고, 다섯 가지 성질을 만족하도록 형태가 검증됐다(Figure 3, 부록 B). 임의로 고른 휴리스틱이 아니라는 점에서 후속 연구가 신뢰하고 쓸 만하다.
- 이론과 경험의 맞물림: Theorem 1·2로 "토큰 뭉침 → 낮은 SOCM"의 사슬을 세우고, Figure 4와 부록 H에서 실제 모델의 를 측정해 이론의 전제가 성립함을 보였다. 두 축이 서로를 지지한다.
- 일관된 재현성: Wikipedia, MS MARCO passages, MS MARCO hard negatives 세 데이터셋(Table 1, 5, 6)에서 같은 경향이 반복되고, 백본과 파인튜닝 모델의 크기를 동일하게 통제(Table 4)해 결론의 견고함을 높였다.
- 선행 연구와의 연결: Xiao et al.(2023)의 비등방성 관찰에 "붕괴 강건성"이라는 새 의미를 부여하며, 흩어져 있던 관찰들을 하나의 서사로 묶었다.
한계 및 아쉬운 점
- 2차 통계량으로의 제한: 토큰 임베딩 리스트를 가우시안으로 근사하므로 3차 이상 모멘트는 다루지 못한다. 저자들도 인정하듯, 실제 분포에 고차 모멘트 정보가 있다면 SOCM이 그것까지 잡아내진 못한다.
- 거의 정의에 가까운 이론: 6장의 "토큰이 뭉치면 공분산이 작아지므로 붕괴가 없다"는 논리는 다소 순환적이다. 정말 어려운 질문 - "왜 대조 학습이 애초에 토큰을 뭉치게 만드는가" - 는 여전히 열려 있고, 저자들도 이를 future work로 남겼다.
- 작은 상관 표본: 7장의 다운스트림 상관()이 12개 모델에 기반한다. 로 유의하긴 하나, 표본이 작아 인과는커녕 상관의 일반화도 조심스럽다.
- 가정의 취약성: SOCM은 과 를 전제한다. 부록 J가 특정 아키텍처 조건에서 이를 정당화하지만, 2차 모멘트가 아주 큰 경우엔 지표가 제대로 작동하지 않을 수 있다.
- all-MiniLM 예외에 대한 침묵: 유일하게 SOCM이 증가한 all-MiniLM-L12-v2(Table 1, 5)를 저자들이 깊이 파고들지 않는다. 이 반례를 분석했다면 "어떤 대조 학습이 붕괴를 줄이는가"에 대한 이해가 한층 정밀해졌을 것이다.
- 분석 도구에 머무름: SOCM을 학습 정규화 항으로 넣거나 인코더 개발에 활용하는 실용적 응용은 제안만 되고 실험되지 않았다. 진단 도구로서의 가치는 보였지만, "그래서 이걸로 더 좋은 모델을 만들 수 있는가"는 아직 미지수다.
- 텍스트 임베딩으로 국한: LLM 기반 생성·추론에서의 mean pooling(예: 컨텍스트 압축, Feldman and Artzi, 2025)은 다루지 않는다. 요즘 mean pooling이 LLM 컨텍스트 압축에서도 쓰이는 만큼, 이쪽으로의 확장이 자연스러운 다음 걸음이다.
10. 마치며
이 논문의 진짜 매력은 결론보다 질문의 뒤집기에 있다. "정보를 버리는 mean pooling이 왜 문제가 안 되는가"를 물었고, 답은 "버릴 정보가 남아 있지 않도록 대조 학습이 토큰을 한 점에 뭉쳐놓기 때문"이었다. mean pooling의 성공이 pooling 자체의 미덕이 아니라, 그 앞단 인코더가 만들어낸 표현 기하학의 산물이라는 것이다. 이 관점은 임베딩을 "어떻게 집계할까"에서 "인코더가 어떤 분포를 만드는가"로 시선을 옮기게 한다.
방법론적으로는 SOCM이라는 측정 가능하고 원리적인 지표를 남겼다는 점이 실질적 기여다. Wasserstein 거리의 1·2차 분해에서 유도되고 다섯 성질로 검증된 이 지표는, 붕괴 진단뿐 아니라 문장 간 분리와 문장 내 뭉침을 동시에 포착하는 도구로 쓸 수 있다. 다운스트림 성능과의 음의 상관(Table 2)은 이 지표가 단순한 이론적 장난감이 아님을 시사한다.
물론 남은 숙제도 뚜렷하다. 대조 학습이 왜 뭉침을 유도하는지에 대한 온전한 수학적 설명, SOCM을 학습 목표로 편입했을 때의 실효성, LLM 생성으로의 확장은 모두 후속 연구의 몫이다. 그럼에도 "seemingly coarse"해 보이던 mean pooling에 명확한 이유를 붙였다는 것만으로, 이 논문은 텍스트 임베딩을 다루는 사람이라면 한 번쯤 짚고 넘어갈 만한 관점을 제공한다. 다음에 무심코 mean_pooling(token_embeddings)을 호출할 때, 그 한 줄 뒤에 어떤 기하학이 깔려 있는지 떠올리게 만든다는 점에서 말이다.
References
- Hara, Kurita, Imaizumi, Inui, Yokoi. 2026. "Why Mean Pooling Works: Quantifying Second-Order Collapse in Text Embeddings." arXiv:2604.27398.
- Reimers and Gurevych. 2019. "Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks." (EMNLP-IJCNLP)
- Gao, Yao, Chen. 2021. "SimCSE: Simple Contrastive Learning of Sentence Embeddings." (EMNLP)
- Wang et al. 2024. "Text Embeddings by Weakly-Supervised Contrastive Pre-training." (E5)
- Li et al. 2023. "Towards General Text Embeddings with Multi-stage Contrastive Learning." (GTE)
- Nussbaum et al. 2025. "Nomic Embed: Training a Reproducible Long Context Text Embedder." (TMLR)
- Dowson and Landau. 1982. "The Fréchet distance between multivariate normal distributions." (J. Multivariate Analysis)
- Cuesta-Albertos, Matrán-Bea, Tuero-Díaz. 1996. "On lower bounds for the L2-Wasserstein metric in a Hilbert space."
- Heusel et al. 2017. "GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium." (FID)
- Xiao, Long, Al Moubayed. 2023. "On Isotropy, Contextualization and Learning Dynamics of Contrastive-based Sentence Representation Learning." (Findings of ACL)
- Wang and Isola. 2020. "Understanding Contrastive Representation Learning through Alignment and Uniformity on the Hypersphere." (ICML)
- Ethayarajh. 2019. "How Contextual are Contextualized Word Representations?" (EMNLP-IJCNLP)
- Enevoldsen et al. 2025. "MMTEB: Massive Multilingual Text Embedding Benchmark." (ICLR)
- Yoda et al. 2024. "Sentence Representations via Gaussian Embedding." (GaussCSE, EACL)
- Yokoi et al. 2020. "Word Rotator's Distance." (EMNLP)
- Khattab and Zaharia. 2020. "ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT." (SIGIR)