논문 리뷰
논문 리뷰: On the Robustness of LLM-Based Dense Retrievers: A Systematic Analysis of Generalizability and Stability
오픈소스 LLM 기반 dense retriever 6종을 BM25, 인코더 모델 2종과 함께 30개 데이터셋, 5가지 쿼리 변형, 2가지 코퍼스 포이즈닝 위협 모델 위에서 시험해, "리더보드 상위 LLM 리트리버는 실제로 얼마나 강건한가"를 일반화성(generalizability)과 안정성(stability) 두 축으로 해부한 체계적 분석 논문.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | On the Robustness of LLM-Based Dense Retrievers: A Systematic Analysis of Generalizability and Stability |
| 저자 | Yongkang Li, Panagiotis Eustratiadis, Evangelos Kanoulas (University of Amsterdam), Yixing Fan (Chinese Academy of Sciences) |
| 학회/저널 | arXiv preprint (2026년 4월), ACM TOIS 투고 원고 (33쪽) |
| 논문 링크 | arXiv:2604.16576 |
| 코드 | github.com/liyongkang123/Robust_LLM_Retriever_Eval |
1. 들어가며
지금 BEIR나 BRIGHT 리더보드 상단을 보면 거의 전부가 디코더 전용(decoder-only) LLM을 백본으로 쓰는 임베딩 모델이다. Qwen3-Embedding, Linq-Embed-Mistral, gte-Qwen2, 그리고 추론 특화 리트리버인 ReasonIR, DIVER, ReasonEmbed까지. BERT 계열 인코더로 DPR, Contriever를 학습하던 시절과 비교하면 nDCG@10이 수십 점씩 오른 데이터셋도 흔하다.
문제는 리더보드 점수가 "깨끗한 테스트셋에서의 평균 성능"이라는 점이다. 실제 서비스에서 쿼리는 오타투성이고, 같은 질문을 사람마다 다르게 쓰며, RAG 파이프라인의 검색 코퍼스에는 누군가 악의적으로 문서를 심어 둘 수도 있다. 파라미터가 수십 배 커지고 사전학습 데이터가 웹 규모로 늘어난 LLM 리트리버가 이런 상황에서도 더 믿을 만한지, 아니면 평균 점수만 오른 것인지는 생각보다 제대로 검증된 적이 없다.
이 논문은 그 질문을 정면으로 다룬다. 저자들은 강건성(robustness)을 두 갈래로 나눈다. 하나는 일반화성(generalizability)으로, 태스크, 쿼리 유형, 코퍼스 출처가 달라져도 성능이 유지되는지를 본다. 다른 하나는 안정성(stability)으로, 쿼리에 오타나 패러프레이즈 같은 교란이 들어가거나 코퍼스에 적대적 문서가 주입될 때 얼마나 버티는지를 본다. 여기에 "무엇이 강건성을 예측하는가"라는 세 번째 질문을 얹어, 임베딩 공간의 등방성(isotropy), 모델 크기, 스펙트럴 노름(spectral norm)과의 관계를 분석한다.
저자진을 보면 문서 측 실험이 왜 이렇게 촘촘한지 짐작이 간다. Yongkang Li와 Kanoulas 그룹은 ECIR 2025에서 HotFlip 기반 코퍼스 포이즈닝 재현 연구를, SIGIR 2025에서 연속 공간 비지도 포이즈닝 공격을 발표한 팀이다. 공격 파이프라인을 직접 만들어 본 사람들이 방어 쪽 평가를 설계한 셈이다.
미리 결론의 윤곽을 말하면 이렇다. 범용 instruction-augmented LLM 리트리버(Qwen3, Linq, GTE)는 일반화와 오타 내성, 화이트박스 포이즈닝 내성 모두에서 인코더 모델보다 낫다. 그러나 추론 특화 모델은 BRIGHT에서 얻은 이득을 다른 곳에서 반납하는 "전문화 세금(specialization tax)"을 낸다. 동의어 치환(synonymizing)은 모델 계열과 무관하게 모두를 흔들고, 임베딩의 각도 균일성(angular uniformity)은 어휘 수준 교란에 대한 취약성을 꽤 잘 예측하지만, 그것을 직접 학습 목표로 넣어도 강건성은 좋아지지 않았다.
2. 기존 연구의 한계
2.1 검색 패러다임: Sparse에서 LLM 기반 Dense까지
정보 검색은 오랫동안 TF-IDF, BM25 같은 희소(sparse) 어휘 매칭이 지배했다. 효율적이고 해석 가능하지만, 의미는 같은데 단어가 다른 쿼리와 문서를 놓치는 어휘 불일치(vocabulary mismatch) 문제가 고질적이었다. SPLADE 같은 학습형 희소 모델이 이를 부분적으로 완화했고, 결국 BERT 기반 bi-encoder가 쿼리와 문서를 같은 벡터 공간에 매핑하는 dense retrieval 패러다임이 자리를 잡았다. DPR이 대조 학습(contrastive learning)의 효과를 보여준 뒤 사전학습 강화(Contriever, RetroMAE), 지식 증류(TAS-B, DRAGON), 다국어 확장(BGE-M3)이 뒤따랐다.
LLaMA, Mistral, Qwen 같은 디코더 LLM이 등장하면서 RepLLaMA, LLM2Vec처럼 LLM을 dense 인코더로 바꾸는 시도가 이어졌다. 인과적 어텐션(causal attention) 구조상 보통 마지막 토큰 풀링(last-token pooling)을 쓴다. 그다음 세대가 Linq, GTE, NV-Retriever, Qwen3-Embedding 같은 instruction-augmented 리트리버로, 쿼리 앞에 태스크 설명을 붙여 태스크 간 전이를 끌어올렸다. 최근에는 한 번 더 분화가 일어나 ReasonIR(chain-of-thought 트레이스로 학습), DIVER(다단계 학습), ReasonEmbed(Qwen3 백본에 논리적 의존 관계 모델링 추가) 같은 추론 특화 리트리버가 BRIGHT에서 강세를 보이고 있다.
저자들이 던지는 의문은 여기서 출발한다. 추론 벤치마크에서의 개선이 더 넓은 검색 조건으로 옮겨 가는가? ColBERT 계열 멀티벡터 late interaction 모델은 다른 패러다임이라 이번 분석에서 제외했고, 단일 벡터 임베딩 검색의 이론적 한계를 지적한 Weller et al. (2025)도 언급하면서 범위를 단일 벡터 LLM 리트리버로 한정했다.
2.2 일반화 연구: 벤치마크 단위 비교에 머물다
BEIR는 초기 BERT 기반 dense retriever가 제로샷 OOD 평가에서 BM25보다 못한 경우가 많다는 사실을 드러낸 벤치마크다. BRIGHT는 추론 집약적 검색을 내세워 어휘 기반과 신경망 기반의 격차가 좁아지는 영역을 보여줬다. Wu et al. (2023)과 Liu et al. (2025)은 성능 분산, OOD 일반화, 적대적 내성을 묶은 개념적 틀을 제시했다.
하지만 실제 실증 연구는 파편화되어 있다. 어떤 연구는 벤치마크 단위 전이만, 어떤 연구는 적대적 취약성만 보고, 대부분은 인코더 기반 리트리버를 대상으로 한다. 특히 "어떤 태스크 유형에서, 어떤 쿼리 의도에서, 어떤 코퍼스 출처에서" 성능이 흔들리는지를 요인(factor) 단위로 쪼개 본 연구는 드물다. 데이터셋마다 쿼리 수가 수십 개에서 만 개까지 차이 나는 불균형 상황에서 단순 평균을 내면 모델 능력과 데이터셋 난이도가 뒤섞인다는 통계적 문제도 방치되어 왔다. IR 평가에서 ANOVA가 자주 쓰이지만, 불균형 설계와 쿼리가 데이터셋에 중첩(nested)된 구조는 ANOVA의 가정과 맞지 않는다.
2.3 안정성 연구: 쿼리 쪽과 문서 쪽이 따로 놀았다
쿼리 측에서는 Zhuang & Zuccon (2021, 2022)이 BERT 기반 dense retriever가 오타에 민감하다는 것을 보였고, Sidiropoulos & Kanoulas가 듀얼 인코더 전반의 오타 취약성과 개선 방법을 다뤘다. Penha et al. (2022)은 오타(misspelling), 어순 변경(reordering), 동의어 치환(synonymizing), 패러프레이즈(paraphrasing), 자연화(naturalizing) 다섯 가지 쿼리 변형을 체계화해 의미가 같은 재구성만으로도 성능이 크게 떨어진다는 것을 보였다. 가장 가까운 선행 연구는 Hagen et al. (2024)으로, 초기 LLM 기반 모델을 포함해 쿼리 변형 강건성을 재검토했지만 쿼리 측 교란과 소규모 벤치마크에 한정되었다.
문서 측에서는 코퍼스 포이즈닝(corpus poisoning)이 대표적 위협이다. Zhong et al. (2023)은 공들여 만든 적대적 문서를 인덱스에 주입해 특정 쿼리의 검색 결과를 가로챌 수 있음을 보였다. HotFlip 같은 토큰 단위 그래디언트 탐색, 이산 토큰 탐색 없이 연속 임베딩 공간에서 최적화하는 방법(Li et al., 2025), 멀티뷰 대조 학습 기반 블랙박스 공격(Liu et al., 2023), 신경망 랭커에 대한 PRADA, Order-Disorder, 그리고 dense 검색 전반의 취약성을 다룬 GASLITE까지 공격 연구는 풍부하다. 그러나 대부분 BERT 기반 리트리버가 대상이었고, LLM 인코더에 대한 비교 증거는 부족하다. LLM 기반 relevance judge가 콘텐츠 주입에 속는다는 연구(Tamber & Lin, 2025), 악의적 쿼리 하에서의 리트리버 행동(BehnamGhader et al., 2025)처럼 검색 파이프라인 주변 컴포넌트의 취약성도 보고되었다.
저자들은 기존 연구의 공백을 세 가지로 정리한다. 일반화 연구가 요인 단위 변동을 보지 않았다는 점, 안정성 연구가 쿼리 측과 문서 측을 한 실험 틀 안에서 평가하지 않았다는 점, 그리고 최신 LLM 리트리버를 직접 겨냥한 연구(강건성 스케일링을 다룬 Liu et al., 2025 포함)가 범위 면에서 제한적이라는 점이다.
2.4 임베딩 기하학: 등방성은 강건성의 신호인가
Ethayarajh (2019)는 사전학습 언어 모델의 문맥 표현이 고차원 공간의 좁은 원뿔(narrow cone)에 몰려 있다는 이방성(anisotropy) 현상을 보고했다. 이후 평균 쌍별 코사인 유사도, 주성분 기반 분석, IsoScore 같은 진단 지표가 제안되었고, 등방성이 표현 품질과 연결된다는 주장이 이어졌다. 다만 최근에는 이방성이 정말 해로운지, 다운스트림 성능과 인과 관계가 있는지에 대해 반론도 적지 않다.
Dense retrieval에서 이방성은 임베딩 공간의 유효 용량을 줄여 교란에 취약하게 만들 수 있다는 가설이 자연스럽다. 벡터들이 한쪽으로 몰려 있으면 작은 입력 변화에도 이웃 관계가 쉽게 뒤바뀔 수 있기 때문이다. 그런데 이 가설을 최신 LLM 리트리버의 강건성과 직접 연결해 검증한 연구는 거의 없었다.
3. 핵심 아이디어
이 논문은 새로운 모델이나 학습법을 제안하지 않는다. 기여는 평가 설계 자체에 있고, 세 가지 선택이 전체를 떠받친다.
첫째, 강건성을 하나의 숫자로 뭉치지 않고 두 축으로 분해한다. 일반화성은 "다른 조건에서도 잘하나", 안정성은 "같은 조건에서 흔들어도 버티나"를 묻는다. 안정성은 다시 쿼리 측(자연스러운 사용자 변형)과 문서 측(악의적 코퍼스 조작)으로 나뉜다. 건강검진에 비유하면 평소 체력(평균 점수)만 재는 게 아니라, 환경을 바꿔 보고(일반화) 스트레스 테스트도 걸어 보는(안정성) 셈이다.
둘째, 일반화 분석에 선형 혼합효과 모델(Linear Mixed-Effects Model, LMM)을 도입한다. 데이터셋 난이도를 랜덤 효과로 흡수해 "평균 난이도의 데이터셋이라면 이 모델은 이 조건에서 몇 점을 낼까"를 추정하는 것이 목표다. 단순 평균이 데이터셋 크기와 난이도에 휘둘리는 문제를 통계적으로 다루겠다는 의도다.
셋째, 관찰된 강건성 차이를 모델 내재 속성(등방성, 크기, 스펙트럴 노름)과 연결하고, 상관관계에서 멈추지 않고 개입 실험(intervention)으로 인과성을 찔러 본다. 결과적으로 이 개입이 부정적 결과를 냈다는 점이 오히려 이 논문을 정직하게 만드는 대목이다.
4. 평가 프레임워크와 실험 설정
4.1 Dense Retrieval 정식화
쿼리 와 코퍼스 의 문서 가 주어지면, bi-encoder 가 둘을 공통의 차원 공간으로 매핑한다.
풀링은 모델마다 다르다. BERT 계열은 [CLS] 또는 평균 풀링, 디코더 LLM은 인과적 어텐션 때문에 마지막 토큰 풀링이나 평균 풀링을 쓴다. 저자들은 각 모델의 기본 설정을 그대로 쓰고 풀링을 실험 변수로 삼지 않았다. instruction-augmented 모델은 쿼리 앞에 태스크 설명을 붙인다. 관련도는 와 의 코사인 유사도 또는 내적으로 계산하며, 이 문서 임베딩이 RQ3의 기하 분석에도 그대로 쓰인다. 모든 모델은 공식 체크포인트를 사용하고, 벤치마크 규모가 감당할 만해서 ANN 대신 FAISS 정확 검색(exact search)을 썼다.
4.2 선형 혼합효과 모델 (LMM)
일반화 분석의 통계적 뼈대다. ANOVA가 IR 평가에서 요인 효과 분해에 널리 쓰이지만, 이 논문의 데이터는 (1) 데이터셋마다 쿼리 수가 크게 달라 심하게 불균형하고, (2) 쿼리가 데이터셋 안에 중첩되어 관측치 간 독립성이 깨진다. 그래서 계층 구조에서 오는 무작위 변동을 명시적으로 모델링하는 LMM을 쓴다. 태스크 유형, 쿼리 유형, 코퍼스 출처 유형 각각에 대해 하나씩, 총 세 개의 LMM을 같은 형태로 적합한다.
각 항의 의미는 다음과 같다.
- : 모델 가 데이터셋 의 쿼리 에서 얻은 쿼리 단위 nDCG@10
- : 전역 절편
- : 모델 정체성(model identity)의 주효과
- : 요인 수준 (예: "Fact Checking", "FACTOID", "Wikipedia")의 주효과
- : 모델과 요인 수준의 상호작용. "이 모델은 이 조건에서 유독 강하다/약하다"를 포착하는 항이다
- : 데이터셋 의 랜덤 절편으로 데이터셋 고유 난이도를 흡수한다
- : 데이터셋 에 중첩된 쿼리 의 랜덤 절편. 같은 쿼리를 모든 모델이 풀기 때문에 모델 간 공유되며, 데이터셋 평균을 넘어서는 쿼리 고유 난이도를 잡는다
- : 잔차
랜덤 효과의 분포 가정은 다음과 같다.
요인 수준 의 정의는 분석마다 다르다. 쿼리 유형은 쿼리 단위로 정해지고, 태스크 유형과 코퍼스 출처는 쿼리가 속한 데이터셋에 의해 정해진다.
적합된 모델에서 각 모델-요인 조합의 추정 주변 평균(Estimated Marginal Means, EMM)을 뽑는다. 고정효과 부분만 평가하고 랜덤 효과는 평균(0)으로 둔 값이다.
저자들의 표현을 빌리면 EMM은 "평균 난이도의 데이터셋에서 이 리트리버가 이 조건일 때 낼 성능"에 대한 답이다. 고정효과의 유의성은 Satterthwaite 자유도 근사를 쓴 Type III F-검정으로 판단한다(R의 lmerTest, emmeans 패키지). 이 설계가 실제로 무엇을 계산하는지는 5.4절에서 숫자로 따져 본다.
4.3 데이터셋
MS MARCO(도메인 내 패시지 검색), BEIR(이질적 제로샷 전이), BRIGHT(추론 집약 검색), BrowseComp-Plus(길고 노이즈 많은 웹 문서)의 네 벤치마크에서 30개 데이터셋을 모았다.
| Dataset | Task | Corpus Source | #Corpus | #Query | Avg. D/Q | Avg. Query Len. | Avg. Doc Len. |
|---|---|---|---|---|---|---|---|
| MS MARCO (Custom Research License, Non-Commercial) | |||||||
| MS MARCO | Passage Retrieval | General Web | 8,841,823 | 6,980 | 1.1 | 5.96 | 55.98 |
| TREC DL 19 | Passage Retrieval | General Web | 8,841,823 | 43 | 95.4 | 5.96 | 55.98 |
| TREC DL 20 | Passage Retrieval | General Web | 8,841,823 | 54 | 66.8 | 5.96 | 55.98 |
| BEIR (Various Research Licenses) | |||||||
| TREC-COVID | Bio-Medical Retrieval | Scientific Paper | 171,332 | 50 | 493.5 | 10.6 | 160.8 |
| NFCorpus | Bio-Medical Retrieval | Scientific Paper | 3,633 | 323 | 38.2 | 3.3 | 232.3 |
| NQ | Question Answering | Wikipedia | 2,681,468 | 3,452 | 1.2 | 9.2 | 78.9 |
| HotpotQA | Question Answering | Wikipedia | 5,233,329 | 7,405 | 2.0 | 17.6 | 46.3 |
| FiQA | Question Answering | Online Community | 57,638 | 648 | 2.6 | 10.8 | 132.3 |
| Quora | Duplicate Question Retrieval | Online Community | 522,931 | 10,000 | 1.6 | 9.5 | 11.4 |
| DBPedia | Entity Retrieval | Wikipedia | 4,635,922 | 400 | 38.2 | 5.4 | 49.7 |
| SCIDOCS | Citation Prediction | Scientific Paper | 25,657 | 1,000 | 4.9 | 9.4 | 176.2 |
| SciFact | Fact Checking | Scientific Paper | 5,183 | 300 | 1.1 | 12.4 | 213.6 |
| FEVER | Fact Checking | Wikipedia | 5,416,568 | 6,666 | 1.2 | 8.1 | 84.8 |
| Climate-FEVER | Fact Checking | Wikipedia | 5,416,593 | 1,535 | 3.0 | 20.1 | 84.8 |
| ArguAna | Argument Retrieval | Domain KB | 8,674 | 1,406 | 1.0 | 193.0 | 166.8 |
| Touché-2020 | Argument Retrieval | Domain KB | 382,545 | 49 | 19.0 | 6.6 | 292.4 |
| BRIGHT (CC-BY-4.0) | |||||||
| Biology | StackExchange Post Retrieval | Online Community | 57,359 | 103 | 3.6 | 115.2 | 83.6 |
| Earth Science | StackExchange Post Retrieval | Online Community | 121,249 | 116 | 5.3 | 109.5 | 132.6 |
| Economics | StackExchange Post Retrieval | Online Community | 50,220 | 103 | 8.0 | 181.5 | 120.2 |
| Psychology | StackExchange Post Retrieval | Online Community | 52,835 | 101 | 7.3 | 149.6 | 118.2 |
| Robotics | StackExchange Post Retrieval | Online Community | 61,961 | 101 | 5.5 | 818.9 | 121.0 |
| Stack Overflow | StackExchange Post Retrieval | Online Community | 107,081 | 117 | 7.0 | 478.3 | 704.7 |
| Sustainable Living | StackExchange Post Retrieval | Online Community | 60,792 | 108 | 5.6 | 148.5 | 107.9 |
| LeetCode | Code Retrieval | Domain KB | 413,932 | 142 | 1.8 | 497.5 | 482.6 |
| Pony | Code Retrieval | Domain KB | 7,894 | 112 | 22.5 | 102.6 | 98.3 |
| AoPS | Theorem Retrieval | Domain KB | 188,002 | 111 | 4.7 | 117.1 | 250.5 |
| TheoremQA-Q | Theorem Retrieval | Domain KB | 188,002 | 194 | 3.2 | 93.4 | 250.5 |
| TheoremQA-T | Theorem Retrieval | Domain KB | 23,839 | 76 | 2.0 | 91.7 | 354.8 |
| BrowseComp-Plus (CC-BY 4.0) | |||||||
| Evidence | Question Answering | General Web | 100,195 | 830 | 6.1 | 96.5 | 5179.2 |
| Gold | Question Answering | General Web | 100,195 | 830 | 2.9 | 96.5 | 5179.2 |
Table 1 (원논문): 사용 데이터셋 통계. Domain KB는 도메인 특화 지식 베이스, Avg. D/Q는 쿼리당 평균 관련 문서 수, 길이는 단어 수 기준. 학습셋은 제외하고 평가(test/dev) 분할만 집계했다.
이 표에서 가장 먼저 봐야 할 열은 #Query다. Quora 10,000개, HotpotQA 7,405개, MS MARCO dev 6,980개, FEVER 6,666개가 상위권인 반면, Touché-2020은 49개, TREC-COVID는 50개, TREC DL 19는 43개에 불과하다. 30개 데이터셋 전체 쿼리는 약 4만 3천 개인데, 상위 4개 데이터셋이 그중 70% 이상(약 3만 1천 개)을 차지한다. 이 불균형이 LMM 도입의 명분이자, 뒤에서 다룰 EMM 해석의 함정이기도 하다.
쿼리 길이 분포도 극단적이다. MS MARCO는 평균 6단어의 키워드형 쿼리인 반면 BRIGHT Robotics는 819단어, LeetCode는 498단어의 긴 문제 서술이다. BrowseComp-Plus는 문서 평균 길이가 5천 단어를 넘는다. 쿼리 길이는 RQ2에서 교란 효과를 해석하는 열쇠로 다시 등장한다.
4.4 평가 대상 모델
세 계열 9개 모델을 공통 풀로 쓴다. 어휘 기반 BM25, 인코더 전용 dense 모델 2종(Contriever, BGE-M3), 디코더 LLM 기반 6종이다. LLM 기반은 다시 범용 instruction-augmented(Qwen3, Linq, GTE)와 추론 특화(ReasonIR, DIVER, ReasonEmbed)로 나뉜다.
| Model | Size | Emb. Dim | Context | HuggingFace Name | Release | Score Function | Pooling | License |
|---|---|---|---|---|---|---|---|---|
| BM25 | N/A | N/A | N/A | N/A | N/A | N/A | N/A | N/A |
| Instruction-free Embedding Models | ||||||||
| Contriever | 110M | 768 | 512 | contriever-msmarco | 2022 Jan | Inner Product | Mean Pooling | CC BY-NC 4.0 |
| BGE-M3 | 561M | 1024 | 8192 | bge-m3 | 2024 Jan | Cosine Similarity | CLS Pooling | MIT |
| LLM-based Instruction-augmented Embedding Models | ||||||||
| Qwen3 | 8B | 4096 | 32k | Qwen3-Embedding-8B | 2025 Jul | Cosine Similarity | Last Token Pooling | Apache-2.0 |
| Linq | 7B | 4096 | 32k | Linq-Embed-Mistral | 2024 May | Cosine Similarity | Last Token Pooling | CC BY-NC 4.0 |
| GTE | 7B | 3584 | 32k | gte-Qwen2-7B-instruct | 2024 Jun | Cosine Similarity | Last Token Pooling | Apache-2.0 |
| LLM-based Instruction-augmented Reasoning Embedding Models | ||||||||
| ReasonIR | 8B | 4096 | 128k | ReasonIR-8B | 2025 Apr | Cosine Similarity | Mean Pooling | CC BY-NC 4.0 |
| DIVER | 4B | 2560 | 40k | Diver-Retriever-4B | 2025 Aug | Cosine Similarity | Last Token Pooling | Apache-2.0 |
| ReasonEmbed | 8B | 4096 | 32k | reason-embed-qwen3-8b-0928 | 2025 Oct | Cosine Similarity | Last Token Pooling | Apache-2.0 |
Table 2 (원논문): 평가 대상 검색 모델 개요.
모델 선택은 합리적이다. 범용 LLM 리트리버 셋은 서로 다른 백본(Qwen3, Mistral, Qwen2)을 대표하고, 추론 특화 셋은 2025년에 나온 대표 모델을 망라한다. 다만 몇 가지 비대칭이 있다. Contriever만 내적(inner product) 스코어를 쓰고 나머지는 모두 코사인이다. 이 차이가 6.4절에서 Contriever의 극단적 포이즈닝 취약성으로 이어진다. ReasonIR만 평균 풀링을 쓰는 LLM 리트리버라는 점, GTE만 양방향 어텐션(bidirectional attention)으로 학습된 LLM 리트리버라는 점도 뒤에서 결과를 해석할 때 단서가 된다. 크기는 DIVER가 4B로 가장 작고 나머지 LLM 모델은 7-8B다.
4.5 구현 세부사항
instruction-augmented 모델은 개발자가 제공한 기본 쿼리 프롬프트 템플릿을 쓰고, 정확한 템플릿은 코드 저장소에 문서화했다. 문서 입력은 Contriever만 512 토큰, 나머지 dense 모델은 8,192 토큰에서 자른다. BM25는 Gensim의 LuceneBM25Model(, )이다. 주 지표는 nDCG@10이고, RQ2에서는 상대 성능 하락률과 ASR@20을 추가로 쓴다. 실험은 네덜란드 국가 슈퍼컴퓨터 Snellius의 H100 GPU에서 수행했다.
4.6 3축 분류 체계
RQ1의 요인별 분석을 위해 평가 공간을 태스크 유형, 쿼리 유형, 코퍼스 출처 유형 세 축으로 나눈다.
태스크 유형(11개): BEIR 태스크 정의를 출발점으로, BrowseComp-Plus는 Question Answering으로, BRIGHT 12개 데이터셋은 원 벤치마크 설계에 따라 StackExchange Post Retrieval, Code Retrieval, Theorem Retrieval로 묶었다. 결과적으로 Passage Retrieval, Bio-Medical Retrieval, Question Answering, Duplicate Question Retrieval, Entity Retrieval, Citation Prediction, Fact Checking, Argument Retrieval, StackExchange Post Retrieval, Code Retrieval, Theorem Retrieval의 11개가 된다.
쿼리 유형(8개): Bolotova et al. (2022)의 쿼리 의도 분류 체계와 공개 분류기(nf-cats)로 각 쿼리를 자동 분류한다.
| Category | Description | Expected Answer Structure | Patterns |
|---|---|---|---|
| FACTOID (37.4%) | 날짜, 장소, 이름 같은 구체적 사실 정보를 찾는다 | 한두 단어 수준의 간결한 사실 진술이나 직접 답 | Where is ... located? Who is/was ...? When did/was ...? |
| INSTRUCTION (6.4%) | 무언가를 하는 절차나 방법을 이해하고 싶다 | 단계별 지침이나 가이드라인 | How to ...? How can I do ...? What is the process for ...? What is the best way to ...? |
| REASON (3.2%) | 어떤 일의 이유를 알고 싶다 | 근거를 동반한 이유 목록 | Why does ...? What is the reason for ...? What causes ...? How come ... happened? |
| EVIDENCE-BASED (13.1%) | 개념, 대상, 사건의 특징이나 정의를 알고 싶다 | 사실에만 기반해 대상을 기술하는 위키피디아식 문단 | What is ...? How does/do ... work? What are the properties of ...? What is the meaning of ...? How do you describe ...? |
| COMPARISON (1.3%) | 둘 이상을 비교하거나 차이와 공통점을 알고 싶다 | 주요 차이점과 공통점 목록 | How is X ... to/from Y? What are the ... of X over Y? How does X ... against Y? |
| EXPERIENCE (3.7%) | 특정 주제에 대한 조언이나 추천을 원한다 | 개인 경험에서 요약한 장단점과 주요 특징 | Would you recommend ...? How do you like ...? What do you think about ...? Should I ...? |
| DEBATE (7.7%) | 옳고 그름, 긍정과 부정이 갈리는 가설적 질문을 논하고 싶다 | 찬반 근거로 뒷받침된 서로 다른 의견 | Does ... exist? Can ... be successful? Do you think ... are ...? Is ... really a ...? |
| NOT-A-QUESTION (27.2%) | 의문문 형태 없이 정보 요구, 명확화 요청, 특정 콘텐츠 탐색을 표현한다 | 문서, 요약, 목록 등 암묵적 요구에 맞는 콘텐츠. 답이 다른 유형보다 덜 직접적이다 | Find ... in ..., Details on ..., Gmail login, 특정 브랜드나 인물 |
Table 3 (원논문): 사용한 쿼리 유형 분류 체계(Bolotova et al., 2022). 범주명 옆 비율은 4개 벤치마크 30개 데이터셋 전체 쿼리에서 해당 유형이 차지하는 비중이다.
FACTOID(37.4%)와 NOT-A-QUESTION(27.2%)이 합쳐서 거의 3분의 2를 차지하고, COMPARISON은 1.3%에 불과하다. 쿼리 유형 분석의 소수 범주는 표본이 수백 개 수준이라 추정 불확실성이 클 수밖에 없다. 분류기가 비사실형 QA(non-factoid QA) 데이터로 학습된 모델이라, MS MARCO 키워드 쿼리나 BRIGHT의 수백 단어짜리 서술형 쿼리에 얼마나 정확히 작동하는지는 검증되지 않았다는 점도 기억해 둘 만하다.
코퍼스 출처 유형(5개): 각 데이터셋의 구축 과정을 따져 General Web(노이즈와 주제 분포가 이질적인 웹 크롤), Wikipedia(비교적 깨끗한 백과사전), Scientific Paper(학술 논문과 초록), Online Community(Reddit, StackExchange 같은 사용자 생성 포럼), Domain KB(토론 포털, 코딩 플랫폼, 정리 저장소 같은 큐레이션된 도메인 지식)로 나눴다.
5. RQ1 결과: LLM 리트리버는 얼마나 일반화되는가
5.1 데이터셋별 원시 점수
| Dataset | BM25 | Contriever | BGE-M3 | Qwen3 | Linq | GTE | ReasonIR | DIVER | ReasonEmbed |
|---|---|---|---|---|---|---|---|---|---|
| MS MARCO | |||||||||
| MS MARCO | 21.8 | 40.7 | 38.4 | 43.7 | 44.9 | 46.0 | 32.2 | 31.4 | 32.3 |
| TREC DL 19 | 50.0 | 67.6 | 67.3 | 76.3 | 74.6 | 74.4 | 63.9 | 67.7 | 68.8 |
| TREC DL 20 | 48.7 | 66.7 | 67.8 | 74.3 | 73.0 | 72.9 | 63.8 | 64.4 | 64.6 |
| Avg. (MS MARCO) | 40.2 | 58.3 | 57.8 | 64.8 | 64.2 | 64.4 | 53.3 | 54.5 | 55.2 |
| BEIR | |||||||||
| TREC-COVID | 52.9 | 59.4 | 55.6 | 94.7 | 87.1 | 81.1 | 76.8 | 78.8 | 81.2 |
| NFCorpus | 31.4 | 32.8 | 31.6 | 41.4 | 41.9 | 39.9 | 37.9 | 38.0 | 39.9 |
| NQ | 29.5 | 49.8 | 60.6 | 64.9 | 70.4 | 66.8 | 52.6 | 54.2 | 60.7 |
| HotpotQA | 60.1 | 63.8 | 69.5 | 76.8 | 76.4 | 73.0 | 62.8 | 65.8 | 44.4 |
| FiQA | 23.7 | 33.0 | 41.1 | 64.7 | 61.2 | 61.8 | 48.4 | 47.9 | 44.2 |
| Quora | 76.9 | 86.4 | 88.6 | 89.0 | 90.2 | 89.6 | 81.0 | 88.4 | 48.5 |
| DBPedia | 31.0 | 41.3 | 39.8 | 49.9 | 51.3 | 52.4 | 39.7 | 41.5 | 41.3 |
| SCIDOCS | 14.4 | 16.6 | 16.4 | 32.8 | 22.1 | 28.9 | 22.8 | 23.5 | 22.5 |
| SciFact | 67.0 | 67.7 | 64.1 | 78.5 | 78.7 | 79.5 | 75.1 | 76.6 | 78.8 |
| FEVER | 60.3 | 75.7 | 80.9 | 91.8 | 92.3 | 95.2 | 77.4 | 77.8 | 65.1 |
| Climate-FEVER | 15.2 | 23.8 | 29.7 | 47.4 | 39.3 | 46.2 | 31.4 | 30.2 | 25.2 |
| ArguAna | 38.7 | 44.5 | 54.0 | 76.6 | 68.2 | 68.5 | 60.2 | 48.3 | 49.0 |
| Touché-2020 | 44.4 | 20.5 | 22.1 | 35.7 | 30.0 | 33.8 | 19.6 | 24.8 | 26.5 |
| Avg. (BEIR) | 42.0 | 47.3 | 50.3 | 64.9 | 62.2 | 62.8 | 52.7 | 53.5 | 48.3 |
| BRIGHT | |||||||||
| Biology | 18.9 | 19.0 | 10.3 | 19.7 | 25.2 | 30.3 | 26.2 | 41.9 | 53.2 |
| Earth Science | 27.2 | 28.3 | 17.5 | 32.5 | 31.4 | 40.3 | 31.1 | 44.6 | 56.4 |
| Economics | 14.9 | 17.4 | 11.1 | 18.2 | 22.9 | 15.8 | 23.5 | 22.0 | 35.5 |
| Psychology | 12.5 | 16.2 | 14.5 | 27.4 | 26.7 | 26.4 | 30.1 | 34.4 | 46.2 |
| Robotics | 13.6 | 14.1 | 11.2 | 15.9 | 18.3 | 12.5 | 18.2 | 20.9 | 35.8 |
| Stack Overflow | 18.4 | 14.2 | 9.1 | 18.4 | 16.6 | 15.8 | 24.0 | 20.8 | 36.7 |
| Sustainable Living | 15.0 | 14.3 | 10.0 | 17.5 | 24.8 | 20.9 | 20.1 | 25.3 | 39.2 |
| LeetCode | 24.1 | 22.2 | 24.7 | 33.8 | 30.9 | 31.0 | 34.2 | 37.7 | 34.2 |
| Pony | 7.9 | 9.8 | 14.8 | 1.0 | 23.7 | 2.5 | 9.9 | 13.6 | 17.9 |
| AoPS | 6.2 | 9.8 | 4.6 | 9.7 | 8.2 | 15.8 | 14.6 | 11.1 | 12.9 |
| TheoremQA-Q | 10.4 | 10.1 | 12.9 | 39.0 | 28.9 | 32.2 | 31.7 | 38.5 | 41.0 |
| TheoremQA-T | 4.9 | 4.0 | 5.2 | 39.3 | 33.0 | 35.8 | 27.8 | 36.8 | 45.8 |
| Avg. (BRIGHT) | 14.5 | 15.0 | 12.2 | 22.7 | 24.2 | 23.3 | 24.3 | 29.0 | 37.9 |
| BrowseComp-Plus | |||||||||
| Evidence | 4.4 | 6.9 | 6.3 | 20.1 | 12.4 | 17.4 | 15.5 | 17.7 | 16.1 |
| Gold | 3.7 | 6.5 | 5.1 | 18.7 | 10.8 | 17.8 | 13.6 | 17.3 | 16.9 |
| Avg. (BrowseComp-Plus) | 4.1 | 6.7 | 5.7 | 19.4 | 11.6 | 17.6 | 14.6 | 17.5 | 16.5 |
Table 4 (원논문): 전체 벤치마크에 대한 모델별 원시 nDCG@10. 볼드는 행별 최고값. 본문의 LMM은 이 집계값이 아닌 쿼리 단위 점수를 사용한다.
이 표 하나만으로도 이야깃거리가 많다. 먼저 벤치마크 간 난이도 차이가 압도적이다. FEVER(최고 95.2), Quora(90.2) 같은 쉬운 데이터셋과 BrowseComp-Plus(최고 20.1) 사이에 수십 점 차이가 난다. 대부분 모델에서 BEIR 평균과 BRIGHT 평균의 격차가 30점을 넘는다(Qwen3 기준 64.9 vs 22.7). 이 정도 이질성이면 모든 데이터셋을 단순 평균했을 때 BEIR 같은 쉬운 데이터셋의 점수가 결과를 좌우하게 된다는 저자들의 문제의식이 이해된다. 참고로 본문은 BrowseComp-Plus에서 "최고 모델도 5점 미만"이라고 쓰지만 표에서는 Qwen3가 20.1이다. 5점 미만인 것은 BM25이므로 본문 쪽 서술 오류로 보인다.
두 번째로 보이는 것은 "전문화 세금"의 원형이다. ReasonEmbed는 BRIGHT 12개 중 9개에서 1위를 차지하고 BRIGHT 평균 37.9로 2위 DIVER(29.0)를 9점 가까이 앞선다. 그런데 Quora에서 48.5에 그친다. 다른 LLM 리트리버가 전부 88 이상, BM25조차 76.9인 데이터셋이다. HotpotQA(44.4, BM25 60.1보다 낮음)와 FEVER(65.1)에서도 크게 처진다. BEIR 평균은 48.3으로 BGE-M3(50.3)보다도 낮다. 추론 집약 쿼리에 최적화한 대가를 일반 쿼리에서 치르는 셈이다. 같은 추론 특화 계열인 ReasonIR과 DIVER는 Quora에서 81.0, 88.4로 이런 붕괴를 보이지 않으므로, 추론 특화 학습 일반의 문제라기보다 ReasonEmbed 고유의 문제로 보는 편이 맞다.
세 번째, 어휘 기반 방법이 여전히 무시할 수 없는 영역이 있다. Touché-2020에서는 BM25(44.4)가 모든 dense 모델을 이긴다. 이건 BEIR 원 논문 때부터 알려진 현상이다. BRIGHT 평균에서도 BM25(14.5)는 Contriever(15.0)와 비슷하고 BGE-M3(12.2)보다 낫다.
표에서 저자들이 언급하지 않은 이상치도 하나 있다. Pony(희귀 프로그래밍 언어 코드 검색)에서 Qwen3가 1.0, GTE가 2.5로 BM25(7.9)보다 한참 낮다. 같은 Qwen 계열 백본인 ReasonEmbed(17.9)와 DIVER(13.6)는 멀쩡하고, Linq는 23.7로 1위다. 같은 백본 계열에서 이 정도 편차가 나는 건 학습 데이터 구성이나 instruction 템플릿 차이로 설명할 수밖에 없을 텐데, 리트리버 선택 시 특정 도메인에서 이런 "구멍"이 있을 수 있다는 실무적 경고로 읽힌다.
5.2 고정효과 유의성 검정
| Factor | Fixed Effects | F-ratio | p-value |
|---|---|---|---|
| Task Type | Model | 675.89 | < .001 |
| Task Type | 2.67 | .003 | |
| Model × Task Type | 303.48 | < .001 | |
| Query Type | Model | 3143.25 | < .001 |
| Query Type | 32.85 | < .001 | |
| Model × Query Type | 166.54 | < .001 | |
| Corpus Source Type | Model | 2276.43 | < .001 |
| Corpus Source Type | 2.33 | .054 | |
| Model × Corpus Source Type | 468.79 | < .001 |
Table 5 (원논문): 세 LMM의 고정효과에 대한 Type III 결합 F-검정(Satterthwaite 근사). 상호작용 항이 유의하다는 것은 요인 수준에 따라 일반화 양상이 균일하지 않다는 뜻이다.
세 분석 모두에서 모델 × 요인 상호작용이 F = 166.54-468.79로 매우 유의하다. "어떤 모델이 더 좋다"는 결론이 조건에 따라 달라진다는 뜻이다. 저자들이 짚는 비대칭은 코퍼스 출처다. 주효과는 관례적 유의 수준에 못 미치는데(F = 2.33, p = .054) 모델과의 상호작용은 세 분석 중 가장 크다(F = 468.79). 코퍼스 출처가 모든 모델을 일률적으로 끌어올리거나 내리는 게 아니라, 모델에 따라 정반대 방향으로 작용한다는 해석이다. 그래서 하나로 뭉친 효과 대신 코퍼스 출처별 EMM을 봐야 한다는 주장으로 이어진다.
한 가지 덧붙이면, 관측치가 약 4만 3천 쿼리 × 9개 모델, 즉 39만 개 가까이 되는 상황에서 p < .001은 거의 보장된 결과다. F-ratio의 크기도 상당 부분 표본 크기에서 온다. 요인 주효과의 F가 작은 이유는 그 효과가 데이터셋 수준(30개)에서 추정되고 데이터셋 랜덤 절편과 경쟁하기 때문이다. 유의성보다 랜덤 효과 분산 성분(, )이나 효과 크기를 함께 보고했다면 "데이터셋 난이도가 전체 분산의 몇 %를 설명하는가" 같은 더 유용한 정보를 얻을 수 있었을 것이다.
5.3 추정 주변 평균(EMM)
| Factor | Level | BM25 | Contriever | BGE-M3 | Qwen3 | Linq | GTE | ReasonIR | DIVER | ReasonEmbed |
|---|---|---|---|---|---|---|---|---|---|---|
| Task Type | Passage Retrieval | 22.1 | 41.1 | 38.8 | 44.2 | 45.3 | 46.3 | 32.7 | 31.9 | 32.7 |
| Bio-Medical Retrieval | 47.5 | 49.6 | 48.1 | 61.7 | 61.2 | 58.7 | 56.4 | 56.8 | 58.7 | |
| Question Answering | 32.8 | 41.4 | 48.2 | 56.0 | 56.6 | 53.9 | 43.0 | 45.3 | 34.0 | |
| Duplicate Question Retrieval | 76.9 | 86.4 | 88.6 | 89.0 | 90.2 | 89.6 | 81.0 | 88.4 | 48.5 | |
| Entity Retrieval | 31.0 | 41.3 | 39.8 | 49.9 | 51.3 | 52.4 | 39.8 | 41.5 | 41.3 | |
| Citation Prediction | 14.4 | 16.6 | 16.4 | 32.8 | 22.1 | 28.9 | 22.8 | 23.5 | 22.5 | |
| Fact Checking | 43.4 | 57.1 | 62.1 | 74.3 | 73.3 | 76.8 | 60.1 | 60.2 | 49.4 | |
| Argument Retrieval | 26.1 | 31.0 | 40.2 | 62.5 | 54.1 | 54.6 | 46.1 | 34.8 | 35.5 | |
| StackExchange Post Retrieval | 17.3 | 17.7 | 11.9 | 21.4 | 23.6 | 23.2 | 24.7 | 30.0 | 43.3 | |
| Code Retrieval | 15.8 | 15.6 | 19.2 | 18.2 | 26.6 | 17.3 | 22.4 | 26.0 | 25.9 | |
| Theorem Retrieval | 7.2 | 7.9 | 8.0 | 29.6 | 22.8 | 27.2 | 25.0 | 29.3 | 32.9 | |
| Avg. (task) | 30.4 | 36.9 | 38.3 | 49.1 | 47.9 | 48.1 | 41.3 | 42.5 | 38.6 | |
| Query Type | FACTOID | 25.7 | 35.8 | 39.6 | 46.5 | 47.1 | 45.7 | 34.1 | 36.3 | 27.5 |
| INSTRUCTION | 26.2 | 35.8 | 38.3 | 40.8 | 41.8 | 41.8 | 30.8 | 38.8 | 0.2 | |
| REASON | 30.2 | 39.6 | 41.6 | 44.4 | 46.1 | 44.9 | 39.1 | 43.0 | 16.4 | |
| EVIDENCE-BASED | 23.4 | 39.5 | 39.8 | 44.3 | 45.0 | 45.5 | 35.5 | 35.9 | 22.2 | |
| COMPARISON | 36.9 | 48.0 | 52.4 | 55.1 | 55.8 | 54.1 | 44.8 | 48.8 | 26.1 | |
| EXPERIENCE | 29.9 | 40.2 | 43.0 | 43.3 | 44.9 | 44.2 | 33.4 | 42.8 | 0.8 | |
| DEBATE | 31.7 | 40.6 | 43.4 | 47.2 | 47.7 | 46.8 | 37.7 | 43.1 | 16.9 | |
| NOT-A-QUESTION | 21.8 | 32.7 | 37.3 | 50.6 | 48.4 | 51.1 | 37.9 | 37.0 | 29.3 | |
| Avg. (query) | 28.2 | 39.0 | 41.9 | 46.5 | 47.1 | 46.8 | 36.7 | 40.7 | 17.4 | |
| Corpus Source Type | General Web | 10.7 | 27.9 | 25.8 | 32.0 | 32.3 | 33.7 | 21.3 | 20.8 | 21.4 |
| Wikipedia | 40.2 | 51.4 | 57.7 | 66.6 | 67.0 | 66.6 | 52.8 | 54.2 | 42.5 | |
| Scientific Paper | 44.1 | 46.0 | 44.9 | 60.3 | 53.8 | 57.5 | 52.5 | 53.2 | 53.5 | |
| Online Community | 26.6 | 35.5 | 37.4 | 39.8 | 40.8 | 40.3 | 32.1 | 38.9 | 4.5 | |
| Domain KB | 12.4 | 15.9 | 22.8 | 42.2 | 36.1 | 36.1 | 30.4 | 23.7 | 24.9 | |
| Avg. (corpus source) | 26.8 | 35.4 | 37.7 | 48.2 | 46.0 | 46.8 | 37.8 | 38.2 | 29.4 |
Table 6 (원논문): 태스크, 쿼리, 코퍼스 출처 요인별로 LMM에서 도출한 nDCG@10 추정 주변 평균. 데이터셋 난이도와 규모를 통제한 값이며, 볼드는 행별 최고값이다.
요인 전반을 놓고 보면 범용 instruction-augmented 3종(Qwen3, Linq, GTE)이 평균 EMM에서 확실히 앞선다(태스크 47.9-49.1, 쿼리 46.5-47.1, 코퍼스 46.0-48.2). 한 요인에만 국한되지 않고 세 요인 모두에서 BM25와 인코더 모델을 이긴다는 점에서, 이들의 우위는 "넓은" 우위라고 할 수 있다.
태스크 유형별로는 편차가 크다. Duplicate Question Retrieval은 LLM 리트리버 대부분이 80을 넘지만, Citation Prediction과 Theorem Retrieval은 가장 어렵다(Qwen3 기준 32.8, 29.6). BRIGHT 유래 태스크에서 추론 특화 모델이 강한 것은 맞지만 균일하지는 않다. ReasonEmbed가 Theorem Retrieval(32.9)과 StackExchange Post Retrieval(43.3)을 이끄는 반면, Code Retrieval은 Linq(26.6), DIVER(26.0), ReasonEmbed(25.9)가 엇비슷하다. 추론 특화 모델의 이점이 "추론 집약적 태스크 전반"이 아니라 특정 태스크에 한정된다는 저자들의 결론은 표와 맞아떨어진다.
쿼리 유형에서는 instruction-augmented 모델이 8개 유형 모두를 이끈다. 격차는 NOT-A-QUESTION에서 가장 크다(Qwen3 50.6, GTE 51.1 vs BM25 21.8). 가장 극적인 숫자는 ReasonEmbed의 INSTRUCTION 0.2, EXPERIENCE 0.8이다. BM25(26.2, 29.9)보다 한참 아래인 거의 완전한 실패다. 저자들은 ReasonEmbed의 학습 레시피와 프롬프트 동작이 명령형이나 조언 요청형 질문보다 사실 탐색형, 추론형 질문에 맞춰져 있을 가능성을 제시하면서도, 이 분석만으로는 원인을 특정할 수 없다고 선을 긋는다. ReasonIR과 DIVER는 이 실패 모드를 보이지 않으므로 역시 모델 고유 현상이다.
코퍼스 출처에서는 Wikipedia가 모든 모델에서 가장 높다(Qwen3 66.6, BM25 40.2). 학습 데이터에 위키피디아가 많이 들어 있기 때문으로 보인다. General Web은 전 모델이 함께 떨어진다(최고 GTE 33.7). 노이즈 많고 이질적인 문서 분포 탓일 것이다. Domain KB에서는 모델 계층 간 격차가 가장 크다(Qwen3 42.2 vs BM25 12.4). Online Community에서 ReasonEmbed는 EMM 4.5라는 극단적 약점을 드러낸다.
이를 종합해 저자들은 추론 특화 리트리버가 좁은 니치(정리 검색, StackExchange 포스트 검색)에서 강한 대신 다른 쿼리 유형과 코퍼스 출처에서 크게 무너지는 현상을 **전문화 세금(specialization tax)**이라 부른다. BRIGHT 점수만 보고 추론 특화 리트리버를 범용 RAG에 투입하려는 팀에게는 꽤 실질적인 경고다.
5.4 리뷰어 노트: EMM 순위는 사실상 쿼리 가중 평균이다
Online Community EMM 4.5라는 숫자를 보고 의아했다. Table 4에서 Online Community로 분류된 9개 데이터셋(FiQA, Quora, BRIGHT StackExchange 7개)의 ReasonEmbed 원시 점수는 가장 낮은 것이 35.5(Economics)이고, BRIGHT 쪽은 오히려 전부 1위다. 모든 구성 데이터셋에서 35점 이상인 모델의 "평균 난이도 데이터셋 기준 성능"이 4.5라는 건 직관과 맞지 않는다.
그래서 Table 1의 쿼리 수와 Table 4의 원시 점수로 직접 계산해 봤다. 결과는 아래와 같다.
| 모델 | Online Community 쿼리 가중 평균 | EMM (Table 6) | 차이 | 데이터셋 단순 평균 |
|---|---|---|---|---|
| BM25 | 69.97 | 26.6 | -43.4 | 24.6 |
| Qwen3 | 83.18 | 39.8 | -43.4 | 33.7 |
| Linq | 84.18 | 40.8 | -43.4 | 35.3 |
| GTE | 83.66 | 40.3 | -43.4 | 34.8 |
| DIVER | 82.26 | 38.9 | -43.4 | 38.5 |
| ReasonEmbed | 47.92 | 4.5 | -43.4 | 44.0 |
리뷰어 계산: Table 1의 쿼리 수로 가중한 Table 4 원시 점수 평균과 Table 6 EMM 비교. Online Community 쿼리 11,397개 중 Quora가 10,000개(87.7%)를 차지한다.
9개 모델 전부에서 EMM은 쿼리 가중 평균에서 정확히 같은 상수(-43.4)를 뺀 값이다(반올림 오차 ±0.1 이내). Passage Retrieval 수준에서도 같은 계산을 하면 상수가 거의 0이고 오차 ±0.1 이내로 일치한다. 이건 우연이 아니라 모델 구조에서 나오는 성질이다. 식 (1)의 랜덤 효과 와 은 모든 모델이 공유하므로 모델 간 차이를 계산하면 소거된다. 모든 쿼리를 모든 모델이 푸는 균형 설계에서, 모델-요인 상호작용은 결국 쿼리별 짝지은 차이의 평균, 즉 쿼리마다 같은 가중치를 준 평균으로 추정된다. 데이터셋 랜덤 효과가 하는 일은 그 요인 수준 전체의 절대 높이를 옮기는 것뿐이다.
이게 의미하는 바는 크다. 첫째, Table 6 안에서 모델 간 순위와 격차는 데이터셋 크기 편향을 "통제"한 것이 아니라 쿼리 수가 많은 데이터셋이 지배하는 마이크로 평균(micro-average) 그대로다. Online Community의 결론은 사실상 Quora 하나에 대한 결론이고, Passage Retrieval은 6,980개 쿼리의 MS MARCO dev가 98.6%를 차지해 깊게 판정된 TREC DL 19/20의 영향이 거의 사라진다. Passage Retrieval EMM에서 GTE(46.3)가 1위인데, TREC DL 19/20에서는 Qwen3가 1위였다는 점이 이를 보여준다. 둘째, 데이터셋을 동등하게 취급하는 단순 평균(macro-average)을 쓰면 Online Community에서 ReasonEmbed는 꼴찌가 아니라 **1위(44.0)**다. "전문화 세금"이라는 결론 중 코퍼스 출처 부분은 어떤 가중 방식을 택하느냐에 따라 뒤집힐 수 있다는 얘기다. 셋째, EMM의 절대값은 관측 범위 밖으로 나갈 수 있어서(4.5), "평균 난이도 데이터셋에서의 nDCG@10"으로 읽으면 오해하기 쉽다.
쿼리 유형 분석의 ReasonEmbed INSTRUCTION 0.2, EXPERIENCE 0.8도 같은 맥락에서 읽어야 한다고 본다. 쿼리별 데이터가 없어 직접 검증할 수는 없지만, "How can I...", "Should I..." 형태가 많은 Quora 쿼리가 이 범주에 대량으로 들어갔다면, ReasonEmbed의 Quora 붕괴가 그대로 이 범주의 큰 격차로 옮겨 갔을 가능성이 높다.
저자들이 단순 평균의 문제로 지적한 "데이터셋 크기 차이에 따른 왜곡"을 LMM이 해결한 게 아니라, 데이터셋 동등 가중에서 쿼리 동등 가중으로 편향의 방향을 바꾼 것에 가깝다. 모델 × 데이터셋 랜덤 기울기(random slope)를 넣었다면 한 데이터셋에서의 모델별 특이 성능이 랜덤 효과로 흡수되어, 큰 데이터셋 하나가 요인 수준 결론을 지배하는 현상이 완화되었을 것이다. 이 지적이 논문의 큰 그림을 무너뜨리지는 않는다. 범용 instruction-augmented 모델의 넓은 우위는 원시 점수만 봐도 분명하다. 다만 Table 6의 개별 셀, 특히 ReasonEmbed 관련 극단값은 이 점을 감안하고 읽는 편이 안전하다.
6. RQ2 결과: 교란 앞에서 얼마나 안정적인가
RQ2는 BM25를 제외한 dense 리트리버 8종을 대상으로 한다. BM25는 학습 파라미터가 없어 그래디언트 기반 포이즈닝을 적용할 수 없고, 쿼리 측과 문서 측 분석의 모델 집합을 맞추기 위해서다.
6.1 쿼리 변형 실험 설정
Penha et al. (2022)의 다섯 가지 변형 유형을 채택한다. 평가 데이터셋은 NQ, MS MARCO Dev, HotpotQA, FiQA 네 개로, 쿼리 스타일과 난이도 구간을 고루 덮으면서 계산 비용을 감당할 수 있게 골랐다. 지표는 상대 성능 하락률이다.
는 nDCG@10이다. 한 변형 유형에 생성 방법이 여러 개면 쿼리마다 하나를 무작위로 고르고, 모든 실험을 5개 랜덤 시드(1999, 2016, 2026, 5, 27)로 반복한다.
- Misspelling(오타): Penha et al.의 원래 방법보다 연산 종류가 다양한 Zhuang & Zuccon의 오타 생성기를 쓴다. 3글자 초과 키워드 중 정확히 하나를 골라 문자 삽입, 삭제, 치환, 인접 문자 교환, 키보드 인접 문자 교환 중 하나를 적용한다.
- Reordering(어순 변경): 어휘는 그대로 두고 두 단어의 위치를 무작위로 맞바꾼다.
- Synonymizing(동의어 치환): 불용어가 아닌 단어 하나를 (1) counter-fitted GloVe 임베딩 공간의 최근접 이웃 또는 (2) WordNet의 첫 번째 동의어로 바꾼다.
- Paraphrasing(패러프레이즈): (1) 피벗 언어를 거친 역번역(back-translation) 또는 (2) 패러프레이즈용으로 파인튜닝한 T5로 의미가 같은 재구성을 만든다.
- Naturalizing(자연화): 불용어를 모두 제거해 키워드식 검색 행동을 흉내 낸다. Penha et al.이 제안한 T5 기반 자연어 질문 생성 방식은 모델이 더 이상 공개되어 있지 않아 쓰지 못했다.
| Variation | Original Query | Perturbed Query |
|---|---|---|
| Misspelling | who is the leader of the ontario pc party | who is the leader of the ontario pc paryt |
| Reordering | who plays the doc in back to the future | who back the doc in plays to the future |
| Synonymizing | when did the apple iphone se come out | when did the apple iphone se arriving out |
| Paraphrasing | why does king from tekken wear a mask | Why the King of Tekken Wears a Mask |
| Naturalizing | where does the donkey talk in the bible | donkey talk bible |
Table 7 (원논문): NQ 데이터셋에서 뽑은 변형 유형별 쿼리 예시.
예시를 보면 변형의 품질이 균일하지 않다는 점이 바로 드러난다. Misspelling, Reordering, Naturalizing은 의도대로 표면만 흔든다. 그런데 Synonymizing 예시 "come out → arriving out"은 동의어라기보다 의미를 깨뜨린 치환이다. "come out"이라는 구동사(phrasal verb)를 단어 단위로 처리하다 보니 생긴 문제다. 동의어 치환이 모든 모델을 흔든다는 뒤의 결론을 해석할 때, 그 하락분 중 일부는 모델의 취약성이 아니라 쿼리 의미 자체가 바뀌어 원래 relevance 판정이 더 이상 유효하지 않게 된 데서 왔을 수 있다는 점을 염두에 둬야 한다. 논문은 생성된 변형의 의미 보존 여부를 사람이나 모델로 검증하지 않았다.
6.2 쿼리 변형 결과
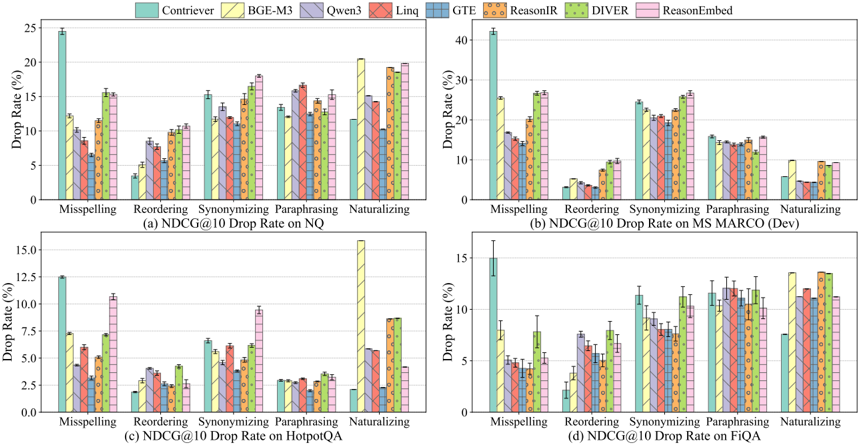
Figure 1: 네 데이터셋에서 다섯 가지 쿼리 변형 유형에 따른 nDCG@10 하락률(%). 막대는 5개 시드의 평균, 오차 막대는 ±1 표준편차이며 낮을수록 강건하다. (원논문)
다섯 변형은 서로 다른 강건성 프로필을 드러내고, 하나의 축으로 뭉칠 수 없다. 유형별로 정리하면 다음과 같다.
Misspelling은 모델 계열 간 차이가 가장 선명한 교란이다. MS MARCO에서 Contriever는 약 42% 하락하고, 그림상 범용 LLM 3종(Qwen3, Linq, GTE)은 14-17% 수준이며 GTE가 가장 낮다. 추론 특화 모델은 이 이점을 공유하지 못한다. DIVER와 ReasonEmbed는 약 27%로 BGE-M3(약 25%)와 비슷하다. NQ에서는 계열 간 격차가 좁아져 Contriever(약 24%)가 여전히 최악이지만 나머지는 6-16% 범위에 모인다. 웹 규모 노이즈 텍스트로 대규모 사전학습한 효과로 오타 내성이 생겼다는 가설과 일관되지만, 이 결과만으로 그 가설이 입증되지는 않는다고 저자들은 조심스럽게 말한다. 덧붙이면 본문은 MS MARCO에서 BGE-M3가 "약 17%", 범용 LLM 모델이 "6-12%"라고 쓰는데, 그림의 MS MARCO 패널에서는 BGE-M3가 약 25%, Qwen3가 16.8%(Figure 3(b)의 8B 값과도 일치)로 보인다. 본문 수치는 NQ 패널과 섞인 것으로 보인다.
Synonymizing과 Paraphrasing은 모든 모델에서 상당한 하락을 일으킨다. MS MARCO에서는 동의어 치환이 22-27%로 패러프레이즈(그림상 12-16%)보다 확실히 세다. 저자들이 내놓는 설명은 쿼리 길이다. 같은 변형 레시피라도 6단어짜리 키워드 쿼리에서 한 단어를 바꾸는 것은 17.6단어짜리 HotpotQA 쿼리에서 한 단어를 바꾸는 것보다 훨씬 치명적이다. 실제로 HotpotQA의 패러프레이즈 하락률은 일률적으로 약 3%에 불과하고, 쿼리 길이가 중간(9.2단어)인 NQ는 중간 정도의 효과를 보인다. 동의어 치환은 데이터셋을 가리지 않고 어렵고, 패러프레이즈는 데이터셋 의존성이 크다. 두 경우 모두 LLM 모델과 인코더 모델의 격차가 오타보다 훨씬 좁다. 모델 크기나 사전학습 규모로 해결되지 않는 의미 수준의 불변성 문제라는 뜻으로 읽힌다.
Reordering은 부분적인 아키텍처 효과를 드러낸다. NQ에서 가장 뚜렷한데, Contriever가 약 3%로 오히려 가장 강건하고 여러 LLM 리트리버는 8-11%로 더 크게 떨어진다. MS MARCO와 HotpotQA에서는 이 격차가 작고 일관성도 떨어진다. LLM 중에서는 GTE가 인코더 수준의 하락률을 보이는 예외다. 저자들은 어텐션 방향성으로 이를 설명하려 한다. 인과적 어텐션에서는 두 단어를 맞바꾸면 주변 토큰들의 왼쪽 문맥 표현이 전부 바뀌고, 마지막 토큰 풀링은 그 변화를 고스란히 떠안는다. 양방향 어텐션으로 학습된 GTE가 상대적으로 안정적인 것이 이 가설과 맞는다. 하지만 Qwen3-Embedding-0.6B를 양방향으로 바꿔 MS MARCO로 파인튜닝한 예비 실험에서는 이득이 미미했다. 저자들은 양방향 전환이 대규모 지속 사전학습을 필요로 한다는 선행 연구를 들며, 어텐션 방향성을 "그럴듯하지만 검증되지 않은 요인"으로 남겨 둔다.
Naturalizing은 데이터셋 의존적이다. 원래 키워드형인 MS MARCO에서는 불용어 제거의 영향이 작아 모두 3-10% 수준이다. 반면 NQ와 HotpotQA에서는 BGE-M3가 가장 취약하다(약 20.5%, 16%). 그림을 자세히 보면 NQ에서는 추론 특화 3종(약 18.5-19.8%)도 BGE-M3와 거의 비슷하게 취약한데, 본문은 BGE-M3에만 초점을 맞춘다.
FiQA는 다른 양상이다. 모델 간 차이가 전반적으로 작고, 그럼에도 동의어 치환과 패러프레이즈가 오타보다 큰 하락을 일으킨다. FiQA의 평균 쿼리 길이(10.8단어)가 MS MARCO와 HotpotQA 사이라는 점에서 쿼리 길이 가설과 대체로 맞지만, 금융 도메인 특유의 표현도 영향을 줬을 수 있다. 오차 막대가 커서 모델 차이를 가르는 변별력이 다른 세 데이터셋보다 떨어진다.
전체적으로 GTE가 변형 유형 전반에서 가장 일관되게 강건하고, 추론 특화 학습은 쿼리 측 안정성 향상으로 이어지지 않았다. 쿼리 길이 가설은 설득력이 있지만, 네 데이터셋의 평균 길이와 하락률을 대조한 정성적 논증에 머문다. 같은 데이터셋 안에서 쿼리 길이 구간별로 하락률을 나눠 봤다면 데이터셋 고유 특성과 길이 효과를 분리할 수 있었을 것이다.
6.3 코퍼스 포이즈닝 실험 설정
문서 측 안정성은 코퍼스 포이즈닝, 즉 적대적 문서를 검색 코퍼스에 주입하는 공격에 대한 내성으로 정의한다. 문서 측 교란 전체를 대표하지는 않지만, 검색 특화 위협 모델로 가장 잘 정립되어 있고 보안상 실질적 의미가 크다는 이유에서다.
Li et al. (2025)과 Zhong et al. (2023)의 프로토콜을 따라 수백만 문서 규모 코퍼스에 적대적 문서 개를 주입하고 Top-20 공격 성공률(ASR@20)을 잰다. 테스트 쿼리 중 상위 20개 검색 결과에 적대적 문서가 하나라도 들어간 비율이다. 텍스트 정의를 수식으로 옮기면 다음과 같다.
적대적 문서는 학습 쿼리에 대해 최적화하고, 평가는 따로 떼어 둔 테스트 쿼리로 한다. 공격이 최적화 대상 밖의 쿼리로 일반화되는지를 보는 설정이다. 데이터셋은 NQ, MS MARCO(Dev), HotpotQA 세 개이고, 역시 5개 시드의 평균과 표준편차를 보고한다.
화이트박스 공격: 공격자가 대상 모델의 가중치와 구조에 완전히 접근할 수 있다고 가정하고, HotFlip 알고리즘으로 적대적 문서를 직접 최적화한다. HotFlip은 1차 그래디언트 근사로 이산 토큰 탐색을 안내하며, 적대적 문서의 토큰을 반복적으로 교체해 목표 쿼리 임베딩과의 유사도를 최대화한다. 이를 개념적으로 쓰면 학습 쿼리 클러스터 에 대해
를 토큰 공간에서 근사적으로 푸는 셈이다. 학습 쿼리를 K-means로 개 클러스터로 나누고 클러스터마다 50토큰짜리 적대적 문서 하나를 만든다(instruction 모델이 쿼리에 붙이는 태스크 설명은 제외). 의미적으로 응집된 쿼리 묶음을 겨냥해야 다양한 쿼리 의도를 커버할 수 있기 때문이다. 방어 수단 없이 모델 접근이 완전한 설정이므로 공격 효과의 최악 상한(upper bound)에 해당한다.
Direct-transfer 블랙박스 공격: 일반적인 블랙박스 공격은 대상 모델을 대리 모델(surrogate)로 증류하고, 대리 모델에 화이트박스 최적화를 한 뒤, 결과를 대상 모델로 전이한다. 그런데 LLM 규모 리트리버에서는 대리 모델의 충실도가 또 하나의 교란 변수가 된다. 대리 모델이 약하면 공격 가능성을 과소평가하게 되어, 대상 모델의 강건성과 대리 모델 품질을 구분하기 어렵다. 여러 LLM 리트리버에 대해 충실한 대리 모델을 학습하는 비용도 크다. 그래서 저자들은 대리 모델 학습 없이, 한 모델에 대해 화이트박스로 만든 적대적 문서를 다른 모든 모델의 코퍼스에 그대로 주입하는 좁은 설정을 택했다. 접근 권한이 전혀 없는 조건에서의 교차 아키텍처 전이성을 보는 것이다.
| Dataset | Adversarial Document Excerpt |
|---|---|
| NQ | raham-map [ZH] ONA [ZH] MarIES [ZH] HING continent OINST [TR] Country [ZH] Website [DE] . . . |
| MS MARCO | ActualAt [ZH] Ob [ZH] disgr monthlyustral [ZH] months advantages [ZH] incapacexclude [ZH] . . . |
| HotpotQA | [ZH] Founded Wit [ZH] Directed helt Franz t séarty heiLTalus [ZH] Education . . . |
Table 8 (원논문): DIVER를 대상으로 화이트박스 HotFlip 공격이 생성한 적대적 문서 예시. 가독성을 위해 일부만 발췌했으며, 실제 문서는 최적화된 50개 토큰으로 이루어지고 그래디언트 기반 생성 특유의 혼합 문자 체계와 다국어 조각을 자주 포함한다.
적대적 문서는 사람이 읽으면 의미 없는 토큰 조합이다. [ZH], [TR], [DE] 표시는 언어 코드로 보아 각각 중국어, 터키어, 독일어 조각을 축약한 것으로 보인다. "continent", "Country", "Website", "Founded", "Directed", "Education" 같은 단어가 섞여 있는데, 해당 데이터셋 학습 쿼리 클러스터의 주제어(지리, 영화, 인물 정보)를 겨냥한 흔적으로 보인다. 다국어 조각이 많은 것은 LLM 토크나이저의 거대한 어휘에서 그래디언트가 가리키는 토큰을 고르다 보면 자연스럽게 생기는 현상이다. 실무 관점에서는 이런 문서는 퍼플렉시티(perplexity) 필터 같은 간단한 방어로도 걸러낼 가능성이 높다는 점도 함께 기억해 둘 만하다. 논문은 방어 기법을 평가 범위에 넣지 않았다.
6.4 화이트박스 공격 결과
| Dataset | |A| | Contriever | BGE-M3 | Qwen3 | Linq | GTE | ReasonIR | DIVER | ReasonEmbed |
|---|---|---|---|---|---|---|---|---|---|
| NQ | 10 | 78.8 (4.0) | 6.3 (0.6) | 1.3 (0.2) | 4.5 (0.5) | 0.0 (0.0) | 0.8 (0.7) | 10.6 (1.0) | 5.4 (1.9) |
| NQ | 50 | 94.8 (1.0) | 21.2 (1.1) | 5.2 (0.6) | 14.8 (0.7) | 0.0 (0.0) | 3.8 (1.0) | 20.7 (0.6) | 11.9 (1.0) |
| MS MARCO | 10 | 49.0 (8.1) | 0.6 (0.1) | 0.0 (0.0) | 0.0 (0.0) | 0.0 (0.0) | 0.0 (0.0) | 5.6 (0.4) | 5.4 (2.3) |
| MS MARCO | 50 | 89.3 (1.6) | 6.1 (0.3) | 0.3 (0.1) | 0.7 (0.2) | 0.0 (0.0) | 0.1 (0.0) | 8.4 (0.3) | 10.1 (1.9) |
| HotpotQA | 10 | 94.4 (0.8) | 22.7 (0.7) | 0.8 (0.4) | 15.6 (1.1) | 0.0 (0.0) | 0.1 (0.0) | 3.7 (0.4) | 8.7 (4.1) |
| HotpotQA | 50 | 99.5 (0.1) | 55.0 (0.9) | 11.0 (1.7) | 43.8 (0.6) | 0.0 (0.0) | 0.7 (0.2) | 13.5 (0.4) | 24.1 (1.6) |
Table 9 (원논문): 코퍼스 포이즈닝 공격의 Top-20 공격 성공률(%). 각 데이터셋 학습셋으로 적대적 문서 개를 만들어 코퍼스에 주입한 뒤, 따로 떼어 둔 테스트 쿼리의 상위 20개 결과에 적대적 문서가 하나라도 포함되는지 평가했다. 5개 시드의 평균(괄호 안은 표준편차)이며 낮을수록 강건하다. 볼드는 리뷰어가 표시한 행별 최저값이다.
GTE가 모든 데이터셋과 두 공격 예산 모두에서 ASR 0%로 가장 강건하다. ReasonIR이 그다음으로, 에서도 4% 미만이다. Qwen3도 전반적으로 강하지만 HotpotQA 고예산에서 11.0까지 오른다. Linq는 NQ와 MS MARCO에서는 강건하지만 HotpotQA에서 43.8까지 치솟는다.
반대편 끝은 Contriever다. 에서 이미 49.0-94.4, 50에서는 89.3-99.5로 사실상 무방비다. 저자들이 이전 연구(Li et al., 2025)에서 밝혔듯, 내적 스코어를 쓰기 때문에 적대적 문서가 L2 노름을 부풀리는 것만으로 모든 쿼리와의 점수를 올릴 수 있다. 코사인 유사도는 노름을 정규화하므로 이 경로가 막힌다. BGE-M3는 중간이지만 예산이 늘면 HotpotQA에서 22.7 → 55.0으로 크게 오른다.
추론 특화 모델은 일관된 이점이 없다. ReasonIR은 매우 강건한 반면, DIVER(HotpotQA 13.5)와 ReasonEmbed(24.1)는 중간 정도 취약하다. 데이터셋과 예산도 중요하다. 예산을 10에서 50으로 늘리면 여러 모델의 성공률이 크게 늘고, HotpotQA가 대체로 가장 어려운 데이터셋이다. HotpotQA는 다중 홉 질문이라 학습 쿼리 클러스터가 주제적으로 더 응집되어 있고(영화, 인물 등 엔티티 중심), 그만큼 클러스터 중심을 겨냥한 적대적 문서가 테스트 쿼리에도 잘 걸리는 것으로 추측해 볼 수 있다.
GTE의 0.0 (0.0)은 짚고 넘어갈 필요가 있다. 3개 데이터셋 × 2개 예산 × 5개 시드, 총 30번의 실행에서 단 하나의 테스트 쿼리도 상위 20위 안에 적대적 문서를 들이지 못했다는 뜻이다. 강건성의 증거일 수도 있지만, 이 모델에 대해 HotFlip 최적화 자체가 제대로 진행되지 않았을 가능성도 배제하기 어렵다. 예를 들어 적대적 문서와 학습 쿼리 간 달성된 유사도가 정답 문서 유사도와 비교해 어느 수준까지 올라갔는지 같은 공격 측 진단이 함께 보고되었다면 "공격이 실패했다"와 "모델이 버텼다"를 구분할 수 있었을 것이다. 거의 같은 Qwen 계열 어휘를 쓰는 Qwen3가 11.0까지 뚫린다는 점에서 토크나이저 차이만으로 설명되지는 않을 것으로 보이지만, 저자들 스스로도 GTE 강건성의 출처를 특정하지 못했다(8.1절).
6.5 Direct-transfer 블랙박스 결과
결과는 일률적으로 부정적이다. 소스 모델 8개 × 타깃 모델 8개 × 데이터셋 3개 조합 전체에서(, 5개 시드), 전이 ASR@20이 모두 1% 미만이었다. 화이트박스에서 89-99%가 뚫린 Contriever조차 다른 모델로 만든 적대적 문서에는 거의 반응하지 않았다. 모든 값이 0 근처라 별도 표 없이 본문으로만 보고했다.
Li et al. (2025)이 이미 비슷한 목적함수로 학습된 인코더 리트리버 사이에서도 직접 전이가 약하다고 보고한 바 있고, 이번에는 인코더, 범용 LLM, 추론 특화 LLM이 섞인 훨씬 이질적인 모델 집합이라 전이가 더 어려운 것이 자연스럽다. 아키텍처, 학습 방식, 임베딩 기하가 모두 다르기 때문이다.
실무적으로는 화이트박스 포이즈닝의 심각한 위험이 "아무 접근 권한 없는 직접 전이" 조건으로는 그대로 옮겨 가지 않는다는 뜻이다. 그렇다고 블랙박스 위험 전체가 무시할 만하다는 뜻은 아니다. 문헌의 강한 블랙박스 공격은 충실한 대리 모델을 먼저 만들고 화이트박스 최적화를 하므로 화이트박스 상한에 훨씬 가까이 갈 수 있다. 저자들도 대리 모델 기반 공격을 중요한 미해결 위협으로 남긴다. 솔직히 직접 전이가 안 된다는 결과는 예상 범위 안이라 정보량이 크지 않다. 오픈소스 임베딩 모델을 그대로 가져다 쓰는 서비스가 대부분이라는 현실을 생각하면, 공격자가 같은 공개 체크포인트로 화이트박스 공격을 하는 시나리오가 오히려 더 현실적인 위협일 수 있다.
6.6 RQ2 종합
LLM 리트리버의 강건성 이득은 교란 유형별로 다르며 균일하지 않다. 오타와 화이트박스 포이즈닝에서는 강한 LLM 리트리버(특히 GTE, ReasonIR, Qwen3)가 인코더 모델보다 확실히 낫다. 반면 의미를 보존하는 쿼리 재구성, 특히 동의어 치환은 모델 계열을 가리지 않고 불안정성의 큰 원천으로 남는다. GTE는 쿼리 측과 문서 측 모두에서 가장 일관되게 안정적이고, 추론 특화 학습은 어느 쪽에서도 일관된 안정성 이점을 주지 않는다.
7. RQ3 결과: 무엇이 강건성을 예측하는가
세 후보 요인을 두 가지 분석으로 본다. 임베딩 등방성과 스펙트럴 노름은 RQ2 안정성 지표와의 모델 간 상관 분석, 모델 크기는 Qwen3 임베딩 패밀리 안에서의 스케일링 분석이다.
7.1 임베딩 등방성
임베딩 기하는 방향 집중도, 차원 활용도, 노름 분포, 국소 이웃 구조 등을 포괄하는 넓은 개념이다. 저자들은 그중 "의미 정보가 공간에 얼마나 고르게 퍼져 있는가"를 포착한다고 알려진 등방성을 다루기 쉬운 대표 지표로 골랐다. 등방성은 서로 관련 있지만 구별되는 두 성질로 나뉜다.
각도 균일성(Angular uniformity): 임베딩 벡터들이 좁은 원뿔에 몰리지 않고 여러 방향으로 퍼져 있는가. 평균 쌍별 코사인 유사도로 측정하며, 낮을수록 각도 균일성이 높다. 무작위로 뽑은 임베딩 쌍 집합 에 대해
분산 균일성(Variance uniformity): 임베딩 공간의 각 차원을 고르게 쓰는가. IsoScore(Rudman et al., 2022)로 측정하며 1에 가까울수록 균일하고, 낮으면 일부 차원에만 의존한다는 뜻이다. 임베딩 10만 개를 무작위로 뽑아 계산한다.
측정은 각 데이터셋의 코퍼스 임베딩으로 한다. 쿼리 집합은 작고 데이터셋마다 크기 차이가 커서, 기하 추정에는 훨씬 크고 안정적인 코퍼스 표본이 낫다는 판단이다. 쿼리와 문서가 같은 공간에 임베딩되므로 코퍼스 쪽 기하로도 검색에 관련된 표현 공간을 비교할 수 있다. BM25는 dense 임베딩이 없고, Contriever는 L2 노름 팽창 때문에 스코어가 교란되어 있어 상관을 왜곡하므로 제외했다. 결국 각 상관은 7개 모델로 계산된다.
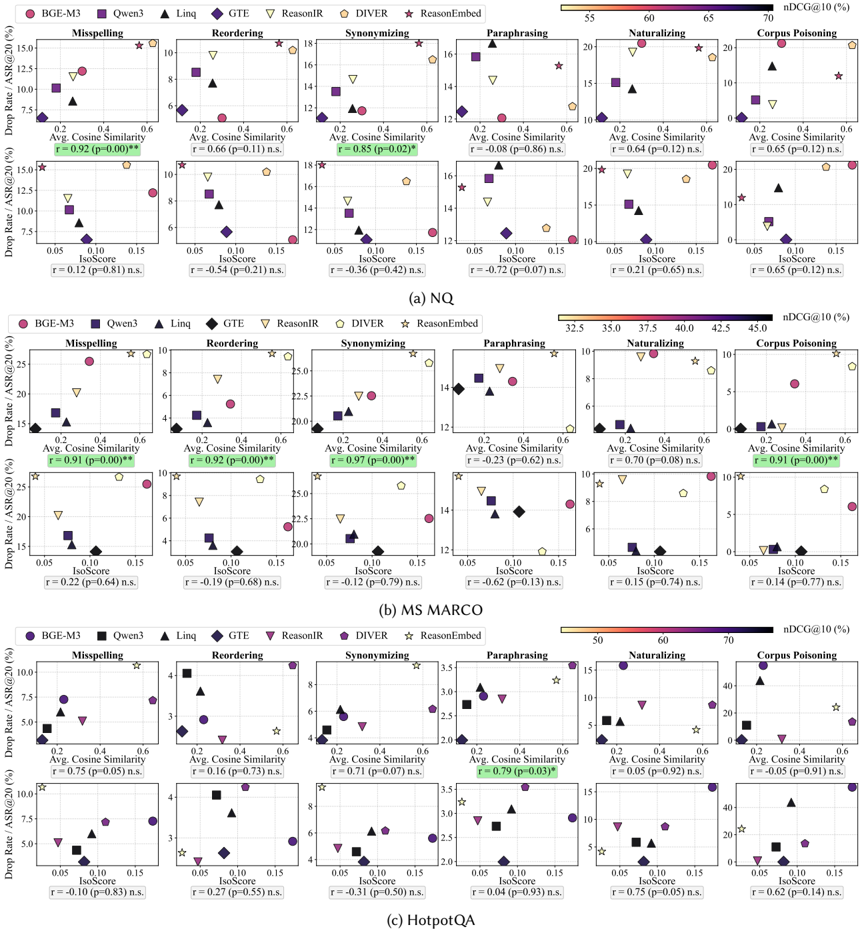
Figure 2: 코퍼스 임베딩에서 계산한 등방성 지표와 RQ2 강건성 지표 간 피어슨 상관. (a) NQ, (b) MS MARCO, (c) HotpotQA. 각 하위 그림은 2 × 6 산점도이며 점 하나가 리트리버 하나다. 윗줄은 각도 균일성(평균 코사인 유사도), 아랫줄은 분산 균일성(IsoScore) 대 강건성 지표이고, 열은 다섯 가지 쿼리 변형(nDCG@10 하락률, %)과 코퍼스 포이즈닝(ASR@20, %)이다. 각 패널에 피어슨 r과 p값을 표시했고 초록 상자는 p < 0.05다. 점 색은 깨끗한 조건의 nDCG@10, 마커 모양은 리트리버를 나타낸다. (원논문)
각도 균일성은 어휘 및 표면 수준 강건성의 신호다. 평균 코사인 유사도가 높을수록(벡터가 몰려 있을수록) 어휘 및 표면 수준 교란에 취약하다는 것이 가장 뚜렷한 모델 간 신호로 나타났다. NQ에서 Misspelling(r = 0.92, p < 0.01)과 Synonymizing(r = 0.85, p < 0.05)이 유의하다. MS MARCO에서는 더 강해서 Misspelling(r = 0.91), Reordering(r = 0.92), Synonymizing(r = 0.97)이 모두 p < 0.01이다. 같은 데이터셋에서 코퍼스 포이즈닝과도 강하게 상관한다(r = 0.91, p < 0.01). 저자들은 몰린 임베딩 공간이 정확한 용어 정렬에 의존하는 공격 패턴에 더 취약할 가능성과 일관된다고 해석한다. HotpotQA에서는 Misspelling(r = 0.75, p = 0.05)과 Synonymizing(r = 0.71, p = 0.07)이 같은 방향의 추세를 보인다.
Paraphrasing은 HotpotQA에서만 유의한 상관(r = 0.79, p < 0.05)을 보이고 NQ, MS MARCO에서는 없다. 저자들은 HotpotQA 쿼리의 다중 홉 성격과 관련 있을지 모른다고 가설을 세우면서도, 다른 데이터셋에서 반복되지 않으므로 탐색적 패턴으로만 해석한다. 결국 각도 균일성의 주된 연관은 의미 수준이 아니라 어휘 및 표면 수준 안정성과의 연관이다.
분산 균일성은 암시적이지만 일관되지 않다. IsoScore는 쿼리 변형에 대해 일관된 패턴이 없다. 상관이 약하고 데이터셋과 변형 유형에 따라 방향마저 바뀐다. 코퍼스 포이즈닝에서는 NQ(r = 0.65)와 HotpotQA(r = 0.62)에서 양의 추세가 보이지만 유의하지 않고, MS MARCO는 r = 0.14로 약하다. 차원 활용도가 높을수록 포이즈닝에 더 취약할 가능성은 열려 있지만, 통계적으로나 데이터셋 간으로나 아직 신뢰할 만한 패턴은 아니다.
결과 자체보다 해석의 견고함을 따져 볼 필요가 있다. 그림을 보면 평균 코사인 유사도 축에서 DIVER와 ReasonEmbed가 약 0.55-0.65로 오른쪽 끝에 떨어져 있고, 나머지 5개 모델은 0.1-0.35 사이에 모여 있다. 동시에 이 두 모델은 Misspelling과 Synonymizing에서 가장 크게 떨어지는 축에 속한다. 7개 점 중 2개가 멀리 떨어진 상황에서 r = 0.9대는 상당 부분 이 두 점의 지렛대 효과(leverage)에서 나온다. 또한 이 두 점은 "추론 특화 학습"이라는 공통 레시피를 공유하므로, 각도 균일성이 강건성을 예측한다기보다 학습 레시피라는 공통 원인이 둘 다를 결정했을 수도 있다. 검정 횟수도 많다. Figure 2에만 2개 지표 × 6개 강건성 지표 × 3개 데이터셋 = 36개 검정이 있고 다중 비교 보정은 하지 않았다. n = 7에서 p < 0.05를 넘으려면 |r| ≥ 0.75 정도가 필요하므로 유의한 상관은 모두 큰 값이지만, 그만큼 점 하나의 위치에 민감하다. 저자들이 "소표본 신호"라고 계속 단서를 다는 것은 적절하고, 각도 균일성에서 18개 중 7개가 유의하게 나온 패턴 자체는 우연으로 치부하기 어렵다. 다만 "강건성의 예측 변수"라기보다 "취약한 모델 집단을 가려내는 진단 신호"로 읽는 것이 데이터에 더 충실하다.
7.2 모델 크기
인코더 리트리버에서는 크기가 커지면 효과성과 강건성이 함께 개선되지만 항상 단조적이지는 않다는 선행 연구(Liu et al., 2025)가 있다. 디코더 임베딩 모델에서도 그런지 보기 위해, 아키텍처 교란을 줄이고자 0.6B, 4B, 8B 세 크기가 공개된 Qwen3 임베딩 패밀리를 RQ2와 같은 프로토콜(쿼리 변형 하락률, ASR@20)로 평가했다.
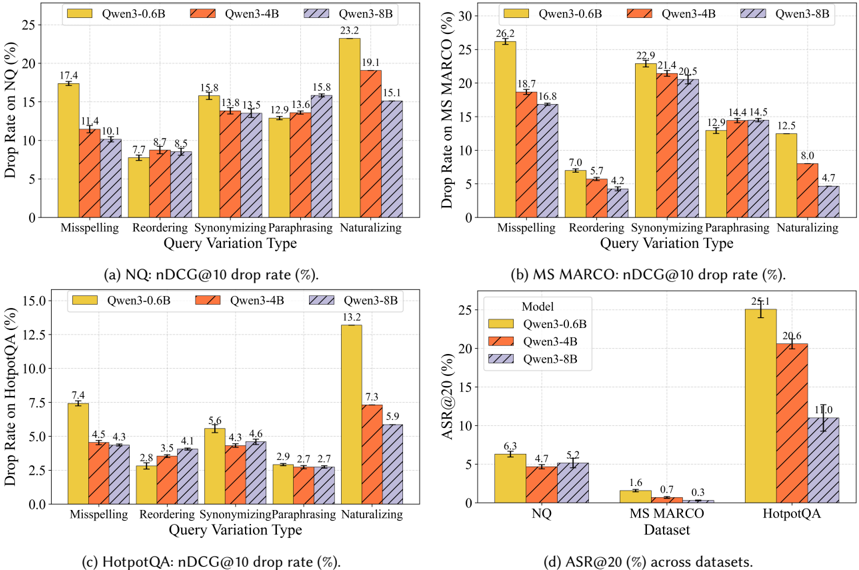
Figure 3: Qwen3 모델 크기가 쿼리 변형과 코퍼스 포이즈닝 강건성에 미치는 영향. (a-c) NQ, MS MARCO, HotpotQA에서 다섯 가지 쿼리 변형에 따른 nDCG@10 하락률(%). (d) 데이터셋별 코퍼스 포이즈닝 공격 성공률(ASR@20, %). 낮을수록 강건하며 오차 막대는 랜덤 시드에 대한 ±1 표준편차다. (원논문)
쿼리 변형에서는 대체로 큰 모델일수록 하락률이 작다. Misspelling, Synonymizing, Naturalizing에서 추세가 뚜렷하다. NQ Misspelling은 0.6B 17.4% → 4B 11.4% → 8B 10.1%, MS MARCO Misspelling은 26.2% → 18.7% → 16.8%, MS MARCO Naturalizing은 12.5% → 8.0% → 4.7%로 줄어든다. HotpotQA Naturalizing도 13.2% → 7.3% → 5.9%다.
Reordering과 Paraphrasing의 개선은 약하고 데이터셋 의존적이라고 저자들은 쓰는데, 숫자를 보면 "약하다"보다 "반대 방향"인 경우도 있다. NQ Paraphrasing은 12.9% → 13.6% → 15.8%로 크기가 커질수록 오히려 나빠진다. MS MARCO Paraphrasing도 12.9% → 14.4% → 14.5%로 소폭 악화되고, HotpotQA Reordering은 2.8% → 3.5% → 4.1%로 단조 증가한다. 크기를 키우면 표면 형태 교란에는 강해지지만 구조적, 의미적 재구성에 대해서는 개선이 보장되지 않는다는 저자들의 해석이 맞다. 오히려 큰 모델이 어순과 표현의 미세한 차이를 더 민감하게 인코딩한다는 해석도 가능해 보인다.
코퍼스 포이즈닝(Figure 3(d))에서도 ASR@20이 크기에 따라 줄어드는 경향이다. HotpotQA에서 25.1% → 20.6% → 11.0%로 가장 뚜렷하고, MS MARCO도 1.6% → 0.7% → 0.3%로 같은 패턴이다. NQ는 6.3% → 4.7% → 5.2%로 4B가 8B보다 약간 낫다.
Qwen3 패밀리의 효과성이 크기와 함께 오른다는 기존 결과와 합치면, 같은 패밀리 안에서 모델 크기는 쓸 만한 강건성 신호라는 것이 저자들의 결론이다. 다만 패밀리를 넘어서는 검증은 남아 있다. RQ2에서 4B인 DIVER가 8B인 ReasonEmbed보다 화이트박스 포이즈닝에 더 강하거나 비슷한 경우가 있고, 7B인 GTE가 모든 모델을 이긴다는 점을 보면 패밀리 간에는 크기가 강건성을 설명하지 못한다.
7.3 스펙트럴 노름
마지막 요인은 립시츠 평활도(Lipschitz smoothness)의 대리 지표로서의 평균 스펙트럴 노름이다. 연속 입력 설정에서는 국소 립시츠 민감도가 낮을수록 강건하다는 이론적 근거가 있다. 대형 트랜스포머에서 정확한 국소 추정은 비현실적이라, 각 모델의 주요 가중치 행렬(쿼리, 키, 값, 출력 프로젝션과 피드포워드 층)의 스펙트럴 노름을 파워 이터레이션(power iteration)으로 구하고 층 전체에 걸쳐 평균한다.
는 모든 층의 주요 가중치 행렬 집합, 는 행렬 의 최대 특이값이다. 등방성 분석과 같이 BM25와 Contriever는 제외했다.
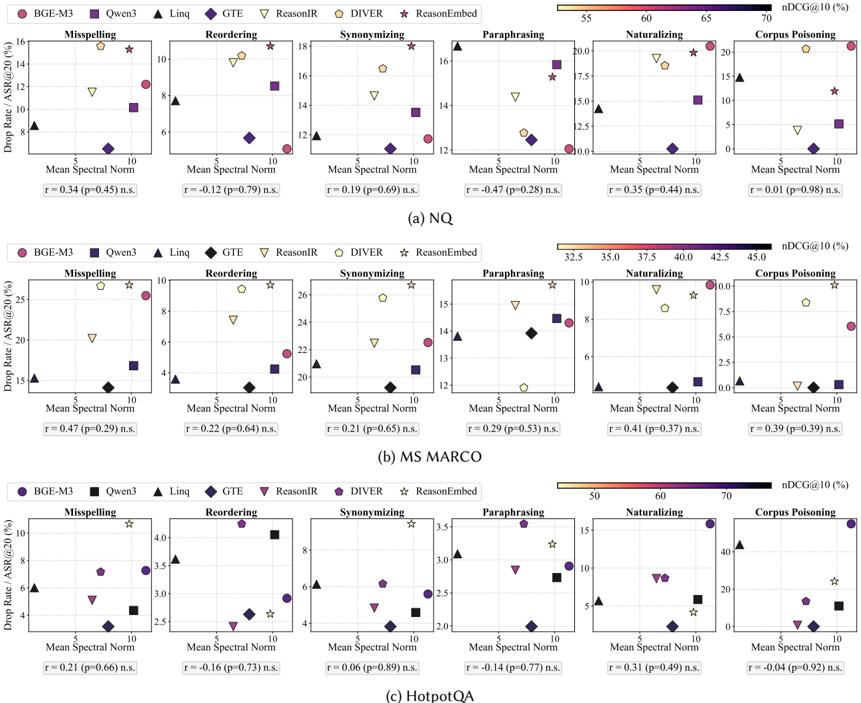
Figure 4: 평균 스펙트럴 노름과 RQ2 강건성 지표 간 피어슨 상관. (a) NQ, (b) MS MARCO, (c) HotpotQA. 각 하위 그림은 산점도 6개로 구성되며 점 하나가 리트리버 하나, x축은 평균 스펙트럴 노름이다. 열은 다섯 가지 쿼리 변형(nDCG@10 하락률, %)과 코퍼스 포이즈닝(ASR@20, %)이며, 각 패널에 피어슨 r과 p값을 표시했다. 점 색은 깨끗한 조건의 nDCG@10, 마커 모양은 리트리버를 나타낸다. (원논문)
18개 상관 중 통계적으로 유의한 것은 하나도 없다. 제한적인 패턴은 있다. Misspelling은 세 데이터셋 모두에서 양의 상관(NQ r = 0.35, MS MARCO 0.47, HotpotQA 0.21)이고, Naturalizing도 그렇다(0.35, 0.41, 0.31). 스펙트럴 노름이 클수록 어휘 노이즈에 민감할 수 있다는 약한 신호지만 유의하지 않다. Reordering, Synonymizing, Paraphrasing은 일관성이 없거나 0에 가깝다. 코퍼스 포이즈닝도 MS MARCO만 r = 0.39이고 NQ(0.01)와 HotpotQA(-0.04)는 관계가 없다.
어느 정도 예상할 만한 결과다. 스펙트럴 노름의 이론적 동기는 연속 교란 분석에 뿌리를 두는데, dense retrieval의 입력은 이산 토큰이다. 잔차 연결(residual connection)과 층 정규화(layer normalization)도 층별 스펙트럴 노름과 전체 함수의 민감도 사이 연결을 약하게 만든다. 그림에서 Linq만 스펙트럴 노름이 1 근처로 다른 모델(약 6-12)과 동떨어져 있는데, 논문은 이 이유를 다루지 않는다. 다만 Linq는 9개 중 유일하게 Mistral 백본이라, 백본마다 가중치 스케일과 정규화 층의 배치가 다르면 층별 노름을 모델 간에 직접 비교하는 것 자체가 큰 의미가 없을 수 있다. 이 점도 상관이 약하게 나온 이유 중 하나로 보인다. 언어 모델의 국소 민감도를 더 정밀하게 추정하는 방법은 저자들도 미래 과제로 남긴다.
7.4 RQ3 종합
살펴본 요인 중 임베딩 등방성, 특히 각도 균일성이 가장 뚜렷한 모델 간 신호를 준다. 모델 크기는 Qwen3 패밀리 안에서 예비적 증거를 주고, 평균 스펙트럴 노름은 약하고 맥락 의존적인 연관만 보인다. 저자들은 매끄러움(smoothness) 대리 지표보다 표현 기하가 강건성을 들여다보는 더 유익한 렌즈라고 정리한다.
8. 논의: 상관에서 인과로, 그리고 실무 가이드라인
8.1 개입 실험: 상관-인과 간극 찔러 보기
각도 균일성이 어휘 강건성과 상관한다면, 학습 중에 각도 균일성을 직접 최적화하면 강건성이 좋아질까? 이를 확인하기 위해 Qwen3-0.6B를 MS MARCO에서 LoRA로 파인튜닝하는 통제 실험 두 가지를 수행했다.
각도 균일성 정규화: 학습 목적함수에 문서 임베딩 간 평균 쌍별 코사인 유사도를 낮추는 코사인 패널티를 추가했다. 개입은 기하를 확실히 바꿨다. FiQA에서 평균 코사인 유사도가 0.801에서 0.139로 떨어졌고, 같은 데이터셋의 검색 효과성은 그대로였다(두 조건 모두 nDCG@10 = 35.5). 그런데 다섯 가지 쿼리 변형으로 평가하면 일관된 강건성 개선이 없었다. 정규화로 평균 코사인 유사도를 낮추는 것만으로는 쿼리 측 안정성이 좋아지지 않는다는 뜻이고, 저자들은 각도 균일성을 독립적인 학습 신호보다는 진단 지표로 쓰는 것이 낫다고 결론 낸다.
이 결과는 꽤 수긍이 간다. 평균 코사인 유사도는 모든 임베딩이 공유하는 공통 방향 성분(common direction)에 크게 좌우된다. 그 공통 성분을 줄이는 것은 비교적 쉬운 변형이고, 쿼리와 문서 사이의 상대적 순위나 국소 이웃 구조를 크게 건드리지 않을 수 있다. 효과성이 정확히 35.5로 유지됐다는 사실도 정규화가 순위에 관여하는 구조를 거의 바꾸지 않았음을 암시한다. 교란에 대한 강건성은 "교란된 쿼리가 원래 쿼리의 이웃에 머무는가"라는 국소 구조의 문제이므로, 전역 통계량을 바꾸는 것만으로 해결되기를 기대하기는 어렵다. 한편 0.801이라는 기준 모델의 코사인 유사도는 Figure 2의 상용 8B 모델들(대체로 0.1-0.35)보다 훨씬 높은데, 이 차이가 LoRA 파인튜닝 설정에서 온 것인지에 대한 설명은 없다.
양방향 어텐션 전환: GTE의 양방향 어텐션 설계에서 착안해, 같은 통제 설정에서 Qwen3-0.6B를 양방향 어텐션으로 바꾸고 MS MARCO로 파인튜닝했다. 인과적 어텐션 기준선 대비 일관된 강건성 개선은 없었다. 양방향 전환이 의미 있는 이득을 내려면 대규모 지속 사전학습이 필요하다는 선행 연구(Eslami et al., 2026)를 고려하면, MS MARCO 규모의 실험은 그 효과를 드러내기에 부족했을 수 있다. 그래서 어텐션 방향성은 "그럴듯하지만 검증되지 않은" 요인으로 남는다.
참조점으로서의 GTE: GTE는 화이트박스 포이즈닝에서 유일하게 ASR 0%를 달성했고 쿼리 변형 전반에서도 가장 안정적이었다. 하지만 위 두 개입 중 어느 것도 단독으로는 이 수준을 재현하지 못했다. GTE의 학습 세부(데이터 구성, 목적함수, 최적화 선택)가 공개되어 있지 않아 원인을 확정할 수 없으므로, 저자들은 GTE를 위협 모델 하의 강력한 경험적 참조점으로만 두고 그 강건성의 출처를 열린 연구 질문으로 남긴다.
부정적 결과를 숨기지 않고 보고한 점은 높이 평가한다. 다만 이 절에는 수치 표가 없다. "일관된 개선이 없었다"는 서술만 있고 변형 유형별 하락률이 기준선 대비 얼마였는지가 빠져 있어서, 개선이 정말 0인지, 일부 유형에서는 있었는데 일관되지 않았던 것인지 독자가 판단할 수 없다. 0.6B 모델 하나, LoRA, MS MARCO 단일 데이터라는 설정도 결론의 일반성을 제한한다.
8.2 실무 가이드라인
RQ1-RQ3와 개입 실험을 종합해 저자들은 네 가지 지침을 제시한다.
평가: 여러 강건성 축을 모두 덮어라. 다섯 가지 변형은 질적으로 다른 실패 모드를 드러내고, 하나의 종합 강건성 점수로는 포착되지 않는다. 오타에 강한 모델이 의미 재구성에는 약할 수 있고, 코퍼스 포이즈닝 내성은 쿼리 측 안정성과 다른 패턴을 따른다. 따라서 최소한 문자 수준 교란 하나, 의미 재구성 하나, 문서 측 적대적 공격 하나를 포함하고, 결과를 교란 유형과 데이터셋별로 따로 보고하라고 권한다.
모델 선택: 규모나 아키텍처만으로 강건성을 추론하지 마라. 파라미터 수, 인코더 대 디코더, 추론 특화 대 instruction-augmented 같은 거친 속성 중 어느 것도 일반화나 강건성을 믿을 만하게 예측하지 못했다. 넓은 전이가 필요하면 GTE와 Qwen3가, 화이트박스 포이즈닝이 주된 우려라면 GTE와 ReasonIR이 가장 강하다. Qwen3 패밀리 안에서는 크기가 클수록 하락률과 ASR이 줄지만, 이 추세가 아키텍처를 넘어 일반화되지는 않는다. 아키텍처 라벨이나 파라미터 수보다 관련 조건에서 경험적으로 검증된 행동을 우선하라는 것이다.
학습과 손실 설계: 기하는 독립 학습 목표보다 진단 도구로 쓰라. 낮은 평균 코사인 유사도를 강건성 학습 목표로 삼지 말고, 사후 진단(post-hoc diagnostic)으로 쓰라고 권한다. 평균 코사인 유사도가 높은(몰린) 모델은 어휘 교란에 취약할 가능성이 크니, 그때는 기하에 직접 페널티를 주기보다 학습 데이터 다양성과 목적함수 설계를 들여다보라는 것이다. 오타 강건성은 typo-aware 대조 사전학습 등으로 이미 다뤄지기 시작했지만, 동의어 치환은 여전히 모든 계열에서 어렵고 패러프레이즈는 짧은 쿼리 설정(MS MARCO, FiQA)에서 특히 파괴적이다. 원래 쿼리와 패러프레이즈 쿼리의 표현을 정렬하는 일관성 손실(consistency loss)처럼, 이 더 어려운 불변성을 직접 겨냥하는 학습 목표 개발이 우선순위 높은 과제로 제시된다.
위협 모델 보정: 화이트박스와 전이 위험은 비대칭이다. 화이트박스 포이즈닝은 고예산()에서 여러 모델에 실제 위험이고 HotpotQA가 가장 어렵다. 반면 직접 전이는 모든 모델 쌍에서 ASR이 0에 가깝다. 모델 가중치에 대한 적대적 접근이 그럴듯하면 화이트박스 강건성을 우선하고, 무접근 직접 전이 설정에서는 실질 위험이 훨씬 낮다고 보라는 조언이다. 평가하지 않은 대리 모델 기반 블랙박스 공격은 여전히 중요한 미해결 위협이다.
9. 관련 연구와의 위치
이 논문을 주변 연구와 놓고 보면 위치가 분명해진다. 쿼리 변형 쪽에서 Penha et al. (2022)은 다섯 가지 변형 생성기를 만들고 BERT 시대 파이프라인을 평가했고, Hagen et al. (2024)은 초기 LLM 모델까지 포함해 이를 재검토했다. 이 논문은 같은 변형 체계를 2025년 이후 LLM 리트리버 6종에 적용하고, 문서 측 공격과 같은 모델 집합 안에서 비교했다는 점에서 한 단계 확장이다.
문서 측에서는 Zhong et al. (2023)의 코퍼스 포이즈닝, 저자들 자신의 HotFlip 재현(Li et al., ECIR 2025)과 연속 공간 공격(Li et al., SIGIR 2025)이 직접적인 기반이다. 이번 연구는 새로운 공격을 만들지 않고 기존 프로토콜을 LLM 리트리버로 넓혀 "어떤 LLM 리트리버가 뚫리고 어떤 것이 버티는가"의 지도를 그렸다.
스케일링 관점에서는 Liu et al. (SIGIR 2025)이 인코더 리트리버의 강건성-효과성 스케일링을 다뤘고, 이 논문의 Qwen3 패밀리 분석은 디코더 모델에 대한 첫 예비 증거에 해당한다. 일반화 평가에서는 BEIR, BRIGHT가 벤치마크 수준 비교를 제공했다면, 이 논문은 30개 데이터셋을 태스크, 쿼리, 코퍼스 출처 요인으로 재분류하고 LMM으로 분석했다는 점이 차별점이다. Wu et al. (TOIS 2023)과 Liu et al. (TOIS 2025)의 개념적 강건성 틀을 실증적으로 채운 작업으로 보는 것이 가장 정확하다.
임베딩 기하 쪽에서는 이방성이 해로운지에 대한 논쟁(Ait-Saada & Nadif, 2023; Fuster Baggetto & Fresno, 2022; Rudman & Eickhoff, 2024)이 진행 중인데, 이 논문의 개입 실험은 "상관은 있지만 직접 최적화는 효과 없음"이라는 결과로 회의론 쪽에 증거를 하나 보탠다.
10. 강점과 한계
강점
- 넓고 일관된 평가 범위: 9개 모델 × 30개 데이터셋(RQ1), 8개 모델 × 4개 데이터셋 × 5가지 변형 × 5개 시드(쿼리 측), 8개 모델 × 3개 데이터셋 × 2개 예산 × 5개 시드에 8×8 전이 조합(문서 측)까지, 같은 모델 집합으로 쿼리 측과 문서 측을 함께 본 연구는 드물다. Table 9처럼 시드 표준편차까지 보고한 점도 신뢰도를 높인다.
- "전문화 세금"이라는 실용적 발견: ReasonEmbed가 BRIGHT 12개 중 9개에서 1위를 하면서 Quora에서 48.5로 무너지는 대비(Table 4)는 추론 벤치마크 리더보드만 보고 모델을 고르는 관행에 대한 구체적 경고다.
- 교란 유형별로 다른 강건성 프로필: 오타에는 LLM이 확실히 강하지만 동의어 치환에는 모두가 약하다는 결과(Figure 1)는 "LLM이면 강건하다"는 막연한 기대를 교정한다. 평가 시 여러 축을 따로 보고하라는 지침도 이 증거에 단단히 기대고 있다.
- 정직한 서술과 부정적 결과 보고: 상관을 인과로 과장하지 않고 개입 실험의 실패까지 보고했다. "plausible but unverified", "small-sample signals" 같은 단서가 반복되는데, 과장 없이 증거 수준에 맞춘 서술이라 신뢰가 간다.
- 재현성: 코드, 설정, 프롬프트 템플릿을 공개했고, 적대적 문서 공개에 대한 책임 있는 공개 원칙도 밝혔다.
한계 및 아쉬운 점
- LMM의 실제 의미: 5.4절에서 계산했듯이 Table 6의 모델 간 격차는 쿼리 가중 원시 평균과 정확히 일치한다. 랜덤 절편만 있는 모델 구조에서는 데이터셋 효과가 모델 간 비교에서 소거되기 때문이다. 결과적으로 Quora(Online Community 쿼리의 87.7%)나 MS MARCO dev(Passage Retrieval의 98.6%) 같은 큰 데이터셋이 요인 수준 결론을 지배하고, 데이터셋 단순 평균을 쓰면 Online Community에서 ReasonEmbed가 꼴찌에서 1위로 바뀐다. 모델 × 데이터셋 랜덤 기울기를 넣거나 두 가중 방식을 병기했다면 결론의 견고함을 보여줄 수 있었을 것이다.
- ReasonEmbed 이상치의 원인 미규명: Quora 48.5, INSTRUCTION 0.2, Online Community 4.5가 모두 같은 뿌리일 가능성이 높은데, 원인 분석이 없다. Quora는 질문 대 질문의 대칭 태스크라 양쪽에 같은 instruction을 쓰는 등의 특수 처리가 흔한데, 기본 쿼리 프롬프트를 그대로 쓴 설정이 영향을 줬을 가능성도 하나의 후보다. 이런 설정 민감도를 확인하지 않으면 "전문화 세금"의 일부가 평가 설정에서 왔을 수 있다.
- 소표본 상관 분석: 등방성과 스펙트럴 노름 분석은 7개 점으로 계산되고, 54개 검정에 다중 비교 보정이 없다. 각도 균일성의 강한 상관은 평균 코사인 유사도가 유독 높은 DIVER와 ReasonEmbed 두 점의 지렛대 효과와 학습 레시피라는 교란 변수에서 자유롭지 않다. 같은 모델의 여러 체크포인트나 같은 패밀리의 크기 변형을 추가해 점의 수를 늘리는 설계가 필요해 보인다.
- 변형의 의미 보존 미검증: Table 7의 동의어 치환 예시("come out → arriving out")처럼 변형이 쿼리 의미를 깨뜨리는 경우, 하락분이 모델 취약성인지 relevance 라벨의 무효화인지 구분되지 않는다. "동의어 치환이 모든 모델을 흔든다"는 주요 결론과 일관성 손실을 우선 과제로 꼽은 가이드라인이 이 부분에 기대고 있어 아쉽다. 표본 일부라도 사람이 의미 보존 여부를 판정하거나 LLM 판정기로 필터링했다면 결론이 훨씬 단단해졌을 것이다.
- GTE 0% ASR의 해석: 30번 실행 모두 0.0이라는 결과가 강건성인지 공격 최적화 실패인지 가려줄 공격 측 진단이 없다. 이 결과가 "GTE가 가장 강건한 참조점"이라는 결론의 큰 축이라 더 아쉽다.
- 개입 실험의 정량 보고 부재: 각도 균일성 정규화와 양방향 전환 모두 수치 없이 "일관된 개선 없음"으로만 요약되었다. 0.6B LoRA 단일 설정이라는 범위도 좁다.
- 본문과 표/그림의 불일치: BrowseComp-Plus "최고 모델도 5점 미만"(Table 4에서는 20.1), MS MARCO Misspelling의 BGE-M3 "약 17%"와 범용 LLM "6-12%"(Figure 1에서는 각각 약 25%, 14-17%) 같은 서술 오류가 보인다. 결론을 바꿀 정도는 아니지만 TOIS 최종본에서는 정리되어야 할 부분이다.
- 스케일링 결과의 해석: Figure 3에서 NQ Paraphrasing(12.9 → 15.8%)과 HotpotQA Reordering(2.8 → 4.1%)은 크기가 커질수록 나빠지는데, 본문은 "개선이 약하다" 정도로 서술한다. 크기가 표면 교란에는 도움이 되지만 의미 교란에는 해가 될 수도 있다는 더 흥미로운 가설로 이어질 수 있는 지점이다.
- 저자들이 밝힌 한계: 모델 집합이 대표적이지만 망라적이지 않고, 영어 데이터만 다루며, 대리 모델 기반 블랙박스 공격과 학습 시점 백도어 공격은 평가하지 않았다. 기하 분석은 상관 위주이고 코퍼스 임베딩을 대리 지표로 썼으며, 크기 분석은 Qwen3 패밀리에 한정되고, 계산 제약으로 포이즈닝 실험은 세 데이터셋에 그쳤다. 멀티벡터와 학습형 희소 모델도 범위 밖이다. 방어 기법(퍼플렉시티 필터 등)이 평가에 들어가지 않은 점도 실무적 해석을 제한한다.
11. 마치며
이 논문이 남기는 메시지는 간단하다. LLM 기반 dense retrieval의 강건성은 여러 차원으로 이루어진 성질이라, 아키텍처 선택 하나, 모델 크기 하나, 기하 통계량 하나로 추론할 수 없다. 범용 instruction-augmented LLM 리트리버는 일반화, 오타 내성, 화이트박스 포이즈닝 내성에서 인코더 모델을 분명히 앞서지만, 의미를 보존하는 재구성 앞에서는 여전히 흔들린다. 추론 특화 모델은 BRIGHT에서 얻은 것을 다른 곳에서 내준다. 그리고 각도 균일성은 취약한 모델을 가려내는 데는 쓸모 있지만 그것을 직접 고친다고 강건해지지는 않는다.
개인적으로 이 논문의 가장 큰 가치는 결론보다 평가 관행에 대한 문제 제기에 있다고 본다. 리더보드 평균 하나로 리트리버를 고르던 관행에 "어떤 조건에서, 어떤 교란에 대해, 어떤 위협 모델 하에서"라는 질문을 붙이도록 만든다. 실무에서 RAG용 리트리버를 고를 때 자기 도메인의 쿼리 분포와 위협 모델에 맞춰 직접 교란 테스트를 돌려 보라는 조언은 지금 바로 적용할 수 있다. GTE와 Qwen3가 대부분의 축에서 안전한 선택이라는 점, 그리고 BRIGHT 상위권 모델을 범용 검색에 쓰기 전에는 Quora 같은 일반 쿼리에서 반드시 점검해야 한다는 점도 바로 쓸 수 있는 교훈이다.
방법론 측면에서는 LMM 도입이 의미 있는 시도였지만, 5.4절에서 본 것처럼 랜덤 절편만으로는 모델 간 비교에서 데이터셋 크기 편향을 제거하지 못한다. 후속 연구가 이 틀을 채택한다면 랜덤 기울기를 포함하거나 가중 방식에 따른 민감도를 함께 보고하는 것이 좋겠다. 남은 연구 방향도 분명하다. 패러프레이즈와 동의어 치환에 대한 불변성을 직접 겨냥한 학습 목표, 대리 모델 기반 블랙박스 공격 평가, 비영어 검색으로의 확장, 그리고 GTE가 왜 그렇게 단단한지에 대한 해명이 다음 과제로 남아 있다.
References
- Li, Eustratiadis, Fan, Kanoulas, 2026. "On the Robustness of LLM-Based Dense Retrievers: A Systematic Analysis of Generalizability and Stability." arXiv:2604.16576.
- Penha, Câmara, Hauff, 2022. "Evaluating the Robustness of Retrieval Pipelines with Query Variation Generators." ECIR 2022.
- Hagen, Scells, Potthast, 2024. "Revisiting Query Variation Robustness of Transformer Models." Findings of EMNLP 2024.
- Zhong, Huang, Wettig, Chen, 2023. "Poisoning Retrieval Corpora by Injecting Adversarial Passages." EMNLP 2023.
- Li, Eustratiadis, Kanoulas, 2025. "Reproducing HotFlip for Corpus Poisoning Attacks in Dense Retrieval." ECIR 2025.
- Li, Eustratiadis, Lupart, Kanoulas, 2025. "Unsupervised Corpus Poisoning Attacks in Continuous Space for Dense Retrieval." SIGIR 2025.
- Liu et al., 2025. "On the Scaling of Robustness and Effectiveness in Dense Retrieval." SIGIR 2025.
- Liu et al., 2025. "Robust Neural Information Retrieval: An Adversarial and Out-of-Distribution Perspective." ACM TOIS.
- Wu et al., 2023. "Are Neural Ranking Models Robust?" ACM TOIS.
- Thakur et al., 2021. "BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models." NeurIPS Datasets and Benchmarks.
- Su et al., 2025. "BRIGHT: A Realistic and Challenging Benchmark for Reasoning-Intensive Retrieval." ICLR 2025.
- Chen et al., 2025. "BrowseComp-Plus: A More Fair and Transparent Evaluation Benchmark of Deep-Research Agent." arXiv:2508.06600.
- Zhang et al., 2025. "Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models." arXiv:2506.05176.
- Shao et al., 2025. "ReasonIR: Training Retrievers for Reasoning Tasks." COLM 2025.
- Long et al., 2025. "DIVER: A Multi-Stage Approach for Reasoning-intensive Information Retrieval." arXiv:2508.07995.
- Chen et al., 2025. "ReasonEmbed: Enhanced Text Embeddings for Reasoning-Intensive Document Retrieval." arXiv:2510.08252.
- Bolotova et al., 2022. "A Non-Factoid Question-Answering Taxonomy." SIGIR 2022.
- Ethayarajh, 2019. "How Contextual are Contextualized Word Representations?" EMNLP-IJCNLP 2019.
- Rudman et al., 2022. "IsoScore: Measuring the Uniformity of Embedding Space Utilization." Findings of ACL 2022.
- Zhuang & Zuccon, 2022. "CharacterBERT and Self-Teaching for Improving the Robustness of Dense Retrievers on Queries with Typos." SIGIR 2022.
- Weller et al., 2025. "On the Theoretical Limitations of Embedding-Based Retrieval." arXiv:2508.21038.
- Eslami et al., 2026. "Diffusion-Pretrained Dense and Contextual Embeddings." arXiv:2602.11151.