논문 리뷰
논문 리뷰: Rare Tokens Degenerate All Tokens: Improving Neural Text Generation via Adaptive Gradient Gating for Rare Token Embeddings
언어모델 임베딩이 좁은 원뿔 모양으로 퇴화하는 근본 원인을 희귀 토큰의 그래디언트 한 부분에서 찾아내고, 그 부분만 선택적으로 차단하는 Adaptive Gradient Gating(AGG)으로 전체 임베딩의 등방성을 되살린 ACL 2022 논문.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Rare Tokens Degenerate All Tokens: Improving Neural Text Generation via Adaptive Gradient Gating for Rare Token Embeddings |
| 저자 | Sangwon Yu, Jongyoon Song, Heeseung Kim, Seong-min Lee, Woo-Jong Ryu, Sungroh Yoon (서울대학교 Data Science & AI Lab, 현대자동차그룹 AIRS Company) |
| 학회/저널 | ACL 2022 (Long Paper) |
| 논문 링크 | aclanthology.org/2022.acl-long.3 |
1. 들어가며
언어모델을 학습시켜 놓고 토큰 임베딩을 꺼내 보면 꽤 불편한 사실을 마주하게 된다. 수만 개의 토큰 벡터가 고차원 공간에 고르게 퍼져 있을 것 같지만, 실제로는 한 방향으로 쏠린 좁은 원뿔(narrow cone) 안에 몰려 있다. 임의의 두 토큰 임베딩을 뽑아 코사인 유사도를 재면 의미와 무관하게 전반적으로 높게 나온다. Gao et al. (2019)이 표현 퇴화 문제(representation degeneration problem)라고 이름 붙인 이 현상은 임베딩의 표현력을 갉아먹는다. 서로 다른 토큰이 다 비슷해 보이니 모델이 토큰 사이의 의미 관계를 제대로 학습하기 어렵고, 생성 텍스트의 품질과 다양성도 떨어진다.
이 문제를 다룬 기존 연구가 없었던 것은 아니다. 다만 대부분은 "퇴화가 일어난 뒤의 현상"을 관찰하고, 그 현상을 완화하는 후처리나 정규화 항을 전체 토큰 임베딩에 일괄 적용하는 방식이었다. 증상을 보고 약을 쓰는 셈인데, 정작 학습 과정에서 임베딩이 왜, 어떻게 퇴화하는지에 대한 설명은 비어 있었다. 게다가 모든 토큰에 똑같이 손을 대다 보니, 이미 의미 관계가 잘 학습된 토큰까지 과도하게 정규화되는 부작용(over-regularization)이 따라왔다.
이 논문이 던지는 질문은 다르다. "퇴화는 언제 처음 시작되는가?"를 학습 역학(training dynamics) 관점에서 들여다본다. 저자들은 토큰을 출현 빈도로 나눠 학습 초기의 움직임을 추적하다가, 희귀 토큰(rare token)이 가장 먼저 퇴화하고 그 뒤를 이어 나머지 토큰이 끌려 들어가는 패턴을 발견한다. 여기서 한 발 더 들어가, 희귀 토큰 임베딩에 작용하는 그래디언트를 세 부분으로 분해하고 그중 특정 한 부분이 전체 퇴화의 방아쇠라는 점까지 짚어낸다. 그리고 그 부분만 골라 막는 Adaptive Gradient Gating(AGG)을 제안한다. 원인을 정확히 겨냥하기 때문에, 다수를 차지하는 빈번한 토큰에는 손을 대지 않고도 전체 임베딩 공간의 등방성(isotropy)을 회복시킬 수 있다는 것이 핵심 주장이다.
2. 배경과 기존 연구의 한계
2.1 신경망 언어모델의 텍스트 생성
대부분의 신경망 생성 모델은 텍스트 생성을 조건부 언어모델링으로 처리한다. 어휘 집합 과 각 토큰에 대응하는 임베딩 벡터 가 있고, 모델은 입력과 타깃 쌍 를 받아 번째 위치의 문맥 특징 벡터 를 계산한 뒤, 출력 소프트맥스 층에서 타깃 토큰 의 확률을 다음과 같이 산출한다.
여기서 는 출력 소프트맥스 층의 가중치 역할을 하는 출력 토큰 임베딩이고, 는 토큰 의 인덱스다. 눈여겨볼 점은 입력 임베딩과 출력 소프트맥스 가중치가 같은 행렬을 공유하는 weight tying 구조라는 것이다(Press and Wolf, 2017). 즉 토큰 임베딩이 입력 표현이자 출력 분류기의 가중치라는 이중 역할을 한다. 이 공유 구조 때문에 소프트맥스 학습에서 생긴 그래디언트가 곧바로 임베딩 기하 구조에 흔적을 남긴다. 이 논문의 분석이 소프트맥스 그래디언트에서 출발하는 이유도 여기에 있다.
학습은 음의 로그 우도(negative log likelihood)를 최소화하는 방식이다.
2.2 임베딩 공간의 문제들
문맥 임베딩 공간의 기하를 분석한 연구들은 임베딩 벡터 분포가 등방성과는 거리가 멀고 좁은 원뿔 공간을 차지한다는 점을 반복적으로 관찰해 왔다(Mu and Viswanath, 2018; Ethayarajh, 2019). Gao et al. (2019)이 이를 표현 퇴화 문제로 정식화했다. 퇴화가 일어나면 토큰 임베딩 사이의 전반적 코사인 유사도가 올라가고, 결과적으로 모델이 토큰 간 의미 관계를 학습하기 어려워진다.
이 문제가 왜 생성 품질까지 해치는지에 대한 설명으로는 Demeter et al. (2020)의 "stolen probability"가 설득력 있다. 출력 층에서 로짓을 계산할 때 임베딩의 노름(norm) 정보가 너무 지배적이어서 각도 정보가 무시되고, 그 결과 노름이 작은 임베딩은 문맥과 무관하게 항상 낮은 확률을 배정받는다. 이렇게 특정 토큰이 구조적으로 억눌리면 생성 텍스트의 다양성이 줄어든다.
기존 해법은 크게 두 갈래였다. 하나는 학습이 끝난 임베딩 벡터를 후처리하는 방식(Mu and Viswanath, 2018; Biś et al., 2021)이고, 다른 하나는 퇴화로 나타난 현상을 억제하는 정규화 항을 손실에 추가하는 방식(Gao et al., 2019; Wang et al., 2019; Wang et al., 2020)이다. 두 갈래 모두 공통된 약점이 있다. 전체 토큰 임베딩에 일괄 적용되기 때문에, 의미 관계가 이미 잘 학습된 임베딩까지 건드리는 과도한 정규화가 발생한다. 그리고 어디까지나 "퇴화의 결과"를 다룰 뿐, 학습 역학 자체에 기반한 접근은 아니었다.
빈도 편향(frequency bias)도 임베딩 공간의 또 다른 숙제다. Ott et al. (2018)은 기계 번역에서 희귀 토큰이 구조적으로 과소평가되는 현상을 분석했고, Gong et al. (2018)은 언어모델 임베딩이 빈도 쪽으로 편향된다는 점을 관찰해 적대적 학습(FRAGE)으로 대응했다. 이 논문은 뒤에서 자신들의 AGG가 빈도 편향 완화와도 연결된다는 점을 시각화로 보여준다.
3. 핵심 관찰: 희귀 토큰이 전체를 퇴화시킨다
방법론에 앞서, 이 논문의 설득력은 상당 부분 3절의 경험적 분석에서 나온다. 저자들은 WikiText-103으로 Transformer 언어모델을 처음부터 학습시키면서, 어휘 전체를 출현 빈도 기준으로 빈번(frequent) 30%, 중간(medium) 50%, 희귀(rare) 20% 세 그룹으로 나눈다.
3.1 학습 초기의 임베딩 역학
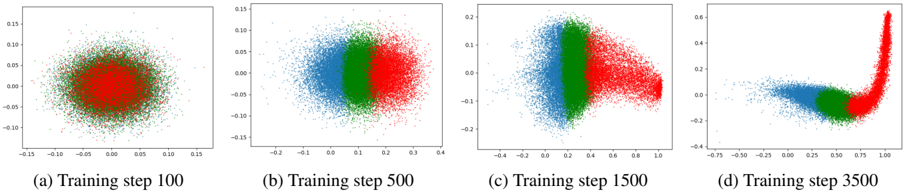
Figure 1: WikiText-103으로 학습한 언어모델의 토큰 임베딩 시각화. 빨강, 초록, 파랑은 각각 희귀, 중간, 빈번 그룹을 나타낸다. (a)~(d)는 서로 다른 학습 스텝의 분포다. (원논문)
SVD로 임베딩을 2차원에 투영해 학습 초기의 움직임을 찍은 것이 Figure 1이다. 스텝 100(a)에서는 세 그룹이 원점 주변에 뒤섞여 등방적으로 퍼져 있다. 그런데 스텝 500(b)을 보면 빨간 점, 즉 희귀 그룹이 먼저 한쪽 방향으로 삐져나오기 시작한다. 스텝 1500(c)에서는 그 쏠림이 뚜렷해지고, 스텝 3500(d)에 이르면 전체 분포가 가느다란 곡선 형태로 접혀 들어가면서 세 그룹이 모두 좁은 영역에 눌린다. 퇴화가 희귀 그룹에서 시작해 나머지로 전파된다는 것을 눈으로 확인할 수 있는 셈이다. 이 관찰에서 "희귀 토큰 임베딩의 퇴화가 비희귀 토큰 임베딩의 퇴화를 유발한다"는 가설이 나온다.
3.2 희귀 토큰을 얼리면 전체가 살아난다
가설을 검증하는 방법이 꽤 직접적이다. 학습 내내 희귀 그룹 임베딩을 초기 상태로 얼려(freeze) 두고, 모든 임베딩을 정상 학습시킨 베이스라인(MLE)과 비교한다. 여기서 쓰는 지표가 두 가지다. 하나는 익숙한 퍼플렉서티(PPL)이고, 다른 하나는 임베딩 분포의 등방성을 재는 다.
는 Arora et al. (2016)의 분배 함수 에서 출발한다. 임베딩이 완벽히 등방적이면 단위 벡터 를 어느 방향으로 돌려도 가 거의 일정하다는 성질을 이용한다.
여기서 는 의 고유벡터 집합이고 이다. 값이 1에 가까울수록 등방적, 0에 가까울수록 퇴화된 상태다. 추가로, 희귀 그룹의 퇴화가 빈번 그룹의 퇴화를 끌고 간다는 것을 보기 위해 두 그룹 임베딩 사이의 평균 코사인 유사도도 측정한다.
| Methods | PPL↓ Freq | PPL↓ Med | PPL↓ Rare | PPL↓ Total | I(W)↑ Freq | I(W)↑ Med | I(W)↑ Rare | I(W)↑ Total |
|---|---|---|---|---|---|---|---|---|
| MLE | 16.58 | 224.24 | 813.76 | 20.77 | 0.426 | 0.286 | 0.198 | 0.293 |
| Freeze | 16.48 | 233.92 | 3017.53 | 20.78 | 0.840 | 0.651 | 0.831 | 0.739 |
Table 1 (원논문): 각 토큰 그룹의 퍼플렉서티와 I(W). PPL은 낮을수록, I(W)는 높을수록 좋다.
Table 1의 결과가 이 논문에서 가장 의외인 대목이다. 희귀 토큰을 아예 학습하지 않았을 뿐인데, 전체 가 0.293에서 0.739로 2.5배 넘게 뛴다. 더 눈에 띄는 것은 빈번 그룹의 퍼플렉서티가 16.58에서 16.48로 오히려 미세하게 좋아졌다는 점이다. 희귀 토큰을 전혀 건드리지 않았는데 빈번 토큰의 생성 성능이 개선됐다는 것은, 희귀 토큰의 학습이 빈번 토큰에 해를 끼치고 있었다는 뜻이다. 물론 공짜는 아니다. 얼려버린 희귀 토큰 자신의 PPL은 813에서 3017로 크게 나빠진다. 희귀 토큰을 전혀 학습하지 않으니 당연한 대가인데, 전체 PPL이 20.77에서 20.78로 사실상 변하지 않는 것은 희귀 토큰이 차지하는 비중이 작기 때문이다. 이 지점이 나중에 AGG의 설계 동기로 이어진다. 완전히 얼리는 것은 과하고, 해로운 부분만 선택적으로 막아야 한다는 것이다.
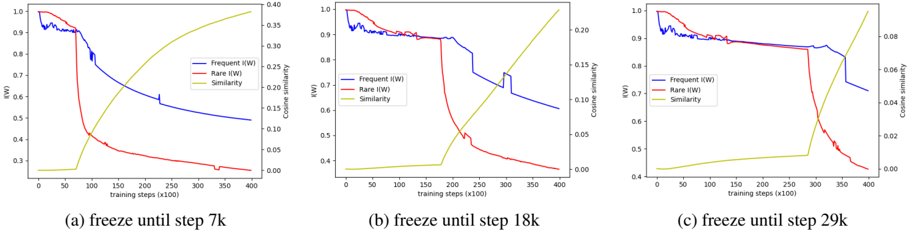
Figure 2: 희귀 토큰 학습을 특정 스텝까지 얼렸다가 푸는 실험에서, 희귀/빈번 그룹의 I(W)와 두 그룹 임베딩 사이 평균 코사인 유사도의 변화. (원논문)
Figure 2는 희귀 토큰을 각각 7k, 18k, 29k 스텝까지만 얼렸다가 푸는 실험이다. 세 그래프 모두 똑같은 패턴을 보인다. 희귀 토큰(빨간선 Rare )이 얼려 있는 동안에는 빈번 토큰(파란선 Frequent )의 등방성이 완만하게 유지되지만, 얼림을 푸는 바로 그 순간 희귀 가 급격히 꺾여 내려가고, 곧이어 빈번 도 따라 떨어지며, 두 그룹 사이 코사인 유사도(노란선)는 치솟는다. 얼림을 늦게 풀수록(7k → 29k) 퇴화가 시작되는 시점도 그만큼 뒤로 밀린다. 희귀 토큰의 학습 재개가 전체 퇴화의 방아쇠라는 가설이 시간축에서 그대로 확인되는 셈이다.
3.3 그래디언트에서 진범 찾기
희귀 토큰을 통째로 얼리면 전체 퇴화가 멈춘다는 것까지는 알았다. 그렇다면 희귀 토큰 임베딩에 작용하는 그래디언트의 어느 부분이 범인일까. 저자들은 개의 문맥 특징 벡터 에 대해 희귀 토큰 임베딩 의 NLL 손실 그래디언트를 세 부분으로 분해한다.
여기서 는 의 타깃 토큰, 은 희귀 토큰 그룹, 는 가 주어졌을 때 토큰 의 조건부 확률이다. 각 부분의 역할을 뜯어보면 이렇다.
- Part (a): 타깃이 자신인 문맥 벡터 쪽으로 을 끌어당긴다. 임베딩이 타깃에 정렬되도록 하는 당연히 필요한 힘이다.
- Part (b): 타깃이 비희귀 토큰인 문맥 벡터로부터 을 밀어낸다.
- Part (c): 타깃이 다른 희귀 토큰인 문맥 벡터로부터 을 밀어낸다.
이제 각 부분을 PyTorch의 detach()로 계산 그래프에서 떼어내(즉 해당 그래디언트를 0으로) 학습해 보면서 범인을 가린다. Part (a)는 임베딩을 타깃에 맞추는 필수 요소이므로 모든 설정에서 살려 둔다.
| Methods | PPL↓ Freq | PPL↓ Med | PPL↓ Rare | PPL↓ Total | I(W)↑ Freq | I(W)↑ Med | I(W)↑ Rare | I(W)↑ Total |
|---|---|---|---|---|---|---|---|---|
| MLE | 16.58 | 224.24 | 813.76 | 20.77 | 0.426 | 0.286 | 0.198 | 0.293 |
| Freeze (b)&(c) | 17.41 | 247.89 | 66.41 | 21.79 | 0.323 | 0.693 | 0.551 | 0.536 |
| Freeze (b) | 16.99 | 240.72 | 65.76 | 21.26 | 0.495 | 0.561 | 0.678 | 0.748 |
| Freeze (c) | 16.61 | 220.07 | 645.24 | 20.76 | 0.443 | 0.276 | 0.15 | 0.317 |
Table 2 (원논문): 그래디언트 부분 동결 실험에서 각 토큰 그룹의 퍼플렉서티와 I(W).
Table 2의 대비가 결론을 선명하게 만든다. Part (b)를 얼린 설정(Freeze (b))은 전체 가 0.748까지 올라가며 MLE(0.293)를 크게 앞선다. 희귀 토큰 PPL도 813에서 65.76으로 극적으로 좋아진다. 반면 Part (c)만 얼린 설정(Freeze (c))은 가 0.317로 MLE와 거의 차이가 없고, 희귀 PPL도 645로 여전히 나쁘다. 다시 말해, Part (b)를 살려 두고 Part (c)만 막으면 퇴화가 그대로 진행되지만, Part (b)를 막으면 Part (c)가 살아 있어도 퇴화가 거의 사라진다. 범인은 Part (b), 즉 "희귀 토큰 임베딩을 비희귀 타깃의 문맥 벡터로부터 밀어내는 힘"이라는 결론이 나온다.
왜 Part (b)가 치명적인지는 직관적으로도 납득이 된다. 비희귀 토큰은 학습 코퍼스에서 압도적으로 자주 타깃으로 등장한다. 그러니 희귀 토큰 입장에서는 매 스텝마다 수많은 비희귀 문맥 벡터로부터 "너는 여기 답이 아니다"라며 밀려난다. 이 밀어내는 힘이 특정 방향으로 누적되면서 희귀 임베딩이 한쪽으로 쏠리고, weight tying으로 묶인 소프트맥스 기하가 그 쏠림을 다시 비희귀 임베딩에 전파한다. Part (b)&(c)를 함께 얼린 설정이 Part (b)만 얼린 것보다 오히려 가 낮은 점(0.536 < 0.748)도 흥미로운데, 이는 Part (c)를 무작정 다 막는 것이 최선은 아니며 섬세한 처리가 필요하다는 신호다. AGG가 Part (c)를 "아주 희귀한" 경우에만 조건부로 다루는 설계로 가는 근거가 여기에 있다.
4. 제안 방법: Adaptive Gradient Gating (AGG)
3절의 분석을 한 문장으로 요약하면 "희귀 토큰 임베딩의 그래디언트 중 Part (b)를 적절히 막으면 전체 퇴화를 해결할 수 있다"는 것이다. AGG는 이 처방을 실제 학습에 녹여 넣는 방법으로, 두 축으로 구성된다. 희귀 토큰을 매 스텝 동적으로 골라내는 그룹핑과, 골라낸 토큰의 특정 그래디언트만 차단하는 게이팅이다.
4.1 동적 희귀 토큰 그룹핑
3절에서는 전체 코퍼스 빈도로 희귀 그룹을 고정했지만, 실제 학습은 미니배치로 이뤄진다. 최근 배치에서 덜 나온 토큰이 진짜 "지금" 희귀한 토큰이고, 이 집합은 스텝마다 바뀐다. 그래서 AGG는 최근 출현을 반영한 동적 그룹핑을 쓴다.
구체적으로 토큰 카운터 메모리를 둔다. 직전 스텝 각각의 토큰 출현 횟수를 로 기억하는데, 은 번째 이전 스텝에서 개 어휘 각각의 출현 횟수다. 매 스텝 토큰 출현량 를 개 메모리의 합 로 계산한다. 이 를 기준으로 출현량이 가장 적은 하위 비율의 토큰을 희귀 그룹 로 지정한다.
는 의 번째 성분이고, 는 전체 어휘에서 희귀 토큰이 차지하는 비율을 조절하는 하이퍼파라미터다. 는 한 에폭의 반복 스텝 수로 설정한다. 즉 "최근 한 에폭 동안 가장 덜 나온 비율의 토큰"이 매 스텝 갱신되는 희귀 그룹이 된다. (출현량으로 하위 분위를 잘라내는 조건의 정확한 수식 표기는 원문에서 이미지로 처리되어 있어 위 식은 그 동작을 재구성한 것이다.)
4.2 그래디언트 게이팅 메커니즘
특정 파라미터의 그래디언트만 골라 세기를 조절하려면 깔끔한 도구가 필요하다. 저자들은 값은 와 같지만 계산 그래프에서 분리되어 상수 취급되는 텐서 를 도입한다. 는 상수이므로 그에 대한 그래디언트는 존재하지 않는다. PyTorch의 detach()로 쉽게 얻을 수 있다. 이 를 이용해 게이트 텐서 로 그래디언트를 조절한다.
이 식의 영리함은 순전파와 역전파가 분리된다는 데 있다. 값으로 보면 이므로 , 즉 순전파 출력은 원래 와 완전히 동일하다. 반면 역전파에서는 가 상수라 미분되지 않으므로 가 된다. 를 함수 에 넣으면, 의 출력값은 그대로 유지하면서 로 흘러드는 그래디언트만 정확히 배로 조절되는 것이다. 이면 그래디언트가 온전히 흐르고, 이면 완전히 차단된다. 손실 함수의 형태 자체는 건드리지 않고 그래디언트만 손본다는 점이 뒤에서 다룰 호환성의 근거가 된다.
4.3 Part (b)를 겨냥한 게이트
3절에서 밝혀낸 진범 Part (b)를 처리하기 위해, 문맥 벡터 가 주어졌을 때 게이트 벡터 을 도입한다. Part (b)는 타깃 가 비희귀일 때 희귀 임베딩 을 밀어내는 힘이므로, 이 상황에서 희귀 토큰 성분에 대한 그래디언트를 줄이는 것이 목표다.
는 의 번째 성분이다. 타깃이 비희귀()인 상황에서 희귀 토큰 에 대응하는 성분만 로 낮춰 Part (b)의 밀어내는 힘을 억제하고, 나머지는 1로 두어 정상 학습을 보존한다. 중요한 점은 억제 강도 가 각 토큰의 희귀도 에 따라 달라진다는 것이다. 더 희귀할수록 더 강하게 막는다. 이 적응성(adaptive)이 방법 이름의 "A"다. 모든 토큰에 같은 세기를 적용하는 기존 정규화와 달리, 토큰별 희귀도에 맞춰 차등적으로 개입한다. (게이트 성분의 정확한 함수 형태 역시 원문에서 이미지 수식으로 제공되어, 위 식은 논문이 서술한 동작을 재구성한 것이다.)
4.4 Part (c)와 "아주 희귀한" 토큰을 위한 게이트
3절에서 Part (c)는 퇴화의 주범이 아니라고 결론 내렸는데, 왜 다시 다루는가. 저자들의 통찰은 희귀 그룹 안에도 빈도 격차가 있다는 점이다. 희귀 토큰 사이에서도 상대적으로 "덜 희귀한" 토큰과 "아주 희귀한(very rare)" 토큰이 나뉜다. 아주 희귀한 토큰 입장에서 보면, 같은 희귀 그룹의 덜 희귀한 토큰은 상대적으로 자주 등장하는 셈이다. 그러면 Part (c)가 이 아주 희귀한 토큰을 덜 희귀한 토큰의 문맥 벡터로부터 밀어내는데, 이것이 바로 Part (b)와 똑같은 메커니즘으로 작동해 퇴화를 유발한다. 즉 희귀 그룹 내부에서 작은 규모의 Part (b) 현상이 재현되는 것이다.
이를 막기 위해 희귀도를 두 단계로 근사한다. 희귀 토큰 전체의 평균 출현량 (여기서 )을 기준으로, 출현량 가 평균보다 작으면 "아주 희귀한" 토큰으로 본다. 그리고 두 번째 게이트 벡터 을 도입한다.
는 의 번째 성분이고 은 에 대한 의 평균이다. 는 아주 희귀한 토큰 임베딩이 덜 희귀한 문맥 벡터로부터 밀려나는 정도를 제어한다. 과 마찬가지로 각 성분이 토큰의 희귀도 에 따라 적응적으로 계산된다. 2단계 근사는 어디까지나 근사이고, 저자들도 여러 단계의 희귀도를 다루는 것을 향후 과제로 남겨 둔다.
4.5 로짓과 손실 계산
게이트를 실제 손실에 연결하기 위해 에 대해 세 개의 로짓을 계산한다.
는 임베딩 행렬이다. 은 어떤 게이팅도 적용하지 않은 로짓인데, 이것은 문맥 벡터 자체에 대한 그래디언트를 위해 쓴다. AGG는 임베딩의 그래디언트만 손대는 방법이므로 로 흐르는 그래디언트는 게이팅 없이 정상적으로 유지해야 하기 때문이다. 과 은 각각 , 로 임베딩 행렬을 게이팅한 로짓이다. 최종적으로 번째 위치의 NLL 손실 는 세 로짓에서 얻은 확률 ()을 타깃의 희귀 여부에 따라 지시 함수 로 조합해 구성한다. 타깃이 비희귀냐, 덜 희귀한 희귀 토큰이냐, 아주 희귀한 토큰이냐에 따라 적용되는 게이트가 달라지도록 설계된 것이다. 희귀 토큰 임베딩 에 대한 그래디언트 의 전체 유도는 Appendix A에 세 가지 경우(, 이되 , )로 나뉘어 제시된다.
정리하면 AGG의 동작은 이렇다. 매 스텝 최근 출현량으로 희귀 그룹을 동적으로 추리고, 그 안에서 아주 희귀한 토큰을 다시 가른다. 그리고 비희귀 타깃이 희귀 임베딩을 밀어내는 Part (b)와, 덜 희귀한 타깃이 아주 희귀한 임베딩을 밀어내는 Part (c)의 해로운 변종만, 희귀도에 비례하는 세기로 차단한다. 손실 형태는 그대로 두고 그래디언트만 조절하므로 다른 기법과 겹쳐 쓰기도 쉽다.
5. 실험 결과
저자들은 AGG를 언어 모델링, 단어 유사도, 기계 번역 세 과제에서 검증한다. 언어 모델링에서는 생성 텍스트의 다양성을, 단어 유사도에서는 토큰 사이 의미 관계 학습을, 기계 번역에서는 생성 텍스트의 품질을 본다. 모든 실험은 해당 과제의 최신 모델 아키텍처를 베이스라인으로 삼는다.
5.1 언어 모델링
WikiText-103(약 1억 단어, 어휘 26만)으로 BPE 전처리 후, GPT-2 medium 구조(24층 Transformer decoder)를 베이스라인으로 처음부터 최대 50k 스텝 학습한다. 는 에서 탐색한다. 평가 지표는 세 가지다. 다음 토큰 예측 난이도를 보는 퍼플렉서티, 생성 토큰의 다양성을 세는 Uniq(Welleck et al., 2020, 서로 다른 다음 토큰 예측의 개수), 그리고 임베딩 공간 등방성을 재는 다.
| Methods | PPL↓ Freq | PPL↓ Med | PPL↓ Rare | PPL↓ Total | Uniq↑ Freq | Uniq↑ Med | Uniq↑ Rare | Uniq↑ Total | I(W)↑ |
|---|---|---|---|---|---|---|---|---|---|
| MLE | 13.30 | 146.47 | 438.67 | 15.51 | 9107 | 3945 | 91 | 13143 | 0.377 |
| AGG | 13.35 | 146.44 | 75.39 | 15.51 | 9105 | 4287 | 345 | 13737 | 0.813 |
| Human | - | - | - | - | 10844 | 7146 | 300 | 18920 | - |
Table 3 (원논문): WikiText-103 언어 모델링에서 토큰 그룹별 MLE 베이스라인과 AGG 비교.
Table 3에서 AGG의 성격이 잘 드러난다. 전체 PPL은 15.51로 베이스라인과 동일하다. 즉 전반적 언어모델 성능은 그대로 유지하면서, 희귀 그룹 PPL을 438.67에서 75.39로 6배 가까이 끌어내렸다. 다양성 지표 Uniq는 더 극적이다. 희귀 그룹의 서로 다른 토큰 예측 수가 91에서 345로 늘었는데, 이는 사람의 분포(300)마저 넘어선 수치다. 전체 Uniq도 13143에서 13737로 올랐고, 는 0.377에서 0.813으로 2배 넘게 뛴다. 빈번 그룹의 지표가 거의 변하지 않았다는 점이 중요하다. 다수를 차지하는 빈번 토큰을 건드리지 않고도 소수의 희귀 토큰만 손봐서 전체 등방성과 다양성을 끌어올렸다는, 이 논문의 핵심 주장이 수치로 뒷받침된다.
생성 텍스트를 직접 보면 차이가 더 피부에 와닿는다.
| Method | Texts | Uniq↑ |
|---|---|---|
| Prefix | No. 20 Squadron is a Royal Australian Air Force ( RAAF ) support squadron . Coming under the control of No. 96 Wing , it is responsible for the management of the airfield at RAAF Base Woomera , South Australia . The squadron | |
| MLE | is responsible for air defence , air defence , and air defence , as well as air defence , aerial reconnaissance , and air defence . It is also responsible for air defence , air defence , and air defence , as well as air defence , aerial reconnaissance , and air defence . | 15 |
| AGG | was established in October 1943 at Townsville , Queensland , under the command of Group Captain Paddy Heffernan . It was initially based at Townsville , Queensland , under the control of No. 9 Operational Group , which controlled all air bases in New South Wales . It was renamed No. 1 Mobile Fighter Sector in April 1944 . | 48 |
Table 5 (원논문): WikiText-103 테스트셋 생성 예시. 50개 BPE 토큰을 프리픽스로 주고 다음 100개 BPE 토큰을 생성. 각 텍스트의 Uniq 토큰 수 표기.
Table 5의 MLE 출력은 "air defence"를 거의 주문처럼 반복한다. 고유 토큰이 15개뿐이다. 반면 AGG는 연도, 지명, 인명, 부대 명칭 같은 희귀 토큰을 자연스럽게 섞어 그럴듯한 서사를 만들어내고 고유 토큰이 48개로 세 배 이상이다. 퇴화된 임베딩 공간에서는 노름이 작은 희귀 토큰이 구조적으로 억눌려 생성에 등장하지 못하는데(stolen probability), 등방성을 회복한 AGG에서는 이 토큰들이 제 확률을 되찾은 결과로 읽힌다.
AGG의 또 다른 장점은 다른 기법과의 호환성이다. 신경망 텍스트 퇴화(neural text degeneration) 문제, 즉 모델이 사람 분포와 동떨어진 텍스트를 내놓는 문제를 다루는 대표 기법이 unlikelihood training(UL, Welleck et al., 2020)이다. UL은 보조 손실을 더하는 방식인데, AGG는 손실 형태를 바꾸지 않고 그래디언트만 조절하므로 UL과 그대로 겹쳐 쓸 수 있다.
| Methods | PPL↓ Freq | PPL↓ Med | PPL↓ Rare | PPL↓ Total | Uniq↑ Freq | Uniq↑ Med | Uniq↑ Rare | Uniq↑ Total | I(W)↑ |
|---|---|---|---|---|---|---|---|---|---|
| UL | 14.05 | 125.17 | 385.6 | 16.17 | 9527 | 4402 | 97 | 14026 | 0.396 |
| UL + AGG | 14.17 | 125.93 | 71.48 | 16.25 | 9625 | 4884 | 453 | 14962 | 0.654 |
| Human | - | - | - | - | 10844 | 7146 | 300 | 18920 | - |
Table 4 (원논문): WikiText-103 언어 모델링에서 UL과 UL+AGG 비교.
Table 4를 보면 UL 단독으로는 가 0.396에 그치지만, AGG를 얹으면 0.654로 올라가고 희귀 Uniq도 97에서 453으로 뛴다. 두 기법이 서로 다른 문제(UL은 반복 억제, AGG는 임베딩 퇴화)를 다루기 때문에, 합쳤을 때 각각의 이득을 합한 것 이상의 시너지가 난다. 손실 형태를 보존하는 설계 덕분에 가능한 조합이다.
5.2 단어 유사도
AGG가 임베딩의 의미 관계를 실제로 개선하는지 보기 위해 네 개의 단어 유사도 데이터셋(MEN, WS353, RG65, RW)에서 평가한다. 두 단어의 임베딩 코사인 유사도가 사람이 매긴 정답 유사도와 얼마나 일치하는지를 스피어만 순위 상관으로 잰다. 언어 모델링에서 학습한 모델을 그대로 쓴다.
| Datasets | MLE | AGG |
|---|---|---|
| MEN | 33.57 | 55.13 |
| WS353 | 47.51 | 56.54 |
| RG65 | 35.48 | 65.45 |
| RW | 32.13 | 36.36 |
Table 6 (원논문): 네 개 단어 유사도 데이터셋에서의 성능(스피어만 γ × 100).
Table 6에서 AGG는 네 데이터셋 모두에서 베이스라인을 앞선다. 특히 RG65에서 35.48 → 65.45로 거의 두 배 가까이 뛴 것이 눈에 띈다. 희귀 토큰의 그래디언트만 조절했을 뿐인데 전체 토큰의 의미 정렬이 좋아진다는 것은, 3절의 "희귀 토큰이 전체를 퇴화시킨다"는 명제의 이면, 즉 "희귀 토큰을 바로잡으면 전체가 살아난다"를 보여준다. 다만 RW(Rare Word 데이터셋)에서의 개선 폭(32.13 → 36.36)은 상대적으로 작은데, 희귀 단어 자체의 의미 정렬은 여전히 어려운 과제로 남아 있음을 시사한다.
5.3 기계 번역
WMT 2014 영어→독일어(450만 문장 쌍, 37K 공유 BPE 어휘)에서 Transformer base와 big 두 버전을 베이스라인으로 평가한다. 지표는 BLEU다.
| Methods | BLEU↑ Base | BLEU↑ Big |
|---|---|---|
| Transformer (Vaswani et al., 2017) | 27.30 | 28.40 |
| CosReg (Gao et al., 2019) | 28.38 | 28.94 |
| Adv MLE (Wang et al., 2019) | 28.43 | 29.52 |
| SC (Wang et al., 2020) | 28.45 | 29.32 |
| AGG | 28.70 | 29.81 |
Table 7 (원논문): BLEU 기준 여러 기법 비교.
Table 7에서 AGG는 base에서 1.4, big에서 1.41 BLEU를 베이스라인 대비 올린다. 더 의미 있는 비교는 퇴화 문제를 다룬 다른 기법들과의 대결이다. CosReg, Adv MLE, SC는 모두 전체 임베딩에 정규화를 거는 방식인데, AGG가 base/big 양쪽에서 이들을 모두 앞선다. 저자들이 강조하는 차별점이 여기서 드러난다. 다른 기법들이 모든 토큰을 건드려 과도한 정규화 위험을 안는 반면, AGG는 학습 역학 분석으로 찾아낸 희귀 토큰만 겨냥하기 때문에 빈번 토큰의 과도한 정규화를 피할 수 있다. 원인을 정확히 짚은 처방이 증상 억제보다 낫다는 것을 번역 품질로 확인한 셈이다.
6. AGG 분석
6.1 Ablation Study
AGG의 두 게이트 벡터가 각각 얼마나 기여하는지 뜯어본다.
| Method | PPL↓ | Uniq↑ | I(W)↑ |
|---|---|---|---|
| MLE | 15.51 | 13143 | 0.377 |
| AGG | 15.51 | 13737 | 0.813 |
| no g₁ | 15.48 | 13018 | 0.367 |
| no g₂ | 15.51 | 13682 | 0.701 |
Table 8 (원논문): AGG 게이트 벡터에 대한 ablation.
Table 8에서 을 빼면(no g₁) Uniq가 13018로, 가 0.367로 떨어져 사실상 MLE 수준으로 돌아간다. 3절에서 진범으로 지목한 Part (b)를 다루는 것이 이니, 이것이 빠지면 AGG의 효과가 거의 사라지는 것이 당연하다. 이 전체 성능을 떠받치는 기둥인 셈이다. 를 빼면(no g₂) 가 0.813에서 0.701로 내려가고 Uniq도 소폭 준다. 주범은 아니지만, 희귀 그룹 내부의 아주 희귀한 토큰을 다루는 도 등방성 회복에 분명히 기여한다는 것을 보여준다. 4.4절의 "희귀 그룹 안에서도 Part (b) 같은 현상이 재현된다"는 논증이 수치로 확인되는 대목이다.
동적 그룹핑이 정말 필요한지도 검증한다.
| Method | PPL↓ | Uniq↑ | I(W)↑ |
|---|---|---|---|
| MLE | 15.51 | 13143 | 0.377 |
| AGG | 15.51 | 13737 | 0.813 |
| static AGG | 15.55 | 13614 | 0.752 |
Table 9 (원논문): AGG의 동적 그룹핑에 대한 ablation.
Table 9의 static AGG는 1 에폭 후 희귀 그룹을 고정한 버전이다. 동적 그룹핑 대비 Uniq(13614 < 13737)와 (0.752 < 0.813)가 모두 떨어진다. 차이가 크지는 않지만, 매 스텝 최근 출현을 반영해 희귀 그룹을 갱신하는 것이 일관되게 낫다는 것을 보여준다. 왜 동적 그룹핑이 유리한지는 다음 그림이 설명해 준다.
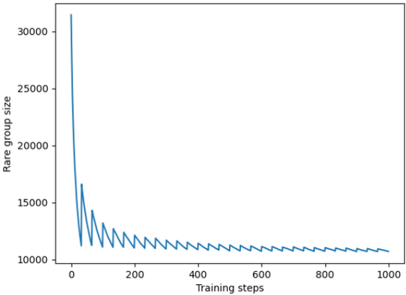
Figure 4: WikiText-103 학습 초기 1k 스텝 동안 희귀 토큰 그룹의 크기 변화. (원논문)
Figure 4를 보면 학습 초기에 희귀 그룹 크기가 3만 개를 넘겼다가 1만 개 근처로 급락하고, 이후에도 톱니 모양으로 심하게 요동친다. 미니배치마다 어떤 토큰이 희귀한지가 계속 바뀐다는 뜻이다. 고정된 그룹으로는 이 변동을 따라갈 수 없고, 동적 그룹핑이라야 매 스텝 "지금 실제로 희귀한" 토큰을 정확히 겨냥할 수 있다. Table 9의 성능 차이가 이 변동성에서 비롯된다.
6.2 시각화
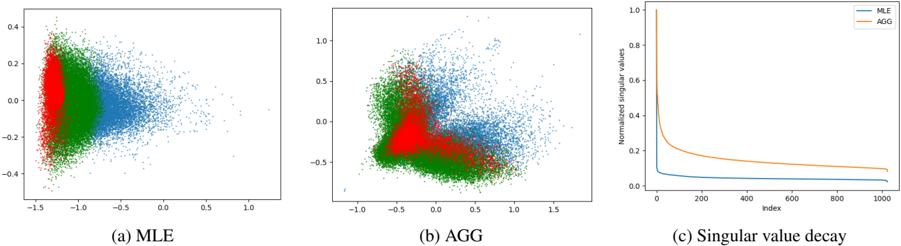
Figure 3: (a), (b) WikiText-103 언어 모델링에서 베이스라인 MLE와 AGG의 토큰 임베딩 시각화. 빨강, 초록, 파랑은 각각 희귀, 중간, 빈번 그룹. (c) MLE와 AGG의 정규화된 특잇값. (원논문)
Figure 3이 AGG의 효과를 가장 직관적으로 보여준다. (a) MLE에서는 세 그룹이 좁은 영역에 눌려 있고, 결정적으로 빨간 희귀 그룹과 파란 빈번 그룹이 서로 다른 영역에 분리되어(disjoint) 있다. 이것이 Gong et al. (2018)이 지적한 빈도 편향 문제다. 임베딩이 의미가 아니라 빈도에 따라 자리를 잡는 것이다. (b) AGG에서는 분포가 훨씬 넓게 퍼져 등방성을 되찾았을 뿐 아니라, 세 그룹이 겹쳐서 섞여 있다. 빈도에 따른 분리가 사라진 것이다. 희귀 토큰의 학습을 조절했을 뿐인데 빈도 편향까지 완화된다는 점은, 퇴화와 빈도 편향이 같은 뿌리를 공유한다는 것을 시사한다.
(c)의 특잇값 그래프도 같은 이야기를 한다. MLE(파란선)는 첫 몇 개 특잇값이 압도적으로 크고 나머지는 급락한다. 소수의 방향이 공간을 지배하는 비등방 분포의 전형이다. AGG(주황선)는 특잇값이 완만하게 감소한다. 여러 방향이 고르게 기여하는 등방 분포라는 뜻으로, 가 올라간 것과 일관된다.
7. 부록(Appendix) 상세
7.1 AGG 손실의 그래디언트 유도 (Appendix A)
부록 A는 AGG 손실 를 희귀 토큰 임베딩 로 미분하는 전 과정을 담는다. 먼저 와 로짓 성분 의 에 대한 그래디언트를 정리한 뒤, 타깃의 희귀 여부에 따라 세 경우로 나눠 유도한다. (1) 인 경우 이 적용되어 Part (b)가 게이팅되고, (2) 이되 인 경우 가 작동하며, (3) 인 경우는 두 번째 경우와 같은 유도 과정을 공유한다. 값으로는 ()가 성립하므로 최종 그래디언트가 깔끔하게 정리된다. 이 부록은 4.5절에서 서술한 "세 로짓을 지시 함수로 조합한 손실"이 실제로 의도한 그래디언트 게이팅을 정확히 만들어낸다는 것을 수식으로 보증하는 역할을 한다. 논문에서 이 유도에만 수식 11번부터 23번까지 할애한다.
7.2 실험 세부사항과 하이퍼파라미터 (Appendix B)
모든 실험은 NVIDIA A40 단일 GPU에서 단일 실행으로 수행됐다. 같은 과제 안에서는 학습 목표(MLE, AGG, UL)가 달라도 동일한 모델 아키텍처와 완전히 같은 하이퍼파라미터를 쓴다. 공정한 비교를 위한 통제다.
| Hyperparameter | Empirical Study | Language Modeling | MT Base | MT Big |
|---|---|---|---|---|
| # of layers | 6 | 24 | 6-6 | 6-6 |
| Hidden dimension | 512 | 1024 | 512 | 1024 |
| Projection dimension | 2048 | 4096 | 2048 | 4096 |
| # of heads | 8 | 16 | 8 | 16 |
| Dropout | 0.1 | 0.1 | 0.1 | 0.3 |
| Vocabulary size | 44256 | 44256 | 40624 | 40624 |
| # of parameters | 42M | 358M | 65M | 218M |
| Learning rate | 7·10⁻⁴ | 7·10⁻⁴ | 1·10⁻³ | 1·10⁻³ |
| Max tokens per batch | 32k | 32k | 64k | 64k |
| Maximum training steps | 40k | 50k | 190k | 190k |
| Warmup steps | 4k | 4k | 4k | 4k |
| Optimizer | Adam | Adam | Adam | Adam |
| Weight decay | 0.01 | 0.01 | 0.01 | 0.01 |
| α for AGG | - | 0.03 | 0.08 | 0.08 |
| α for UL | - | 1.0 | - | - |
Table 12 (원논문): 본문 모든 실험의 모델 구성과 학습 하이퍼파라미터. 단어 유사도는 언어 모델링 학습 모델을 그대로 평가한다.
Table 12에서 과제별 설정이 흥미롭다. 언어 모델링은 0.03, 기계 번역은 0.08로, 번역에서 더 큰 희귀 그룹을 쓴다. 3절 경험적 분석(Empirical Study)은 6층 42M의 작은 모델로, 본 실험은 그보다 훨씬 큰 모델(358M, 218M)로 수행됐다는 점도 확인된다. 작은 모델에서 발견한 현상이 큰 모델에서도 유효함을 간접적으로 보여주는 셈이다.
7.3 빈도 그룹별 I(W) (Appendix C)
본문 Table 3은 전체 만 보고했는데, 부록 C는 이를 그룹별로 쪼갠다.
| Methods | Freq | Med | Rare |
|---|---|---|---|
| MLE | 0.51 | 0.33 | 0.278 |
| AGG | 0.702 | 0.714 | 0.813 |
Table 10 (원논문): WikiText-103 언어 모델링에서 MLE와 AGG의 그룹별 I(W).
| Methods | Freq | Med | Rare |
|---|---|---|---|
| UL | 0.533 | 0.351 | 0.293 |
| UL + AGG | 0.731 | 0.626 | 0.696 |
Table 11 (원논문): WikiText-103 언어 모델링에서 UL과 UL+AGG의 그룹별 I(W).
Table 10에서 특히 눈에 띄는 것은 희귀 그룹의 가 0.278에서 0.813으로 가장 크게 오른다는 점이다. 직접 겨냥한 희귀 그룹이 가장 크게 개선되는 것은 당연하지만, 빈번(0.51 → 0.702)과 중간(0.33 → 0.714) 그룹까지 함께 올라간다는 것이 핵심이다. 희귀 토큰만 손봤는데 모든 그룹의 등방성이 개선된다는 것은, AGG가 특정 그룹에 국한된 미봉책이 아니라 전체 퇴화 문제를 뿌리에서 해결한다는 주장을 뒷받침한다. Table 11은 UL과 결합했을 때도 같은 패턴이 유지됨을 보여준다.
7.4 하이퍼파라미터 민감도 (Appendix D)
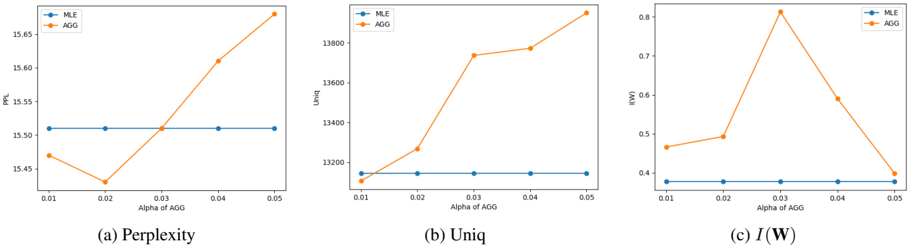
Figure 5: WikiText-103 언어 모델링에서 AGG의 하이퍼파라미터 α에 따른 (a) 퍼플렉서티, (b) Uniq, (c) I(W) 변화. (원논문)
Figure 5는 희귀 그룹 비율 를 0.01부터 0.05까지 바꿔 가며 지표를 관찰한 것이다. 여기서 저자들은 흥미로운 현상을 발견한다. 희귀 그룹에 대해서는 Uniq와 가 양의 상관을 보이며 특정 까지 함께 오르다 함께 내린다. (c)에서 가 에서 0.81로 정점을 찍고 이후 급락하는 것이 그 모습이다. 그런데 비희귀 그룹(다수 그룹)에서는 이야기가 다르다. 가 특정 임계값을 넘으면 Uniq는 계속 오르는데 는 떨어지고 PPL은 올라간다. (a)에서 부터 PPL이 상승 곡선을 그리고 (b)에서 Uniq는 계속 증가하는 모순이 그것이다.
저자들은 이를 또 다른 형태의 퇴화로 해석한다. 등방성과 우도에 해를 끼치면서 Uniq만 오르는 것은 텍스트 품질 향상이 아니라 부적절한 토큰이 마구 생성되는 것일 뿐이기 때문이다. 희귀 그룹을 너무 크게 잡으면(가 과도하면) 원래 비희귀였어야 할 토큰까지 희귀 처리되어 역효과가 나는 것이다. 이 현상 자체를 다루는 것은 향후 과제로 남긴다. 실용적으로는 부근이 세 지표의 균형점임을 보여준다.
7.5 토큰 간 의미 정렬 정성 분석 (Appendix E)
AGG가 의미 관계를 실제로 개선하는지를 최근접 이웃으로 확인한다. WikiText-103에서 희귀 토큰 "homepage", "Werewolf", "policymakers"를, WMT14 En→De에서 "optimum", "criminal", "happiness"를 골라 코사인 거리 기준 상위 5개 이웃을 뽑는다.
| homepage (MLE) | homepage (AGG) | Werewolf (MLE) | Werewolf (AGG) | policymakers (MLE) | policymakers (AGG) |
|---|---|---|---|---|---|
| BOX | website | ASUS | Creature | Steam | politicians |
| inbox | webpage | riet | Nightmare | death | environmentalists |
| livestream | blog | 480 | Bride | Venezuel | activists |
| namespace | Tumblr | nuclear | Sneak | includ | planners |
| hashes | websites | ATCH | Sniper | reason | economists |
Table 13 (원논문): WikiText-103에서 각 희귀 토큰의 상위 5개 최근접 이웃. MLE와 AGG 비교.
Table 13의 대비가 선명하다. MLE에서 "homepage"의 이웃은 "BOX", "hashes" 같은 뒤죽박죽한 토큰인데, AGG에서는 "website", "webpage", "blog"처럼 의미적으로 밀접한 토큰이 모인다. "policymakers"도 MLE에서는 "Steam", "death" 같은 무관한 토큰이 붙지만, AGG에서는 "politicians", "economists"처럼 자연스러운 이웃이 나온다. 퇴화된 공간에서는 의미가 아니라 빈도 같은 엉뚱한 축으로 이웃이 정해지는데, 등방성을 되찾으면 의미 축이 복원된다는 것을 보여준다.
| optimum (MLE) | optimum (AGG) | criminal (MLE) | criminal (AGG) | happiness (MLE) | happiness (AGG) |
|---|---|---|---|---|---|
| therto | optimal | Criminal | criminals | juries | happy |
| ratory | optimale* | criminals | Criminal | enness | joy |
| consultan@@ | optimalen* | perpetr@@ | krimi@@* | ocopying | happ@@ |
| sofar | maximum | secution | kriminellen* | ratory | Glück* |
| protection@@ | Optim@@ | xious | crime | sacri@@ | pleasure |
*Table 14 (원논문): WMT14 En→De에서 각 희귀 소스 토큰의 상위 5개 최근접 이웃. @@는 서브워드 토큰화, 는 타깃 언어의 동의어 토큰.
Table 14는 번역 모델에서 더 흥미로운 결과를 보여준다. AGG로 학습한 "happiness"의 이웃에 독일어 "Glück"(행복)이 등장한다. 별표가 붙은 토큰들은 타깃 언어의 동의어인데, 소스 언어 토큰의 임베딩이 타깃 언어의 의미적으로 대응하는 토큰과 가까워졌다는 뜻이다. 희귀 토큰의 그래디언트를 조절했을 뿐인데 교차 언어(cross-lingual) 의미 정렬까지 학습된다는 것은, 등방성 회복이 번역 품질 향상(Table 7)으로 이어지는 경로를 설명해 준다.
7.6 추가 생성 예시 (Appendix F)
본문 Table 5 외에 부록 F는 네 개의 생성 예시를 더 제시한다. 모두 50개 BPE 프리픽스를 주고 100개 토큰을 생성한 결과다.
| Method | Texts | Uniq↑ |
|---|---|---|
| Prefix | A Company , 2nd Engineer Combat Battalion , moved to the south side of the Yongsan - Naktong River road ; D Company of the 2nd Engineer Battalion was on the north side of the road . Approximately 2 miles ( 3 | |
| MLE | . 2 km ) north of the river , the 2nd Engineer Combat Battalion was on the south side of the road . The 2nd Engineer Combat Battalion was on the south side of the road . | 22 |
| AGG | . 2 km ) north of the river , the 2nd Engineer Combat Battalion was attacked by a small force of North Korean People 's Volunteer Army ( NK ) troops . The North Koreans were able to penetrate the UN lines and capture the town . | 43 |
| Method | Texts | Uniq↑ |
|---|---|---|
| Prefix | The twelve 45 - calibre 35 . 6 cm ( 14 . 0 in ) Type 41 guns of the Ise class were mounted in three pairs of twin - gun , superfiring turrets . Numbered one through | |
| MLE | two , the turrets were placed in superfiring pairs ... (동일 구절 반복) | 19 |
| AGG | five from front to rear , the guns had a firing arc of 260° . They fired a 45 . 3 kg ( 99 lb ) projectile at a muzzle velocity of 835 m/s ... | 55 |
| Method | Texts | Uniq↑ |
|---|---|---|
| Prefix | Following the loss of most of the IJN 's large aircraft carriers during the Battle | |
| MLE | of Midway , the IJN was forced to rely on ... aircraft carriers and aircraft carriers ... (반복) | 37 |
| AGG | of Midway , the IJN decided to modernize its fleet ... capable of operating at speeds of up to 30 knots ( 56 km/h ; 35 mph ) ... | 63 |
| Method | Texts | Uniq↑ |
|---|---|---|
| Prefix | While at Crewe , he also played for another local team , Bollington United , as a centre | |
| MLE | - back . He was a member of the team that won the FA Youth Cup in 1989 ... (반복) | 24 |
| AGG | - back . He was signed by Crewe Alexandra in July 2006 , and made his debut ... in a 2-1 win over Rotherham United in the League Cup on 18 August 2006 . | 52 |
Table 15 (원논문): WikiText-103 테스트셋 추가 생성 예시와 각 텍스트의 Uniq 토큰 수.
Table 15의 네 예시는 모두 같은 패턴을 반복적으로 보여준다. MLE는 어김없이 특정 구절("the 2nd Engineer Combat Battalion was on the south side", "superfiring pairs", "aircraft carriers", "won the FA Youth Cup")에 갇혀 같은 말을 되풀이하는데, AGG는 구체적인 수치, 날짜, 고유명사를 동원해 사실적이고 다양한 문장을 만든다. 모든 예시에서 AGG의 Uniq가 MLE의 두 배 이상이다. 임베딩 퇴화가 생성 반복(repetition)으로 이어지고, 등방성 회복이 그 반복을 깨뜨린다는 것을 여러 사례로 확인시켜 주는 부록이다.
8. 강점과 한계
강점
- 진단과 처방의 일관성: 이 논문의 가장 큰 미덕은 문제의 원인을 끈질기게 파고든 뒤 그 원인만 정확히 겨냥한다는 점이다. Figure 1의 시각적 관찰에서 출발해 Table 1의 freeze 실험, Table 2의 그래디언트 부분 동결 실험으로 범인을 Part (b)까지 좁혀 가는 과정이 설득력 있다. 증상이 아니라 원인을 다룬다는 주장이 공허한 수사가 아니라 단계적 실험으로 뒷받침된다.
- 소수 개입으로 전체 개선: Table 3에서 빈번 그룹 지표를 거의 그대로 둔 채 희귀 그룹과 전체 를 크게 끌어올린 것이 핵심 성과다. 다수 토큰의 과도한 정규화를 피하면서 전체 퇴화를 해결한다는, 기존 기법과의 근본적 차별점이 수치로 입증된다.
- 손실 형태 보존에서 오는 호환성: 그래디언트만 조절하고 손실 함수를 바꾸지 않는 설계 덕분에 UL 같은 다른 기법과 그대로 결합된다(Table 4). 실무에서 기존 파이프라인에 얹기 쉬운 방법이라는 뜻이다.
- 다과제 검증과 정성 분석의 풍부함: 언어 모델링, 단어 유사도, 기계 번역에 걸친 정량 평가에 더해, 최근접 이웃(Table 13-14)과 생성 예시(Table 5, 15), 임베딩 시각화(Figure 3)까지 정성 근거가 두텁다. 특히 교차 언어 의미 정렬(Table 14)은 예상 밖의 부수 효과로 인상적이다.
한계 및 아쉬운 점
- 단일 실행, 단일 GPU: Appendix B에 따르면 모든 실험이 단일 실행(single run)으로 수행됐다. 분산 정보나 신뢰 구간이 없어, 특히 Table 7의 1.4 BLEU 같은 개선이 통계적으로 얼마나 견고한지는 확인하기 어렵다.
- 2단계 희귀도 근사의 거칠음: 저자들도 밝혔듯, 희귀도를 "덜 희귀/아주 희귀" 두 단계로만 근사한다. 의 ablation(Table 8)에서 기여가 있긴 하지만, Figure 5가 보여준 민감도 문제와 맞물려 보면 여러 단계의 희귀도를 다루는 더 정교한 설계 여지가 남아 있다.
- 민감도: Figure 5에서 가 임계값을 넘으면 비희귀 토큰에 또 다른 퇴화가 생긴다. 과제마다 를 다시 탐색해야 하고(언어 모델링 0.03, 번역 0.08), 그 폭이 좁다는 점은 실용적 부담이다.
- 구식 베이스라인과 소규모 설정: GPT-2 medium을 처음부터 학습하는 2022년 기준 설정이라, 대규모 사전학습 모델(이미 수조 토큰으로 학습된 LLM)에서도 같은 퇴화 역학과 AGG 효과가 성립하는지는 이 논문만으로는 알 수 없다. 사전학습된 임베딩에 AGG를 적용하는 시나리오가 다뤄지지 않은 점이 아쉽다.
- 게이트 함수의 구체성: 논문 본문에서 , 성분의 정확한 함수 형태를 수식으로 제시하긴 하나(본 리뷰에서는 원문 이미지 수식을 재구성), 희귀도 를 게이트 값으로 매핑하는 설계 선택의 민감도에 대한 분석은 제한적이다.
9. 마치며
이 논문의 매력은 "왜"를 끝까지 추적했다는 데 있다. 표현 퇴화라는 익숙한 문제를 두고, 대부분의 연구가 결과를 억누르는 데 집중할 때 이 논문은 학습 역학으로 거슬러 올라가 희귀 토큰의 그래디언트 Part (b)라는 구체적 지점을 범인으로 특정했다. 그리고 그 지점만 정확히 차단하는 Adaptive Gradient Gating으로, 다수 토큰을 건드리지 않고도 전체 임베딩 공간의 등방성을 회복시켰다.
소수의 희귀 토큰이 전체 임베딩을 퇴화시킨다는 발견 자체가, 소프트맥스와 임베딩이 가중치를 공유하는 생성 모델의 구조적 특성이 어떻게 기하학적 병리로 이어지는지를 보여주는 좋은 사례다. 그래디언트를 값과 분리해 선택적으로 게이팅하는 detach() 기반 기법은 그 자체로 재사용 가능한 도구이고, 손실 형태를 보존한다는 성질 덕분에 다른 기법과의 결합도 자연스럽다.
빈도 편향 완화나 교차 언어 의미 정렬 같은 부수 효과는, 퇴화와 빈도 편향이 공통의 뿌리를 공유할 가능성을 시사한다. 대규모 사전학습 모델에서도 같은 역학이 작동하는지, 여러 단계의 희귀도를 어떻게 다룰지, 민감도를 어떻게 완화할지는 후속 연구가 이어받을 질문이다. 증상이 아니라 원인을 다룬다는 접근의 가치를, 임베딩 퇴화라는 구체적 문제 위에서 깔끔하게 입증해 낸 논문이다.
References
- Gao et al., 2019. "Representation degeneration problem in training natural language generation models." ICLR. (표현 퇴화 문제 정식화, CosReg)
- Mu and Viswanath, 2018. "All-but-the-top: Simple and effective postprocessing for word representations." ICLR.
- Demeter et al., 2020. "Stolen probability: A structural weakness of neural language models." ACL.
- Gong et al., 2018. "FRAGE: Frequency-agnostic word representation." NeurIPS. (빈도 편향)
- Welleck et al., 2020. "Neural text generation with unlikelihood training." ICLR. (UL, Uniq 지표)
- Arora et al., 2016. "A latent variable model approach to PMI-based word embeddings." TACL. (I(W)의 분배 함수)
- Wang et al., 2019. "Improving neural language modeling via adversarial training." ICML. (Adv MLE)
- Wang et al., 2020. "Improving neural language generation with spectrum control." ICLR. (SC)
- Biś et al., 2021. "Too much in common: Shifting of embeddings in transformer language models and its implications." NAACL.
- Vaswani et al., 2017. "Attention is all you need." NeurIPS. (Transformer 베이스라인)