논문 리뷰
논문 리뷰: CharacterBERT and Self-Teaching for Improving the Robustness of Dense Retrievers on Queries with Typos
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | CharacterBERT and Self-Teaching for Improving the Robustness of Dense Retrievers on Queries with Typos |
| 저자 | Shengyao Zhuang, Guido Zuccon (The University of Queensland) |
| 학회 | SIGIR 2022 (45th International ACM SIGIR Conference) |
| 논문 링크 | arXiv:2204.00716 |
| 코드/데이터 | github.com/ielab/CharacterBERT-DR |
1. 들어가며
검색창에 "infromation retrieval"이라고 오타를 낸 적이 있을 것이다. 구글이나 빙이라면 대개 "혹시 이걸 찾으셨나요?"라며 알아서 교정해 준다. 그런데 요즘 검색 시스템의 1차 후보 생성을 책임지는 밀집 검색기(Dense Retriever, DR)는 이 한 글자 오타에 의외로 취약하다. BERT로 쿼리와 문서를 벡터로 바꾸고 벡터 유사도로 랭킹을 매기는 이 방식은, 오타 없는 쿼리에서는 전통적인 BM25를 크게 앞서면서도 오타가 하나만 끼어들면 성능이 급락한다. 심지어 BM25보다 더 민감하게 무너진다.
이 논문이 던지는 질문은 두 가지다. 첫째, 왜 밀집 검색기는 오타에 이토록 약한가. 둘째, 오타 없는 쿼리에서의 성능을 희생하지 않으면서 오타 쿼리에 강한 검색기를 어떻게 만들 수 있는가. 저자들은 첫 질문의 범인으로 BERT의 WordPiece 토크나이저를 지목하고, 두 번째 질문에 대해 CharacterBERT라는 인코더와 Self-Teaching(ST)이라는 학습 기법을 조합한 해법을 내놓는다.
같은 저자들의 이전 연구([46], EMNLP 2021)가 "DR이 오타에 약하다"는 현상을 데이터 증강(augmentation) 기반 학습으로 일부 완화했다면, 이번 논문은 그 현상의 원인을 토큰화 수준에서 파고들고, 더 효율적인 학습 기법과 함께 실제 사용자 오타로 구성된 평가 데이터셋 DL-typo까지 공개한다. 원인 분석, 방법론, 데이터셋 기여가 한 편에 모두 담긴 알찬 구성이다.
2. 기존 연구의 한계
2.1 밀집 검색기의 발전
밀집 검색기는 BERT, RoBERTa 같은 사전학습 언어모델(PLM)을 IR에 적용하면서 BM25류 전통 방식을 크게 앞질렀다. 바이-인코더(bi-encoder) 구조로 쿼리와 문서를 각각 저차원 밀집 벡터로 인코딩하고, 코사인 유사도나 내적으로 관련성을 추정한다. 문서는 색인 단계에서 미리 인코딩해 두고 질의 시점에는 쿼리만 인코딩하면 되므로, ANN(Approximate Nearest Neighbor) 탐색과 결합해 대규모 코퍼스에서도 빠르게 동작한다.
DR의 성능을 끌어올리는 핵심은 네거티브 샘플링 전략이었다. Karpukhin 등[17]의 DPR은 BM25 상위 결과에서 하드 네거티브를 뽑는 단순한 방식으로도 꽤 효과적인 DR을 학습할 수 있음을 보였고, 이후 ANCE[42]는 비동기적으로 갱신되는 ANN 색인에서 하드 네거티브를 샘플링했으며, ADORE[44]는 쿼리 인코더를 동적으로 갱신해 최신 임베딩 기준으로 네거티브를 뽑았다. RocketQA[31]는 여러 GPU에 걸쳐 네거티브를 공유해 학습 샘플당 네거티브 수를 극대화했다. 또 다른 축은 지식 증류(Knowledge Distillation, KD)로, ColBERT 같은 강한 멀티벡터 교사나 크로스-인코더 교사로부터 바이-인코더 학생 DR을 학습시키는 방식이다[22, 23, 33].
2.2 강건성(robustness) 문제
이렇게 전반적으로는 강력하지만, DR은 특정 종류의 쿼리에서 기대 이하의 성능을 보인다. Arabzadeh 등[1]은 MS MARCO 리더보드 분석에서 흔치 않은 용어가 든 쿼리나 복잡한 쿼리에서 DR이 약하다는 점을, Sciavolino 등[34]은 개체(entity)가 포함된 쿼리에서 DR이 오히려 BM25보다 못하다는 점을 보고했다. 이 논문이 다루는 오타 쿼리도 이 "분포 밖(out-of-distribution) 쿼리" 계열에 속한다.
오타 쿼리에 관해서는 Zhuang과 Zuccon[46]의 선행 연구가 직접적인 출발점이다. 그들은 영어 쿼리에 현실적인 오타를 규칙 기반으로 주입하는 합성 생성 프레임워크를 만들어, 한 글자 오타만으로도 DR의 효과가 급락하며 심지어 BM25보다 오타에 더 민감하다는 사실을 체계적으로 입증했다. 그리고 이를 완화하기 위해 학습 쿼리의 일부를 확률적으로 오타 쿼리로 변환하는 데이터 증강 학습(typo-aware training, 이 논문에서는 +Aug로 표기)을 제안했다.
이 선행 연구에는 두 가지 빈틈이 있었다. 하나는 "왜 DR이 오타에 약한지"에 대한 설명이 없었다는 점이고, 다른 하나는 평가가 현실적이긴 해도 합성으로 만든 오타에만 의존했다는 점이다. 이 논문은 바로 이 두 빈틈을 겨냥한다. 원인을 토큰화 관점에서 규명하고, 실제 사용자 오타 데이터셋으로 평가를 보강한다.
NLP 쪽에서도 BERT가 오타에 약하다는 보고[36]는 있었지만, 검색 태스크와 DR을 대상으로 한 분석은 아니었다. 또 Chen 등[2]은 개체 쿼리에 대한 DR 강건성을 희소 검색기 모방 방식으로 다뤘으나 대량의 학습 데이터와 연산 자원을 요구한다는 단점이 있었다. 이 논문이 제안하는 Self-Teaching은 이런 자원 부담을 덜면서 오타 강건성을 확보하려는 시도다.
3. 왜 밀집 검색기는 오타에 약한가: 토큰화와 임베딩 분석
방법론에 앞서 저자들은 "왜"에 대한 분석을 먼저 제시한다. 이 분석이 뒤에 나올 CharacterBERT와 ST의 설계 동기를 전부 떠받치기 때문에, 논문에서 가장 중요한 밑돌에 해당한다.
핵심 가설은 이렇다. BERT의 WordPiece 토크나이저는 고정된 서브워드 어휘집(vocabulary)에 의존하는데, 오타가 든 단어는 이 어휘집에 없으므로 여러 개의 작은 서브토큰으로 쪼개진다. 예컨대 'information'은 WordPiece에서 단일 토큰으로 매핑되지만, 'infromation'으로 철자가 틀리면 ['in', 'fr', 'oma', 'tion'] 네 개의 서브토큰으로 분해된다. 그 결과 쿼리 인코더에 들어가는 입력 임베딩이 단일 임베딩에서 네 개의 (위치 임베딩까지 더해진) 토큰 임베딩으로 완전히 달라진다. 입력이 달라지니 인코더가 내놓는 쿼리 임베딩도 원본과 크게 어긋나고, 결국 검색 효과가 떨어진다는 것이다.
이 가설을 정량적으로 뒷받침하기 위해, 저자들은 MS MARCO dev의 모든 쿼리에 대해 선행 연구[46]의 5가지 오타 생성기(RandInsert, RandDelete, RandSub, SwapNeighbor, SwapAdjacent)로 한 글자 오타를 주입했다. 쿼리당 오타는 하나만, 3글자 이상이면서 불용어가 아닌 단어에만 넣었다. 이렇게 6,975쌍의 (원본, 오타) 쿼리 쌍을 만들고, 특정 토큰 선택에 결과가 좌우되지 않도록 전 과정을 10회 반복해 평균을 냈다.
| Diff | 1 | 2 | 3 | 4 | 5 | 6 | 7 | Total |
|---|---|---|---|---|---|---|---|---|
| Count | 803.9 | 2926.6 | 2431.6 | 712.4 | 91.5 | 8.2 | 0.8 | 6,975 |
Table 1 (원논문): MS MARCO dev 10회 반복에 대한 토큰화 차이(tokenization difference) 분포의 평균. "Diff"는 원본 쿼리와 오타 쿼리의 토큰화 결과에서 서로 다른 토큰 수를, "Count"는 해당 차이를 보인 쿼리 수의 평균이다.
여기서 "토큰화 차이(tokenization difference)"는 원본 쿼리와 오타 쿼리를 각각 WordPiece로 토큰화했을 때 서로 다른 토큰의 개수를 뜻한다. 예를 들어 토큰화 차이가 3이라는 건, 오타 쿼리의 토큰 중 3개가 원본 쿼리의 토큰과 다르다는 의미다. Table 1을 보면 대부분의 오타 쿼리가 2 또는 3의 토큰화 차이를 유발하고(2,926.6 + 2,431.6건), 드물게는 6~7까지도 간다. 주목할 대목은 토큰화 차이가 0인 쿼리 쌍이 단 하나도 없다는 점이다. 한 글자 오타가 무조건 토큰 분포를 바꿔 놓는다는 뜻이다.
이 수치가 왜 치명적인지는 원본 쿼리의 평균 토큰 길이와 비교하면 드러난다. MS MARCO dev 쿼리는 WordPiece로 토큰화하면 평균 7개 토큰으로 쪼개진다. 그런데 토큰화 차이가 2~3이라는 건 전체 토큰의 29%~43%가 달라졌다는 뜻이다. 쿼리 절반 가까이가 다른 토큰으로 바뀌는 셈이니, WordPiece에 의존하는 DR이 오타에 민감한 것은 당연한 귀결이다.
그렇다면 이 토큰화 차이가 실제 표현(representation)과 효과(effectiveness)의 변화로 얼마나 이어지는가? 저자들은 두 가지 지표를 도입한다. 하나는 **인코딩 유사도(encoding similarity)**로, 원본 쿼리 임베딩과 오타 쿼리 임베딩 사이의 코사인 유사도다. 코사인이 작을수록 두 임베딩이 멀어졌다는 뜻이다. 다른 하나는 **MRR 하락률()**로, 원본 쿼리 대비 오타 쿼리의 RR(Reciprocal Rank) 점수가 평균적으로 얼마나 떨어지는지를 나타낸다.
여기서 는 원본 쿼리, 는 그에 대응하는 오타 쿼리다. 분자는 오타로 인한 RR 손실의 총합, 분모는 원본 RR의 총합이므로, 이 클수록 오타 때문에 효과가 많이 깎였다는 의미가 된다. 이 분석에는 대표 모델로 뒤에서 소개할 베이스라인 StandardBERT-DR을 사용했다.
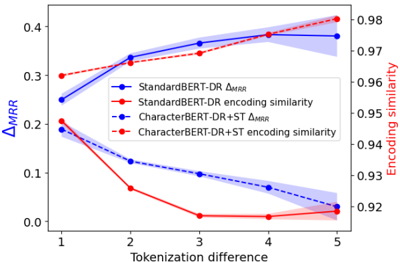
Figure 2: 토큰화 차이 값별 MRR 하락률(, 파란색)과 인코딩 유사도(빨간색) 분석. 실선은 StandardBERT-DR(오타 대응 학습 없음), 점선은 CharacterBERT-DR+ST다. 음영은 10회 오타 변형에 걸친 표준편차. 토큰화 차이 6, 7은 표본이 너무 적어 분산이 커지므로 분석에서 제외했다. (원논문)
Figure 2의 실선(StandardBERT-DR)부터 보자. 파란 실선()은 토큰화 차이가 커질수록 가파르게 올라간다. 토큰이 많이 달라진 오타일수록 효과 손실이 크다는 뜻이다. 반대로 빨간 실선(인코딩 유사도)은 토큰화 차이가 커질수록 떨어진다. 두 곡선이 정확히 반대로 움직이는 것이 핵심인데, 이는 "오타가 WordPiece 토큰화를 적게 흔들수록(토큰화 차이가 작을수록) 원본과 오타의 임베딩이 더 비슷하게 남고, 그만큼 효과 손실도 작다"는 인과 사슬을 그대로 보여준다. 토큰화가 많이 흔들리면 그 반대가 성립한다.
이 분석에서 저자들이 끌어내는 결론은 간명하다. 오타에 강한 DR을 만들려면 쿼리 임베딩이 오타의 유무에 불변(invariant)이어야 한다. 오타가 있든 없든 같은 쿼리라면 거의 같은 임베딩을 내놓아야 한다는 것이다. 이 목표를 (1) 입력 토큰화 자체를 오타에 둔감하게 만들고, (2) 학습으로 임베딩 불변성을 강제하는 두 갈래로 풀어내는 것이 다음 장의 CharacterBERT와 Self-Teaching이다. (Figure 2의 점선, 즉 CharacterBERT-DR+ST의 곡선은 6.1절에서 다시 다룬다.)
4. 제안 방법: CharacterBERT와 Self-Teaching
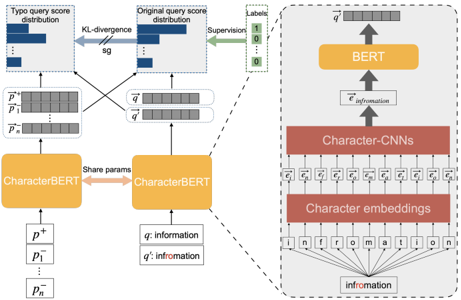
Figure 1: CharacterBERT + Self-Teaching 학습 구조. 왼쪽은 원본 쿼리 와 오타 쿼리 가 파라미터를 공유하는 CharacterBERT 인코더를 거쳐 각각 후보 패시지에 대한 점수 분포를 만들고, 두 분포 사이의 KL-divergence를 최소화하는 Self-Teaching 과정이다. 원본 쿼리 분포에는 stop-gradient(sg)가 걸리고, 정답 라벨로 지도 학습(Supervision)도 함께 수행된다. 오른쪽은 'infromation'이라는 오타 단어가 문자 임베딩(Character embeddings) → Character-CNNs → 단일 토큰 임베딩 → BERT로 처리되는 CharacterBERT 내부 흐름이다. (원논문)
Figure 1은 이 논문의 방법론을 한 장에 압축한 그림이다. 왼쪽의 Self-Teaching 학습 루프와 오른쪽의 CharacterBERT 인코더 내부 구조로 나눠서 읽으면 이해가 쉽다. 두 구성요소를 차례로 뜯어본다.
4.1 CharacterBERT 기반 오타-강건 DR
3장의 결론은 "오타에 둔감한 토큰화가 필요하다"였다. CharacterBERT[6]가 바로 이 요구에 들어맞는다. CharacterBERT는 BERT에서 WordPiece 토크나이저를 들어내고, 그 자리에 Character-CNN 모듈을 집어넣은 변종이다. Figure 1 오른쪽이 그 흐름을 보여준다. 입력 단어는 먼저 개별 문자로 쪼개지고, 각 문자는 문자 임베딩 행렬에서 해당 임베딩을 가져온다. 이 문자 임베딩들이 CNN 레이어 스택을 통과한 뒤 집계·투영되어 단어 하나당 단일 벡터 표현으로 합쳐진다. 이렇게 만든 토큰 표현은 문맥 독립적 단어 임베딩 역할을 하며, 위치·세그먼트 임베딩과 결합되어 BERT 본체로 들어간다.
BERT와의 결정적 차이는, CharacterBERT가 사전 정의된 어휘집에 의존하지 않고 어떤 단어든 단일 임베딩으로 표현한다는 점이다. 이것이 오타 문제에 정확히 들어맞는다. 'infromation'이라는 오타 단어도 WordPiece처럼 네 조각으로 쪼개지는 대신 단 하나의 임베딩으로 표현되므로, 'information'의 임베딩과 가까이 머물 여지가 생긴다. 문자 단위로 단어를 구성하니, 철자가 조금 틀려도 그 변화가 임베딩에 국소적으로만 반영되는 것이다. CharacterBERT가 여러 NLP 태스크, 특히 전문 도메인의 어휘 외(out-of-vocabulary) 단어에서 BERT보다 강건하다는 기존 보고[6]도 이 기대를 뒷받침한다. 다만 CharacterBERT를 DR 인코더로, 더 나아가 뉴럴 랭커로 쓴 연구는 이 논문이 처음이다.
구체적으로는 전형적인 바이-인코더 DR 구조를 그대로 두되, 쿼리와 패시지를 인코딩하는 백본만 CharacterBERT로 바꾼다. 각각의 [CLS] 토큰 출력 임베딩을 단일 벡터로 사용한다.
여기서 , 는 각각 쿼리 와 패시지 의 인코딩 벡터다. 바이-인코더이므로 패시지는 색인 시점에 미리 인코딩해 두고 질의 시점에는 쿼리만 인코딩하면 되어, DR 특유의 효율성은 그대로 유지된다. 랭킹은 ANN 탐색으로 구성하며, 쿼리-패시지 유사도는 내적으로 정의한다.
4.2 Self-Teaching: 자기 자신을 가르치는 지식 증류
CharacterBERT만으로도 오타 강건성이 어느 정도 개선되지만, 저자들의 실험에 따르면 오타 쿼리와 정상 쿼리 사이의 효과 격차를 메우기엔 여전히 부족하다. 그래서 등장하는 것이 Self-Teaching(ST)이다.
ST의 출발점은 지식 증류(KD)다. 기존 KD는 ColBERT 같은 강한 멀티벡터 교사나 크로스-인코더 교사로부터 학생 DR을 학습시킨다. 문제는 비용이다. 잘 학습된 교사 모델을 따로 준비하거나, 학생과 교사를 함께 학습시켜야 하므로 연산 자원이 많이 든다. ST는 이 제약을 비튼다. 모델 자신이 교사이자 학생이다. 학습 중 최적화되는 모델은 하나뿐이다.
이 발상의 근거는 3장(Figure 2)의 관찰에 있다. DR은 오타 없는 쿼리에서 훨씬 높은 효과를 낸다. 이는 DR이 오타만 없다면 쿼리를 잘 "이해"하고 좋은 관련성 추정을 할 수 있다는 뜻이다. 그렇다면 오타 쿼리에 대해서도, 대응하는 정상 쿼리로부터 얻은 DR의 지식을 주입해 주면 되지 않을까? 바로 이것이 ST다. 같은 모델이 정상 쿼리에 대해 내놓는 "믿을 만한" 판단을, 오타 쿼리에 대한 판단의 교사 신호로 삼는 것이다.
학습 과정은 이렇게 돌아간다. 학습 쿼리 집합 의 각 쿼리 에 대해, 3장에서 쓴 오타 생성기 중 하나를 무작위로 골라 임의의 단어에 적용해 오타 쿼리 를 만든다(실험에서는 각 변환을 균등 확률로 선택하되, 실제 검색 로그의 오타 유형 분포에 맞춰 조정할 수도 있다고 언급한다). 이때 쌍 는 원본 쿼리 에 딸린 동일한 후보 패시지 집합 을 공유한다. 그러면 와 각 패시지의 유사도 , 그리고 와 각 패시지의 유사도 를 각각 계산할 수 있고, 이를 Softmax로 정규화해 점수 분포를 만든다.
에 대한 분포 도 같은 방식으로 정의된다. ST의 목표는 오타 쿼리의 점수 분포 를 정상 쿼리의 점수 분포 에 맞추는 것, 즉 둘 사이의 KL-divergence를 최소화하는 것이다.
여기서 는 stop-gradient 연산으로, 정상 쿼리(원본)의 점수 분포에는 그래디언트가 흐르지 않게 막는 장치다. 즉 정상 쿼리의 분포를 고정된 "정답"처럼 두고, 오타 쿼리의 분포가 그쪽으로 끌려오도록 학습한다. 저자들은 이 stop-gradient가 학습을 더 안정시키고 전체 효과를 약간 높인다고 보고한다. 교사와 학생이 같은 모델인데도 학습이 발산하지 않는 비결이 바로 이 지점이다.
문제는 이 KL 손실만으로는 "원본과 오타의 분포를 맞추라"는 신호만 줄 뿐, 정작 "무엇이 정답 패시지인가"라는 관련성 신호가 없다는 점이다. 두 분포가 똑같이 틀려도 KL은 0이 될 수 있다. 그래서 정답 라벨을 이용한 지도 대조 학습(supervised contrastive) 손실을 함께 쓴다. MS MARCO에서 각 쿼리의 후보 집합 는 평균 하나의 정답 패시지 와 여러 개의 네거티브 패시지 를 포함하는데, 이를 교차 엔트로피로 학습한다.
최종 ST 손실은 이 두 손실의 합이다.
정리하면, 가 "정상 쿼리로 관련성을 제대로 배워라"를 담당하고, 이 "오타 쿼리의 판단을 정상 쿼리의 판단에 맞춰라"를 담당한다. 교사 모델을 따로 두지 않고, 같은 모델이 정상 쿼리에서 만든 신뢰할 만한 분포를 오타 쿼리 학습의 목표로 재활용하는 것이 ST의 핵심이자 +Aug(데이터 증강) 방식과 구별되는 지점이다. 증강은 오타 쿼리를 그냥 학습 데이터에 섞어 "이것도 맞혀라"라고 시킬 뿐, 정상 쿼리의 판단을 명시적으로 전수하지는 않는다. ST는 그 전수 과정을 KL 손실로 명확히 설계했다는 점에서 한 걸음 더 나아간 셈이다.
5. 실험 설정
5.1 데이터셋과 평가
평가에는 네 개의 데이터셋을 쓴다. 모두 MS MARCO가 공개한 880만 패시지를 코퍼스로 공유하며, 쿼리 집합에서만 차이가 난다.
- MS MARCO dev: 6,980개 쿼리, 쿼리당 평균 1개의 정답 패시지. 지표는 MRR@10과 R@1000.
- TREC DL 2019 / 2020: 각각 43개, 54개의 판정 쿼리로, MS MARCO dev보다 훨씬 촘촘한 관련성 판정(평균 215.3개, 210.9개 패시지 판정)을 갖는다. 0~3단계의 등급 판정이며, 지표는 nDCG@10, MRR, MAP. 관련성 라벨 1(on-topic이지만 관련 없음)은 이진 지표 계산 시 0으로 합친다.
- DL-typo: 이 논문이 새로 만든, 실제 사용자 오타 쿼리 데이터셋.
MS MARCO dev, DL 2019, DL 2020에는 3장에서 쓴 합성 오타 생성 과정을 적용한다. 각 쿼리에 오타를 주입하고 원본의 관련성 판정을 그대로 물려주며, 오타 유형과 영향받는 단어가 결과를 좌우하지 않도록 10회 반복해 평균을 낸다.
학습에는 MS MARCO 학습 쿼리 약 50만 개를 쓴다. 이 쿼리들은 MS Bing 검색 로그에서 수집된 것으로, 쿼리당 평균 1개의 정답 라벨을 갖는다.
5.2 DL-typo: 실제 오타 데이터셋
합성 오타가 아무리 현실적이어도 실제 사용자 오타와는 다를 수 있다. 이 격차를 메우려고 만든 것이 DL-typo다. 저자들은 Hagen 등[12]이 공개한 대규모 쿼리 철자 교정 코퍼스(원본은 익명화된 AOL 검색 로그[28])에서, 네 가지 흔한 오타 유형에 걸쳐 60개 오타 쿼리와 그에 대응하는 사람이 교정한 정상 쿼리를 균등하게 뽑았다. 유형별 구성은 RandInsert 15개, RandDelete 15개, SwapNeighbor 15개, RandSub 15개(이 중 SwapAdjacent 3개 포함)다.
관련성 판정을 위해, 60개 오타 쿼리와 60개 교정 쿼리(합 120개)를 7개 검색 모델(BM25, BERT, BERT+augment, BERT+ST, CharacterBERT, CharacterBERT+augment, CharacterBERT+ST)에 돌려 각 쿼리당 상위 10개 패시지를 풀링하고, TREC DL 판정 지침에 따라 Relevation[19] 도구로 전수 판정했다.
| #Queries | 0 (Irrelevant) | 1 (Related) | 2 (Relevant) | 3 (Perfect) | Total |
|---|---|---|---|---|---|
| 60 | 37.75 | 11.50 | 9.67 | 4.60 | 63.52 |
Table 2 (원논문): DL-typo 데이터셋 통계. 쿼리당 평균 판정 패시지 수를 관련성 라벨별로 나눈 것이다.
Table 2를 보면 쿼리당 평균 63.52개 패시지가 판정되었고, 그중 관련 있는(라벨 2 이상) 패시지는 평균 14.27개(9.67 + 4.60) 수준이다. 규모 자체는 60개 쿼리로 작지만, TREC DL 방식의 촘촘한 전수 판정을 따랐다는 점에서 실제 오타에 대한 신뢰할 만한 평가 기반이 된다. DL-typo는 합성이 아니라 사람이 실제로 낸 오타와 사람이 교정한 정답 쌍을 담고 있다는 데 의미가 있다.
5.3 베이스라인과 구현
비교 대상은 크게 세 부류다. 첫째, 오타를 명시적으로 다루지 않는 강력한 DR인 ANCE[42]와 TCT-ColBERTv2[23]다. 둘 다 학습 비용이 높아 Pyserini[20]의 공개 체크포인트와 사전 구축 ANN 색인을 그대로 가져다 썼다. 참고용으로 BM25도 함께 넣었다.
둘째, 저자들이 직접 구현한 StandardBERT-DR이다. ANCE나 TCT-ColBERTv2는 정상 쿼리 성능 극대화를 위한 정교한 학습 "트릭"이 많이 들어가 있어 CharacterBERT-DR과 공정하게 비교하기 어렵다. 그래서 DPR[17]과 유사하면서도 전반적으로 더 나은 vanilla BERT DR을 따로 만들었다. 이 StandardBERT-DR과 CharacterBERT-DR은 백본(그리고 그에 따른 토크나이저)만 다를 뿐 학습 설정이 동일해, 토크나이저의 효과를 깨끗하게 분리해 볼 수 있다.
두 모델 모두 DPR식 하드 네거티브 학습을 따른다. 각 학습 쿼리마다 BM25 상위 200개에서 하드 네거티브 7개와 정답 1개를 뽑고, 배치 크기 16에 in-batch 네거티브를 적용해 학습 샘플당 개의 네거티브를 확보한다. AdamW, 학습률 5e-6, 선형 스케줄로 150,000 스텝 학습하며, Tesla V100 32G 한 장으로 약 하루면 끝난다. 백본은 Huggingface의 BERT-base-uncased(StandardBERT-DR)와 일반 도메인으로 사전학습된 CharacterBERT 체크포인트(CharacterBERT-DR)를 쓴다.
셋째, 오타 대응 학습 기법 두 가지를 각 백본에 조합한다. +Aug는 선행 연구[46]의 데이터 증강(typo-aware) 학습이고, +ST는 이 논문의 Self-Teaching이다. 결과적으로 네 가지 조합이 핵심 비교군이 된다.
- StandardBERT-DR+Aug: 선행 연구[46]의 원래 방법
- StandardBERT-DR+ST: 증강 대신 Self-Teaching을 쓴 BERT 기반 DR
- CharacterBERT-DR+Aug: 제안한 CharacterBERT DR에 증강 학습
- CharacterBERT-DR+ST: 제안한 CharacterBERT DR에 Self-Teaching (최종 제안 모델)
통계적 유의성은 Bonferroni 보정을 적용한 양측 쌍체 t-검정으로 판정한다. 저자들은 CharacterBERT와 ST가 어떤 DR 위에도 얹힐 수 있어 ANCE나 TCT-ColBERTv2와도 결합 가능하지만, 이들의 높은 학습 비용 때문에 이번엔 하지 않고 후속 연구로 남긴다고 밝힌다.
6. 실험 결과
6.1 합성 오타 쿼리 결과
메인 결과는 Table 3에 담겨 있다. MS MARCO, TREC DL 2019/2020에 대해 오타 없는 쿼리(상단 a~i)와 합성 오타 쿼리(하단 j~r)를 모두 평가했다.
| Queries | Methods | MRR@10 | R@1000 | nDCG@10 | MRR | MAP | nDCG@10 | MRR | MAP |
|---|---|---|---|---|---|---|---|---|---|
| MS MARCO | MS MARCO | DL 2019 | DL 2019 | DL 2019 | DL 2020 | DL 2020 | DL 2020 | ||
| Without Typos | a) BM25 | .187 | .857 | .497 | .685 | .290 | .487 | .659 | .287 |
| b) ANCE [42] | .330 | .959 | .645 | .837 | .371 | .641 | .790 | .403 | |
| c) TCT-ColBERTv2 [23] | .358 | .969 | .720 | .887 | .447 | .689 | .839 | .475 | |
| d) StandardBERT-DR | .325 | .953 | .608 | .719 | .353 | .633 | .798 | .407 | |
| e) CharacterBERT-DR | .327 | .950 | .609 | .772 | .340 | .586 | .744 | .379 | |
| f) StandardBERT-DR+Aug [46] | .325 | .951 | .620 | .803 | .347 | .629 | .794 | .398 | |
| g) StandardBERT-DR+ST | .331 | .949 | .616 | .826 | .345 | .631 | .781 | .393 | |
| h) CharacterBERT-DR+Aug | .331 | .949 | .634 | .841 | .343 | .612 | .843 | .398 | |
| i) CharacterBERT-DR+ST | .325 | .950 | .643 | .845 | .340 | .606 | .827 | .390 | |
| With Typos | j) BM25 | .095 | .611 | .256 | .340 | .147 | .291 | .410 | .168 |
| k) ANCE [42] | .200 | .803 | .448 | .643 | .247 | .461 | .603 | .278 | |
| l) TCT-ColBERTv2 [23] | .199 | .806 | .449 | .597 | .256 | .471 | .615 | .302 | |
| m) StandardBERT-DR | .136 | .688 | .298 | .427 | .167 | .323 | .459 | .194 | |
| n) CharacterBERT-DR | .159 | .724 | .355 | .506 | .189 | .326 | .484 | .203 | |
| o) StandardBERT-DR+Aug [46] | .215 | .841 | .434 | .582 | .235 | .466 | .630 | .280 | |
| p) StandardBERT-DR+ST | .228 | .856 | .443 | .615 | .241 | .481 | .629 | .284 | |
| q) CharacterBERT-DR+Aug | .251 | .877 | .498 | .688 | .264 | .486 | .683 | .300 | |
| r) CharacterBERT-DR+ST | .263 | .894 | .519 | .706 | .268 | .514 | .722 | .314 |
Table 3 (원논문): 오타 없는 쿼리와 합성 오타 쿼리에 대한 결과. 오타 생성은 10회 반복하며, 평균은 먼저 시드 쿼리별로 낸 뒤 쿼리 전체에 대해 다시 낸다. 굵게 표시한 행이 이 논문의 최종 제안 모델이다.
읽어낼 지점이 여럿이다. 하나씩 짚어 보자.
정상 쿼리에서는 큰 손해가 없다. 상단(a~i)을 보면 모든 DR이 BM25를 앞선다. ANCE(.330)와 TCT-ColBERTv2(.358)는 정교한 학습 덕에 vanilla StandardBERT-DR(.325)보다 MS MARCO MRR@10에서 높지만, 그 차이가 StandardBERT-DR과 ANCE 사이에서는 통계적으로 유의하지 않다. 더 중요한 건 CharacterBERT로 백본을 바꿔도(e, .327) StandardBERT-DR(d, .325)과 거의 동일하다는 점이다. 백본 교체가 정상 쿼리 성능을 깎지 않는다는 뜻으로, 오타 대응의 전제 조건을 만족한다. 유의한 차이는 TREC DL 2020 nDCG@10 한 군데뿐이었다.
흥미로운 부수 효과도 있다. 오타 대응을 겨냥한 학습(f~i)이 오히려 정상 쿼리 성능까지 살짝 끌어올리는 경향이 보인다. 예를 들어 CharacterBERT-DR+Aug와 +ST 모두 TREC DL 2019/2020 nDCG@10과 MRR에서 순수 CharacterBERT-DR보다 높다(유의하지는 않음). 오타 쿼리로 학습 신호를 늘린 것이 일종의 정규화로 작용한 것으로 보인다.
오타 쿼리에서는 대응 없는 모델이 처참하게 무너진다. 하단에서 오타 대응이 없는 j~m을 상단 대응 행(a~d)과 비교하면 급락이 뚜렷하다. StandardBERT-DR은 MS MARCO MRR@10이 .325에서 .136으로 58% 추락한다. ANCE(.330→.200), TCT-ColBERTv2(.358→.199) 같은 고성능 DR도 예외가 아니다. 특히 TCT-ColBERTv2는 정상 쿼리 1위였지만 오타 쿼리에서는 .199로 ANCE(.200)와 비슷한 수준까지 떨어진다. 정교한 학습이 오타 강건성을 보장하지 않는다는 방증이다.
CharacterBERT 단독으로는 부족하다. 오타 쿼리에서 CharacterBERT-DR(n, .159)은 StandardBERT-DR(m, .136)보다 유의하게 낫다. 토큰화를 오타에 둔감하게 바꾼 효과가 분명히 있다. 하지만 .159라는 절대 수치는 여전히 낮다. 토크나이저만 바꿔서는 격차를 메우기 어렵고, 학습 기법이 더해져야 한다는 3장의 예고가 수치로 확인되는 셈이다.
ST가 Aug를 꾸준히 앞선다. 오타 대응 학습을 적용한 o~r을 보면, 같은 백본에서 ST가 Aug보다 거의 항상 낫다(StandardBERT-DR+ST의 TREC DL 2020 MRR 한 경우만 예외, 유의하지 않음). MS MARCO dev에서 StandardBERT-DR 기준 ST의 모든 지표 개선과 CharacterBERT-DR 기준 R@1000 개선은 통계적으로 유의하다. 그리고 어느 학습 기법을 쓰든 CharacterBERT-DR이 StandardBERT-DR보다 오타 쿼리에서 높다. 3장의 직관("오타 둔감 토큰화 + 임베딩 불변 학습")이 두 축 모두에서 성립함을 보여준다.
최종 모델의 성과. CharacterBERT-DR+ST(r)는 오타 쿼리에서 MS MARCO MRR@10 .263을 기록한다. 대응 없는 StandardBERT-DR(.136) 대비 약 2배, 선행 연구인 StandardBERT-DR+Aug(.215) 대비로도 뚜렷한 개선이다. R@1000에서는 .894로, 비교군 중 통계적으로 가장 높다(q인 CharacterBERT-DR+Aug보다도 유의하게 높음). 오타가 섞인 상황에서도 정답 패시지를 상위 1,000개 안에 끌어오는 능력, 즉 1차 검색기로서의 리콜이 크게 회복됐다는 의미다.
이제 3장에서 미뤄 둔 Figure 2의 점선(CharacterBERT-DR+ST)을 보자. StandardBERT-DR의 실선과는 정반대 추세가 나타난다. 토큰화 차이가 커질수록 CharacterBERT-DR+ST의 (파란 점선)은 오히려 감소하고, 인코딩 유사도(빨간 점선)는 증가한다. 오타가 토큰화를 많이 흔드는 어려운 경우일수록, 제안 모델이 원본과 오타의 임베딩을 더 가깝게 유지하면서 효과 손실을 줄인다는 뜻이다. 3장에서 세운 "임베딩 불변성" 목표가 실제로 달성됐음을, 베이스라인과 정반대로 뒤집힌 곡선이 시각적으로 증명한다. 솔직히 이 그림 한 장이 방법론의 당위성을 가장 설득력 있게 보여주는 대목이다.
6.2 실제 오타 쿼리 결과 (DL-typo)
합성 오타에서의 성공이 실제 사용자 오타로도 이어질까? DL-typo 결과가 Table 4다.
| Queries | Methods | nDCG@10 | MRR | MAP |
|---|---|---|---|---|
| Without Typos | a) BM25 | .527 | .633 | .298 |
| b) ANCE [42] | .606 | .770 | .480 | |
| c) TCT-ColBERTv2 [23] | .650 | .890 | .565 | |
| d) StandardBERT-DR | .722 | .833 | .565 | |
| e) CharacterBERT-DR | .716 | .855 | .538 | |
| f) StandardBERT-DR+Aug [46] | .737 | .840 | .594 | |
| g) StandardBERT-DR+ST | .725 | .827 | .583 | |
| h) CharacterBERT-DR+Aug | .713 | .821 | .539 | |
| i) CharacterBERT-DR+ST | .706 | .793 | .539 | |
| With Typos | j) BM25 | .212 | .203 | .104 |
| k) ANCE [42] | .340 | .508 | .245 | |
| l) TCT-ColBERTv2 [23] | .310 | .421 | .221 | |
| m) StandardBERT-DR | .283 | .371 | .167 | |
| n) CharacterBERT-DR | .297 | .386 | .224 | |
| o) StandardBERT-DR+Aug [46] | .408 | .502 | .283 | |
| p) StandardBERT-DR+ST | .433 | .531 | .301 | |
| q) CharacterBERT-DR+Aug | .443 | .598 | .326 | |
| r) CharacterBERT-DR+ST | .473 | .615 | .348 |
Table 4 (원논문): DL-typo(실제 오타) 결과. 굵게 표시한 행이 최종 제안 모델이다.
여기서 한 가지 주의할 점이 있다. StandardBERT-DR과 CharacterBERT-DR 계열(d~i, m~r)은 DL-typo 풀링에 참여했으므로 상위 10위까지 전수 판정된 반면, ANCE와 TCT-ColBERTv2는 풀링에 들어가지 않아 미판정 패시지가 많다(상위 10개 중 20~30%가 미판정). 따라서 ANCE·TCT-ColBERTv2와의 직접 비교는 이들에게 불리하게 작용할 수 있어 조심해서 봐야 한다.
전반적 추세는 Table 3과 일관된다. 오타 없는 쿼리(상단)에서는 Aug든 ST든 표준 학습과 비슷한 수준이고, 오타 쿼리(하단)에서는 오타 대응 학습이 확실히 효과를 낸다. 실제 오타에서도 최종 모델 CharacterBERT-DR+ST(r)가 nDCG@10 .473, MRR .615, MAP .348로 세 지표 모두에서 최고다. 선행 연구 StandardBERT-DR+Aug(o, nDCG@10 .408) 대비 6.5점 높고, 대응 없는 StandardBERT-DR(m, .283)과는 비교가 안 되는 격차다. 합성 오타에서 보인 우위가 실제 오타에서도 재현된다는 점이 DL-typo의 핵심 메시지다.
그렇다면 쿼리 중 오타 비율이 얼마나 되어야 CharacterBERT-DR+ST를 쓰는 게 이득일까? 이 질문을 Figure 3이 다룬다.
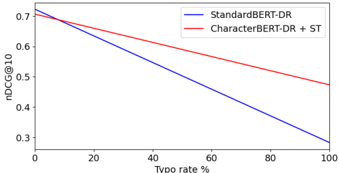
Figure 3: 쿼리 집합에서 오타 쿼리의 상대 비율(Typo rate %)에 따른 nDCG@10 변화. 파란색이 StandardBERT-DR, 빨간색이 CharacterBERT-DR+ST다. (원논문)
Figure 3은 DL-typo에서 오타 쿼리 비율을 0%에서 100%까지 바꿔 가며 두 모델의 nDCG@10을 그린 것이다. 오타가 전혀 없을 때(0%)는 두 모델이 거의 같은 지점에서 출발한다. 오타 비율이 늘수록 두 선 모두 하락하지만, StandardBERT-DR(파란색)이 훨씬 가파르게 떨어진다. 두 선이 교차하는 지점은 약 8%로, 전체 쿼리의 8%만 오타여도 CharacterBERT-DR+ST가 더 높은 효과를 낸다. 그 차이가 통계적으로 유의해지는 지점은 약 30%다.
이 8%라는 수치가 왜 중요한가 하면, 여러 선행 연구[12, 27, 35, 37, 38]가 실제 검색 로그의 오타 비율이 상당히 높다고 보고해 왔기 때문이다. 게다가 그 오타를 일일이 교정하는 비용도 만만치 않다. 현실의 검색 서비스라면 오타 비율이 8%를 넘는 경우가 드물지 않을 테니, CharacterBERT-DR+ST가 실용적 선택지가 될 수 있다는 논증이다.
지연 시간과 모델 크기. 직관적으로는 Character-CNN을 돌리는 CharacterBERT가 단순 룩업 테이블을 쓰는 BERT보다 느릴 것 같다. 그런데 실측에서는 GPU 쿼리 지연이 BERT보다 겨우 1밀리초 느릴 뿐이었다. Character-CNN이 만드는 토큰 임베딩 수가 WordPiece보다 대체로 적어서, BERT 트랜스포머 레이어의 셀프 어텐션 계산이 오히려 덜 무거워지기 때문이다. 오타 쿼리가 WordPiece에서 여러 조각으로 불어나는 것과 대비되는 지점이다. 파라미터 수도 CharacterBERT가 105M으로 BERT의 110M보다 적다. WordPiece 어휘집의 토큰 임베딩을 저장할 필요 없이 문자 임베딩 262개와 약간의 CNN 파라미터만 있으면 되기 때문이다. 성능을 지키면서 모델이 더 가볍고 느려지지도 않는다는 건 실무 관점에서 꽤 반가운 조합이다.
6.3 CharacterBERT-DR+ST vs 스펠체커
실제 검색 엔진이 오타를 다루는 가장 흔한 방식은 쿼리를 검색기에 넣기 전에 스펠체커로 교정하는 전처리 파이프라인이다. 그렇다면 end-to-end로 오타를 처리하는 CharacterBERT-DR+ST는 이 파이프라인과 비교해 어느 정도일까? 저자들은 규칙 기반 pyspellchecker와 딥러닝·통계 기계번역에 대규모 크롤링 데이터까지 결합한 Microsoft Bing 스펠체크 API(MSspellchecker)를 비교 대상으로 삼았다.
| Queries | Method | MRR@10 | R@1000 | nDCG@10 | MRR | MAP |
|---|---|---|---|---|---|---|
| MS MARCO | MS MARCO | DL-typo | DL-typo | DL-typo | ||
| Without Typos | a) pyspellchecker → CharacterBERT-DR | .279 | .887 | .703 | .824 | .527 |
| b) MSspellchecker → CharacterBERT-DR | .326 | .948 | .715 | .855 | .538 | |
| c) CharacterBERT-DR+ST | .325 | .950 | .706 | .793 | .539 | |
| With Typos | d) pyspellchecker → CharacterBERT-DR | .234 | .821 | .462 | .573 | .339 |
| e) MSspellchecker → CharacterBERT-DR | .305 | .930 | .714 | .915 | .539 | |
| f) CharacterBERT-DR+ST | .263 | .894 | .473 | .615 | .348 |
Table 5 (원논문): CharacterBERT-DR+ST와 스펠체커 파이프라인 비교. "A → B"는 A로 교정한 쿼리를 B에 넣는 파이프라인을 뜻한다.
결과를 뜯어보면 양면적이다.
정상 쿼리에서는 규칙 기반 스펠체커가 오히려 독이 된다. MS MARCO 정상 쿼리에서 pyspellchecker 파이프라인(a, MRR@10 .279)은 CharacterBERT-DR+ST(c, .325)보다 유의하게 낮다. 오타가 없는데도 pyspellchecker가 멀쩡한 단어를 오타로 잘못 짚어 "교정"해 버리면서 검색기 성능을 깎아먹기 때문이다. 반면 MSspellchecker(b)와 CharacterBERT-DR+ST(c)는 비슷한 수준이다. DL-typo 정상 쿼리에서는 세 방법 간 유의한 차이가 없었다.
오타 쿼리에서는 MSspellchecker가 가장 강하다. 오타 쿼리에서 MSspellchecker 파이프라인(e)은 다른 방법들을 크게 앞선다. DL-typo에서 MRR .915에 이를 정도다. 다만 저자들은 MSspellchecker가 비교군 중 학습·추론 비용이 가장 높고, 훨씬 방대한 데이터와 라벨로 파인튜닝됐을 가능성이 크다는 점을 분명히 한다. 공정한 맞비교라기보다 "최상단 상용 시스템이 어디쯤에 있는가"를 보여주는 기준선에 가깝다.
규칙 기반 스펠체커보다는 확실히 낫다. CharacterBERT-DR+ST(f)는 오타 쿼리에서 pyspellchecker 파이프라인(d)을 양쪽 데이터셋에서 앞선다(MS MARCO에서 유의). end-to-end 방식이 규칙 기반 전처리 파이프라인보다 더 나은, 적어도 대등한 효과를 더 낮은 연산 비용으로 달성한다는 뜻이다.
여기서 저자들이 강조하는 건 효과 수치만이 아니라 엔지니어링상의 이점이다. 스펠체커 + 검색기로 이뤄진 파이프라인은 교정 단계와 검색 단계가 분리된 두 컴포넌트를 각각 유지·모니터링·갱신해야 한다. 반면 CharacterBERT-DR+ST는 오타 처리를 검색기 안에 녹인 단일 시스템이라 구조가 단순하고 관리 부담이 작다. 성능이 상용 스펠체커에 다소 못 미치더라도, 시스템 복잡도를 줄이는 대안으로서의 가치가 있다는 주장이다.
7. 강점과 한계
강점
- 원인 규명의 명료함: "DR이 오타에 약하다"는 현상을 WordPiece 토큰화 → 입력 임베딩 변화 → 쿼리 임베딩 변화 → 효과 하락이라는 인과 사슬로 깔끔하게 설명했다. Table 1의 토큰화 차이 분포와 Figure 2의 상반된 두 곡선이 이 설명을 정량적으로 뒷받침한다. 방법론이 이 진단에서 자연스럽게 도출되는 구성이 설득력 있다.
- Self-Teaching의 효율성: 별도 교사 모델 없이 모델 자신을 교사로 삼는 설계는 KD의 연산 부담을 크게 던다. 그러면서도 Table 3에서 기존 증강 학습(Aug)을 일관되게 앞선다. "단일 모델만 최적화한다"는 단순함과 성능을 동시에 잡았다.
- 실제 오타 데이터셋 기여: DL-typo는 합성이 아닌 실제 사용자 오타와 사람이 교정한 정답 쌍을 TREC DL 방식으로 전수 판정한 데이터셋이다. 합성 평가에만 의존하던 선행 연구의 한계를 메우고, 후속 연구의 공통 평가 기반이 될 수 있다.
- 실무 친화적 특성: 성능을 지키면서 모델이 더 가볍고(105M vs 110M) 지연도 사실상 동일하다(+1ms). Figure 3이 보여주듯 오타 비율 8%만 넘어도 이득이며, 코드·데이터·결과를 모두 공개했다.
한계 및 아쉬운 점
- 상용 스펠체커와의 격차: Table 5에서 MSspellchecker 파이프라인은 오타 쿼리에서 CharacterBERT-DR+ST를 뚜렷이 앞선다. 저자들도 인정하듯, end-to-end 방식이 고도로 학습된 딥러닝 스펠체커를 완전히 대체하기엔 아직 거리가 있다.
- 단순한 DR 학습 레시피에만 검증: 제안 방법은 DPR식 하드 네거티브 학습 위에서만 평가됐다. ANCE나 TCT-ColBERTv2 같은 정교한 학습 파이프라인에 얹었을 때도 같은 이득이 나는지는 비용 문제로 후속 과제로 미뤄졌다. CharacterBERT와 ST가 "어떤 DR에도 얹힌다"는 주장이 실험으로 완전히 검증되지는 않은 셈이다.
- DL-typo의 규모: 60개 쿼리는 실제 오타 평가로서 신뢰할 만한 전수 판정을 갖췄지만, 통계적 검정력 면에서는 작은 편이다. 영어, 그리고 네 가지 오타 유형에 한정됐다는 점도 일반화의 폭을 제한한다.
- 언어 의존성: 오타 생성기와 CharacterBERT 모두 영어 기준이다. 저자들도 현실적 오타 생성이 언어 의존적이라고 밝혔듯, 다른 언어(특히 한국어처럼 음절·자모 구조가 다른 언어)로의 확장은 별도 연구가 필요하다.
- ST 손실의 민감도 분석 부재: 와 을 단순 합산하는데, 두 손실의 가중치 비율이나 오타 생성기 선택 분포가 결과에 미치는 영향에 대한 ablation이 있었다면 설계의 견고함을 더 잘 보일 수 있었을 것이다.
8. 마치며
이 논문의 미덕은 "현상 → 원인 → 해법 → 검증"의 고리를 한 편 안에서 단단하게 닫았다는 데 있다. BERT 기반 밀집 검색기가 오타에 약한 이유를 WordPiece 토큰화에서 찾아내고, 그 진단으로부터 "쿼리 임베딩을 오타에 불변으로 만들라"는 목표를 세운 뒤, 이를 토큰화 수준(CharacterBERT)과 학습 수준(Self-Teaching) 양쪽에서 공략한다. Figure 2에서 베이스라인과 제안 모델의 곡선이 정반대로 뒤집히는 장면은, 설정한 목표가 실제로 달성됐음을 한눈에 보여주는 설득력 있는 증거다.
실무적으로 보면, Self-Teaching이 별도 교사 없이 단일 모델만 학습시키면서도 기존 증강 학습을 앞선다는 점, 그리고 CharacterBERT가 성능·크기·속도 어느 쪽에서도 손해를 보지 않는다는 점이 매력적이다. 검색 로그의 오타 비율이 8%만 넘어도 이득이라는 Figure 3의 분석은, 이 방법이 학술적 호기심을 넘어 실제 서비스에 쓸 만하다는 주장을 뒷받침한다. 스펠체커 전처리 파이프라인을 검색기 하나로 대체해 시스템 복잡도를 줄일 수 있다는 엔지니어링 관점의 제안도 눈여겨볼 만하다.
물론 상용 스펠체커와의 격차, 단순 학습 레시피에만 머문 검증, 영어·소규모에 한정된 평가 같은 빈틈은 남아 있다. 그럼에도 오타라는 구체적이고 현실적인 강건성 문제를, 원인 분석과 실제 데이터셋까지 갖춰 정면으로 다뤘다는 점에서 밀집 검색 강건성 연구의 좋은 디딤돌이다. 저자들이 던진 "CharacterBERT와 ST를 더 정교한 DR 위에 얹으면 어떻게 될까"라는 질문은, 다음 연구자들이 이어받기 좋은 열린 과제로 남아 있다.
References
- [6] El Boukkouri et al., 2020. "CharacterBERT: Reconciling ELMo and BERT for Word-Level Open-Vocabulary Representations From Characters." COLING.
- [13] Hinton et al., 2015. "Distilling the Knowledge in a Neural Network." arXiv:1503.02531.
- [17] Karpukhin et al., 2020. "Dense Passage Retrieval for Open-Domain Question Answering." EMNLP. (DPR)
- [23] Lin et al., 2021. "In-Batch Negatives for Knowledge Distillation with Tightly-Coupled Teachers for Dense Retrieval." RepL4NLP. (TCT-ColBERTv2)
- [42] Xiong et al., 2020. "Approximate Nearest Neighbor Negative Contrastive Learning for Dense Text Retrieval." ICLR. (ANCE)
- [46] Zhuang & Zuccon, 2021. "Dealing with Typos for BERT-based Passage Retrieval and Ranking." EMNLP. (선행 연구, typo-aware training)
- [12] Hagen et al., 2017. "A Large-Scale Query Spelling Correction Corpus." SIGIR. (DL-typo 원천)
- [10] Gao et al., 2022. "Tevatron: An Efficient and Flexible Toolkit for Dense Retrieval." arXiv:2203.05765.
- [20] Lin et al., 2021. "Pyserini: A Python Toolkit for Reproducible Information Retrieval Research." SIGIR.