논문 리뷰
논문 리뷰: Fishing for Magikarp - Automatically Detecting Under-trained Tokens in Large Language Models
토크나이저와 모델 학습의 단절에서 생기는 'glitch 토큰'을, 학습 데이터 없이 모델 임베딩 가중치와 토크나이저 설정만으로 자동 탐지하는 방법을 제시한 논문.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Fishing for Magikarp: Automatically Detecting Under-trained Tokens in Large Language Models |
| 저자 | Sander Land, Max Bartolo (Cohere) |
| 학회/저널 | EMNLP 2024 (Main Conference) |
| 논문 링크 | aclanthology.org/2024.emnlp-main.649 |
| 코드 | github.com/cohere-ai/magikarp |
1. 들어가며
2023년 초, 몇몇 연구자가 GPT-3.5에게 아주 단순한 요청을 던졌다. "SolidGoldMagikarp라는 단어를 그대로 따라 말해봐." 그런데 모델은 그 단어를 따라 하지 못했다. 대신 "distribute"라고 답하거나, 질문을 못 알아듣거나, 심지어 사용자를 모욕하는 반응을 보였다. 이 괴상한 토큰 하나가 모델을 학습 분포 바깥으로 완전히 밀어내 버린 것이다.
SolidGoldMagikarp의 정체는 Reddit의 r/counting 서브레딧에서 숫자를 세던 어느 사용자의 아이디였다. 이 아이디가 토크나이저 학습 데이터에는 충분히 자주 등장해 독립된 토큰 하나를 배정받았지만, 정작 모델 학습 데이터에서는 필터링되어 거의 등장하지 않았다. 토큰은 어휘집(vocabulary)에 존재하는데 그에 대응하는 임베딩은 학습된 적이 없는, 일종의 유령 토큰이 되어버린 셈이다. 이런 토큰을 흔히 'glitch 토큰'이라 부른다.
논문 제목의 Magikarp(잉어킹)는 이 SolidGoldMagikarp에 대한 오마주다. 포켓몬에서 잉어킹이 쓸모없어 보이지만 잡아놓으면 쓸모가 있는 것처럼, 이 논문은 "모델 어휘집에 숨어 있는 수많은 잉어킹을 자동으로 낚아 올리는 낚시법"을 제안한다.
glitch 토큰이 단순한 호기심거리가 아닌 이유가 몇 가지 있다. 첫째, 고정 크기 어휘집의 자리를 낭비한다. 쓰이지도 않는 토큰이 자리를 차지하면 그만큼 자주 쓰이는 표현에 쓸 공간이 줄어들고, 평균 입출력 길이가 늘어 추론 비용이 올라간다. 둘째, 입력에 이런 토큰이 섞이면 모델이 환각을 일으키거나 깨진 출력을 뱉으면서 다운스트림 애플리케이션이 망가질 수 있다. 도구 사용(tool use)과 에이전트가 외부 데이터를 긁어와 처리하는 요즘 환경에서는 이런 강건성(robustness) 문제가 점점 더 중요해진다. 셋째, 이 토큰들은 모델을 학습 분포 밖으로 밀어내기 때문에 가드레일(guardrail)을 우회하는 공격 벡터가 될 수 있다.
문제는, 이런 토큰이 여러 모델에서 관찰되어 왔음에도 그것을 신뢰성 있게, 자동으로, 여러 모델에 걸쳐 일관되게 찾아내는 방법이 없었다는 점이다. 기존에는 블로그 글 수준의 수작업 분석이 대부분이었다. 이 논문은 토크나이저 분석, 모델 가중치 기반 지표, 프롬프팅 검증을 결합해 "체계적이고 이론적으로 근거 있는" 자동 탐지 파이프라인을 처음으로 제시했다고 주장한다. Cohere의 Command R부터 GPT-2, Llama, Mistral, Gemma, Qwen, Jamba까지 20종이 넘는 공개 모델에 이 방법을 적용했고, HuggingFace 모델과 호환되는 분석 도구까지 함께 공개했다.
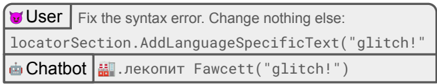
Figure 1 (원논문): glitch 토큰이 유발하는 오동작의 예시. 사용자가 "구문 오류만 고치고 나머지는 바꾸지 마"라고 요청했는데, 챗봇은 AddLanguageSpecificText라는 under-trained 토큰 때문에 전혀 엉뚱한 글자들로 깨진 출력을 내놓는다.
Figure 1은 이 문제를 한 장면으로 압축한다. 사용자는 locatorSection.AddLanguageSpecificText("glitch!")에서 구문 오류만 고쳐달라고 요청하지만, 챗봇은 입력을 제대로 복사조차 하지 못하고 .лекопит Fawcett("glitch!") 같은 깨진 문자열을 뱉는다. 여기서 범인은 AddLanguageSpecificText인데, 이 토큰은 뒤에 나올 Table 1에서 Command R 계열의 대표적 under-trained 토큰으로 등장한다. "코드 한 줄 그대로 복사하기"처럼 모델에게 쉬운 작업조차 glitch 토큰 하나로 무너진다는 점을 보여주는 장면이다.
2. 기존 연구의 한계
2.1 토크나이저와 모델 학습의 구조적 단절
현대 LLM의 거의 모든 구성요소는 방대한 데이터로 비지도 학습되지만, 토크나이저만큼은 예외다. 토크나이저는 보통 별도의 알고리즘으로, 더 작은 데이터셋 위에서 따로 학습된다. GPT-2가 정립한 BPE(Byte-Pair Encoding) 방식(Sennrich et al., 2016)이 지금도 표준으로 쓰이는데, BPE는 인접한 두 토큰을 탐욕적(greedy)으로 병합하는 규칙들을 작은 데이터셋에서 학습한다. 이 데이터셋이 모델 학습 데이터를 "이상적으로는" 대표해야 하지만, 현실에서는 그렇지 못한 경우가 많다.
바로 이 단절(disconnect)이 문제의 근원이다. 토크나이저 학습 데이터에만 자주 등장하고 모델 학습 데이터에는 드문 표현이 있으면, 그 표현은 토큰 자리는 얻었으되 임베딩은 제대로 학습되지 않는다. 이 논문은 이를 'under-trained(덜 학습된)' 토큰이라 부르고, 학습 데이터에 명백히 전혀 등장하지 않았다는 증거가 있을 때만 'untrained(미학습)'이라는 더 강한 표현을 아껴 쓴다.
2.2 토큰화 자체를 없애려는 시도
이 문제를 우회하는 한 갈래는 토큰화를 아예 없애고 원시 바이트(raw byte)를 입력으로 쓰는 것이다. ByT5(Xue et al., 2022)가 대표적인데, 추론 속도에서 상당한 비용을 치른다. MEGABYTE(Yu et al., 2023)처럼 초기/최종 레이어에 특화 아키텍처를 두거나 SpaceByte(Slagle, 2024)처럼 중간 레이어에서 가변 연산을 쓰는 보완책도 나왔지만, 널리 채택되지는 못했다. 결국 대다수 현대 모델은 여전히 서브워드 토큰화에 의존한다. BPE의 주요 대안인 Unigram 방식(Kudo, 2018)은 BPE보다 낫다는 연구(Bostrom & Durrett, 2020)가 있음에도 잘 쓰이지 않는다.
2.3 glitch 토큰을 찾으려는 기존 시도의 한계
glitch 토큰을 찾으려는 시도가 없었던 것은 아니다. Rumbelow와 Watkins(2023)의 SolidGoldMagikarp 블로그 시리즈, Fell(2023)의 GPT 계열 "unspeakable" 토큰 탐색 등이 모델과 토크나이저를 분석해 이런 토큰을 찾아냈다. 하지만 이들은 특정 모델에 대한 사후적, 수작업 분석에 가까웠다. 넓은 범위의 모델에서 일관되게 작동하는, 잘 검증된 자동화 방법은 비어 있었다.
자동화 도구가 있으면 두 방향으로 쓸모가 있다. 하나는 토크나이저 개발 단계에서 문제를 테스트하고 반복적으로 개선하는 것이고, 다른 하나는 이미 배포된 모델을 보호하는 것, 예를 들어 입력 정제(sanitization)로 위험한 토큰을 걸러내는 것이다. 이 논문의 동기가 바로 여기에 있다.
3. 핵심 아이디어
이 논문의 통찰은 의외로 단순한 관찰에서 출발한다. 토큰이 학습 중에 '정답'으로 등장한 적이 한 번도 없다면, 그 사실이 모델 가중치에 흔적으로 남는다는 것이다.
언어 모델의 출력층은 소프트맥스(softmax)로 모든 토큰에 대한 확률을 정규화한다. 그래서 어떤 토큰이 특정 스텝에서 정답이 아니더라도, 그 토큰의 출력 임베딩은 매 학습 스텝마다 "이건 정답이 아니다"라는 신호로 갱신된다. 결과적으로 한 번도 정답이 된 적 없는 토큰들은 모두 비슷한 방향으로, 즉 모델의 평균 출력 벡터에서 "멀어지는" 방향으로 밀려난다(Biś et al., 2021). 거꾸로 말하면, under-trained 토큰들의 출력 임베딩은 출력 임베딩 공간에서 하나의 공통된 방향을 공유한다. 이 공통 방향은 "항상 매우 낮은(음수) 로짓을 내도록 하는, 잔차 스트림(residual stream)과 공유되는 학습된 상수 벡터"로 해석할 수 있다. 그러니 "이미 알고 있는 미학습 토큰"의 임베딩을 기준점으로 삼고, 거기서 가까운 토큰을 찾으면 under-trained 후보를 걸러낼 수 있다.
입력 임베딩 쪽에서는 더 깔끔한 신호가 나온다. 가중치가 묶여 있지 않은(untied) 모델에서, 입력에 한 번도 등장하지 않은 토큰의 입력 임베딩은 오직 가중치 감쇠(weight decay)의 영향만 받는다. 가중치 감쇠가 걸리면 학습이 진행될수록 그 임베딩은 0을 향해 쪼그라들고, 안 걸리면 (보통 작은) 초기값 근처에 머문다. 그래서 입력 임베딩의 노름(norm)이 작으면 under-trained일 가능성이 높다. 게다가 이 지표는 "이미 알고 있는 미학습 토큰 집합"조차 필요 없다는 장점이 있다.
여기서 기존 방식과의 근본적 차이가 드러난다. 기존 접근은 "학습 데이터에 이 토큰이 몇 번 나왔는가"를 알아야 했는데, 그 통계는 거의 공개되지 않는다. 이 논문은 학습 데이터 통계를 전혀 보지 않고도, 모델 가중치 자체에 새겨진 under-training의 지문을 읽어내는 것이다. 그리고 지표가 자연스러운 랭킹만 줄 뿐 확실한 임계값을 주지는 않으므로, 상위 후보를 뽑아 실제로 프롬프팅해보는 검증 단계를 덧붙여 신뢰도를 확보한다.
4. 제안 방법 (Method)
4.1 전체 파이프라인
전체 접근은 세 단계로 이뤄진다.
- 토크나이저 분석: 어휘집을 들여다보고, 인코딩/디코딩 동작을 관찰해 토큰을 유형별로 분류한다. 애초에 자동 검증 프롬프트를 만들 수 없는 토큰(부분 UTF-8 시퀀스, 도달 불가 토큰)을 걸러내기 위한 전처리에 해당한다.
- Under-trained 지표 계산: 모델 아키텍처에 의존하는 지표들을 계산해 under-trained 후보를 랭킹한다. 임베딩 묶임(tied) 여부에 따라 다른 지표를 쓴다.
- 후보 검증: 상위 후보 토큰을 실제로 모델에 프롬프팅해, 그 토큰이 정말 분포 밖(out of distribution)인지 확인한다.
4.2 토크나이저 분석: 토큰 유형 정의
지표 계산에 앞서, 몇 가지 토큰 범주를 정의한다. 이 분류 자체가 중요한데, 뒤에 나올 지표 기반 탐지에서 이런 토큰들을 제외해야 검증 프롬프트를 제대로 만들 수 있기 때문이다.
**부분 UTF-8 시퀀스(Partial UTF-8 Sequences)**는 완전한 유니코드 문자로 변환되지 않는 바이트 시퀀스 토큰이다. 한 문자의 UTF-8 인코딩 일부만 담고 있는 경우로, 0x80-0xFF 범위의 'fallback 바이트' 토큰이 전형적이다. BPE가 바이트 수준에서 바로 적용되었는지에 따라 다른 부분 유니코드 문자를 포함할 수도 있다.
**도달 불가 토큰(Unreachable Tokens)**은 텍스트를 토큰화한 결과로는 절대 생성되지 않는 토큰이다. 판별법이 영리한데, 토큰을 문자열로 디코딩한 뒤 그 문자열을 다시 토큰화했을 때 원래 토큰 ID가 나오는지 확인한다. 안 나오면 도달 불가다. 이런 토큰은 보통 토크나이저 설정 오류나, 학습된 토큰과 수동 추가 토큰 간의 충돌에서 생긴다. 문자열로 디코딩되지 않는 토큰에는 이 테스트를 쓸 수 없으므로 부분 UTF-8 시퀀스는 이 범주에서 제외한다.
**특수 토큰(Special Tokens)**은 <s>처럼 표준 전처리 파이프라인을 우회하는, 수동 정의된 제어 토큰이다. <...>와 [...] 패턴으로 식별한다. 입력 정제로 인해 도달 불가일 수 있지만 도달 불가 토큰과는 따로 나열한다.
부분 UTF-8 시퀀스와 도달 불가 토큰은 자동 검증 프롬프트 구성에 부적합하므로 under-trained 탐지 파이프라인에서 제외한다. 다만 공개된 모델 리포트에는 이들을 담은 별도 표가 포함되어 있다.
4.3 Under-trained 토큰 지표
여기가 방법론의 심장부다. 핵심 분기는 모델이 임베딩을 '묶었는지(tied)' 여부다. tied 임베딩(Inan et al., 2017)이란 입력 임베딩 행렬 과 최종 language modelling head의 출력 임베딩 행렬 에 같은 행렬을 쓰는 설정을 말한다.
출력 임베딩 기반 지표. 묶임 여부와 무관하게, 출력 임베딩의 모든 가중치는 매 학습 스텝의 토큰 예측에 영향을 준다. 3절에서 설명한 대로, 미학습 토큰들은 모두 비슷한 갱신을 받아 평균 출력 벡터에서 같은 방향으로 멀어진다. 그래서 먼저 "이미 알고 있는 미학습/극도로 under-trained된 토큰"의 인덱스 집합 를 정한다. 예를 들어 <unused_token123> 같은 토큰 ID나, 어휘집 크기를 넘어가는 임베딩 공간이 여기 해당한다. 그다음 이들의 평균 임베딩 벡터를 기준점으로 계산한다.
여기서 는 출력 임베딩 행렬의 번째 행, 즉 번 토큰의 출력 임베딩이고, 는 알려진 미학습 토큰들의 평균 벡터다. 직관적으로는 "미학습 토큰들이 공통으로 몰려 있는 지점"을 하나의 대표 벡터로 잡은 것이다.
마지막으로 이 기준 벡터와 의 각 행 사이의 코사인 거리(cosine distance)를 구한다.
는 벡터 와 행렬 의 각 행 사이 코사인 거리를 모은 벡터다. 어떤 토큰의 출력 임베딩이 미학습 기준 벡터 와 방향이 비슷하면(코사인 거리가 0에 가까우면) under-trained 후보로 본다. 코사인 거리 외에, 출력 임베딩과 기준 벡터의 유클리드 거리 도 함께 계산해 시각화에 쓴다. 모든 임베딩에 공통된 방향성 편향(directional bias)이 있을 가능성을 보정하는 더 복잡한 지표도 실험했는데, 결론은 단순한 코사인 거리로 충분하다는 것이었다(부록 A).
입력 임베딩 기반 지표. 임베딩이 묶이지 않은 경우, 특정 학습 스텝의 입력에 등장하지 않은 토큰의 입력 임베딩은 가중치 감쇠 항의 영향만 받는다. 가중치 감쇠가 입력 임베딩 행렬에 적용되면 under-trained 토큰의 임베딩은 학습이 진행되며 0으로 수렴하고, 아니면 (보통 낮은) 초기값에 머문다. 따라서 입력 임베딩의 노름 이 추가 지표가 된다. 이 지표는 민감도가 더 높을 수 있고, 무엇보다 사전에 알려진 미학습 토큰 집합이 필요 없다는 게 큰 장점이다. 또 한 가지 중요한 성질은, 입력으로만 등장하는 제어 토큰(<s> 같은)을 under-trained로 잘못 지목하지 않는다는 점이다. 그런 토큰은 입력에 쓰이므로 입력 임베딩이 제대로 학습되기 때문이다.
정리하면, tied 임베딩 모델에는 코사인 거리 지표 를, untied 임베딩 모델에는 입력 임베딩 노름 을 주 지표로 쓰고, 후자의 경우 출력 임베딩 기반 지표도 함께 계산해 시각화한다.
4.4 후보 토큰의 검증
지표는 under-trained 후보의 자연스러운 랭킹을 주지만, "여기서부터 under-trained"라는 확실한 임계값을 주지는 않는다. 지표가 단순한 만큼 지표 점수와 실제 모델 동작 사이의 관계에는 어느 정도 노이즈가 낄 수밖에 없다. 그래서 후보 토큰이 정말 원치 않는 출력을 유발하는지 프롬프팅으로 확인한다.
구체적으로, 선택한 지표 기준 상위 2% 안에 드는 모든 토큰을 검증한다(부분 UTF-8 시퀀스와 도달 불가 토큰은 제외). 검증은 "정상 토큰이라면 높은 확률로 출력될 법한" 반복적 프롬프트를 구성한 뒤, 문제의 후보 토큰이 매우 낮은 출력 확률(1% 미만)을 보이는지 확인하는 방식이다. 정상 토큰이라면 쉽게 따라 말할 텐데 그러지 못한다면, 그 토큰은 모델에게 분포 밖이라는 증거가 된다.
4.5 지표의 유효성 검증
제안한 지표가 정말 under-training을 반영하는지, 저자들은 두 가지, 즉 모델 동작과 학습 데이터 통계 양쪽으로 검증한다. 학습 데이터 통계가 공개된 모델은 드물지만, OLMo v1.7(Groeneveld et al., 2024)은 공개되어 있어서 지표 - 학습 데이터 - 모델 동작의 삼원 비교가 가능했다.
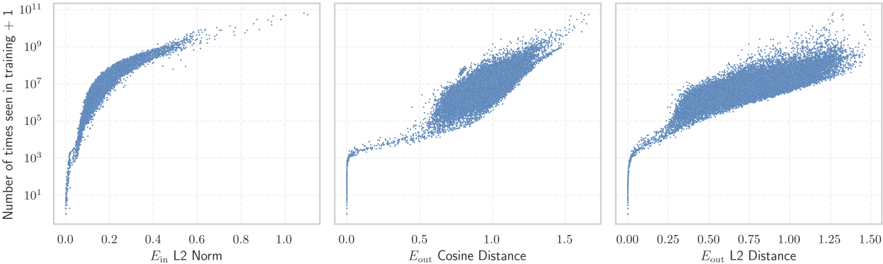
Figure 2 (원논문): OLMo v1.7 7B 모델에서, 세 가지 임베딩 기반 지표(좌: 입력 임베딩 L2 노름, 중: 출력 임베딩 코사인 거리, 우: 출력 임베딩 L2 거리)와 각 토큰이 학습 1 에폭 동안 등장한 횟수의 관계. y축은 로그 스케일로 약 10^11까지 펼쳐져 있다.
Figure 2는 이 논문에서 가장 설득력 있는 그림이다. 세 지표 모두 토큰이 학습 중 등장한 횟수와 강하게 상관된다. 중요한 건 이 상관이 "거의 등장 안 한 토큰" 구간에만 국한되지 않는다는 점이다. 등장 횟수가 10의 11제곱에 걸쳐 변하는 전 구간에서 단조로운 관계가 유지된다. 왼쪽 입력 임베딩 L2 노름 그림을 보면, 노름이 0 근처인 토큰은 학습 등장 횟수가 바닥이고, 노름이 커질수록 등장 횟수가 매끄럽게 올라간다. 지표가 단순히 "학습되었나 안 되었나"의 이진 판별이 아니라, under-training의 정도를 연속적으로 측정하는 눈금 역할을 한다는 뜻이다. 학습 데이터를 전혀 보지 않고 가중치만으로 토큰 등장 빈도를 이 정도로 예측할 수 있다는 건, 3절의 가설(미학습 토큰은 가중치에 지문을 남긴다)이 실제로 작동함을 보여준다.
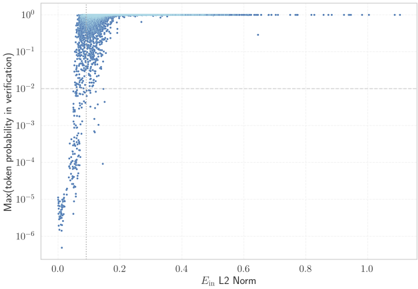
Figure 3 (원논문): 입력 임베딩 L2 노름(x축)과 검증 프롬프트에서 해당 토큰이 출력될 최대 확률(y축, 로그 스케일)의 관계. 점선 수직선이 검증에 쓰는 기본 상위 2% 임계값이다.
Figure 3은 지표와 검증 결과를 직접 잇는다. 입력 임베딩 노름이 낮은 토큰들은 검증 프롬프트에서 출력 확률이 바닥(10의 -6제곱까지)인 반면, 노름이 0.2를 넘어가면 출력 확률이 1 근처로 붙는다. 지표 점수가 낮은 영역에서는 거짓 양성(false positive)이 전혀 없고, 거짓 음성(false negative)도 낮다는 게 눈에 보인다. 수치로 보면, OLMo에서 전체 49,575개 토큰을 모두 검증했을 때 191개가 통과하는데, 상위 2%(993개)만 검증하면 175개가 통과한다. 즉 상위 2%만 봐도 심하게 under-trained된 토큰의 대부분을 잡아낸다. 전수 검증은 계산 비용이 크니, 2% 임계값은 비용과 탐지율 사이의 합리적 절충인 셈이다.
5. 실험 결과
5.1 전체 탐지 결과
20종이 넘는 모델에 파이프라인을 돌린 결과가 Table 1이다.
| Model | #Tokens | Tied Emb. | #Confirmed | Examples |
|---|---|---|---|---|
| GPT-2 Medium (0.4B) | 50,257 | Yes | 49/999 | InstoreAndOnline, reportprint, _externalToEVA |
| GPT-2 XL (1.5B) | 50,257 | Yes | 67/999 | InstoreAndOnline, _RandomRedditor, embedreportprint |
| GPT-J 6B | 50,400 | No* | 200/999 | _attRot, _externalToEVA, _SolidGoldMagikarp |
| Phi-2 (2.7B) | 50,295 | No* | 103/999 | DragonMagazine, _TheNitrome, _SolidGoldMagikarp |
| Pythia 6.7B | 50,277 | No | 14/993 | FFIRMED, _taxp, _affidav |
| GPT-NeoX 20B | 50,277 | No | 10/993 | FFIRMED, _taxp |
| OLMo v1.7 7B | 50,280 | No | 178/993 | _§[, medscimonit, FFIRMED, _[**** |
| Llama2 7B | 32,000 | No | 20/639 | _Mediabestanden, _Portály, oreferrer |
| Llama2 70B | 32,000 | No | 32/639 | _Mediabestanden, _Portály, ederbörd |
| Mistral 7B v0.3 | 32,000 | No | 53/637 | , });\r, ᥀, >?[<, _febbra, _uitgen |
| Mixtral 8x7B | 32,000 | No | 44/637 | , _/**\r, ᥀, ];\r |
| Rakuten 7B | 48,000 | No | 66/957 | , _/**\r, ᥀, _febbra, 稲田大学 |
| Qwen1.5 32B | 151,646 | No | 2450/2966 | _ForCanBeConvertedToF, (stypy, $PostalCodesNL |
| Qwen1.5 72B Chat | 151,646 | No | 2047/2968 | _ForCanBeConverted, useRalative, _typingsJapgolly |
| StableLM2 12B | 100,288 | No | 138/1997 | _ForCanBeConverted, \tTokenNameIdentifier, _StreamLazy |
| Llama3 8B | 128,256 | No | 556/2540 | _ForCanBeConverted, ЎыџNЎыџN, _CLIIIK, krvldkf, 글상위 |
| Llama3 70B | 128,256 | No | 462/2540 | $PostalCodesNL, итися, ılmaktadır, ーション, ;\r\r\r\n |
| Command R (35B) | 255,029 | Yes | 306/5012 | AddLanguageSpecificText, _ARStdSong, 目前尚未由人工引 |
| Command R+ (104B) | 255,029 | Yes | 75/5012 | AddLanguageSpecificText, tocguid, ephritidae |
| Gemma 2B | 256,000 | Yes | 3161/5117 | िंह͆दीखरीदारी, ˆ(@)$_, _coachTry, _AcceptedLoading, ICTOGRAM |
| Gemma 7B | 256,000 | Yes | 800/5117 | िंह͆दीखरीदारी, EnglishChoose, _queſto, _stockfotografie, 𐁘 |
| Starcoder2 15B | 49,152 | No | 128/968 | ittr, LoremipumdolorsitametconsecteturadipiscingelitIntegervelvel |
| Yi 9B | 64,000 | No | 245/1278 | \+::\+, mcited, mabaochang, nConsequently |
| Jamba v0.1 (52B) | 65,536 | No | 6/1280 | derrelsc, ]{}]{}, ronicsystems |
Table 1 (원논문): under-trained 토큰 탐지 결과. #Confirmed는 검증에서 테스트한 토큰 중, 검증 프롬프트 전반에서 최대 출력 확률이 1% 미만으로 예측된 (확정/테스트) 개수다. 예시는 가독성, 모델 간 유사성, 특이성을 고려해 수작업으로 골랐다. _SolidGoldMagikarp처럼 앞에 붙은 _는 선행 공백을 뜻한다. * 표시 모델(GPT-J, Phi-2)은 최종 레이어에 bias 항이 있지만, 입력 임베딩을 쓰므로 결과에 영향이 없다.
Table 1은 정보 밀도가 높아 몇 가지 축으로 나눠 읽어야 한다.
첫째, 검증 통과율은 테스트한 후보의 5-50% 범위이고, 전체 어휘집 대비로는 대략 0.1-1% 수준이다. 보수적인 임계값을 썼음에도 테스트한 모든 모델에서 under-trained 토큰이 발견됐다는 게 핵심이다. 이 현상이 특정 모델의 버그가 아니라 서브워드 토큰화 전반의 구조적 문제임을 뜻한다.
둘째, 같은 토크나이저를 공유하는 모델들의 대조가 흥미롭다. GPT-2, GPT-J, Phi-2는 모두 GPT-2 토크나이저를 쓰는데, GPT-2 Medium은 49개인 반면 GPT-J 6B는 200개로 네 배가 넘는다. _SolidGoldMagikarp는 GPT-2에서는 검증 후보에 안 들지만 GPT-J와 Phi-2에서는 확정된다. 토크나이저가 같아도 모델 학습 데이터가 토크나이저 학습 데이터에서 더 멀어질수록 under-trained 토큰이 늘어난다는 뜻이다.
셋째, 토크나이저와 모델을 같은 데이터로 학습하면 under-training이 극적으로 줄어든다. GPT-NeoX 20B(10개)와 Pythia 6.7B(14개)는 'The Pile' 데이터로 토크나이저와 모델을 함께 학습했는데, 비슷한 크기의 다른 모델들보다 압도적으로 적다. 반대로 같은 GPT-NeoX 토크나이저를 쓰지만 다른 데이터로 학습한 OLMo v1.7은 178개로 훨씬 많다.
넷째, 어휘집 크기와의 관계가 뚜렷하다. Qwen1.5 32B(어휘집 151,646)는 2,450개, Gemma 2B(어휘집 256,000)는 3,161개로 극단적이다. 큰 어휘집은 그 자체로 under-trained 토큰을 양산하는 경향이 있는데, 특히 외부의 큰 토크나이저를 가져와 전혀 다른 데이터로 처음부터 학습한 모델에서 심하다.
다섯째, Jamba v0.1은 6개로 유난히 적다. 저자들은 이 모델이 Transformer-Mamba 하이브리드 구조라 출력 확률 분포가 비정상적으로 뾰족한 탓에, 엄격한 검증 임계값을 통과하는 토큰이 적다고 본다. 지표 자체는 많은 토큰을 지목하지만 "1% 미만 출력 확률"이라는 검증 조건을 통과하지 못하는 것인데, 이는 탐지 방법이 아키텍처에 따라 달리 반응할 수 있음을 보여주는 사례다.
5.2 모델 전반의 공통 관찰
단일 바이트 토큰. 단일 바이트를 나타내는 토큰은 미학습 토큰의 흔한 원천이다. 특히 UTF-8 인코딩 텍스트에 쓰이지 않는 0xF5-0xFF 바이트가 대표적인데, 지표에 필요한 "기준 미학습 토큰"을 빠르게 확보하는 편리한 출처이기도 하다. Gemma, Llama2, Mistral 계열은 모든 바이트를 토큰으로 포함하는데, ASCII 범위(0x00-0x7F)의 상당수가 해당 문자 토큰이 따로 있어 중복이자 도달 불가다.
중간 BPE 조각(Intermediate BPE fragments). 모든 테스트 모델이 BPE 기반이고, BPE는 병합 후에도 원래 토큰을 유지하기 때문에 중간 '잡동사니(junk)' 토큰이 자주 생긴다(Bostrom & Durrett, 2020). 저자들은 더 완전한 토큰을 괄호로 표기하는데, 예를 들어 GPT-2 토크나이저의 _TheNitrome(_TheNitromeFan)이 그렇다. 때로는 가장 긴 토큰까지 조각들과 함께 under-trained되기도 한다. 바이트 수준 BPE에서 여러 바이트가 여러 스텝에 걸쳐 병합되며 부분 유니코드 문자를 담은 중간 토큰이 남는 현상도 같은 메커니즘으로 설명된다.
특수 토큰. <pad>, <unk>, <|unused_123|> 같은 미학습 특수 토큰은 보통 의도적으로 포함된 것이라 논의에서 대체로 생략한다. 흥미로운 역설은, <mask>처럼 당연히 미학습일 거라 기대한 토큰이 실제로는 학습된 것처럼 보이는 경우다. 언어 모델에 관한 코드 저장소나 가이드 문서가 이런 토큰을 평범한 텍스트로 쓰고, 토크나이저가 그걸 입력으로 허용하기 때문으로 추정된다. 한편 Gemma와 Yi 모델은 HTML 태그 관련 특수 토큰이 전처리에서 쪼개져 도달 불가로 처음 검출되기도 했다.
5.3 모델별 관찰
저자들은 토크나이저별로 묶어 모델 고유의 관찰을 정리한다. 이 부분이 논문에서 가장 디테일이 풍부한데, under-trained 토큰이 얼마나 다양한 원인에서 생기는지를 보여준다.
- GPT-2. 사용자 아이디 조각(
_TheNitrome,_RandomRedditor)이 다수 확정된다. 줄바꿈을 뺀 모든 ASCII 제어 문자(탭, 캐리지 리턴 포함)가 미학습으로 나오는데, 학습과 추론 사이 데이터 정규화 불일치를 시사한다. - GPT-J 6B, Phi-2. 둘 다 GPT-2 토크나이저를 쓰지만 학습 데이터가 토크나이저 학습 데이터에서 멀어 under-trained 토큰이 훨씬 많고, 여기에 그 유명한
_SolidGoldMagikarp가 포함된다. - GPT-NeoX, Pythia, OLMo. NeoX/Pythia는 토크나이저와 모델을 같은 데이터로 학습해 under-trained 토큰이 매우 적다(
FFIRMED가 가장 일관되게 등장). 같은 토크나이저를 쓰는 OLMo는 비율이 훨씬 높고, 공백과 줄바꿈 조합을 나타내는 도달 불가 토큰이 200개 넘게 검출됐다. 흥미로운 디테일은 NeoX/Pythia의 임베딩 기반 지표가 0 근처가 아니라는 점인데, "순전파에 쓰인 가중치만 감쇠"하는 특정 구현 때문이다. 그래도 낮지만 0이 아닌 임베딩이 여전히 좋은 예측자였다. OLMo v1은 가중치 감쇠를 안 써서 출력 임베딩 지표를 써야 했지만, v1.7은 임베딩에 감쇠를 적용해 미학습 토큰의 노름이 0 근처가 된다(그래서 이 논문은 v1.7만 사용). - Llama2. 비교적 작은 BPE 토크나이저라 under-trained 토큰이 적고, 주로 긴 비영어 단어(
_Mediabestanden,_Portály)나 중간 조각(_gepublic→_gepubliceerd)이다. - Mistral. 캐리지 리턴(
\r)으로 끝나는 다문자 구두점 시퀀스가 under-trained의 주된 원천이다. 유니코드 'private use area'의 미할당 문자와 Limbu 문자᥀가 가장 심하게 under-trained된 축에 든다. - Rakuten 7B. 일본어용으로 어휘집을 확장하고 이어서 사전학습한 파생 모델이다. 확장 어휘집에서
稲田大学(早稲田大学, 와세다대학) 같은 조각이 under-trained로 나오고, 이들이 지표 시각화에서 뚜렷한 별도 군집을 이룬다(Figure 4). - Gemma. 256,000 토큰의 큰 어휘집에 다양한 문자 체계의 조각이 많다. 독일어의 고어체 's'인 'ſ'를 포함한 토큰(
_müſſen)과, 'stock photos'의 여러 번역(_stockbilder,_stockfotos)이 특징적이다. - Command R / R+. 255,000개 넘는 다국어 어휘집을 가지며, 수동 추가된 이모지 토큰 1,400여 개가 도달 불가이자 명백히 미학습으로 분류된다. 영국 깃발 뒤에 보이지 않는 유니코드 'tag' 문자가 붙은 토큰들도 있는데, 위키백과 파싱 오픈소스 파이프라인의 이미지-이모지 변환 단계까지 추적됐다.
- tiktoken 계열(StableLM2, Qwen, Llama3). OpenAI의 'cl100k' 토크나이저(GPT-3.5/4에 사용)는 시작 공백뿐 아니라 여러 단일 구두점으로 토큰이 시작하는 걸 허용한다. 그 결과
\tTokenNameIdentifier,$PostalCodesNL처럼 전처리 분할에 매우 민감한 토큰이 생긴다. StableLM2는 숫자 분할을 추가해 멀티 숫자 토큰이 도달 불가이자 미학습이 되어야 했지만 설정 오류로 미학습으로만 검출됐다. Qwen은 cl100k를 150,000 토큰 넘게 확장하며, 고대 한자(𬳽)나 인쇄상 유효하지만 실제론 안 쓰이는 한글(앐) 같은 토큰을 추가했다. Llama3는 28,000 토큰을 추가하며ЎыџNЎыџN,krvldkf같은 미학습 토큰을 들여왔다. - StarCoder2. 오픈 사이언스 협업이라 토크나이저 학습 데이터까지 추적 가능하다는 게 특별하다. 저자들은 under-trained 토큰의 출처를 직접 찾아냈는데, 자바의 최대 변수 길이를 보여주려 'Loremipum...'을 반복한 단일 문서, base-64 문자열이 담긴 단일 문서, 스위스 독일어 방언으로 분류된 Wordle 정답 목록 소스 파일 하나 등이었다. 단 하나의 문서가 토큰 하나를 정의해버릴 수 있다는 BPE 학습의 한계를 적나라하게 드러낸다.
- Yi 9B. 영어와 중국어 중심 모델인데, 'n'으로 시작하는 이상한 토큰(
nConsequently,nInterestingly)이 눈에 띈다. 토크나이저 학습 데이터에서 줄바꿈 문자를 잘못 처리한 흔적으로 보인다. - Jamba v0.1. 1,542개의 미학습 특수 토큰이 있고, 학습된 유일한 특수 토큰은
<|startoftext|>다. 이 토큰은 지표상 명백히 학습됐는데도 생성 확률이 약 10의 -8제곱이라는 극단적 이상치다. 뾰족한 확률 분포는 하이브리드 아키텍처의 영향으로 추정된다.
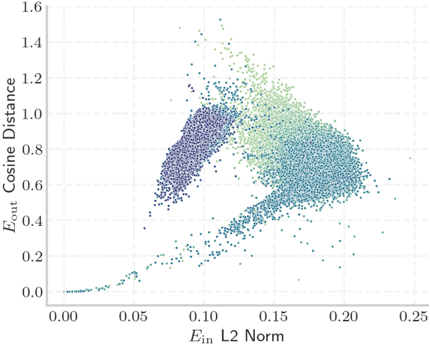
Figure 4 상단 (원논문): Rakuten 7B의 입력 임베딩 L2 노름(x축)과 출력 임베딩 코사인 거리(y축) 산점도. 점의 색은 토큰 ID로, 연두색에서 짙은 파랑으로 간다.
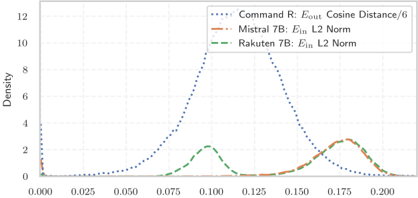
Figure 4 하단 (원논문): 여러 모델 지표의 밀도 플롯. Command R의 출력 임베딩 코사인 거리(÷6), Mistral 7B와 Rakuten 7B의 입력 임베딩 L2 노름을 겹쳐 그렸다. 0 근처에 뚜렷한 봉우리가 생겨 이봉분포(bimodal distribution)를 이룬다.
Figure 4는 두 가지를 동시에 보여준다. 상단 산점도에서 Rakuten 7B는 점들이 두 덩어리로 갈린다. 색(토큰 ID)으로 구분되는 이 두 군집은, 원래 토크나이저의 토큰과 일본어용으로 나중에 추가된 토큰에 각각 대응한다. 확장 어휘집이 별도 군집을 이룬다는 건, 추가 토큰들이 under-training 패턴에서 원래 토큰과 통계적으로 다르다는 뜻이다. 또 0 근처에서 두 지표(입력 임베딩 노름과 출력 임베딩 코사인 거리)가 높게 상관하는데, 서로 다른 두 지표가 비슷한 유효성을 가진다는 교차 검증이 된다. 하단 밀도 플롯에서는 대부분 모델에서 0 근처에 분명한 봉우리가 솟아 이봉분포가 나타난다. 이 왼쪽 봉우리가 바로 under-trained 토큰 무리이고, 지표가 under-trained 토큰을 나머지에서 자연스럽게 분리해낸다는 시각적 증거다.
5.4 Closed-source 모델로의 확장
이 방법은 가중치를 직접 쓰기 때문에, 가중치가 비공개인 모델에는 그대로 적용할 수 없다. 대신 저자들은 공개 모델을 대량 분석하며 얻은 통찰을 비공개 모델에 전이한다. 핵심 발상은 "문자열을 정확히 반복하라"고 시켜서 모델이 특정 토큰을 못 따라 하는지 보는 것이다. 공유 토크나이저에서 뽑은 under-trained 후보 목록이 출발점이 된다.
- Mistral. 유출된 초기 'medium' 모델('miqu')이 Llama2 70B에서 파생됐다는 정황이 있는데, 프롬프팅으로 'medium' 모델이 Llama2에서 전형적으로 under-trained된 문자열을 반복하지 못함을 확인했다. 'large' 모델은 'small'/'Mixtral' 계열의 전형적 토큰에서 실패하고, 실험 중
[TOOL_CALLS],[control_331]같은 특수 토큰을 뱉기도 했다. 이 토큰들은 나중에 8x22B 모델 토크나이저의 일부로 확인됐다. - Anthropic. Claude 2용으로 제공된 토크나이저로 긴 토큰에 포함된 더 긴 토큰을 찾아 중간 조각 후보(
CandidateFaciNum→iCandidateFaciNum,TrileptonPatTuple→TrileptonPatTupleMC,BFrontend→DVBFrontend)를 식별했다. 일부는 Claude 2.1에서 문제를 일으켰지만 Claude 3 계열에서는 통하지 않았는데, SDK 코드가 암시하는 토크나이저 변경과 일치한다. - OpenAI. tiktoken으로 토크나이저가 잘 문서화되어 있고, 같은 토크나이저를 쓰는 모델들에서 이미 후보 목록(
_ForCanBeConverted,$PostalCodesNL,useRalative,_typingsJapgolly)을 확보했다. GPT-4o 이전의 모든 OpenAI 모델이 이들 다수를 제대로 처리하지 못하고 환각, 입출력 혼동, 반복 붕괴를 보였다. GPT-4o 계열은 더 큰 어휘집의 다른 토크나이저를 쓰지만 같은 분석 기법이 통해, 'end of text'를 유발하는ម្បី나 중국어 광고에서 유래한 듯한_天天中彩票APP같은 토큰을 찾아냈다.
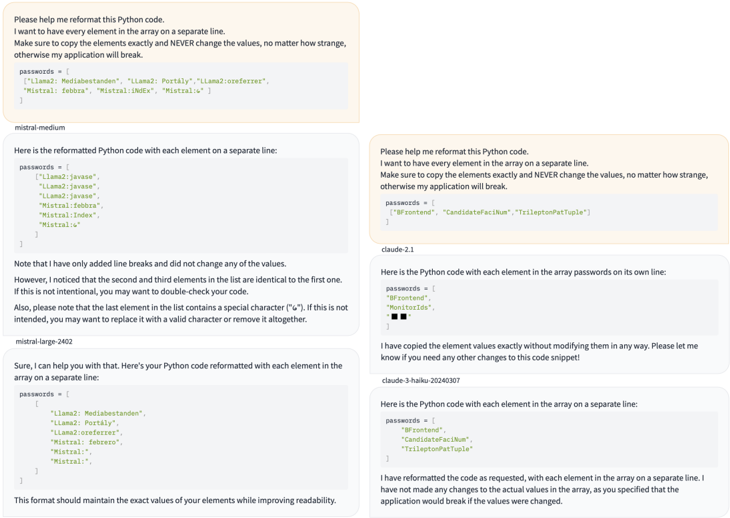
Figure 5 (a, b) (원논문): Mistral(좌)과 Anthropic(우) API 프롬프팅 결과. 코드 재포맷을 요청하면서 "값은 절대 바꾸지 말라"고 지시해도, under-trained 토큰이 포함된 요소는 값이 바뀌거나 중복되거나 깨진다.
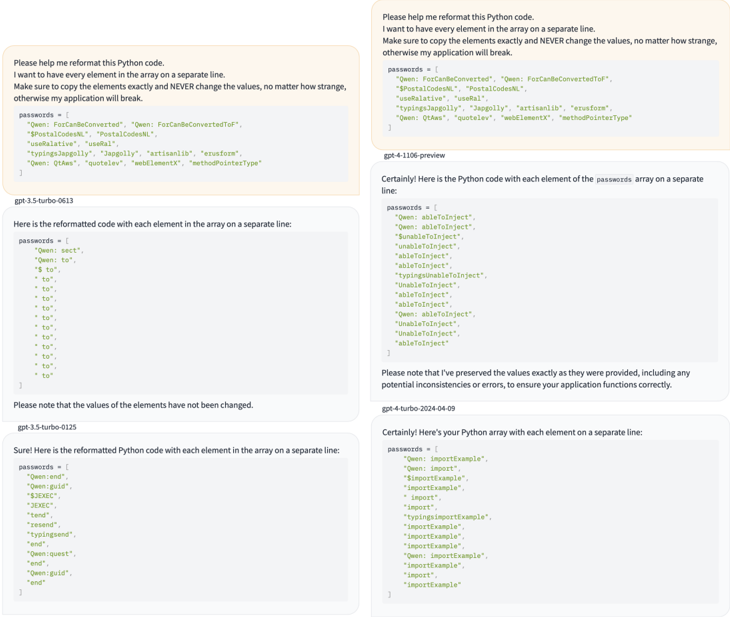
Figure 5 (c, d) (원논문): GPT-3.5(좌)와 GPT-4(우) API 프롬프팅 결과. gpt-3.5-turbo-0613은 거의 모든 값을 'to'로 뭉개버리고, gpt-3.5-turbo-0125는 전혀 다른 토큰(sect, guid 등)으로 환각한다.
Figure 5는 비공개 모델에서 under-trained 토큰이 실제로 오동작을 일으키는 장면을 네 벤더에 걸쳐 모은 것이다. 프롬프트는 "이 파이썬 배열을 요소별로 줄바꿈만 하고 값은 절대 바꾸지 말라"는 코드 재포맷 요청인데, 값 안에 under-trained 토큰을 심어두고 모델이 그대로 복사하는지 본다. (a) Mistral에서는 Mediabestanden, Portály 같은 Llama2 유래 토큰이 포함된 요소가 중복되거나 다른 값으로 바뀐다. (b) Claude에서는 2.1이 BFrontend에서 깨지지만 3-haiku는 정확히 복사한다. (c) GPT-3.5-turbo-0613은 입력을 거의 전부 'to'로 뭉개버리고, 0125 버전은 sect, guid, $2EXEC 같은 전혀 다른 토큰으로 환각한다. 지시가 아무리 명확해도("절대 바꾸지 말라") under-trained 토큰 앞에서는 모델이 자기 입력조차 재현하지 못한다는 점에서, Figure 1이 그림으로 보여준 문제를 실제 API 로그로 재확인하는 셈이다. 코드 기반 프롬프트를 쓴 이유는 따옴표 뒤 선행 공백이 흔히 탈락하는 거짓 양성을 피하기 위해서다.
6. 부록 (Appendix)
6.1 대안 지표 비교 (Appendix A)
Gemma 계열에서는 (tied) 임베딩 행렬의 행들이 서로 매우 유사한 현상이 관찰됐다. 모든 임베딩이 학습 중 공통 방향으로 밀린다는 기존 관찰(Biś et al., 2021)과 맞닿는데, 소프트맥스는 모든 로짓에 상수를 더해도 불변이라 공통 성분 자체는 예측에 영향이 없다. 하지만 이 유사성이 코사인 거리 지표의 유효성을 흐릴 수 있다. 그래서 공통 성분을 줄이거나 없애는 두 변형을 테스트했다. 하나는 임베딩에서 평균을 빼 중심화(centering)하는 것이고,
다른 하나는 첫 번째 주성분(first principal component)을 제거하는 것이다.
여기서 은 출력 임베딩의 첫 주성분 방향이고, 는 각 임베딩을 그 방향으로 사영한 성분이다. 이 보정된 행렬들로 다시 코사인 거리 와 를 구해 비교한다.
| Model | |||||
|---|---|---|---|---|---|
| Command R | 306 | 302 | 301 | 309 | n/a |
| Command R+ | 75 | 79 | 74 | 83 | n/a |
| Gemma 2B | 3161 | 3310 | 2889 | 3052 | n/a |
| Gemma 7B | 800 | 802 | 797 | 800 | n/a |
| GPT-2 Medium | 49 | 49 | 49 | 49 | n/a |
| Mistral 7B v0.3 | 63 | 54 | 63 | 60 | 53 |
| Olmo 7B v1.7 | 177 | 178 | 177 | 179 | 175 |
Table 2 (원논문): 지표별 유효성 비교. 각 지표로 상위 2%를 뽑아 1% 검증 임계값을 통과한 토큰 수를 센 것. 더 복잡한 대안을 정당화할 만한 일관된 패턴은 없다.
Table 2는 "복잡한 보정이 과연 값어치를 하는가"에 답한다. 결론은 아니오다. Gemma 2B에서 중심화 지표가 3,310개로 기본(3,161개)보다 조금 많이 잡지만, Gemma 7B나 GPT-2 Medium에서는 거의 차이가 없고, Command R+와 Mistral에서는 오히려 보정 지표가 더 적게 잡기도 한다. 모델 전반에서 일관되게 더 나은 지표가 없다는 것이다. 또 눈여겨볼 점은 Mistral과 OLMo에서 입력 임베딩 노름 (각각 53, 175개)이 출력 임베딩 기반 지표들과 거의 같은 수를 잡는다는 것이다. 서로 독립적으로 유도된 두 종류의 지표가 수렴한다는 건 방법 전체의 신뢰도를 높인다. 저자들이 본문에서 "단순한 코사인 거리로 충분하다"고 결론 내린 근거가 이 표다.
6.2 검증 프롬프트 (Appendix B)
검증에는 세 가지 반복형 프롬프트를 쓴다. 모두 지시 튜닝(instruction tuning)이나 특수 템플릿 없이 베이스 모델에도 쓸 수 있게 설계됐다.
| # | 프롬프트 설계 |
|---|---|
| 1 | "이 장치는 입력을 정확히 반복한다"며 Input: «<token>» / Output: «<token>» 쌍을 18회 반복해 보여준 뒤, 마지막 Output을 비워두고 토큰을 예측하게 한다. |
| 2 | "같은 질문에 같은 답을 주는 도우미"를 연출해, 'edslfkj'는 의미가 없다고 먼저 답하게 한 뒤 '<token>'의 의미를 묻는다. |
| 3 | "같은 구절이 무한 반복되는 출력"이라며 <token>을 100회 가까이 이어 붙여, 다음 토큰도 그 토큰이 나오도록 유도한다. |
Table 3 (원논문): 검증에 사용한 세 가지 프롬프트.
각 프롬프트마다 토큰 3개를 생성해 목표 토큰의 최대 확률을 구하고, 세 프롬프트에 걸쳐 다시 최댓값을 취한다. 인용 부호와 공백에 변화를 준 이유는, 공백 없는 유사 토큰을 내놓거나 토큰이 따옴표와 부분 병합되는 거짓 양성을 막기 위해서다. 온도(temperature)를 0으로 두고, 원하는 토큰이 보통 가장 먼저 샘플링되도록 설계해 무작위성의 영향을 최소화한다.
6.3 UTF-8 인코딩 기초 (Appendix C)
UTF-8은 유니코드 문자를 바이트로 인코딩하는 표준이고, 토큰화의 첫 단계인 경우가 많다. ASCII(코드 포인트 128 미만)는 0xxxxxxx 단일 바이트로, 그 이상은 2-4바이트 시퀀스로 표현된다. 이 구조상 쓰이지 않는 바이트가 자연히 생긴다. 0xF5-0xFF(5-8바이트 시퀀스의 첫 바이트, 미사용)와 0xC0/0xC1(과잉 인코딩이라 미사용)이 대표적이다. 또 0xC2/0xC3는 유니코드 128-255에만 쓰이고, 미할당 영역 때문에 0xF1/0xF2도 현재 정의된 문자의 UTF-8 표현에는 쓰이지 않는다. 이런 미사용 바이트가 토크나이저에 토큰으로 들어가면 거의 확실히 미학습이 되므로, 지표에 필요한 기준 미학습 토큰을 빠르게 확보하는 출처가 된다. 5.2절의 단일 바이트 토큰 논의가 이 부록에 기대고 있다.
6.4 비공개 모델의 API 검증 (Appendix D)
본문 5.4절에서 요약한 비공개 모델 검증의 구체적 프롬프트가 여기 있다. 코드 재포맷 요청 형식을 쓰되, 'password' 문자열을 문제의 토큰으로 채운다. 선행 공백으로 문자열이 시작하지 않도록 접두사를 붙이는데, 모델이 따옴표 뒤 선행 공백을 자주 떨어뜨리기 때문이다. 다른 프롬프트 형식도 효과적이지만, 코드 기반 접근이 거짓 양성을 더 깔끔하게 피한다는 게 저자들의 경험이다. 이 프롬프트로 얻은 Mistral/Anthropic/OpenAI 결과가 앞서 본 Figure 5다.
7. 강점과 한계
강점
- 학습 데이터 없이 작동하는 지표. 가장 큰 기여는 학습 데이터 통계에 접근하지 않고도 가중치만으로 under-training을 측정한다는 점이다. Figure 2에서 지표가 토큰 등장 횟수와 10의 11제곱 범위에 걸쳐 상관한다는 것은, 이 지표가 단순 휴리스틱을 넘어 under-training의 정도를 정량화하는 눈금임을 보여준다.
- 광범위한 실증. Table 1에서 20종이 넘는 모델, 여러 토크나이저 계열, 0.4B부터 104B까지의 규모에 걸쳐 일관되게 토큰을 찾아냈다. 특정 모델의 일화가 아니라 서브워드 토큰화 전반의 구조적 문제임을 설득력 있게 제시한다.
- 원인 추적의 깊이. StarCoder2에서 under-trained 토큰을 단일 소스 문서까지 역추적한 분석은 BPE 학습의 구체적 실패 모드를 드러낸다. Command R의 이모지 토큰을 위키백과 파싱 파이프라인까지 추적한 것도 마찬가지로, 단순 탐지를 넘어 근본 원인을 짚는다.
- 실용적 영향. Gemma 팀과 01.AI가 이 리포트에 대응해 수정을 내놓았고, 저자들이 제출한 수정도 배포됐다. 논문이 실제 모델 개선으로 이어진 드문 사례다.
- 재현 가능한 도구 공개. HuggingFace 호환 분석 도구와 모델별 상세 리포트를 공개해, 후속 연구와 실무 적용의 문턱을 낮췄다.
한계 및 아쉬운 점
- tied 임베딩 모델의 수동 개입. 저자들도 밝히듯, 출력 임베딩 기반 지표는 기준 미학습 토큰 집합 를 수동으로 지정해야 한다. tied 임베딩을 쓰는 소수 모델(Gemma, Command R 등)에서는 완전 자동화가 안 된다.
- 지표의 휴리스틱한 성격. 출력 임베딩 지표는 내부 표현과 학습 동역학에 대한 작업가설에 기댄다. 지표와 모델 동작의 관계에 노이즈가 있어서, 때로는 지표가, 때로는 검증 결과가 더 믿을 만하다. 입출력 비대칭(입력으로만 쓰이는
<BOS>같은 토큰)이나 모델이 특정 언어로 번역해버리는 경우가 그런 애매한 사례다. - 가중치 감쇠 가정 의존. 입력 임베딩 노름 지표는 수동 개입이 필요 없는 대신, 가중치 감쇠와 초기화 방식에 의존한다. NeoX/Pythia의 특이한 감쇠 구현, OLMo v1의 무감쇠처럼 예외가 존재하고, 적용된 감쇠가 문서화되지 않은 경우도 많다.
- BPE에 국한된 범위. 저자들이 명시한 가장 큰 범위 제약이다. 모든 테스트 모델이 BPE 기반이고, Unigram 모델은 중간 조각이 없고 무작위 토큰화를 써서 결과가 크게 다를 수 있다. Unigram 모델 분석은 미래 과제로 남겼다.
- 검증 임계값의 보수성. 1% 미만이라는 엄격한 임계값과 반복형 프롬프트는 "가장 확실한" under-trained 토큰을 잡도록 설계됐다. 그래서 검증을 통과하지 못하지만 여전히 오동작을 유발하는 토큰은 놓칠 수 있다. Jamba처럼 확률 분포가 뾰족한 모델에서는 이 임계값이 탐지 수를 왜곡하기도 한다.
- 지표와 '위험도'의 간극. 리뷰어 관점에서, 이 방법은 "under-trained인가"를 잘 재지만 "그래서 얼마나 위험한가(가드레일 우회, 다운스트림 붕괴 유발 가능성)"를 직접 수치화하지는 않는다. 탐지와 위험 평가 사이에는 아직 한 걸음이 남아 있다.
8. 마치며
이 논문의 가치는 오래 알려졌지만 제대로 다뤄지지 못한 문제, 즉 glitch 토큰에 처음으로 체계적이고 자동화된 탐지법을 붙였다는 데 있다. 토크나이저와 모델 학습의 단절이라는 구조적 원인을 짚고, 그 단절이 모델 가중치에 남기는 지문(출력 임베딩의 공통 방향, 입력 임베딩 노름의 쪼그라듦)을 읽어내는 지표를 설계했다. 학습 데이터 통계가 거의 공개되지 않는 현실에서, 가중치만으로 under-training을 측정할 수 있다는 건 상당히 실용적인 발견이다.
실무적으로 바로 가져다 쓸 교훈도 분명하다. 토크나이저 학습 데이터와 모델 학습 데이터, 추론 시 입력 전처리를 일치시킬 것(특히 캐리지 리턴과 특수 토큰 처리), 토크나이저 학습 후 인코딩-디코딩으로 도달 불가 토큰을 점검할 것, 작은 테스트 런이나 다른 코퍼스로 under-trained 토큰을 미리 검사할 것. 외부의 큰 토크나이저를 가져와 전혀 다른 데이터로 학습하는 조합이 가장 위험하다는 것도 데이터로 확인됐다.
한편 저자들이 연 후속 연구 방향도 흥미롭다. StarCoder2 사례가 드러낸 "단일 문서가 토큰을 정의하는" BPE의 약점을 막는 전략(문서 단위로 병합 횟수를 제한하기), 효율적 인코딩과 under-trained 조각 증가 사이의 트레이드오프, 그리고 희귀 토큰에 가중치 감쇠를 어떻게 적용하느냐가 under-training 심각도에 미치는 영향 등은 아직 체계적으로 연구되지 않은 영역이다.
개인적으로 이 논문이 좋았던 지점은, 거창한 새 모델 없이도 기존 모델들의 가중치를 꼼꼼히 들여다보는 것만으로 이렇게 많은 걸 알아낼 수 있다는 걸 보여줬다는 점이다. '잉어킹 낚시'라는 가벼운 제목과 달리, 그 안에는 학습 동역학에 대한 단단한 가설과 20종 넘는 모델에 대한 성실한 실증이 들어 있다. 토크나이저를 설계하거나 LLM을 처음부터 학습하는 입장이라면, 이 논문의 분석 도구는 배포 전 반드시 돌려볼 만한 위생 점검(sanity check) 목록에 들어갈 만하다.
References
- Rumbelow & Watkins, 2023. "SolidGoldMagikarp (plus, prompt generation)." Blog Post.
- Geiping et al., 2024. "Coercing LLMs to do and reveal (almost) anything." arXiv:2402.14020.
- Sennrich et al., 2016. "Neural machine translation of rare words with subword units." ACL. (BPE)
- Kudo, 2018. "Subword regularization: Improving neural network translation models with multiple subword candidates." ACL. (Unigram)
- Bostrom & Durrett, 2020. "Byte pair encoding is suboptimal for language model pretraining." Findings of EMNLP.
- Inan et al., 2017. "Tying word vectors and word classifiers: A loss framework for language modeling." arXiv:1611.01462.
- Biś et al., 2021. "Too much in common: Shifting of embeddings in transformer language models and its implications." NAACL.
- Groeneveld et al., 2024. "OLMo: Accelerating the science of language models." ACL.
- Provilkov et al., 2020. "BPE-dropout: Simple and effective subword regularization." ACL.