논문 리뷰
논문 리뷰: Scaffold-BPE: Enhancing Byte Pair Encoding for Large Language Models with Simple and Effective Scaffold Token Removal
Scaffold-BPE 리뷰
BPE가 어휘에 몰래 끼워 넣는 저빈도 "비계(scaffold)" 토큰을 학습 과정에서 동적으로 걸러내, 추가 파라미터 없이 토큰 빈도 불균형을 완화하고 LLM 성능을 끌어올린 토크나이저.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Scaffold-BPE: Enhancing Byte Pair Encoding for Large Language Models with Simple and Effective Scaffold Token Removal |
| 저자 | Haoran Lian (Beihang Univ.), Yizhe Xiong (Tsinghua Univ.), Jianwei Niu (교신저자, Beihang Univ.) 외 (Beihang, Tsinghua, BNRist, 중국과학원, 베이징공과대학) |
| 학회/저널 | arXiv preprint (2024년 4월 최초 공개, v3 2024년 11월) |
| 논문 링크 | arXiv:2404.17808 |
1. 들어가며
토크나이저는 LLM 파이프라인에서 가장 먼저 등장하면서도 가장 적게 의심받는 부품이다. GPT 계열부터 LLaMA, Baichuan, Qwen에 이르기까지 거의 모든 현대 LLM이 Byte Pair Encoding(BPE)을 쓴다. 원래 1994년에 데이터 압축용으로 고안된 알고리즘(Gage, 1994)을 Sennrich et al.(2015)이 서브워드 분절에 가져다 쓴 뒤로, BPE는 "일단 깔고 보는" 기본값이 되었다. 어휘 크기를 32K로 할지 128K로 할지, BPE-Dropout을 섞을지 같은 하이퍼파라미터는 많이 연구됐지만, 정작 BPE가 어휘를 만드는 방식 자체에 흠이 있을 수 있다는 질문은 거의 던져지지 않았다.
이 논문이 파고드는 지점이 바로 거기다. BPE는 "가장 자주 등장하는 토큰 쌍을 반복해서 병합"하는 방식으로 어휘를 키우는데, 이 과정에서 한번 만들어진 토큰은 어휘에서 절대 빠지지 않는다. 문제는 어떤 토큰은 더 긴 토큰을 만들기 위한 중간 재료로만 쓰이고 정작 혼자서는 거의 등장하지 않는다는 점이다. 저자들은 이런 토큰을 비계 토큰(Scaffold Token) 이라 부른다. 건물을 지을 때 쓰는 비계처럼, 완성된 토큰을 만드는 데는 필요하지만 완성 후에는 쓸모가 떨어지는 토큰이라는 뜻이다.
비계 토큰이 왜 문제가 되는가? 이들은 개별 등장 빈도가 낮아서 모델이 충분히 학습하기 어렵다. 게다가 어휘 크기는 고정되어 있으니, 비계 토큰이 자리를 차지하는 만큼 정작 자주 쓰이는 실제 고빈도 토큰이 어휘에 못 들어오는 낭비가 생긴다. 논문에 따르면 LLaMA가 쓰는 32K 어휘 기준으로 약 6.07%가 비계 토큰이다. 100개 중 6개꼴로 "제대로 학습되지도 않고 공간만 차지하는" 토큰이 섞여 있는 셈이다.
Scaffold-BPE의 해법은 이름 그대로다. 학습 과정에서 비계 토큰을 동적으로 표시해두고, 인코딩이 끝난 최종 토큰 표현에서는 이들을 제거한다. 추가 파라미터가 없고(parameter-free), 연산 부담이 거의 없으며(computation-light), 구현이 간단하다(easy-to-implement). BPE의 단순함을 그대로 유지하면서 작은 수정만으로 언어 모델링과 기계 번역 양쪽에서 일관된 성능 향상을 보여준다는 것이 이 논문의 주장이다.
2. 기존 연구의 한계
2.1 BPE와 그 변형들
BPE의 기본 동작은 간단하다. 코퍼스를 문자/바이트 단위로 쪼갠 뒤, 가장 빈번하게 인접해서 나타나는 토큰 쌍을 하나로 병합하고, 이걸 어휘에 추가한다. 이 과정을 목표 어휘 크기에 도달할 때까지 반복한다. 희귀 단어를 서브워드로 분해해 OOV(out-of-vocabulary) 문제를 피할 수 있다는 점 때문에 신경망 기반 NLP의 표준으로 자리 잡았다.
BPE가 널리 쓰이면서 여러 개선 연구가 나왔다. 하나는 태스크에 맞는 최적 어휘 크기를 찾는 방향이다(Xu et al., 2020; Gutierrez-Vasques et al., 2021; Gowda et al., 2020). 다른 하나는 토큰의 인코딩 경로를 확률적으로 바꿔 일종의 정규화 효과를 노리는 방향인데, BPE-Dropout(Provilkov et al., 2019)이나 동적 프로그래밍 기반 분절(He et al., 2020a)이 여기 속한다.
이 개선들의 공통점은 "어휘 크기를 어떻게 정할까", "같은 어휘로 어떻게 다르게 분절할까"에 집중했다는 것이다. 정작 "어휘에 어떤 토큰이 들어가야 하는가"라는 질문, 즉 어휘 구성 자체의 품질은 건드리지 않았다. 비계 토큰 문제는 바로 이 사각지대에 있다.
2.2 토큰 빈도 불균형 문제
사실 빈도 불균형이 학습을 방해한다는 통찰 자체는 새롭지 않다. 객체 탐지에서 클래스 불균형을 다룬 Focal Loss(Lin et al., 2017)나, 생성 언어 모델에서 토큰별 학습 난이도 편향을 다룬 InfoEntropy Loss(Su et al., 2023)가 이미 "자주 안 나오는 대상은 학습이 덜 된다"는 점을 지적했다.
다만 이들은 손실 함수 쪽에서 불균형을 보정하려 했다. Scaffold-BPE는 접근이 다르다. 불균형을 만드는 원인 중 하나인 저빈도 토큰 자체를 어휘 구성 단계에서 솎아낸다. 손실 설계로 사후에 보정하는 대신, 토크나이저 단에서 애초에 불균형을 줄이는 셈이다. 이 둘은 서로 배타적이지 않으니 함께 쓸 수도 있지만, 적어도 "토크나이저가 불균형의 공범"이라는 지적은 이 논문이 선명하게 짚은 지점이다.
3. 핵심 아이디어
저자들의 출발점은 하나의 관찰이다. 같은 "서브워드"라도 성격이 완전히 다른 두 부류가 어휘에 섞여 있다는 것.
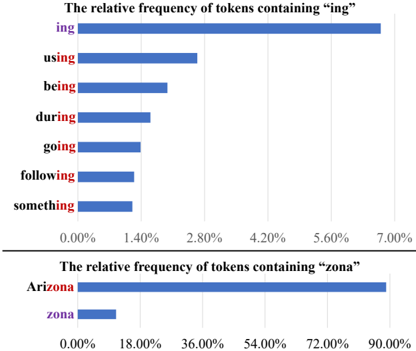
Figure 1: Pile 데이터셋을 32K 어휘의 원본 BPE로 토크나이즈했을 때 나타나는 두 종류의 토큰. 가로축은 'ing'/'zona'를 포함하는 모든 토큰의 전체 빈도 중 해당 토큰이 차지하는 비율이다. (원논문)
위 그래프가 비계 토큰 개념을 가장 직관적으로 보여준다. 위쪽은 'ing'를 포함하는 토큰들의 상대 빈도 분포다. 'ing' 자체(약 6.8%)뿐 아니라 'using', 'being', 'during', 'going' 등 여러 토큰에 'ing'가 골고루 분산되어 있다. 핵심은, 'connecting' 같은 단어가 어휘에 통째로 들어있지 않고 'connect'+'ing'로 분절되기 때문에, 'ing'가 독립 토큰으로 자주 등장한다는 점이다. 그래서 'ing'는 비계 토큰이 아니다.
반면 아래쪽 'zona'를 보면 이야기가 다르다. 'zona'를 포함하는 토큰의 빈도 중 약 90%가 'Arizona' 하나에 쏠려 있고, 'zona' 자체가 독립적으로 등장하는 비율은 20%도 안 된다. 'zona'는 'Arizona'를 만들기 위한 중간 재료로만 존재하는 전형적인 비계 토큰인 것이다. BPE는 'Arizona'를 만드는 과정에서 'zona'를 거쳐야 했기 때문에 'zona'를 어휘에 넣었지만, 정작 'Arizona'가 완성되고 나면 'zona'가 독립적으로 쓰일 일은 거의 없다.
이렇게 어휘 안에 저빈도 비계 토큰이 쌓이면 어떤 일이 벌어지는가?
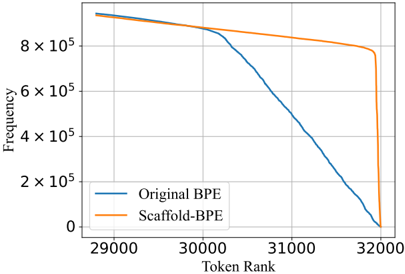
Figure 2: 원본 BPE와 Scaffold-BPE의 토큰 빈도를 내림차순으로 정렬한 분포. 가로축은 토큰 순위(28000~32000 구간), 세로축은 빈도. (원논문)
이 그래프는 어휘의 "꼬리" 부분, 즉 빈도가 낮은 순위 28000~32000 구간을 확대한 것이다. 파란 선(원본 BPE)을 보면 순위 31000 언저리부터 빈도가 급격히 곤두박질쳐서 사실상 0에 가까운 토큰들이 어휘 끝자락을 채우고 있다. 이들이 바로 비계 토큰이다. 반면 주황 선(Scaffold-BPE)은 같은 구간에서 훨씬 완만하게, 더 높은 빈도를 유지하다가 맨 끝에서야 떨어진다. 비계 토큰을 걷어내고 그 자리를 실제 고빈도 토큰으로 채웠기 때문에, 어휘 전체의 빈도 분포가 한결 균일해진 것이다.
여기서 저자들의 직관을 정리하면 이렇다. BPE는 "병합은 하되 제거는 안 하는" 단조 증가 방식이라 저빈도 중간 토큰이 어휘에 눌러앉는다. 그러니 한번 어휘에 들어온 토큰이라도 이후 병합 과정에서 빈도가 충분히 떨어지면 다시 끌어내릴 수 있는 장치, 즉 동적 제거 메커니즘을 BPE에 심어주면 된다. 기존 연구가 "어떤 토큰을 넣을까"의 입구만 관리했다면, Scaffold-BPE는 출구까지 함께 관리하는 셈이다.
4. 제안 방법 (Method)
4.1 전체 구조와 용어 정의
Scaffold-BPE의 핵심 자료구조는 확장 어휘(Expanded Vocabulary) 다. 원본 BPE가 단일 어휘 만 다룬다면, Scaffold-BPE는 를 두 부분으로 나눠서 관리한다. 각 토큰에는 Scaffold(·)라는 불리언 속성이 붙고, 이 값에 따라 토큰이 두 부류로 갈린다.
실제로 모델 학습과 텍스트 표현에 쓰이는 정상 토큰(normal token)의 집합은 다음과 같이 정의된다.
반대로 모델에 입력되지도 않고 인코딩 후 토큰 표현에도 나타나지 않는 비계 토큰의 집합은 이렇게 정의된다.
중요한 점은 어휘 크기를 셀 때 비계 토큰 는 포함하지 않는다는 것이다. 정상 토큰 의 개수만 센다. 즉 "32K 어휘"라고 하면 32K이고, 는 그 위에 얹힌 보조 재료일 뿐이다. 비계 토큰은 오직 학습과 인코딩 과정에서 더 긴 정상 토큰을 조립하기 위한 중간 다리로만 쓰인다. 이 설계 덕분에 Scaffold-BPE는 원본 BPE와 "같은 어휘 크기"라는 조건을 공정하게 맞추면서도, 내부적으로는 더 많은 토큰 정보를 활용할 수 있다.
4.2 학습 과정 (Training Process)
먼저 원본 BPE의 학습을 복습하면, 코퍼스 를 문자/바이트 리스트 로 쪼갠 뒤 매 반복마다 가장 빈번한 토큰 쌍을 찾아 병합한다. 를 토큰 또는 토큰 쌍의 빈도라 할 때, 각 반복에서 선택되는 쌍은 다음과 같다.
이렇게 찾은 를 새 토큰 로 병합해 어휘에 추가하고, 에서 모든 를 로 치환한 뒤 다시 반복한다. 효율을 위해 토큰 쌍들을 빈도 내림차순 우선순위 큐 에 넣어두는데, 병합이 일어날 때마다 인접 쌍들의 빈도만 갱신하면 되므로 매번 전체를 다시 스캔할 필요가 없다. 예를 들어 '...u, a, b, v...' 문맥에서 가 로 치환되면 와 의 빈도는 1씩 줄고, 새로 생긴 와 가 큐에 들어간다.
Scaffold-BPE가 여기에 더하는 건 매 반복 끝에 들어가는 작은 추가 단계 하나다. 핵심 통찰은 이렇다. 어떤 토큰 쌍 가 병합되어 가 될 때, 와 의 빈도 , 는 그만큼 줄어든다(그 쌍이 에 흡수됐으니까). BPE 학습 내내 토큰의 빈도는 오직 이런 병합을 통해서만 감소한다. 그러니 병합 직후 줄어든 , 를 보고 "이 토큰이 아직도 고빈도인가?"를 판정하면 된다.
판정 기준이 영리하다. 우선순위 큐의 머리 에 있는 쌍은 다음번에 어휘로 들어갈 유력 후보다. 따라서 는 "어휘에 들어갈 자격이 있는 빈도"와 "없는 빈도"를 가르는 자연스러운 경계선 역할을 한다. 그래서 병합 후 (또는 )의 빈도가 이 경계 아래로 떨어지면 비계 토큰으로 표시한다.
이 설계의 묘미는 추가 하이퍼파라미터가 전혀 없다는 점이다. 비계 토큰을 걸러내는 임계값을 사람이 정하는 게 아니라, BPE가 이미 들고 있는 를 그대로 재활용한다. 게다가 는 매 반복마다 동적으로 바뀌므로, 어떤 학습 단계에서든 상황에 맞게 비계 토큰을 적응적으로 식별할 수 있다.
또 하나 중요한 디테일은, 비계 토큰 표시가 영구적이지 않다는 것이다. 비계로 표시된 토큰은 큐 에 다시 push되어, 나중에 다른 병합으로 빈도가 회복되면 우선순위 큐 상단에 올라와 정상 토큰으로 복귀할 가능성을 남겨둔다. 알고리즘(Algorithm 1)에서 큐 머리를 pop했을 때 그 토큰이 이미 비계 집합 에 있으면, Scaffold 속성을 다시 False로 되돌리고 정상 토큰으로 편입하는 분기가 바로 이 복귀 경로다.
이 한 번의 반복을 그림으로 보면 이해가 한결 쉽다.
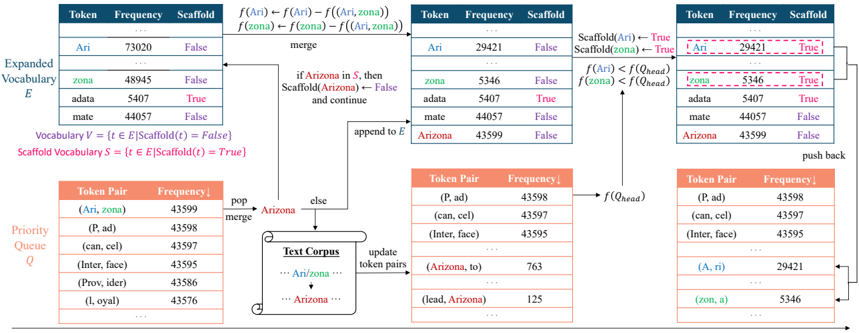
Figure 3: Scaffold-BPE 학습 과정의 한 반복을 그린 그림. 좌측의 확장 어휘 와 우선순위 큐 에서 시작해, 가장 빈번한 쌍 (Ari, zona)를 병합하고, 그 결과 빈도가 떨어진 Ari와 zona를 비계 토큰으로 재표시하는 흐름을 보여준다. (원논문)
그림을 따라가 보면, 우선순위 큐 의 머리에 있는 (Ari, zona) 쌍(빈도 43599)을 pop해서 'Arizona'로 병합한다. 'Arizona'가 아직 비계 집합 에 없으므로 정상 토큰으로 에 추가되고, 텍스트 코퍼스에서 'Ari zona'가 모두 'Arizona'로 치환된다. 그 결과 'Ari'의 빈도는 73020에서 29421로, 'zona'의 빈도는 48945에서 5346으로 크게 떨어진다. 이제 갱신된 큐의 머리 빈도 와 비교하는데, 와 가 모두 그보다 작아졌으므로 둘 다 비계 토큰으로 표시된다(우측 상단의 점선 박스). 그리고 이들은 다시 큐로 push되어 재기의 기회를 얻는다. 'Ari'가 다른 쌍 (A, ri)로, 'zona'가 (zon, a)로 큐에 되돌아가는 모습이 우측 하단에 보인다.
여기서 눈여겨볼 건, 'zona'처럼 빈도가 급락한 토큰은 'Arizona'라는 더 긴 토큰에 흡수된 결과라는 점이다. 즉 비계 토큰은 "자기보다 긴 토큰이 자길 집어삼킨" 흔적인 셈이고, Scaffold-BPE는 이 흔적을 포착해 어휘에서 밀어낸다.
4.3 인코딩 과정 (Encoding Process)
학습으로 확장 어휘 가 완성되면, 이제 임의의 텍스트 를 토큰 열 로 바꾸는 인코딩 차례다. 원본 BPE의 인코딩은 텍스트를 문자 단위로 쪼갠 뒤, 어휘에 먼저 추가된(=더 빈번한) 토큰일수록 높은 우선순위를 주면서 토큰 쌍을 반복 병합한다.
Scaffold-BPE의 인코딩은 두 가지 특별한 단계를 더한다. Scaffolding과 Demolishing이다.
Scaffolding: 병합할 쌍을 고를 때 정상 토큰뿐 아니라 비계 토큰까지 포함한 확장 어휘 전체를 후보로 쓴다. 가능한 병합 중에서 에서의 순위가 가장 앞선(=가장 먼저 어휘에 추가된) 것을 선택한다.
여기서 는 확장 어휘 에서의 순위다. 비계 토큰을 중간 다리로 적극 활용하기 때문에, 인코딩 도중 실제로 등장하는 토큰 종류는 일시적으로 어휘 크기 을 넘어설 수 있다. 비계 토큰을 발판 삼아 더 긴 정상 토큰으로 조립해 올라가는 과정이라 '비계 세우기(Scaffolding)'라는 이름이 붙었다.
Demolishing: 더 이상 병합할 쌍이 없으면 원본 BPE는 여기서 끝낸다. 하지만 Scaffold-BPE의 중간 결과 에는 아직 비계 토큰이 남아 있을 수 있다. 이대로 두면 토큰 종류가 어휘 크기를 넘어서서 모델의 임베딩 테이블 범위를 벗어난다. 그래서 마지막에 남은 비계 토큰을 전부 "가장 짧은 비계 아닌 자식 토큰 열"로 분해한다. 비계 토큰 가 와 로 이루어졌다면,
이 분해를 , 에 대해 재귀적으로 적용해, 이 오직 정상 토큰 만으로 이루어지도록 만든다. 건물을 다 지은 뒤 비계를 철거하는 것과 같아서 '철거(Demolishing)'다.
말로만 들으면 복잡해 보이니 실제 예시를 보자.
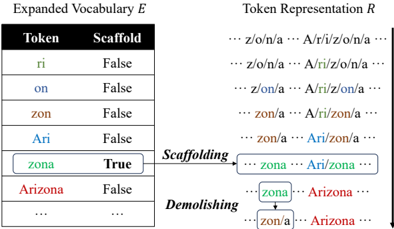
Figure 4: 'zona'와 'Arizona'에 대한 인코딩 과정. 비계 토큰 'zona'(Scaffold=True)를 발판으로 쓰는 Scaffolding 단계와, 최종적으로 'zona'를 'zon'+'a'로 철거하는 Demolishing 단계를 보여준다. (원논문)
오른쪽의 토큰 표현 열을 위에서 아래로 따라가면 병합이 진행되는 모습이 보인다. 'Arizona'의 경우, 문자 단위 'A/r/i/z/o/n/a'에서 시작해 Scaffolding을 거치며 'Ari/zona'까지 조립된다. 이때 'zona'는 비계 토큰이지만 중간 다리로 동원된다. 그다음 'Ari'+'zona'가 정상 토큰 'Arizona'로 병합되므로, 최종 에는 비계 토큰이 남지 않는다. 깔끔하게 'Arizona' 하나로 끝난다.
반면 'zona'가 단독으로 등장하는 경우를 보자. Scaffolding을 거치면 'zona'(비계 토큰)까지 조립되지만, 더 이상 병합할 정상 토큰이 없다. 이대로 끝내면 에 비계 토큰 'zona'가 남는다. 그래서 Demolishing 단계에서 'zona'를 가장 짧은 정상 토큰 열인 'zon'+'a'로 분해한다. 결과적으로 'zona'가 단독으로 나올 때는 두 개의 정상 토큰으로 표현되는 것이다.
구현상의 영리함은, 모든 비계 토큰의 "가장 짧은 정상 자식 토큰 열"을 학습 과정에서 미리 계산해둘 수 있다는 점이다. 덕분에 철거 한 번의 시간 복잡도는 이고, 인코딩 효율에 미치는 영향은 무시할 만하다. Figure 1에서 봤던 'zona'의 빈도 분포가 여기서 설명된다. 'zona'는 'Arizona'의 일부일 때는 비계로서 조립에 쓰이고, 단독일 때는 'zon'+'a'로 철거되므로, 어느 쪽이든 최종 토큰 열에서 독립 토큰 'zona'로 남지 않는다.
정리하면, Scaffold-BPE는 학습 때 비계 토큰을 동적으로 표시하고(Training), 인코딩 때는 비계 토큰을 발판으로 썼다가(Scaffolding) 마지막에 철거한다(Demolishing). 이 세 조각이 맞물려 "비계 토큰은 조립을 돕되 최종 결과엔 남지 않는다"는 목표를 달성한다. 알고리즘 전체가 BPE의 기존 메커니즘 위에 올라타므로 파라미터도, 하이퍼파라미터도 늘지 않는다는 점이 이 방법의 가장 큰 미덕이다.
5. 실험 결과
5.1 실험 설정
- 데이터셋: Pile(Gao et al., 2020). 825.18 GiB 규모의 영어 텍스트 데이터셋으로, 데이터 분포는 원 논문과 동일하게 맞췄다.
- 토크나이저: 원본 BPE와 Scaffold-BPE로 각각 32K 어휘를 학습했다(LLaMA 계열과 동일한 크기). GPT-2처럼 사전 토큰화(pre-tokenization)로 서로 다른 문자 범주의 병합을 막았고, LLaMA를 따라 숫자는 개별 자릿수로 분할했다.
- 모델: 468M, 1.2B, 6.7B 세 가지 크기의 언어 모델을 학습했다. 468M와 1.2B는 Pythia의 410M/1.0B 구조와 동일하며(어휘 크기 차이로 임베딩/출력 레이어 파라미터가 조금 다름), 6.7B는 LLaMA-7B와 동일한 구조다.
- 학습: 기본 설정은 모든 모델을 100B 토큰으로 사전학습했다. 두 토크나이저는 압축률이 달라서 같은 토큰 수가 담는 실제 텍스트 양이 조금씩 다른데, LLM 학습에서 흔히 쓰는 "토큰 수" 기준 연산 예산에 맞춰 비교했다(텍스트 양을 맞춘 비교는 5.4.5에서 별도로 다룸).
- 평가: 오픈소스 lm-evaluation-harness(Gao et al., 2023)를 사용했고, 마지막 5개 체크포인트의 평균을 보고했다. 모든 주요 결과에 대해 -검정을 수행해 -value < 0.01로 통계적 유의성을 확인했다.
5.2 상식 추론 (Common Sense Reasoning)
상식 추론 능력은 BoolQ, HellaSwag, OpenBookQA, PIQA, SIQA, StoryCloze, Winogrande 등 7개 벤치마크에서 0-shot과 5-shot 평균 정확도로 평가했다.
| Model | Tokenizer | BoolQ | HellaSwag | OpenBookQA | PIQA | SIQA | StoryCloze | Winogrande |
|---|---|---|---|---|---|---|---|---|
| 468M | Original BPE | 58.64 | 40.78 | 30.50 | 66.57 | 43.40 | 62.77 | 53.00 |
| 468M | Scaffold-BPE | 60.52 | 41.68 | 32.20 | 68.69 | 44.09 | 63.04 | 54.22 |
| 1.2B | Original BPE | 60.86 | 47.25 | 31.70 | 68.55 | 44.09 | 65.61 | 55.52 |
| 1.2B | Scaffold-BPE | 62.26 | 48.07 | 32.90 | 69.86 | 45.34 | 67.02 | 56.00 |
| 6.7B | Original BPE | 62.87 | 60.57 | 35.10 | 73.69 | 46.98 | 71.43 | 60.97 |
| 6.7B | Scaffold-BPE | 64.95 | 61.19 | 38.00 | 74.54 | 47.49 | 72.26 | 61.76 |
Table 1 (원논문): 모델 크기별 0/5-shot 상식 추론 벤치마크 평균 정확도 (-value < 0.01). Scaffold-BPE를 볼드 처리.
표에서 바로 눈에 들어오는 건 7개 벤치마크 × 3개 모델 크기, 즉 21개 조합 전부에서 Scaffold-BPE가 원본 BPE를 이긴다는 점이다. 단 한 칸도 지지 않는다. 토크나이저만 바꿨을 뿐인데 이 정도로 일관된 우위가 나오는 건 드문 일이다.
규모가 커질수록 격차가 벌어지는 경향도 보인다. 가장 큰 6.7B 모델에서 BoolQ는 62.87 → 64.95로 2.08pp, OpenBookQA는 35.10 → 38.00으로 2.90pp 올랐다. 작은 468M 모델에서도 PIQA가 66.57 → 68.69로 2.12pp 개선됐다. 이 결과를 저자들은 "Scaffold-BPE가 더 균형 잡힌 빈도 분포로 텍스트를 인코딩하므로, 언어 모델이 모든 토큰을 더 충분히 학습할 수 있다"는 것으로 해석한다. 토큰 하나하나가 학습 신호를 골고루 받으니 다운스트림 성능이 올라간다는 논리다.
흥미로운 건 이 개선이 "공짜"에 가깝다는 점이다. 아키텍처도, 학습 데이터도, 연산 예산도 그대로인데 토크나이저의 어휘 구성만 손봤다. 그만큼 비계 토큰이 그동안 묵묵히 성능을 갉아먹고 있었다는 방증이기도 하다.
5.3 폐쇄형 질의응답 (Closed-Book Question Answering)
상식 추론만으로는 부족하다 싶었는지, 저자들은 성격이 다른 태스크인 폐쇄형 QA에서도 검증한다. 모델이 외부 문서 없이 내부 지식만으로 답을 맞혀야 하는 과제다. 가장 큰 6.7B 모델로 TriviaQA와 WebQuestions에서 정확 일치(exact match) 성능을 측정했다.
| Tokenizer | TriviaQA | WebQuestions |
|---|---|---|
| Original BPE | 15.63 | 8.56 |
| Scaffold-BPE | 18.86 | 9.89 |
Table 2 (원논문): 6.7B 모델의 0/5-shot 폐쇄형 QA 정확 일치 성능 (-value < 0.01).
TriviaQA에서 15.63 → 18.86으로 3.23pp, WebQuestions에서 8.56 → 9.89로 1.33pp 올랐다. TriviaQA의 3.23pp는 상대적으로 보면 20% 넘는 향상이라 결코 작지 않다. 폐쇄형 QA는 모델이 암기한 지식을 정확히 꺼내야 하는 태스크인데, 토큰이 더 고르게 학습되면 개체명이나 사실 정보를 담은 토큰의 표현 품질이 좋아져서 이런 지식 집약적 과제에 유리하게 작용한 것으로 보인다. 상식 추론과 지식 QA라는 서로 다른 성격의 태스크 모두에서 개선이 나타난다는 건, Scaffold-BPE의 효과가 특정 과제에 국한되지 않는다는 근거가 된다.
5.4 추가 분석 (Discussion)
이 논문이 성실한 지점은, "32K 어휘, 100B 토큰"이라는 기본 설정에서만 좋은 결과를 보이고 끝내지 않는다는 데 있다. 어휘 크기, 학습 토큰 수, 태스크/언어/아키텍처, 압축률, 코퍼스 크기 통제까지 다섯 갈래로 강건성을 파고든다.
5.4.1 다양한 어휘 크기 (Various Vocabulary Size)
실무에서는 코퍼스 규모, 언어 다양성, 모델 크기, 태스크에 따라 어휘 크기를 다르게 잡는다. 그래서 32K 외에 64K(Baichuan 계열), 128K(Baichuan 2 계열) 어휘로도 468M 모델을 학습해 검증했다.
먼저 비계 토큰을 걷어낸 자리에 들어온 실제 고빈도 토큰이 얼마나 더 자주 등장하는지를 보자.
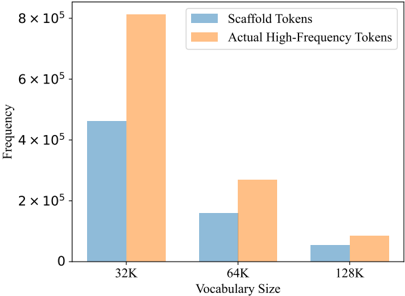
Figure 5: 32K, 64K, 128K 어휘에서 제거된 비계 토큰(파랑)과 그 자리를 대체한 새 고빈도 토큰(주황)의 평균 빈도 비교. (원논문)
세 어휘 크기 모두에서 주황 막대(대체 토큰)가 파랑 막대(비계 토큰)보다 뚜렷하게 높다. 빈도 증가율은 32K에서 76.40%, 64K에서 68.58%, 128K에서 58.99%였다. 즉 Scaffold-BPE가 쫓아낸 비계 토큰 대신 들여온 토큰들은 평균적으로 60~76% 더 자주 등장한다는 뜻이다. 어휘의 "꼬리"를 더 알찬 토큰으로 채웠다는 Figure 2의 관찰이 수치로 재확인되는 셈이다.
한 가지 짚을 만한 건, 어휘가 커질수록 증가율이 조금씩 줄어든다는 점(76% → 69% → 59%)이다. 어휘가 클수록 애초에 더 희귀한 토큰까지 담게 되므로, 비계 토큰과 대체 토큰 사이의 빈도 격차가 상대적으로 좁아지는 것으로 읽힌다. 그래도 128K에서도 여전히 60% 가까운 개선이 유지되니, 큰 어휘에서도 비계 토큰 문제가 사라지지 않는다는 점이 드러난다.
그렇다면 이 빈도 개선이 실제 성능으로 이어지는가?
| Benchmark | 64K Orig. BPE | 64K Scaffold-BPE | 128K Orig. BPE | 128K Scaffold-BPE |
|---|---|---|---|---|
| BoolQ | 58.01 | 59.71 | 56.67 | 59.43 |
| HellaSwag | 41.82 | 42.06 | 42.70 | 42.91 |
| OpenBookQA | 30.90 | 31.10 | 31.10 | 32.30 |
| PIQA | 67.95 | 69.26 | 67.68 | 68.82 |
| SIQA | 43.47 | 43.86 | 43.83 | 44.14 |
| StoryCloze | 64.19 | 65.02 | 64.11 | 65.26 |
| Winogrande | 53.67 | 54.34 | 53.91 | 55.09 |
Table 3 (원논문): 어휘 크기(64K/128K)별 468M 모델의 0/5-shot 상식 추론 평균 정확도 (-value < 0.01). Scaffold-BPE를 볼드 처리.
64K와 128K 양쪽 모두, 7개 벤치마크 전부에서 Scaffold-BPE가 앞선다. 특히 128K의 BoolQ는 56.67 → 59.43으로 2.76pp나 벌어진다. 어휘 크기를 바꿔도 우위가 흔들리지 않는다는 건, Scaffold-BPE의 효과가 특정 어휘 크기에 의존하지 않는다는 뜻이다. 앞서 강조했듯 비계 토큰 판정에 사람이 튜닝하는 하이퍼파라미터가 없고 라는 내부 신호에만 의존하기 때문에, 어떤 어휘 크기에서도 알고리즘이 알아서 적응한다는 설계 철학이 실험으로 뒷받침된다.
5.4.2 더 많은 학습 토큰 (More Training Tokens)
Scaling Law(Kaplan et al., 2020)를 생각하면, 학습 토큰을 더 쏟아부었을 때도 이득이 유지되는지가 중요하다. 토큰을 많이 보면 저빈도 토큰도 결국 충분히 학습되어 Scaffold-BPE의 이점이 희석될 수 있다는 반론이 가능하기 때문이다. 이를 확인하려고 468M 모델을 300B 토큰까지 이어서 학습했다.
| Benchmark | Original BPE | Scaffold-BPE |
|---|---|---|
| BoolQ | 58.21 | 61.62 |
| HellaSwag | 45.10 | 46.03 |
| OpenBookQA | 31.10 | 33.50 |
| PIQA | 68.63 | 69.86 |
| SIQA | 43.78 | 44.73 |
| StoryCloze | 65.53 | 66.54 |
| Winogrande | 53.67 | 56.12 |
Table 4 (원논문): 300B 학습 토큰에서 468M 모델의 0/5-shot 상식 추론 평균 정확도 (-value < 0.01). Scaffold-BPE를 볼드 처리.
300B 토큰에서도 7개 벤치마크 전부 Scaffold-BPE가 우세하다. BoolQ는 58.21 → 61.62로 3.41pp, Winogrande는 53.67 → 56.12로 2.45pp 올랐다. 100B 설정(Table 1)과 비교하면 격차가 오히려 커진 지표도 보인다. 학습 데이터가 점점 커지는 요즘 추세에서, 단순한 토크나이저 수정만으로 이런 이득을 유지한다는 건 실용적으로 반가운 소식이다. 토큰을 많이 봐도 빈도 불균형이라는 구조적 문제는 저절로 해소되지 않는다는 방증이기도 하다.
5.4.3 다른 태스크/언어/아키텍처, 그리고 BPE-Dropout과의 결합
LLM이 대세라지만, 학습/추론 비용 때문에 여전히 전통적인 모델을 쓰는 응용도 많다. 그래서 저자들은 BPE가 원래 태어난 고향인 기계 번역으로 돌아가 검증한다. WMT'14 En-De, En-Fr 데이터셋에서 Ott et al.(2018)과 동일한 설정으로 실험했다. 여기서는 언어 모델링과 달리 인코더-디코더 구조(Transformer)를 쓴다.
| Method | En-De | En-Fr |
|---|---|---|
| Original BPE | 29.31 | 43.20 |
| Original BPE + BPE-Dropout | 29.50 | 43.44 |
| Scaffold-BPE | 29.76 | 43.81 |
| Scaffold-BPE + BPE-Dropout | 29.78 | 43.83 |
Table 5 (원논문): WMT'14 En-De, En-Fr의 BLEU 점수. Scaffold-BPE를 볼드 처리.
이 표 하나가 여러 주장을 동시에 입증한다. 첫째, Scaffold-BPE(29.76/43.81)가 원본 BPE(29.31/43.20)를 BLEU에서 앞선다. 언어 모델링 전용이 아니라 기계 번역에도 통한다는 뜻이다. 둘째, En-De와 En-Fr 양쪽에서 통하므로 특정 언어에 묶이지 않는다(언어 비민감성). 셋째, 앞선 실험이 디코더 전용 구조였던 것과 달리 여기선 인코더-디코더 구조인데도 효과가 나타나므로, 아키텍처에도 비민감하다.
넷째가 개인적으로 가장 흥미로운데, Scaffold-BPE는 기존 BPE 개선 기법과 직교(orthogonal)한다. BPE-Dropout은 인코딩 경로를 확률적으로 바꾸는 정규화 기법이고, Scaffold-BPE는 어휘 구성을 손보는 기법이라 작동 층위가 다르다. 그래서 둘을 겹쳐 쓸 수 있는데, Scaffold-BPE + BPE-Dropout(29.78/43.83)이 각각을 단독으로 쓸 때보다 조금 더 높다. 다만 결합의 추가 이득(29.76 → 29.78)은 크지 않아서, 번역 과제에서는 Scaffold-BPE 단독으로도 이미 상당 부분의 이득을 챙긴다고 보는 게 맞겠다.
5.4.4 더 높은 압축률 (Higher Compression Rate)
토크나이저의 효율을 재는 또 다른 지표가 압축률, 즉 토큰 하나가 평균 몇 바이트를 담느냐다. 값이 클수록 같은 텍스트를 더 적은 토큰으로 표현한다는 뜻이라 학습/추론 효율에 직결된다.
| Tokenizer | Pile | En-De | En-Fr |
|---|---|---|---|
| Original BPE | 3.879 | 4.830 | 5.012 |
| Scaffold-BPE | 3.889 | 4.861 | 5.042 |
Table 6 (원논문): Pile과 WMT 데이터셋에서의 압축률(토큰당 평균 바이트 수). Scaffold-BPE를 볼드 처리.
세 코퍼스 모두에서 Scaffold-BPE의 압축률이 미세하게 높다(Pile 3.879 → 3.889 등). 비계 토큰을 걷어낸 자리에 실제 고빈도 토큰을 채우니, 같은 텍스트를 조금 더 적은 토큰으로 표현할 수 있게 된 것이다. 차이 자체는 소수점 둘째 자리 수준으로 작지만, 방향이 일관되게 개선 쪽이라는 점이 중요하다. 그런데 이 지점이 바로 다음 실험의 동기가 된다. 압축률이 높아졌다는 건, 같은 100B 토큰이라도 Scaffold-BPE가 더 많은 "실제 텍스트"를 소화했다는 뜻이기 때문이다. 그렇다면 앞선 성능 향상이 혹시 "데이터를 더 많이 본" 덕분은 아닐까?
5.4.5 동일 코퍼스 크기에서의 비교 (Same Corpus Size)
이 반론을 정면으로 반박하는 게 5.4.5다. 지금까지는 "토큰 수"를 맞춰서 비교했는데, 압축률 차이 때문에 두 토크나이저가 소화한 실제 텍스트 양이 달랐다. 이 변수를 제거하기 위해, 정확히 388 GiB의 동일한 텍스트(약 100B 토큰에 해당)로 468M 모델 두 개를 다시 학습했다.
| Benchmark | Original BPE | Scaffold-BPE |
|---|---|---|
| BoolQ | 58.72 | 60.55 |
| HellaSwag | 40.84 | 41.69 |
| OpenBookQA | 30.55 | 32.22 |
| PIQA | 66.58 | 68.78 |
| SIQA | 43.40 | 44.13 |
| StoryCloze | 62.85 | 63.08 |
| Winogrande | 53.07 | 54.25 |
Table 7 (원논문): 정확히 388 GiB의 동일 학습 텍스트에서 468M 모델의 0/5-shot 상식 추론 평균 정확도 (-value < 0.01). Scaffold-BPE를 볼드 처리.
텍스트 양을 똑같이 맞췄는데도 7개 벤치마크 전부에서 Scaffold-BPE가 이긴다. 이건 중요한 통제 실험이다. Scaffold-BPE의 이득이 단지 "같은 연산 예산으로 데이터를 더 많이 먹어서" 생긴 게 아니라는 걸 증명하기 때문이다. 압축률 향상으로 인한 데이터 증가 효과를 제거해도, 토큰 빈도 불균형 완화 자체가 모델이 모든 토큰을 더 충분하고 고르게 학습하도록 돕는다는 핵심 주장이 살아남는다. 솔직히 이런 반론을 저자들이 스스로 예상하고 통제 실험까지 붙여둔 건 논문의 신뢰도를 크게 높이는 부분이다.
6. 추가 실험 및 부록 (Appendix)
부록은 "왜 Scaffold-BPE가 더 잘 학습되는가"를 정보이론과 임베딩 공간 두 각도에서 뒷받침하고, 재현에 필요한 세부 설정을 제공한다.
6.1 더 높은 엔트로피, 더 낮은 중복도 (Higher Entropy, Lower Redundancy)
빈도 불균형이 완화되면 정보이론적으로 어떤 변화가 생기는지를 Shannon 엔트로피와 중복도(Redundancy)로 측정했다(Gutierrez-Vasques et al., 2021). 어휘 에 대해 토큰 확률 를 상대 빈도로 추정할 때, 엔트로피는 평균 정보량을 나타낸다.
엔트로피가 높을수록 복잡도가 높고(덜 예측 가능하고), 토큰들이 더 고른 확률로 등장한다는 뜻이다. 중복도는 실제 엔트로피가 이론적 최대값에 얼마나 가까운지를 재는 지표다.
| Tokenizer | Entropy ↑ | Redundancy ↓ |
|---|---|---|
| Original BPE | 11.2382 | 0.2491 |
| Scaffold-BPE | 11.2443 | 0.2487 |
Table 8 (원논문): 토크나이즈한 Pile 데이터셋의 엔트로피와 중복도(32K 어휘 기준).
Scaffold-BPE가 엔트로피는 더 높고(11.2382 → 11.2443) 중복도는 더 낮다(0.2491 → 0.2487). 차이는 작지만 방향이 일관된다. 어휘의 토큰들이 더 균형 잡힌 등장 확률을 가진다는 것을 정량적으로 보여주는 셈이다. Su et al.(2023)의 논리에 기대면, 토큰 등장이 고를수록 학습 불균형이 완화되고 코퍼스에 대한 학습이 더 충분해져 성능이 올라간다. 수치 차이가 미미한 건 아쉬운 지점이지만, 이는 32K 어휘 중 약 6%인 비계 토큰이 전체 분포에서 차지하는 비중이 작기 때문이기도 하다. 소수의 꼬리를 손봤을 때 전역 엔트로피가 크게 요동치지 않는 건 자연스럽다.
6.2 학습된 임베딩의 더 나은 균일성 (Better Uniformity)
토큰 빈도가 고르면 임베딩 공간의 품질도 좋아질까? Wang & Isola(2020)는 임베딩이 초구(hypersphere) 위에 고르게 퍼질수록(uniformity) 정보를 최대한 보존하는 좋은 표현이라고 봤다. 저자들은 이 관점에서 6.7B 모델의 토큰 임베딩을 시각화했다(Provilkov et al., 2019의 방식).
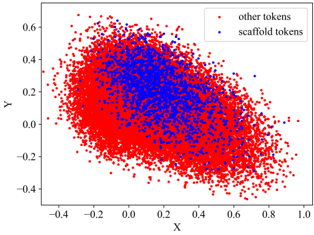
Figure 6: 원본 BPE로 학습한 토큰 임베딩의 시각화. 빨강은 일반 토큰(other tokens), 파랑은 비계 토큰(scaffold tokens)이다. 비계 토큰들이 중앙에 뭉쳐 있다. (원논문)
위 그림은 원본 BPE 패널로, 파란 점(비계 토큰)들이 중앙 영역에 눈에 띄게 뭉쳐 있다(clustered). 임베딩이 특정 영역에 몰려 있다는 건 서로 잘 구분되지 않는다는 뜻, 즉 제대로 학습되지 못했다는 신호다. 빈도가 낮으니 학습 신호를 적게 받아 표현이 뭉개진 것이다. 논문의 Scaffold-BPE 패널(원논문 Figure 6b)에서는, 비계 토큰을 제거하고 그 자리에 들여온 새 토큰들이 의미 공간 전반에 더 고르게 퍼져(better uniformity) 초구를 넓게 덮는다. 정보이론 지표(Table 8)에서 보인 균형 개선이 임베딩 공간의 기하학적 품질로도 확인되는 셈이고, 이것이 다운스트림 성능 향상의 중간 메커니즘이라는 저자들의 설명과 맞아떨어진다.
6.3 학습 하이퍼파라미터와 실험 환경
재현성을 위해 모델 구조와 환경이 상세히 공개되어 있다. 세 모델의 구조는 다음과 같다.
| model size | dimension | n heads | n layers | batch size | seq length |
|---|---|---|---|---|---|
| 468M | 1024 | 16 | 24 | 1024 | 1024 |
| 1.2B | 2048 | 8 | 16 | 2048 | 1024 |
| 6.7B | 4096 | 32 | 32 | 2048 | 2048 |
Table 9 (원논문): 모델 크기별 아키텍처 설정.
최적화는 LLaMA를 따라 AdamW(Loshchilov & Hutter, 2017)를 썼고, 학습률 , warmup 2k 스텝, cosine 감쇠 스케줄을 적용했다. 눈에 띄는 건 1.2B 모델의 설정인데, dimension이 2048로 468M(1024)보다 크지만 n_layers는 16으로 오히려 468M(24)보다 얕다. 깊이보다 너비를 키운 구조라는 점이 흥미롭다.
실험 환경은 16대 서버, 각 서버에 NVIDIA H800 GPU 8장(총 128장), 서버당 메모리 600GB, 70코어 CPU, Ubuntu 20.04.6 LTS였다. 사용한 패키지 버전도 부록에 표로 정리되어 있다.
| Package | Version |
|---|---|
| absl-py | 1.4.0 |
| accelerate | 0.21.0 |
| datasets | 2.14.3 |
| deepspeed | 0.10.0 |
| ninja | 1.11.1 |
| protobuf | 4.23.4 |
| pytorch-triton | 2.1.0+e6216047b8 |
| scikit-learn | 1.3.0 |
| scipy | 1.11.1 |
| torch | 2.1.0.dev20230807+cu121 |
| torchaudio | 2.1.0.dev20230807+cu121 |
| torchinfo | 1.8.0 |
| torchvision | 0.16.0.dev20230807+cu121 |
| triton | 2.0.0 |
| wandb | 0.15.7 |
| flash-attn | 2.0.4 |
| zstandard | 0.21.0 |
| seaborn | 0.12.2 |
| gradio | 3.39.0 |
Table 10 (원논문): 실험에 사용한 패키지 버전.
flash-attn, deepspeed 같은 대규모 학습 스택이 포함된 걸 보면 6.7B 모델 학습까지 표준적인 LLM 파이프라인을 그대로 썼음을 알 수 있다. 평가 역시 오픈소스 lm-evaluation-harness를 쓰고 마지막 5개 체크포인트 평균을 보고해, 단일 체크포인트의 운에 기대지 않는 공정한 비교를 지향했다.
7. 강점과 한계
강점
- 거의 공짜에 가까운 개선: 추가 파라미터도, 새 하이퍼파라미터도 없이 BPE의 내부 신호()만 재활용한다. Table 1에서 21개(7벤치마크 × 3모델) 조합 전부, Table 3에서 64K/128K 양쪽 전부, Table 7에서 코퍼스 통제 후에도 전부 이긴다. 이렇게 빈틈없는 일관성은 토크나이저 연구에서 흔치 않다.
- 철저한 강건성 검증: 어휘 크기(32K/64K/128K), 학습 토큰 수(100B/300B), 태스크(언어 모델링/기계 번역), 언어(En-De/En-Fr), 아키텍처(디코더 전용/인코더-디코더)까지 바꿔가며 효과를 확인했다. 특히 압축률 향상이 "데이터를 더 본" 교란 변수일 수 있다는 점을 스스로 지적하고 388 GiB 동일 코퍼스 실험(Table 7)으로 반박한 건 연구자로서 성실한 태도다.
- 기존 기법과의 직교성: Table 5에서 BPE-Dropout과 결합해 추가 이득을 얻는 걸 보였다. 어휘 구성을 손보는 Scaffold-BPE와 인코딩 경로를 바꾸는 BPE-Dropout이 다른 층위에서 작동하므로, 기존 파이프라인에 덧붙이기 쉽다.
- 메커니즘에 대한 설명: 성능 수치만 나열하지 않고, 빈도 분포(Figure 2, 5), 정보 엔트로피(Table 8), 임베딩 균일성(Figure 6)까지 동원해 "왜 효과가 나는지"의 인과 사슬을 그려 보였다. 설명이 설득력 있다.
한계 및 아쉬운 점
- 절대 향상 폭이 크지 않은 지표도 많다: BoolQ, OpenBookQA처럼 2~3pp 오르는 지표가 있는 반면, HellaSwag나 StoryCloze는 0.2~0.9pp 수준의 미미한 개선에 그치는 경우도 있다. -value < 0.01로 통계적 유의성은 확보했다지만, 실질적 임팩트가 지표마다 들쭉날쭉한 건 사실이다.
- 정보이론 지표의 차이가 미세하다: Table 8의 엔트로피(11.2382 → 11.2443)와 중복도(0.2491 → 0.2487) 차이는 소수점 셋째 자리 수준이다. "비계 토큰 제거가 분포를 더 균형 있게 만든다"는 주장의 방향은 맞지만, 이 미세한 차이가 Table 1의 2~3pp 성능 향상을 온전히 설명하는지는 다소 비약으로 느껴진다. 중간 메커니즘의 정량적 연결이 더 촘촘했으면 좋았겠다.
- 6.07%라는 비계 토큰 비율의 민감도 분석 부재: 32K 어휘에서 비계 토큰이 약 6.07%라고 했는데, 이 비율이 코퍼스 도메인(영어 외 언어, 코드 등)에 따라 어떻게 달라지는지, 그리고 비율이 높을수록 Scaffold-BPE의 이득이 커지는지에 대한 분석이 없다. 실험이 사실상 영어 Pile과 WMT 번역에 집중되어 있어, 교착어나 비라틴 문자 언어에서의 거동은 미지수다.
- 대형 모델에서의 추가 검증 공백: 폐쇄형 QA(Table 2)는 6.7B에서만, 300B 토큰 실험(Table 4)과 어휘 크기 실험(Table 3)은 468M에서만 수행됐다. 각 분석이 모든 모델 크기로 교차 검증되지는 않아서, "큰 모델 + 많은 토큰 + 큰 어휘"가 동시에 겹칠 때의 거동은 추정에 기댈 수밖에 없다.
- 추론/학습 오버헤드의 정량화 부족: "computation-light"라고 주장하지만, 학습 시 비계 토큰 판정과 큐 재삽입, 인코딩 시 Scaffolding/Demolishing이 더해지는 만큼 실제 처리 속도(throughput)나 토크나이징 지연이 원본 BPE 대비 얼마나 늘어나는지 벤치마크 수치가 없다. Demolishing이 이라는 분석은 있으나, 전체 파이프라인의 실측 오버헤드를 보여줬으면 "거의 공짜"라는 주장이 더 단단해졌을 것이다.
8. 마치며
Scaffold-BPE의 미덕은 문제를 보는 각도에 있다. 모두가 손실 함수나 모델 구조를 건드려 성능을 짜내려 할 때, 이 논문은 "토크나이저의 어휘 구성 자체에 흠이 있다"는 당연하지만 아무도 묻지 않던 질문을 던졌다. BPE가 더 긴 토큰을 만드느라 어쩔 수 없이 품고 가던 저빈도 비계 토큰, 그 조용한 비효율을 포착해 BPE의 기존 메커니즘만으로 걷어낸다. 추가 파라미터도 하이퍼파라미터도 없이 말이다.
결과도 설득력 있다. 모델 크기, 어휘 크기, 학습 토큰 수, 태스크, 언어, 아키텍처를 바꿔가며 거의 모든 조합에서 원본 BPE를 이겼고, "데이터를 더 봐서 좋아진 것 아니냐"는 반론까지 코퍼스 통제 실험으로 막아냈다. 빈도 분포, 정보 엔트로피, 임베딩 균일성으로 이어지는 설명도 "왜 되는지"를 납득시킨다.
물론 지표별 향상 폭이 고르지 않고, 영어 중심 실험이라는 한계, 실측 오버헤드의 공백은 남는다. 그럼에도 이 연구가 주는 메시지는 분명하다. LLM 파이프라인에서 가장 당연하게 여겨지던 부품에도 아직 개선의 여지가 있으며, 그 개선이 꼭 복잡할 필요는 없다는 것. 기존 토크나이저에 작은 수정으로 덧붙일 수 있고 다른 BPE 개선 기법과도 겹쳐 쓸 수 있다는 점에서, 실무에서 "밑져야 본전"으로 시도해볼 만한 기법이다. 토크나이저를 더 이상 블랙박스로 두지 말자는 제안으로 읽어도 좋겠다.
References
- Sennrich et al., 2015. "Neural machine translation of rare words with subword units." (BPE의 서브워드 적용)
- Gage, 1994. "A new algorithm for data compression." (BPE의 기원)
- Provilkov et al., 2019. "BPE-Dropout: Simple and effective subword regularization."
- Gao et al., 2020. "The Pile: An 800GB dataset of diverse text for language modeling."
- Touvron et al., 2023a. "LLaMA: Open and efficient foundation language models."
- Biderman et al., 2023. "Pythia: A suite for analyzing large language models across training and scaling."
- Su et al., 2023. "InfoEntropy loss to mitigate bias of learning difficulties for generative language models."
- Lin et al., 2017. "Focal loss for dense object detection."
- Gutierrez-Vasques et al., 2021. "From characters to words: the turning point of BPE merges."
- Wang & Isola, 2020. "Understanding contrastive representation learning through alignment and uniformity on the hypersphere."
- Kaplan et al., 2020. "Scaling laws for neural language models."
- Ott et al., 2018. "Scaling neural machine translation." (WMT'14 실험 설정)